«Неужели gpt-4o-mini скоро снимут с поддержки?» — этот вопрос в последнее время регулярно появляется в технических сообществах. Поводом стали многочисленные объявления о выводе моделей из эксплуатации в Azure OpenAI Service, а также устойчивое падение gpt-4o-mini в различных рейтингах тестов. Из-за этого многие команды начали заново оценивать выбранные модели.
В этой статье на основе официальной документации OpenAI, объявлений Microsoft Learn о выводе моделей из эксплуатации и авторитетных данных Artificial Analysis мы сначала разберёмся с путаницей вокруг слухов об отключении gpt-4o-mini. Затем сравним по цене и производительности пять альтернативных моделей сопоставимой стоимости: GPT-5 mini, GPT-5 nano, Gemini 2.5 Flash-Lite, DeepSeek V4 Flash и Claude Haiku 4.5. Это поможет понять, нужна ли вам миграция и какая модель принесёт наибольшую выгоду.
Главная ценность статьи: дочитав её, вы будете точно знать, действительно ли gpt-4o-mini «частично выводят из эксплуатации» или слухи просто неверно интерпретируют, а также какая альтернативная модель даст наиболее заметный прирост качества при примерно том же бюджете.
Такие заблуждения широко распространяются во многом потому, что в обсуждениях смешиваются объявления Azure о выводе моделей из эксплуатации, удаление моделей из веб-интерфейса ChatGPT и обобщённые заявления сообщества о том, что «OpenAI избавляется от старых моделей». При этом не хватает чёткого разбора по платформам и типам развёртывания. Ниже мы разделим эти временные линии, чтобы вы не начали спешно мигрировать из-за слухов, которые ещё не вступили в силу, и одновременно не пропустили действительно важные сроки вывода Azure.
Текущее состояние gpt-4o-mini: всего 7 баллов в тестах — правда ли, что модель снимают с поддержки
Сначала главное: в слухах о выводе gpt-4o-mini из эксплуатации заметна серьёзная путаница. У Azure и официального API OpenAI совершенно разные графики, поэтому нельзя безоговорочно утверждать, что «gpt-4o-mini скоро отключат».
Текущие цены и производительность gpt-4o-mini
| Показатель | Значение | Описание |
|---|---|---|
| Цена входных данных | $0.15 / 1M токенов | Цена в официальном API OpenAI |
| Цена кэшированных входных данных | $0.075 / 1M токенов | При попадании в кэш цена снижается вдвое |
| Цена выходных данных | $0.60 / 1M токенов | Цена в официальном API OpenAI |
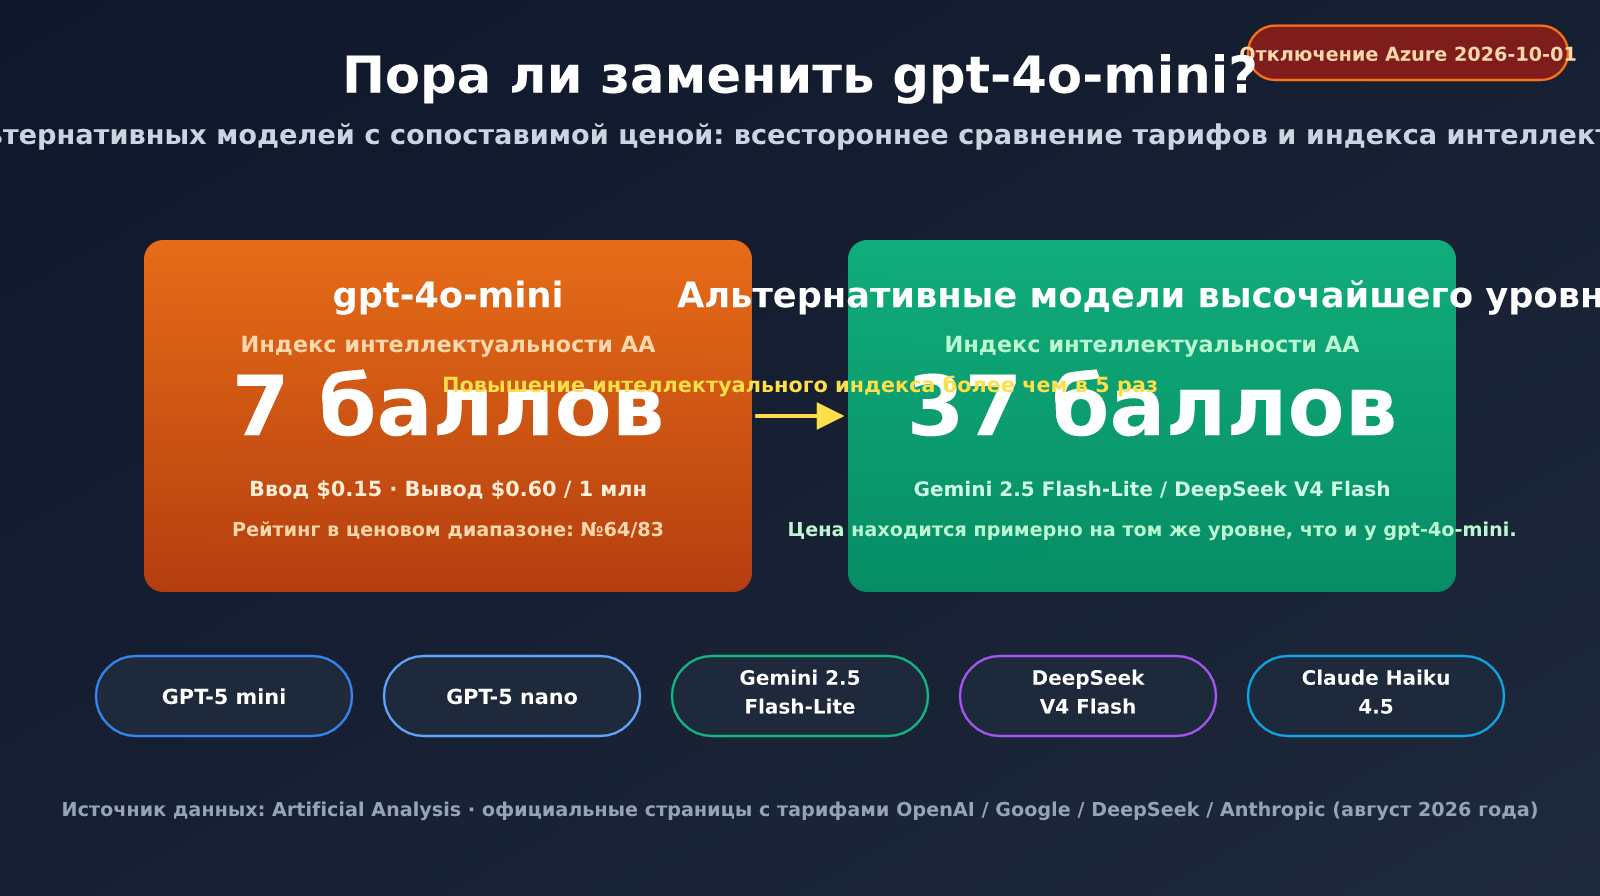
| Индекс интеллекта AA | 7 баллов | Оценка Artificial Analysis, место №64 из 83 в ценовом сегменте |
| Скорость генерации | 100.9 токена/с | Ниже среднего показателя аналогичных моделей — 102.1 токена/с |
Причина, по которой gpt-4o-mini в 2026 году стали так часто критиковать, связана не с изменением цены. Главная проблема — индекс интеллекта Artificial Analysis на уровне всего 7 баллов. Среди 83 моделей в том же ценовом сегменте она занимает 64-е место, заметно уступая медианному уровню этой категории. Иными словами, gpt-4o-mini по-прежнему остаётся дешёвой, но «дёшево» больше не означает «выгодно»: теперь за тот же бюджет можно получить гораздо более интеллектуальную модель.
Отдельно стоит пояснить, насколько показателен индекс интеллекта AA. Artificial Analysis рассчитывает его на основе нескольких публичных тестов, охватывающих рассуждения, программирование, математику и другие способности, а затем сводит результаты с помощью взвешенной формулы. Преимущество этого подхода — широкий охват моделей и частое обновление данных: разные решения разных поставщиков можно сравнивать по одной шкале. Ограничение в том, что индекс отражает средний уровень универсальных способностей и не может полностью заменить тестирование на ваших собственных рабочих данных. Надёжнее использовать его как первый фильтр при отборе кандидатов, а не как окончательный критерий выбора.
График вывода gpt-4o-mini из эксплуатации: Azure и API OpenAI — это совершенно разные сроки
| Платформа / способ развёртывания | Статус | Дата вывода из эксплуатации |
|---|---|---|
| Официальный API OpenAI (сама модель gpt-4o-mini) | Дата вывода не назначена | Пока нет |
| Версия OpenAI с дообучением ft-gpt-4o-mini | План опубликован | Окончание обучения — не ранее 2027-04-01, окончание развёртывания — 2027-10-01 |
| Развёртывание Azure OpenAI Standard | Уже выведено из эксплуатации | 2026-03-31 |
| Provisioned / Global Standard / Data Zone Standard в Azure | Скоро будет выведено из эксплуатации | 2026-10-01 |
Важно уточнить: 13 февраля 2026 года OpenAI действительно убрала GPT-4o, GPT-4.1, GPT-4.1 mini и o4-mini из интерфейса ChatGPT. Но это изменение селектора моделей в веб-версии ChatGPT. В официальном объявлении прямо сказано, что API это не затрагивает, а самой модели gpt-4o-mini в списке отключаемых моделей вообще нет.
На практике в первую очередь стоит обратить внимание на график Azure. Развёртывание gpt-4o-mini в Azure OpenAI Standard уже выведено из эксплуатации 31 марта 2026 года. Развёртывания Provisioned, Global Standard и Data Zone Standard будут полностью отключены 1 октября 2026 года — до этой даты осталось меньше двух месяцев, после чего вызовы начнут напрямую возвращать ошибку 410 Gone. Если ваш рабочий процесс работает в Azure, этот график гораздо важнее вопроса о том, «отключает ли OpenAI модель».
Есть и ещё одна деталь, которую легко упустить: даже при одинаковом названии «gpt-4o-mini» сроки вывода из эксплуатации в Azure различаются в зависимости от способа развёртывания — Standard, Provisioned, Global Standard или Data Zone Standard. Команды, использующие несколько вариантов одновременно, могут проверить объявление только для одного типа развёртывания и ошибочно принять его за общий график отключения.
Поэтому перед проверкой сначала выясните в портале Azure, какой именно тип развёртывания вы используете, а затем отдельно сопоставьте его с таблицей выше. Это поможет избежать расхождения между «говорят, что модель отключают» и «сколько времени она фактически ещё будет доступна».
gpt-4o-mini против 5 альтернативных моделей: полное сравнение цен и результатов тестов
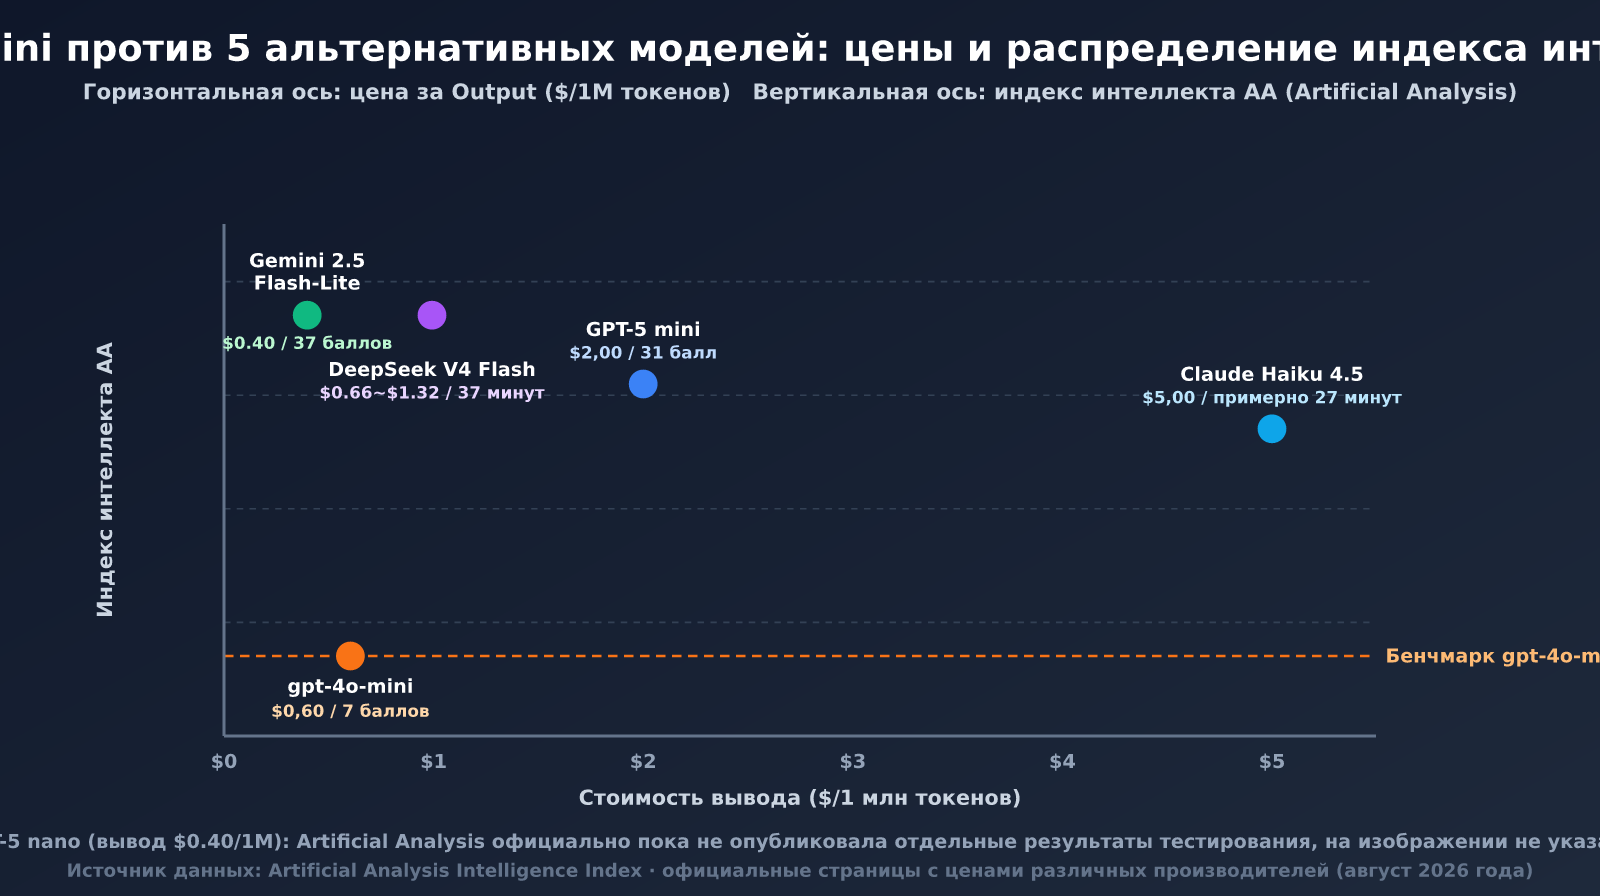
Если вы оцениваете варианты миграции, таблица ниже поможет быстро сравнить 5 альтернативных моделей с ценами, близкими к gpt-4o-mini. Для каждой из них есть официальные данные или результаты авторитетных сторонних тестов.
| Модель | Input / Output ($/1M) | Индекс интеллекта AA | Ключевое преимущество |
|---|---|---|---|
| gpt-4o-mini (базовая модель) | $0.15 / $0.60 | 7 баллов (#64/83) | Зрелая экосистема, хорошая совместимость |
| GPT-5 nano | $0.05 / $0.40 | Официальные результаты отдельно не опубликованы | Самый доступный вариант в линейке |
| GPT-5 mini | $0.25 / $2.00 | 31 балл (режим рассуждений medium) | Самая прямая официальная замена в экосистеме OpenAI |
| Gemini 2.5 Flash-Lite | $0.10 / $0.40 | 37 баллов | Цена близка к gpt-4o-mini, а индекс интеллекта заметно выше |
| DeepSeek V4 Flash | $0.22–$0.44 / $0.66–$1.32 (цены в зависимости от времени суток) | 37 баллов (высокая интенсивность рассуждений) | Динамическое ценообразование, при попадании в кэш стоимость снижается до $0.007/1M |
| Claude Haiku 4.5 | $1.00 / $5.00 | Примерно 24–30 баллов (в зависимости от режима рассуждений) | Более сильные возможности для работы с длинным контекстом и вызова инструментов |
🎯 Техническая рекомендация: перед окончательным выбором мы советуем протестировать все перечисленные модели через APIYI apiyi.com. Платформа предоставляет единый API для вызова gpt-4o-mini, моделей серии GPT-5, Gemini, DeepSeek и Claude — это позволяет быстро переключаться между ними и сравнивать результаты в одном и том же коде.
Помимо этих 5 моделей, стоит обратить внимание на Qwen3.5 Flash от Alibaba Cloud — его цена также находится примерно в том же диапазоне. Сторонние сервисы сравнения указывают стоимость около $0.10 / $0.40, но поскольку эти данные не подтверждены напрямую на официальной странице тарифов DashScope, перед миграцией лучше свериться с ценами в официальной консоли. Это поможет избежать расхождений из-за региона или курса валют.
Кроме того, для GPT-5 nano пока не удалось найти отдельные результаты тестов, опубликованные OpenAI или Artificial Analysis. Поэтому здесь честно указано «не опубликовано», а не приведена выдуманная цифра.
В целом Gemini 2.5 Flash-Lite — самый очевидный кандидат для первичного тестирования. Его цена лишь немного выше, чем у gpt-4o-mini, а индекс интеллекта AA вырастает с 7 до 37 баллов. Среди моделей в том же ценовом диапазоне это один из самых заметных приростов по соотношению цены и возможностей.
Если для вас особенно важна совместимость с экосистемой OpenAI, стоит рассмотреть GPT-5 mini. Его цена более чем вдвое выше, чем у gpt-4o-mini, но прирост производительности также весьма заметен. При крайне ограниченном бюджете можно обратить внимание на GPT-5 nano и тарифы DeepSeek V4 Flash в непиковые часы.
Механизм ценообразования DeepSeek V4 Flash заслуживает отдельного пояснения. Модель использует два тарифа: в непиковые часы Input/Output стоят всего $0.22/$0.66, а в часы пик цена повышается до $0.44/$1.32. При попадании в кэш стоимость может дополнительно снизиться до $0.007–$0.014 за миллион токенов.
Для офлайн-задач, которые можно запускать в непиковое время — например, ночной пакетной генерации саммари или анализа логов, — такая схема часто выгоднее фиксированной цены. Но если сервис обрабатывает запросы в реальном времени в дневные часы пик, стоимость нужно пересчитывать по повышенному тарифу.
Claude Haiku 4.5 придерживается другой стратегии: его цена значительно выше, чем у gpt-4o-mini, зато модель лучше справляется со стабильной обработкой длинного контекста и вызовом инструментов. Поэтому она больше подходит для работы с большими документами и многоэтапной оркестрации инструментов, чем для простой замены модели в сценариях коротких вопросов и ответов.
Рекомендации по сценариям: какую модель выбрать для разных задач
| Сценарий | Рекомендуемая модель | Причина |
|---|---|---|
| Высокая нагрузка на поддержку / FAQ-бот | Gemini 2.5 Flash-Lite | Цена сопоставима с gpt-4o-mini, а показатель интеллектуальности выше более чем в 5 раз |
| Сложные рассуждения / многоэтапные задачи Agent | GPT-5 mini | Лучшая совместимость с экосистемой OpenAI, заметно более сильные способности к рассуждению по сравнению с gpt-4o-mini |
| Массовая обработка по минимальной цене (разметка контента, суммаризация) | GPT-5 nano / DeepSeek V4 Flash в непиковые часы | Цена за единицу может быть примерно в три раза ниже, чем у gpt-4o-mini |
| Анализ длинных документов / длинного контекста | Claude Haiku 4.5 | Более стабильная работа с длинным контекстом и более сильные возможности вызова инструментов |
| Проверка прототипа при крайне ограниченном бюджете | DeepSeek V4 Flash при попадании в кэш | При попадании в кэш стоимость можно снизить до крайне низкого уровня |
💡 Совет по выбору: выбор модели в первую очередь зависит от конкретного сценария и требований к качеству. Мы рекомендуем провести практическое тестирование через платформу APIYI apiyi.com: сравнить, как разные модели работают на реальных данных вашего бизнеса при одинаковом бюджете, а не принимать решение только на основе опубликованных бенчмарков.
Важно учитывать, что в таблице указаны «модели по умолчанию». На практике выбор также нужно корректировать с учётом длины контекста, количества параллельных запросов и требований к задержке. Например, в сценарии поддержки при длинной истории диалога и частых обращениях к предыдущему контексту преимущество Gemini 2.5 Flash-Lite по соотношению цены и качества может частично нивелироваться расходом на более длинный промпт. В таком случае стоит добавить Claude Haiku 4.5 и провести параллельное сравнение. Аналогично, если для сложных задач Agent важна низкая задержка ответа, необходимо измерить сквозное время работы GPT-5 mini именно с вашей цепочкой инструментов, а не ориентироваться только на опубликованный производителем показатель интеллектуальности.
Быстрая миграция: переход с gpt-4o-mini на альтернативную модель за два шага
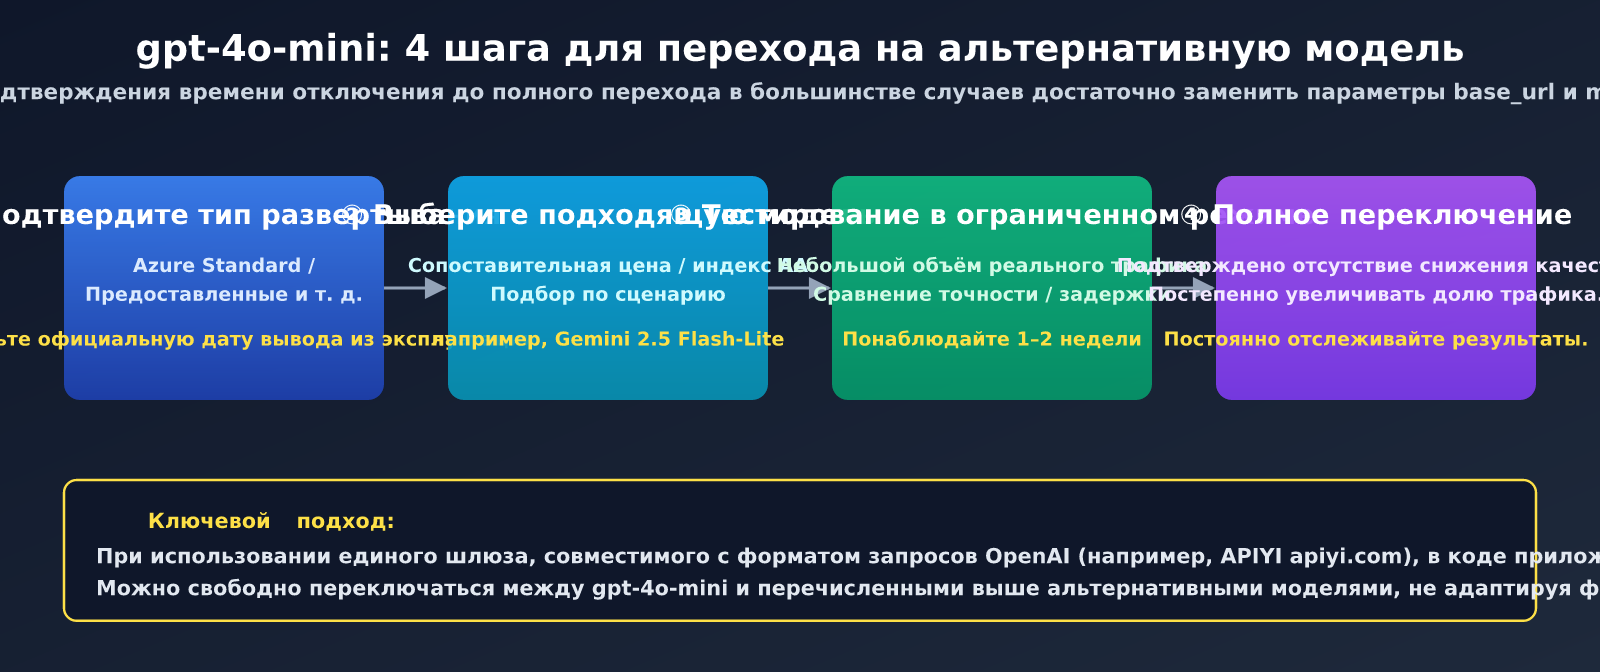
В большинстве случаев для миграции достаточно изменить два параметра: base_url и model. Если вы уже используете OpenAI SDK или клиент в совместимом формате, переписывать бизнес-логику не потребуется.
Настоящая сложность обычно возникает не на уровне кода, а из-за различий между нативными интерфейсами разных поставщиков: форматом сообщений, полями вызова инструментов и стратегиями ограничения скорости запросов. При прямом переходе на нативный SDK Gemini или Claude часто приходится переписывать тело запроса и логику разбора ответа. Единый шлюз, совместимый с форматом запросов OpenAI, позволяет скрыть эти различия. В результате бизнес-коду достаточно поддерживать один способ вызова. Именно поэтому в примере ниже model вынесен в настраиваемый параметр, а не реализован отдельный клиент для каждой модели.
Минимальный пример
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс APIYI: одно подключение для переключения между разными моделями
)

response = client.chat.completions.create(
    model="gemini-2.5-flash-lite",  # Переход с gpt-4o-mini на альтернативную модель
    messages=[{"role": "user", "content": "Hello!"}]
)
print(response.choices[0].message.content)
Посмотреть полный код миграции (с переключателем моделей и повторными попытками при ошибках)
import openai
import os

MODEL_MAP = {
    "baseline": "gpt-4o-mini",
    "openai-upgrade": "gpt-5-mini",
    "budget": "gpt-5-nano",
    "gemini": "gemini-2.5-flash-lite",
    "deepseek": "deepseek-v4-flash",
    "claude": "claude-haiku-4-5",
}

client = openai.OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс APIYI, совместимый с форматом вызовов OpenAI SDK
)

def call_model(prompt: str, profile: str = "gemini", max_retries: int = 2):
    model = MODEL_MAP[profile]
    for attempt in range(max_retries + 1):
        try:
            response = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
                timeout=30,
            )
            return response.choices[0].message.content
        except Exception:
            if attempt == max_retries:
                raise
    return None

if __name__ == "__main__":
    print(call_model("Суммируй сроки отключения gpt-4o-mini", profile="gemini"))
🚀 Быстрый старт: рекомендуем провести сравнительное тестирование перед миграцией через платформу APIYI apiyi.com. Платформа поддерживает единую тарификацию для нескольких моделей — не нужно отдельно получать ключи и создавать аккаунты для каждой новой модели. Все представленные выше варианты можно запустить за несколько минут.
Часто задаваемые вопросы
Q1: Я сейчас использую gpt-4o-mini в Azure OpenAI. Как долго ещё смогу им пользоваться?
Всё зависит от типа развертывания. Если используется Standard-развертывание, модель была выведена из эксплуатации 31 марта 2026 года, поэтому сейчас вызовы, скорее всего, уже недоступны. Для развертываний Provisioned, Global Standard и Data Zone Standard дата вывода из эксплуатации — 1 октября 2026 года, то есть до неё осталось меньше двух месяцев. Рекомендуем как можно скорее провести миграционное тестирование через платформу с поддержкой переключения между моделями, например APIYI apiyi.com, чтобы избежать перебоев в работе после окончания этого срока.
Q2: Я использую официальный API OpenAI. Мне тоже обязательно нужно срочно мигрировать?
Нет, это необязательно. Согласно официальной странице OpenAI Deprecations, сама модель gpt-4o-mini пока не включена в список моделей, выводимых из эксплуатации. В списке находится только её дообученная версия ft-gpt-4o-mini, для которой установлен более поздний график. Если для вас особенно важна стоимость, можно пока продолжить наблюдение. Однако индекс интеллекта AA у gpt-4o-mini составляет всего 7 баллов, поэтому сравнительное тестирование моделей в том же ценовом диапазоне через платформу APIYI apiyi.com обычно позволяет заметно повысить качество без увеличения бюджета.
Q3: Как после перехода на новую модель убедиться, что качество не ухудшилось?
Не стоит полагаться только на субъективные впечатления. Сначала зафиксируйте набор репрезентативных примеров из реальных бизнес-сценариев — а не несколько тестовых запросов, составленных на скорую руку. Затем запустите gpt-4o-mini и модели-кандидаты на одном и том же наборе входных данных и сравните результаты по трём параметрам: точности, доле ответов, соответствующих требуемому формату, и среднему времени отклика. На этапе поэтапного переключения можно направить новой модели лишь небольшую часть реального трафика и наблюдать за результатами в течение одной-двух недель. Если заметного ухудшения качества или задержек не будет, постепенно увеличивайте долю трафика до 100%.
Итоги и рекомендации по принятию решения
| Пункт проверки | Описание |
|---|---|
| Уточнить тип развертывания | Для Azure Standard / Provisioned / Global Standard / Data Zone Standard установлены разные даты вывода из эксплуатации |
| Проверить официальные цены | Стоимость может меняться в зависимости от региона и времени суток; ориентируйтесь на официальную страницу |
| Сравнить индекс интеллекта AA | В первую очередь обращайте внимание на открытые рейтинги сторонних сервисов, например Artificial Analysis, а не только на заявления производителей |
| Поэтапное переключение | Сначала проверьте качество на некритичных участках, затем постепенно увеличивайте долю трафика |
| Унифицировать вызовы API | Используйте сервис-прокси API с совместимым форматом OpenAI SDK, чтобы снизить стоимость переключения между моделями |
В целом gpt-4o-mini не был полностью выведен из эксплуатации в официальном API OpenAI, однако график вывода модели из эксплуатации на стороне Azure уже становится очень сжатым. Кроме того, её отставание в результатах тестов — объективный факт. Для большинства сценариев Gemini 2.5 Flash-Lite и GPT-5 mini — два приоритетных варианта с сопоставимой ценой и заметно более высокой производительностью. В сценариях с крайне жёсткими ограничениями по бюджету можно дополнительно рассмотреть GPT-5 nano и цены DeepSeek V4 Flash в разные периоды нагрузки.
Важно помнить: не стоит поспешно менять модель только потому, что она «дешевле» или «говорят, что её скоро отключат». Цена и результаты тестов — лишь первый этап формирования списка кандидатов. Окончательное решение о миграции и выборе модели следует принимать на основе её фактической работы с данными вашего бизнеса. Более надёжный подход — проводить оценку в течение одной-двух недель и охватывать достаточно широкий набор реальных сценариев, а не гнаться за изменениями рейтинговых баллов. В итоге рекомендуем выполнить сравнительное тестирование на реальных бизнес-данных через платформу APIYI apiyi.com и только после этого выбирать модель для миграции.
Если в процессе миграции у вас возникнут конкретные вопросы, обращайтесь в службу технической поддержки APIYI apiyi.com. Мы продолжим отслеживать изменения официальных цен на gpt-4o-mini и альтернативные модели и обновлять данные в этой статье.