「هل اقترب موعد الاستغناء عن gpt-4o-mini؟» سؤال يتكرر كثيرًا مؤخرًا في أوساط التقنية. والسبب المباشر وراء هذا التساؤل هو إعلانات تقاعد النماذج التي نشرتها خدمة Azure OpenAI Service تباعًا، إلى جانب التراجع المستمر في ترتيب gpt-4o-mini ضمن مختلف قوائم التقييم، ما دفع كثيرًا من الفرق إلى إعادة تقييم اختياراتها للنماذج.
استنادًا إلى الوثائق الرسمية من OpenAI، وإعلانات التقاعد على Microsoft Learn، وبيانات التقييم الموثوقة من Artificial Analysis، يوضح هذا المقال أولًا الالتباس المعلوماتي المحيط بشائعات إيقاف gpt-4o-mini، ثم يقارن، من حيث السعر والأداء، بين 5 نماذج بديلة قريبة السعر، هي GPT-5 mini وGPT-5 nano وGemini 2.5 Flash-Lite وDeepSeek V4 Flash وClaude Haiku 4.5، لمساعدتك على تحديد ما إذا كنت بحاجة إلى الترحيل، وأي نموذج سيحقق أكبر فائدة.
القيمة الأساسية: بعد قراءة هذا المقال، ستعرف بوضوح ما إذا كان gpt-4o-mini قد أصبح «متاحًا جزئيًا» فقط أم أن الأمر أُسيء تفسيره، كما ستعرف أي نموذج بديل يمكنه تحقيق تحسن ملحوظ في النتائج مع بقاء الميزانية تقريبًا على حالها.
انتشرت هذه الالتباسات على نطاق واسع إلى حد كبير لأن إعلانات التقاعد من جانب Azure، وإزالة النماذج من واجهة ChatGPT على الويب، والتصريحات العامة في المجتمع التقني من قبيل «OpenAI ستتخلى عن النماذج القديمة»، نوقشت معًا من دون تمييز. لذلك سنفصل أدناه هذه الخطوط الزمنية ونوضحها بحسب المنصة ونوع النشر، حتى لا تتعجل الترحيل بسبب إشاعة لم تدخل حيز التنفيذ فعليًا بعد، وفي الوقت نفسه لا تتجاهل مواعيد التقاعد الفعلية والمُلِحّة على Azure.
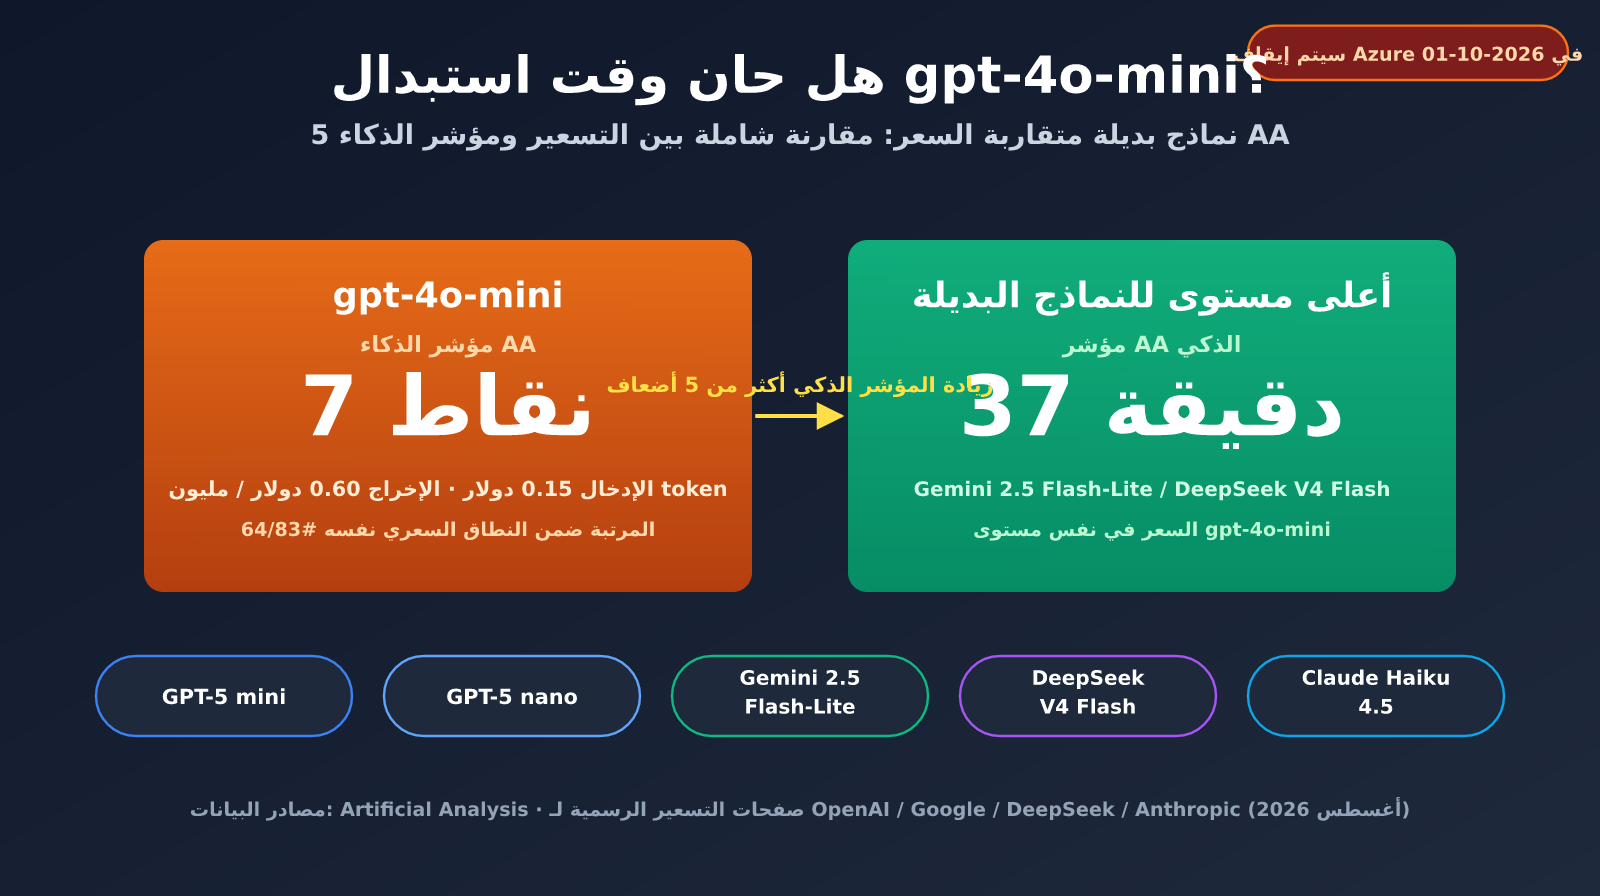
الوضع الحالي لـ gpt-4o-mini: حصل على 7 نقاط فقط، فهل شائعات إيقافه صحيحة؟
الخلاصة أولًا: تنطوي شائعات إيقاف gpt-4o-mini على خلط واضح للمعلومات. فلكل من Azure وواجهة API الرسمية من OpenAI جدول زمني مختلف تمامًا، ولذلك لا يمكن القول بشكل عام إن «gpt-4o-mini سيتوقف».
الأسعار والأداء الحاليان لـ gpt-4o-mini
| المؤشر | القيمة | التوضيح |
|---|---|---|
| سعر الإدخال | $0.15 / 1M tokens | سعر واجهة API الرسمية من OpenAI |
| سعر الإدخال المخزّن مؤقتًا | $0.075 / 1M tokens | ينخفض السعر إلى النصف عند الاستفادة من التخزين المؤقت |
| سعر الإخراج | $0.60 / 1M tokens | سعر واجهة API الرسمية من OpenAI |
| مؤشر الذكاء من AA | 7 نقاط | تقييم Artificial Analysis، والمرتبة #64/83 ضمن النطاق السعري نفسه |
| سرعة الإخراج | 100.9 tokens/s | أقل من متوسط النماذج المماثلة البالغ 102.1 tokens/s |
السبب الأساسي وراء كثرة التشكيك في gpt-4o-mini خلال عام 2026 ليس تغير سعره، بل أن مؤشر الذكاء من Artificial Analysis لا يتجاوز 7 نقاط، ما يضعه في المرتبة 64 بين 83 نموذجًا ضمن النطاق السعري نفسه، وهي نتيجة أقل بكثير من مستوى الوسيط في هذه الفئة السعرية. بعبارة أخرى، لا يزال gpt-4o-mini رخيصًا، لكن «الرخص» لم يعد يعني بالضرورة «أفضل قيمة مقابل السعر»؛ فالميزانية نفسها تتيح الآن شراء نماذج أكثر ذكاءً بكثير.
وللتوضيح، فإن مؤشر الذكاء من AA تحسبه Artificial Analysis بدمج نتائج عدة تقييمات عامة، تشمل الاستدلال والبرمجة والرياضيات وغيرها، مع ترجيحها. وتتمثل ميزته في تغطيته عددًا كبيرًا من النماذج وتحديثه بوتيرة مرتفعة، ما يتيح مقارنة نماذج الشركات المختلفة باستخدام مقياس موحد. أما حدوده فتكمن في أنه يعكس متوسط القدرات العامة، ولا يمكنه أن يحل بالكامل محل الاختبار الفعلي على بيانات نشاطك. لذلك من الأفضل اعتباره مرشحًا أوليًا لتصفية النماذج، لا أساسًا نهائيًا لاتخاذ قرار الاختيار.
الجدول الزمني لإيقاف gpt-4o-mini: اختلاف كامل بين Azure وواجهة API من OpenAI
| المنصة / أسلوب النشر | الحالة | تاريخ التقاعد |
|---|---|---|
| واجهة API الرسمية من OpenAI (النموذج الأساسي gpt-4o-mini) | لم يُحدد تاريخ للتقاعد | لا يوجد حاليًا |
| إصدار OpenAI المُحسّن بالتدريب ft-gpt-4o-mini | توجد خطة معلنة | انتهاء التدريب في موعد لا يسبق 2027-04-01، وانتهاء النشر في 2027-10-01 |
| نشر Azure OpenAI Standard | أُحيل إلى التقاعد | 2026-03-31 |
| Provisioned / Global Standard / Data Zone Standard على Azure | سيُحال إلى التقاعد قريبًا | 2026-10-01 |
من المهم توضيح أن OpenAI أزالت بالفعل في 13 فبراير 2026 نماذج GPT-4o وGPT-4.1 وGPT-4.1 mini وo4-mini من واجهة اختيار النماذج في منتج ChatGPT. لكن هذا التغيير يخص واجهة ChatGPT على الويب، وقد أوضح الإعلان الرسمي أن واجهة API لم تتغير، كما أن gpt-4o-mini نفسه ليس ضمن قائمة النماذج التي أُوقفت. أما الجدول الزمني الذي يستحق المتابعة بجدية فهو جدول Azure: فقد أُحيل نشر gpt-4o-mini بنمط Standard على Azure OpenAI إلى التقاعد في 31 مارس 2026، كما ستتوقف خدمة النشر بأنماط Provisioned وGlobal Standard وData Zone Standard بشكل موحد في 1 أكتوبر 2026. ولم يتبقَّ على ذلك سوى أقل من شهرين، وبعدها ستعيد الاستدعاءات مباشرة الخطأ 410 Gone. إذا كان نشاطك يعمل على Azure، فإن هذا الجدول الزمني أهم من سؤال «هل ستوقف OpenAI النموذج؟» ويجب إعطاؤه الأولوية.
ومن التفاصيل التي يسهل تجاهلها أن اسم «gpt-4o-mini» نفسه لا يعني توحّد موعد التقاعد على Azure؛ فموعد التقاعد يختلف باختلاف أسلوب النشر، سواء كان Standard أو Provisioned أو Global Standard أو Data Zone Standard. وقد يخطئ الفريق الذي يستخدم أكثر من أسلوب نشر في تقدير وتيرة الإيقاف إذا اكتفى بالاطلاع على إعلان يخص أحدها فقط. لذلك يُنصح قبل التحقق من الأمر بفتح بوابة Azure والتأكد من أسلوب النشر المستخدم تحديدًا، ثم مقارنته بالجدول أعلاه والتحقق من تاريخ التقاعد لكل حالة، لتجنب الفجوة بين «سمعت أنه سيتوقف» و«إلى متى سيظل متاحًا فعليًا».
gpt-4o-mini مقابل 5 نماذج بديلة: مقارنة شاملة للأسعار ونتائج التقييم
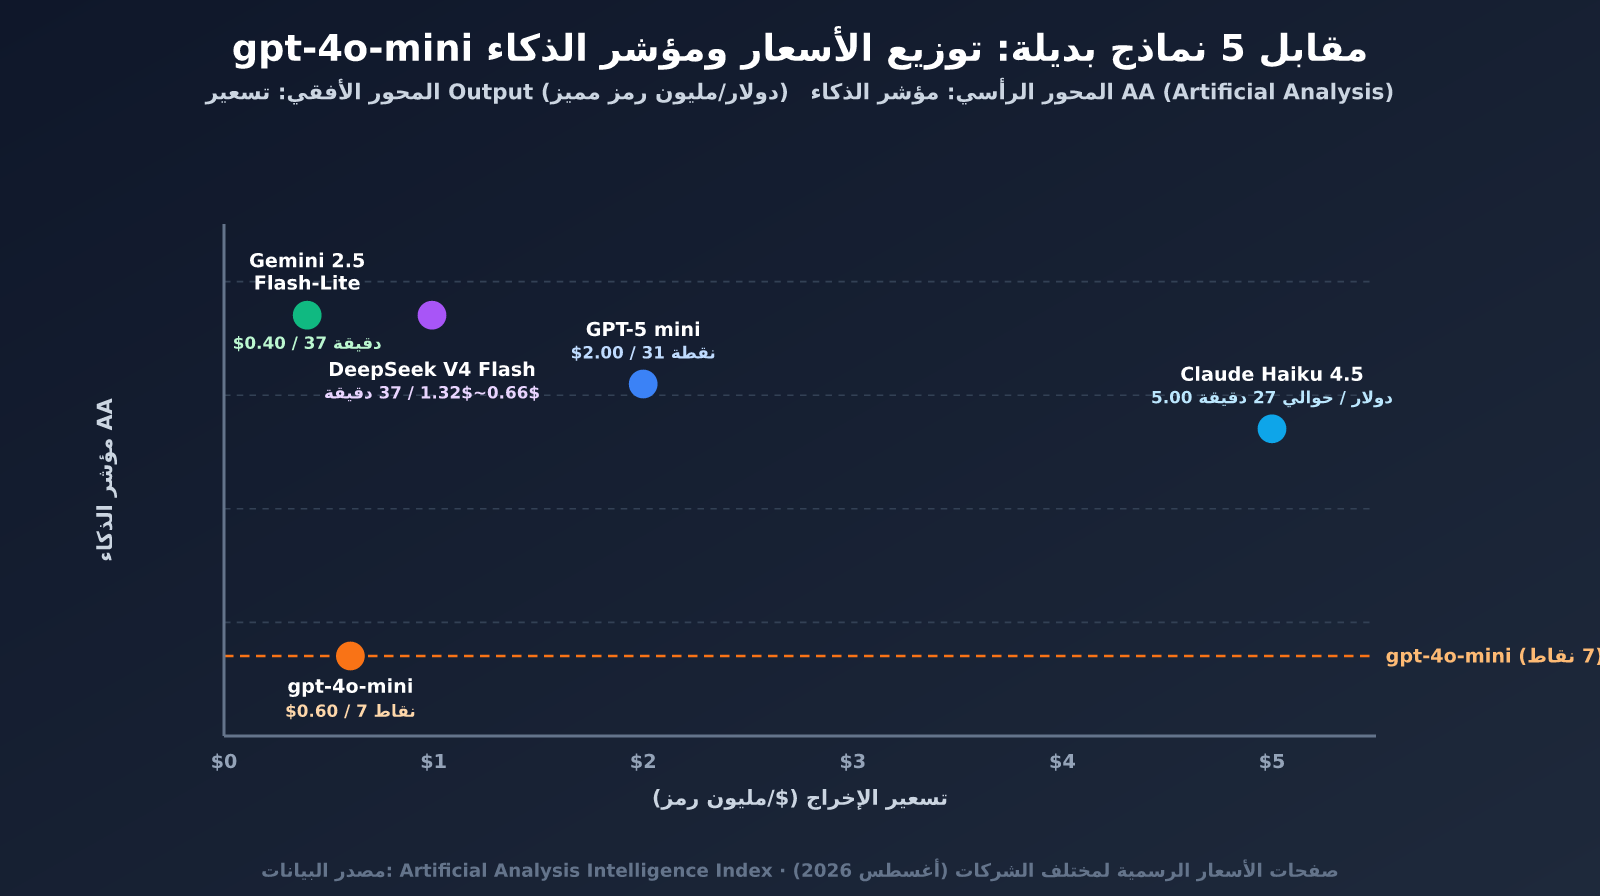
إذا كنت تقيّم خيارات الترحيل، يلخص الجدول التالي 5 نماذج بديلة تقترب أسعارها من gpt-4o-mini، وتستند إلى بيانات رسمية أو بيانات موثوقة من جهات خارجية، ما يسهّل تصفيتها سريعًا وفق الميزانية ومتطلبات الأداء.
| النموذج | الإدخال / الإخراج ($/1M) | مؤشر الذكاء من AA | الميزة الأساسية |
|---|---|---|---|
| gpt-4o-mini (المرجع) | $0.15 / $0.60 | 7 نقاط (#64/83) | منظومة ناضجة وتوافق جيد |
| GPT-5 nano | $0.05 / $0.40 | لم تُعلن نتيجة منفصلة رسميًا | الخيار الأقل تكلفة ضمن السلسلة نفسها |
| GPT-5 mini | $0.25 / $2.00 | 31 نقطة (مستوى الاستدلال المتوسط) | البديل الرسمي الأقرب داخل منظومة OpenAI |
| Gemini 2.5 Flash-Lite | $0.10 / $0.40 | 37 نقطة | سعر قريب من gpt-4o-mini مع تحسن واضح في مؤشر الذكاء |
| DeepSeek V4 Flash | $0.22~$0.44 / $0.66~$1.32 (تسعير الذروة وخارج الذروة) | 37 نقطة (شدة استدلال مرتفعة) | تسعير حسب الفترة، وقد ينخفض السعر عند إصابة التخزين المؤقت إلى $0.007/1M |
| Claude Haiku 4.5 | $1.00 / $5.00 | نحو 24~30 نقطة (بحسب مستوى الاستدلال) | تميز أكبر في السياق الطويل واستدعاء الأدوات |
🎯 نصيحة تقنية: عند الاختيار الفعلي، ننصح باختبار واجهات النماذج المذكورة واحدًا تلو الآخر عبر منصة APIYI apiyi.com. إذ تدعم المنصة، من خلال واجهة API موحدة، استدعاء gpt-4o-mini وسلسلة GPT-5 وGemini وDeepSeek وClaude وغيرها من النماذج الرائدة، ما يسهّل التبديل السريع بينها ومقارنة النتائج ضمن قاعدة الشفرة نفسها.
إضافة إلى هذه النماذج الخمسة، يُعد Qwen3.5 Flash من Alibaba Cloud خيارًا آخر يقع ضمن نطاق سعري قريب؛ إذ تذكر قنوات المقارنة التابعة لجهات خارجية سعرًا يقارب $0.10 / $0.40. لكن بما أن السعر لم يُتحقق منه مباشرة في صفحة التسعير الرسمية لـ DashScope، فمن الأفضل الاعتماد على السعر الظاهر في وحدة التحكم الرسمية قبل الترحيل الفعلي، لتجنب الفروقات الناتجة عن المنطقة أو أسعار الصرف. وبالمثل، لم نعثر حاليًا على نتيجة تقييم مستقلة رسمية أو منشورة من Artificial Analysis لـ GPT-5 nano، لذلك أشرنا بصدق إلى أنها «غير منشورة» بدل اختلاق رقم.
عمومًا، يُعد Gemini 2.5 Flash-Lite الخيار الأجدر بالاختبار أولًا: فسعره أعلى قليلًا فقط من gpt-4o-mini، بينما يقفز مؤشر الذكاء من AA من 7 إلى 37 نقطة، ما يجعله النموذج صاحب أكبر تحسن في القيمة مقابل السعر ضمن الفئة السعرية نفسها. وإذا كانت الأولوية للتوافق مع منظومة OpenAI، فإن GPT-5 mini، رغم أن سعره يزيد على ضعف سعر gpt-4o-mini، يقدم تحسنًا ملحوظًا في الأداء. أما في الحالات شديدة الحساسية تجاه التكلفة، فيمكن النظر في GPT-5 nano وتسعير DeepSeek V4 Flash خارج أوقات الذروة.
يستحق نموذج DeepSeek V4 Flash شرحًا منفصلًا لآلية تسعيره؛ فهو يستخدم سعري الذروة وخارج الذروة. ويبلغ سعر الإدخال/الإخراج خارج الذروة $0.22/$0.66 فقط، بينما يرتفع في أوقات الذروة إلى $0.44/$1.32. وعند إصابة التخزين المؤقت، يمكن أن ينخفض السعر أكثر إلى $0.007~$0.014 لكل مليون token. وبالنسبة إلى المهام غير المتصلة التي يمكن تشغيلها خارج أوقات الذروة، مثل التلخيص الجماعي ليلًا وتحليل السجلات، غالبًا ما يكون هذا التسعير أوفر من النماذج ذات السعر الثابت. أما إذا كان النشاط يعتمد على طلبات فورية خلال ساعات الذروة، فيجب إعادة حساب التكلفة باستخدام سعر الذروة. ويسلك Claude Haiku 4.5 مسارًا مختلفًا؛ فسعره أعلى بوضوح من gpt-4o-mini، لكنه يقدم استقرارًا أفضل في التعامل مع السياق الطويل وقدرات أقوى على استدعاء الأدوات، ما يجعله أنسب لمعالجة المستندات الطويلة وتنسيق الأدوات عبر جولات متعددة، لا للاستبدال المباشر في الأسئلة القصيرة فحسب.
توصيات حسب السيناريو: أي نموذج تختار لكل احتياج؟
| سيناريو الاستخدام | النموذج الموصى به | السبب |
|---|---|---|
| خدمة عملاء عالية التزامن / روبوت FAQ | Gemini 2.5 Flash-Lite | سعره مماثل لـ gpt-4o-mini، مع ارتفاع مؤشر الذكاء بأكثر من 5 أضعاف |
| الاستدلال المعقد / مهام الوكلاء متعددة الخطوات | GPT-5 mini | أفضل توافق مع منظومة OpenAI، وقدرات الاستدلال فيه تتفوق بوضوح على gpt-4o-mini |
| المعالجة الدفعية منخفضة التكلفة للغاية (وضع العلامات على المحتوى، التلخيص) | GPT-5 nano / DeepSeek V4 Flash خارج أوقات الذروة | قد ينخفض السعر لكل وحدة إلى نحو ثلث سعر gpt-4o-mini |
| تحليل المستندات الطويلة / السياقات الطويلة | Claude Haiku 4.5 | يتميز باستقرار أكبر في التعامل مع السياقات الطويلة، إلى جانب قدرات أقوى على استدعاء الأدوات |
| اختبار النماذج الأولية مع حساسية شديدة للميزانية | DeepSeek V4 Flash عند إصابة ذاكرة التخزين المؤقت | يمكن خفض السعر عند إصابة ذاكرة التخزين المؤقت إلى مستوى منخفض للغاية |
💡 نصيحة للاختيار: يعتمد اختيار النموذج بدرجة كبيرة على سيناريو الاستخدام الفعلي ومتطلبات الجودة لديك. نوصي بإجراء اختبارات عملية عبر منصة APIYI apiyi.com، ومقارنة أداء النماذج المختلفة على بيانات نشاطك الحقيقية ضمن الميزانية نفسها، بدلًا من اتخاذ القرار اعتمادًا على نتائج الاختبارات العامة فقط.
تجدر الإشارة إلى أن الجدول أعلاه يقدم «توصيات افتراضية»، بينما يجب أن يأخذ الاختيار الفعلي في الحسبان طول السياق، وحجم التزامن، ومتطلبات زمن الاستجابة. فمثلًا، إذا كان سيناريو خدمة العملاء يتضمن سجل محادثة طويلًا ويتطلب الاستشهاد بالسياق السابق بشكل متكرر، فقد يتراجع جزء من ميزة القيمة مقابل السعر التي يوفرها Gemini 2.5 Flash-Lite بسبب استهلاك موجه أطول. في هذه الحالة، من المفيد أيضًا إدراج Claude Haiku 4.5 في اختبار مقارن مباشر. وبالمثل، إذا كانت مهام الوكيل المعقدة تتطلب زمن استجابة قصيرًا جدًا، فينبغي قياس الزمن الكامل لاستجابة GPT-5 mini ضمن سلسلة الأدوات الخاصة بك، بدلًا من الاكتفاء بالنظر إلى درجة مؤشر الذكاء المعلنة رسميًا.
ترحيل سريع: لا يتطلب الانتقال من gpt-4o-mini إلى نموذج بديل سوى خطوتين
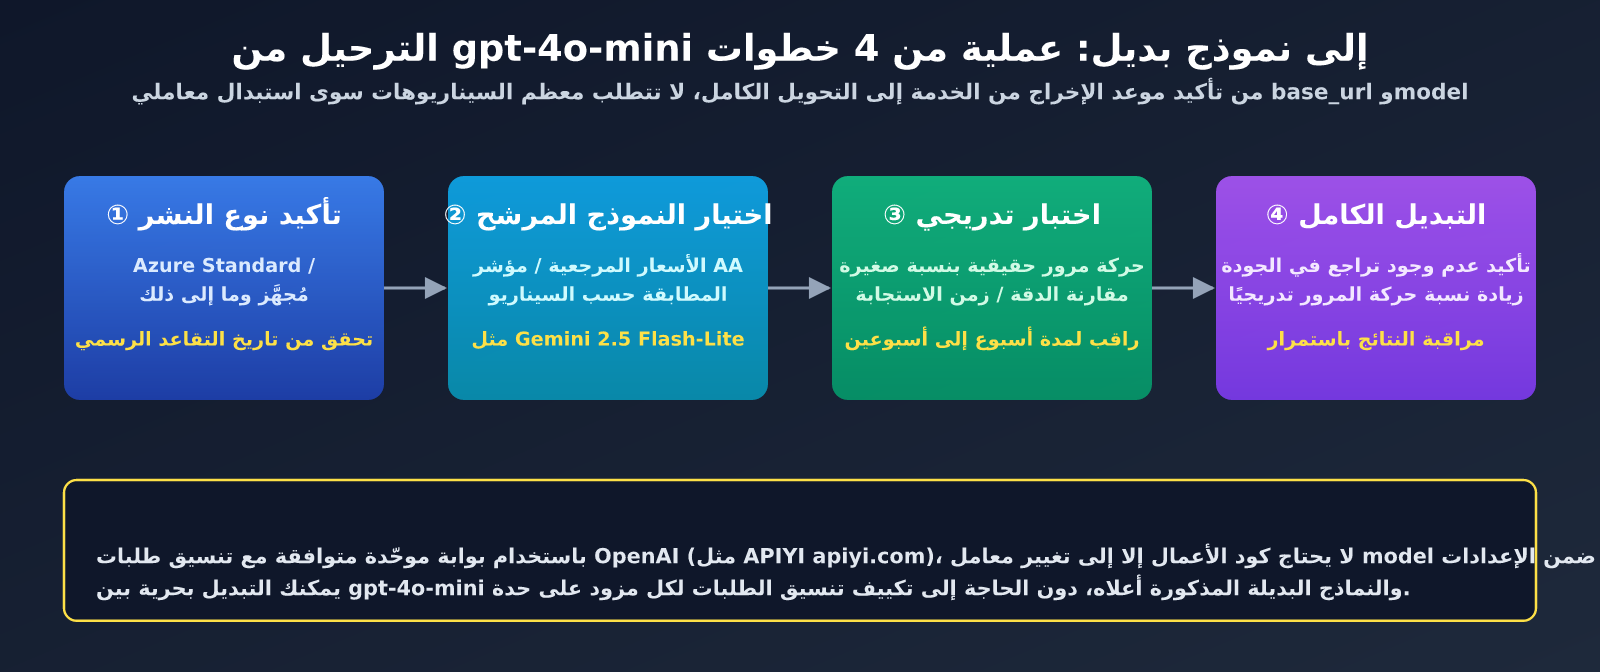
تقتصر معظم أعمال الترحيل على تعديل معاملَي base_url وmodel. فإذا كنت تستخدم OpenAI SDK أو عميلًا متوافقًا مع هذه الصيغة، فلن تحتاج إلى إعادة كتابة أي منطق خاص بالأعمال.
عادةً لا تكمن الصعوبة الحقيقية في طبقة الشفرة، بل في أن الواجهات الأصلية لمختلف الشركات لا تتطابق تمامًا من حيث تنسيق الرسائل، وحقول استدعاء الأدوات، واستراتيجيات تحديد معدل الطلبات. وعند الانتقال مباشرةً إلى SDK الأصلي لـ Gemini أو Claude، ستحتاج غالبًا إلى إعادة كتابة نص الطلب ومنطق تحليل الاستجابة. أما استخدام بوابة موحدة متوافقة مع تنسيق طلبات OpenAI، فيحجب هذه الاختلافات ويتيح لشفرة الأعمال الاحتفاظ بطريقة استدعاء واحدة. ولهذا يجعل المثال التالي قيمة model قابلة للتهيئة، بدل كتابة عميل منفصل لكل مزود.
مثال مبسط للغاية
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI الموحدة، تتيح التبديل بين عدة نماذج عبر عملية ربط واحدة
)

response = client.chat.completions.create(
    model="gemini-2.5-flash-lite",  # التبديل من gpt-4o-mini إلى نموذج بديل
    messages=[{"role": "user", "content": "Hello!"}]
)
print(response.choices[0].message.content)
عرض شفرة الترحيل الكاملة (بما في ذلك مفتاح تبديل النموذج وإعادة محاولة الأخطاء)
import openai
import os

MODEL_MAP = {
    "baseline": "gpt-4o-mini",
    "openai-upgrade": "gpt-5-mini",
    "budget": "gpt-5-nano",
    "gemini": "gemini-2.5-flash-lite",
    "deepseek": "deepseek-v4-flash",
    "claude": "claude-haiku-4-5",
}

client = openai.OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI الموحدة، ومتوافقة مع تنسيق استدعاءات OpenAI SDK
)

def call_model(prompt: str, profile: str = "gemini", max_retries: int = 2):
    model = MODEL_MAP[profile]
    for attempt in range(max_retries + 1):
        try:
            response = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
                timeout=30,
            )
            return response.choices[0].message.content
        except Exception:
            if attempt == max_retries:
                raise
    return None

if __name__ == "__main__":
    print(call_model("لخّص الجدول الزمني لإيقاف gpt-4o-mini", profile="gemini"))
🚀 ابدأ بسرعة: نوصي باستخدام منصة APIYI apiyi.com لإجراء اختبارات المقارنة قبل الترحيل. توفر المنصة فوترة موحدة لعدة نماذج، ولا تحتاج إلى طلب مفتاح أو حساب منفصل لكل نموذج جديد، ويمكنك تشغيل جميع النماذج المرشحة الواردة في الجدول أعلاه خلال دقائق قليلة.
الأسئلة الشائعة
س1: أستخدم حاليًا gpt-4o-mini على Azure OpenAI، إلى متى يمكنني الاستمرار في استخدامه؟
يعتمد ذلك على نوع النشر المحدد. إذا كان النشر من نوع Standard، فقد أُوقف في 31 مارس 2026، ومن المفترض ألا يكون استدعاؤه ممكنًا الآن. أما إذا كان النشر من نوع Provisioned أو Global Standard أو Data Zone Standard، فسيكون تاريخ الإيقاف في 1 أكتوبر 2026، أي لم يتبقَّ سوى أقل من شهرين. يُنصح بإجراء اختبارات الترحيل في أقرب وقت ممكن عبر منصات تدعم التبديل بين نماذج متعددة، مثل APIYI apiyi.com، لتجنب انقطاع الخدمة بعد انتهاء المهلة.
س2: أستخدم واجهة OpenAI API الرسمية، فهل يجب عليّ الترحيل فورًا أيضًا؟
ليس بالضرورة. وفقًا لصفحة الإيقاف الرسمية لدى OpenAI، لم يُدرج gpt-4o-mini نفسه حاليًا ضمن قائمة النماذج التي سيُوقف دعمها، بينما يملك إصدار الضبط الدقيق الخاص به ft-gpt-4o-mini جدولًا زمنيًا مختلفًا وأكثر تأخرًا. إذا كانت الأولوية لديك هي خفض التكلفة، فيمكنك الانتظار والمراقبة. لكن نظرًا إلى أن مؤشر الذكاء AA لنموذج gpt-4o-mini لا يتجاوز 7 نقاط، فإن إجراء مقارنة للأداء بين نماذج ضمن الفئة السعرية نفسها عبر منصة APIYI apiyi.com قد يتيح عادةً تحسينًا ملحوظًا في الجودة من دون زيادة الميزانية.
س3: بعد الترحيل إلى نموذج جديد، كيف أتأكد من أن الأداء لم يتراجع؟
لا تعتمد على الانطباع الشخصي وحده. يُنصح أولًا بتثبيت مجموعة من عينات الأعمال الحقيقية والتمثيلية، بدلًا من كتابة عدد قليل من حالات الاختبار العشوائية. بعد ذلك، اجعل gpt-4o-mini والنموذج المرشح يعالجان المدخلات نفسها، ثم قارن النتائج من ثلاثة جوانب: معدل الدقة، ومعدل الالتزام بالتنسيق، ومتوسط زمن الاستجابة. خلال مرحلة التبديل التدريجي، يمكنك توجيه نسبة صغيرة فقط من حركة المرور الفعلية إلى النموذج الجديد، ومراقبة أدائه لمدة أسبوع أو أسبوعين. وبعد التأكد من عدم وجود تراجع واضح في الجودة أو زمن الاستجابة، ارفع نسبة الحركة تدريجيًا حتى تشمل كامل الاستخدام.
الخلاصة والتوصيات لاتخاذ القرار
| بند التحقق | التوضيح |
|---|---|
| التأكد من نوع النشر | تختلف مواعيد إيقاف Azure Standard وProvisioned وGlobal Standard وData Zone Standard |
| التحقق من الأسعار الرسمية | قد تختلف الأسعار باختلاف المنطقة وفترات الذروة وخارجها؛ لذا يُرجع إلى الصفحة الرسمية |
| مقارنة مؤشر الذكاء AA | يُفضّل الرجوع أولًا إلى التصنيفات العامة الصادرة عن جهات مستقلة مثل Artificial Analysis، بدل الاكتفاء بالدعاية التي تقدمها الشركات |
| التبديل التدريجي | تحقّق من الأداء أولًا في المسارات غير الأساسية، ثم وسّع نسبة حركة المرور تدريجيًا |
| توحيد استدعاءات الواجهة | استخدم منصة وكيل API متوافقة مع تنسيق OpenAI SDK لتقليل تكلفة التبديل بين النماذج |
بوجه عام، لم تُوقف OpenAI نموذج gpt-4o-mini بالكامل عبر واجهة API الرسمية، لكن الجدول الزمني لإيقافه على Azure أصبح ضيقًا جدًا، كما أن تأخره في نتائج التقييمات حقيقة موضوعية. بالنسبة إلى معظم الاستخدامات، يُعد كل من Gemini 2.5 Flash-Lite وGPT-5 mini خيارين أساسيين، إذ يقترب سعرهما من سعره مع تحسن ملحوظ في الأداء. أما في الحالات شديدة الحساسية تجاه الميزانية، فيمكن أيضًا دراسة أسعار GPT-5 nano وDeepSeek V4 Flash خلال فترات الذروة وخارجها.
وتجدر الإشارة إلى أنه لا يُنصح بالتبديل المتسرع إلى نموذج آخر لمجرد أنه «أرخص» أو لأنك «سمعت أنه سيُوقف». فالسعر ونتائج التقييمات ليسا سوى الخطوة الأولى لتصفية قائمة النماذج المرشحة. أما العامل الحاسم في تحديد ما إذا كان ينبغي الترحيل وإلى أي نموذج، فهو الأداء الفعلي للنموذج على بيانات أعمالك الخاصة. إن تمديد فترة التقييم إلى أسبوع أو أسبوعين، مع تغطية عدد كافٍ من السيناريوهات الحقيقية، أكثر موثوقية من ملاحقة التغيرات في نتائج التصنيفات. وفي النهاية، يُوصى بإجراء اختبار مقارن باستخدام بيانات أعمال حقيقية عبر منصة APIYI apiyi.com، ثم اتخاذ قرار بشأن النموذج الذي ستنتقل إليه.
إذا واجهت مشكلة محددة أثناء عملية الترحيل، فنرحب بتواصلك عبر قناة الدعم الفني لدى APIYI apiyi.com. وسنواصل متابعة التغيرات في الأسعار الرسمية لنموذج gpt-4o-mini والبدائل المختلفة، مع تحديث بيانات هذه المقالة تباعًا.