“¿Está a punto de desaparecer gpt-4o-mini?” es una pregunta que se repite últimamente en las comunidades técnicas. El detonante directo son los anuncios de retirada de modelos publicados progresivamente por Azure OpenAI Service, junto con el descenso continuo de gpt-4o-mini en distintos rankings de rendimiento. Esto ha llevado a muchos equipos a reevaluar la selección de modelos para sus proyectos.
Este artículo se basa en la documentación oficial de OpenAI, los anuncios de retirada de Microsoft Learn y los datos de referencia de Artificial Analysis. Primero aclara la confusión informativa que rodea a los rumores sobre la desaparición de gpt-4o-mini y, después, compara en términos de precio y rendimiento 5 modelos alternativos de precio similar: GPT-5 mini, GPT-5 nano, Gemini 2.5 Flash-Lite, DeepSeek V4 Flash y Claude Haiku 4.5. El objetivo es ayudarte a decidir si necesitas migrar y qué modelo puede ofrecerte el mayor beneficio.
Valor principal: al terminar de leer, sabrás con claridad si gpt-4o-mini está experimentando una “retirada parcial” o si la situación se ha interpretado de forma exagerada. También sabrás qué modelo alternativo puede mejorar más los resultados sin aumentar significativamente el presupuesto.
Este tipo de confusión se ha extendido, en gran medida, porque los anuncios de retirada de Azure, la eliminación de modelos de la interfaz web de ChatGPT y las afirmaciones generales de la comunidad sobre que “OpenAI va a retirar los modelos antiguos” se han tratado como si fueran el mismo asunto. Falta una explicación clara que separe la situación por plataforma y tipo de implementación. A continuación, desglosaremos estas líneas temporales para evitar que migres precipitadamente por un rumor que todavía no ha entrado realmente en vigor, pero también para que no pases por alto una fecha de retirada de Azure que sí sea urgente.
Situación actual de gpt-4o-mini: solo 7 puntos en las evaluaciones, ¿son ciertos los rumores de retirada?
Empecemos por la conclusión: los rumores sobre la retirada de gpt-4o-mini mezclan información de forma evidente. Azure y la API oficial de OpenAI siguen calendarios completamente distintos, así que no se puede afirmar sin más que “gpt-4o-mini va a desaparecer”.
Precio y rendimiento actuales de gpt-4o-mini
| Métrica | Valor | Descripción |
|---|---|---|
| Precio de entrada | $0.15 / 1M tokens | Precio de la API oficial de OpenAI |
| Precio de entrada en caché | $0.075 / 1M tokens | El precio se reduce a la mitad cuando se utiliza la caché |
| Precio de salida | $0.60 / 1M tokens | Precio de la API oficial de OpenAI |
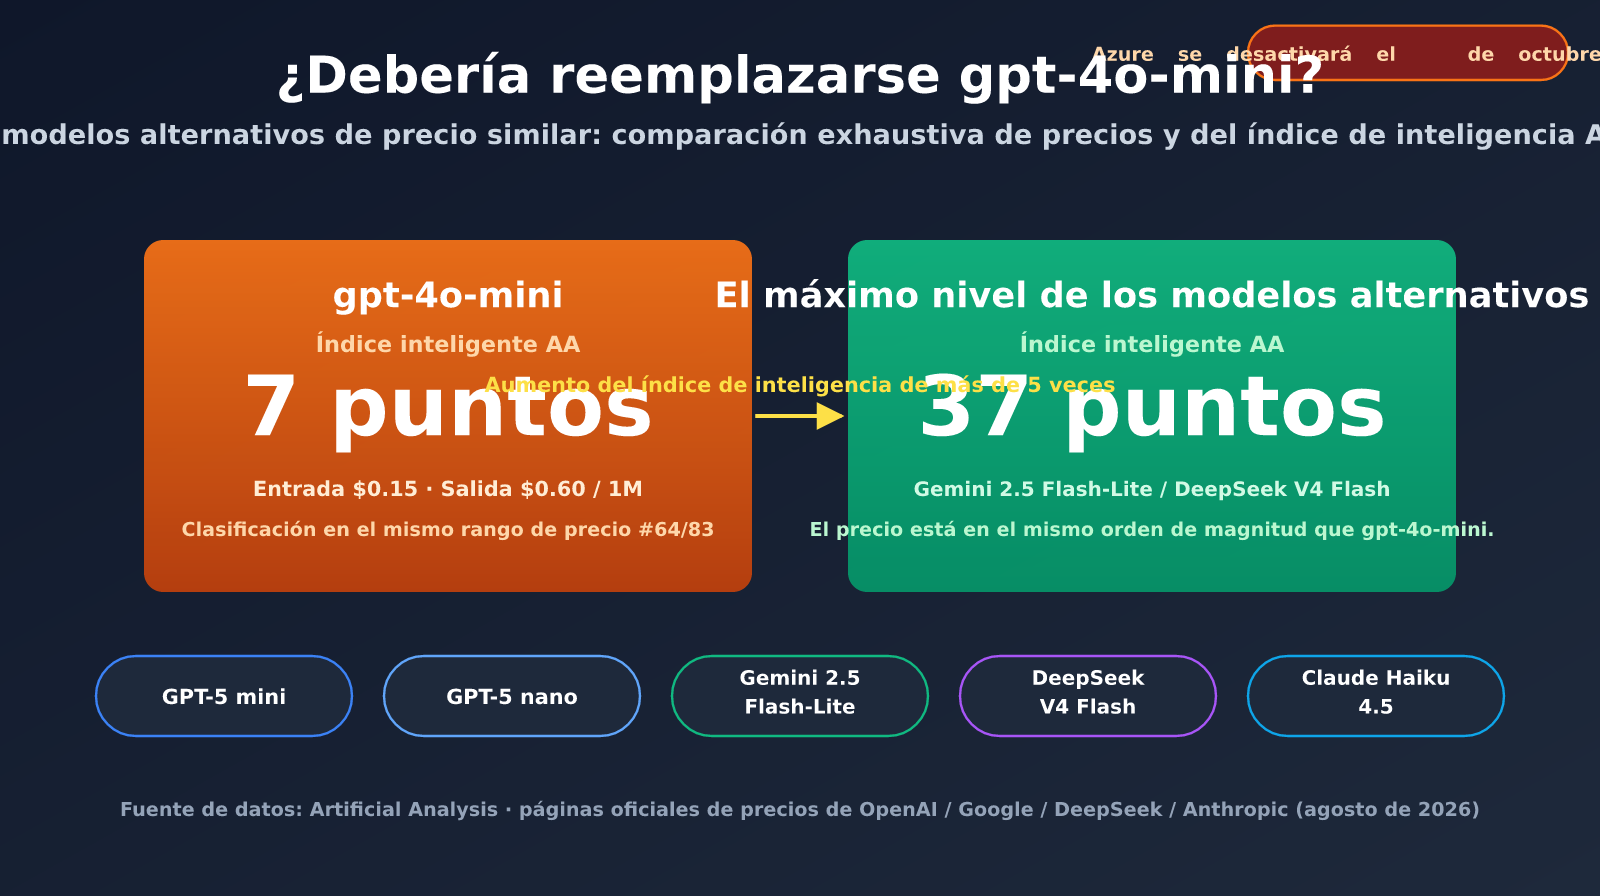
| Índice de inteligencia de AA | 7 puntos | Evaluación de Artificial Analysis; posición n.º 64/83 en el segmento de precio equivalente |
| Velocidad de salida | 100.9 tokens/s | Por debajo de la media de modelos similares: 102.1 tokens/s |
La razón principal por la que gpt-4o-mini se cuestiona tanto en 2026 no es que su precio haya cambiado, sino que su índice de inteligencia de Artificial Analysis es de apenas 7 puntos. Entre los 83 modelos del mismo segmento de precio, ocupa el puesto 64, claramente por debajo de la mediana de esa categoría. Dicho de otro modo, gpt-4o-mini sigue siendo barato, pero “barato” ya no significa necesariamente “rentable”: con el mismo presupuesto, ahora es posible acceder a modelos mucho más capaces.
Conviene aclarar el valor de referencia del índice de inteligencia de AA. Artificial Analysis lo calcula combinando y ponderando varias evaluaciones públicas que cubren dimensiones como razonamiento, programación y matemáticas. Su ventaja es que incluye muchos modelos y se actualiza con frecuencia, lo que permite comparar modelos de distintos proveedores con el mismo criterio. Su limitación es que refleja el nivel medio de capacidad general y no puede sustituir por completo las pruebas con los datos de tu propio negocio. Lo más prudente es utilizarlo como primer filtro para seleccionar candidatos, no como criterio definitivo de elección.
Calendario de retirada de gpt-4o-mini: Azure y la API de OpenAI son completamente distintos
| Plataforma / tipo de implementación | Estado | Fecha de retirada |
|---|---|---|
| API oficial de OpenAI (modelo gpt-4o-mini) | No se ha establecido una fecha de retirada | Por ahora, ninguna |
| Versión ajustada de OpenAI ft-gpt-4o-mini | Plan anunciado | El entrenamiento finalizará no antes del 2027-04-01; la implementación, el 2027-10-01 |
| Implementación Standard de Azure OpenAI | Ya retirada | 2026-03-31 |
| Implementaciones Provisioned / Global Standard / Data Zone Standard | Próximas a retirarse | 2026-10-01 |
Es importante aclarar que el 13 de febrero de 2026 OpenAI sí retiró GPT-4o, GPT-4.1, GPT-4.1 mini y o4-mini de la interfaz de producto de ChatGPT. Sin embargo, se trató de un cambio en el selector de modelos de la versión web de ChatGPT. El anuncio oficial especificó claramente que no había cambios en la API y, además, gpt-4o-mini no formaba parte de esa lista de modelos retirados. El calendario que realmente requiere atención es el de Azure: la implementación Standard de gpt-4o-mini en Azure OpenAI se retiró el 31 de marzo de 2026, mientras que las implementaciones Provisioned, Global Standard y Data Zone Standard dejarán de prestar servicio el 1 de octubre de 2026. Quedan menos de dos meses y, a partir de esa fecha, las invocaciones devolverán directamente un error 410 Gone. Si tu negocio funciona sobre Azure, este calendario merece prioridad frente a la pregunta general de si “OpenAI va a retirar el modelo”.
Otro detalle que suele pasarse por alto es que, incluso con el mismo nombre de “gpt-4o-mini”, las distintas modalidades de implementación en Azure —Standard, Provisioned, Global Standard y Data Zone Standard— no tienen la misma fecha de retirada. Los equipos que las utilizan de forma combinada pueden interpretar mal el calendario general si solo consultan el anuncio correspondiente a uno de los tipos de implementación. Antes de investigar el asunto, te recomendamos confirmar en el portal de Azure qué modalidad utilizas exactamente y comprobar después cada fecha en la tabla anterior. Así evitarás la discrepancia entre “he oído que lo van a retirar” y “cuánto tiempo seguirá disponible realmente”.
gpt-4o-mini frente a 5 modelos alternativos: comparación completa de precios y puntuaciones
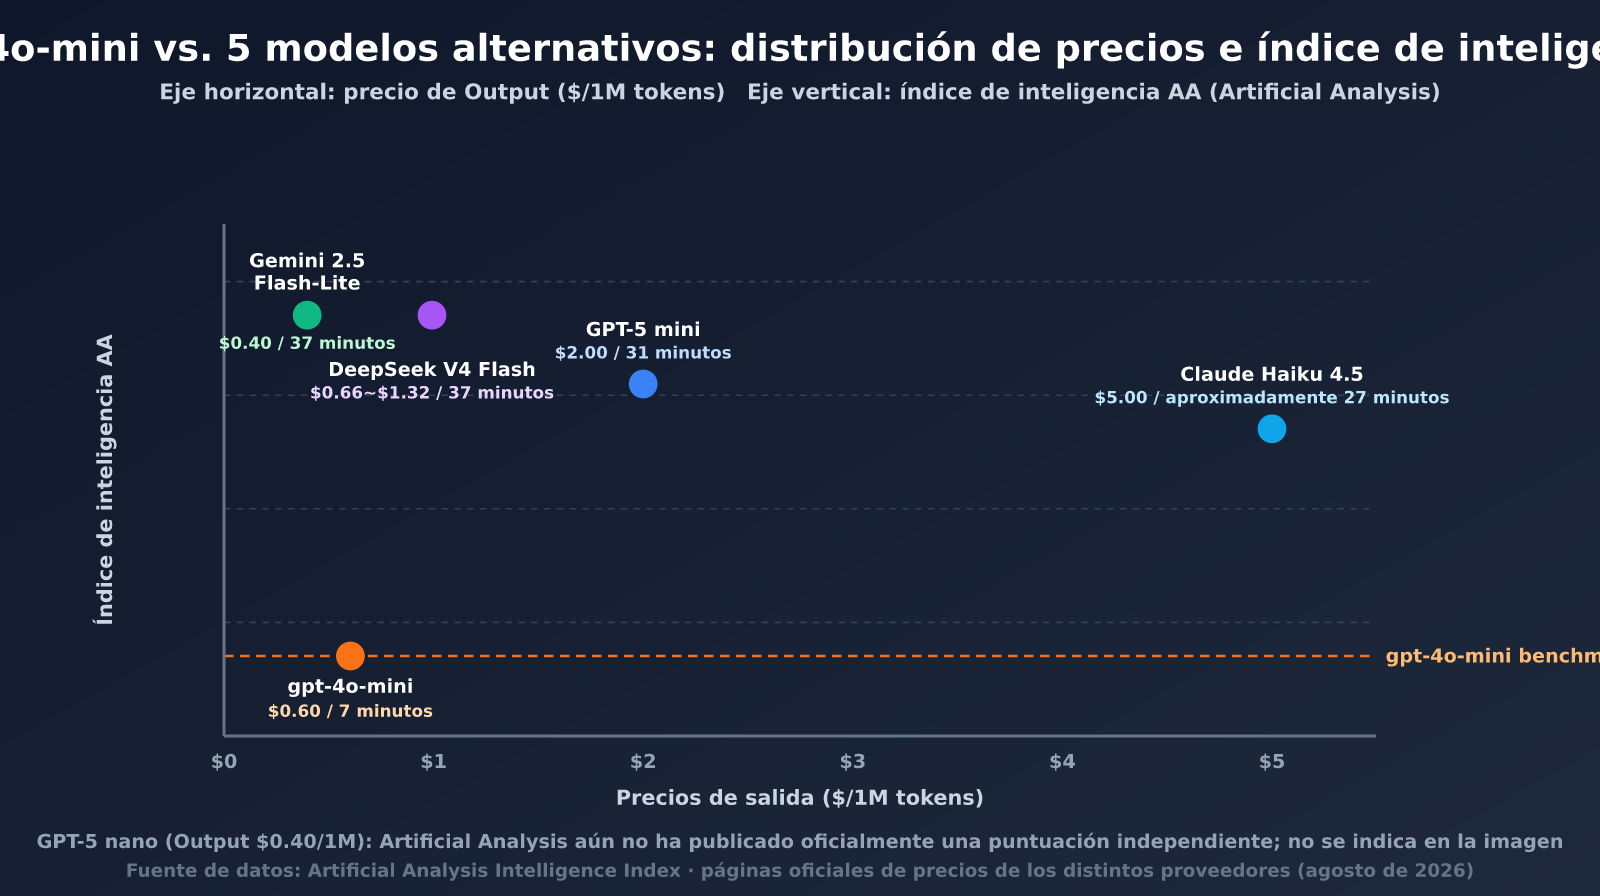
Si estás evaluando una estrategia de migración, la siguiente tabla resume 5 modelos alternativos con precios cercanos a gpt-4o-mini y datos oficiales o de terceros reconocidos, para que puedas filtrar rápidamente según tu presupuesto y tus necesidades de rendimiento.
| Modelo | Input / Output ($/1M) | Índice de inteligencia de AA | Ventaja principal |
|---|---|---|---|
| gpt-4o-mini (referencia) | $0.15 / $0.60 | 7 puntos (#64/83) | Ecosistema maduro y buena compatibilidad |
| GPT-5 nano | $0.05 / $0.40 | La puntuación no se ha publicado oficialmente por separado | La opción de menor costo de la misma familia |
| GPT-5 mini | $0.25 / $2.00 | 31 puntos (nivel de razonamiento medium) | El reemplazo oficial más directo dentro del ecosistema de OpenAI |
| Gemini 2.5 Flash-Lite | $0.10 / $0.40 | 37 puntos | Precio cercano al de gpt-4o-mini, con una mejora notable en el índice de inteligencia |
| DeepSeek V4 Flash | $0.22~$0.44 / $0.66~$1.32 (precios punta-valle) | 37 puntos (alta intensidad de razonamiento) | Precios según la franja horaria; con caché, el costo mínimo puede llegar a $0.007/1M |
| Claude Haiku 4.5 | $1.00 / $5.00 | Aproximadamente 24~30 puntos (según el nivel de razonamiento) | Mayor solidez con contextos largos y llamadas a herramientas |
🎯 Recomendación técnica: para la selección final, recomendamos probar mediante APIYI apiyi.com las interfaces de todos los modelos anteriores. La plataforma ofrece una API unificada compatible con gpt-4o-mini, la serie GPT-5, Gemini, DeepSeek y Claude, lo que facilita cambiar rápidamente de modelo y comparar resultados usando el mismo código.
Además de estos 5 modelos, Qwen3.5 Flash de Alibaba Cloud también es una opción con un rango de precios similar. Los canales de comparación de terceros sitúan su precio cerca de $0.10 / $0.40, pero como no se ha confirmado directamente en la página oficial de precios de DashScope, conviene consultar el precio mostrado en la consola oficial antes de realizar una migración formal, para evitar diferencias derivadas de la región o del tipo de cambio. Del mismo modo, actualmente no se ha encontrado una puntuación independiente de GPT-5 nano publicada por OpenAI o Artificial Analysis. Por eso se marca honestamente como «no publicada», en lugar de inventar una cifra.
En conjunto, Gemini 2.5 Flash-Lite es la opción que más merece la pena probar primero: su precio es solo ligeramente superior al de gpt-4o-mini, pero su índice de inteligencia de AA pasa de 7 a 37 puntos, lo que representa la mejora de relación calidad-precio más clara dentro de este rango. Si priorizas la compatibilidad con el ecosistema de OpenAI, GPT-5 mini cuesta más del doble que gpt-4o-mini, pero también ofrece una mejora de rendimiento considerable. En escenarios con una sensibilidad extrema al presupuesto, puedes considerar GPT-5 nano y las tarifas de DeepSeek V4 Flash fuera de las horas punta.
El mecanismo de precios de DeepSeek V4 Flash merece una explicación aparte: utiliza dos tarifas, una para horas punta y otra para horas valle. En las horas valle, el costo de Input/Output es de solo $0.22/$0.66, mientras que en las horas punta sube a $0.44/$1.32. Si se produce un acierto de caché, el costo puede reducirse aún más, hasta $0.007~$0.014 por millón de tokens. Para tareas offline que puedan ejecutarse fuera de las horas punta, como resumir grandes volúmenes de contenido o analizar registros durante la noche, este esquema suele ser más rentable que los modelos con tarifa fija. Sin embargo, si tu negocio depende de solicitudes en tiempo real durante las horas de mayor demanda, tendrás que recalcular el costo usando la tarifa punta. Claude Haiku 4.5 sigue una estrategia diferente: su precio unitario es claramente superior al de gpt-4o-mini, pero ofrece mayor estabilidad con ventanas de contexto largas y mejores capacidades de llamada a herramientas. Por eso encaja mejor en escenarios que requieren procesar documentos extensos y coordinar herramientas en varias rondas, en lugar de limitarse a sustituir respuestas breves.
Recomendaciones por escenario: qué modelo elegir según tus necesidades
| Escenario de uso | Modelo recomendado | Motivo |
|---|---|---|
| Atención al cliente con alta concurrencia / bot de preguntas frecuentes | Gemini 2.5 Flash-Lite | Precio similar al de gpt-4o-mini, con un índice de inteligencia más de 5 veces superior |
| Razonamiento complejo / tareas de Agent con varios pasos | GPT-5 mini | Mejor compatibilidad con el ecosistema de OpenAI y capacidades de razonamiento claramente superiores a gpt-4o-mini |
| Procesamiento masivo de muy bajo costo (etiquetado de contenido, resúmenes) | GPT-5 nano / DeepSeek V4 Flash en horas de baja demanda | El precio unitario puede ser aproximadamente un tercio del de gpt-4o-mini |
| Análisis de documentos extensos / contextos largos | Claude Haiku 4.5 | Ofrece mayor estabilidad con contextos largos y mejores capacidades de invocación de herramientas |
| Validación de prototipos con presupuesto extremadamente limitado | DeepSeek V4 Flash en escenarios con aciertos de caché | Con aciertos de caché, el precio puede reducirse a niveles muy bajos |
💡 Recomendación de elección: el modelo adecuado depende principalmente de tu escenario de uso concreto y de los requisitos de calidad. Te recomendamos realizar pruebas reales a través de la plataforma de APIYI apiyi.com y comparar, con el mismo presupuesto, el rendimiento de los distintos modelos con datos reales de tu negocio, en lugar de tomar decisiones basadas únicamente en las puntuaciones públicas.
Ten en cuenta que la tabla anterior muestra una “recomendación predeterminada”. La elección real también debe considerar la longitud del contexto, el nivel de concurrencia y los requisitos de latencia. Por ejemplo, en un escenario de atención al cliente, si el historial de conversación es muy largo y es necesario consultar con frecuencia el contexto anterior, la ventaja de relación calidad-precio de Gemini 2.5 Flash-Lite podría reducirse parcialmente debido al mayor consumo de la indicación. En ese caso, también conviene incluir Claude Haiku 4.5 en una prueba comparativa. Del mismo modo, si una tarea compleja de Agent exige una latencia de respuesta muy baja, deberías medir el tiempo total de GPT-5 mini en tu cadena de herramientas concreta, en lugar de fijarte únicamente en la puntuación oficial del índice de inteligencia.
Migración rápida: cambiar de gpt-4o-mini a un modelo alternativo solo requiere dos pasos
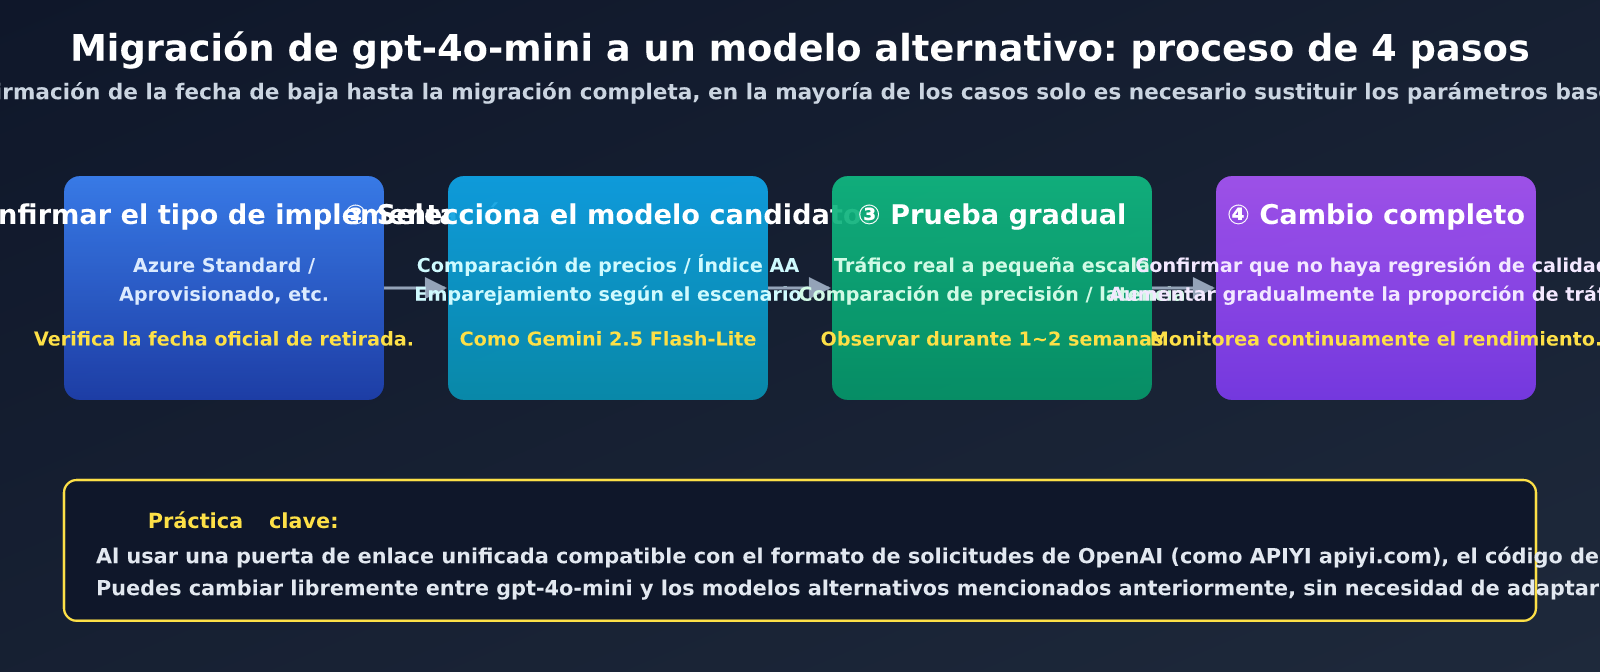
La mayoría de las migraciones solo requieren modificar los parámetros base_url y model. Si originalmente utilizabas el SDK de OpenAI o un cliente compatible con su formato, no necesitas reescribir ninguna lógica de negocio.
La verdadera dificultad normalmente no está en el código, sino en que las interfaces nativas de cada proveedor no son completamente iguales en cuanto al formato de los mensajes, los campos de invocación de herramientas y las estrategias de limitación de velocidad. Cambiar directamente al SDK nativo de Gemini o Claude suele exigir reescribir la lógica del cuerpo de la solicitud y del análisis de la respuesta. Una pasarela unificada compatible con el formato de solicitudes de OpenAI puede ocultar estas diferencias y permitir que el código de negocio mantenga una única forma de invocación. Por eso, en el ejemplo siguiente model se convierte en un parámetro configurable, en lugar de escribir un cliente independiente para cada proveedor.
Ejemplo mínimo
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI统一接口,一次接入可切换多家模型
)

response = client.chat.completions.create(
    model="gemini-2.5-flash-lite",  # 从 gpt-4o-mini 切换到替代模型
    messages=[{"role": "user", "content": "Hello!"}]
)
print(response.choices[0].message.content)
Ver el código completo de migración (incluye selector de modelo y reintentos ante errores)
import openai
import os

MODEL_MAP = {
    "baseline": "gpt-4o-mini",
    "openai-upgrade": "gpt-5-mini",
    "budget": "gpt-5-nano",
    "gemini": "gemini-2.5-flash-lite",
    "deepseek": "deepseek-v4-flash",
    "claude": "claude-haiku-4-5",
}

client = openai.OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"  # APIYI统一接口,兼容 OpenAI SDK 调用格式
)

def call_model(prompt: str, profile: str = "gemini", max_retries: int = 2):
    model = MODEL_MAP[profile]
    for attempt in range(max_retries + 1):
        try:
            response = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
                timeout=30,
            )
            return response.choices[0].message.content
        except Exception:
            if attempt == max_retries:
                raise
    return None

if __name__ == "__main__":
    print(call_model("总结一下 gpt-4o-mini 的下线时间表", profile="gemini"))
🚀 Empieza rápido: te recomendamos utilizar la plataforma de APIYI apiyi.com para realizar pruebas comparativas antes de la migración. La plataforma ofrece facturación unificada para varios modelos, por lo que no necesitas solicitar una clave API ni una cuenta independiente para cada modelo nuevo. En pocos minutos puedes probar todos los modelos candidatos de la tabla anterior.
Preguntas frecuentes
Q1: Actualmente uso gpt-4o-mini en Azure OpenAI. ¿Cuánto tiempo más podré seguir utilizándolo?
Depende del tipo de implementación. Si es una implementación Standard, se retiró el 31 de marzo de 2026 y, a estas alturas, probablemente ya no se pueda invocar. Si es una implementación Provisioned, Global Standard o Data Zone Standard, la fecha de retirada es el 1 de octubre de 2026, por lo que quedan menos de dos meses. Se recomienda completar cuanto antes las pruebas de migración mediante plataformas compatibles con el cambio entre varios modelos, como APIYI apiyi.com, para evitar interrupciones del servicio cuando llegue la fecha límite.
Q2: Utilizo la API oficial de OpenAI. ¿También tengo que migrar de inmediato?
No es obligatorio. Según la página oficial de obsolescencias de OpenAI, el modelo gpt-4o-mini como tal no figura actualmente en la lista de modelos retirados; solo su versión ajustada, ft-gpt-4o-mini, tiene un calendario posterior. Si das prioridad a los costos, puedes seguir observando la situación. Sin embargo, dado que el índice de inteligencia AA de gpt-4o-mini es de solo 7 puntos, comparar mediante la plataforma de APIYI apiyi.com el rendimiento de modelos con un precio similar suele permitir obtener una mejora notable de calidad sin aumentar el presupuesto.
Q3: Después de migrar a un modelo nuevo, ¿cómo puedo confirmar que el rendimiento no ha empeorado?
No conviene basarse únicamente en impresiones subjetivas. Lo recomendable es fijar primero un conjunto representativo de muestras reales del negocio, en lugar de escribir unas pocas pruebas improvisadas. Después, ejecuta las mismas entradas con gpt-4o-mini y con los modelos candidatos, y compara los resultados en tres dimensiones: precisión, cumplimiento del formato y tiempo medio de respuesta. Durante la fase de migración gradual, puedes asignar al modelo nuevo solo una pequeña parte del tráfico real y observar su comportamiento en producción durante una o dos semanas. Si no se detectan retrocesos claros en calidad o latencia, aumenta progresivamente su proporción de tráfico hasta cubrirlo por completo.
Resumen y recomendaciones para la toma de decisiones
| Elemento de comprobación | Descripción |
|---|---|
| Confirmar el tipo de implementación | Azure Standard, Provisioned, Global Standard y Data Zone Standard tienen fechas de retirada distintas |
| Verificar los precios oficiales | Los precios pueden variar según la región y las franjas de mayor o menor demanda; toma como referencia la página oficial |
| Comparar el índice de inteligencia AA | Da prioridad a clasificaciones públicas de terceros, como Artificial Analysis, y evita fijarte únicamente en la promoción de los proveedores |
| Migración gradual | Verifica primero el rendimiento en flujos no críticos y amplía después progresivamente la proporción de tráfico |
| Unificar las invocaciones mediante una interfaz común | Utiliza un servicio proxy de API compatible con el formato del SDK de OpenAI para reducir el costo de cambiar entre varios modelos |
En conjunto, gpt-4o-mini no ha sido retirado por completo de la API oficial de OpenAI, pero el calendario de retirada en Azure es ya muy ajustado, y su desventaja en las pruebas de rendimiento también es un hecho objetivo. Para la mayoría de los casos de uso, Gemini 2.5 Flash-Lite y GPT-5 mini son dos opciones prioritarias con un precio similar y una mejora de rendimiento clara. En escenarios extremadamente sensibles al presupuesto, también puedes considerar GPT-5 nano y los precios de DeepSeek V4 Flash en periodos de alta y baja demanda.
También conviene recordar que no es recomendable cambiar de modelo de forma precipitada solo porque sea «más barato» o porque «se rumorea que va a retirarse». El precio y las puntuaciones de las pruebas sirven únicamente para crear una lista inicial de candidatos. Lo que realmente determina si debes migrar y a qué modelo hacerlo es su rendimiento medido con los datos de tu propio negocio. Ampliar el periodo de evaluación a una o dos semanas y cubrir suficientes escenarios reales es más fiable que perseguir las variaciones de las puntuaciones en las clasificaciones. Como paso final, se recomienda realizar una prueba comparativa con datos reales del negocio mediante la plataforma de APIYI apiyi.com antes de decidir a qué modelo migrar.
Si encuentras algún problema concreto durante la migración, puedes ponerte en contacto con el canal de soporte técnico de APIYI apiyi.com. Seguiremos realizando un seguimiento de los cambios en los precios oficiales de gpt-4o-mini y de sus modelos alternativos, y actualizaremos los datos de este artículo.