„Wird gpt-4o-mini bald eingestellt?“ Diese Frage taucht in den letzten Monaten immer wieder in technischen Communities auf. Der unmittelbare Auslöser sind die nach und nach veröffentlichten Abkündigungen von Azure OpenAI Service. Gleichzeitig fällt gpt-4o-mini in verschiedenen Benchmark-Ranglisten immer weiter zurück, weshalb viele Teams ihre Modellauswahl neu bewerten.
Dieser Artikel stützt sich auf die offiziellen OpenAI-Dokumente, die Abkündigungsmitteilungen von Microsoft Learn sowie maßgebliche Benchmark-Daten von Artificial Analysis. Zunächst klären wir die Informationsverwirrung rund um die angebliche Einstellung von gpt-4o-mini. Anschließend vergleichen wir unter den Gesichtspunkten Preis und Leistung fünf preislich ähnliche Alternativen: GPT-5 mini, GPT-5 nano, Gemini 2.5 Flash-Lite, DeepSeek V4 Flash und Claude Haiku 4.5. So kannst du besser einschätzen, ob eine Migration notwendig ist und welches Modell den größten Mehrwert bietet.
Der zentrale Mehrwert: Nach der Lektüre weißt du genau, ob gpt-4o-mini tatsächlich „teilweise eingestellt“ wird oder ob die Meldungen überinterpretiert wurden. Außerdem erfährst du, welches alternative Modell bei nahezu unverändertem Budget den deutlichsten Leistungszuwachs bieten kann.
Solche Missverständnisse verbreiten sich vor allem deshalb so stark, weil die Abkündigungsmitteilungen von Azure, die Entfernung von Modellen aus der ChatGPT-Weboberfläche und die pauschale Aussage „OpenAI schafft alte Modelle ab“ in einen Topf geworfen werden. Was fehlt, ist eine klare Aufschlüsselung nach Plattform und Bereitstellungsart. Im Folgenden trennen wir diese Zeitlinien voneinander. So vermeidest du sowohl eine überhastete Migration aufgrund eines noch nicht wirksamen Gerüchts als auch das Übersehen eines tatsächlich dringenden Azure-Abkündigungstermins.
Aktueller Stand von gpt-4o-mini: Nur 7 Punkte im Benchmark – stimmt das Gerücht über die Einstellung?
Zuerst das Fazit: Das Gerücht über die Einstellung von gpt-4o-mini beruht auf einer deutlichen Vermischung verschiedener Informationen. Azure und die offizielle OpenAI-API folgen zwei völlig unterschiedlichen Zeitplänen. Daher kann man nicht pauschal sagen, dass „gpt-4o-mini eingestellt wird“.
Aktuelle Preise und Leistung von gpt-4o-mini
| Kennzahl | Wert | Beschreibung |
|---|---|---|
| Input-Preis | 0,15 $ / 1 Mio. Tokens | Preis der offiziellen OpenAI-API |
| Preis für zwischengespeicherte Eingaben | 0,075 $ / 1 Mio. Tokens | Bei einem Cache-Treffer halbiert sich der Preis |
| Output-Preis | 0,60 $ / 1 Mio. Tokens | Preis der offiziellen OpenAI-API |
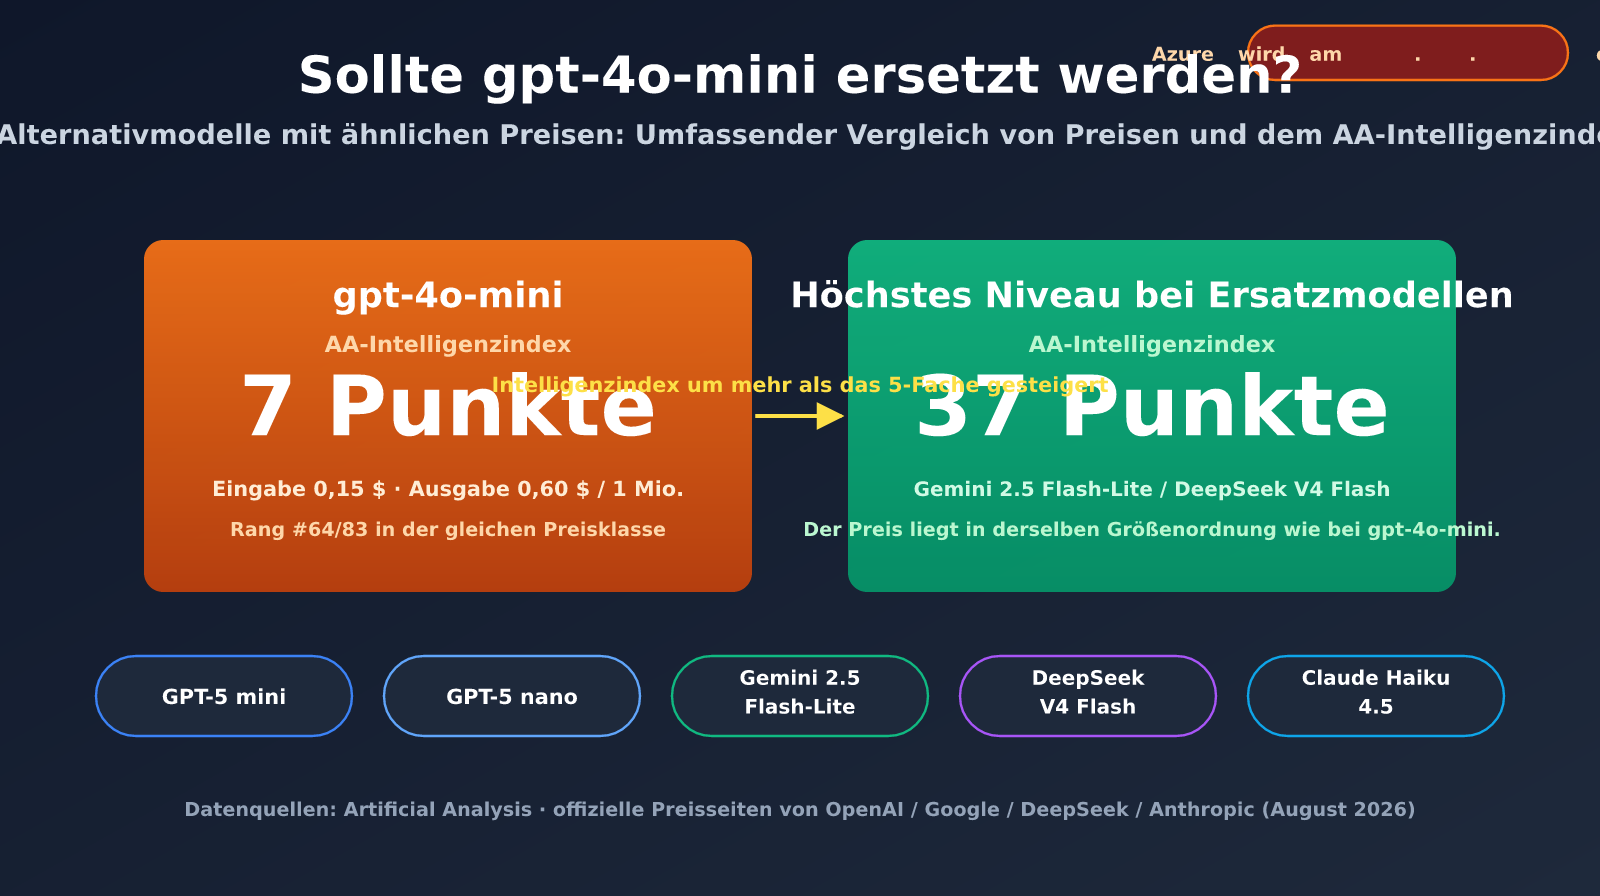
| AA-Intelligenzindex | 7 Punkte | Bewertung von Artificial Analysis, Rang #64/83 in der Preisklasse |
| Ausgabegeschwindigkeit | 100,9 Tokens/s | Unter dem Durchschnitt vergleichbarer Modelle von 102,1 Tokens/s |
Der Hauptgrund, warum gpt-4o-mini im Jahr 2026 so häufig infrage gestellt wird, liegt nicht in einer Preisänderung. Entscheidend ist vielmehr, dass das Modell im Intelligenzindex von Artificial Analysis nur 7 Punkte erreicht. Unter 83 Modellen derselben Preisklasse belegt es damit Platz 64 und liegt deutlich unter dem Median dieser Kategorie. Anders gesagt: gpt-4o-mini ist weiterhin günstig, aber „günstig“ bedeutet nicht mehr automatisch „preiswert“. Für dasselbe Budget sind inzwischen deutlich leistungsfähigere Modelle verfügbar.
Zur Einordnung des AA-Intelligenzindex: Artificial Analysis berechnet ihn auf Basis mehrerer öffentlicher Benchmarks, die unter anderem Schlussfolgerungs-, Programmier- und Mathematikfähigkeiten abdecken. Der Vorteil ist die große Modellabdeckung und die hohe Aktualisierungsfrequenz. Dadurch lassen sich Modelle verschiedener Anbieter anhand derselben Skala vergleichen. Die Einschränkung: Der Index bildet die durchschnittlichen Fähigkeiten für allgemeine Aufgaben ab und kann eigene Tests mit deinen Geschäftsdaten nicht vollständig ersetzen. Am sinnvollsten ist es daher, ihn als erste Vorauswahl und nicht als endgültige Entscheidungsgrundlage zu verwenden.
Zeitplan für die Einstellung von gpt-4o-mini: Azure und OpenAI-API sind völlig unterschiedlich
| Plattform / Bereitstellungsart | Status | Einstellungstermin |
|---|---|---|
| Offizielle OpenAI-API (gpt-4o-mini selbst) | Kein Einstellungstermin festgelegt | Noch keiner |
| OpenAI-Finetuning-Version ft-gpt-4o-mini | Plan veröffentlicht | Trainingsende frühestens am 01.04.2027, Ende der Bereitstellung am 01.10.2027 |
| Azure OpenAI Standard-Bereitstellung | Bereits eingestellt | 31.03.2026 |
| Azure Provisioned / Global Standard / Data Zone Standard | Wird eingestellt | 01.10.2026 |
Wichtig ist insbesondere folgende Klarstellung: Am 13. Februar 2026 entfernte OpenAI GPT-4o, GPT-4.1, GPT-4.1 mini und o4-mini tatsächlich aus der Modellauswahl der ChatGPT-Oberfläche. Dabei handelte es sich jedoch um eine Anpassung des Modellauswahlmenüs in der ChatGPT-Webanwendung. In der offiziellen Mitteilung wurde ausdrücklich erklärt, dass sich an der API nichts ändert. Außerdem war gpt-4o-mini selbst nicht Teil dieser Liste.
Die wirklich relevante Zeitplanung betrifft Azure: Die Standard-Bereitstellung von gpt-4o-mini in Azure OpenAI wurde am 31. März 2026 eingestellt. Die Bereitstellungsarten Provisioned, Global Standard und Data Zone Standard werden am 1. Oktober 2026 ebenfalls vollständig eingestellt. Bis dahin verbleiben weniger als zwei Monate; danach liefern Aufrufe direkt den Fehler 410 Gone zurück. Wenn deine Anwendung auf Azure läuft, solltest du diesen Zeitplan deutlich höher priorisieren als die Frage, ob OpenAI das Modell allgemein einstellt.
Ein weiteres leicht zu übersehendes Detail: Selbst wenn der Modellname „gpt-4o-mini“ identisch ist, gelten für die verschiedenen Bereitstellungsarten bei Azure – Standard, Provisioned, Global Standard und Data Zone Standard – unterschiedliche Einstellungstermine. Teams, die mehrere Bereitstellungsarten verwenden, können leicht zu falschen Schlussfolgerungen kommen, wenn sie nur die Mitteilung zu einer einzigen Variante prüfen. Kläre daher zuerst im Azure-Portal, welche Bereitstellungsart du tatsächlich nutzt, und gleiche sie anschließend einzeln mit der obigen Tabelle ab. So vermeidest du eine Diskrepanz zwischen „angeblich wird es eingestellt“ und „wie lange ist es tatsächlich noch verfügbar?“.
gpt-4o-mini vs. 5 alternative Modelle: Preis- und Benchmark-Vergleich
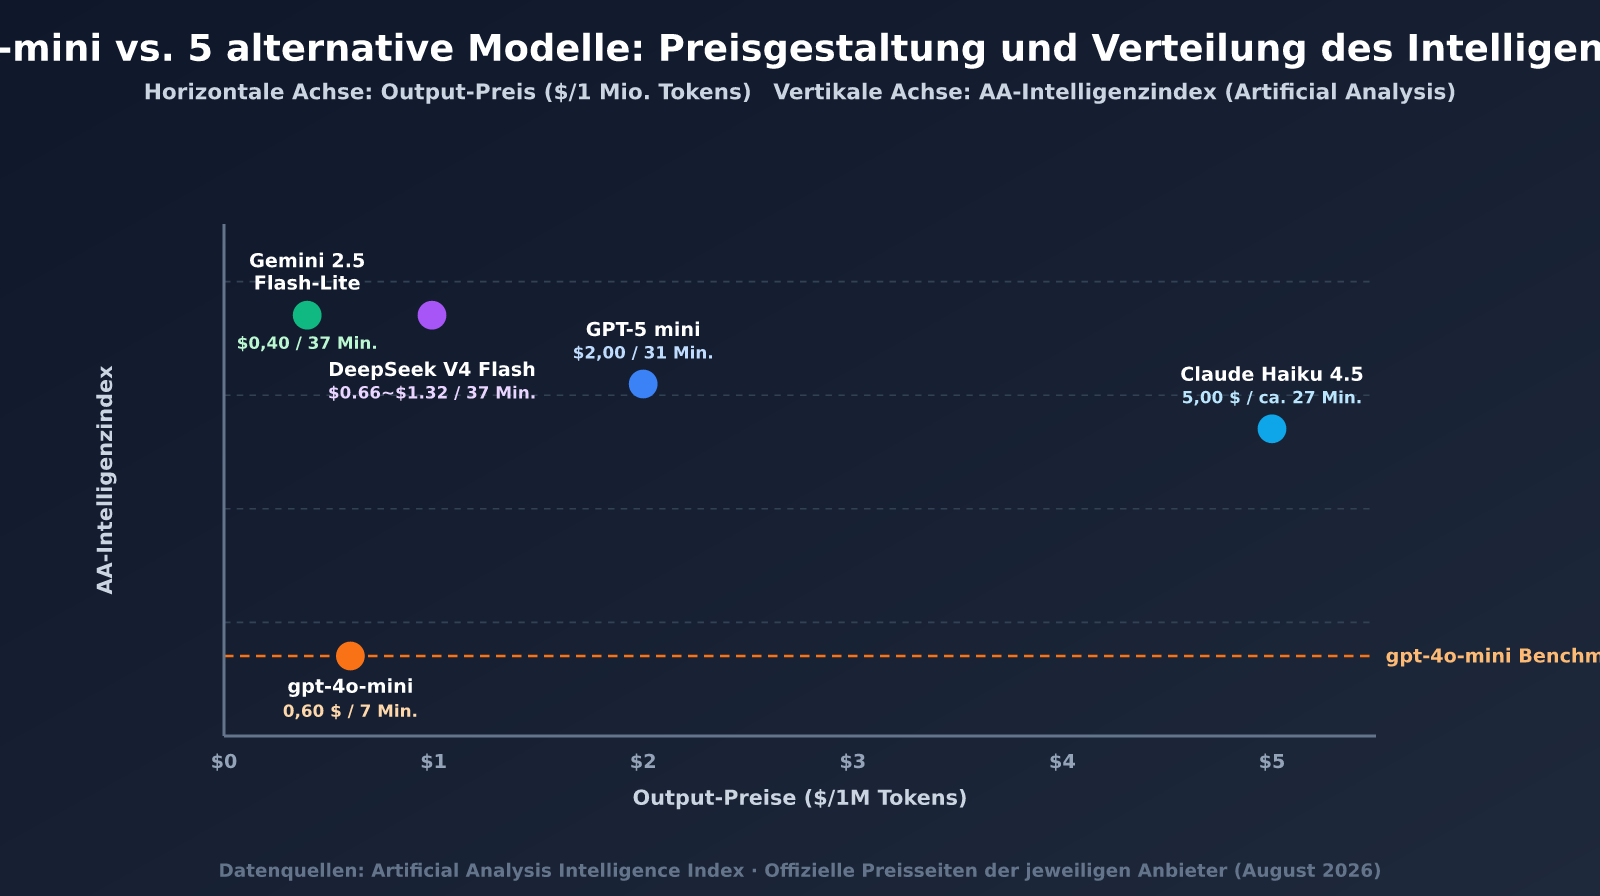
Wenn Sie eine Migration evaluieren, fasst die folgende Vergleichstabelle fünf Alternativmodelle zusammen, deren Preise nahe am gpt-4o-mini liegen und für die offizielle oder fundierte Daten von Drittanbietern verfügbar sind. So können Sie schnell nach Budget und Leistungsanforderungen auswählen.
| Modell | Input / Output ($/1M) | AA-Intelligenzindex | Hauptvorteil |
|---|---|---|---|
| gpt-4o-mini (Basis) | $0.15 / $0.60 | 7 Punkte (#64/83) | Ausgereiftes Ökosystem, gute Kompatibilität |
| GPT-5 nano | $0.05 / $0.40 | Offiziell kein separater Benchmark veröffentlicht | Kostengünstigste Option innerhalb der Modellfamilie |
| GPT-5 mini | $0.25 / $2.00 | 31 Punkte (Reasoning-Stufe „medium“) | Direkteste offizielle Alternative innerhalb des OpenAI-Ökosystems |
| Gemini 2.5 Flash-Lite | $0.10 / $0.40 | 37 Punkte | Preis nahe am gpt-4o-mini, deutliche Verbesserung beim Intelligenzindex |
| DeepSeek V4 Flash | $0.22–$0.44 / $0.66–$1.32 (Neben-/Hauptzeiten) | 37 Punkte (hohe Reasoning-Intensität) | Zeitabhängige Preise, bei Cache-Treffern bis zu $0.007/1M |
| Claude Haiku 4.5 | $1.00 / $5.00 | etwa 24–30 Punkte (je nach Reasoning-Stufe) | Stärker bei langem Kontext und Tool-Aufrufen |
🎯 Technischer Tipp: Für die praktische Auswahl empfehlen wir, die genannten Modelle über die Plattform APIYI apiyi.com einzeln per API zu testen. Die Plattform unterstützt über eine einheitliche API-Schnittstelle gleichzeitig Modellaufrufe mit gpt-4o-mini, der GPT-5-Serie, Gemini, DeepSeek und Claude. So lassen sich Modelle schnell innerhalb desselben Codes vergleichen und austauschen.
Neben diesen fünf Modellen ist auch Qwen3.5 Flash von Alibaba Cloud eine preislich ähnliche Option. Vergleichsportale von Drittanbietern nennen Preise von etwa $0.10 / $0.40. Da diese Angaben jedoch nicht direkt auf der offiziellen DashScope-Preisseite bestätigt wurden, sollten Sie sich vor einer formellen Migration an den Preisen in der offiziellen Konsole orientieren. So vermeiden Sie Abweichungen aufgrund regionaler Unterschiede oder Wechselkurse. Auch für GPT-5 nano konnten bisher keine unabhängigen Benchmarks von OpenAI oder Artificial Analysis gefunden werden. Daher wird das Ergebnis hier korrekt als „nicht veröffentlicht“ angegeben, anstatt eine erfundene Zahl zu nennen.
Insgesamt ist Gemini 2.5 Flash-Lite die Option, die Sie zuerst testen sollten: Der Preis liegt nur geringfügig über dem des gpt-4o-mini, während der AA-Intelligenzindex von 7 auf 37 Punkte steigt. Damit bietet dieses Modell im vergleichbaren Preisbereich die deutlichste Verbesserung beim Preis-Leistungs-Verhältnis. Wenn Ihnen die Kompatibilität mit dem OpenAI-Ökosystem wichtiger ist, ist GPT-5 mini zwar mehr als doppelt so teuer wie gpt-4o-mini, bietet dafür aber ebenfalls einen deutlichen Leistungszuwachs. Bei äußerst knappem Budget kommen GPT-5 nano und die Preise von DeepSeek V4 Flash außerhalb der Hauptzeiten infrage.
Die Preisstruktur von DeepSeek V4 Flash verdient eine gesonderte Betrachtung: Es gibt zwei Preisstufen für Neben- und Hauptzeiten. Außerhalb der Hauptzeiten kostet Input/Output nur $0.22/$0.66, während die Preise in den Hauptzeiten auf $0.44/$1.32 steigen. Bei einem Cache-Treffer können die Kosten zusätzlich auf $0.007–$0.014 pro eine Million Token sinken. Für Offline-Aufgaben, die sich außerhalb der Hauptzeiten ausführen lassen, etwa nächtliche Stapelverarbeitung für Zusammenfassungen oder Loganalysen, ist dieses Modell oft günstiger als Modelle mit einem festen Einheitspreis. Bei Echtzeitanfragen während der Tageshauptzeiten müssen Sie die Kosten allerdings anhand der höheren Preise neu kalkulieren. Claude Haiku 4.5 verfolgt dagegen einen anderen Ansatz: Der Einheitspreis liegt deutlich über dem des gpt-4o-mini, dafür bietet das Modell eine höhere Stabilität bei langen Kontexten und leistungsfähigere Tool-Aufrufe. Es eignet sich daher besser für die Verarbeitung langer Dokumente und mehrstufige Tool-Orchestrierung als für den einfachen Ersatz bei kurzen Frage-Antwort-Szenarien.
Szenarioempfehlungen: Welches Modell eignet sich für welchen Bedarf?
| Anwendungsszenario | Empfohlenes Modell | Begründung |
|---|---|---|
| Kundenservice mit hoher Parallelität / FAQ-Bot | Gemini 2.5 Flash-Lite | Preislich auf dem Niveau von gpt-4o-mini, bei einem um mehr als das Fünffache höheren Intelligenzindex |
| Komplexes Schlussfolgern / mehrstufige Agent-Aufgaben | GPT-5 mini | Beste Kompatibilität mit dem OpenAI-Ökosystem, deutlich bessere Schlussfolgerungsfähigkeiten als gpt-4o-mini |
| Besonders kostengünstige Stapelverarbeitung (Inhalts-Tagging, Zusammenfassungen) | GPT-5 nano / DeepSeek V4 Flash außerhalb der Spitzenzeiten | Der Einzelpreis kann auf etwa ein Drittel von gpt-4o-mini sinken |
| Analyse langer Dokumente / langer Kontexte | Claude Haiku 4.5 | Stabilität bei langen Kontexten und Fähigkeiten für Tool-Aufrufe sind besonders ausgeprägt |
| Prototypvalidierung mit extrem knappem Budget | DeepSeek V4 Flash bei Cache-Treffern | Bei Cache-Treffern lässt sich der Preis auf ein äußerst niedriges Niveau drücken |
💡 Auswahlempfehlung: Welches Modell am besten geeignet ist, hängt vor allem vom konkreten Anwendungsszenario und den Qualitätsanforderungen ab. Wir empfehlen, über die Plattform APIYI apiyi.com praktische Tests durchzuführen und bei gleichem Budget die Leistungsunterschiede der verschiedenen Modelle anhand Ihrer echten Geschäftsdaten zu vergleichen, statt die Entscheidung ausschließlich auf Grundlage öffentlich verfügbarer Benchmark-Ergebnisse zu treffen.
Zu beachten ist, dass die obige Tabelle eine „Standardempfehlung“ darstellt. Bei der tatsächlichen Auswahl müssen auch Kontextlänge, Parallelität und Latenzanforderungen berücksichtigt werden. Selbst im Kundenservice kann der Preis-Leistungs-Vorteil von Gemini 2.5 Flash-Lite teilweise durch einen längeren Prompt aufgezehrt werden, wenn der Gesprächsverlauf sehr lang ist und häufig auf vorherigen Kontext verwiesen werden muss. In diesem Fall lohnt es sich, auch Claude Haiku 4.5 in einen direkten Vergleich einzubeziehen. Bei komplexen Agent-Aufgaben mit hohen Anforderungen an die Antwortlatenz sollte außerdem die End-to-End-Ausführungszeit von GPT-5 mini in Ihrer konkreten Toolchain praktisch gemessen werden, anstatt nur auf den offiziell veröffentlichten Intelligenzindex zu schauen.
Schnelle Migration: In zwei Schritten von gpt-4o-mini zu einem alternativen Modell wechseln
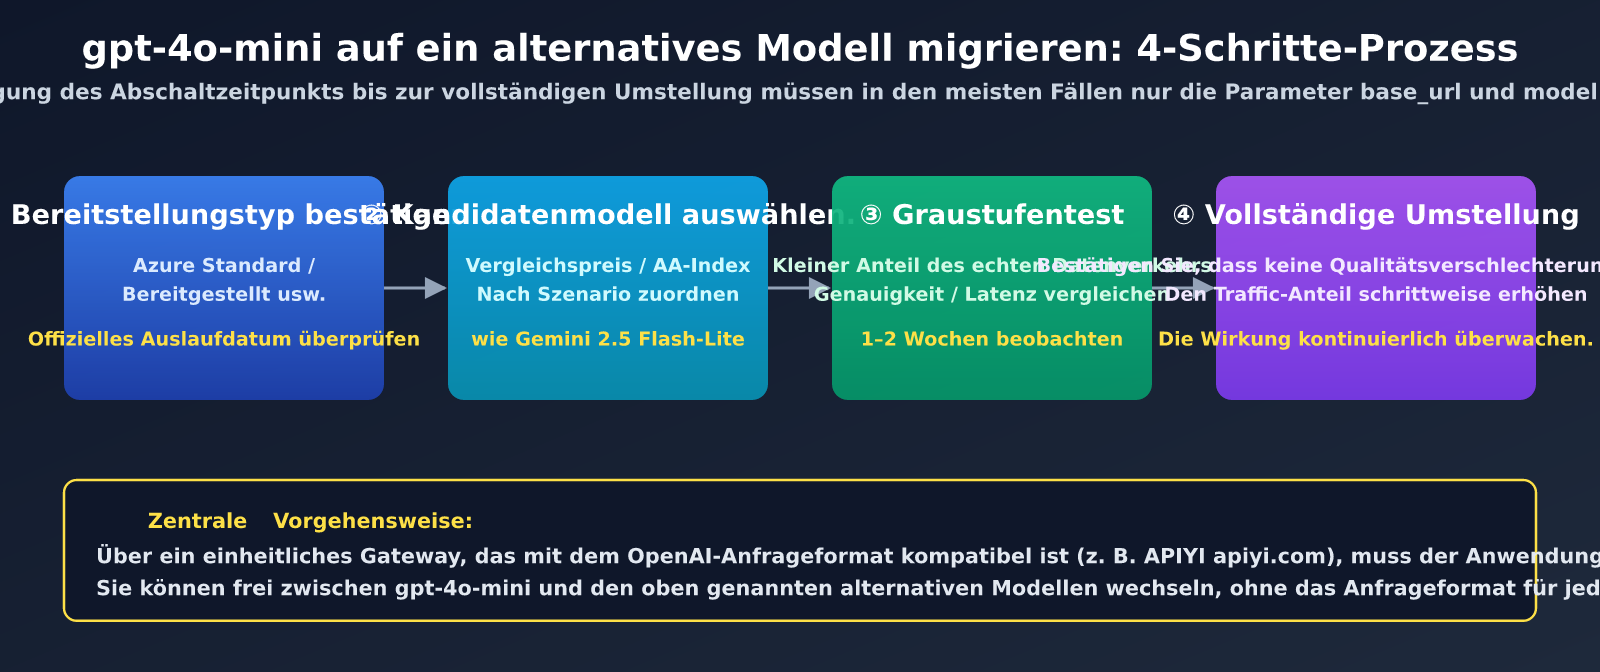
Bei den meisten Migrationen müssen lediglich die beiden Parameter base_url und model angepasst werden. Wenn Sie ursprünglich das OpenAI SDK oder einen Client im kompatiblen Format verwendet haben, müssen Sie keine Geschäftslogik neu schreiben.
Die eigentliche Herausforderung liegt in der Regel nicht auf Codeebene. Die nativen Schnittstellen verschiedener Anbieter unterscheiden sich bei Nachrichtenformaten, Feldern für Tool-Aufrufe und Strategien zur Ratenbegrenzung teilweise erheblich. Ein direkter Wechsel zum nativen SDK von Gemini oder Claude erfordert daher oft eine Überarbeitung des Request-Bodys und der Logik zur Antwortanalyse. Ein einheitliches Gateway, das das OpenAI-Anfrageformat unterstützt, kann diese Unterschiede abschirmen. So muss der Anwendungscode nur eine einzige Aufrufmethode verwalten. Genau deshalb wird model im folgenden Beispiel als konfigurierbarer Parameter umgesetzt, statt für jeden Anbieter einen eigenen Client zu schreiben.
Minimalbeispiel
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle: Mit einer Integration zwischen mehreren Modellen wechseln
)

response = client.chat.completions.create(
    model="gemini-2.5-flash-lite",  # Von gpt-4o-mini zu einem alternativen Modell wechseln
    messages=[{"role": "user", "content": "Hello!"}]
)
print(response.choices[0].message.content)
Vollständigen Migrationscode anzeigen (einschließlich Modellauswahl und Wiederholung bei Fehlern)
import openai
import os

MODEL_MAP = {
    "baseline": "gpt-4o-mini",
    "openai-upgrade": "gpt-5-mini",
    "budget": "gpt-5-nano",
    "gemini": "gemini-2.5-flash-lite",
    "deepseek": "deepseek-v4-flash",
    "claude": "claude-haiku-4-5",
}

client = openai.OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle, kompatibel mit dem Aufrufformat des OpenAI SDK
)

def call_model(prompt: str, profile: str = "gemini", max_retries: int = 2):
    model = MODEL_MAP[profile]
    for attempt in range(max_retries + 1):
        try:
            response = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
                timeout=30,
            )
            return response.choices[0].message.content
        except Exception:
            if attempt == max_retries:
                raise
    return None

if __name__ == "__main__":
    print(call_model("Fasse den Zeitplan für die Abschaltung von gpt-4o-mini zusammen", profile="gemini"))
🚀 Schnellstart: Für Vergleichstests vor der Migration empfehlen wir die Plattform APIYI apiyi.com. Sie bietet eine einheitliche Abrechnung für mehrere Modelle. Für jedes neue Modell müssen weder ein separater API-Schlüssel noch ein eigenes Konto beantragt werden. Innerhalb weniger Minuten lassen sich alle oben genannten Kandidatenmodelle testen.
Häufig gestellte Fragen
F1: Ich nutze derzeit gpt-4o-mini auf Azure OpenAI. Wie lange kann ich es noch verwenden?
Das hängt vom konkreten Bereitstellungstyp ab. Bei einer Standard-Bereitstellung wurde das Modell bereits am 31. März 2026 eingestellt und sollte derzeit nicht mehr aufrufbar sein. Bei den Bereitstellungstypen Provisioned, Global Standard oder Data Zone Standard ist das Einstellungsdatum der 1. Oktober 2026 – bis dahin verbleiben nur noch weniger als zwei Monate. Es empfiehlt sich, möglichst bald über eine Plattform wie APIYI apiyi.com, die den Wechsel zwischen mehreren Modellen unterstützt, Migrationstests durchzuführen, um Betriebsunterbrechungen nach Ablauf der Frist zu vermeiden.
F2: Ich verwende die offizielle OpenAI-API. Muss ich ebenfalls sofort migrieren?
Nein, das ist nicht zwingend erforderlich. Laut der offiziellen OpenAI-Seite zu abgekündigten Funktionen und Modellen wurde gpt-4o-mini selbst bisher nicht in die Liste der einzustellenden Modelle aufgenommen. Nur die Fine-Tuning-Version ft-gpt-4o-mini hat einen späteren Zeitplan. Wenn für Sie vor allem die Kosten entscheidend sind, können Sie zunächst abwarten. Allerdings erreicht gpt-4o-mini beim AA-Intelligenzindex nur 7 Punkte. Ein Vergleich mit Modellen in einer ähnlichen Preisklasse über die Plattform APIYI apiyi.com kann daher häufig eine deutliche Qualitätssteigerung ermöglichen, ohne das Budget zu erhöhen.
F3: Wie kann ich nach dem Wechsel zu einem neuen Modell sicherstellen, dass die Ergebnisse nicht schlechter werden?
Verlassen Sie sich bei der Bewertung nicht ausschließlich auf Ihr subjektives Empfinden. Stellen Sie zunächst eine repräsentative Sammlung realer Geschäftsdaten zusammen – nicht nur einige spontan formulierte Testfälle. Lassen Sie gpt-4o-mini und die Kandidatenmodelle dieselben Eingaben verarbeiten und vergleichen Sie die Ergebnisse anhand von Genauigkeit, Formatkonformität und durchschnittlicher Antwortzeit. Während der schrittweisen Umstellung kann das neue Modell zunächst nur einen kleinen Teil des echten Datenverkehrs übernehmen. Beobachten Sie die Leistung im Produktivbetrieb ein bis zwei Wochen lang. Wenn keine deutlichen Einbußen bei Qualität oder Latenz erkennbar sind, können Sie den Traffic-Anteil schrittweise auf 100 % erhöhen.
Zusammenfassung und Entscheidungsempfehlungen
| Prüfpunk | Erläuterung |
|---|---|
| Bereitstellungstyp bestätigen | Für Azure Standard / Provisioned / Global Standard / Data Zone Standard gelten unterschiedliche Einstellungsdaten |
| Offizielle Preise überprüfen | Die Preise können je nach Region sowie je nach Stoß- und Nebenzeiten variieren. Maßgeblich ist die offizielle Preisseite |
| AA-Intelligenzindex vergleichen | Bevorzugen Sie öffentlich zugängliche Rankings von Drittanbietern wie Artificial Analysis und verlassen Sie sich nicht ausschließlich auf Herstellerangaben |
| Schrittweise Umstellung | Prüfen Sie die Ergebnisse zunächst in nicht kritischen Prozessen und erweitern Sie den Traffic-Anteil anschließend schrittweise |
| Einheitliche API-Aufrufe | Nutzen Sie einen API-Proxy-Dienst mit Unterstützung für das OpenAI-SDK-Format, um den Aufwand beim Wechsel zwischen mehreren Modellen zu reduzieren |
Zusammenfassend lässt sich sagen: gpt-4o-mini wurde über die offizielle OpenAI-API nicht vollständig eingestellt. Der Zeitplan für die Einstellung auf Azure ist jedoch bereits sehr knapp, und die schwächeren Benchmark-Ergebnisse sind eine objektive Tatsache. Für die meisten Einsatzszenarien sind Gemini 2.5 Flash-Lite und GPT-5 mini zwei vorrangige Optionen mit ähnlichen Preisen und deutlich besserer Leistung. Bei äußerst preissensiblen Anwendungen können Sie zusätzlich die Preise von GPT-5 nano und DeepSeek V4 Flash zu Stoß- und Nebenzeiten prüfen.
Wichtig ist außerdem: Wechseln Sie ein Modell nicht überstürzt, nur weil es „günstig“ ist oder angeblich bald eingestellt wird. Preis und Benchmark-Ergebnisse dienen lediglich als erster Schritt bei der Auswahl geeigneter Kandidaten. Ob sich eine Migration lohnt und für welches Modell Sie sich entscheiden sollten, hängt letztlich von den Ergebnissen mit Ihren eigenen Geschäftsdaten ab. Ein ein- bis zweiwöchiger Evaluierungszeitraum mit ausreichend vielen realen Szenarien ist zuverlässiger, als lediglich Änderungen in den Ranking-Punktzahlen zu verfolgen. Empfehlenswert ist, über die Plattform APIYI apiyi.com einen direkten Vergleichstest mit realen Geschäftsdaten durchzuführen und erst danach über das Zielmodell der Migration zu entscheiden.
Wenn Sie während der Migration auf konkrete Probleme stoßen, können Sie sich gerne über den technischen Support von APIYI apiyi.com an uns wenden. Wir verfolgen die offiziellen Preisänderungen von gpt-4o-mini und den jeweiligen Alternativmodellen kontinuierlich und aktualisieren die Daten in diesem Artikel entsprechend.