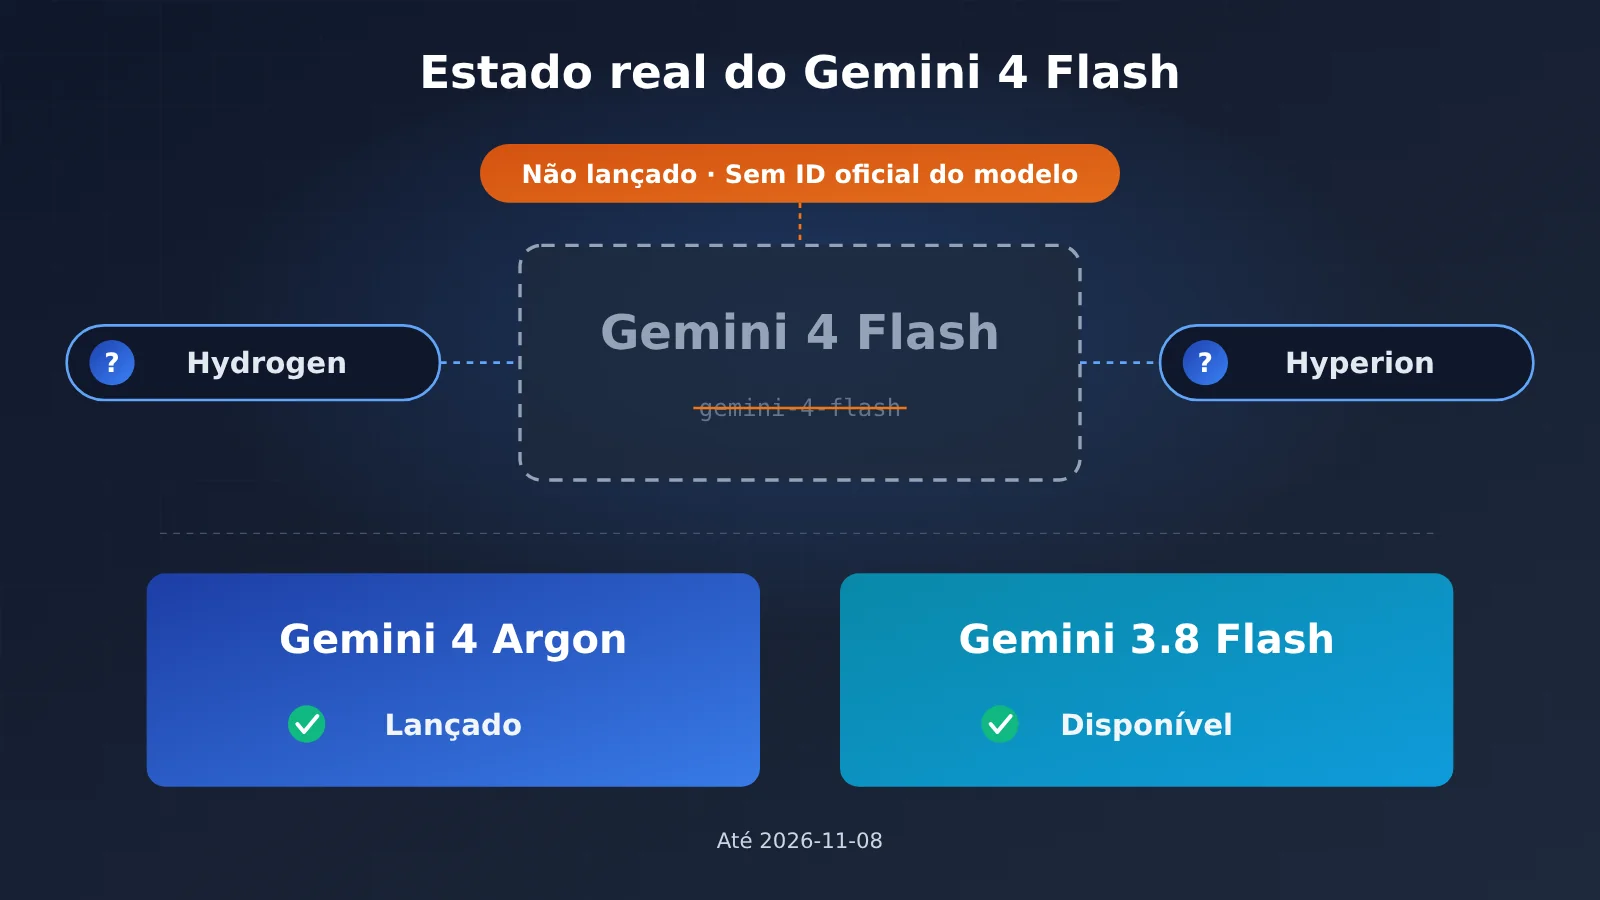
Nota do autor: até 8 de novembro de 2026, o Gemini 4 Flash ainda não tinha um ID de modelo oficial. Neste artigo, analisamos a origem das pistas sobre os codinomes Hydrogen e Hyperion, esclarecemos as diferenças em relação ao Gemini 4 Argon e ao Gemini 3.8 Flash e trazemos uma lista para ajudar na escolha do modelo e na preparação antes do lançamento.
Começando pela conclusão: o Gemini 4 Flash ainda não foi lançado. Até 8 de novembro de 2026, o Google não havia divulgado um ID de modelo oficial para o Gemini 4 Flash. Também não há registro de gemini-4-flash na referência de modelos da API Gemini, nem uma data oficial de lançamento. Se sua equipe está pensando em pausar o cronograma porque ouviu dizer que “o Flash chega na semana que vem”, recomendamos não parar por enquanto.
No momento, há dois modelos disponíveis para uso. Se você precisa de capacidade de ponta e uma janela de contexto longa, use gemini-4-argon. Se precisa lidar com muitas requisições simultâneas, baixa latência e custos controlados, use o Gemini 3.8 Flash. Os codinomes Hydrogen e Hyperion merecem atenção, mas, por enquanto, são apenas pistas vazadas, não sinais de lançamento.
Isso não é uma crítica ao novo modelo. Estamos apenas separando “fatos confirmados”, “pistas vazadas” e “puros rumores” para que você possa planejar com base em informações verificáveis.
O que você leva deste artigo: em 3 minutos, entenda a situação real do Gemini 4 Flash e confira uma tabela para decidir “o que usar agora e como se preparar antes do lançamento”.
Gemini 4 Flash foi lançado? Primeiro, defina um critério objetivo
Antes de discutir qualquer rumor sobre o lançamento de um modelo, vale a pena a equipe alinhar os critérios de avaliação. Caso contrário, o gerente de produto vê um vazamento, o engenheiro vê uma captura de tela e cada um acaba com uma ideia diferente do que significa “lançado”. Nossa sugestão é usar os canais oficiais do Google como única fonte e exigir que vários critérios sejam atendidos ao mesmo tempo.
| Critério | Requisito específico | Situação atual do Gemini 4 Flash |
|---|---|---|
| ID oficial do modelo | Aparece na página de referência de modelos da documentação da Gemini API | ❌ Não aparece; há apenas gemini-4-argon |
| Página de preços | A página de preços da Gemini API informa o preço do modelo | ❌ Não |
| Disponível no AI Studio | Pode ser selecionado diretamente na lista de modelos do AI Studio | ❌ Não há opção oficial |
| Anúncio oficial | Publicado no blog ou em uma conta oficial do Google | ❌ Não |
A regra é simples: os três primeiros critérios precisam ser atendidos ao mesmo tempo para que o modelo seja considerado “lançado”. Um anúncio oficial conta como ponto positivo, mas, sem ID do modelo e preço, os desenvolvedores ainda não conseguem integrá-lo ao ambiente de produção. Por esse padrão, o Gemini 4 Flash não atende a nenhum dos quatro critérios, sem margem para dúvida.
Esse padrão tem outra vantagem: ele pode fazer parte do processo de avaliação de modelos da equipe. No futuro, seja um novo modelo do Gemini, do Claude ou de outro fornecedor, dá para aplicar esses critérios antes de decidir se vale investir recursos na avaliação.
💡 Sugestão de critério: além da documentação oficial, a lista de modelos na plataforma de acesso também é um ponto de verificação útil. No caso da APIYI apiyi.com, por exemplo, a disponibilidade de um modelo para invocação deve ser confirmada na lista de modelos do console. Um modelo especulado não aparece na lista só porque um vazamento ganhou repercussão.
Gemini 4 Flash: fatos, vazamentos e rumores
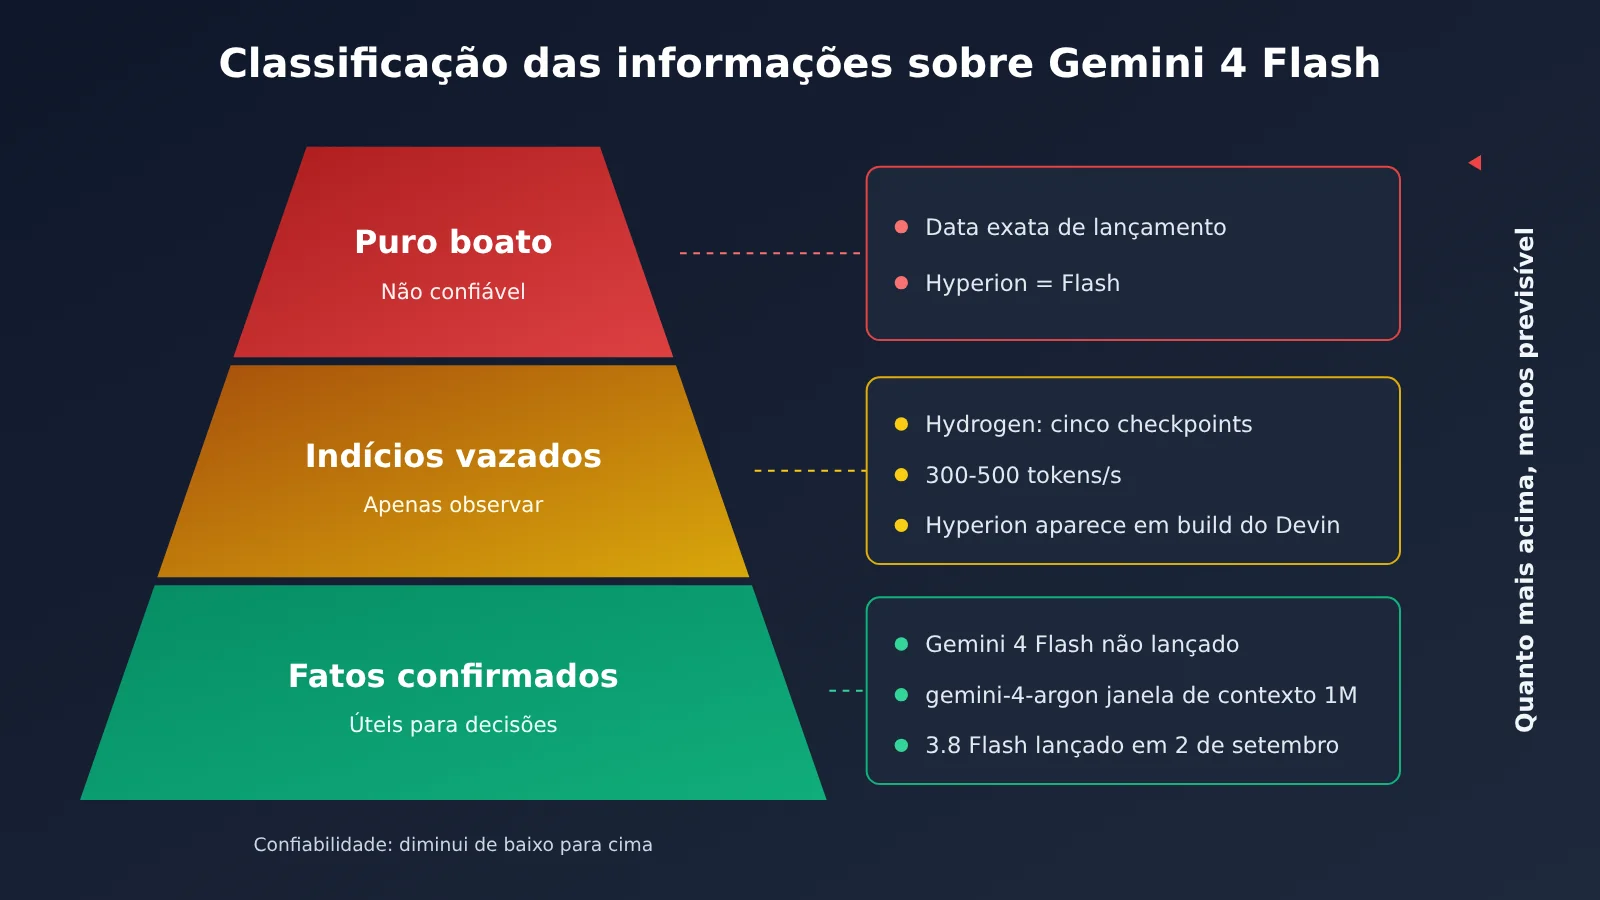
Separar as informações que circulam por nível de confiabilidade é mais eficiente do que discutir cada uma isoladamente. A tabela abaixo resume os principais pontos que orientam a análise deste artigo:
| Informação | Categoria | Fonte | É possível tomar decisões com base nela? |
|---|---|---|---|
| O Gemini 4 Flash não foi lançado e não tem ID de modelo oficial | Fato confirmado | Referência de modelos da Gemini API | ✅ Sim |
O gemini-4-argon foi lançado, tem contexto de 1M e está disponível via API |
Fato confirmado | Documentação da Gemini API | ✅ Sim |
| O Gemini 3.8 Flash é o Flash mais recente e foi lançado em 2 de setembro de 2026 | Fato confirmado | Anúncio oficial do Google | ✅ Sim |
| O codinome interno do Gemini 4 Flash é Hydrogen e há cinco checkpoints | Indício de vazamento | Informação divulgada por uma conta no X | ⚠️ Apenas para acompanhar |
| A velocidade de saída do Hydrogen é de 300-500 tokens/s | Indício de vazamento | Informação divulgada por uma conta no X | ⚠️ Não serve de base para planejar capacidade |
| Testes A/B no LMArena e no AI Studio a partir do fim de outubro | Indício de vazamento | Informação divulgada por uma conta no X | ⚠️ Apenas para acompanhar |
| A família de modelos Hyperion apareceu em uma build do Devin | Indício de vazamento | Build do Devin, da Cognition | ⚠️ Não confirmado pela empresa |
| “Hyperion é o Gemini 4 Flash” | Pura especulação | Associação feita pela comunidade | ❌ Não |
| “O Gemini 4 Flash será lançado em determinada data” | Puro rumor | Sem fonte oficial | ❌ Não |
Gemini 4 Flash, codinome Hydrogen: até onde vão os indícios vazados
Hydrogen é o codinome mais associado ao Gemini 4 Flash até agora. Segundo informações divulgadas no X, esse seria o codinome interno do modelo, que já teria passado por cinco checkpoints. As mesmas fontes afirmam que sua velocidade de saída fica entre 300-500 tokens/s e que ele participa de testes A/B na LMArena e no AI Studio desde o fim de outubro.
As informações parecem bem específicas, mas é importante considerar a origem delas. Todas as afirmações sobre Hydrogen vêm de contas no X, não de documentação oficial, publicações ou fichas de modelo do Google. Os cinco checkpoints indicam que o modelo ainda estaria em desenvolvimento interno — não são evidência de que esteja perto de ser finalizado.
O que os indícios sobre Hydrogen significam para desenvolvedores
Mesmo que todas as informações vazadas sejam verdadeiras, as conclusões possíveis ainda são bastante limitadas. Os testes A/B indicam que o modelo pode aparecer anonimamente em plataformas de avaliação, sem que os usuários possam selecioná-lo ou obter um ID de modelo estável. A faixa de 300-500 tokens/s é ampla e não há detalhes sobre as condições do teste, então ela não serve para estimar a latência e a capacidade de processamento simultâneo do seu serviço.
A interpretação mais útil para desenvolvedores é que Hydrogen sugere que o Google provavelmente está trabalhando em um modelo da categoria Flash para a família Gemini 4. Mas ainda não há definição sobre prazo, preço ou limites de capacidade. Vale colocá-lo na lista de acompanhamento, mas não como uma dependência no cronograma.
- O que fazer: acompanhar as páginas de referência de modelos e de preços da documentação da Gemini API e ficar de olho em mudanças no menu de seleção de modelos do AI Studio.
- O que não fazer: ajustar antecipadamente os tempos limite em produção com base em 300-500 tokens/s ou adiar o lançamento de funcionalidades para esperar pelo Hydrogen.
Codinome Hyperion: qual é sua relação com o Gemini 4 Argon?
A origem do Hyperion é diferente da do Hydrogen. Ele apareceu em uma compilação do Devin, da Cognition, como nome de uma família de modelos, listado antes do Gemini 4 Argon. Foi essa posição na lista que levou a comunidade a especular sobre uma relação entre o Hyperion e a série Gemini 4.
Mas há dois pontos importantes. Primeiro, nenhum fabricante confirmou o que é o Hyperion: ele pode ser um modelo do Google ou apenas um codinome que a Cognition usa internamente para alguma versão de prévia. Segundo, mesmo que o Hyperion seja de fato um modelo do Google, não há nenhuma evidência de que ele pertença à categoria Flash.
Por que não dá para dizer que Hyperion é o Gemini 4 Flash
Os nomes de modelos em produtos de terceiros frequentemente não coincidem com os nomes oficiais dados pelos fabricantes. É comum que desenvolvedores de ferramentas usem codinomes para modelos em prévia, seja para testes internos, implantação gradual ou sigilo. A ordem de uma lista também pode seguir critérios como alfabeto, data de lançamento ou prioridade interna, e não permite deduzir as especificações dos modelos.
Portanto, o que o Hyperion indica é bem limitado: uma família de modelos ainda não anunciada apareceu em uma compilação de terceiros. Só isso. Juntar essa pista ao Hydrogen e concluir que “o Gemini 4 Flash já está sendo usado no Devin” é um exemplo clássico de interpretação equivocada pela combinação de indícios.
Gemini 4 Argon e Gemini 3.8 Flash: os dois modelos disponíveis agora
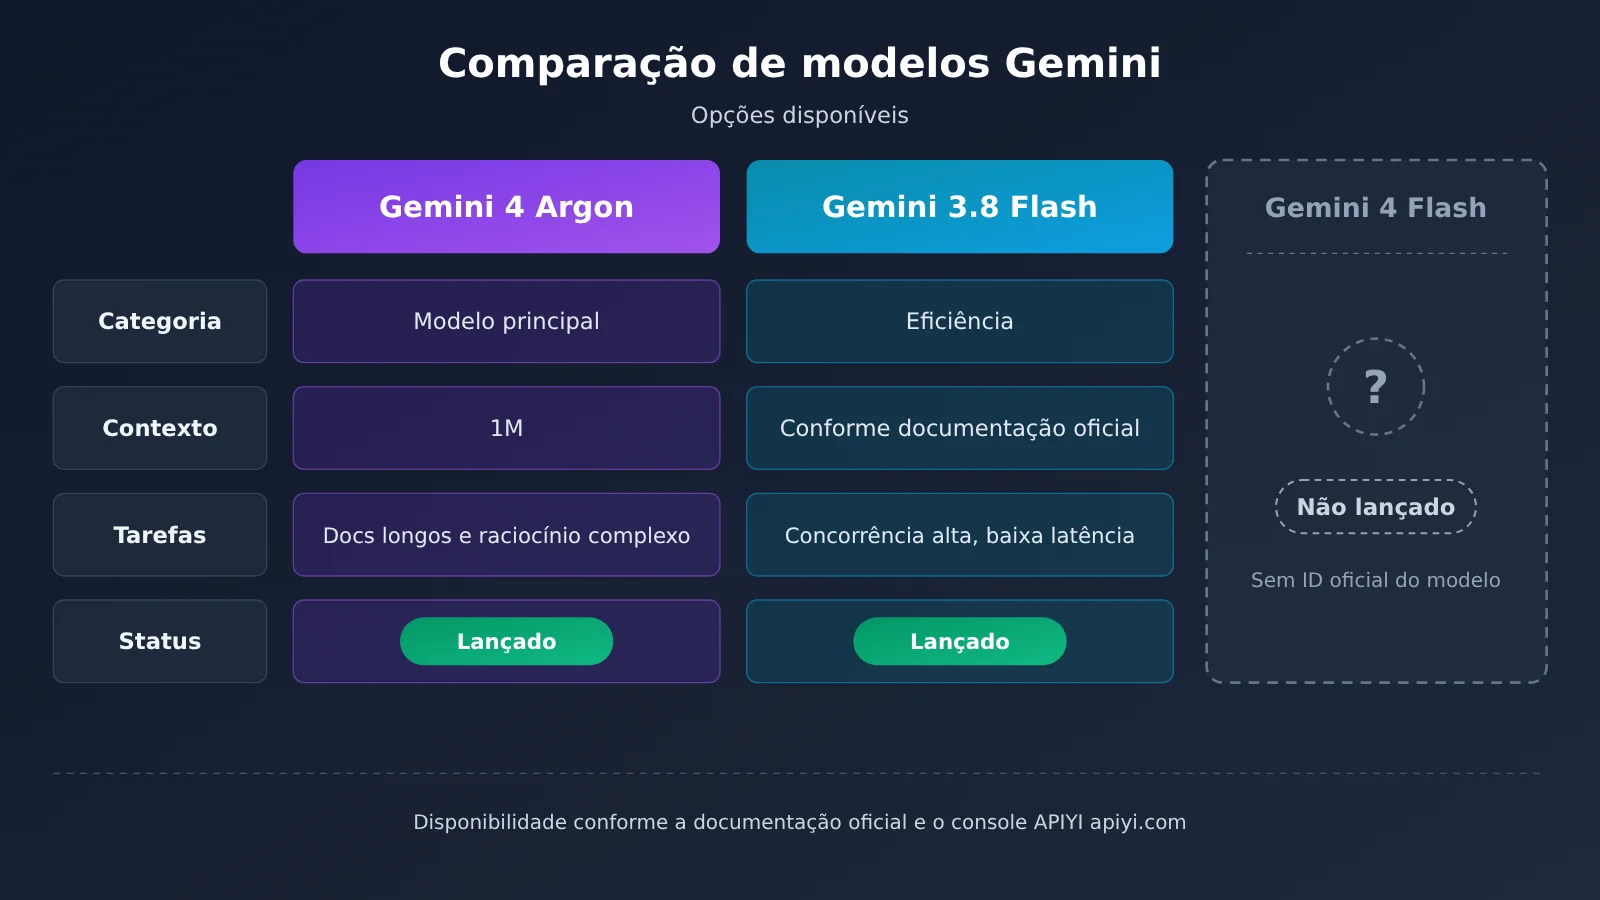
Até o lançamento do Gemini 4 Flash, estes são os dois principais modelos Gemini disponíveis para desenvolvedores. Cada um tem um foco bem definido: um prioriza capacidade, o outro, eficiência.
Gemini 4 Argon: o modelo topo de linha já lançado da família Gemini 4
O gemini-4-argon é o primeiro modelo topo de linha da família Gemini 4 e, no momento, o único modelo Gemini 4 listado na referência da API Gemini. Ele oferece uma janela de contexto de 1M e já está disponível na API oficial. É indicado para análise de documentos longos, compreensão de grandes bases de código, raciocínio cruzado entre vários arquivos e tarefas em que a qualidade da resposta importa mais que a velocidade.
Vale lembrar que Argon e Gemini 4 Flash pertencem à mesma geração, mas ocupam categorias diferentes. A disponibilidade do Argon não significa que o Flash chegará em seguida: não há informações oficiais sobre o calendário de lançamento dos dois.
Gemini 3.8 Flash: a opção Flash mais recente
O Gemini 3.8 Flash foi lançado em 2 de setembro de 2026 e é o modelo Flash mais recente do Google. Ele é voltado para tarefas com alta concorrência, baixa latência e sensibilidade a custos, como classificação em lote, extração de informações, primeira resposta no atendimento ao cliente, preenchimento em tempo real e chamadas leves de ferramentas em agentes.
Até o lançamento do Gemini 4 Flash, o 3.8 Flash é a opção mais viável nessa categoria. Em vez de apenas esperar pela próxima geração, vale testar o desempenho e os custos do 3.8 Flash. Esses dados servirão como referência para avaliar o Gemini 4 Flash mais adiante.
| Modelo | ID oficial do modelo / Status | Principais características | Casos de uso | Plataformas disponíveis |
|---|---|---|---|---|
| Gemini 4 Argon | gemini-4-argon, lançado |
Primeiro modelo topo de linha do Gemini 4, contexto de 1M | Contexto longo, raciocínio complexo, respostas de alta qualidade | API oficial do Google, APIYI apiyi.com |
| Gemini 3.8 Flash | Lançado (2026-09-02) | Flash mais recente, baixa latência | Alta concorrência, resposta em tempo real, tarefas sensíveis a custos | API oficial do Google, APIYI |
| Gemini 4 Flash | Sem ID oficial do modelo | Não lançado | Ainda não é possível planejar seu uso | Consulte a documentação oficial e a lista no console |
Como escolher antes do lançamento do Gemini 4 Flash: estratégia combinada com Argon e 3.8 Flash
A maioria dos sistemas em produção não precisa apostar em um único modelo. Uma estratégia mais segura é dividir as tarefas por camada, deixando Argon e 3.8 Flash cuidarem do que fazem melhor e, quando necessário, usar modelos de outros fornecedores como alternativa ou referência.
- Tarefas complexas com Argon: use
gemini-4-argonnas etapas em que a qualidade é essencial, como busca em contextos longos, resumos de vários documentos e revisão de código. - Tarefas frequentes com 3.8 Flash: use Gemini 3.8 Flash em tarefas com grande volume de chamadas e baixo valor individual, como classificação, extração, reescrita e reconhecimento de intenção.
- Roteamento em cascata: comece com 3.8 Flash e passe para Argon quando a confiança for insuficiente ou a entrada for longa demais, equilibrando custo e qualidade.
- Comparação entre fornecedores: mantenha um modelo Claude ou OpenAI como alternativa nos fluxos críticos, para evitar que oscilações de um único fornecedor afetem a operação.
Essa arquitetura em camadas também traz um benefício menos óbvio: quando o Gemini 4 Flash for lançado, você só precisará substituir o modelo da “camada de tarefas frequentes” e fazer uma implantação gradual, mantendo o impacto sob controle. Se todas as chamadas forem vinculadas diretamente a um único modelo desde já, o custo de migração será maior.
🎯 Recomendação: a parte mais trabalhosa de combinar vários modelos é lidar com diferentes chaves e sistemas de cobrança. Com a APIYI apiyi.com, você pode usar uma única chave API para chamar Gemini 4 Argon, Gemini 3.8 Flash e modelos como Claude e OpenAI. A interface é compatível com o formato da OpenAI, e basta alterar o parâmetro
modelpara trocar de modelo, facilitando o roteamento em camadas descrito acima.
O que preparar antes do lançamento do Gemini 4 Flash: quatro medidas de engenharia
Não interromper o planejamento por causa de rumores não significa ficar parado. A abordagem mais profissional é preparar a integração de novos modelos com antecedência. Assim, não importa quando o Gemini 4 Flash chegar: você poderá avaliá-lo em poucas horas, em vez de semanas.
| Preparação | Ação concreta | Benefício após o lançamento |
|---|---|---|
| Conjunto de avaliação | Selecione amostras representativas de situações reais e padronize as entradas e os critérios de pontuação | Avalie o novo modelo assim que ele chegar, sem depender de impressões |
| Mapeamento de modelos | Use apenas nomes lógicos no código da aplicação, como fast-tier, e associe-os aos IDs dos modelos na configuração |
Para trocar de modelo, basta alterar a configuração, sem mexer no código |
| Base de custos | Registre o consumo atual de tokens, o custo por requisição e a distribuição de latência do Argon e do 3.8 Flash | Saiba se o novo modelo realmente é mais rápido e econômico |
| Reversão e implantação gradual | Faça a troca por proporção de tráfego e mantenha uma opção para voltar ao modelo anterior com um clique | Minimize rapidamente o impacto se o novo modelo ficar abaixo das expectativas |
Mapeamento de modelos e conjunto de avaliação: trocar de modelo com uma mudança de configuração
O mapeamento de modelos é a mais fácil de esquecer entre as quatro medidas, mas também uma das que mais vale preparar com antecedência. Uma boa prática é manter na central de configurações uma tabela de “categoria lógica → ID do modelo”: por exemplo, quality-tier associado a gemini-4-argon e fast-tier ao Gemini 3.8 Flash. Se a camada de integração usar a APIYI, todos os modelos compartilharão o mesmo base_url: https://api.apiyi.com/v1. Assim, basta manter os nomes dos modelos na tabela, sem precisar gerenciar endereços e chaves separadamente.
Para o conjunto de avaliação, inclua três tipos de amostra: requisições típicas, casos difíceis e menos frequentes e casos problemáticos identificados no passado. O conjunto não precisa ser grande; o importante é que seja fixo e possa ser executado novamente. Quando o Gemini 4 Flash tiver um ID de modelo oficial, basta executar o mesmo conjunto para compará-lo diretamente com o 3.8 Flash.
Base de custos e logs de uso: dados no lugar de suposições
Uma base de custos precisa de dados reais de invocação, não apenas do preço unitário do site oficial multiplicado por uma estimativa de uso. Registre o consumo de tokens e o número de requisições por modelo e por linha de negócio durante pelo menos uma semana a um mês. Registre também as latências P50 e P95. Assim, quando um novo modelo prometer ser “mais rápido e mais barato”, você poderá verificar isso com os dados do seu negócio.
📊 Dica sobre dados: a APIYI apiyi.com oferece faturamento unificado e logs de uso, reunindo os registros de invocação de diferentes modelos em um só lugar. Eles podem ajudar a montar a base de custos do Argon e do 3.8 Flash. Consulte o console e a documentação para confirmar preços e disponibilidade.
Perguntas frequentes sobre o Gemini 4 Flash
P1: Já é possível usar o Gemini 4 Flash?
Não. Até 8 de novembro de 2026, o Google não havia lançado o Gemini 4 Flash, a documentação da Gemini API não incluía o ID de modelo `gemini-4-flash` e não havia uma data oficial. O único modelo Gemini 4 disponível no momento é o `gemini-4-argon`.
P2: Hydrogen e Hyperion são o mesmo modelo?
Não há evidências que confirmem isso. Hydrogen surgiu em uma publicação no X sobre o suposto codinome interno do Gemini 4 Flash. Já Hyperion apareceu em uma build do Devin, da Cognition, e não foi confirmado pelo fornecedor: pode ser um modelo do Google ou um codinome que a Cognition deu a uma versão preliminar. As informações têm origens diferentes, então não dá para tratá-las como uma só nem considerá-las oficiais.
P3: Vale esperar pelo Gemini 4 Flash ou usar o Gemini 3.8 Flash agora?
Use o Gemini 3.8 Flash agora. Ele é o modelo Flash mais recente disponível e serve bem para tarefas com alta concorrência, baixa latência e custos sensíveis. As avaliações e os dados de custo coletados agora servirão como base de comparação para avaliar o Gemini 4 Flash no futuro. Pela APIYI apiyi.com, você pode invocar o 3.8 Flash e o Argon com a mesma chave, o que facilita testar uma estratégia em camadas.
P4: Como confirmar assim que o Gemini 4 Flash for lançado se ele já está disponível?
Confira os critérios objetivos deste artigo: o ID oficial do modelo deve aparecer na documentação da Gemini API, a página de preços deve listar seus valores e o modelo deve estar disponível para seleção no AI Studio. O lançamento só estará confirmado quando os três critérios forem atendidos. Para saber se ele já está disponível para uso pela APIYI apiyi.com, consulte a lista de modelos no console. Quando o modelo aparecer, valide-o com o conjunto de avaliação que você preparou.
Principais pontos sobre o Gemini 4 Flash e checklist de rumores
Principais pontos:
- Status de lançamento: o Gemini 4 Flash não havia sido lançado até 8 de novembro, e não havia ID de modelo nem data oficial.
- Hydrogen: codinome interno revelado por uma conta no X; os cinco checkpoints e a velocidade de 300-500 tokens/s não foram confirmados oficialmente.
- Hyperion: apareceu em uma build do Devin, listado antes do Argon. O fornecedor não o confirmou, e não é possível concluir que se trata do Flash.
- Gemini 4 Argon: primeiro modelo flagship lançado da linha Gemini 4, com contexto de 1M e disponível via API.
- Gemini 3.8 Flash: lançado em 2 de setembro de 2026, é a opção mais viável atualmente na categoria Flash.
- Recomendação: mantenha o cronograma e comece a preparar o conjunto de avaliação, o mapeamento de modelos, a linha de base de custos e o mecanismo de rollback.
Checklist para verificar rumores sobre o Gemini 4 Flash
Na próxima vez que vir uma notícia dizendo que “o Gemini 4 Flash foi lançado”, confira cada item desta lista:
| Item | Como verificar | Critério de aprovação |
|---|---|---|
| ID oficial do modelo | Consulte a página de referência de modelos na documentação da Gemini API | Há um ID explícito para o modelo Gemini 4 Flash |
| Preços | Consulte a página de preços da Gemini API | Os preços de entrada e saída estão listados |
| AI Studio | Abra o seletor de modelos do AI Studio | É possível selecionar o modelo diretamente, sem depender de um teste A/B anônimo |
| Anúncio oficial | Consulte o blog ou as contas oficiais do Google | Há um artigo de lançamento oficial |
| Fonte da informação | Rastreie a origem da notícia | A informação vem de uma fonte oficial, não de uma conta no X ou de uma build de terceiros |
| Mapeamento do codinome | Verifique se há uma explicação oficial que relacione o codinome ao nome formal | A relação foi confirmada oficialmente, não é uma especulação da comunidade |
| Disponibilidade para integração | Verifique a lista de modelos no console da plataforma que você usa | O modelo está na lista e pode ser invocado |
O lançamento só deve ser considerado confirmado quando os três primeiros itens forem atendidos ao mesmo tempo. Os quatro últimos ajudam a avaliar a credibilidade da notícia. Se o primeiro item não for atendido, por mais detalhado que seja o vazamento, ele deve entrar na categoria de “observação”, não de “decisão”.
Resumo
O status do Gemini 4 Flash pode ser resumido em três frases:
- Ele ainda não foi lançado: não há ID oficial do modelo, preços nem data; Hydrogen e Hyperion são apenas pistas.
- Há alternativas disponíveis agora: o
gemini-4-argonatende às necessidades de um modelo flagship e de contexto longo, enquanto o Gemini 3.8 Flash atende a cenários de alta concorrência e baixa latência. - Preparar-se é mais importante do que esperar: com conjunto de avaliação, mapeamento de modelos, linha de base de custos, rollback e implantação gradual preparados com antecedência, você pode fazer a troca rapidamente quando o novo modelo chegar.
Para desenvolvedores e equipes de produto, a melhor abordagem é seguir com o cronograma atual e estruturar tecnicamente o processo de integração de novos modelos. A recomendação é usar a APIYI em apiyi.com para testar a combinação de Argon e 3.8 Flash com uma única chave e estabelecer uma linha de base de custos a partir dos logs de uso. Quando o Gemini 4 Flash estiver disponível oficialmente, faça uma comparação por meio de uma implantação gradual.
Referências
- Referência de modelos da Gemini API: IDs oficiais dos modelos e especificações de contexto
- Link:
ai.google.dev/gemini-api/docs/models -
Observação: primeira referência para verificar se o Gemini 4 Flash foi lançado
-
Página de preços da Gemini API: preços oficiais dos modelos
- Link:
ai.google.dev/gemini-api/docs/pricing -
Observação: os preços de novos modelos são listados aqui após o lançamento oficial
-
Google AI Studio: plataforma oficial para testar modelos
- Link:
aistudio.google.com - Observação: permite confirmar se o modelo pode ser selecionado diretamente
Autor: Equipe técnica da APIYI
Contato técnico: entre em contato conosco pela página inicial do site da APIYI. Para mais informações sobre integração de modelos, acesse a central de documentação em docs.apiyi.com