Nota do autor: de “corrigir um crash” a “fazer o aplicativo parar de quebrar”, este artigo detalha as 5 mudanças que o fluxo de trabalho precisa implementar antes de entregar o resultado à IA — e apresenta um roteiro prático para colocar isso em prática sem escrever código.
Muitas equipes já usam IA todos os dias para escrever e-mails, revisar textos e montar apresentações, mas sentem que o valor dela vai muito além disso. O problema muitas vezes não está no modelo, e sim no que entregamos: entregamos uma tarefa, não um resultado. Este artigo usa ideias práticas compartilhadas recentemente por Felix Rieseberg, desenvolvedor do Claude, para apresentar o método de reformular o fluxo de trabalho para evoluir de “delegar tarefas” para “delegar resultados”.
Não é mais uma coletânea de dicas de comando. Por melhor que seja o comando, se a IA não tiver acesso aos dados, não puder interagir com o ambiente e não tiver validação externa, ela só vai ficar girando dentro da caixinha que você delimitou. O que precisa mudar primeiro é o próprio fluxo de trabalho.
Valor central: ao terminar a leitura, você saberá quais trabalhos valem a pena “entregar o resultado à IA” e, antes de fazer isso, quais 5 condições básicas precisam ser preenchidas para que a IA consiga operar de forma independente e contínua por longos períodos.
Os pontos centrais de delegar tarefas à IA e delegar resultados à IA
Felix Rieseberg decompõe a “ambição” no uso da IA em quatro dimensões: velocidade, altitude, profundidade e amplitude. Entre elas, a “velocidade” é o uso mais maduro, enquanto “delegar o resultado à IA” corresponde principalmente à dimensão “altitude” — já profundidade e amplitude definem o teto de qualidade do resultado.
| Dimensão | Significado | Prática típica | Exigência sobre o fluxo de trabalho |
|---|---|---|---|
| Velocidade | Fazer o mesmo trabalho em menos tempo | Deixar a IA escrever código e documentos mais rápido | Baixa, o processo atual já basta |
| Altitude | Focar no resultado final, não na tarefa imediata | Passar de “corrija este bug” para “faça o aplicativo parar de quebrar” | Alta, exige canal de dados e ambiente de validação |
| Profundidade | Pensar como um especialista de ponta da área | Usar bancos de dados e modelos estatísticos no lugar de tabelas Markdown | Média-alta, exige dados brutos e ferramentas especializadas |
| Amplitude | Emprestar métodos de outros domínios | Trazer a metodologia de jornalistas, editores e investidores que apostam na queda | Média, exige múltiplas sessões ou subagentes |
Por que delegar resultados à IA é, antes de tudo, uma questão de fluxo de trabalho
Quando você passa uma tarefa para o modelo, o que ele executa é, na verdade, “o caminho que você acredita hoje ser o mais provável de atingir o objetivo”. Ou seja, a tarefa já carrega o seu julgamento; o modelo é apenas o executor. Para subir um nível, é preciso se perguntar: o que eu realmente quero que aconteça daqui para frente? Por trás desse objetivo imediato, existe algum objetivo maior?
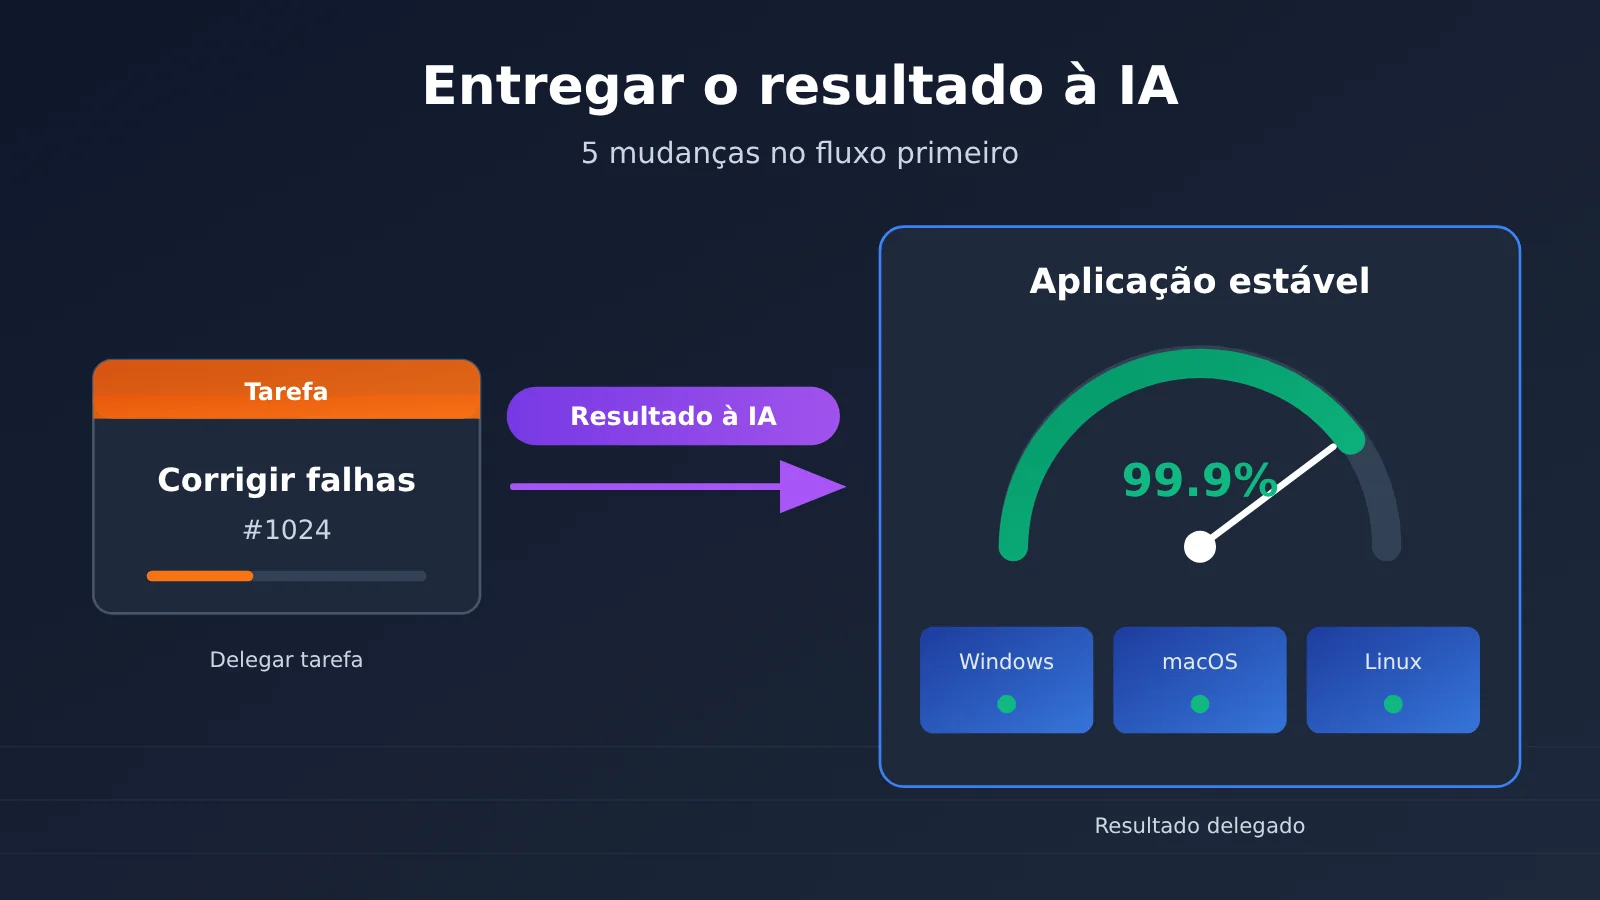
O texto original traz um exemplo bem concreto. No começo, o autor pedia ao Claude para corrigir um a um os problemas de crash; depois, passou a encarregá-lo de “manter o aplicativo estável, sem quebrar”. Mas esse passo não se resolve mudando uma frase do comando: primeiro ele precisou garantir que o Claude conseguisse acessar facilmente os relatórios de crash, soubesse qual commit do Git corresponde a cada versão do aplicativo e ainda pudesse usar máquinas com Windows, macOS e Linux. Só assim ele conseguiria reproduzir o problema de forma independente e verificar se a correção funcionou de fato.
Essa é a tese central deste artigo: delegar o resultado à IA pressupõe que a IA tenha as entradas, a capacidade de agir e os meios de verificação necessários para fechar o ciclo. Se faltar qualquer uma dessas peças, a delegação de resultado degenera em delegação de tarefa — e você volta a ficar distribuindo atividades o tempo todo.
O salto de três níveis ao entregar resultados à IA: o exemplo da revisão trimestral
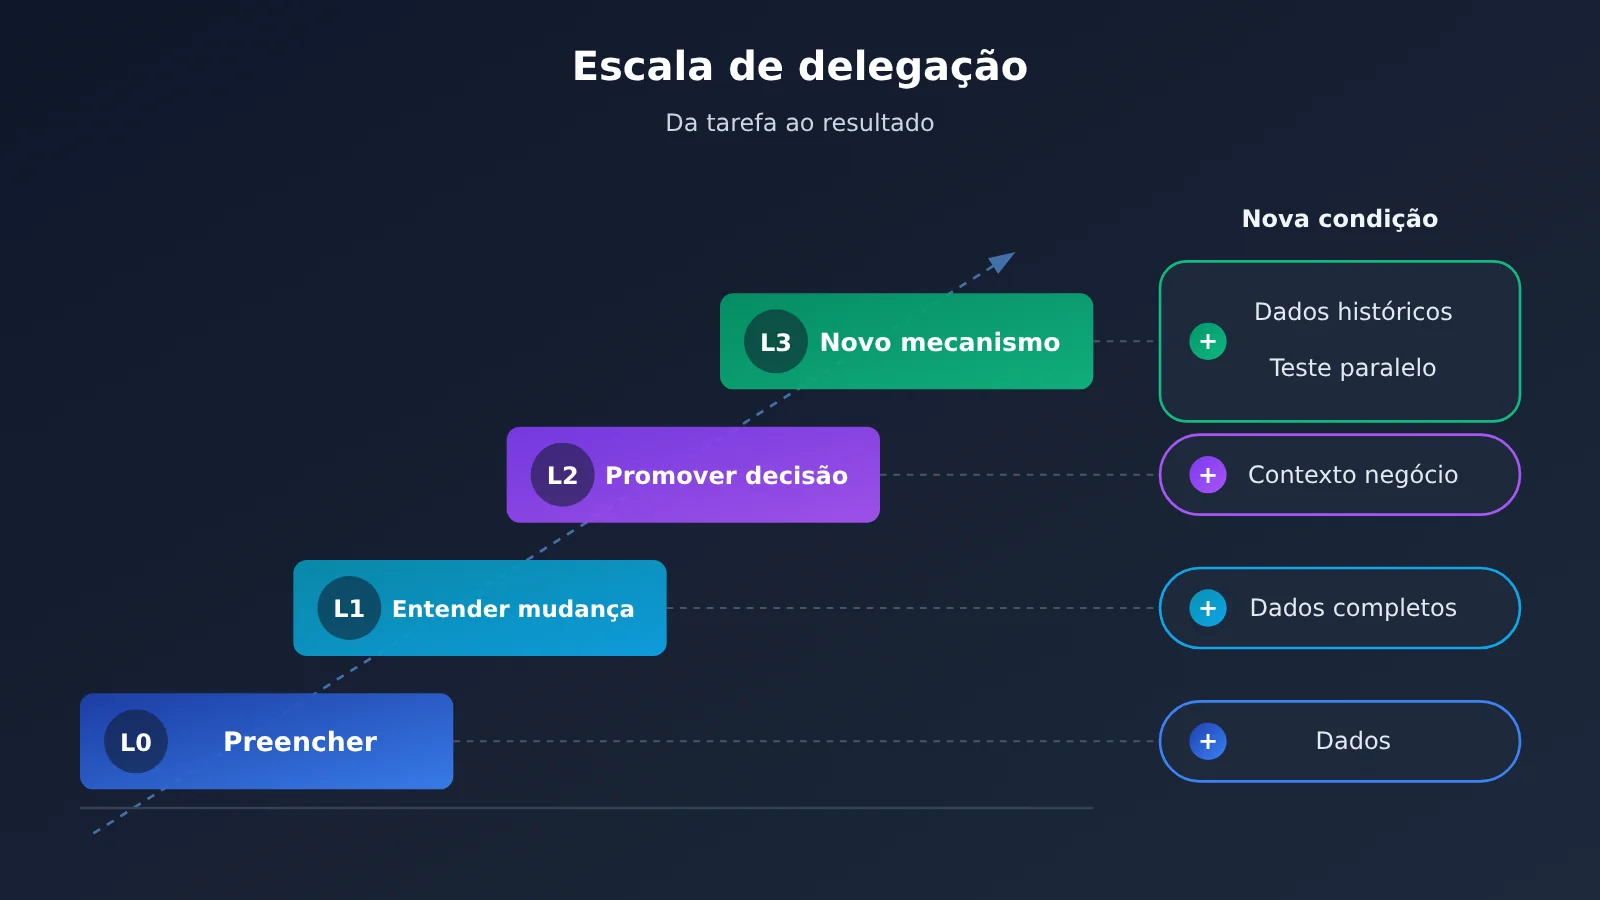
O artigo original usa uma tarefa de escritório “meio entediante” como demonstração: montar os slides de revisão trimestral de negócios (QBR) para a empresa fictícia Acme. A mesma tarefa pode ser dividida em três níveis, do mais baixo ao mais alto.
| Nível | O que você entrega à IA | Formulação típica | O que a IA precisa |
|---|---|---|---|
| L0 Tarefa | Preencher números no modelo | “Transforme esses dados em slides” | Um conjunto de dados já organizado |
| L1 Compreensão | Entender o que aconteceu | “Me diga o que mudou neste trimestre, por quê e o que fazer a respeito” | Dados de negócio o mais completos possível |
| L2 Decisão | Impulsionar a reunião a tomar decisões | “Identifique as três decisões mais urgentes e liste os argumentos a favor e contra” | Dados mais contexto e restrições de negócio |
| L3 Mecanismo | Redesenhar a própria revisão | “Projete uma forma melhor do que os slides trimestrais, use dados históricos para provar que ela detecta problemas mais cedo e rode em paralelo com o processo atual por um trimestre” | Dados históricos, ambiente de execução e validação comparativa |
Ao chegar ao L3, o que você entrega já não é “um conjunto de slides”, mas sim o resultado de “fazer a gestão detectar problemas cedo e alocar capital e pessoas nos lugares certos”. O artigo original dá um sinal de julgamento muito útil: se aquilo que você está fazendo ainda vai precisar de uma reunião para ser discutido depois, provavelmente vale a pena elevar o objetivo mais um nível.
5 coisas que o fluxo de trabalho precisa mudar antes de entregar os resultados à IA
Juntando os dois casos do texto original — tratamento de crashes e retrospectiva trimestral —, dá para resumir 5 infraestruturas que precisam ser alteradas primeiro. A tabela abaixo compara os dois casos lado a lado para facilitar o mapeamento para o seu negócio.
| Item de melhoria | Caso de tratamento de crashes | Caso de retrospectiva trimestral | Pergunta de autoavaliação |
|---|---|---|---|
| 1. Canal de dados brutos | Leitura direta dos relatórios de crash | Acesso aos logs de negócio e dados de usuário originais | A IA recebe material original ou um resumo de segunda mão? |
| 2. Mapeamento rastreável | Número da versão corresponde ao commit no Git | A definição da métrica corresponde à fonte de dados | A IA consegue rastrear do sintoma à causa? |
| 3. Ambiente operável | Máquinas de teste nos três principais sistemas operacionais | Capacidade de instalar software, rodar banco de dados e modelos estatísticos | A IA consegue reproduzir e experimentar por conta própria? |
| 4. Avaliação externa | Após a correção, o sistema realmente deixa de apresentar crashes | Validar o poder de previsão com dados que o modelo nunca viu | O resultado é comprovado por algo fora da IA? |
| 5. Paralelismo e saída | A correção é validada primeiro no ambiente de teste | O novo mecanismo roda em paralelo com o fluxo antigo por um trimestre | Se falhar, é possível reverter sem perdas? |
Transformação 1: abrir o canal de dados brutos para entregar os resultados à IA
O texto original, na seção “Profundidade”, enfatiza repetidamente: profissionais de ponta começam pelos materiais mais brutos, em vez de usar informações já organizadas e processadas. No mundo dos negócios, muitos “fatos aceitos” são apenas aproximações grosseiras da realidade; se você entregar à IA apenas uma tabela-resumo pronta feita por outra pessoa, ela só conseguirá raciocinar em cima dessa aproximação.
Na prática, você pode começar montando uma “lista de dados legíveis pela IA”: logs, chamados, relatórios de crash, contas de banco de dados somente leitura, documentos históricos etc. O texto original menciona que é possível usar conectores MCP ou outros meios para o modelo acessar os dados relevantes. Hoje já existem muitas ferramentas que oferecem esse tipo de recurso; escolher uma delas é bem mais confiável do que ficar colando informações manualmente várias vezes.
Transformação 2: criar um mapeamento rastreável do sintoma à causa
Nos casos de crash, “qual commit do Git corresponde a cada versão do aplicativo” parece um detalhe, mas define se a IA consegue ou não partir de um relatório de crash e chegar à alteração específica no código. Sem esse mapeamento, a IA só pode chutar; se errar, você ainda precisa intervir manualmente.
No contexto de negócios, isso significa que a definição das métricas precisa ser rastreável até a fonte de dados. Por exemplo, é preciso deixar transparente para a IA em qual janela de tempo e para qual tipo de usuário a “taxa de churn” é calculada. Quanto mais claro for o mapeamento, menos a IA tende a se desviar quando trabalha em um nível mais alto de abstração.
Transformação 3: Dar à IA um computador onde ela possa pôr a mão na massa
O texto original é bem direto: todas as abordagens anteriores partem de uma premissa — o modelo precisa conseguir usar um computador, instalar software e obter os mais variados dados relevantes. Quando o Claude se prepara para dar conta da análise com uma tabela Markdown, insista para que ele use bancos de dados e modelos estatísticos, porque “fazer o modelo parecer um especialista” muitas vezes só troca o vocabulário, sem trocar o método de trabalho.
Esse passo significa, para equipes de engenharia, ambiente de sandbox, máquinas de teste e isolamento de permissões; para equipes de negócio, significa um espaço de trabalho onde seja possível rodar ferramentas de análise. A recomendação de permissões é seguir o princípio do menor privilégio: comece apenas com leitura e, depois de validar a confiabilidade, libere gradualmente a permissão de escrita.
Transformação 4: Manter a avaliação externa, sem deixar a IA dar nota a si mesma
A recomendação do autor original é muito clara: pelo menos neste momento, em outubro de 2026, é fortemente aconselhável manter a validação externa, de preferência com ferramentas que o próprio modelo consiga executar e que devolvam feedback imediato. Casos de teste, resultados reais reproduzidos e conjuntos de validação reservados são bem mais confiáveis do que “que nota o modelo se deu”.
Na versão mais aprofundada da retrospectiva trimestral, o texto original pede que o Claude construa, a partir dos logs, uma simulação de comportamento do cliente, identifique os sinais que mais cedo indicam churn e então prove, com dados que ele nunca viu, que esse sinal realmente tem capacidade preditiva. Essa é a forma padrão da avaliação externa: a conclusão precisa resistir à verificação feita fora do modelo.
Reforma Cinco: projetar um período de execução paralela e condições de saída
A delegação no nível L3 tem uma ação fundamental: colocar o novo mecanismo para rodar em paralelo com o fluxo existente por um trimestre. Isso não é apenas cautela, mas também uma avaliação externa — se o novo mecanismo realmente identifica problemas mais cedo, dá para usar o processo antigo do mesmo período como referência de comparação.
Ao mesmo tempo, é preciso encarar as limitações de frente. O texto original admite que, em 2026, uma simples frase como “Claude, vá ganhar dinheiro” ainda não funciona para a maioria das empresas. Por isso, toda delegação por resultado deve deixar bem claros os limites, os pontos de verificação e a forma de reversão, em vez de entregar tudo de uma vez.
Primeiros passos para entregar resultados à IA: um processo de delegação sem escrever código
O processo a seguir não depende de nenhuma programação e pode ser aplicado diretamente por equipes de produto, operações, análise e engenharia.
Primeiro passo: avaliar se vale a pena entregar o resultado desse trabalho à IA
Comece filtrando com três perguntas: esse trabalho ainda vai precisar de reunião para ser discutido depois? Ele tem um resultado final claro, e não apenas uma produção criativa? Ele se repete periodicamente? O texto original aponta que elevar o nível do objetivo é mais útil quando se busca um resultado final e funciona menos bem em trabalhos criativos. Se você responder “sim” a duas das três perguntas, vale a pena tentar.
Segundo passo: preencher um manual de delegação de resultados
Em vez de escrever um comando longo, divida a delegação em campos fixos. A estrutura abaixo pode ser reaproveitada diretamente.
| Campo | O que preencher | Exemplo (tratamento de crashes) |
|---|---|---|
| Resultado final | O que você realmente quer que aconteça | O aplicativo se mantém estável nas três principais plataformas |
| Objetivo por trás do resultado | A intenção um nível acima | Reduzir a perda de usuários por causa de crashes |
| Dados disponíveis | Lista do material bruto e como obtê-lo | Relatórios de crash, mapeamento de versões e commits |
| Ambiente disponível | Máquinas e ferramentas que a IA pode operar | Máquinas de teste Windows, macOS e Linux |
| Validação externa | Quem ou o que comprova que o resultado está correto | Conseguir reproduzir de forma estável e verificar que a correção funciona |
| Limites e plano de contingência | As linhas que não podem ser cruzadas e o plano em caso de falha | Alterar apenas o branch de teste, com merge manual |
| Meta desafiadora | Um padrão alto que parece irrazoável | Exemplo do texto original: exigir que o tempo de carregamento caia de 10 segundos direto para 200 milissegundos |
O campo “Meta desafiadora” vem de uma sugestão mais profunda do texto original: estabeleça um objetivo que pareça irrazoável e diga ao modelo que ele é totalmente razoável. Se o modelo achar que não dá, reforce de novo que o problema tem solução e que ele só precisa continuar se esforçando. A psicologia também sustenta essa ideia: a conclusão de Locke e Latham, após revisar 35 anos de pesquisas sobre definição de metas, é que objetivos específicos e desafiadores superam o vago “faça o seu melhor”.
Terceiro passo: reescreva sua delegação com as “quatro perguntas profundas”
O autor original compartilhou uma linha de raciocínio que costuma usar: antes de reescrever a tarefa, ele pede que o modelo responda a quatro perguntas. Dá para expressar isso com suas próprias palavras assim:
Quero executar esta tarefa com mais profundidade, não com mais volume. Antes de começar, responda: 1) O que os profissionais de ponta dessa área fariam que eu não pedi? 2) Por quais materiais mais originais eles começariam? 3) Que métodos e ferramentas específicos eles usam? 4) Além do julgamento meu e seu, o que mais pode comprovar que o resultado está correto? Depois, reescreva minha delegação com base nisso.
Essas quatro perguntas correspondem justamente aos itens de ajuste anteriores: dados originais, ferramentas profissionais e avaliação externa. As lacunas que o modelo aponta costumam ser exatamente aquela peça que falta no seu fluxo de trabalho.
Quarto passo: escolha a forma de acesso ao modelo
Uma delegação por resultado normalmente roda por muito tempo e em vários turnos, então a estabilidade do acesso ao modelo e o custo de troca impactam diretamente a implementação. A APIYI oferece chamadas de API para a série Claude abordada neste artigo e para outros modelos mainstream, sendo compatível com os dois formatos de interface, OpenAI e Anthropic. SDKs ou frameworks de Agent já existentes geralmente precisam apenas substituir o base_url e a chave API para conectar. Para endereços e parâmetros específicos, consulte a documentação da APIYI em docs.apiyi.com.
| Necessidade de acesso | Forma recomendada | Descrição | Plataformas disponíveis |
|---|---|---|---|
| Projetos que já usam o SDK da OpenAI | Formato compatível com OpenAI | Altere o base_url e a chave API |
APIYI apiyi.com, API oficial |
| Uso dos recursos nativos do Claude | Formato compatível com Anthropic | Mantenha a estrutura de mensagens da Anthropic | APIYI apiyi.com, API oficial |
| Validação comparativa entre vários modelos | Troca do nome do modelo na interface unificada | Comparar modelos diferentes no mesmo fluxo de trabalho | APIYI apiyi.com |
| Estimativa de custo | Consultar a página de preços | Preços unitários de entrada, saída e cache conforme a página de preços | Página de preços: https://docs.apiyi.com/models |
🚀 Sugestão para começar: delegações por resultado costumam exigir primeiro um ciclo fechado funcionando em pequena escala, para só depois ampliar aos poucos. Recomendo acessar via APIYI apiyi.com usando a interface unificada com um ou dois modelos para fazer testes comparativos. Sobre preços dos modelos, critérios de cobrança, preço unitário de entrada e saída e preço de cache, este artigo não traz números específicos: vale sempre o que estiver na página de preços da APIYI em https://docs.apiyi.com/models.
Expandir a amplitude ao entregar o resultado para a IA: convoque um time virtual
Quando altura e profundidade estão no lugar, a amplitude é o que decide se o resultado vai surpreender. O texto original recomenda duas abordagens, e ambas podem entrar direto no seu briefing de delegação de resultado.
A primeira é trocar substantivos por verbos, uma ideia do livro The Art of Innovation. Uma revisão trimestral não é “um conjunto de slides”, mas sim “fazer um grupo de pessoas ocupadas acreditar, em 30 minutos, em uma explicação causal e tomar decisões em meio à incerteza”. Ao descrever o trabalho em termos de ação, tanto você quanto a IA enxergam com mais facilidade quais áreas podem oferecer uma perspectiva única.
A segunda é convocar o seu time. Suponha que essa revisão precise ser absolutamente brilhante: quem você chamaria? A resposta do original é analista, repórter e editor, mais um designer de motion graphics e um designer de áudio se necessário, além de um “red team” formado por investidores vendidos e contadores forenses. Com múltiplas sessões ou subagentes, isso já não sai caro hoje em dia.
O que exige atenção é a armadilha do role-play: a conversa fica cada vez mais enfeitada, mas o resultado não melhora. O alerta do original é não pedir ao modelo que escreva imitando o tom de um investidor vendido, e sim que ele adote o método que esse investidor realmente usa ao estudar um ativo.
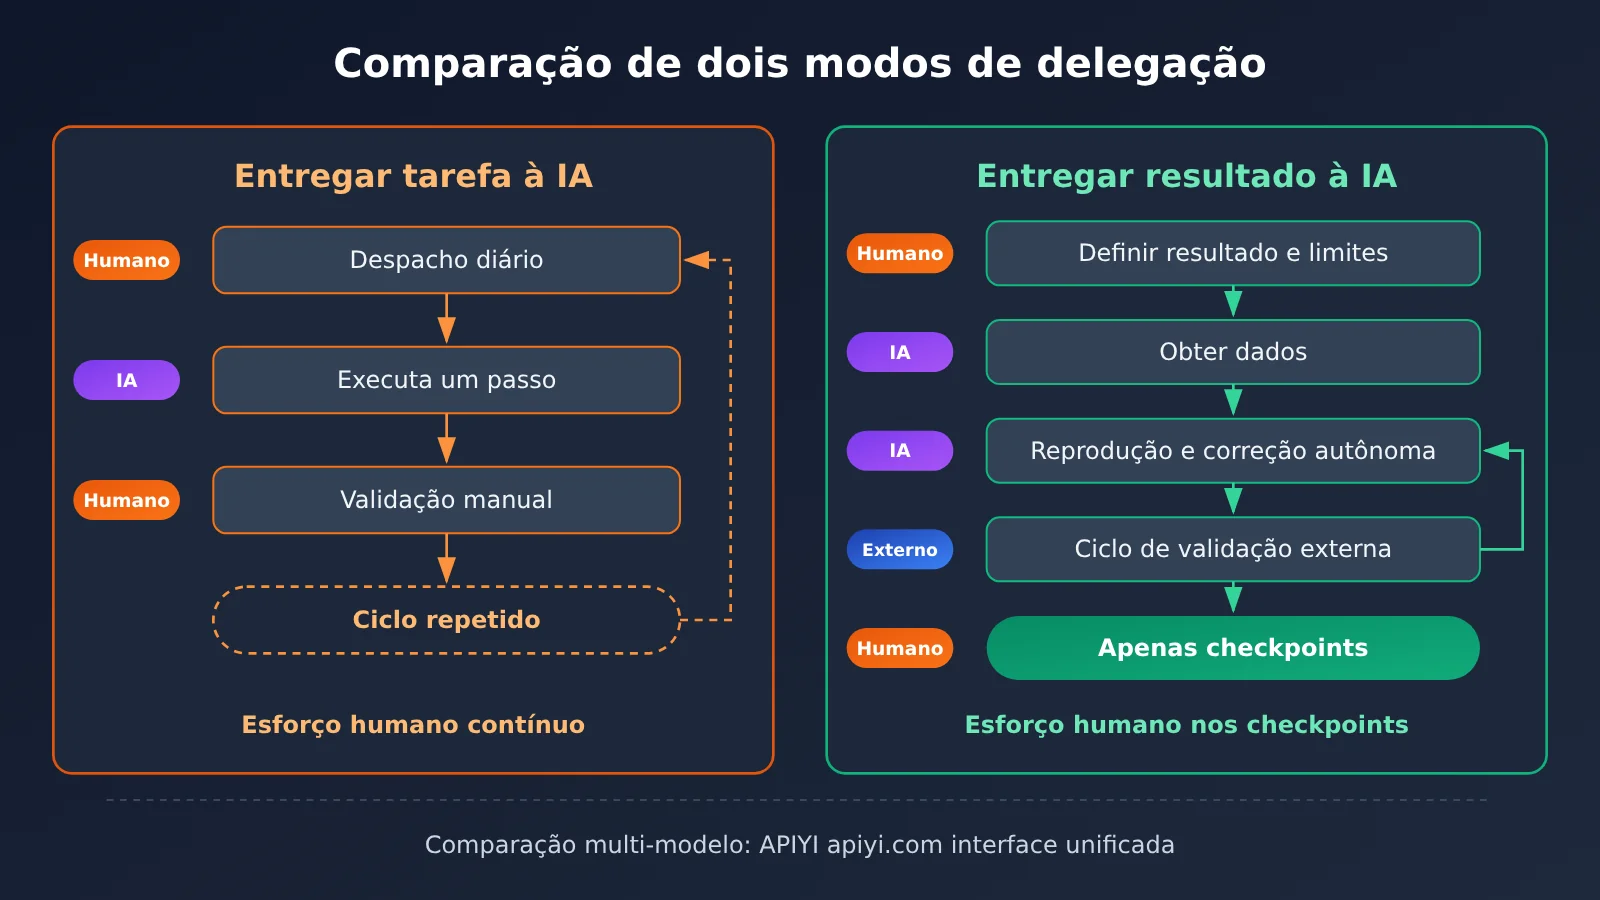
A imagem acima compara a estrutura de esforço humano nos dois modelos de delegação. Se você quiser verificar a diferença de estabilidade entre modelos em cenários de delegação de resultado, dá para usar o APIYI apiyi.com e alternar apenas o nome do modelo dentro do mesmo fluxo de trabalho para fazer o comparativo, reduzindo o trabalho de integração repetida.
Perguntas Frequentes (FAQ)
P1: O que é “entregar o resultado à IA”?
Significa não mais atribuir à IA uma tarefa específica e isolada, mas entregar a ela um resultado final e as condições necessárias, deixando que ela mesma decomponha, execute e valide. Por exemplo, passar de “corrija este crash” para “mantenha a aplicação estável e sem crashes”, cabendo à pessoa apenas definir o objetivo, os limites e os pontos de verificação.
P2: Qual a diferença entre entregar o resultado à IA e uma automação comum de AI Agent?
A automação normalmente encadeia etapas fixas, e as próprias etapas ainda são projetadas por humanos. Entregar o resultado à IA transfere também a decisão de “qual método escolher”, e a IA pode redesenhar o próprio processo — por exemplo, redesenhar o mecanismo de retrospectiva trimestral. A primeira otimiza a eficiência de execução; a segunda eleva o nível de abstração do trabalho.
P3: Os modelos atuais realmente dão conta de assumir a delegação de resultados?
Em parte, sim. O autor do texto original observa que, quanto mais capaz o modelo, mais ele consegue trabalhar em um nível de abstração mais alto, e as pessoas estão justamente encontrando nessa dimensão processos que funcionam a longo prazo sem intervenção contínua. Mas ele também admite que, até 2026, um objetivo totalmente aberto como “vá ganhar dinheiro” ainda não funcionará para a maioria das empresas, sendo necessário combiná-lo com limites e validação externa.
P4: Quais trabalhos são mais adequados para entregar o resultado à IA?
Os cenários principais são:
– **Governança de estabilidade**: ciclo fechado de monitoramento de crashes, reprodução e validação de correções
– **Análise de negócios**: evoluir da retrospectiva trimestral para um alerta precoce contínuo de problemas
– **Estudo de churn de usuários**: buscar nos logs brutos os sinais mais precoces de churn e validar seu poder preditivo
– **Sinal de decisão**: se, depois do resultado, ainda é preciso reunir para discutir, geralmente vale subir um nível
P5: Como montar rapidamente um fluxo de delegação de resultados via API?
Recomenda-se primeiro fechar o ciclo mínimo usando uma interface unificada:
1. Registre-se em APIYI apiyi.com e obtenha uma chave API
2. Consulte a documentação do APIYI em docs.apiyi.com e configure o `base_url` no formato compatível com OpenAI ou Anthropic
3. Use a especificação de delegação de resultados deste artigo para definir um objetivo de escopo pequeno e conecte as fontes de dados
4. Adicione validação externa e, depois de completar um ciclo inteiro, amplie o escopo
P6: Como estimar o custo de uma delegação de resultados de longa duração?
A delegação de resultados gera muitas chamadas em múltiplos turnos. Recomenda-se primeiro registrar, em pequena escala, o consumo real de tokens e depois estimar com base no preço unitário. Para preço unitário, critérios de cobrança e preço de cache, use os dados reais da página de preços do APIYI https://docs.apiyi.com/models; este artigo não traz números concretos. Para contextos longos reutilizados, vale ficar de olho nas explicações de cobrança de cache na página de preços.
P7: Quais são os riscos conhecidos de entregar o resultado à IA?
São principalmente três: primeiro, a autoavaliação do modelo não é confiável, sendo obrigatório introduzir uma avaliação externa; segundo, a expansão em amplitude facilmente vira “role-play”, gerando resultados vistosos mas inúteis; terceiro, permissões excessivas trazem risco operacional — recomenda-se começar com acesso somente leitura, liberar a escrita aos poucos e projetar, para cada delegação, um período de execução paralela e um plano de rollback.
Entregar os resultados à IA: pontos-chave (Key Takeaways)
- A tarefa carrega o seu julgamento: é entregando o resultado que você permite à IA escolher um caminho melhor do que o seu
- Reunião é sinal de que dá para subir um nível: se o resultado ainda precisa ser discutido em reunião, vale a pena elevar o objetivo mais um degrau
- Os três elementos do ciclo fechado: dados brutos, ambiente manipulável e validação externa — nenhum pode faltar
- Profundidade vem de ferramentas profissionais: insista em bancos de dados e modelos estatísticos, não em tabelas Markdown
- Amplitude vem do empréstimo de métodos: pegue emprestado métodos reais de outras áreas, não apenas imite o tom
- Execução em paralelo reduz riscos: rode o novo mecanismo em paralelo com o processo antigo por um ciclo antes de fazer a troca
- Acesso e cobrança: dá para integrar pela interface unificada do APIYI; os preços seguem o que está em docs.apiyi.com/models
Resumo
Os pontos-chave de “entregar a tarefa à IA não é tão bom quanto entregar o resultado à IA”:
- Primeiro eleve o nível: pergunte com clareza qual é o resultado que você realmente quer que aconteça por trás da tarefa imediata, subindo degrau por degrau do L0 (preencher modelo) até o L3 (redefinir o mecanismo)
- Depois mude o fluxo de trabalho: conecte os dados brutos, crie mapeamentos rastreáveis, ofereça um ambiente manipulável, mantenha a avaliação externa e projete paralelismo e critérios de saída
- Por fim, amplie profundidade e amplitude: use as quatro perguntas de profundidade para completar os métodos profissionais e a equipe virtual para trazer perspectivas interdisciplinares
A sugestão é começar por um cenário pequeno, periódico e que precise de discussão em reunião, rodar um ciclo inteiro com o manual de delegação de resultados e só então decidir se vale expandir o escopo. Para o acesso aos modelos, recomendo validar rápido o resultado pelo APIYI apiyi.com: ele oferece chamadas de API para modelos mainstream como o Claude, compatível com os formatos de interface da OpenAI e da Anthropic. Os detalhes de integração estão na documentação docs.apiyi.com, e os preços seguem https://docs.apiyi.com/models.
📚 Referências
- Como definir metas mais ousadas: um guia prático para usuários de IA: tradução chinesa do InfoQ
- Link:
infoq.cn/article/F1ms7x7KI1p7UfocCywh -
Descrição: origem dos pontos centrais deste artigo e dos casos de governança de crises e revisão trimestral
-
How to be more ambitious: A tutorial for humans with models: texto original em inglês de Felix Rieseberg
- Link:
felixrieseberg.com/how-to-be-more-ambitious-a-tutorial-for-humans-with-models -
Descrição: discussão completa das quatro dimensões: velocidade, altura, profundidade e amplitude
-
Central de documentação da APIYI: formatos de interface e instruções de integração
- Link:
docs.apiyi.com -
Descrição: como configurar os formatos compatíveis com OpenAI e Anthropic
-
Página de preços dos modelos da APIYI: preço unitário dos modelos e critérios de cobrança
- Link:
docs.apiyi.com/models - Descrição: os preços de entrada, saída e cache devem ser considerados conforme os dados reais desta página
Autor: Equipe técnica da APIYI
Contato técnico: fique à vontade para falar conosco pela página inicial do site APIYI e trocar experiências sobre a implementação da delegação de resultados. Mais materiais estão disponíveis na central de documentação docs.apiyi.com