著者注:「1件のクラッシュを直す」から「アプリをクラッシュさせない」へ。本記事では、結果をAIに任せる前にワークフローが先に済ませておくべき5つの改修を分解し、コードを書かずに現場へ落とし込むプロセスを紹介します。
多くのチームがすでに、メール作成、コピーの修正、PPT作成に毎日AIを使っています。しかし、その価値はそれだけではないと感じているはずです。問題は多くの場合モデル側ではなく、私たちが渡すものが小さすぎることにあります。渡しているのはタスクであり、結果ではないのです。本記事では、Claudeの開発者であるFelix Rieseberg氏が最近共有した実践的な考え方を参考に、「タスクを任せる」から「結果を任せる」へとアップグレードするワークフローの改修方法を紹介します。
これは、また一つのプロンプト術まとめではありません。どれだけプロンプトをうまく書いても、AIがデータにアクセスできず、環境に触れられず、外部検証もなければ、あなたが定めた小さな枠の中をぐるぐる回るだけです。本当に先に変えるべきなのは、ワークフローそのものです。
本記事の核心:本記事を読み終えると、どの仕事が「結果をAIに任せる」に値するのか、そして任せる前にどの5つの基礎条件を整えれば、AIが長期的に自立して動き続けられるのかが分かります。
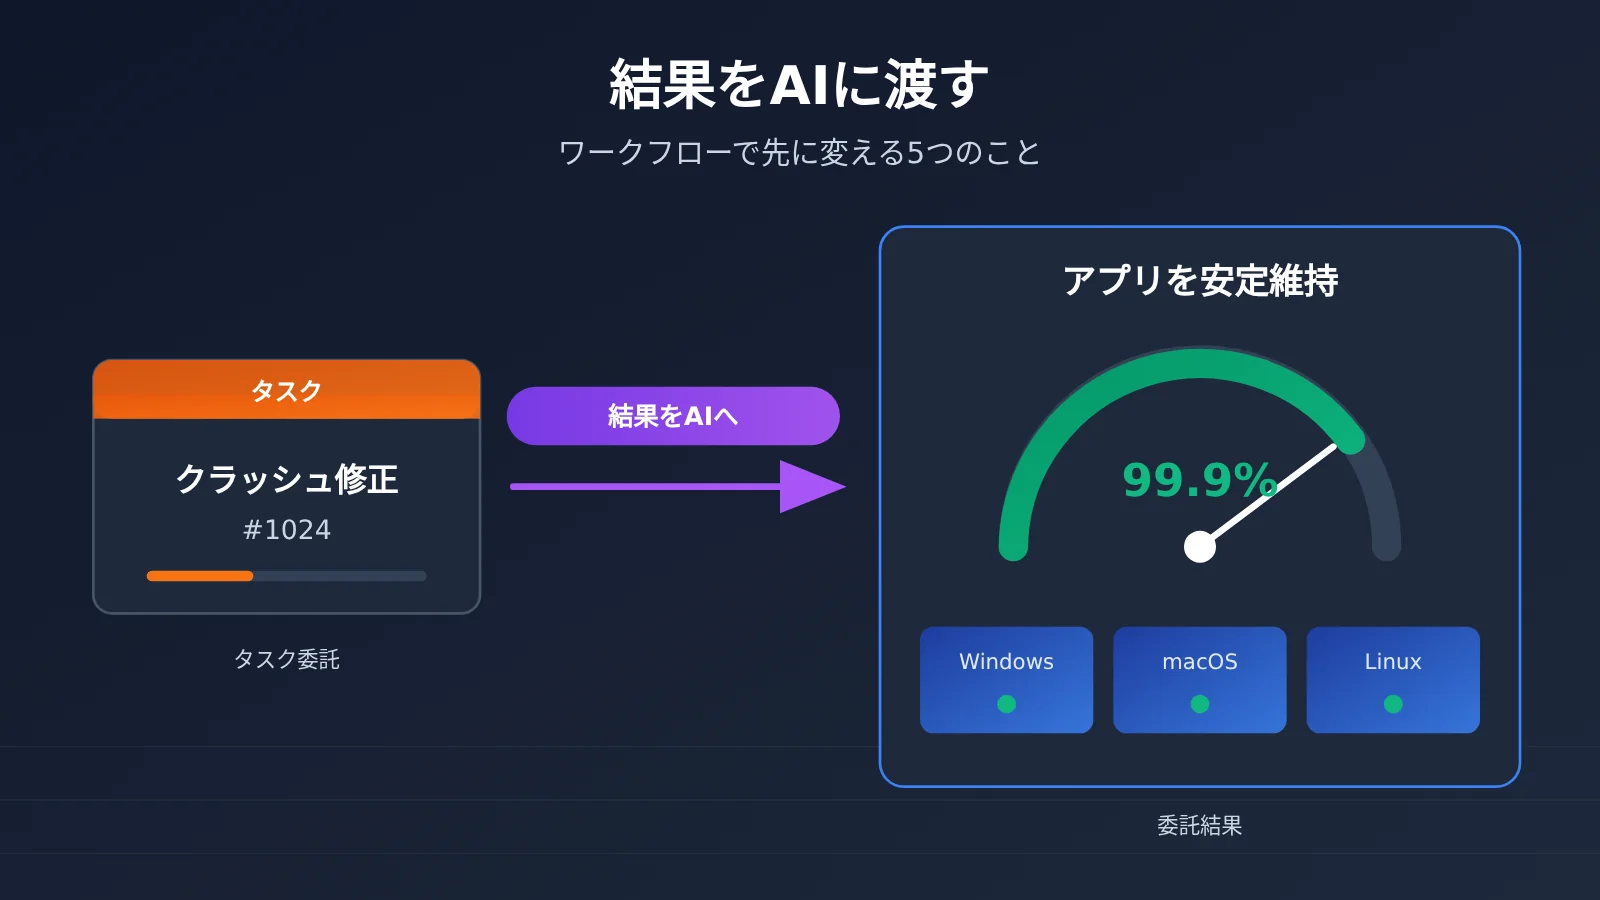
タスクをAIに任せる場合と結果をAIに任せる場合の要点
Felix Rieseberg は、AIを使うときの「野心」を4つの次元に分解しています。速度、高さ、深さ、広さです。このうち「速度」は最も成熟した使い方で、「結果をAIに任せる」は主に「高さ」の次元に対応します。そして深さと広さが、結果の質の上限を決めます。
| 次元 | 意味 | 典型的なやり方 | ワークフローへの要件 |
|---|---|---|---|
| 速度 | 同じ仕事をより短時間で終える | AIにコードや文書をもっと速く書かせる | 低い。既存のフローで十分 |
| 高さ | 目の前のタスクではなく最終結果に注目する | 「このバグを直す」から「アプリを落ちないようにする」へ | 高い。データ経路と検証環境が必要 |
| 深さ | その分野のトップ専門家のように考える | Markdownの表の代わりにデータベースと統計モデルを使う | 中〜高。生データと専門ツールが必要 |
| 広さ | 他分野の手法を借りる | 記者、編集者、空売り投資家の方法論を取り入れる | 中。複数セッションやサブエージェントが必要 |
なぜ「結果をAIに任せる」ことが、まずワークフローの問題になるのか
モデルにタスクを出すとき、モデルが実行しているのは実は「あなたが現時点で目標達成に最も可能性が高いと考えている方法」です。つまり、タスク自体にすでにあなたの判断が含まれており、モデルは単なる実行者にすぎません。一段上に進みたいなら、自分に問いかけてください。次に本当に起きてほしいことは何か? 目の前のこの目標の背後に、さらに大きな目標はないか?
原文には非常に具体的な例が挙げられています。著者は以前、Claude に個々のクラッシュを修正してもらっていましたが、後には「アプリを安定させ、クラッシュしないようにする」こと自体を任せるようになりました。しかしこの一歩は、プロンプトを一行書き換えるだけでは実現できません。まず Claude がクラッシュレポートに簡単にアクセスできるようにし、各アプリバージョンがどの Git コミットに対応するかを把握させ、さらに Windows、macOS、Linux のマシンを使えるようにする必要がありました。そうして初めて、問題を自力で再現し、修正が有効かどうかを検証できるようになります。
これが本記事の核心的な判断です。結果をAIに任せるには、AIが閉ループに必要な入力、実行能力、検証手段を持っていることが前提になります。どれか一つが欠けると、結果の委託はタスクの委託へと退化し、ひっきりなしに仕事を振り続ける状態に戻ってしまいます。
結果をAIに委ねる3段階のジャンプ:四半期レビューを例に
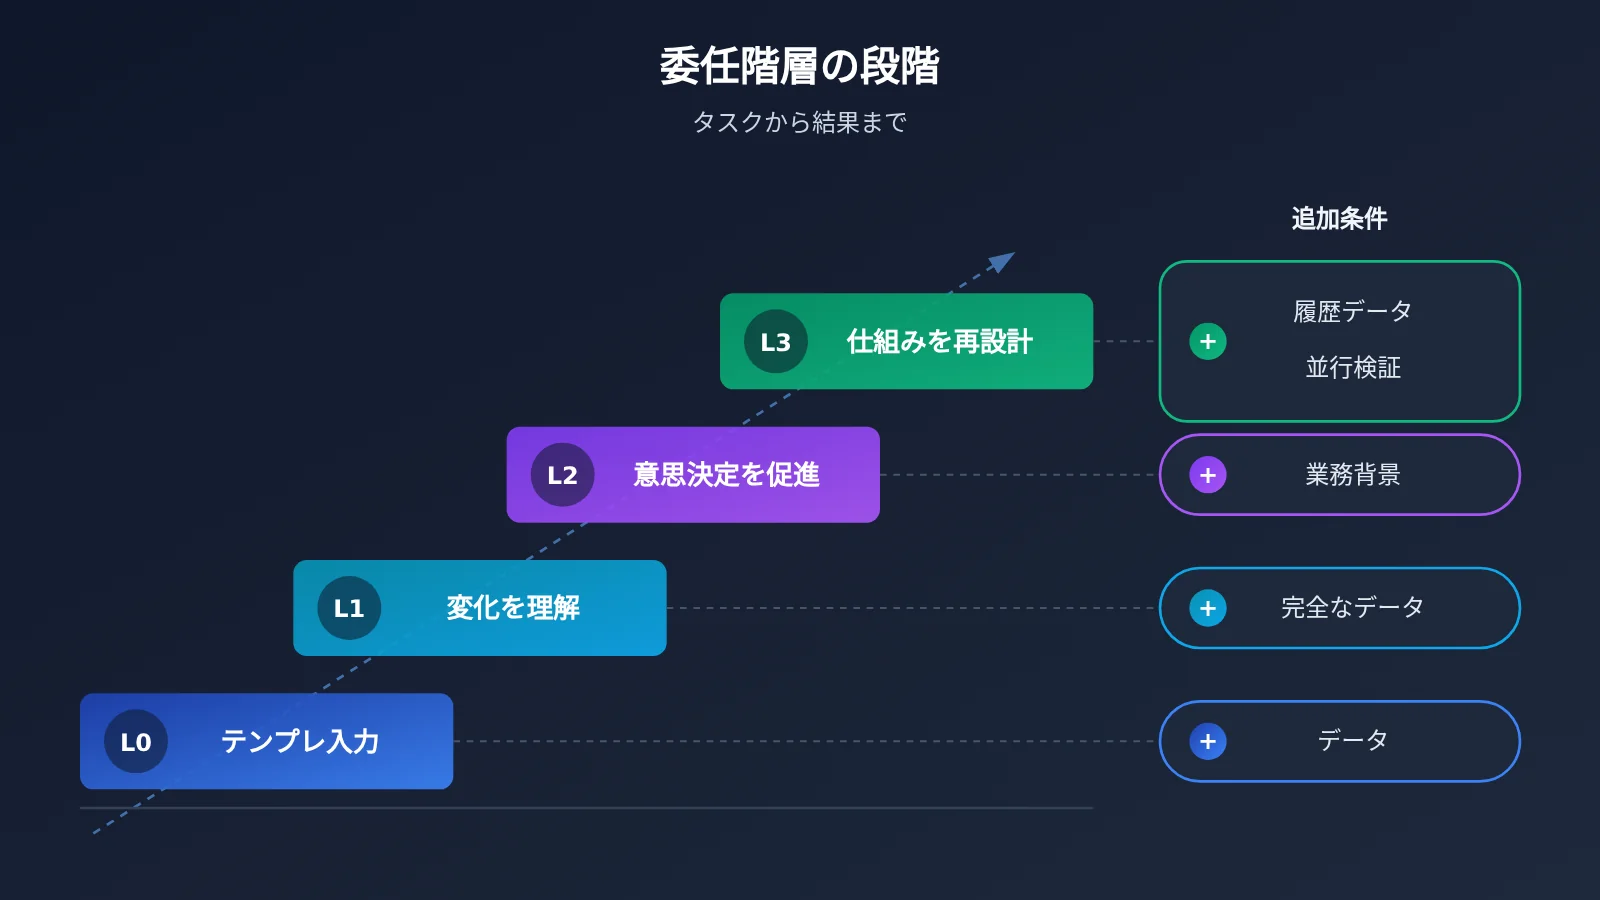
原文では「少し退屈な」オフィスタスクを例にしています。架空の会社Acmeの四半期業務レビュー(QBR)スライドを作る、というものです。同じ作業でも、低いレベルから高いレベルまで3つの階層に分けられます。
| 階層 | AIに渡す内容 | 典型的な指示 | AIに必要な条件 |
|---|---|---|---|
| L0 タスク | テンプレートに数字を埋める | 「このデータをスライドにして」 | 整理済みのデータ |
| L1 理解 | 何が起きたのかを把握する | 「今四半期に何が変わり、なぜそうなったのか、どうすべきか教えて」 | できるだけ完全な業務データ |
| L2 意思決定 | 会議で決定を下せるようにする | 「最も緊急性の高い3つの意思決定を特定し、賛成理由と反対理由を挙げて」 | データに加えて業務背景と制約 |
| L3 仕組み | レビューそのものを再設計する | 「四半期スライドよりも優れた方法を設計し、過去データを使ってより早く問題を発見できることを証明し、既存プロセスと1四半期並行して運用して」 | 過去データ、実行環境、対照検証 |
L3になると、渡しているものはもはや「スライド一式」ではなく、「経営層がより早く問題を発見し、資金と人材を適切な場所に配分できるようにする」という結果そのものです。原文では、非常に使いやすい判断のシグナルが示されています:もし今作っているものに対して、後で会議で議論する必要があるなら、目標をもう一段引き上げる価値が高い可能性が高いということです。
AI に結果を渡す前に、ワークフローをまず変えるべき 5 つのこと
原文のクラッシュ対応と四半期レビューという 2 つのケースを総合すると、まず改めるべきインフラが 5 つあると整理できます。次の表で両ケースを並べて比較しますので、自分の業務に当てはめてみてください。
| 改造項目 | クラッシュ対応ケース | 四半期レビューケース | セルフチェックの問い |
|---|---|---|---|
| 1. 生データのチャネル | クラッシュレポートを直接読み取れる | 生の業務ログとユーザーデータにアクセスできる | AI が手にしているのは生の素材か、それとも二次的な要約か? |
| 2. 追跡可能なマッピング | バージョン番号が Git コミットに対応 | 指標の定義がデータソースに対応 | AI は現象から原因まで遡れるか? |
| 3. 手を動かせる環境 | 3 大 OS のテストマシン | ソフトウェアをインストールし、データベースや統計モデルを実行できる | AI が自分で再現・実験できるか? |
| 4. 外部からの評価 | 修正後、実際にクラッシュしなくなる | モデルが見たことのないデータで予測力を検証 | 結果は AI 以外の何かによって証明されているか? |
| 5. 並行と撤退 | 修正はまずテスト環境で検証 | 新メカニズムと旧プロセスを 1 四半期並行 | 失敗時にロスなく巻き戻せるか? |
改善1:結果をAIに渡すために、元データのチャネルを開通させる
原文では「深さ」のセクションで繰り返し強調されています。一流の専門家は、すでに整理・加工された情報ではなく、最も原始的な材料から着手するものです。ビジネスの世界で語られる多くの「定説」は、実は現実を粗く近似したものに過ぎません。もしAIに誰かが作った要約表だけを渡したら、AIはその近似の上でしか推論できなくなります。
実際に作業するときは、まず「AIが読み取れるデータリスト」を作成しましょう。ログ、チケット、クラッシュレポート、データベースの読み取り専用アカウント、過去のドキュメントなどです。原文では、MCPコネクタなどの経路を通じてモデルに関連データを取得させることができると述べられています。現在、こうした機能を提供するツールは数多くありますので、一つ選んで使うほうが、何度も手作業でコピペを繰り返すよりはるかに信頼できます。
改善2:現象から原因までを追跡できるマッピングを構築する
クラッシュのケースでは、「各アプリバージョンがどのGitコミットに対応するか」は一見些細な点に思えますが、AIがあるクラッシュレポートから具体的なコード変更を特定できるかどうかを左右します。このマッピングがなければ、AIは推測するしかなく、推測が外れれば人間が介入しなければなりません。
これをビジネスシーンに置き換えると、指標の定義がデータソースまで追跡できることが重要になります。たとえば「離脱率」がどの時間枠で、どのユーザー層を対象に計算されるのかは、AIに対して透明でなければなりません。マッピングが明確であるほど、AIがより高い抽象レベルで作業するときに逸脱しにくくなります。
改造その3:AIに“手足を動かせる”コンピュータを渡す
原文は非常に率直にこう述べています。これまでのすべての取り組みには共通の前提があります。モデルが1台のコンピュータを使え、ソフトウェアをインストールでき、さまざまな関連データを取得できること、という前提です。Claude が Markdown の表で分析を済ませようとしたら、データベースと統計モデルを使うように粘り強く促してください。「モデルを専門家のように振る舞わせる」というのは、多くの場合、言い回しを変えただけで、仕事のやり方は変わっていないからです。
このステップは、エンジニアリングチームにとってはサンドボックス環境、テスト用マシン、権限の分離を意味します。ビジネスチームにとっては、分析ツールを実行できるワークスペースを意味します。権限は最小化の原則に従うことをおすすめします。まずは読み取り専用にして、信頼できることを確認してから、書き込み権限を段階的に開放していきます。
改造その4:外部評価にこだわり、AIに自己採点させない
原文の著者の提案は非常に明確です。少なくとも2026年10月という時点では、外部検証を使い続けることを強く推奨しており、できればモデル自身が実行でき、すぐにフィードバックが得られるツールが望ましいとしています。テストケース、実際に再現した結果、ホールドアウトされた検証データセットは、「モデルが自己採点で何点付けたか」よりも信頼できます。
四半期レビューの深掘り活用法では、原文は Claude にログから顧客行動シミュレーションを構築させ、離脱を最も早く示すシグナルを見つけ出し、そしてモデルが見たことのないデータでそのシグナルに本当に予測力があることを証明させるよう指示しています。これが外部評価の標準的な形です。結論は、モデルの外側にある検証に耐えなければなりません。
変革その5:並行運用期間と終了条件を設計する
L3レベルの委任には、重要なアクションが一つあります。新しい仕組みを既存のプロセスと1四半期にわたって並行運用することです。これは単なる慎重さにとどまらず、外部からの評価でもあります。新しい仕組みが本当に問題をより早く発見できたかどうかは、同じ期間の旧プロセスと照らし合わせることで確認できます。
同時に、制約にも正面から向き合う必要があります。原文が率直に認めているとおり、2026年になっても「Claude、稼いでこい」の一言だけでは、ほとんどの企業にとってまだ通用しません。だからこそ各結果委任では、境界・チェックポイント・ロールバックの方法を明確に記述すべきであり、一度にすべてを丸投げするべきではありません。
AIに結果を任せるクイックスタート:コードを書かない委任フロー
以下のフローはプログラミングに一切依存せず、プロダクト・運営・分析・エンジニアリングの各チームがそのまま適用できます。
ステップ1:この作業はAIに結果を任せる価値があるかを見極める
まず3つの質問でスクリーニングします。この作業は後で会議で話し合う必要がありますか? 創造的な産出だけでなく、明確な最終結果がありますか? 周期的に繰り返されますか? 原文は、目標のレベルを上げることは最終結果を追求するときに最も有用であり、創作系の仕事にはそれほど適さないと指摘しています。3つの質問のうち2つが「はい」なら、試す価値があります。
ステップ2:結果委託の仕様書を記入する
長いプロンプトを書くよりも、委託を固定フィールドに分解しましょう。以下の仕様書の構造はそのまま再利用できます。
| フィールド | 記入内容 | 例(クラッシュ対策) |
|---|---|---|
| 最終結果 | 本当に実現したいこと | アプリが3大プラットフォームで安定する |
| 結果の背景にある目標 | さらに一段上の意図 | クラッシュによるユーザー離脱を減らす |
| 利用可能なデータ | 元資料の一覧と取得方法 | クラッシュレポート、バージョンとコミットのマッピング |
| 利用可能な環境 | AIが操作できるマシンとツール | Windows、macOS、Linuxのテストマシン |
| 外部検証 | 誰または何が結果の正しさを証明するか | 安定して再現でき、修正が有効であることを検証できる |
| 境界とロールバック | 越えてはならない線と失敗時のプラン | テストブランチのみ変更し、手動でマージ |
| 挑戦目標 | 一見不合理な高い基準 | 原文の例:読み込み時間を10秒からいきなり200ミリ秒に要求する |
「挑戦目標」の欄は原文の深い提案に由来します。一見不合理な目標を設定し、それが完全に合理的だとモデルに伝えるのです。モデルができないと考えるなら、問題は解決可能であり、ただ努力を続けるだけでよいと改めて強調します。心理学では、LockeとLathamが35年にわたる目標設定理論の研究を整理した結論もこれを支持しています。具体的で挑戦的な目標は、漠然とした「最善を尽くす」よりも優れているというものです。
ステップ3:「深掘り四問」で委託内容を書き換える
原作者はよく使うプロンプトの考え方を共有しています。核心は、タスクを書き換える前に、まずモデルに四つの問いへ答えさせることです。自分の言葉で表すと、次のようになります。
私はこのタスクを、規模を大きくするのではなく、より深くやりたいと考えています。着手する前に次に答えてください。一、この分野のトップ専門家なら、私が指示していないどんなことをするでしょうか。二、彼らはどの最も原初的な資料から入るでしょうか。三、彼らは具体的にどんな方法とツールを使うでしょうか。四、あなたと私の判断以外に、結果が正しいことを証明できるものは何でしょうか。そのうえで私の委託内容を書き換えてください。
この四つの問いは、前述の改造項目——元データ、専門ツール、外部評価——にそれぞれ対応しています。モデルが答えたギャップこそ、あなたのワークフローに補うべき欠けている環であることが多いのです。
ステップ4:モデルの接続方法を選ぶ
結果の委託は通常、長時間・多ターンで実行されるため、モデル接続の安定性と切り替えコストが実装に直接影響します。APIYI は本記事で扱う Claude シリーズをはじめとする主要モデルの API 呼び出しを提供しており、OpenAI と Anthropic の両方のインターフェース形式に対応しています。既存の SDK や Agent フレームワークは通常、base_url と APIキーを差し替えるだけで接続できます。具体的なアドレスとパラメータは APIYI のドキュメント docs.apiyi.com を参照してください。
| 接続ニーズ | 推奨方法 | 説明 | 利用可能なプラットフォーム |
|---|---|---|---|
| 既存の OpenAI SDK プロジェクト | OpenAI 互換形式 | base_url と APIキーを変更 | APIYI apiyi.com、公式 API |
| Claude のネイティブ機能を使う | Anthropic 互換形式 | Anthropic のメッセージ構造をそのまま利用 | APIYI apiyi.com、公式 API |
| 複数モデルの比較検証 | 統一インターフェースでモデル名を切り替え | 同一ワークフローで異なるモデルを比較 | APIYI apiyi.com |
| コスト試算 | 価格ページを確認 | 入力・出力・キャッシュの単価は価格ページに準拠 | 価格ページ:https://docs.apiyi.com/models |
🚀 導入のヒント:結果の委託は、まず小規模でクローズドループを回し、それから徐々に拡大するのがよいでしょう。APIYI apiyi.com を通じて、まず統一インターフェースで1〜2個のモデルに接続し、比較テストを行うことをおすすめします。モデル価格、課金基準、入出力単価、キャッシュ価格について、本記事では具体的な数字を挙げません。すべて APIYI 価格ページ https://docs.apiyi.com/models の実際のデータに準拠します。
結果をAIに委ねて広げる:仮想チームを招集する
高さと深さが十分に確保できたら、最後に「驚き」を生み出せるかどうかを決めるのは広がりです。元の記事では2つの方法が勧められており、どちらも結果委託の仕様書にそのまま書き込むことができます。
1つ目は名詞を動詞に置き換えるという方法で、『イノベーションのアート』(The Art of Innovation)に由来します。四半期レビューは「スライド一式」ではなく、「30分で忙しい人たちに因果関係の説明を納得させ、不確実な状況の中で意思決定してもらうこと」です。仕事を動作で描写すると、どの領域が独自の視点を提供できるのかを、あなたもAIも見つけやすくなります。
2つ目はチームを招集することです。このレビューが絶対に素晴らしいものでなければならないとしたら、あなたは誰を呼びますか。元記事の答えはアナリスト、ジャーナリスト、エディター、必要に応じてモーショングラフィックスデザイナーやオーディオデザイナー、さらに空売り投資家や法務会計士で構成される「レッドチーム」です。マルチセッションやサブエージェントを使えば、今日ではそれほどコストはかかりません。
注意すべきはロールプレイの罠です。会話はどんどん華やかになるのに、成果は良くならないという状況です。元記事が促しているのは、空売り投資家の口調を真似て書かせるのではなく、空売り投資家が対象を調べるときに実際に使う手法をモデルに採用させることです。
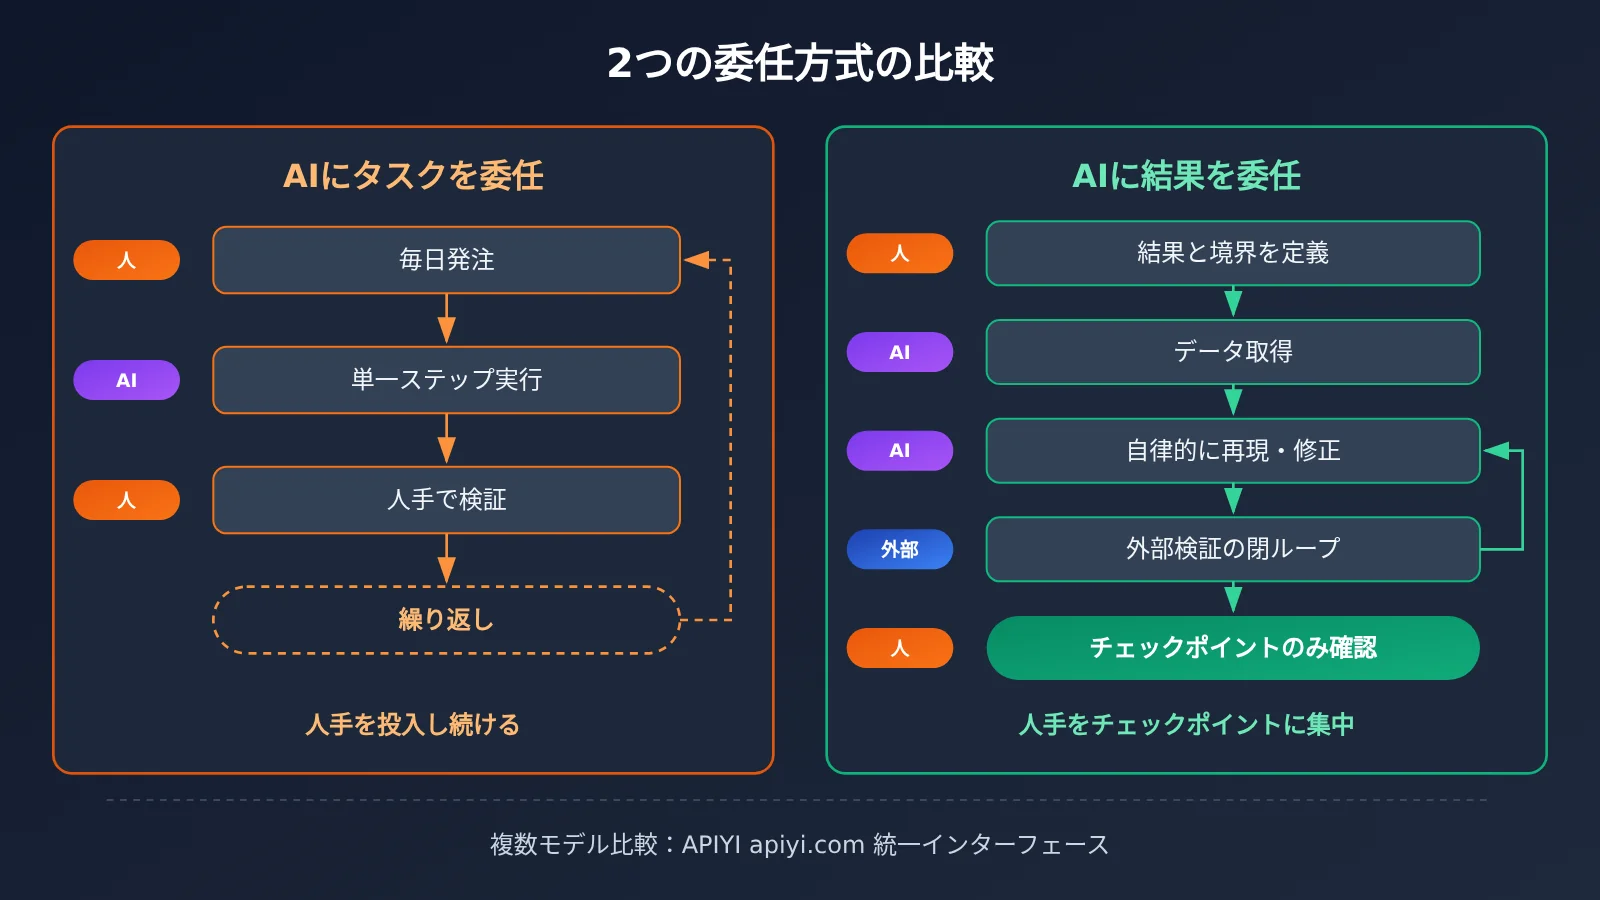
上の図は、2つの委託方法における人的投入の構造を比較したものです。結果委託の場面でモデルごとの安定性の違いを検証したい場合は、APIYI apiyi.com から同じワークフローでモデル名を切り替えて比較でき、接続作業の重複を減らせます。
よくある質問(FAQ)
Q1:「AIに結果を委ねる」とはどういう意味ですか?
AIに個別の具体的なタスクを指示するのではなく、最終的に得たい結果と必要な条件を渡し、その分解・実行・検証までをAI自身に任せることを指します。たとえば「このクラッシュを修正して」から「アプリを安定稼働させ、クラッシュしない状態を維持して」へと変わり、人は目標・境界・チェックポイントの定義だけを担います。
Q2:「AIに結果を委ねる」と通常のAI Agent自動化は何が違うのですか?
自動化は通常、固定された手順をつなぎ合わせるもので、手順そのものは人が設計します。「AIに結果を委ねる」場合は「どの方法を選ぶか」までAIに任せるため、四半期レビューの仕組みそのものを再設計するといったことが可能になります。前者は実行効率を最適化し、後者は仕事の抽象度を一段引き上げます。
Q3:現在のモデルは本当に結果の委託を担えるのですか?
一部は可能です。原文の著者は、モデルの能力が高いほどより高い抽象度で作業できるようになり、この次元で長期間にわたり継続的な介入なしに動き続けるワークフローが見つかりつつあると観察しています。ただし2026年時点では、「儲けてきて」のような完全にオープンな目標は大多数の企業にとって依然として機能せず、境界や外部検証と組み合わせる必要があるとも率直に述べています。
Q4:どのような仕事が「AIに結果を委ねる」のに最も適していますか?
主に次のような場面が適しています。
– **安定性のガバナンス**:クラッシュ監視・再現・修正検証のループ
– **経営分析**:四半期レビューから、問題の早期警告を継続的に行う仕組みへのアップグレード
– **ユーザー離脱の研究**:生ログから最も早い離脱シグナルを見つけ、予測力まで検証する
– 判断の目安:成果物のあとにまだ会議での議論が必要になるものは、たいてい一段上の抽象度に引き上げる価値があります
Q5:APIを使って結果委託のワークフローを素早く構築するには?
まず統一インターフェースで最小限のループを通すことをおすすめします。
1. APIYI apiyi.com で登録し、APIキーを取得する
2. APIYI のドキュメント docs.apiyi.com を参照し、OpenAI または Anthropic 互換形式で base_url を設定する
3. 本記事の結果委託仕様書を使って小範囲の目標を定義し、データソースに接続する
4. 外部検証を加え、1サイクルを回し切ってから範囲を広げる
Q6:長時間稼働する結果委託のコストはどう見積もればよいですか?
結果委託では多数のマルチターン呼び出しが発生するため、まず小範囲で実際のトークン消費量を記録し、そこから単価で推計するのがおすすめです。単価・課金の基準・キャッシュ価格については、APIYI の価格ページ https://docs.apiyi.com/models の実際のデータを参照してください。本記事では具体的な数値は示しません。繰り返し使う長いコンテキストについては、価格ページのキャッシュ課金の説明に注目するとよいでしょう。
Q7:「AIに結果を委ねる」ことにはどんな既知のリスクがありますか?
主に3つあります。1つ目は、モデルの自己評価は信頼できないため、外部の評価を必ず導入する必要があること。2つ目は、対象を広げすぎると単なるロールプレイになり、見た目は派手でも役に立たない成果物になりがちなこと。3つ目は、権限が大きすぎると操作上のリスクが生じるため、まずは読み取り専用から始め、徐々に書き込み権限を開放し、各委託には並行運用期間とロールバック手段を設計すべきことです。
結果をAIに委ねる 核心的なポイント Key Takeaways
- タスクにはあなたの判断が含まれている:結果を委ねてこそ、AIはあなたより良い方法を選べる
- 会議は一段上がるシグナル:成果物がまだ会議での議論を必要とするなら、目標をもう一段引き上げる価値がある
- 閉ループの3要素:生データ、手を動かせる環境、外部検証、この3つが欠かせない
- 深さは専門ツールで:Markdownの表ではなく、データベースや統計モデルにこだわる
- 広さは方法の借用で:他の領域の本物の手法を借りる。口調を真似るのではない
- 並行運用でリスク低減:新しい仕組みは旧プロセスと1サイクル並行してから切り替える
- 接続と課金:APIYIの統一インターフェースから接続可能。価格は docs.apiyi.com/models を参照
まとめ
「タスクをAIに渡すより、結果をAIに委ねる」の核心的なポイント:
- まず高さを上げる:目の前のタスクの背後で本当に起きてほしい結果を問い直し、L0のテンプレート埋めからL3の仕組み再設計へと段階的に進む
- 次にワークフローを変える:生データを通し、追跡可能なマッピングを構築し、手を動かせる環境を提供し、外部評価にこだわり、並行運用と撤退の設計を行う
- 最後に深さと広さを広げる:深さを問う4つの質問で専門手法を補い、仮想チームで領域横断的な視点を取り入れる
周期的で会議での議論が必要な小さなシーンから始め、結果委託仕様書で1サイクルをフルに走らせてから、範囲を広げるかどうかを決めることをおすすめします。モデルの接続については、APIYI apiyi.com で素早く効果を検証するのがおすすめです。Claudeなど主要モデルのAPI呼び出しを提供し、OpenAIとAnthropicのインターフェース形式に互換しています。接続の詳細はドキュメント docs.apiyi.com を、価格は https://docs.apiyi.com/models を参照してください。
📚 参考資料
- より大胆に目標を定める方法:AI ユーザーのための実践ガイド:InfoQ 中国語訳
- リンク:
infoq.cn/article/F1ms7x7KI1p7UfocCywh -
説明: 本記事の中心的な視点、ならびに破綻対応と四半期レビューの事例の出典
-
How to be more ambitious: A tutorial for humans with models:Felix Rieseberg 英語原文
- リンク:
felixrieseberg.com/how-to-be-more-ambitious-a-tutorial-for-humans-with-models -
説明: 速度・高さ・深さ・広さという4つの次元についての詳細な論述
-
APIYI ドキュメントセンター:インターフェース形式と接続方法の説明
- リンク:
docs.apiyi.com -
説明: OpenAI および Anthropic 互換形式の設定方法
-
APIYI モデル価格ページ:モデルの単価と課金基準
- リンク:
docs.apiyi.com/models - 説明: 入力・出力・キャッシュの価格は、このページの実際のデータに準じます
作者: APIYI 技術チーム
技術交流: APIYI ウェブサイトのトップページからぜひお問い合わせください。成果委託の実践経験について意見交換しましょう。詳細な資料は docs.apiyi.com ドキュメントセンターをご覧ください。