作者注:從“修一個崩潰”到“讓應用不再崩潰”,本文拆解把結果交給 AI 之前,工作流必須先完成的 5 項改造,並給出一套不寫代碼的落地流程。
很多團隊已經天天用 AI 寫郵件、改文案、做 PPT,但總覺得它的價值不止於此。問題往往不在模型,而在我們交出去的東西太小了:交出去的是一個任務,而不是一個結果。本文藉助 Claude 開發者 Felix Rieseberg 近期分享的實踐思路,介紹 從“委託任務”升級到“委託結果”的工作流改造方法。
這不是又一篇提示詞技巧合集。提示詞寫得再好,如果 AI 拿不到數據、碰不到環境、沒有外部驗證,它也只能在你劃定的小格子裏打轉。真正要先改的,是工作流本身。
核心價值:讀完本文,你會知道哪些工作值得“把結果交給 AI”,以及在交出去之前,需要先補齊哪 5 項基礎條件,才能讓 AI 長期獨立運轉。
把任務交給 AI 與把結果交給 AI 的核心要點
Felix Rieseberg 把使用 AI 時的“雄心”拆成四個維度:速度、高度、深度和廣度。其中“速度”是最成熟的用法,而“把結果交給 AI”主要對應的是“高度”這一維度,深度和廣度則決定了結果的質量上限。
| 維度 | 含義 | 典型做法 | 對工作流的要求 |
|---|---|---|---|
| 速度 | 用更少時間完成同樣的工作 | 讓 AI 更快寫代碼、寫文檔 | 低,現有流程即可 |
| 高度 | 關注最終結果,而非眼前任務 | 從“修這個 Bug”變成“讓應用不崩潰” | 高,需要數據通道和驗證環境 |
| 深度 | 像領域頂尖專家一樣思考 | 用數據庫和統計模型代替 Markdown 表格 | 中高,需要原始數據和專業工具 |
| 廣度 | 借用其他領域的方法 | 引入記者、編輯、做空投資者的方法論 | 中,需要多會話或子智能體 |
爲什麼把結果交給 AI 首先是工作流問題
當你給模型佈置一項任務時,它執行的其實是“你目前認爲最有可能實現目標的辦法”。也就是說,任務本身已經包含了你的判斷,模型只是執行者。想往上走一層,就要問自己:接下來我真正希望發生什麼?眼前這個目標背後,還有什麼更大的目標?
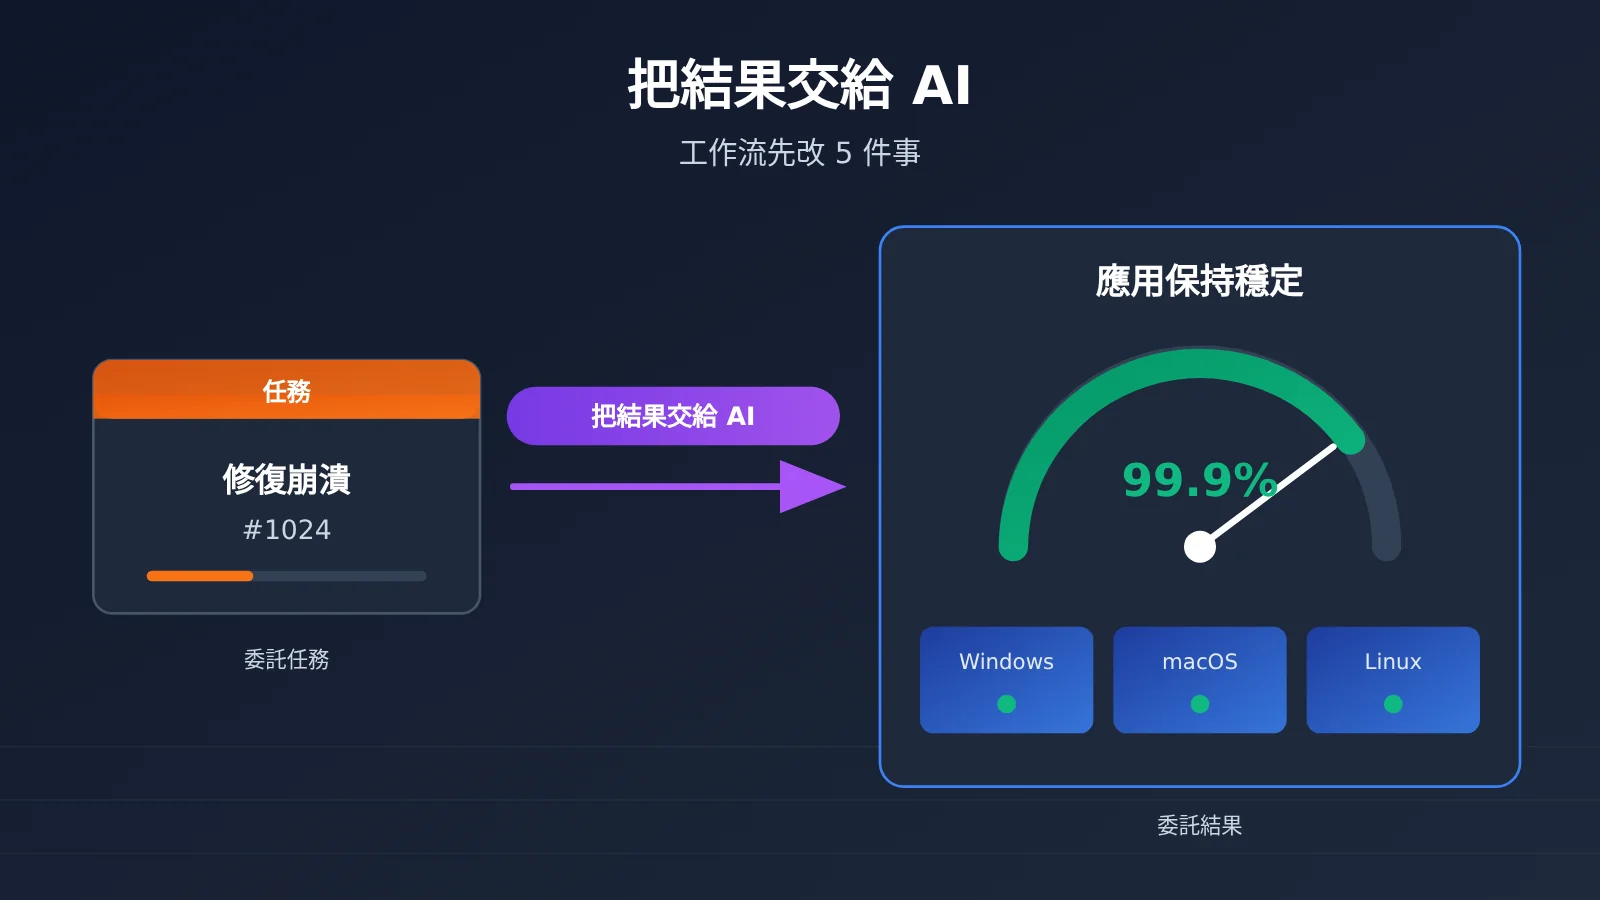
原文給出了一個很具體的例子。作者早先讓 Claude 幫忙修復一個個具體的崩潰問題,後來乾脆讓它負責“讓應用保持穩定、不再崩潰”。但這一步不是改一句提示詞就能完成的:他得先確保 Claude 能方便地獲取崩潰報告,知道每個應用版本對應哪一次 Git 提交,還要能使用 Windows、macOS 和 Linux 電腦。只有這樣,它才能獨立復現問題,並驗證修復是否有效。
這就是本文的核心判斷:把結果交給 AI,前提是 AI 擁有閉環所需的輸入、動手能力和驗證手段。缺了任何一環,結果委託都會退化成任務委託,你又回到了不停給它派活的狀態。
把結果交給 AI 的三級躍遷:以季度覆盤爲例
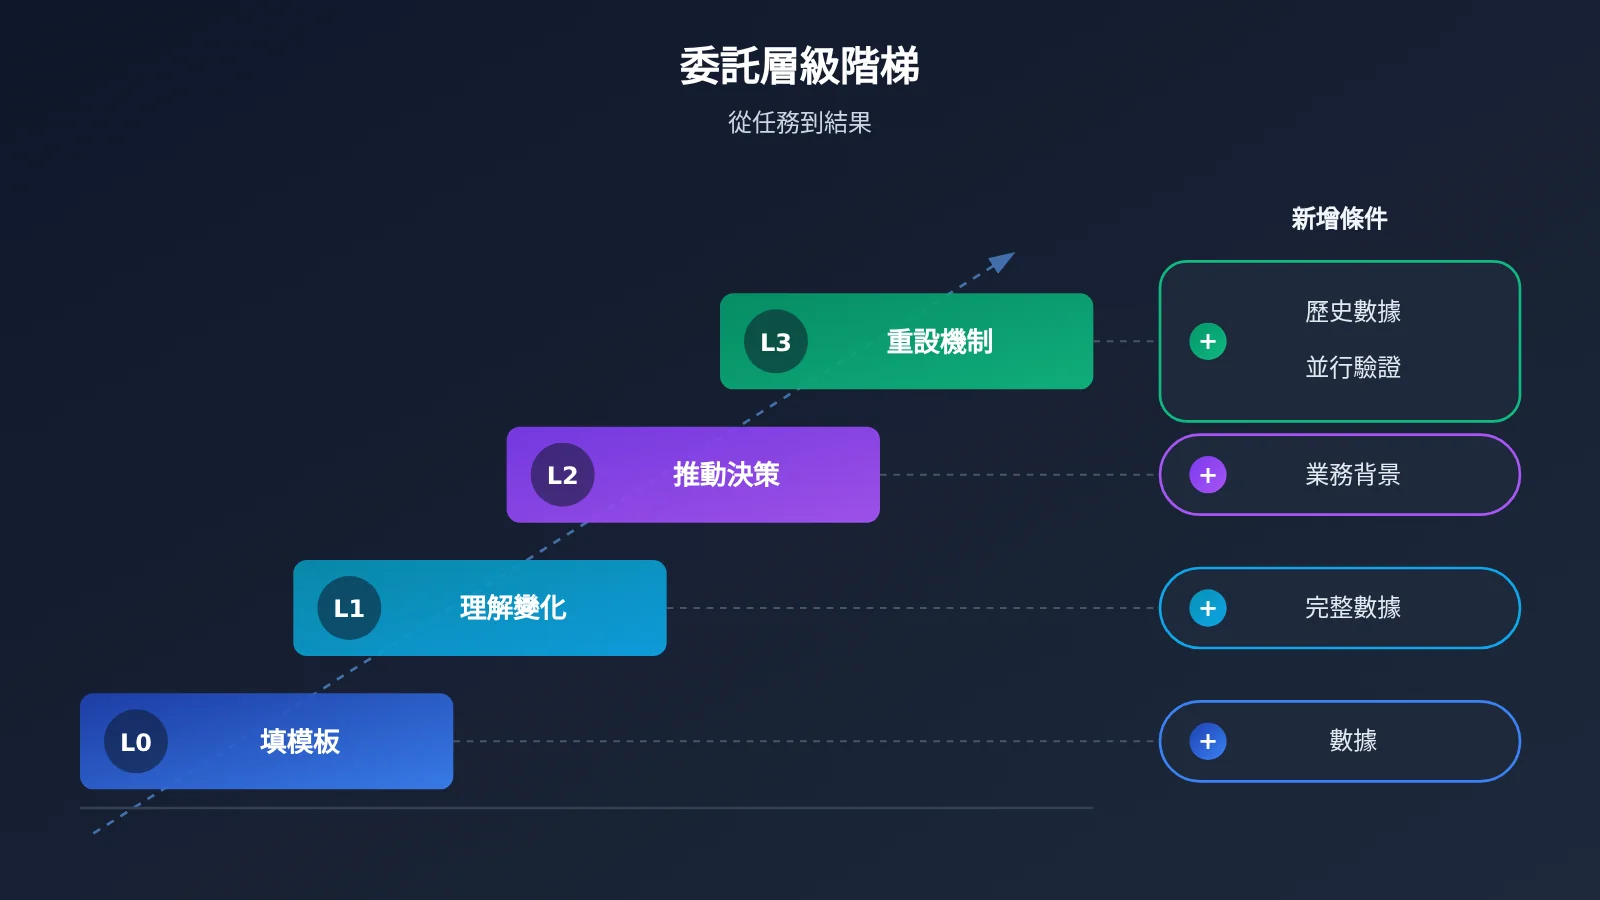
原文用一個“有點乏味”的辦公室任務做示範:爲虛構公司 Acme 製作季度業務覆盤(QBR)幻燈片。同一件事,可以從低到高分出三個層級。
| 層級 | 你交給 AI 的內容 | 典型說法 | AI 需要的條件 |
|---|---|---|---|
| L0 任務 | 往模板裏填數字 | “把這些數據做成幻燈片” | 一份整理好的數據 |
| L1 理解 | 弄清楚發生了什麼 | “告訴我這個季度變了什麼、爲什麼、該怎麼辦” | 儘可能完整的業務數據 |
| L2 決策 | 推動會議作出決定 | “找出最迫切的三個決策,列出支持與反對理由” | 數據加上業務背景與約束 |
| L3 機制 | 重新設計覆盤本身 | “設計比季度幻燈片更好的辦法,用歷史數據證明它能更早發現問題,並與現有流程並行一個季度” | 歷史數據、運行環境、對照驗證 |
到了 L3,交出去的已經不是“一套幻燈片”,而是“讓管理層儘早發現問題、把資金和人力配置到合適地方”這個結果。原文給了一個很好用的判斷信號:如果你正在做的東西,之後還需要開會討論,那麼很可能值得把目標再往上提一層。
把結果交給 AI 之前,工作流需要先改的 5 件事
綜合原文的崩潰治理和季度覆盤兩個案例,可以歸納出 5 項必須先改的基礎設施。下表把兩個案例放在一起對照,方便你映射到自己的業務。
| 改造項 | 崩潰治理案例 | 季度覆盤案例 | 自檢問題 |
|---|---|---|---|
| 1. 原始數據通道 | 可直接讀取崩潰報告 | 可訪問原始業務日誌和用戶數據 | AI 拿到的是原始材料還是二手摘要? |
| 2. 可追溯映射 | 版本號對應 Git 提交 | 指標口徑對應數據來源 | AI 能否從現象追溯到原因? |
| 3. 可動手的環境 | 三大操作系統的測試機器 | 能安裝軟件、跑數據庫和統計模型 | AI 能否自己復現和實驗? |
| 4. 外部評判 | 修復後實際不再崩潰 | 用模型沒見過的數據驗證預測力 | 結果是否由 AI 之外的東西證明? |
| 5. 並行與退出 | 修復先在測試環境驗證 | 新機制與舊流程並行一個季度 | 失敗時能否無損回退? |
改造一:爲把結果交給 AI 打通原始數據通道
原文在“深度”部分反覆強調:頂尖專業人士會從最原始的材料入手,而不是使用已經被整理、加工過的信息。商業領域裏很多“公認事實”其實只是對現實的粗略近似,如果你只給 AI 一份別人做好的彙總表,它就只能在這份近似之上推理。
實際操作時,可以先列一張“AI 可讀數據清單”:日誌、工單、崩潰報告、數據庫只讀賬號、歷史文檔等。原文提到,可以通過 MCP 連接器或其他途徑讓模型獲取相關數據,目前已有不少工具提供這類能力,選一個用起來比反覆手工粘貼可靠得多。
改造二:建立從現象到原因的可追溯映射
崩潰案例裏,“每個應用版本對應哪一次 Git 提交”看起來是個細節,但它決定了 AI 能不能從一份崩潰報告定位到具體代碼改動。沒有這層映射,AI 只能猜,猜錯了你還得人工介入。
放到業務場景,就是指標口徑要能追溯到數據源。比如“流失率”到底按什麼時間窗口、哪類用戶計算,必須對 AI 透明。映射越清晰,AI 在更高抽象層次上工作時越不容易偏離。
改造三:給 AI 一臺能動手的電腦
原文說得很直接:前面所有做法都有一個前提,模型需要能夠使用一臺電腦,可以安裝軟件,也能獲取各種相關數據。當 Claude 準備拿 Markdown 表格應付分析時,要堅持讓它使用數據庫和統計模型,因爲“讓模型表現得像專家”往往只換了一套詞彙,並沒有換工作方法。
這一步對工程團隊意味着沙箱環境、測試機和權限隔離;對業務團隊意味着一個可以運行分析工具的工作空間。權限建議遵循最小化原則:先只讀,驗證可靠後再逐步放開寫權限。
改造四:堅持外部評判,不讓 AI 自己給自己打分
原文作者的建議非常明確:至少在 2026 年 10 月這個時間點,強烈建議堅持使用外部驗證,最好是模型能夠自行運行、並立即獲得反饋的工具。測試用例、真實復現結果、留出的驗證數據集,都比“模型自評打幾分”可靠。
在季度覆盤的深度玩法裏,原文讓 Claude 根據日誌構建客戶行爲模擬,找出最早預示流失的信號,然後用它沒見過的數據證明這個信號確實有預測能力。這就是外部評判的標準形態:結論必須經得起模型之外的檢驗。
改造五:設計並行運行期和退出條件
L3 級別的委託有一個關鍵動作:讓新機制與現有流程並行運行一個季度。這不僅是謹慎,也是一種外部評判,新機制是否真的更早發現了問題,可以用同期的舊流程做對照。
同時也要正視限制。原文坦言,到了 2026 年,單憑一句“Claude,去賺錢吧”對大多數企業還行不通。所以每個結果委託都應該寫清楚邊界、檢查點和回退方式,而不是一次性全盤交出去。
把結果交給 AI 的快速上手:一份不寫代碼的委託流程
下面這套流程不依賴任何編程,適合產品、運營、分析和工程團隊直接套用。
第一步:判斷這項工作是否值得把結果交給 AI
先用三個問題篩選:這項工作之後還需要開會討論嗎?它是否有明確的最終結果,而不只是創作產出?它是否會週期性重複?原文指出,提高目標層次在追求最終結果時最有用,對創作類工作適用性沒那麼強。三個問題裏有兩個答“是”,就值得嘗試。
第二步:填寫一份結果委託說明書
與其寫一段長提示詞,不如把委託拆成固定字段。下面這份說明書結構可以直接複用。
| 字段 | 填寫內容 | 示例(崩潰治理) |
|---|---|---|
| 最終結果 | 你真正希望發生什麼 | 應用在三大平臺保持穩定 |
| 結果背後的目標 | 再往上一層的意圖 | 減少用戶因崩潰流失 |
| 可用數據 | 原始材料清單與獲取方式 | 崩潰報告、版本與提交映射 |
| 可用環境 | AI 能操作的機器和工具 | Windows、macOS、Linux 測試機 |
| 外部驗證 | 由誰或什麼證明結果正確 | 能穩定復現並驗證修復有效 |
| 邊界與回退 | 不可越過的線和失敗方案 | 僅改測試分支,人工合併 |
| 挑戰目標 | 一個看似不合理的高標準 | 原文示例:加載時間從 10 秒直接要求到 200 毫秒 |
“挑戰目標”這一欄來自原文的深度建議:定一個看起來不合理的目標,並告訴模型這完全合理。如果模型認爲做不到,就再次強調問題可以解決,它只需繼續努力。心理學上 Locke 和 Latham 梳理 35 年目標設定研究後的結論也支持這一點:具體而有挑戰性的目標,優於籠統的“盡力而爲”。
第三步:用“深度四問”改寫你的委託
原文作者分享過一段常用提示思路,核心是在改寫任務之前,先讓模型回答四個問題。可以用自己的話表達成這樣:
我想把這項任務做得更深入,而不是規模更大。動手前請先回答:一、這個領域的頂尖專業人士會做哪些我沒提出要求的事?二、他們會從哪些最原始的材料入手?三、他們具體用什麼方法和工具?四、除了你我的判斷,還有什麼能證明結果正確?然後據此重寫我的委託。
這四問分別對應前面的改造項:原始數據、專業工具、外部評判。模型回答出來的缺口,往往就是你工作流裏該補的那一環。
第四步:選擇模型接入方式
結果委託通常是長時間、多輪次運行,模型接入的穩定性和切換成本會直接影響落地。API易 提供本文涉及的 Claude 系列以及其他主流模型的 API 調用,同時兼容 OpenAI 與 Anthropic 兩種接口格式,已有的 SDK 或 Agent 框架通常只需替換 base_url 和 API Key 即可接入,具體地址與參數以 API易 文檔 docs.apiyi.com 爲準。
| 接入需求 | 推薦方式 | 說明 | 可用平臺 |
|---|---|---|---|
| 已有 OpenAI SDK 的項目 | OpenAI 兼容格式 | 修改 base_url 與 API Key | API易 apiyi.com、官方 API |
| 使用 Claude 原生能力 | Anthropic 兼容格式 | 沿用 Anthropic 消息結構 | API易 apiyi.com、官方 API |
| 多模型對比驗證 | 統一接口切換模型名 | 同一工作流對照不同模型 | API易 apiyi.com |
| 成本測算 | 查看價格頁 | 輸入、輸出、緩存單價以價格頁爲準 | 價格頁:https://docs.apiyi.com/models |
🚀 上手建議:結果委託往往要先在小範圍跑通閉環,再逐步放大。建議通過 API易 apiyi.com 先用統一接口接入一到兩個模型做對照測試。關於模型價格、計費口徑、輸入輸出單價和緩存價格,本文不列具體數字,一律以 API易 價格頁 https://docs.apiyi.com/models 的實際數據爲準。
把結果交給 AI 的廣度擴展:召集一支虛擬團隊
當高度和深度都到位後,廣度決定了結果能不能帶來驚喜。原文推薦了兩種方法,都可以直接寫進結果委託說明書裏。
第一種是把名詞換成動詞,出自《創新的藝術》。季度覆盤不是“一套幻燈片”,而是“在 30 分鐘內讓一羣忙碌的人相信一套因果解釋,並在不確定中作出決策”。用動作描述工作後,你和 AI 都更容易看出哪些領域能提供獨特視角。
第二種是召集你的團隊。假設這份覆盤必須精彩絕倫,你會找誰?原文的答案是分析師、記者和編輯,必要時再加動態圖形設計師和音頻設計師,以及一支由做空投資者、法務會計師組成的“紅隊”。藉助多會話或子智能體,這在今天已經不再昂貴。
需要警惕的是角色扮演陷阱:對話越來越花哨,成果卻沒有變好。原文的提醒是,別讓模型模仿做空投資者的口吻寫作,而要讓它採用做空投資者研究標的時真正使用的方法。
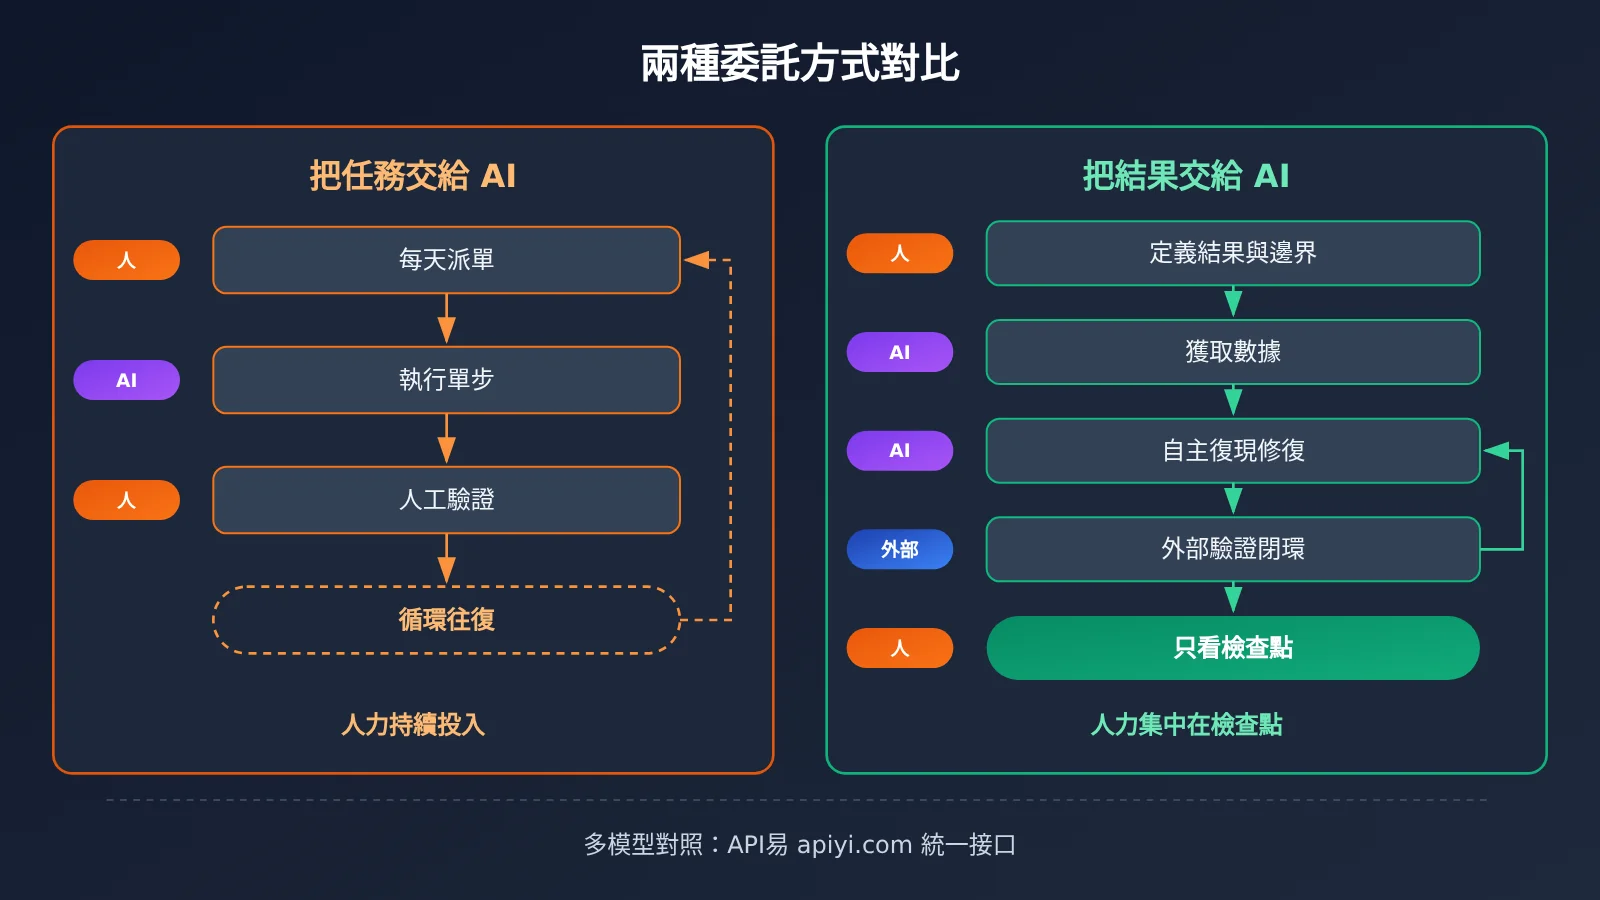
上圖對比了兩種委託方式的人力投入結構。如果你想驗證不同模型在結果委託場景下的穩定性差異,可以通過 API易 apiyi.com 用同一套工作流切換模型名做對照,減少重複接入的工作量。
常見問題 FAQ
Q1:什麼是“把結果交給 AI”?
指不再給 AI 佈置單個具體任務,而是交給它一個最終結果和必要條件,讓它自己拆解、執行和驗證。比如從“修復這個崩潰”變成“讓應用保持穩定不再崩潰”,人只負責定義目標、邊界和檢查點。
Q2:把結果交給 AI 和普通的 AI Agent 自動化有什麼區別?
自動化通常是把固定步驟串起來,步驟本身仍由人設計。把結果交給 AI 則把“選什麼辦法”也交了出去,AI 可以重新設計流程本身,比如重新設計季度覆盤機制。前者優化執行效率,後者提升工作的抽象層次。
Q3:現在的模型真的能承擔結果委託嗎?
部分可以。原文作者觀察到,模型能力越強,越能在更高抽象層次上工作,人們也正在這一維度找到長期運轉、無需持續介入的流程。但他也坦言,到 2026 年,“去賺錢吧”這種完全開放的目標對大多數企業仍行不通,需要配合邊界和外部驗證。
Q4:哪些工作最適合把結果交給 AI?
主要適合以下場景:
– **穩定性治理**:崩潰監控、復現、修復驗證的閉環
– **經營分析**:從季度覆盤升級爲持續的問題早期預警
– **用戶流失研究**:從原始日誌中尋找最早的流失信號並驗證預測力
– 判斷信號:產出物之後還要開會討論的,通常都值得提一層
Q5:如何通過 API 快速搭建結果委託的工作流?
推薦先用統一接口跑通最小閉環:
1. 在 API易 apiyi.com 註冊並獲取 API Key
2. 查閱 API易 文檔 docs.apiyi.com,按 OpenAI 或 Anthropic 兼容格式配置 base_url
3. 用本文的結果委託說明書定義一個小範圍目標並接入數據源
4. 加入外部驗證,跑滿一個週期後再擴大範圍
Q6:長時間運行的結果委託,成本怎麼估算?
結果委託會產生大量多輪調用,建議先在小範圍記錄實際 Token 消耗,再按單價推算。單價、計費口徑以及緩存價格請以 API易 價格頁 https://docs.apiyi.com/models 的實際數據爲準,本文不提供具體數字。重複使用的長上下文可關注價格頁中的緩存計費說明。
Q7:把結果交給 AI 有哪些已知風險?
主要有三類:一是模型自評不可靠,必須引入外部評判;二是廣度擴展容易變成角色扮演,產出花哨但無用;三是權限過大帶來操作風險,建議先只讀、再逐步放開寫權限,併爲每個委託設計並行期和回退方案。
把結果交給 AI 核心要點 Key Takeaways
- 任務包含了你的判斷:交出結果,才能讓 AI 選擇比你更好的辦法
- 會議是提層信號:產出還需要開會討論,就值得把目標再往上提一層
- 閉環三要素:原始數據、可動手環境、外部驗證缺一不可
- 深度靠專業工具:堅持數據庫和統計模型,而不是 Markdown 表格
- 廣度靠方法借用:借其他領域真正的方法,而不是模仿口吻
- 並行運行降風險:新機制與舊流程並行一個週期再切換
- 接入與計費:可通過 API易 統一接口接入,價格以 docs.apiyi.com/models 爲準
總結
“把任務交給 AI,不如把結果交給 AI”的核心要點:
- 先提高度:問清楚眼前任務背後真正希望發生的結果,從 L0 填模板逐級走到 L3 重設機制
- 再改工作流:打通原始數據、建立可追溯映射、提供可動手環境、堅持外部評判、設計並行與退出
- 最後拓深度和廣度:用深度四問補齊專業方法,用虛擬團隊引入跨領域視角
建議從一個週期性、需要開會討論的小場景開始,用結果委託說明書跑滿一個週期,再決定是否擴大範圍。模型接入方面,推薦通過 API易 apiyi.com 快速驗證效果:它提供 Claude 等主流模型的 API 調用,兼容 OpenAI 與 Anthropic 接口格式,接入細節見文檔 docs.apiyi.com,價格以 https://docs.apiyi.com/models 爲準。
📚 參考資料
- 如何把目標定得更大膽:寫給 AI 使用者的實踐指南:InfoQ 中文譯文
- 鏈接:
infoq.cn/article/F1ms7x7KI1p7UfocCywh -
說明: 本文核心觀點與崩潰治理、季度覆盤案例的來源
-
How to be more ambitious: A tutorial for humans with models:Felix Rieseberg 英文原文
- 鏈接:
felixrieseberg.com/how-to-be-more-ambitious-a-tutorial-for-humans-with-models -
說明: 速度、高度、深度、廣度四個維度的完整論述
-
API易 文檔中心:接口格式與接入說明
- 鏈接:
docs.apiyi.com -
說明: OpenAI 與 Anthropic 兼容格式的配置方式
-
API易 模型價格頁:模型單價與計費口徑
- 鏈接:
docs.apiyi.com/models - 說明: 輸入、輸出與緩存價格以此頁實際數據爲準
作者: APIYI 技術團隊
技術交流: 歡迎在 API易 網站首頁聯繫我們交流結果委託的落地經驗,更多資料可訪問 docs.apiyi.com 文檔中心