Anmerkung des Autors: Von „einen Absturz beheben“ zu „die App nicht mehr abstürzen lassen“ – dieser Artikel zerlegt die 5 Umbauten, die der Workflow abschließen muss, bevor Ergebnisse an die KI übergeben werden, und zeigt einen Umsetzungsprozess ohne Programmieren.
Viele Teams nutzen die KI längst täglich, um E-Mails zu schreiben, Texte zu überarbeiten oder Präsentationen zu erstellen, haben aber das Gefühl, dass ihr Wert darüber hinausgeht. Das Problem liegt oft nicht am Modell, sondern daran, dass wir etwas zu Kleines übergeben: Übergeben wird eine Aufgabe, kein Ergebnis. Dieser Artikel greift die praktischen Ideen auf, die der Claude-Entwickler Felix Rieseberg kürzlich geteilt hat, und stellt die Methode zum Umbau des Workflows von „Aufgaben delegieren“ zu „Ergebnisse delegieren“ vor.
Das ist kein weiterer Artikel mit einer Sammlung von Tricks für Eingabeaufforderungen. So gut eine Eingabeaufforderung auch formuliert ist: Wenn die KI keine Daten erhält, keinen Zugriff auf die Umgebung hat und keine externe Validierung bekommt, bewegt sie sich nur in dem kleinen Rahmen, den du ihr gezogen hast. Was wirklich zuerst geändert werden muss, ist der Workflow selbst.
Der Kernnutzen: Nach diesem Artikel weißt du, welche Arbeiten es wert sind, „das Ergebnis an die KI zu übergeben“, und welche 5 Grundvoraussetzungen du vor der Übergabe erfüllen musst, damit die KI langfristig eigenständig arbeiten kann.
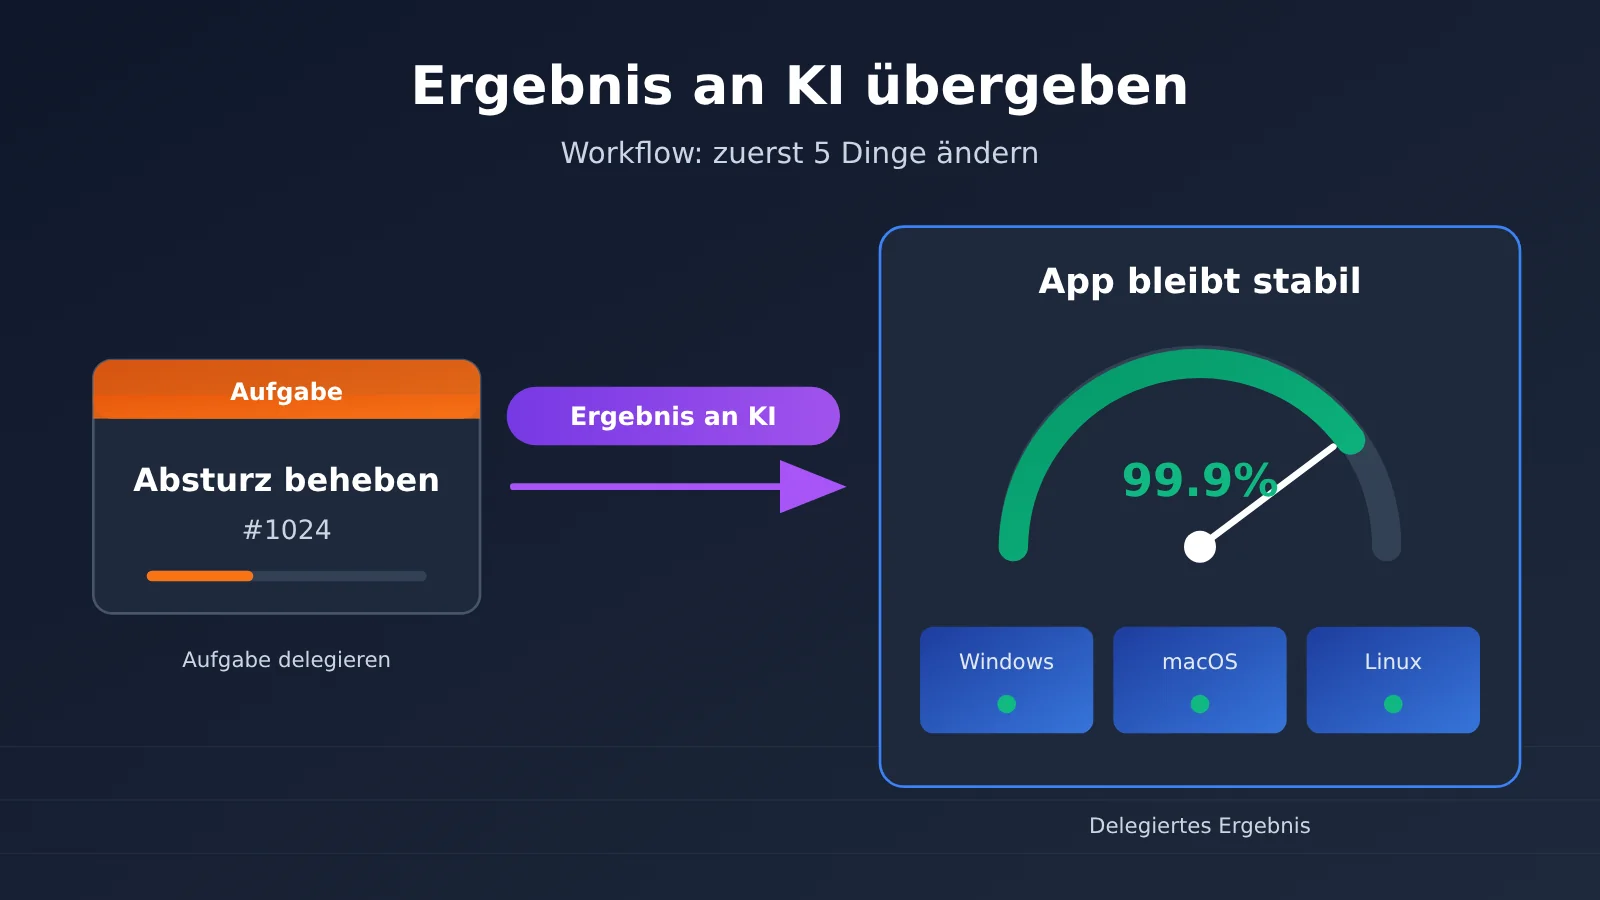
Die Kernpunkte: Aufgaben an die KI geben vs. Ergebnisse an die KI geben
Felix Rieseberg zerlegt den „Ehrgeiz“ beim Einsatz von KI in vier Dimensionen: Geschwindigkeit, Höhe, Tiefe und Breite. „Geschwindigkeit“ ist dabei die ausgereifteste Anwendung, während „das Ergebnis an die KI geben“ vor allem der Dimension „Höhe“ entspricht. Tiefe und Breite bestimmen dagegen, wie gut das Ergebnis höchstens werden kann.
| Dimension | Bedeutung | Typisches Vorgehen | Anforderungen an den Workflow |
|---|---|---|---|
| Geschwindigkeit | Dieselbe Arbeit in weniger Zeit erledigen | Die KI schneller Code und Dokumente schreiben lassen | Gering, bestehende Abläufe reichen aus |
| Höhe | Auf das Endergebnis achten, nicht auf die Aufgabe vor der Nase | Statt „fix diesen Bug“ → „die App darf nicht mehr abstürzen“ | Hoch, braucht Datenkanal und Testumgebung |
| Tiefe | Denken wie ein Spitzenexperte des Fachgebiets | Datenbanken und statistische Modelle statt Markdown-Tabellen | Mittel bis hoch, braucht Rohdaten und Fachwerkzeuge |
| Breite | Methoden aus anderen Bereichen übernehmen | Arbeitsweisen von Journalisten, Redakteuren oder Leerverkäufern einbringen | Mittel, braucht mehrere Sessions oder Sub-Agenten |
Warum „das Ergebnis an die KI geben“ zuerst ein Workflow-Problem ist
Wenn du einem Modell eine Aufgabe gibst, führt es im Grunde „den Weg aus, der aus deiner aktuellen Sicht am wahrscheinlichsten zum Ziel führt“. Die Aufgabe enthält also bereits deine Einschätzung, und das Modell ist nur der Ausführende. Willst du eine Ebene höher, musst du dich fragen: Was soll danach wirklich passieren? Welches größere Ziel steckt hinter dem Ziel, das gerade vor dir liegt?
Der Originalartikel bringt dafür ein sehr konkretes Beispiel. Der Autor ließ Claude zunächst einzelne Abstürze beheben und übergab ihm später kurzerhand die Verantwortung dafür, „die App stabil zu halten und Abstürze zu verhindern“. Dieser Schritt ist aber nicht mit einer umformulierten Eingabeaufforderung getan: Zuerst musste er sicherstellen, dass Claude bequem an die Absturzberichte kommt, dass es weiß, welche App-Version zu welchem Git-Commit gehört, und dass es Windows-, macOS- und Linux-Rechner nutzen kann. Nur so kann es Probleme selbstständig reproduzieren und prüfen, ob ein Fix tatsächlich wirkt.
Das ist die Kernaussage dieses Artikels: Das Ergebnis an die KI zu delegieren setzt voraus, dass die KI die nötigen Eingaben, die Fähigkeit zum Handeln und die Mittel zur Überprüfung für einen geschlossenen Kreislauf besitzt. Fehlt auch nur ein Glied, verkommt die Ergebnisdelegation zur Aufgabendelegation – und du bist wieder damit beschäftigt, ihr ständig neue Aufträge zuzuschieben.
Die dreistufige Entwicklung: Ergebnisse an die KI übergeben – am Beispiel einer Quartalsanalyse
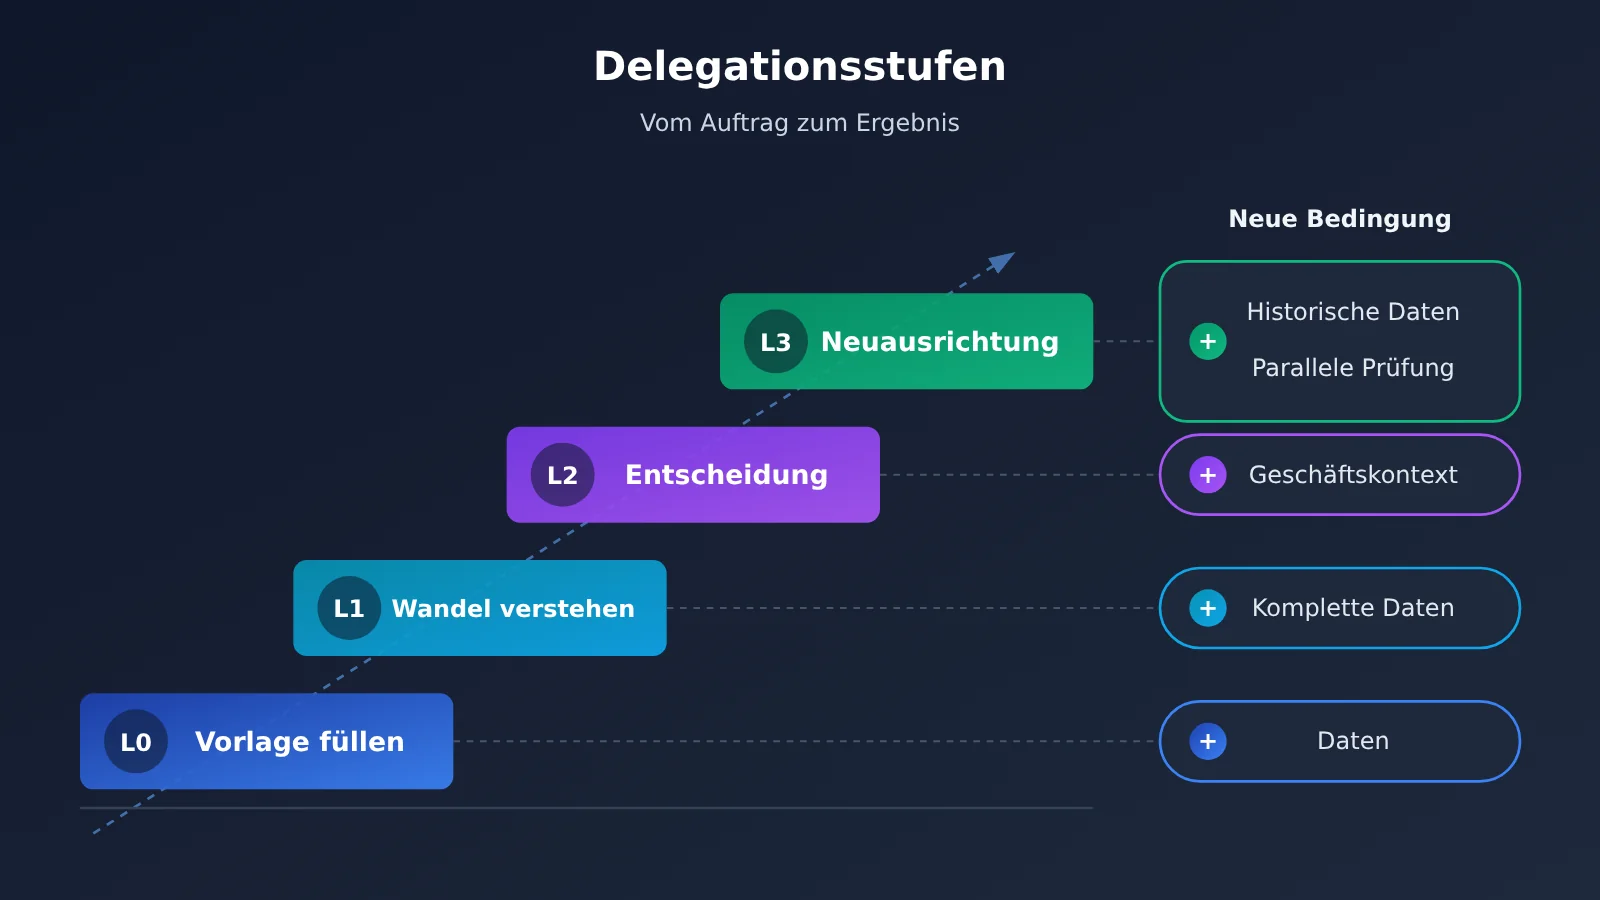
Das Original demonstriert das an einer „etwas langweiligen“ Büroaufgabe: Präsentationsfolien für die Quartalsanalyse (QBR) des fiktiven Unternehmens Acme erstellen. Dieselbe Aufgabe lässt sich in drei Stufen von niedrig bis hoch einordnen.
| Stufe | Was du der KI übergibst | Typische Formulierung | Was die KI dafür braucht |
|---|---|---|---|
| L0 Aufgabe | Zahlen in eine Vorlage eintragen | „Mach aus diesen Daten Folien“ | Einen aufbereiteten Datensatz |
| L1 Verständnis | Herausfinden, was passiert ist | „Sag mir, was sich in diesem Quartal verändert hat, warum und was zu tun ist“ | Möglichst vollständige Geschäftsdaten |
| L2 Entscheidung | Die Besprechung zu einer Entscheidung führen | „Finde die drei dringendsten Entscheidungen und liste Pro und Contra auf“ | Daten plus Geschäftskontext und Rahmenbedingungen |
| L3 Mechanismus | Die Analyse selbst neu gestalten | „Entwirf einen besseren Weg als Quartalsfolien, belege mit historischen Daten, dass er Probleme früher erkennt, und führe ihn ein Quartal lang parallel zum bestehenden Prozess“ | Historische Daten, Laufzeitumgebung, Vergleichsvalidierung |
Auf L3 übergibst du nicht mehr „einen Satz Folien“, sondern das Ergebnis: „das Management soll Probleme früher erkennen und Geld und Personal an die richtigen Stellen bringen“. Das Original liefert ein sehr brauchbares Erkennungssignal: Wenn das, woran du gerade arbeitest, anschließend noch in einer Besprechung diskutiert werden muss, dann lohnt es sich wahrscheinlich, das Ziel noch eine Stufe höher anzusetzen.
5 Dinge, die am Workflow geändert werden müssen, bevor Ergebnisse an die KI übergeben werden
Fasst man die beiden Fallbeispiele aus dem ursprünglichen Text – Crash-Management und Quartalsrückblick – zusammen, lassen sich fünf Infrastrukturmaßnahmen ableiten, die zuerst geändert werden müssen. Die folgende Tabelle stellt beide Fälle gegenüber, damit Sie sie auf Ihr eigenes Geschäft übertragen können.
| Änderungsmaßnahme | Fall Crash-Management | Fall Quartalsrückblick | Selbstprüfungsfrage |
|---|---|---|---|
| 1. Rohdatenkanal | Crash-Berichte direkt lesbar | Zugriff auf ursprüngliche Geschäftslogs und Nutzerdaten | Bekommt die KI Rohmaterial oder sekundäre Zusammenfassungen? |
| 2. Rückverfolgbare Zuordnung | Versionsnummer entspricht Git-Commit | Metrikdefinition entspricht Datenquelle | Kann die KI vom Symptom zur Ursache zurückverfolgen? |
| 3. Handlungsfähige Umgebung | Testmaschinen für die drei großen Betriebssysteme | Software installierbar, Datenbanken und statistische Modelle lauffähig | Kann die KI selbst reproduzieren und experimentieren? |
| 4. Externe Bewertung | Nach dem Fix tritt tatsächlich kein Crash mehr auf | Vorhersagekraft mit Daten validieren, die das Modell nie gesehen hat | Wird das Ergebnis durch etwas außerhalb der KI bewiesen? |
| 5. Parallelbetrieb und Rückzug | Fix wird zuerst in der Testumgebung validiert | Neuer Mechanismus läuft ein Quartal parallel zum alten Prozess | Ist bei einem Fehlschlag ein verlustfreier Rollback möglich? |
Umbau 1: Einen Rohdatenkanal öffnen, um Ergebnisse an die KI zu übergeben
Im Abschnitt „Tiefe“ betont der Originaltext mehrfach: Führende Fachleute beginnen mit dem rohesten Material und nicht mit Informationen, die bereits aufbereitet und verarbeitet wurden. Viele „allgemein anerkannte Fakten“ im Geschäftsleben sind in Wahrheit nur grobe Näherungen der Realität. Wenn Sie der KI nur eine von anderen erstellte Übersichtstabelle geben, kann sie lediglich auf dieser Näherung aufbauen.
In der Praxis können Sie zunächst eine „Liste der für die KI lesbaren Daten“ anlegen: Logs, Tickets, Absturzberichte, schreibgeschützte Datenbankkonten, historische Dokumente und mehr. Der Originaltext erwähnt, dass das Modell über MCP-Konnektoren oder andere Wege auf die relevanten Daten zugreifen kann. Inzwischen bieten viele Tools solche Möglichkeiten; eines auszuwählen ist deutlich zuverlässiger, als Daten immer wieder manuell einzufügen.
Umbau 2: Eine nachvollziehbare Zuordnung vom Symptom zur Ursache aufbauen
Im Absturzfall wirkt „welcher Git-Commit zu welcher App-Version gehört“ wie ein Detail. Es entscheidet aber darüber, ob die KI aus einem Absturzbericht die konkrete Codeänderung lokalisieren kann. Ohne diese Zuordnung kann die KI nur raten – und wenn sie falsch rät, müssen Sie manuell eingreifen.
Auf Geschäftsszenarien übertragen heißt das: Die Definition einer Kennzahl muss bis zur Datenquelle zurückverfolgbar sein. Zum Beispiel muss für die KI transparent sein, nach welchem Zeitfenster und für welche Nutzergruppe die „Abwanderungsrate“ berechnet wird. Je klarer die Zuordnung, desto weniger weicht die KI ab, wenn sie auf einer höheren Abstraktionsebene arbeitet.
Umbau 3: Geben Sie der KI einen Computer, an dem sie tatsächlich arbeiten kann
Der Originaltext sagt es ganz direkt: Alle bisherigen Ansätze haben eine Voraussetzung – das Modell muss einen Computer nutzen können, Software installieren und verschiedene relevante Daten abrufen können. Wenn Claude dazu neigt, eine Analyse mit einer Markdown-Tabelle abzuhandeln, sollten Sie darauf bestehen, dass es Datenbanken und statistische Modelle verwendet. Denn „das Modell wie einen Experten auftreten lassen“ bedeutet oft nur, dass ein neues Vokabular verwendet wird, ohne dass sich die Arbeitsweise ändert.
Für Engineering-Teams bedeutet dieser Schritt eine Sandbox-Umgebung, Testmaschinen und Rechteisolierung; für Business-Teams bedeutet er einen Arbeitsbereich, in dem Analysetools laufen können. Bei den Berechtigungen empfiehlt sich das Prinzip der Minimalrechte: zunächst nur Leserechte, und erst nach zuverlässiger Validierung schrittweise Schreibrechte freigeben.
Umbau 4: Auf externer Bewertung bestehen – die KI darf sich nicht selbst benoten
Die Empfehlung des Originalautors ist eindeutig: Zumindest zum Stand Oktober 2026 ist es dringend ratsam, an externer Validierung festzuhalten – am besten mit Tools, die das Modell selbst ausführen kann und die sofort Feedback liefern. Testfälle, echte Reproduktionsergebnisse und zurückgehaltene Validierungsdatensätze sind verlässlicher als die Frage „Wie viele Punkte gibt sich das Modell selbst?“.
Im fortgeschrittenen Szenario des Quartalsrückblicks lässt der Originaltext Claude anhand von Logs eine Simulation des Kundenverhaltens aufbauen, die frühesten Signale für Abwanderung identifizieren und dann mit Daten, die es noch nie gesehen hat, belegen, dass dieses Signal tatsächlich Vorhersagekraft besitzt. Das ist die Standardform externer Bewertung: Die Schlussfolgerung muss einer Prüfung außerhalb des Modells standhalten.
Umbau Nr. 5: Parallele Laufzeit und Ausstiegsbedingungen festlegen
Delegation auf L3-Ebene hat einen entscheidenden Schritt: den neuen Mechanismus ein Quartal lang parallel zum bestehenden Prozess laufen zu lassen. Das ist nicht nur Vorsicht, sondern auch eine externe Bewertung – ob der neue Mechanismus Probleme tatsächlich früher erkennt, lässt sich im Vergleich mit dem alten Prozess im selben Zeitraum prüfen.
Gleichzeitig gilt es, die Grenzen klar zu benennen. Der Originaltext räumt ein, dass im Jahr 2026 ein bloßes „Claude, geh und verdiene Geld“ für die meisten Unternehmen noch nicht funktioniert. Deshalb sollte jede Ergebnisdelegation Grenzen, Prüfpunkte und Rückfallwege klar definieren – statt alles auf einmal aus der Hand zu geben.
Schnelleinstieg in die Ergebnisdelegation an KI: ein Delegationsablauf ohne Programmieren
Der folgende Ablauf erfordert keinerlei Programmierung und eignet sich für Produkt-, Betriebs-, Analyse- und Engineering-Teams zur direkten Übernahme.
Erster Schritt: Prüfen, ob sich die Übergabe des Ergebnisses an die KI lohnt
Filtern Sie zuerst mit drei Fragen: Muss über diese Arbeit anschließend noch in einem Meeting diskutiert werden? Gibt es ein klares Endergebnis und nicht nur ein kreatives Produkt? Wiederholt sie sich periodisch? Der Originaltext weist darauf hin, dass das Anheben der Zielebene beim Verfolgen eines Endergebnisses am nützlichsten ist und für kreative Arbeit weniger geeignet. Wenn zwei der drei Fragen mit „Ja“ beantwortet werden, lohnt sich ein Versuch.
Zweiter Schritt: Eine Spezifikation zur Ergebnisdelegation ausfüllen
Statt eine lange Eingabeaufforderung zu schreiben, zerlegen Sie die Delegation besser in feste Felder. Die folgende Struktur der Spezifikation können Sie direkt wiederverwenden.
| Feld | Auszufüllender Inhalt | Beispiel (Crash-Management) |
|---|---|---|
| Endergebnis | Was Sie wirklich erreichen wollen | Die App bleibt auf drei Plattformen stabil |
| Ziel hinter dem Ergebnis | Die Absicht eine Ebene darüber | Weniger Nutzerabwanderung durch Abstürze |
| Verfügbare Daten | Liste der Rohmaterialien und wie man sie erhält | Crash-Berichte, Zuordnung von Versionen und Commits |
| Verfügbare Umgebung | Maschinen und Werkzeuge, die die KI bedienen kann | Windows-, macOS-, Linux-Testmaschinen |
| Externe Validierung | Wer oder was beweist, dass das Ergebnis korrekt ist | Stabile Reproduktion und Nachweis, dass die Korrektur wirkt |
| Grenzen und Rückfall | Nicht überschreitbare Linien und Scheiternsplan | Nur den Test-Branch ändern, manuell zusammenführen |
| Herausforderungsziel | Ein scheinbar unangemessen hoher Standard | Beispiel aus dem Originaltext: Ladezeit von 10 Sekunden direkt auf 200 Millisekunden verlangen |
Die Spalte „Herausforderungsziel“ stammt aus einem tiefergehenden Rat des Originaltexts: Setzen Sie ein scheinbar unangemessenes Ziel und sagen Sie dem Modell, dass es völlig angemessen ist. Wenn das Modell glaubt, es sei nicht machbar, betonen Sie erneut, dass das Problem lösbar ist und es einfach weiterarbeiten muss. Auch die psychologische Erkenntnis von Locke und Latham, die 35 Jahre Zielsetzungsforschung zusammenfassten, stützt dies: Konkrete und herausfordernde Ziele sind besser als ein vages „sein Bestes geben“.
Schritt 3: Formuliere deinen Auftrag mit den „vier Tiefenfragen“ neu
Der Autor des Originaltexts hat einen häufig verwendeten Denkansatz für Eingabeaufforderungen geteilt. Der Kern besteht darin, das Modell vor dem Umschreiben der Aufgabe zunächst vier Fragen beantworten zu lassen. In eigenen Worten kann das so aussehen:
Ich möchte diese Aufgabe tiefer angehen, nicht größer. Bevor du loslegst, beantworte bitte: 1. Was würden führende Fachleute in diesem Bereich tun, was ich nicht verlangt habe? 2. Mit welchen möglichst ursprünglichen Materialien würden sie beginnen? 3. Mit welchen konkreten Methoden und Werkzeugen arbeiten sie? 4. Was außer deiner und meiner Einschätzung kann belegen, dass das Ergebnis richtig ist? Schreibe danach meinen Auftrag entsprechend neu.
Diese vier Fragen entsprechen den zuvor genannten Umbau-Punkten: Rohdaten, professionelle Werkzeuge, externe Bewertung. Die Lücken, die das Modell in seinen Antworten benennt, sind oft genau der Teil, der in deinem Workflow noch fehlt.
Schritt 4: Zugangsweg zum Modell wählen
Ergebnis-Aufträge laufen in der Regel lange und über viele Runden. Stabilität der Modellanbindung und Wechselkosten wirken sich daher direkt auf die Umsetzung aus. APIYI bietet API-Aufrufe für die in diesem Artikel behandelte Claude-Reihe sowie für andere gängige Modelle und ist gleichzeitig mit beiden Schnittstellenformaten – OpenAI und Anthropic – kompatibel. Vorhandene SDKs oder Agent-Frameworks lassen sich meist allein durch Ersetzen von base_url und API Key anbinden; konkrete Adressen und Parameter gelten gemäß der APIYI-Dokumentation docs.apiyi.com.
| Zugangsbedarf | Empfohlene Methode | Beschreibung | Verfügbare Plattform |
|---|---|---|---|
| Projekte mit vorhandenem OpenAI SDK | OpenAI-kompatibles Format | base_url und API Key ändern | APIYI apiyi.com, offizielle API |
| Nutzung der Claude-Nativfunktionen | Anthropic-kompatibles Format | Anthropic-Nachrichtenstruktur beibehalten | APIYI apiyi.com, offizielle API |
| Vergleich und Validierung mehrerer Modelle | Modellname über eine einheitliche Schnittstelle wechseln | Derselbe Workflow vergleicht verschiedene Modelle | APIYI apiyi.com |
| Kostenkalkulation | Preisseite ansehen | Einheitspreise für Input, Output und Caching gemäß Preisseite | Preisseite: https://docs.apiyi.com/models |
🚀 Tipp für den Einstieg: Ergebnis-Aufträge sollten zunächst in kleinem Rahmen als geschlossener Kreislauf funktionieren und erst dann schrittweise ausgeweitet werden. Empfohlen: über APIYI apiyi.com zunächst mit einer einheitlichen Schnittstelle ein bis zwei Modelle für Vergleichstests anbinden. Zu Modellpreisen, Abrechnungsgrundlagen, Einheitspreisen für Input und Output sowie Cache-Preisen nennt dieser Artikel keine konkreten Zahlen – maßgeblich sind stets die tatsächlichen Daten auf der APIYI-Preisseite https://docs.apiyi.com/models.
Die Breite erweitern: Ergebnisse an die KI übergeben und ein virtuelles Team zusammenstellen
Wenn Höhe und Tiefe stimmen, entscheidet die Breite darüber, ob das Ergebnis wirklich überrascht. Der Artikel empfiehlt zwei Methoden, die sich direkt in die Spezifikation für die Ergebnisdelegation schreiben lassen.
Die erste Methode ist Substantive durch Verben ersetzen, aus „Die Kunst der Innovation“. Ein Quartalsrückblick ist kein „Satz von Folien“, sondern „innerhalb von 30 Minuten eine Gruppe beschäftigter Menschen von einer kausalen Erklärung zu überzeugen und unter Unsicherheit eine Entscheidung herbeizuführen“. Wenn Sie die Arbeit mit Verben beschreiben, erkennen sowohl Sie als auch die KI leichter, welche Bereiche eine eigenständige Perspektive einbringen können.
Die zweite Methode ist Ihr Team zusammenstellen. Angenommen, dieser Rückblick muss außergewöhnlich gut werden – wen würden Sie hinzuziehen? Die Antwort im Artikel lautet: Analysten, Journalisten und Redakteure, bei Bedarf zusätzlich Motion-Designer und Audio-Designer sowie ein „Red Team“ aus Leerverkäufern und forensischen Buchhaltern. Mit mehreren Sitzungen oder Subagenten ist das heute nicht mehr teuer.
Vorsicht ist bei der Rollenspiel-Falle geboten: Der Dialog wird immer verschnörkelter, doch das Ergebnis wird nicht besser. Der Hinweis im Artikel: Lassen Sie das Modell nicht den Tonfall eines Leerverkäufers imitieren, sondern die Methoden übernehmen, die ein Leerverkäufer tatsächlich bei der Analyse eines Zielobjekts einsetzt.
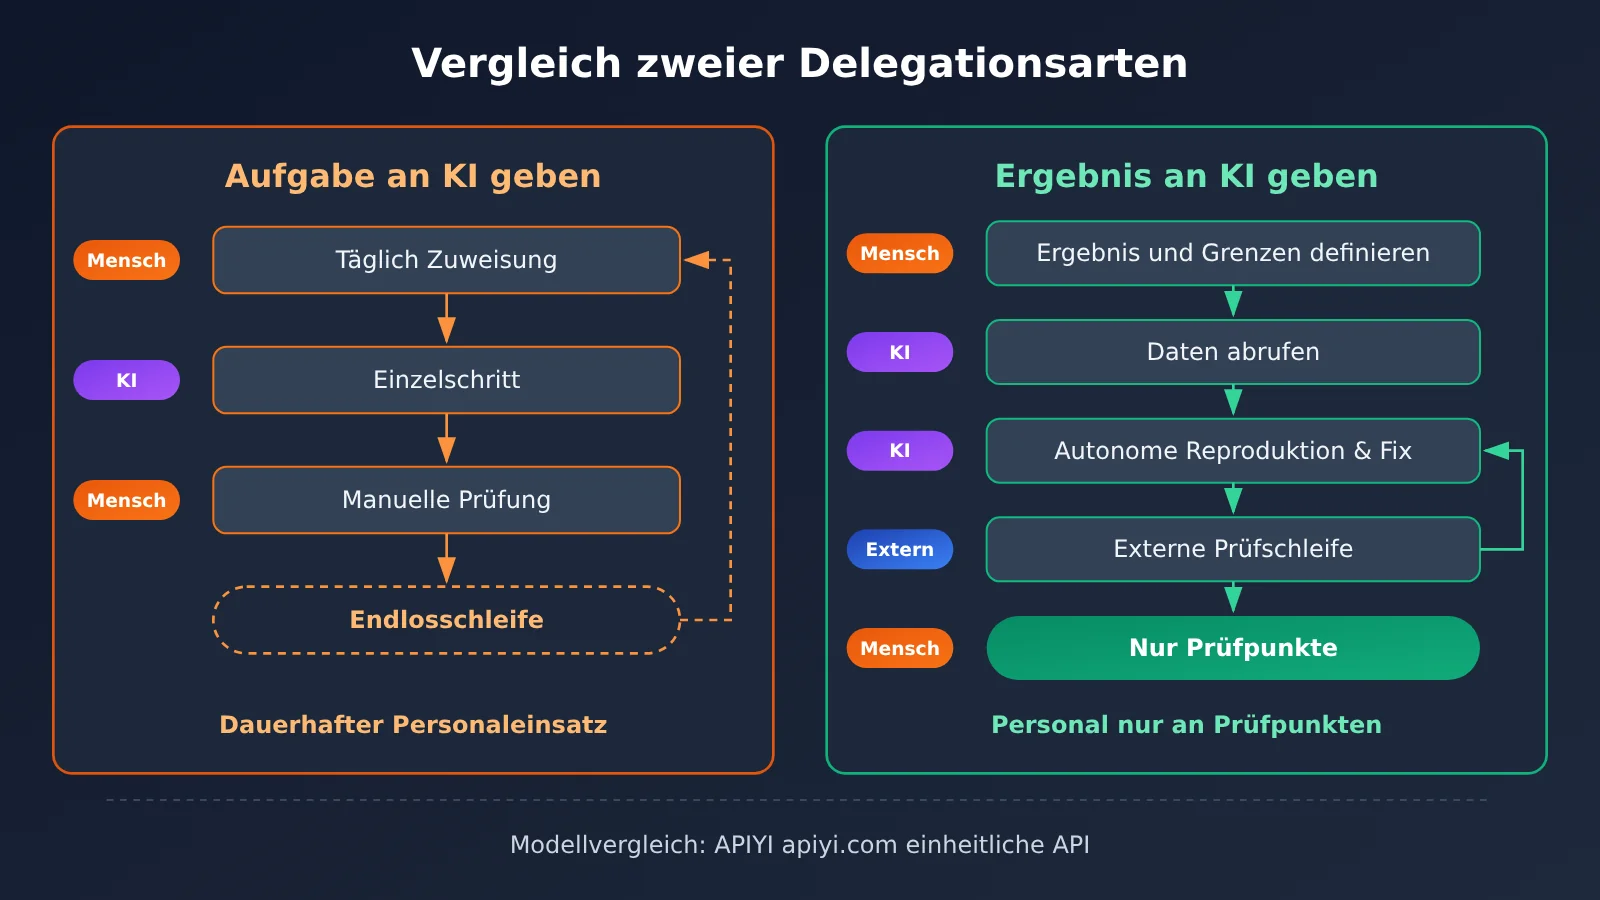
Die obige Abbildung vergleicht die Personalaufwandsstruktur der beiden Delegationsansätze. Wenn Sie die Stabilitätsunterschiede verschiedener Modelle im Szenario der Ergebnisdelegation prüfen möchten, können Sie über APIYI apiyi.com mit demselben Workflow die Modellnamen wechseln und vergleichen – das reduziert den Aufwand für wiederholte Integration.
Häufige Fragen (FAQ)
F1: Was bedeutet es, „das Ergebnis an die KI zu übergeben“?
Damit ist gemeint: Man gibt der KI nicht mehr eine einzelne konkrete Aufgabe, sondern übergibt ihr ein Endergebnis samt der notwendigen Randbedingungen – und sie zerlegt es selbst, führt es aus und überprüft es. Aus „Behebe diesen Absturz“ wird dann zum Beispiel „Sorge dafür, dass die App stabil bleibt und nicht mehr abstürzt“. Der Mensch ist nur noch für Ziel, Grenzen und Prüfpunkte zuständig.
F2: Worin unterscheidet sich das Ergebnis-Delegieren von gewöhnlicher KI-Agenten-Automatisierung?
Bei der Automatisierung werden in der Regel feste Schritte aneinandergereiht, die der Mensch selbst entworfen hat. Beim Ergebnis-Delegieren gibt man zusätzlich das „Wie“ aus der Hand: Die KI darf den Prozess selbst neu gestalten, etwa den Mechanismus für das Quartals-Review komplett neu entwerfen. Das eine optimiert die Ausführungseffizienz, das andere hebt die Arbeit auf eine höhere Abstraktionsebene.
F3: Sind heutige Modelle wirklich schon in der Lage, Ergebnisdelegation zu übernehmen?
Teilweise ja. Der Autor des Originalartikels beobachtet: Je leistungsfähiger ein Modell, desto besser kann es auf einer höheren Abstraktionsebene arbeiten – und genau in dieser Dimension entstehen derzeit Prozesse, die dauerhaft laufen und ohne ständiges Eingreifen auskommen. Er räumt allerdings auch ein, dass ein völlig offenes Ziel wie „Verdiene Geld“ im Jahr 2026 für die meisten Unternehmen noch nicht funktioniert; es braucht klare Grenzen und externe Verifikation.
F4: Welche Arbeiten eignen sich am besten für das Ergebnis-Delegieren?
Vor allem diese Szenarien:
– **Stabilitätsmanagement**: geschlossener Kreislauf aus Absturz-Monitoring, Reproduktion und Verifikation der Korrektur
– **Geschäftsanalyse**: vom Quartals-Review hin zur kontinuierlichen Frühwarnung bei Problemen
– **Untersuchung von Nutzerabwanderung**: aus den Rohlogs die frühesten Abwanderungssignale finden und ihre Vorhersagekraft belegen
– Faustregel: Wenn nach dem Ergebnis noch ein Meeting nötig ist, lohnt es sich meist, eine Abstraktionsebene höher anzusetzen
F5: Wie baut man mit der API schnell einen Workflow für Ergebnisdelegation auf?
Am besten zuerst mit einer einheitlichen Schnittstelle einen minimalen Kreislauf zum Laufen bringen:
1. Bei APIYI apiyi.com registrieren und einen API-Schlüssel holen
2. Die APIYI-Dokumentation unter docs.apiyi.com ansehen und base_url im OpenAI- oder Anthropic-kompatiblen Format konfigurieren
3. Mit der Ergebnisdelegations-Spezifikation aus diesem Artikel ein kleines Ziel definieren und eine Datenquelle anbinden
4. Externe Verifikation ergänzen und erst nach einem vollständigen Zyklus den Umfang erweitern
F6: Wie lassen sich die Kosten für lang laufende Ergebnisdelegation schätzen?
Ergebnisdelegation erzeugt viele mehrstufige Aufrufe. Am besten erfasst man zunächst in kleinem Rahmen den tatsächlichen Token-Verbrauch und rechnet ihn dann mit dem Stückpreis hoch. Stückpreise, Abrechnungsgrundlagen und Cache-Preise entnehmen Sie bitte den aktuellen Angaben auf der APIYI-Preisseite https://docs.apiyi.com/models – konkrete Zahlen nennt dieser Artikel nicht. Für wiederholt genutzte lange Kontexte lohnt ein Blick auf die Cache-Abrechnung auf der Preisseite.
F7: Welche bekannten Risiken gibt es beim Ergebnis-Delegieren?
Vor allem drei: Erstens ist die Selbsteinschätzung von Modellen unzuverlässig, es braucht also eine externe Bewertung. Zweitens kippt eine Ausweitung in die Breite schnell ins Rollenspiel – die Ergebnisse sehen hübsch aus, sind aber nutzlos. Drittens entstehen durch zu weitreichende Berechtigungen operative Risiken. Empfehlung: erst nur lesend arbeiten, Schreibrechte schrittweise freigeben und für jede Delegation eine Parallelphase plus Rückfallplan einplanen.
Die Ergebnisse an die KI übergeben: die wichtigsten Erkenntnisse
- Die Aufgabe enthält deine Einschätzung: Erst wenn du das Ergebnis übergibst, kann die KI einen Weg wählen, der besser ist als deiner.
- Meetings sind ein Signal zum Hochstufen: Wenn über die Ergebnisse noch in einem Meeting diskutiert werden muss, lohnt es sich, das Ziel eine Ebene höher anzusetzen.
- Drei Elemente des geschlossenen Kreises: Rohdaten, eine Umgebung zum Handeln und externe Validierung – auf keines davon lässt sich verzichten.
- Tiefe durch Fachwerkzeuge: Setze konsequent auf Datenbanken und statistische Modelle statt auf Markdown-Tabellen.
- Breite durch Methodenleihe: Übernimm echte Methoden aus anderen Bereichen, statt nur den Tonfall nachzuahmen.
- Paralleler Betrieb senkt Risiken: Lass neue Mechanismen einen Zyklus lang parallel zum alten Prozess laufen, bevor du umstellst.
- Anbindung und Abrechnung: Die Anbindung erfolgt über die einheitliche Schnittstelle von APIYI, die Preise findest du unter docs.apiyi.com/models.
Zusammenfassung
Die Kernpunkte von „Statt die Aufgabe an die KI zu übergeben, übergib ihr das Ergebnis“:
- Zuerst die Höhe erhöhen: Kläre, welches Ergebnis hinter der aktuellen Aufgabe wirklich gewünscht ist, und gehe Stufe für Stufe von L0 (Vorlage ausfüllen) bis L3 (Mechanismus neu aufsetzen).
- Dann den Workflow ändern: Rohdaten anbinden, eine nachvollziehbare Zuordnung aufbauen, eine Umgebung zum Handeln bereitstellen, auf externe Bewertung bestehen und Parallelbetrieb sowie Ausstieg planen.
- Zuletzt Tiefe und Breite erweitern: Mit den vier Tiefen-Fragen fehlende Fachmethoden ergänzen und mit einem virtuellen Team Perspektiven aus anderen Bereichen einbringen.
Empfehlung: Starte mit einem kleinen, wiederkehrenden Szenario, das Meetings erfordert, und arbeite einen vollen Zyklus lang mit einem Ergebnisübergabe-Leitfaden, bevor du entscheidest, ob du den Umfang erweiterst. Für die Modellanbindung empfiehlt es sich, die Wirkung schnell über APIYI apiyi.com zu testen: Dort stehen API-Aufrufe für gängige Modelle wie Claude zur Verfügung, kompatibel mit den Schnittstellenformaten von OpenAI und Anthropic. Details zur Anbindung findest du in der Dokumentation unter docs.apiyi.com, die Preise unter https://docs.apiyi.com/models.
📚 Referenzen
- Wie man sich ehrgeizigere Ziele setzt: Ein praktischer Leitfaden für KI-Nutzer: InfoQ, chinesische Übersetzung
- Link:
infoq.cn/article/F1ms7x7KI1p7UfocCywh -
Erläuterung: Quelle für die Kernaussagen dieses Artikels sowie für die Fallbeispiele zu Ausfallmanagement und Quartalsrückblick
-
How to be more ambitious: A tutorial for humans with models: Felix Rieseberg, englisches Original
- Link:
felixrieseberg.com/how-to-be-more-ambitious-a-tutorial-for-humans-with-models -
Erläuterung: Vollständige Abhandlung der vier Dimensionen Geschwindigkeit, Reichweite, Tiefe und Breite
-
APIYI Dokumentationszentrum: Schnittstellenformate und Integrationsanleitung
- Link:
docs.apiyi.com -
Erläuterung: Konfiguration der OpenAI- und Anthropic-kompatiblen Formate
-
APIYI Modellpreisseite: Modellpreise und Abrechnungsgrundlage
- Link:
docs.apiyi.com/models - Erläuterung: Für Eingabe-, Ausgabe- und Cache-Preise gelten die tatsächlichen Daten auf dieser Seite
Autor: APIYI Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website, um Erfahrungen mit der Umsetzung von Ergebnisdelegationen auszutauschen. Weitere Materialien finden Sie im Dokumentationszentrum unter docs.apiyi.com