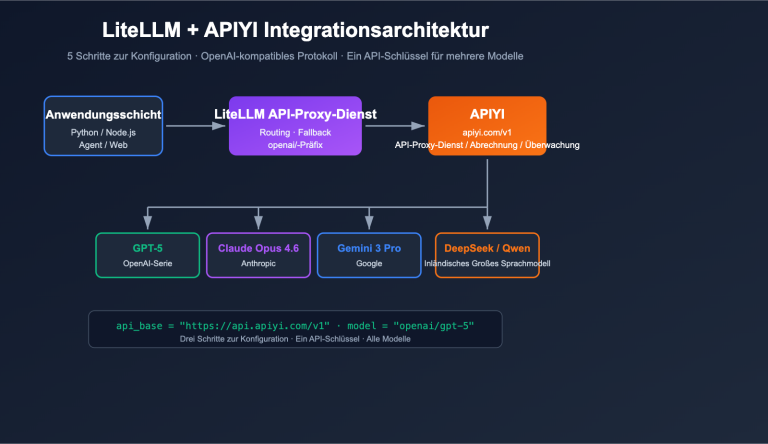
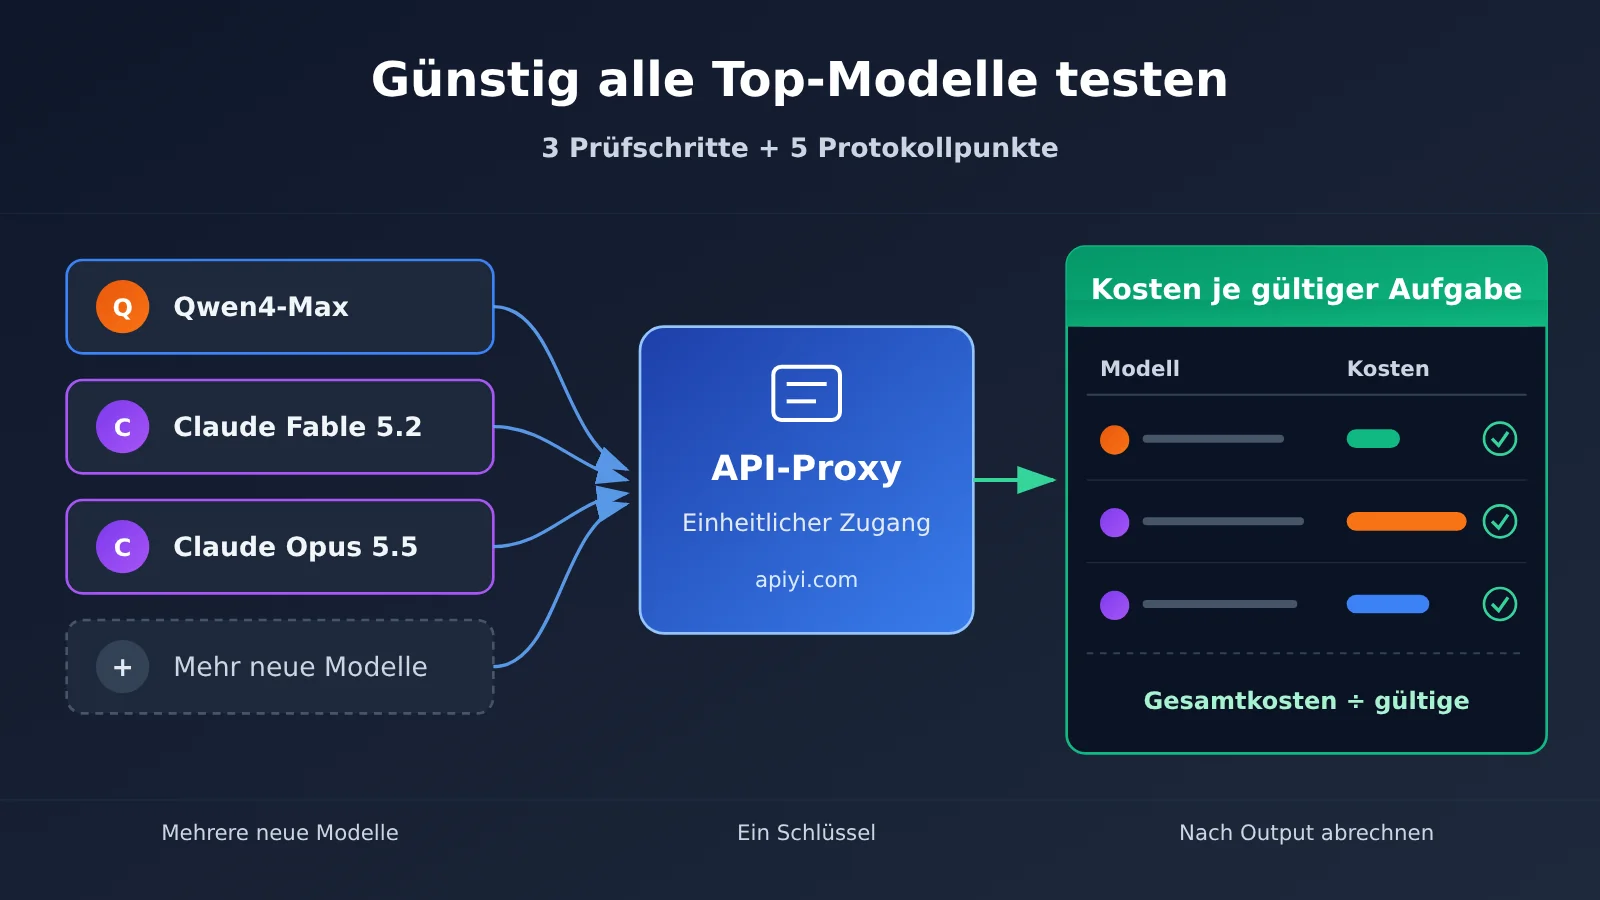
Wenn neue Modelle in kurzer Folge erscheinen und man die angesagten Kandidaten mit kleinem Budget durchtesten möchte, ist der bequemste Weg, die Anbindung über einen einheitlichen Einstiegspunkt eines API-Proxy-Dienstes abzuwickeln. Damit entfallen die wiederholte Registrierung bei jedem Anbieter und die Konfiguration jedes einzelnen SDK. Der einheitliche Zugang beantwortet jedoch nur das „Wie“ der Anbindung, nicht die Frage „Welches Modell soll ich nehmen?“. Die richtige Reihenfolge ist: zuerst Modellkatalog, Schlüsselberechtigungen und Endpunkte prüfen, dann mit derselben Gruppe realer Aufgaben akzeptable Ergebnisse und Gesamtkosten vergleichen. Dieser Artikel zeigt diesen Testablauf mit kleinem Budget und klaren Abnahmekriterien am Beispiel von APIYI apiyi.com.
Was Sie nach dem Lesen wissen:
- Die exakten Modell-IDs, verfügbaren Endpunkte und Gruppen von Qwen4-Max und Claude Fable 5.2 im aktuellen Katalog.
- Einen wiederverwendbaren Basis-Code für die Anbindung und eine Methode, um zuerst zu prüfen, welche Modelle dieser Schlüssel sehen kann.
- Wie Sie mit kleinen Testaufgaben, Usage-Aufzeichnungen und Abrechnungen die Testkosten kontrollieren und anhand der „Kosten pro bestandener Aufgabe“ entscheiden.
Inhaltsübersicht: Im Abschnitt „Objektive Fakten“ werden zuerst die Katalogeinträge mit Stand 2026-11-17, die Zugangsbedingungen und die Testkonditionen aufgeführt; außerdem wird erklärt, wem die in Drittanbieterquellen genannten Preisangaben und Benchmark-Punkte jeweils zuzuordnen sind. Der Abschnitt „Analyse und Einschätzung“ behandelt drei Punkte: wie man kleine Stichproben mit identischer Aufgabenstellung entwirft, wie man Kosten erfasst und wie groß die Lücke zwischen „im Katalog sichtbar“, „Aufruf erfolgreich“ und „Ergebnis akzeptabel“ ist. Zum Schluss folgt eine Erfassungstabelle, die Leser selbst ausfüllen können.
Wissenswertes: Begriffe, die Sie vor dem Testen populärer Modelle über einen API-Proxy-Dienst kennen sollten
| Konzept | Kurze Erklärung |
|---|---|
| API-Proxy-Dienst | Ein Gateway, das Modellanfragen mehrerer Anbieter unter einem einzigen Service-Einstiegspunkt bündelt |
| Modell-ID | Eine Zeichenkette, mit der in einer Anfrage exakt das Modell angegeben wird, z. B. qwen4-max |
| Endpunkt | Ein konkreter Anfragepfad für eine bestimmte Dienstfunktion, etwa chat, responses oder messages |
| Token-Gruppe | Eine Konfiguration, die festlegt, über welche Modellkanäle ein bestimmter Schlüssel laufen darf und nach welchem Abrechnungsfaktor abgerechnet wird |
| usage | Die Verbrauchsangabe in der Antwort, mit der sich die bei dieser Anfrage tatsächlich verbrauchten Token überprüfen lassen |
| Cache-Lesen | Die Wiederverwendung eines bereits verarbeiteten Eingabepräfixes; der Preis dafür kann sich vom Preis für neue Eingaben unterscheiden |
| Kosten pro bestandener Aufgabe | Gesamtkosten aller Versuche ÷ Anzahl der Aufgaben, die die Akzeptanzkriterien letztlich erfüllen |
Auswirkungen im Überblick: Was das Testen von Modellen über einen API-Proxy-Dienst für verschiedene Nutzergruppen bedeutet
- Entwickler, die den Dienst zum ersten Mal anbinden: Mit einer Base URL und einem API-Schlüssel lässt sich das Modell wechseln, ohne Konten und SDKs auf mehreren Plattformen mehrfach einrichten zu müssen.
- Teams, die bereits Anwendungen betreiben: Sie können neue Modelle anhand ihrer eigenen Akzeptanzkriterien testen und müssen sich nicht auf die Rankings anderer verlassen; Parameter für Tool-Aufrufe, Vision und Reasoning müssen jedoch weiterhin separat angepasst werden.
- Preissensible Privatnutzer: Erst die Anzahl der Aufgaben und die Eingabelänge begrenzen, dann anhand des tatsächlich nutzbaren Outputs rechnen. Nicht nur den Preis pro Million Token betrachten.
Objektive Fakten: Das aktuelle Katalogangebot populärer Modelle bei API-Proxy-Diensten und die Zugangsbedingungen
Was im Katalog steht: Einträge zu qwen4-max und claude-fable-5-2
Der öffentlich zugängliche, maschinenlesbare Modellkatalog von APIYI (docs.apiyi.com/model-registry.json) gibt als Datenquelle die Preisschnittstelle der Plattform an; die Erstellungszeit ist 2026-11-17T07:54:33Z. Der Katalog enthält insgesamt 285 Modelleinträge. Beachten Sie: Dies ist die Anzahl der Katalogeinträge und nicht die Anzahl der Modelle, die in einem bestimmten Konto tatsächlich verfügbar sind. Die drei für diesen Artikel relevanten Einträge lauten wie folgt:
| Exakte Modell-ID | Katalog-Endpunkt | Gruppe (Maschinen-ID) | Katalogpreis: Eingabe / Ausgabe / Cache-Lesen (USD pro Million Token) |
|---|---|---|---|
claude-fable-5-2 |
chat / messages | ClaudeCode / ClaudeCodeReverse / ClaudeOfficial / default / svip | 8 / 40 / 0.2 |
claude-opus-5-5 |
chat / messages | ClaudeCode / ClaudeCodeReverse / ClaudeOfficial / default / svip | 4 / 20 / 0.2 |
qwen4-max |
chat / responses / messages | ClaudeCode / CodexResponses / default / svip | 1.5 / 4.5 / 0.075 |
Alle oben genannten Preise sind Katalogpreise vom 2026-11-17, nicht die tatsächlich vom Konto gezahlten Beträge; die tatsächliche Abrechnung hängt außerdem von Faktoren wie der Token-Gruppe ab. Außerdem hieß es in Blogs und älteren Ankündigungen, diese beiden Modelle seien „noch nicht im Katalog verfügbar“. Solche Aussagen spiegeln nur den Stand zum Zeitpunkt ihrer Veröffentlichung wider und taugen nicht als Schlussfolgerung darüber, ob sie heute aufgerufen werden können.
Das Register führt für Fable eine Reverse-Gruppe (ClaudeCodeReverse) auf, doch frühere Ankündigungen und FAQ haben diese Gruppe nicht freigegeben. Daher verwendet dieser Artikel die Gruppe default oder ClaudeCode als Beispiel; eine Verfügbarkeit der Reverse-Gruppe wird nicht garantiert. Wenn Sie einen offiziellen Weiterleitungskanal benötigen, achten Sie auf die Gruppe ClaudeOfficial im Fable-Eintrag.
Wie man anbindet: Base URL und Sichtbarkeitsprüfung
Die Schnellstart-Dokumentation (docs.apiyi.com/getting-started, abgerufen am 2026-11-17) nennt folgende Basis-Konfiguration:
- Base URL des OpenAI-kompatiblen SDK:
https://api.apiyi.com/v1 - Base URL des Anthropic SDK:
https://api.apiyi.com - Der erste Schritt ist eine Anfrage an
GET /v1/models, um zu prüfen, welche Modelle mit dem aktuellen Schlüssel sichtbar sind. Danach wählt man den passenden Endpunkt.
Beide Modelle unterstützen den Chat-Endpunkt, deshalb laufen die folgenden Beispiele einheitlich über die OpenAI-kompatiblen Chat Completions. Zuerst bestätigen, dass das Modell sichtbar ist, dann eine minimale Anfrage senden und usage ausgeben:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # OpenAI-kompatibler Endpunkt von APIYI
)

visible = {m.id for m in client.models.list().data}
for model in ["qwen4-max", "claude-fable-5-2"]:
    if model not in visible:
        print(f"{model}: 本密钥不可见,检查令牌分组")
        continue
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是API中转站。"}],
        max_tokens=100,
    )
    print(model, r.usage, r.choices[0].message.content)
Testguthaben: maßgeblich ist die aktuelle Schnellstart-Seite
Die aktuelle Schnellstart-Seite hält fest, dass ein registriertes Konto ein Testguthaben von 0,05 US-Dollar mitbringt, mit dem sich der erste Aufruf auch ohne Aufladung prüfen lässt. Die Aussage auf älteren Karten – „Registrierung = 3 Millionen Token gratis“ – gilt nicht mehr; maßgeblich sind die Regeln, die auf der Kontoseite angezeigt werden. Erwähnt sei außerdem: Während der Erstellung dieses Artikels wurde kein kostenpflichtiger Modellaufruf durchgeführt. Alle im Text genannten „Kosten“ sind Schätzungen anhand der Katalogpreise und keine tatsächlich abgerechneten Beträge.
Was die einheitliche Schnittstelle teilt – und was nicht
Der Dokumentation zur Textgenerierung von APIYI zufolge eignet sich die einheitliche Chat-Schnittstelle gut dafür, den gemeinsamen Teil von Text-Ein- und -Ausgabe zu vergleichen. Die Historie mehrstufiger Dialoge organisiert der Aufrufer selbst. Bei den Fähigkeiten, den Inferenzeinstellungen und den optionalen Parametern unterscheiden sich die Modelle weiterhin; Bedürfnisse wie Tool-Aufrufe, visuelle Eingaben oder Inferenzintensität müssen separat angepasst werden. Nur das Feld model auszutauschen erspart diese Arbeit nicht.
Wie man Material von Drittanbietern liest: Preisangaben und Benchmark-Werte von OrcaRouter
Die englischsprachigen Beiträge, die in letzter Zeit zu diesen beiden Modellen diskutiert werden, stammen überwiegend aus dem Blog eines anderen Routing-Anbieters, OrcaRouter (veröffentlicht am 2026-11-16). Die wichtigsten Informationen daraus:
- Veröffentlichungsdatum: Qwen4-Max ist seit dem 2026-11-16 offiziell verfügbar; Claude Fable 5.2 wurde am 2026-11-09 veröffentlicht; ein sogenanntes „Claude Fable 5.5“ existiert in der offiziellen Modellliste von Anthropic nicht.
- Benchmark-Werte und Kosten pro Aufgabe: Die im Artikel wiedergegebenen Daten von Artificial Analysis (abgerufen am 2026-11-17) zeigen für Qwen4-Max einen Gesamtindex von rund 42.9 und gemessene Kosten von 3.27 US-Dollar pro Index-Aufgabe; Fable 5.2 erreicht in der Standardstufe „medium“ einen Index von 56.4 bei Kosten von 3.80 US-Dollar pro Aufgabe. Der Artikel weist zugleich darauf hin, dass Qwen4-Max in den Tests eine überdurchschnittlich hohe Anzahl an Ausgabe-Tokens erzeugt.
- Auslaufen der Vorschauversionen: Vorschau-IDs wie
qwen4-max-previewwerden am 2026-11-25 um 24:00 Uhr (UTC+8) eingestellt; die danach gültige offizielle ID istqwen4-max.
Alle oben genannten Zahlen stammen von diesem Anbieter und den entsprechenden Drittanbieter-Benchmarks. Sie sind weder ein Preis von APIYI noch ein Messergebnis aus diesem Artikel. Ihr Referenzwert liegt in der Denkweise, die sie vermitteln: Ein niedriger Stückpreis bedeutet nicht automatisch niedrigere Kosten pro Aufgabe.
Analyse und Bewertung: Wie man mit API-Proxy-Diensten kostengünstig alle beliebten Modelle durchtestet
Erst Aufgaben und Abnahmekriterien festlegen, dann kleine Muster mit derselben Aufgabe
Ein einheitlicher Zugangspunkt senkt die Integrationskosten nahezu auf null – die eigentlichen Kosten verlagern sich damit auf die Frage, was man überhaupt testet. Wir empfehlen, aus den realen Anforderungen 3–5 kleine Aufgaben auszuwählen und für jede Aufgabe die Eingabeversion, die Bestehensgrenze und die Bewertungsgrundlage festzulegen. Zum Beispiel: „Die Ausgabe muss ein parsebares JSON sein und 5 Felder enthalten“ oder „Die Zusammenfassung darf die 3 Zahlen im Originaltext nicht weglassen“. Wenn man die Kriterien nicht vorher festhält, bleibt am Ende oft nur ein Bauchgefühl, welches Modell besser ist.
Als Nächstes schickt man dieselbe Eingabe an die jeweiligen Kandidatenmodelle und hält die Bewertungsregeln konsistent: leere Antworten, Formatfehler und abgeschnittene Ausgaben zählen nicht als bestanden. Bei den Parametern verwendet man zunächst ebenfalls den gemeinsamen Minimalsatz und setzt nur model, messages und max_tokens. Bedürfnisse wie Tool-Aufrufe, Vision oder Reasoning-Intensität testet man in einer eigenen Runde, damit man „falsch eingestellte Parameter“ nicht fälschlich als „das Modell taugt nichts“ fehlinterpretiert.
🚀 Tipp für den Einstieg: Die erste Musterrunde lässt sich direkt mit dem Testguthaben abschließen, das bei der Registrierung bei APIYI apiyi.com dabei ist. Bestätigen Sie zuerst, dass zwei bis drei Kandidatenmodelle mit Ihrem API-Schlüssel sichtbar und aufrufbar sind, und entscheiden Sie dann, ob Sie aufladen, um den Testumfang zu erweitern.
Alle Versuche einrechnen: Kosten pro bestandener Aufgabe
Bei jeder Anfrage müssen die Eingabe-, Ausgabe- und Cache-Lese-Token aus usage erfasst werden (sofern die Antwort dieses Feld zurückgibt); auch Wiederholungen und fehlgeschlagene Anfragen gehören ins Protokoll. Die zentrale Kennzahl ist Kosten pro bestandener Aufgabe = Gesamtkosten aller Versuche ÷ Anzahl der bestandenen Aufgaben. Rechnet man nur die Kosten des einen erfolgreichen Versuchs, unterschätzt man systematisch Modelle, die „günstig sind, aber mehrere Wiederholungen brauchen“.
Im Folgenden eine rein arithmetische Schätzung anhand der Listenpreise (keine tatsächliche Abrechnung – Gruppierungsfaktoren verändern das Ergebnis). Annahme: Eine Anfrage umfasst 2.000 Token Eingabe und 500 Token Ausgabe:
| Modell | Eingabekosten | Ausgabekosten | Schätzung pro Anfrage | 0,05 USD reichen für etwa |
|---|---|---|---|---|
qwen4-max (1,5 / 4,5) |
0,003 USD | 0,00225 USD | ca. 0,0053 USD | ca. 9 Anfragen |
claude-fable-5-2 (8 / 40) |
0,016 USD | 0,02 USD | ca. 0,036 USD | ca. 1 Anfrage |
Aus dieser Tabelle ergeben sich zwei Schlussfolgerungen. Erstens: Das Testguthaben reicht aus, um zu prüfen, „ob es überhaupt läuft“, für einen ernsthaften Qualitätsvergleich braucht man jedoch mehr Budget. Zweitens: Wenn ein Modell tatsächlich längere Ausgaben liefert oder zwei Wiederholungen braucht, bis es besteht, wird der Vorteil beim Stückpreis zunichtegemacht – genau das ist das Phänomen aus den weiter oben genannten Drittanbieter-Materialien. Deshalb sollte das Budget zweistufig gesteuert werden: Zuerst mit dem Kontoguthaben und dem max_tokens pro Anfrage eine Obergrenze setzen, mit kurzen Texten starten und erst nach bestätigter Erfolgsquote auf langen Kontext umsteigen.
Hier ein direkt wiederverwendbares Protokollskript, das jeden Versuch in eine CSV-Datei schreibt, damit die Kosten pro bestandener Aufgabe später berechnet werden können:
Protokollskript für die Testaufgaben anzeigen
import csv, time
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

MODELS = ["qwen4-max", "claude-fable-5-2"]
TASKS = [
    {"id": "t1", "prompt": "把下面的会议记录整理为 JSON:...", "check": lambda s: s.strip().startswith("{")},
    # ergänze 2–4 echte Aufgaben, jede mit einer eigenen Prüffunktion
]

with open("trial_log.csv", "w", newline="", encoding="utf-8") as f:
    w = csv.writer(f)
    w.writerow(["model", "task", "attempt", "prompt_tokens", "completion_tokens",
                "cached_tokens", "passed", "latency_s", "error"])
    for model in MODELS:
        for t in TASKS:
            for attempt in range(1, 3):  # höchstens eine Wiederholung, Fehlschläge ebenfalls protokollieren
                start = time.time()
                try:
                    r = client.chat.completions.create(
                        model=model,
                        messages=[{"role": "user", "content": t["prompt"]}],
                        max_tokens=800,
                    )
                    text = r.choices[0].message.content or ""
                    u = r.usage
                    details = getattr(u, "prompt_tokens_details", None)
                    cached = getattr(details, "cached_tokens", 0) if details else 0
                    ok = bool(text) and t["check"](text)
                    w.writerow([model, t["id"], attempt, u.prompt_tokens,
                                u.completion_tokens, cached, ok,
                                round(time.time() - start, 2), ""])
                    if ok:
                        break
                except Exception as e:
                    w.writerow([model, t["id"], attempt, 0, 0, 0, False,
                                round(time.time() - start, 2), str(e)[:120]])
Was ein einheitlicher Einstiegspunkt erspart – und was nicht
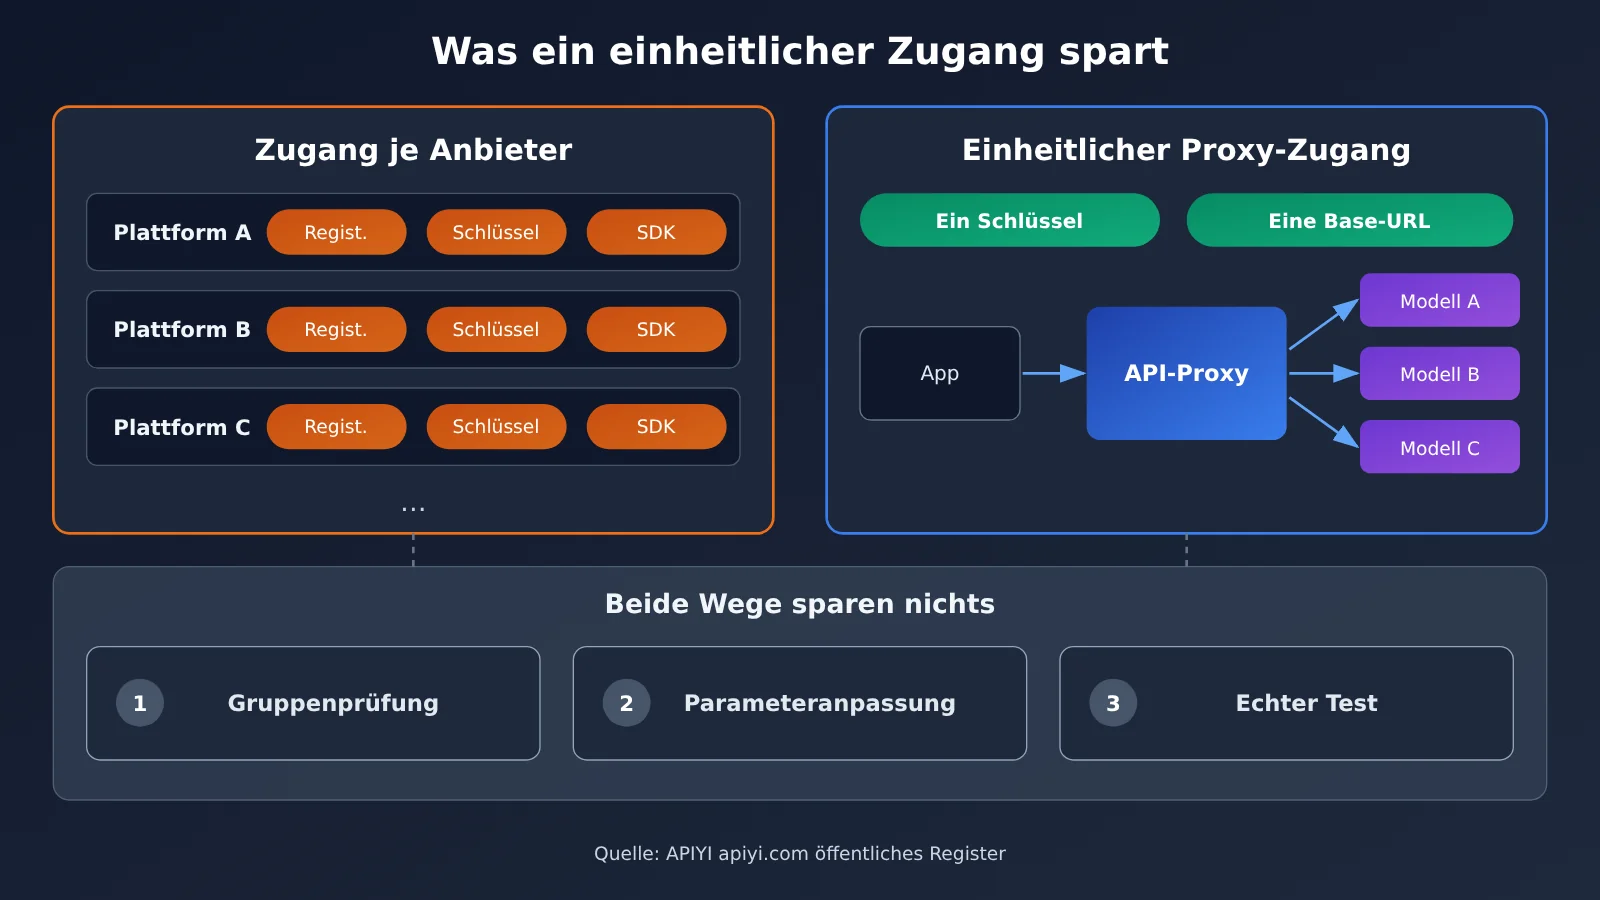
Ein einheitlicher Einstiegspunkt erspart dir die doppelten Konten, Schlüssel und SDK-Konfigurationen. Nicht ersparen lassen sich drei Dinge:
- Gruppierung und Sichtbarkeit: Im Katalog vorhanden zu sein heißt noch lange nicht, dass dein Schlüssel das Modell auch sehen kann.
- Parameter-Anpassung: Nicht-öffentliche Parameter müssen je Modell separat behandelt werden.
- Ergebnisabnahme: Ein Modell sehen zu können heißt noch lange nicht, dass der Aufruf klappt und die Ausgabe taugt.
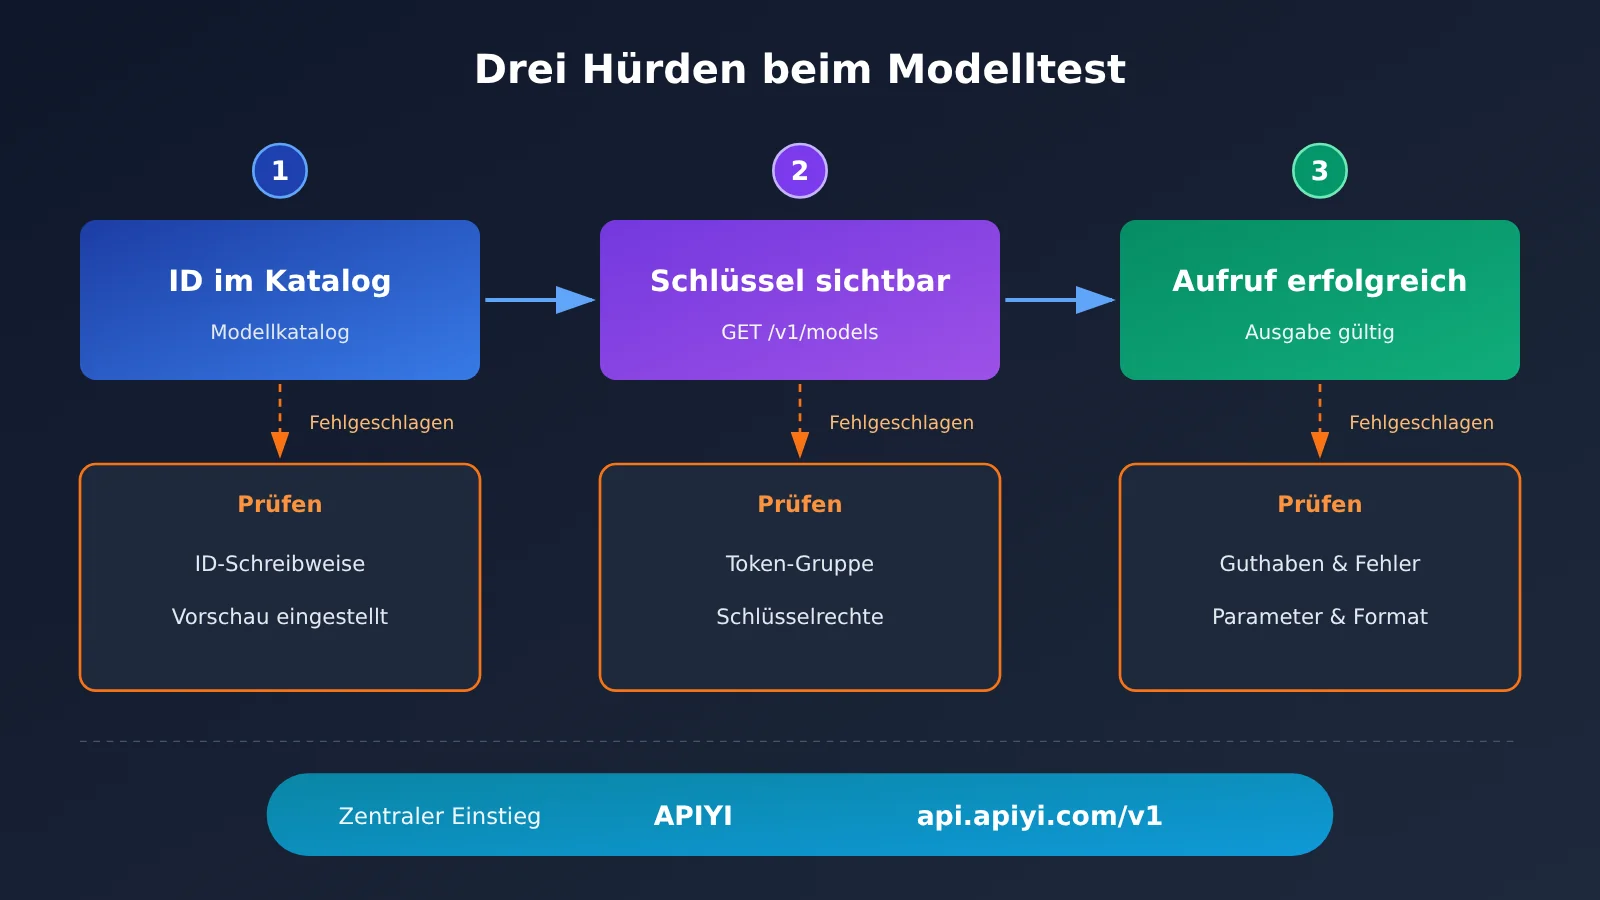
Katalogsichtbarkeit, Schlüsselsichtbarkeit, erfolgreicher Aufruf und passende Ausgabe sind vier aufeinander aufbauende Hürden – jede davon musst du einzeln prüfen. Die folgende Tabelle kannst du beim Testen Punkt für Punkt abhaken:
| Prüfpunkt | Wie prüfen | Häufige Ursache, wenn es nicht klappt |
|---|---|---|
| Modell-ID ist im Katalog vorhanden | Im öffentlichen Register nachsehen und die exakte Schreibweise der ID bestätigen | Eine Vorschau-ID oder einen Alias verwendet |
| Mit diesem Schlüssel sichtbar | GET /v1/models aufrufen |
Die Token-Gruppe enthält diesen Kanal nicht |
| Endpunkt kompatibel | Mit der Endpunkt-Spalte im Katalog abgleichen | Über chat eine Fähigkeit aufgerufen, die nur responses unterstützt |
| Aufruf erfolgreich | Tatsächlich eine möglichst kurze Anfrage abschicken | Guthaben reicht nicht, Parameter werden nicht unterstützt |
| Ausgabe passend | Mit vorab festgelegten Prüfregeln kontrollieren | Formatfehler, abgeschnittene oder leere Rückgabe |
💡 Tipp zur Auswahl: Leg in der APIYI apiyi.com-Konsole ein eigenes Token nur für Tests an und hake ausschließlich die Gruppen an, die der Test braucht. So bleiben Abrechnung und usage getrennt vom Produktionsverkehr – und du kannst hinterher die Kosten pro bestandener Aufgabe klarer nachrechnen.
Die Ergebnistabelle, die Sie selbst ausfüllen
Dieser Artikel liefert kein Qualitätsranking von qwen4-max und claude-fable-5-2 – denn wir haben keine Experimente auf Ihren Aufgaben durchgeführt, und Rankings von Dritten können Ihr Geschäft nicht abbilden. Verlässlicher ist es, erst einen kleinen Testlauf zu machen, die folgende Tabelle selbst auszufüllen und dann zu entscheiden:
| Modell | Versuche | Bestandene Aufgaben | Gesamtkosten (laut Abrechnung) | Kosten pro bestandener Aufgabe | Zusätzlich anzupassende Parameter |
|---|---|---|---|---|---|
| qwen4-max | |||||
| claude-fable-5-2 | |||||
| Ihr aktuell verwendetes Modell |
Zwei Hinweise zur Orientierung – beides Einschätzungen, keine bereits verifizierten Schlussfolgerungen. Erstens: Nehmen Sie Ihr aktuell verwendetes Modell in dieselbe Tabelle auf. Ein Wechsel lohnt sich erst, wenn das neue Modell bei den „Kosten pro bestandener Aufgabe“ oder bei der Erfolgsquote deutlich besser abschneidet. Zweitens: In der Anfangsphase neuer Modelle können sich ID, Preis und Obergrenzen der Parameter ändern – die weiter oben erwähnte Preview-ID, die am 25. November außer Betrieb genommen wird, ist ein Beispiel dafür. Schreiben Sie die Modell-ID besser in eine Konfigurationsdatei statt sie hart zu kodieren, und halten Sie gleichzeitig einen Rückfallpfad bereit. Wenn Sie den Kandidatenkreis erweitern möchten, können Sie über den einheitlichen Zugang von APIYI apiyi.com weitere neue Modelle einbinden und mit demselben Aufgabensatz und denselben Bewertungsregeln einfach noch einmal durchlaufen.
Rankings und Kataloge sagen Ihnen nur, welche Modelle einen Versuch wert sind. Welches Modell wirklich zu Ihrem Geschäft passt, beantwortet allein die Tabelle, die Sie selbst erarbeitet haben. Wie Lu You in „Am Winterabend beim Lesen – meinem Sohn Ziyu“ schrieb: „Was man vom Papier gewinnt, bleibt immer flach – erst wenn man die Sache selbst tut, versteht man sie wirklich.“