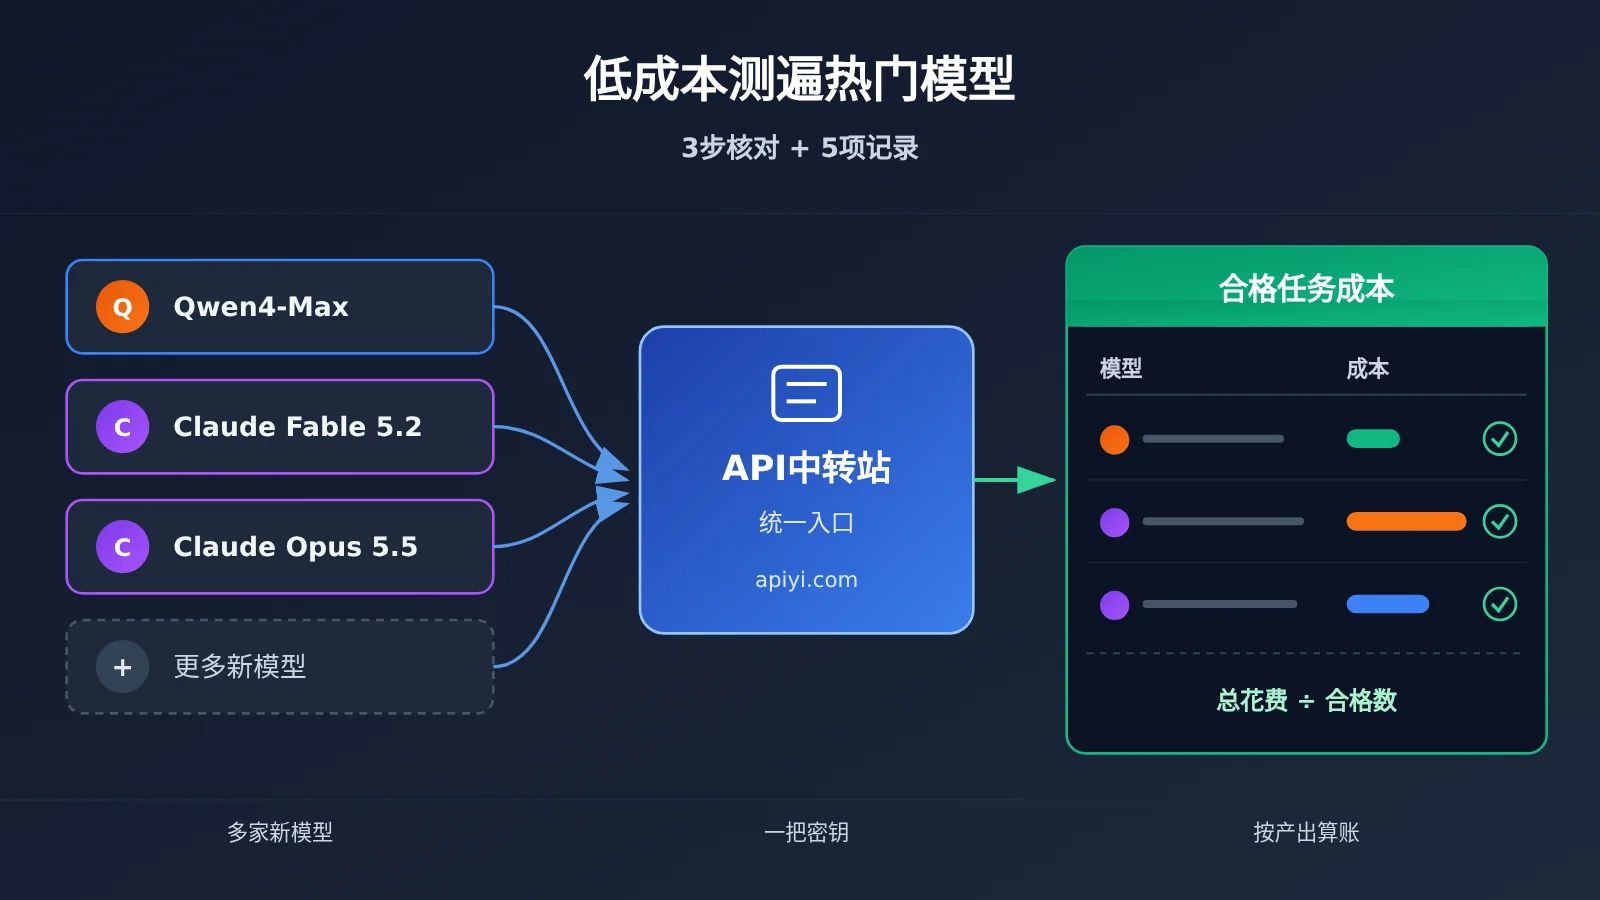
新模型扎堆发布时,想低成本测遍热门模型,最省事的做法是用一个统一的API中转站入口完成接入。这样可以省掉逐家注册、逐套 SDK 配置的重复工作。不过,统一入口只解决“怎么接”,不回答“该选谁”。正确的顺序是先核对模型目录、密钥权限与端点,再用同一批真实任务比较合格产出和总花费。本文以 API易 apiyi.com 为例,演示这套小预算、有验收标准的试用流程。
您读完此文能了解到什么?
- 当前目录中 Qwen4-Max 与 Claude Fable 5.2 的精确模型 ID、可用端点和分组。
- 一套可复用的基础接入代码,以及先查“本密钥能看到哪些模型”的方法。
- 如何用小样任务、usage 记录和账单控制试用成本,并按“合格任务成本”做取舍。
索引:“客观事实”部分先列出截至 2026-11-17 的目录条目、接入条件和试用政策,并说明第三方资料中的报价、榜分分别归属于谁。“分析判断”部分讨论三件事:如何设计同题小样,如何记录成本,以及目录可见、调用成功、产出合格这三者之间的差距。最后附上一张留给读者自行填写的记录表。
To Know:用API中转站测热门模型前需要的概念
| 概念 | 简要解释 |
|---|---|
| API中转站 | 把多家厂商的模型请求接入同一服务入口的网关 |
| 模型ID | 请求中用来精确指定模型的字符串,例如 qwen4-max |
| 端点 | 服务提供某项能力的具体请求路径,如 chat、responses、messages |
| 令牌分组 | 限定某把密钥能走哪些模型通道、按什么计费系数结算的配置 |
| usage | 响应里的用量记录,用于核对本次实际消耗的 Token |
| 缓存读取 | 复用已处理过的输入前缀,其价格可能与新输入不同 |
| 合格任务成本 | 所有尝试的总花费 ÷ 最终满足验收标准的任务数 |
影响速览:API中转站测模型对不同人群意味着什么
- 首次接入的开发者:一个 Base URL 加一把密钥就能切换模型,不必在多个平台重复配置账号和 SDK。
- 已有业务的团队:可以拿自己的合格标准测试新模型,不必依赖他人的榜单结论;但工具调用、视觉、推理等参数仍要单独适配。
- 预算敏感的个人用户:先限制任务数量和输入长度,再按“可用产出”算账。不要只看每百万 Token 的单价。
客观事实:API中转站当前的热门模型目录与接入条件
目录里有什么:qwen4-max 与 claude-fable-5-2 的条目
API易公开的机器可读模型注册表(docs.apiyi.com/model-registry.json)声明的数据来源是平台定价接口,生成时间为 2026-11-17T07:54:33Z。该表共有 285 条模型记录。需要注意,这是目录记录数,不等于某个账户实际可用的模型数。与本文相关的三个条目如下:
| 精确模型ID | 目录端点 | 分组(机器ID) | 目录标价:输入 / 输出 / 缓存读(美元每百万 Token) |
|---|---|---|---|
claude-fable-5-2 |
chat / messages | ClaudeCode / ClaudeCodeReverse / ClaudeOfficial / default / svip | 8 / 40 / 0.2 |
claude-opus-5-5 |
chat / messages | ClaudeCode / ClaudeCodeReverse / ClaudeOfficial / default / svip | 4 / 20 / 0.2 |
qwen4-max |
chat / responses / messages | ClaudeCode / CodexResponses / default / svip | 1.5 / 4.5 / 0.075 |
以上价格均为 2026-11-17 的目录标价,不是账户实付,实际结算还受令牌分组等因素影响。另外,此前曾有博客和旧公告称这两个模型“尚未上架”。这类说法只对应其发布当时的状态,不能作为今天能否调用的结论。
注册表为 Fable 列出了逆向分组(ClaudeCodeReverse),但早期公告和 FAQ 并未开放该分组。因此本文以 default 或 ClaudeCode 分组为例,不保证逆向分组可用。如果需要官方转发通道,可留意 Fable 条目中的 ClaudeOfficial 分组。
怎么接:Base URL 与可见性核对
快速开始文档(docs.apiyi.com/getting-started,检索于 2026-11-17)给出的基础配置如下:
- OpenAI 兼容 SDK 的 Base URL:
https://api.apiyi.com/v1 - Anthropic SDK 的 Base URL:
https://api.apiyi.com - 第一步先请求
GET /v1/models,核对当前密钥能看到哪些模型,再选择兼容的端点。
两个模型都支持 chat 端点,所以下面的示例统一走 OpenAI 兼容的 Chat Completions。先确认模型可见,再发一条最短请求,并把 usage 打印出来:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # API易 OpenAI 兼容入口
)

visible = {m.id for m in client.models.list().data}
for model in ["qwen4-max", "claude-fable-5-2"]:
    if model not in visible:
        print(f"{model}: 本密钥不可见,检查令牌分组")
        continue
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是API中转站。"}],
        max_tokens=100,
    )
    print(model, r.usage, r.choices[0].message.content)
试用额度:以当前快速开始页为准
当前快速开始页写明,注册账号附带 0.05 美元试用额度,不充值即可验证首次调用。早期卡片上“注册即送 300 万 Token”的说法已不再适用,具体以账户页面显示的规则为准。另需说明,本文写作期间没有发起任何付费模型调用,文中所有“成本”都是按目录标价做的估算,不是实测账单。
统一接口共用什么、不共用什么
据 API易文本生成能力文档,统一聊天接口适合比较共享的文本输入输出部分。多轮对话的历史由调用方自行组织。不同模型的能力、推理设置和可选参数仍有差异,工具调用、视觉输入、推理强度等需求需要单独适配,仅仅替换 model 字段并不能免除这部分工作。
第三方资料怎么读:OrcaRouter 的报价与榜分
近期讨论这两个模型的英文资料,多来自另一家路由服务商 OrcaRouter 的博客(2026-11-16 发布),其中的关键信息如下:
- 发布时间:Qwen4-Max 于 2026-11-16 正式可用;Claude Fable 5.2 的发布时间为 2026-11-09;所谓“Claude Fable 5.5”在 Anthropic 官方模型列表中并不存在。
- 榜分与单任务成本:文章转述的 Artificial Analysis 数据(读取于 2026-11-17)显示,Qwen4-Max 的综合指数约为 42.9,每个指数任务的测得成本为 3.27 美元;Fable 5.2 在默认 medium 档下指数为 56.4,每任务成本为 3.80 美元。文章同时指出,Qwen4-Max 在测评中输出 Token 量偏大。
- 预览版退役:
qwen4-max-preview等预览 ID 将于 2026-11-25 24:00(UTC+8)停止服务,之后保留的正式 ID 是qwen4-max。
以上数字都归属于该服务商和对应的第三方测评,既不是 API易的报价,也不是本文的实测结论。它们的参考价值在于提供了一个思路:单价低不等于单任务成本低。
分析判断:如何用API中转站低成本测遍热门模型
先定任务和验收标准,再做同题小样
统一入口把接入成本降到了接近零,真正的成本于是转移到“测什么”上。我们建议从真实需求中挑出 3–5 条小任务,为每条任务固定好输入版本、合格标准和判定依据。例如,“输出必须是可解析的 JSON 且包含 5 个字段”,或者“摘要不得遗漏原文中的 3 个数字”。如果没有事先写好标准,测到最后往往只剩下“感觉哪个更好”。
接下来,把同一份输入分别发给候选模型,判定规则保持一致:空返回、格式错误、截断都不算合格。参数也先用公共最小集,只设 model、messages 和 max_tokens。工具调用、视觉、推理强度等需求单独开一轮测试,避免把“参数没调对”误判成“模型不行”。
🚀 上手建议:首轮小样可以直接用 API易 apiyi.com 注册附带的试用额度完成,先确认两三个候选模型在你的密钥下可见、可调用,再决定是否充值扩大测试范围。
把所有尝试都算进账:合格任务成本
每次请求都要记下 usage 中的输入、输出和缓存读取(如果响应返回了该字段),重试和失败的请求也要一并记录。核心指标是合格任务成本 = 全部尝试的总花费 ÷ 合格任务数。只算成功那一次的花费,会系统性地低估“便宜但需要多次重试”的模型。
下面按目录标价做一个纯算术估算(不代表实际计费,分组系数会改变结果)。假设单次请求的输入为 2,000 Token、输出为 500 Token:
| 模型 | 输入费用 | 输出费用 | 单次估算 | 0.05 美元大约够跑 |
|---|---|---|---|---|
qwen4-max(1.5 / 4.5) |
0.003 美元 | 0.00225 美元 | 约 0.0053 美元 | 约 9 次 |
claude-fable-5-2(8 / 40) |
0.016 美元 | 0.02 美元 | 约 0.036 美元 | 约 1 次 |
从这张表可以得出两个结论。第一,用试用额度验证“能不能通”足够,但正式比较质量需要更多预算。第二,如果某个模型实际输出更长,或者需要重试两次才合格,单价上的优势就会被吃掉,前文第三方资料中提到的现象正是如此。因此预算要分两层控制:先用账户余额和单次 max_tokens 封顶,先跑短文本,确认通过率之后再上长上下文。
下面是一个可直接复用的记录脚本,会把每次尝试写入 CSV,方便后续计算合格任务成本:
查看同题小样记录脚本
import csv, time
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

MODELS = ["qwen4-max", "claude-fable-5-2"]
TASKS = [
    {"id": "t1", "prompt": "把下面的会议记录整理为 JSON:...", "check": lambda s: s.strip().startswith("{")},
    # 再补充 2–4 条真实任务,每条都写好判定函数
]

with open("trial_log.csv", "w", newline="", encoding="utf-8") as f:
    w = csv.writer(f)
    w.writerow(["model", "task", "attempt", "prompt_tokens", "completion_tokens",
                "cached_tokens", "passed", "latency_s", "error"])
    for model in MODELS:
        for t in TASKS:
            for attempt in range(1, 3):  # 最多重试一次,失败也记录
                start = time.time()
                try:
                    r = client.chat.completions.create(
                        model=model,
                        messages=[{"role": "user", "content": t["prompt"]}],
                        max_tokens=800,
                    )
                    text = r.choices[0].message.content or ""
                    u = r.usage
                    details = getattr(u, "prompt_tokens_details", None)
                    cached = getattr(details, "cached_tokens", 0) if details else 0
                    ok = bool(text) and t["check"](text)
                    w.writerow([model, t["id"], attempt, u.prompt_tokens,
                                u.completion_tokens, cached, ok,
                                round(time.time() - start, 2), ""])
                    if ok:
                        break
                except Exception as e:
                    w.writerow([model, t["id"], attempt, 0, 0, 0, False,
                                round(time.time() - start, 2), str(e)[:120]])
统一入口省掉什么、省不掉什么
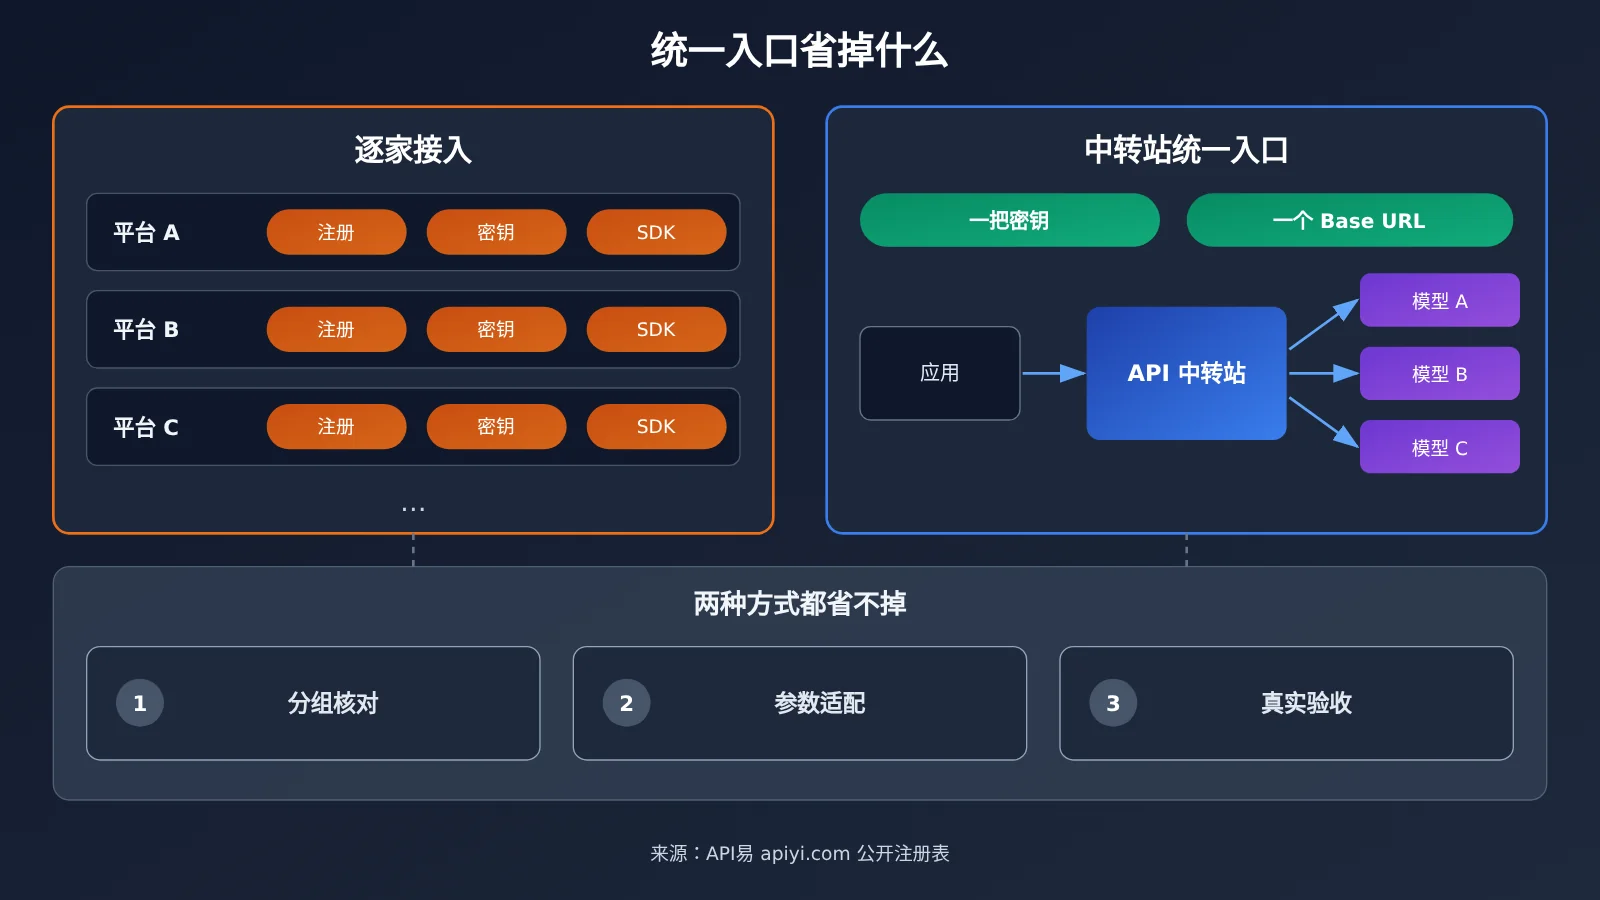
统一入口省掉的是重复的账号、密钥和 SDK 配置。省不掉的有三件事:
- 分组与可见性:目录里有,不等于你的密钥能看到;
- 参数适配:非公共参数需要按模型单独处理;
- 结果验收:能看到模型,也不等于调用成功、产出合格。
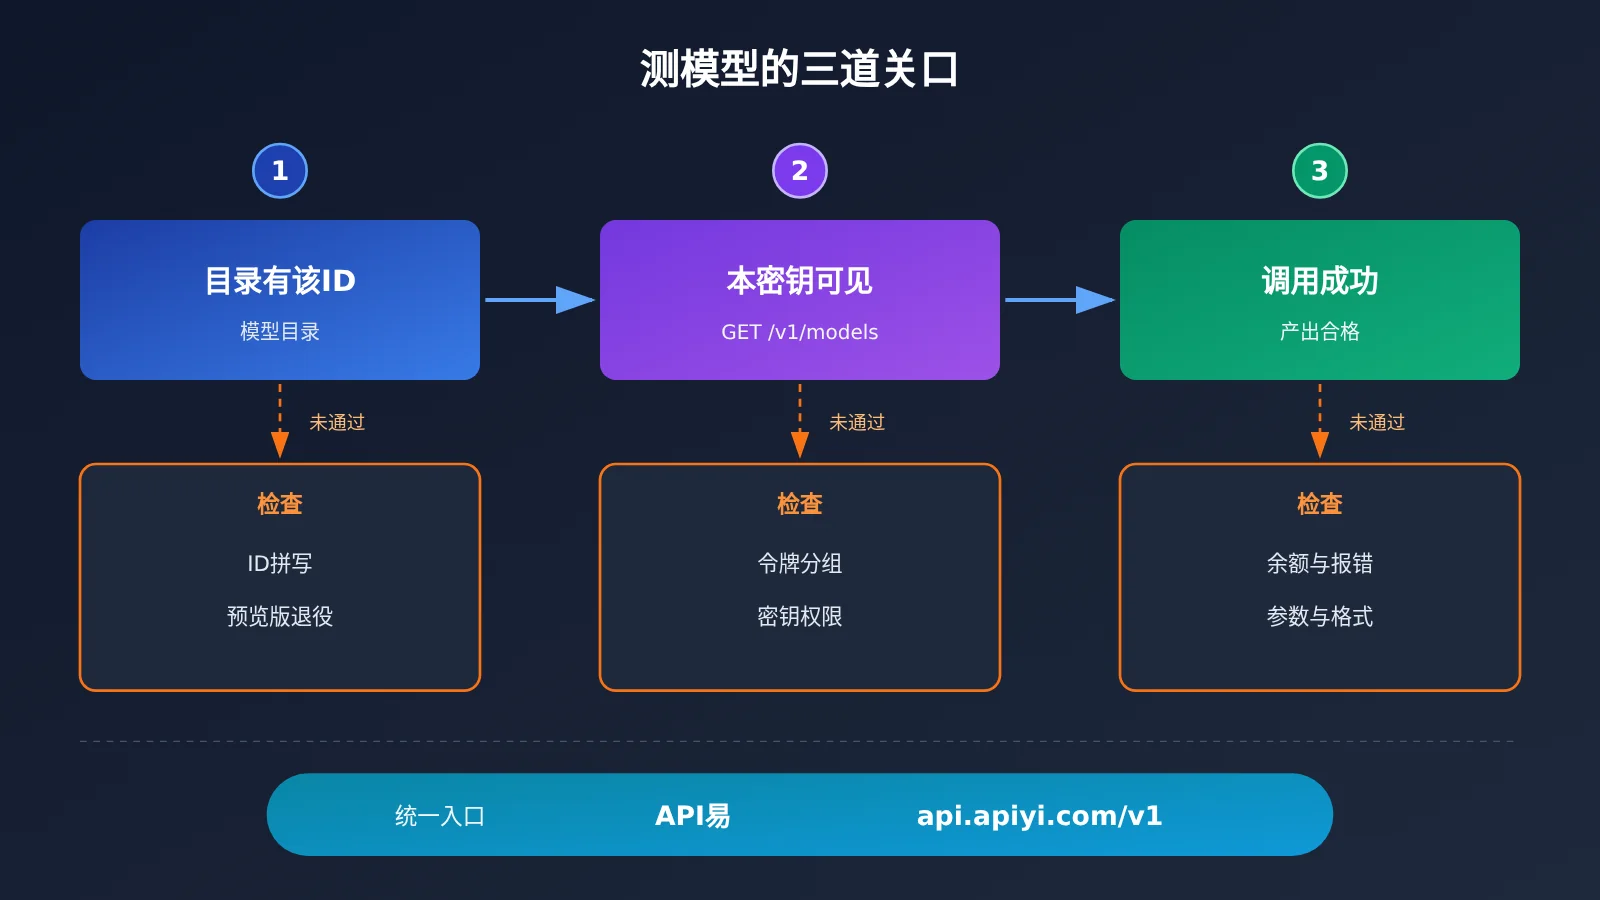
目录可见、密钥可见、调用成功、产出合格,是四道依次递进的关卡,每一道都需要单独验证。下表可以在测试时逐项打勾:
| 核对项 | 怎么验证 | 未通过时的常见原因 |
|---|---|---|
| 目录中存在该模型ID | 查公开注册表,确认 ID 拼写精确 | 使用了预览 ID 或别名 |
| 本密钥可见 | 调用 GET /v1/models |
令牌分组不包含该通道 |
| 端点兼容 | 对照目录中的端点列 | 用 chat 调用了仅支持 responses 的能力 |
| 调用成功 | 实际发起最短请求 | 余额不足、参数不被支持 |
| 产出合格 | 用预设判定规则检查 | 格式错误、截断、空返回 |
💡 选择建议:在 API易 apiyi.com 控制台为测试单独建一把令牌,并只勾选测试需要的分组。这样账单和 usage 能与生产流量分开,事后计算合格任务成本也更清楚。
留给你自己填写的结论表
本文不给出 qwen4-max 与 claude-fable-5-2 的质量排名,因为我们没有在你的任务上做过实验,第三方榜单也代表不了你的业务。更可靠的做法是跑完小样后自己填写下表,再做决定:
| 模型 | 尝试次数 | 合格数 | 总花费(以账单为准) | 合格任务成本 | 需要额外适配的参数 |
|---|---|---|---|---|---|
| qwen4-max | |||||
| claude-fable-5-2 | |||||
| 你的现用模型 |
两点建议供参考,均为判断而非已验证的结论。第一,把现用模型也放进同一张表,新模型只需要在“合格任务成本”或“合格率”上明显胜出时才值得迁移。第二,新模型上线初期,ID、价格和参数上限都可能变化,前文提到的预览 ID 将于 11 月 25 日退役就是一例。建议把模型 ID 写进配置文件而不是硬编码,同时保留一条回退路线。需要扩大候选范围时,可以继续通过 API易 apiyi.com 的统一入口加入新模型,沿用同一套任务和判定规则重新跑一遍即可。
榜单和目录只能告诉你哪些模型值得一试,哪个模型真正适合你的业务,要靠自己亲手跑出来的那张表回答。正如陆游在《冬夜读书示子聿》中所写:“纸上得来终觉浅,绝知此事要躬行。”