عندما تتوالى إصدارات النماذج الجديدة، وتريد اختبار النماذج الشائعة كلها بتكلفة منخفضة، فأقلّ الطرق عناءً هي إتمام الربط عبر مدخل موحّد لخدمة وكيل API. فهذا يغنيك عن تكرار التسجيل لدى كل مزوّد وإعداد حزمة SDK لكل واحد منهم. غير أن المدخل الموحّد يحلّ فقط مسألة «كيف أتصل؟»، ولا يجيب عن «أي نموذج أختار؟». التسلسل الصحيح هو أن تتحقق أولًا من دليل النماذج وصلاحيات المفتاح ونقاط النهاية، ثم تقارن، باستخدام الدفعة نفسها من المهام الحقيقية، المخرجات المقبولة والتكلفة الإجمالية. ويوضح هذا المقال، متخذًا APIYI apiyi.com مثالًا، مسار التجربة هذا ذا الميزانية الصغيرة ومعايير القبول المحددة.
ماذا ستتعرف بعد قراءة هذا المقال؟
- معرّفات النماذج الدقيقة لكل من Qwen4-Max وClaude Fable 5.2 في الدليل الحالي، ونقاط النهاية المتاحة والمجموعات.
- كود ربط أساسي قابل لإعادة الاستخدام، وطريقة التحقق أولًا من «النماذج التي يمكن لهذا المفتاح رؤيتها».
- كيف تتحكم في تكلفة التجربة عبر مهام صغيرة وسجلات الاستخدام (usage) والفواتير، وكيف تحسم الاختيار وفق «تكلفة المهمة المقبولة».
المحتويات: يعرض قسم «الوقائع الموضوعية» أولًا بنود الدليل حتى تاريخ 2026-11-17، وشروط الربط وسياسة التجربة، ويوضح الجهة التي تعود إليها الأسعار ودرجات التصنيف الواردة في مواد الطرف الثالث. أما قسم «التحليل والاستنتاج» فيناقش ثلاثة أمور: كيف تصمم عيّنة صغيرة من المهام نفسها، وكيف تسجل التكلفة، والفجوة بين ثلاثة أمور: ظهور النموذج في الدليل، ونجاح الاستدعاء، وقبول المخرجات. وفي الختام جدول سجلات نتركه للقارئ ليملأه بنفسه.
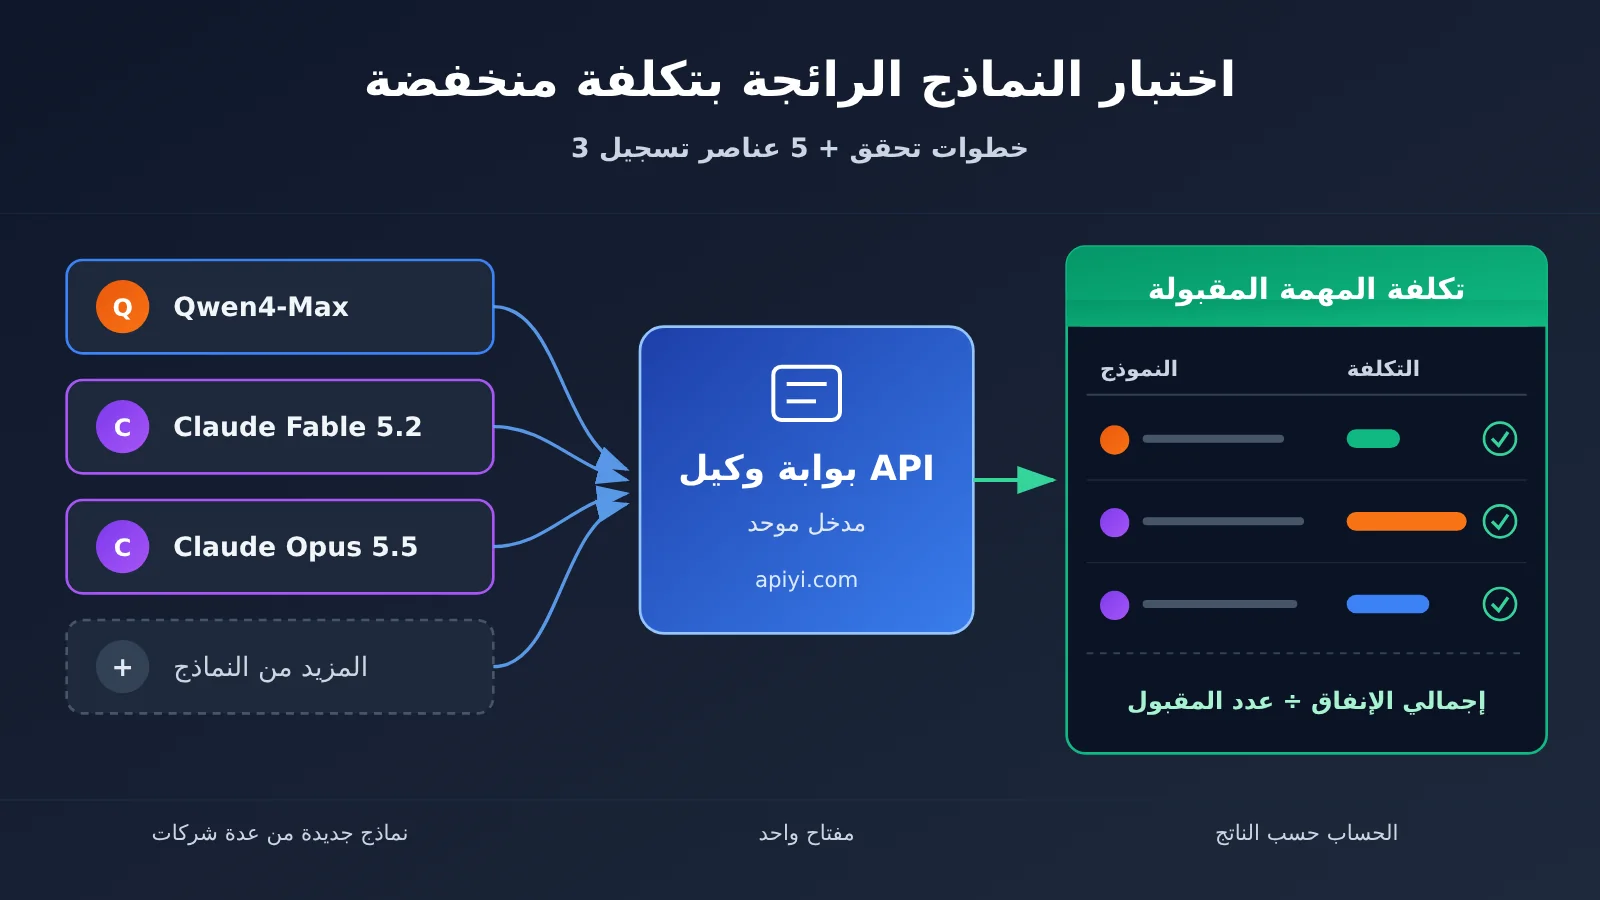
للمعرفة: المفاهيم التي تحتاجها قبل اختبار النماذج الرائجة عبر خدمة وكيل API
| المفهوم | شرح مختصر |
|---|---|
| خدمة وكيل API | بوابة تجمع طلبات النماذج من عدة مزوّدين ضمن نقطة دخول خدمة واحدة |
| معرّف النموذج | سلسلة نصية تُستخدم في الطلب لتحديد النموذج بدقة، مثل qwen4-max |
| نقطة النهاية | المسار المحدد لطلب قدرة معينة من الخدمة، مثل chat وresponses وmessages |
| مجموعة الرموز | إعداد يحدد قنوات النماذج التي يمكن لمفتاح معيّن الوصول إليها، ومعامل الفوترة الذي تُسوّى به التكلفة |
| usage | سجل الاستخدام في الاستجابة، ويُستخدم للتحقق من الرموز المستهلكة فعليًا في هذه المرة |
| قراءة الذاكرة المؤقتة | إعادة استخدام بادئة الإدخال التي سبق معالجتها، وقد يختلف سعرها عن الإدخال الجديد |
| تكلفة المهمة المقبولة | إجمالي تكلفة جميع المحاولات ÷ عدد المهام التي استوفت معايير القبول في النهاية |
نظرة سريعة على التأثير: ماذا يعني اختبار النماذج عبر خدمة وكيل API لفئات مختلفة
- المطورون الذين يتصلون بالخدمة لأول مرة: يكفي عنوان Base URL واحد ومفتاح API واحد لتبديل النماذج، دون الحاجة إلى تكرار إعداد الحسابات وSDK على منصات متعددة.
- الفرق التي لديها أعمال قائمة: يمكنها اختبار النماذج الجديدة وفق معايير القبول الخاصة بها، بدل الاعتماد على نتائج قوائم التصنيف التي يقدمها الآخرون؛ لكن معايير استدعاء الأدوات والرؤية والاستدلال لا تزال بحاجة إلى مواءمة منفصلة.
- المستخدمون الأفراد الحساسون للميزانية: ابدأ بتحديد عدد المهام وطول الإدخال، ثم احسب التكلفة على أساس «المخرجات القابلة للاستخدام». لا تنظر فقط إلى سعر المليون رمز.
حقيقة موضوعية: كتالوج النماذج الرائجة الحالي في خدمة وكيل API وشروط الوصول
ما الموجود في الكتالوج: إدخالات qwen4-max وclaude-fable-5-2
يصرّح سجل النماذج القابل للقراءة آليًا الذي تنشره APIYI (docs.apiyi.com/model-registry.json) بأن مصدر البيانات هو واجهة تسعير المنصة، ووقت الإنشاء هو 2026-11-17T07:54:33Z. يحتوي هذا الجدول على 285 سجل نموذج. ومن المهم ملاحظة أن هذا هو عدد سجلات الكتالوج، وليس عدد النماذج المتاحة فعليًا لحساب معيّن. الإدخالات الثلاثة المرتبطة بهذا المقال هي:
| معرّف النموذج الدقيق | نقاط نهاية الكتالوج | المجموعة (المعرّف الآلي) | سعر الكتالوج: الإدخال / الإخراج / قراءة الذاكرة المؤقتة (دولار لكل مليون توكن) |
|---|---|---|---|
claude-fable-5-2 |
chat / messages | ClaudeCode / ClaudeCodeReverse / ClaudeOfficial / default / svip | 8 / 40 / 0.2 |
claude-opus-5-5 |
chat / messages | ClaudeCode / ClaudeCodeReverse / ClaudeOfficial / default / svip | 4 / 20 / 0.2 |
qwen4-max |
chat / responses / messages | ClaudeCode / CodexResponses / default / svip | 1.5 / 4.5 / 0.075 |
جميع الأسعار أعلاه هي أسعار الكتالوج بتاريخ 2026-11-17، وليست المبلغ الذي يدفعه الحساب فعليًا؛ إذ تتأثر التسوية الفعلية بعوامل مثل مجموعة التوكن. كذلك، كانت هناك مدونات وإعلانات قديمة تذكر أن هذين النموذجين «لم يكونا متاحين بعد». وهذه العبارات تعكس فقط حالتهما وقت نشرها، ولا تصلح كاستنتاج لمعرفة ما إذا كان يمكن استدعاؤهما اليوم.
يسرد السجل مجموعة Reverse الخاصة بـ Fable، أي ClaudeCodeReverse، لكن الإعلانات والأسئلة الشائعة المبكرة لم تفتح هذه المجموعة. لذلك يعتمد هذا المقال على مجموعة default أو ClaudeCode كمثال، ولا يضمن توفّر مجموعة Reverse. وإذا كنت بحاجة إلى قناة إعادة توجيه رسمية، فراقب مجموعة ClaudeOfficial في إدخال Fable.
كيف تبدأ: التحقق من Base URL وإمكانية الوصول
توضح وثائق البدء السريع (docs.apiyi.com/getting-started، بتاريخ 2026-11-17) الإعدادات الأساسية التالية:
- Base URL لواجهة SDK المتوافقة مع OpenAI:
https://api.apiyi.com/v1 - Base URL لواجهة SDK الخاصة بـ Anthropic:
https://api.apiyi.com - الخطوة الأولى هي إرسال
GET /v1/models، للتحقق من النماذج التي يستطيع مفتاحك الحالي رؤيتها، ثم اختيار نقطة النهاية المتوافقة.
كلا النموذجين يدعمان نقطة نهاية chat، لذا تستخدم الأمثلة التالية مسار Chat Completions المتوافق مع OpenAI بشكل موحّد. تأكد أولاً من ظهور النموذج، ثم أرسل طلبًا قصيرًا جدًا واطبع قيمة usage:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # مدخل APIYI المتوافق مع OpenAI
)

visible = {m.id for m in client.models.list().data}
for model in ["qwen4-max", "claude-fable-5-2"]:
    if model not in visible:
        print(f"{model}: 本密钥不可见,检查令牌分组")
        continue
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是API中转站。"}],
        max_tokens=100,
    )
    print(model, r.usage, r.choices[0].message.content)
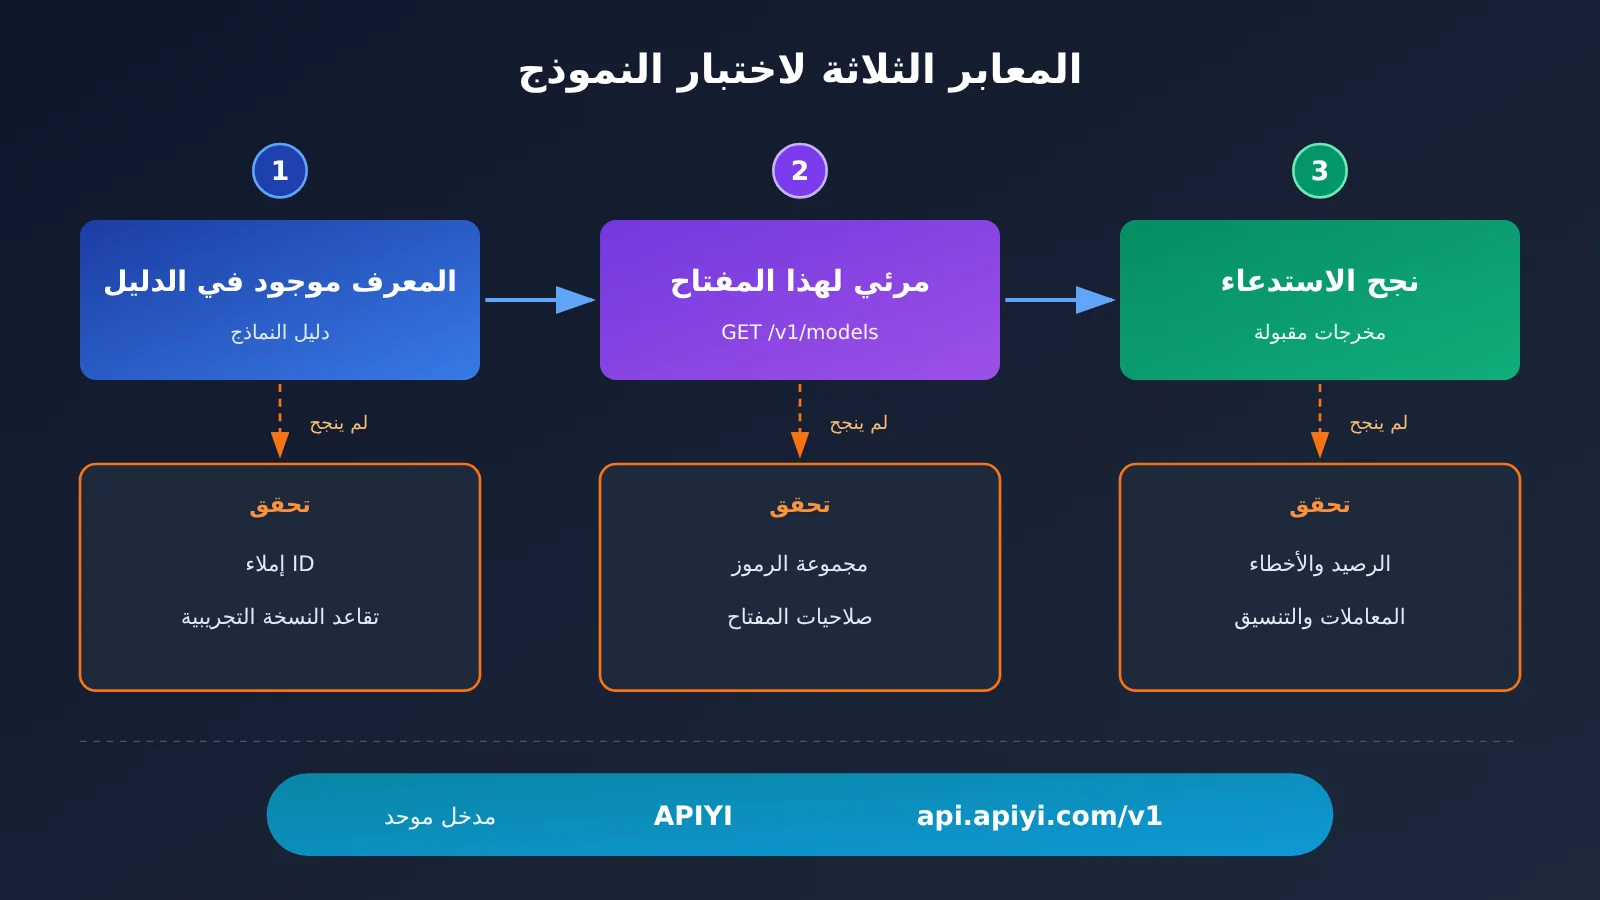
حصة التجربة: المرجع هو صفحة البدء السريع الحالية
توضح صفحة البدء السريع الحالية أن إنشاء حساب يمنحك حصة تجريبية بقيمة 0.05 دولار، ويمكنك من خلالها التحقق من أول استدعاء من دون شحن أي رصيد. أما عبارة “التسجيل يمنحك 3 ملايين Token مجانًا” التي كانت تظهر على البطاقات القديمة فلم تعد صالحة، والمرجع في ذلك هو القواعد المعروضة على صفحة الحساب. ومن الجدير بالذكر أيضًا أننا لم نقم بأي استدعاء مدفوع للنموذج أثناء كتابة هذا المقال، وكل ما ورد فيه من “تكاليف” هو مجرد تقديرات مبنية على الأسعار المعلنة في الكتالوج، وليست فواتير مقاسة فعليًا.
ما تشترك فيه الواجهة الموحدة وما تختلف فيه
وفقًا لوثيقة قدرات توليد النصوص في APIYI، تناسب واجهة الدردشة الموحدة مقارنة الجزء المشترك من إدخال النص وإخراجه. أما تاريخ المحادثات متعددة الأدوار فيقوم المستدعي بتنظيمه بنفسه. وما زالت قدرات النماذج وإعدادات الاستدلال والمعاملات الاختيارية تختلف بين نموذج وآخر، لذا يتطلب كل من استدعاء الأدوات والإدخال البصري وشدّة الاستدلال تكييفًا مستقلًا؛ ومجرد تبديل حقل model لا يعفيك من هذا الجزء من العمل.
كيف نقرأ مواد الطرف الثالث: أسعار OrcaRouter ودرجاته
إن المواد الإنجليزية التي تتناول هذين النموذجين مؤخرًا تأتي في معظمها من مدونة مزوّد خدمة توجيه آخر هو OrcaRouter (نُشرت في 2026-11-16)، وفيها المعلومات الرئيسية التالية:
- وقت الإطلاق: أصبح Qwen4-Max متاحًا رسميًا في 2026-11-16؛ أما Claude Fable 5.2 فكان إطلاقه في 2026-11-09؛ وما يُسمى “Claude Fable 5.5” غير موجود في قائمة نماذج Anthropic الرسمية.
- الدرجات وتكلفة المهمة الواحدة: تُظهر بيانات Artificial Analysis التي نقلها المقال (قُرئت في 2026-11-17) أن المؤشر المركب لـ Qwen4-Max يبلغ نحو 42.9، وأن التكلفة المقاسة لكل مهمة مؤشر تبلغ 3.27 دولار؛ أما Fable 5.2 فبلغ مؤشره 56.4 عند المستوى الافتراضي medium، وبلغت تكلفة المهمة الواحدة 3.80 دولار. ويشير المقال أيضًا إلى أن Qwen4-Max ينتج كمية كبيرة نسبيًا من رموز الإخراج (Tokens) في التقييم.
- إيقاف النسخة التجريبية: ستتوقف معرفات النسخ التجريبية مثل
qwen4-max-previewعن الخدمة في 2026-11-25 24:00 (UTC+8)، وسيبقى بعد ذلك المعرف الرسميqwen4-max.
تنتسب هذه الأرقام جميعًا إلى ذلك المزوّد وإلى التقييمات الخارجية المقابلة، فهي ليست أسعار APIYI ولا نتيجة قياس أجريناه في هذا المقال. وتكمن قيمتها المرجعية في أنها تقدم فكرة: انخفاض سعر الوحدة لا يعني بالضرورة انخفاض تكلفة المهمة الواحدة.
التحليل والحكم: كيف تختبر جميع النماذج الشائعة بتكلفة منخفضة عبر خدمة وكيل API
حدّد المهمة ومعايير القبول أولًا، ثم جرّب عينة صغيرة على المهمة نفسها
لقد خفّضت البوابة الموحدة تكلفة الوصول إلى ما يقارب الصفر، لذا انتقلت التكلفة الحقيقية إلى سؤال: «ماذا نختبر؟». نقترح اختيار 3–5 مهام صغيرة من الاحتياجات الواقعية، وتثبيت نسخة الإدخال ومعايير القبول وأساس الحكم لكل مهمة مسبقًا. على سبيل المثال: «يجب أن يكون الناتج JSON قابلًا للتحليل ويحتوي على 5 حقول»، أو «يجب ألا يحذف الملخص الأرقام الثلاثة الواردة في النص الأصلي». وإذا لم تكتب المعايير مسبقًا، فغالبًا لن يتبقى لديك في النهاية سوى «أيها يبدو أفضل».
بعد ذلك، أرسل الإدخال نفسه إلى كل نموذج مرشح، مع الالتزام بقواعد الحكم نفسها: الاستجابة الفارغة أو الخطأ في التنسيق أو الاقتطاع لا تُعدّ ناجحة. واستخدم في البداية الحد الأدنى المشترك من المعلمات، وحدّد فقط model وmessages وmax_tokens. أما متطلبات مثل استدعاء الأدوات والرؤية وجهد الاستدلال، فاختبرها في جولة منفصلة، لتجنب الخلط بين «إعداد المعلمات بشكل خاطئ» و«النموذج غير جيد».
🚀 نصيحة للبدء: يمكنك إنجاز العينة الأولى مباشرة باستخدام رصيد التجربة المرفق عند التسجيل في APIYI apiyi.com. تأكد أولًا من أن نموذجين أو ثلاثة مرشحة ظاهرة وقابلة للاستدعاء باستخدام مفتاح API الخاص بك، ثم قرّر ما إذا كنت ستشحن الرصيد لتوسيع نطاق الاختبار.
احتساب كل المحاولات في الحساب: تكلفة المهمة المقبولة
في كل طلب، سجّل المدخلات والمخرجات وقراءة الذاكرة المؤقتة (cache) من حقل usage إن أعادها الرد، وسجّل كذلك الطلبات التي أُعيدت والتي فشلت. المؤشر الأساسي هو تكلفة المهمة المقبولة = إجمالي تكلفة كل المحاولات ÷ عدد المهام المقبولة. فإذا حسبت تكلفة المحاولة الناجحة وحدها، فستقلّل بشكل منهجي من تقدير النماذج «الرخيصة لكنها تحتاج إلى إعادات متعددة».
في ما يلي تقدير حسابي بحت اعتمادًا على الأسعار المعلنة في الكتالوج (وهو لا يمثّل الفوترة الفعلية، إذ إن معاملات المجموعات تغيّر النتيجة). لنفترض أن الطلب الواحد يستهلك 2,000 توكن مدخلات و500 توكن مخرجات:
| النموذج | تكلفة المدخلات | تكلفة المخرجات | تقدير الطلب الواحد | ما يكفيه نحو 0.05 دولار |
|---|---|---|---|---|
qwen4-max (1.5 / 4.5) |
0.003 دولار | 0.00225 دولار | نحو 0.0053 دولار | نحو 9 طلبات |
claude-fable-5-2 (8 / 40) |
0.016 دولار | 0.02 دولار | نحو 0.036 دولار | نحو طلب واحد |
من هذا الجدول نستنتج أمرين. الأول أن رصيد التجربة يكفي للتحقق من «هل يعمل الاتصال أم لا»، أما المقارنة الجدية في الجودة فتتطلب ميزانية أكبر. والثاني أن النموذج إذا كان مخرجاته أطول فعليًا، أو احتاج إلى إعادتين قبل أن يُقبل، فإن ميزته في سعر الوحدة تُستنزف، وهذا بالضبط ما أشارت إليه المصادر الخارجية التي ذكرناها سابقًا. لذلك يجب ضبط الميزانية على مستويين: أولًا نحدّد السقف عبر رصيد الحساب وmax_tokens لكل طلب، ونبدأ بالنصوص القصيرة، وبعد التأكد من معدل النجاح ننتقل إلى السياقات الطويلة.
وفي ما يلي سكربت تسجيل جاهز لإعادة الاستخدام، يكتب كل محاولة في ملف CSV، لتسهيل حساب تكلفة المهمة المقبولة لاحقًا:
عرض سكربت تسجيل العينات الصغيرة للمهام المتطابقة
import csv, time
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

MODELS = ["qwen4-max", "claude-fable-5-2"]
TASKS = [
    {"id": "t1", "prompt": "把下面的会议记录整理为 JSON:...", "check": lambda s: s.strip().startswith("{")},
    # أضف من 2 إلى 4 مهام حقيقية أخرى، مع كتابة دالة تحقق لكل مهمة
]

with open("trial_log.csv", "w", newline="", encoding="utf-8") as f:
    w = csv.writer(f)
    w.writerow(["model", "task", "attempt", "prompt_tokens", "completion_tokens",
                "cached_tokens", "passed", "latency_s", "error"])
    for model in MODELS:
        for t in TASKS:
            for attempt in range(1, 3):  # محاولة إعادة واحدة كحد أقصى، ويُسجَّل الفشل أيضًا
                start = time.time()
                try:
                    r = client.chat.completions.create(
                        model=model,
                        messages=[{"role": "user", "content": t["prompt"]}],
                        max_tokens=800,
                    )
                    text = r.choices[0].message.content or ""
                    u = r.usage
                    details = getattr(u, "prompt_tokens_details", None)
                    cached = getattr(details, "cached_tokens", 0) if details else 0
                    ok = bool(text) and t["check"](text)
                    w.writerow([model, t["id"], attempt, u.prompt_tokens,
                                u.completion_tokens, cached, ok,
                                round(time.time() - start, 2), ""])
                    if ok:
                        break
                except Exception as e:
                    w.writerow([model, t["id"], attempt, 0, 0, 0, False,
                                round(time.time() - start, 2), str(e)[:120]])
ماذا يوفّر المدخل الموحّد وماذا لا يوفّر
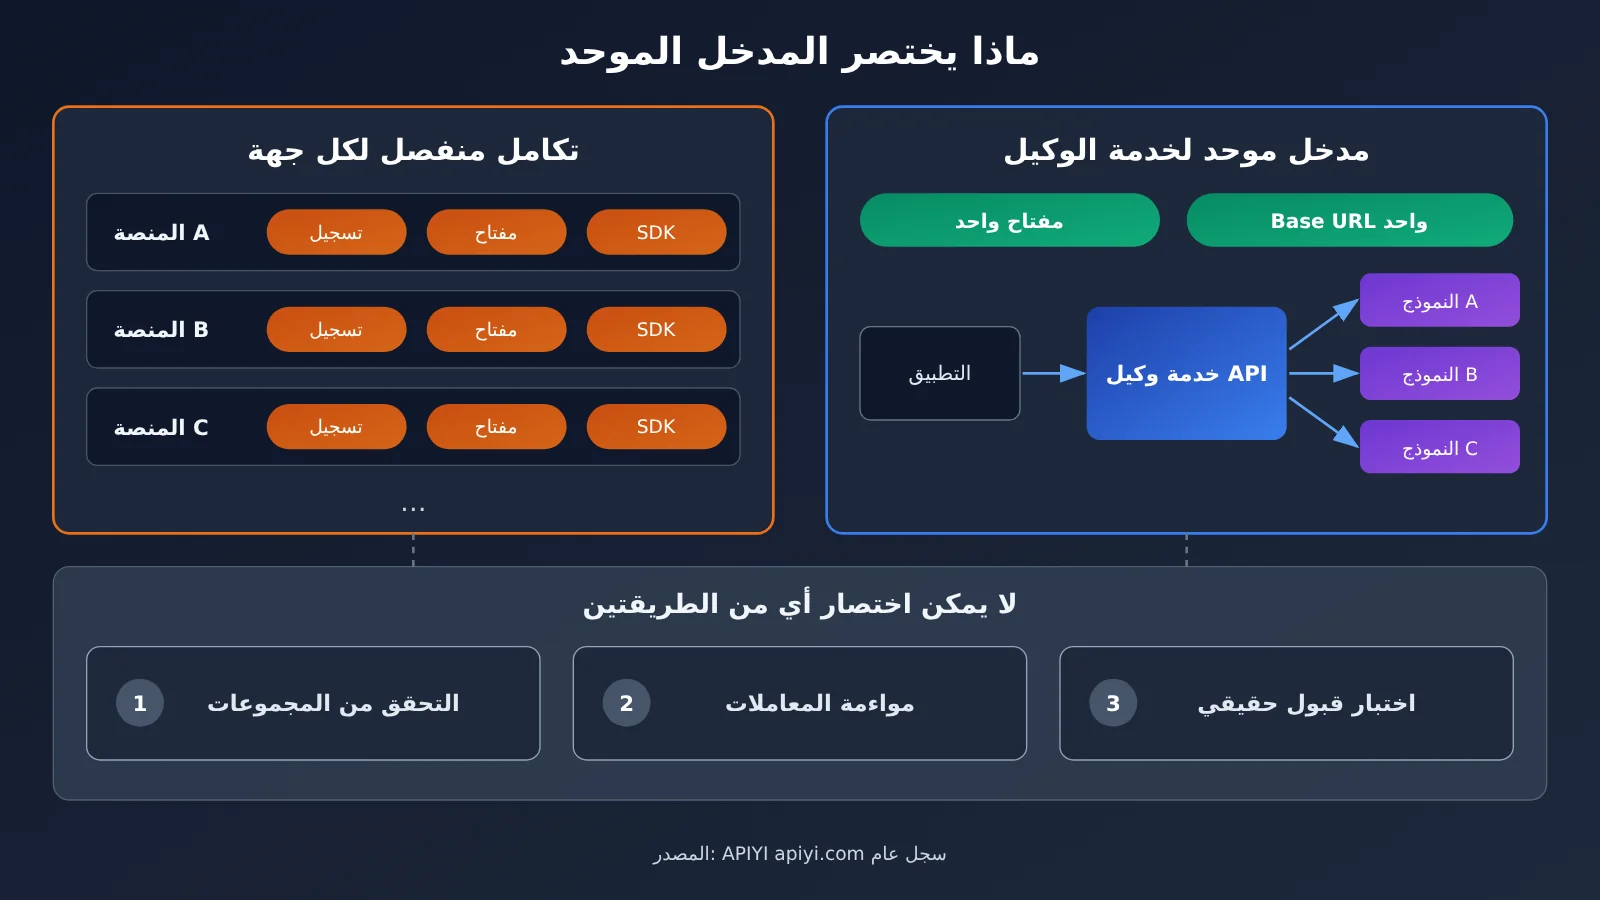
ما يختصره المدخل الموحّد هو الحسابات والمفاتيح وتهيئة SDK المتكررة. أما ما لا يختصره فثلاثة أمور:
- المجموعات والظهور: وجود النموذج في الدليل لا يعني أن مفتاحك يستطيع رؤيته؛
- تكييف المعاملات: المعاملات غير العامة تحتاج معالجة منفصلة لكل نموذج؛
- قبول النتائج: رؤية النموذج لا تعني أن الاستدعاء نجح وأن الناتج مطابق.
ظهور النموذج في الدليل، وظهوره لمفتاحك، ونجاح الاستدعاء، وجودة الناتج، هي أربع بوابات متتالية، كل واحدة منها تحتاج تحققًا منفصلًا. ويمكن استخدام الجدول التالي كقائمة تحقق أثناء الاختبار:
| بند التحقق | كيفية التحقق | الأسباب الشائعة عند عدم النجاح |
|---|---|---|
| وجود معرّف النموذج في الدليل | راجع السجل العام وتأكد من كتابة المعرّف بدقة | استخدام معرّف تجريبي أو اسم مستعار |
| ظهوره لهذا المفتاح | استدعاء GET /v1/models |
مجموعة الرمز لا تتضمن هذه القناة |
| توافق نقطة النهاية | راجع عمود نقطة النهاية في الدليل | استخدام chat لاستدعاء قدرة تدعم responses فقط |
| نجاح الاستدعاء | إرسال أقصر طلب فعلي | الرصيد غير كافٍ أو المعاملات غير مدعومة |
| جودة الناتج | فحصه وفق قواعد تقييم مسبقة | خطأ في التنسيق أو اقتطاع أو إرجاع فارغ |
💡 نصيحة للاختيار: في لوحة تحكم APIYI apiyi.com، أنشئ رمزًا منفصلًا للاختبار وحدد فقط المجموعة التي يحتاجها الاختبار. بهذه الطريقة تنفصل الفوترة والاستخدام عن حركة الإنتاج، ويصبح حساب تكلفة المهام المقبولة لاحقًا أوضح.
جدول الاستنتاجات الذي تكملُه بنفسك
لا يقدّم هذا المقال ترتيبًا لجودة qwen4-max مقابل claude-fable-5-2، لأننا لم نُجرِ تجارب على مهمتك، كما أنّ قوائم التصنيف التي تصدرها جهات أخرى لا تعبّر عن عملك. الطريقة الأكثر موثوقية هي أن تُشغّل عيّنة صغيرة، ثم تملأ الجدول التالي بنفسك، وبعدها تتّخذ قرارك:
| النموذج | عدد المحاولات | عدد الناجح | إجمالي التكلفة (حسب الفاتورة) | تكلفة المهمة الناجحة | المعاملات التي تحتاج إلى تعديل إضافي |
|---|---|---|---|---|---|
| qwen4-max | |||||
| claude-fable-5-2 | |||||
| نموذجك الحالي |
اقتراحان للاستخدام كمرجع، وكلاهما حكم شخصي لا نتيجة مثبتة تجريبيًا. أولًا، ضع نموذجك الحالي في الجدول نفسه؛ فلا يستحق الانتقال إلى نموذج جديد إلا إذا تفوّق بوضوح في «تكلفة المهمة الناجحة» أو «نسبة النجاح». ثانيًا، في الفترة الأولى بعد إطلاق نموذج جديد قد يتغيّر المعرّف والسعر والحد الأعلى للمعاملات، ومن الأمثلة على ذلك أن معرّف الإصدار التجريبي المذكور سابقًا سيتوقف في 25 نوفمبر. لذلك ننصح بكتابة معرّف النموذج في ملف الإعدادات بدلًا من تثبيته داخل الكود، مع الحفاظ على مسار احتياطي للرجوع. وعندما تحتاج إلى توسيع نطاق المرشحين، يمكنك إضافة نماذج جديدة عبر المدخل الموحّد لـ APIYI apiyi.com، ثم إعادة التشغيل بنفس مجموعة المهام وقواعد التقييم.
قوائم التصنيف والفهارس لا تخبرك إلا بالنماذج التي تستحق التجربة؛ أما أيّ نموذج يناسب عملك حقًا، فالجواب يأتي من ذلك الجدول الذي تُشغّل به بنفسك. وكما كتب لو يو في قصيدته «قراءة في ليلة شتوية لأجل ابني»: «ما يُنقل من الكتب يبقى سطحيًا؛ ولا تُدرك الأمور حقًا إلا بممارستها بنفسك.»