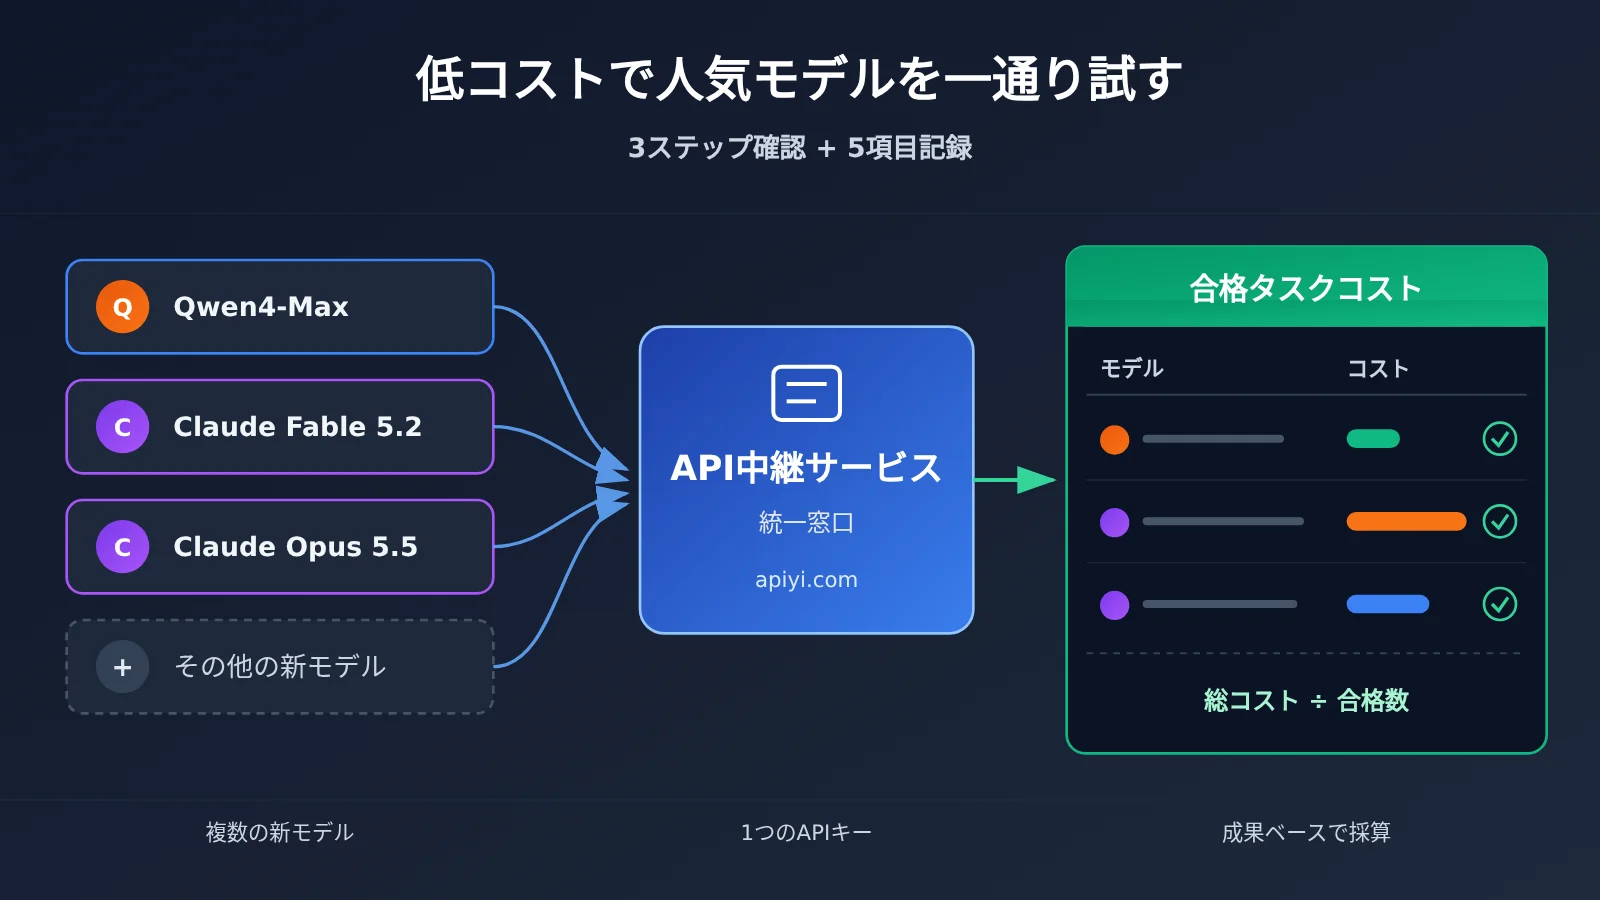
新しいモデルが次々と発表される時期に、話題のモデルを低コストで一通り試したいなら、最も手間のかからない方法は統一されたAPI中継サービスの入口から接続を済ませることです。これにより、各社への個別登録やSDKごとの設定といった繰り返し作業を省けます。ただし、統一入口は「どう接続するか」を解決するだけで、「どれを選ぶべきか」には答えてくれません。正しい順序は、まずモデルカタログ・キーの権限・エンドポイントを確認し、そのうえで同じ実タスク群を使って合格した成果物と総コストを比較することです。本記事ではAPIYI apiyi.comを例に、この小予算・合格基準付きの試用フローを実演します。
この記事を読むとわかること
- 現在のカタログにおける Qwen4-Max と Claude Fable 5.2 の正確なモデルID、利用可能なエンドポイントとグループ。
- 再利用できる基本接続コードと、「このAPIキーでどのモデルが見えるか」を先に確認する方法。
- 小規模なサンプルタスク、usage記録、請求書を使って試用コストを抑え、「合格タスクあたりのコスト」で取捨選択する方法。
目次:「客観的事実」のパートでは、2026-11-17時点のカタログ項目、接続条件、試用ポリシーを列挙し、第三者資料における見積もりやランキングスコアがそれぞれ誰に帰属するのかを説明します。「分析と判断」のパートでは三つの点を論じます。同じ課題の小サンプルをどう設計するか、コストをどう記録するか、そして「カタログで見える」「呼び出しに成功する」「成果物が合格する」という三者の間のギャップです。最後に、読者ご自身で記入できる記録表を添えます。
知っておきたい:API中継サービスで人気モデルをテストする前に必要な概念
| 概念 | 簡単な説明 |
|---|---|
| API中継サービス | 複数ベンダーのモデルリクエストを同一のサービス入口にまとめるゲートウェイ |
| モデルID | リクエストでモデルを正確に指定するための文字列。たとえば qwen4-max |
| エンドポイント | サービスが特定の機能を提供する具体的なリクエストパス。chat、responses、messages など |
| トークングループ | あるキーがどのモデルチャネルを利用できるか、どの課金係数で精算するかを制限する設定 |
| usage | レスポンスに含まれる使用量の記録。今回実際に消費したTokenを確認するために使う |
| キャッシュ読み取り | 処理済みの入力プレフィックスを再利用すること。その価格は新しい入力とは異なる場合がある |
| 合格タスクコスト | すべての試行にかかった総コスト ÷ 最終的に合格基準を満たしたタスク数 |
影響をひと目で:API中継サービスでのモデルテストが異なるユーザー層にとって何を意味するか
- 初めて接続する開発者:Base URL とキー1つでモデルを切り替えられ、複数のプラットフォームでアカウントやSDKを重複して設定する必要がありません。
- 既存事業を持つチーム:自社の合格基準で新モデルをテストでき、他者のランキング結果に頼る必要がありません。ただしツール呼び出し、視覚、推論などのパラメータは個別に調整が必要です。
- 予算に敏感な個人ユーザー:まずタスク数と入力長を制限し、そのうえで「利用可能な産出」でコストを計算しましょう。100万Tokenあたりの単価だけを見てはいけません。
客観的事実:API中継サービスにおける現在の人気モデルカタログと接続条件
カタログの中身:qwen4-max と claude-fable-5-2 のエントリ
APIYIが公開している機械可読なモデルレジストリ(docs.apiyi.com/model-registry.json)は、データの出所をプラットフォームの料金APIと明示しており、生成日時は 2026-11-17T07:54:33Z です。この表には全部で285件のモデルレコードが含まれています。ここで注意すべきは、これはカタログ上のレコード数であり、あるアカウントで実際に利用できるモデル数とは異なるという点です。本記事に関連する3つのエントリは以下のとおりです:
| 正確なモデルID | カタログ上のエンドポイント | グループ(マシンID) | カタログ表示価格:入力 / 出力 / キャッシュ読み取り(100万トークンあたり米ドル) |
|---|---|---|---|
claude-fable-5-2 |
chat / messages | ClaudeCode / ClaudeCodeReverse / ClaudeOfficial / default / svip | 8 / 40 / 0.2 |
claude-opus-5-5 |
chat / messages | ClaudeCode / ClaudeCodeReverse / ClaudeOfficial / default / svip | 4 / 20 / 0.2 |
qwen4-max |
chat / responses / messages | ClaudeCode / CodexResponses / default / svip | 1.5 / 4.5 / 0.075 |
上記の価格はいずれも 2026-11-17 時点のカタログ表示価格であり、アカウントの実際の支払額ではありません。実際の決済額はトークングループなどの要因にも左右されます。また、以前にはブログや旧アナウンスでこれら2つのモデルが「まだ提供されていない」とされていたこともありました。そうした記述は発表当時の状態に対応するものであり、今日呼び出せるかどうかの結論にはなりません。
レジストリではFableに対してリバースグループ(ClaudeCodeReverse)が記載されていますが、初期のアナウンスやFAQではこのグループは開放されていませんでした。そのため本記事では default または ClaudeCode グループを例とし、リバースグループが利用可能であることを保証するものではありません。公式の転送チャネルが必要な場合は、Fableエントリの ClaudeOfficial グループにご注目ください。
接続方法:Base URL と可視性の確認
クイックスタートドキュメント(docs.apiyi.com/getting-started、2026-11-17 時点で確認)で示されている基本設定は次のとおりです:
- OpenAI 互換 SDK の Base URL:
https://api.apiyi.com/v1 - Anthropic SDK の Base URL:
https://api.apiyi.com - まず
GET /v1/modelsをリクエストして、現在の APIキーでどのモデルが見えるかを確認し、そのうえで互換性のあるエンドポイントを選びます。
2つのモデルはどちらも chat エンドポイントに対応しているため、以下の例はすべて OpenAI 互換の Chat Completions を使います。まずモデルが見えることを確認し、それから最短のリクエストを1件送って usage を出力します:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # APIYI の OpenAI 互換エンドポイント
)

visible = {m.id for m in client.models.list().data}
for model in ["qwen4-max", "claude-fable-5-2"]:
    if model not in visible:
        print(f"{model}: 本密钥不可见,检查令牌分组")
        continue
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是API中转站。"}],
        max_tokens=100,
    )
    print(model, r.usage, r.choices[0].message.content)
試用クレジット:最新のクイックスタートページを参照
現在のクイックスタートページには、アカウント登録時に 0.05ドル の試用クレジットが付与され、チャージなしでも初回呼び出しを検証できると記載されています。以前のカードにあった「登録で300万トークン進呈」という説明は現在は適用されません。具体的なルールはアカウントページの表示に従ってください。なお、本記事の執筆時点では有料モデルの呼び出しは一切行っておらず、文中の「コスト」はすべてカタログ価格に基づく概算であり、実測の請求額ではありません。
統一インターフェースで共通する部分と共通しない部分
APIYIのテキスト生成機能ドキュメントによると、統一チャットインターフェースは、共通するテキスト入力・出力部分を比較するのに適しています。マルチターン対話の履歴は呼び出し側が自身で構成します。モデルごとに能力、推論設定、利用可能なパラメータは異なり、ツール呼び出し、視覚入力、推論強度などの要件には個別の対応が必要です。model フィールドを置き換えるだけでは、こうした作業を省けません。
サードパーティ資料の読み方:OrcaRouter の料金とベンチマークスコア
最近、この2つのモデルを扱った英語資料の多くは、別のルーティングサービスプロバイダーである OrcaRouter のブログ(2026-11-16 公開)に由来しています。そこに含まれる主なポイントは次のとおりです。
- 公開時期:Qwen4-Max は 2026-11-16 に正式提供を開始しました。Claude Fable 5.2 の公開日は 2026-11-09 です。また、いわゆる「Claude Fable 5.5」は Anthropic の公式モデルリストには存在しません。
- ベンチマークスコアと1タスクあたりのコスト:記事が引用した Artificial Analysis のデータ(2026-11-17 時点)によると、Qwen4-Max の総合指数は約 42.9、指数タスクあたりの実測コストは 3.27 ドルです。Fable 5.2 はデフォルトの medium 設定で指数 56.4、1タスクあたりコスト 3.80 ドルです。記事では同時に、Qwen4-Max が評価時に出力するトークン量がやや多いとも指摘しています。
- プレビュー版の提供終了:
qwen4-max-previewなどのプレビュー ID は 2026-11-25 24:00(UTC+8)をもって提供を停止します。その後は正式 IDqwen4-maxが残ります。
上記の数値はすべて同サービスプロバイダーおよび対応する第三者評価に帰属するものであり、APIYI の料金でも、本記事による実測結果でもありません。これらの参考価値は、単価が低いからといって、1タスクあたりのコストが低いとは限らない という考え方を示している点にあります。
分析と判断:API中継サービスで人気モデルを低コストで一通りテストする方法
まずタスクと合格基準を決め、同じ課題の小規模サンプルを実行する
統一エンドポイントによって接続コストはほぼゼロになり、本当のコストは「何をテストするか」に移りました。実際のニーズから 3〜5 件の小タスクを選び、各タスクについて入力バージョン、合格基準、判定根拠を固定することをおすすめします。たとえば、「出力は解析可能な JSON でなければならず、5 つのフィールドを含むこと」、あるいは「要約は原文にある 3 つの数値を漏らしてはならない」といった基準です。事前に基準を書いておかないと、テストの最後には「どれがより良く感じるか」しか残らないことがよくあります。
次に、同じ入力を候補モデルそれぞれに送り、判定ルールを統一します。空レスポンス、フォーマットエラー、途中で切れた出力はいずれも不合格です。パラメータもまず共通の最小セットを使い、model、messages、max_tokens だけを設定します。ツール呼び出し、視覚、推論強度などの要件は別ラウンドでテストし、「パラメータ設定が不適切なだけ」を「モデルが使えない」と誤判定しないようにします。
🚀 導入のヒント:初回の小規模サンプルは、APIYI apiyi.com への登録時に付属する試用クレジットでそのまま行えます。まず 2〜3 の候補モデルがお使いの APIキーで表示され、呼び出し可能であることを確認してから、チャージしてテスト範囲を広げるかどうかを決めましょう。
すべての試行をコストに計上する:合格タスクコスト
リクエストごとに、usage の入力・出力・キャッシュ読み取り(レスポンスにそのフィールドが返る場合)を記録し、リトライや失敗したリクエストもあわせて記録します。核心となる指標は 合格タスクコスト = 全試行の総コスト ÷ 合格タスク数 です。成功した1回分のコストだけを数えると、「安いが何度もリトライが必要な」モデルを系統的に過小評価してしまいます。
以下は定価に基づく純粋な算術見積もりです(実際の課金を表すものではありません。グループ係数によって結果は変わります)。1回のリクエストの入力が2,000トークン、出力が500トークンと仮定します:
| モデル | 入力費用 | 出力費用 | 1回あたりの推定 | 0.05ドルで概ね実行できる回数 |
|---|---|---|---|---|
qwen4-max(1.5 / 4.5) |
0.003ドル | 0.00225ドル | 約0.0053ドル | 約9回 |
claude-fable-5-2(8 / 40) |
0.016ドル | 0.02ドル | 約0.036ドル | 約1回 |
この表から2つの結論が導けます。第一に、トライアル枠で「通るかどうか」を検証するには十分ですが、本格的に品質を比較するにはもっと予算が必要です。第二に、あるモデルの実際の出力がより長い場合や、合格までに2回リトライが必要な場合、単価上の優位性は打ち消されてしまいます。前段で触れた第三者資料の現象はまさにこれです。そのため予算は2段階で管理します。まずアカウント残高と1回あたりの max_tokens で上限を設定し、短いテキストから実行して合格率を確認したうえで、長いコンテキストに移ります。
以下はそのまま再利用できる記録スクリプトです。各試行をCSVに書き出し、後から合格タスクコストを計算できるようにします:
同一タスクのサンプル記録スクリプトを見る
import csv, time
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

MODELS = ["qwen4-max", "claude-fable-5-2"]
TASKS = [
    {"id": "t1", "prompt": "以下の会議議事録をJSONに整理してください:...", "check": lambda s: s.strip().startswith("{")},
    # 実際のタスクをさらに2〜4件追加し、それぞれに判定関数を用意する
]

with open("trial_log.csv", "w", newline="", encoding="utf-8") as f:
    w = csv.writer(f)
    w.writerow(["model", "task", "attempt", "prompt_tokens", "completion_tokens",
                "cached_tokens", "passed", "latency_s", "error"])
    for model in MODELS:
        for t in TASKS:
            for attempt in range(1, 3):  # 最大1回リトライ、失敗も記録する
                start = time.time()
                try:
                    r = client.chat.completions.create(
                        model=model,
                        messages=[{"role": "user", "content": t["prompt"]}],
                        max_tokens=800,
                    )
                    text = r.choices[0].message.content or ""
                    u = r.usage
                    details = getattr(u, "prompt_tokens_details", None)
                    cached = getattr(details, "cached_tokens", 0) if details else 0
                    ok = bool(text) and t["check"](text)
                    w.writerow([model, t["id"], attempt, u.prompt_tokens,
                                u.completion_tokens, cached, ok,
                                round(time.time() - start, 2), ""])
                    if ok:
                        break
                except Exception as e:
                    w.writerow([model, t["id"], attempt, 0, 0, 0, False,
                                round(time.time() - start, 2), str(e)[:120]])
統一エントリーポイントで省けるもの、省けないもの
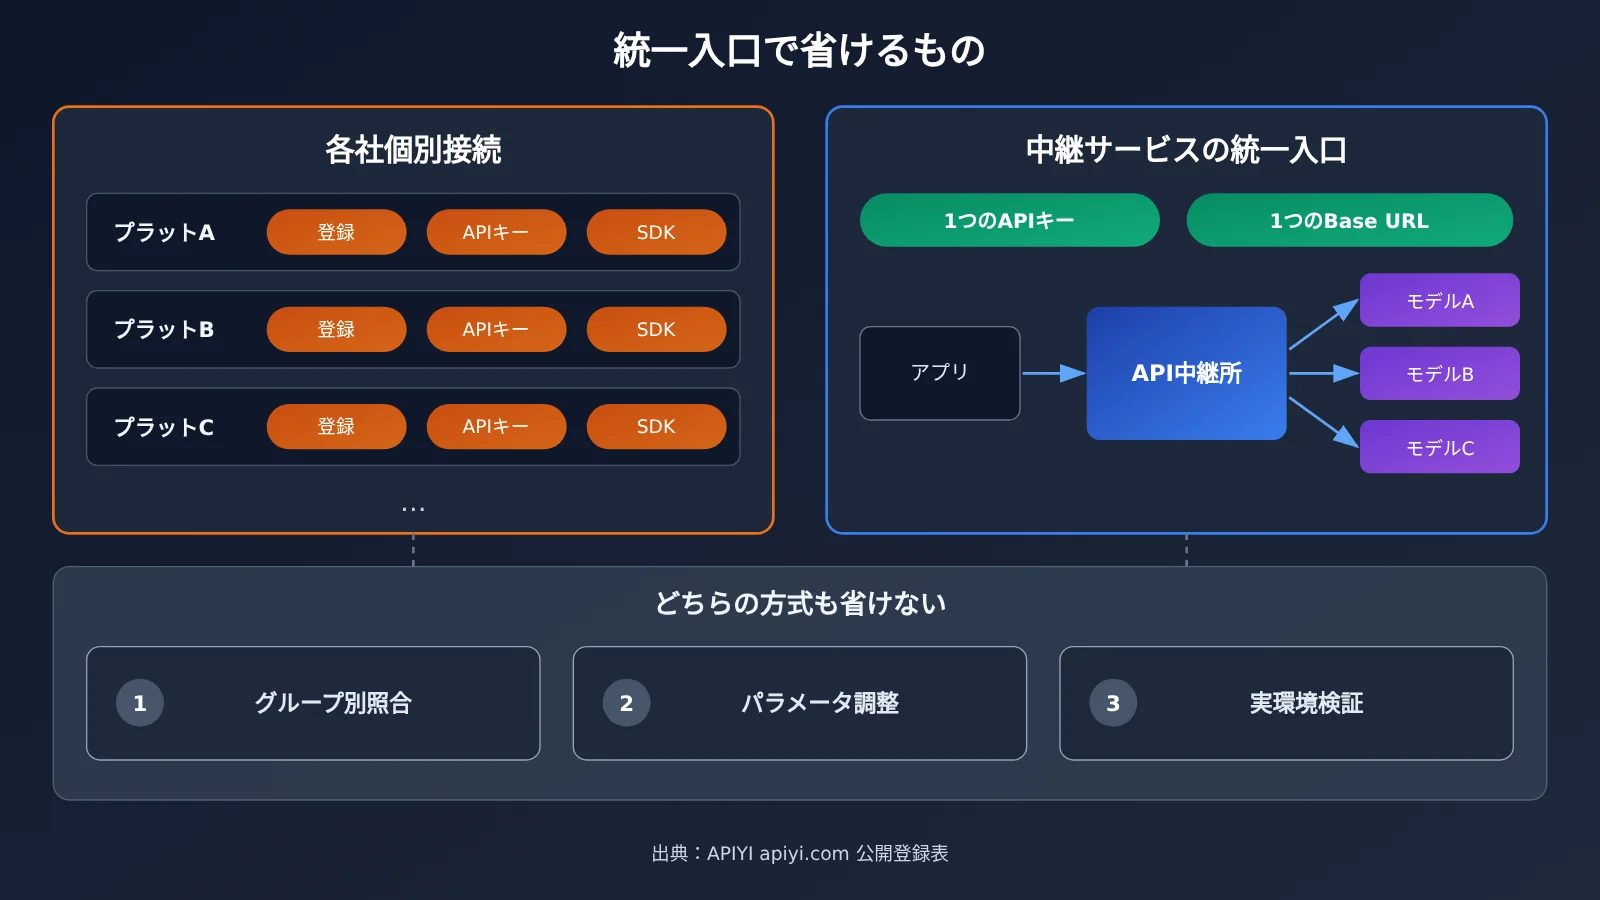
統一エントリーポイントで省けるのは、重複するアカウント、APIキー、SDK の設定です。省けないのは次の3つです:
- グループと可視性:ディレクトリに掲載されていても、あなたのAPIキーから見えるとは限りません;
- パラメータの適合:共通でないパラメータはモデルごとに個別対応が必要です;
- 結果の検証:モデルが見えても、呼び出しが成功して合格できる出力が得られるとは限りません。
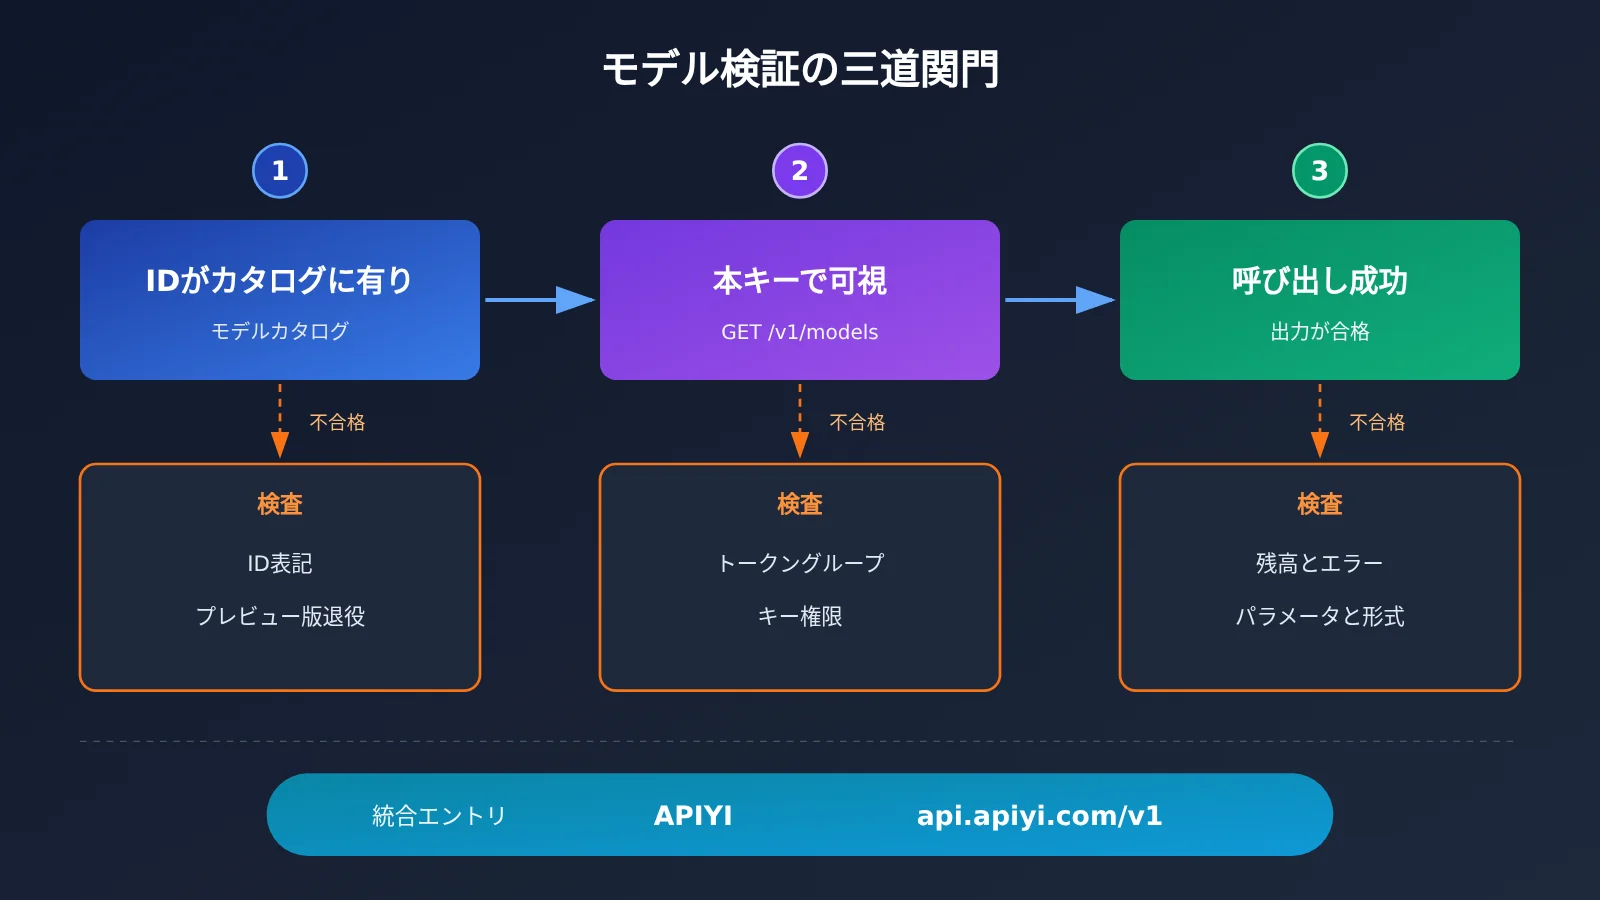
ディレクトリで見える、APIキーで見える、呼び出しが成功する、合格できる出力が得られる、というのは順に進む4つの関門で、それぞれ個別に検証する必要があります。以下の表はテスト時に項目ごとにチェックできます:
| 確認項目 | 検証方法 | 未通過時のよくある原因 |
|---|---|---|
| ディレクトリにそのモデルIDが存在する | 公開レジストリを確認し、ID の綴りが正確か確かめる | プレビュー ID やエイリアスを使用している |
| このAPIキーで見える | GET /v1/models を呼び出す |
トークングループにそのチャネルが含まれていない |
| エンドポイント互換 | ディレクトリのエンドポイント列と照合する | chat で responses のみ対応の機能を呼び出した |
| 呼び出し成功 | 実際に最短のリクエストを発行する | 残高不足、パラメータが未対応 |
| 合格出力 | 事前に定めた判定ルールでチェックする | 形式エラー、切り捨て、空の返却 |
💡 選択のヒント:APIYI apiyi.com のコンソールでテスト専用のトークンを1つ作成し、テストに必要なグループだけをチェックしてください。こうすれば請求や usage を本番トラフィックと分けられ、事後に合格タスクのコストを計算するのも明確になります。
ご自身で記入する結論表
本記事では、qwen4-max と claude-fable-5-2 の品質ランキングは提示しません。私たちはあなたのタスクで実験を行っていませんし、第三者のベンチマークもあなたのビジネスを代表するものではないからです。より確実な方法は、小規模なサンプルを実行したあとにご自身で以下の表を記入し、それから判断することです。
| モデル | 試行回数 | 合格数 | 総コスト(請求書ベース) | 合格タスクあたりのコスト | 追加で調整が必要なパラメータ |
|---|---|---|---|---|---|
| qwen4-max | |||||
| claude-fable-5-2 | |||||
| 現在使用中のモデル |
参考までに2つ提案します。いずれも判断であり、検証済みの結論ではありません。第一に、現在使用中のモデルも同じ表に入れてください。新しいモデルは「合格タスクあたりのコスト」または「合格率」で明らかに勝っている場合にのみ、移行する価値があります。第二に、新しいモデルのリリース初期は、ID、価格、パラメータの上限が変わる可能性があります。前述のプレビュー ID が 11 月 25 日に退役するのもその一例です。モデル ID はハードコードせず設定ファイルに書き込み、あわせてフォールバック経路を1つ残すことをおすすめします。候補の範囲を広げたい場合は、APIYI apiyi.com の統一エントリから新しいモデルを追加し、同じタスクと同じ判定ルールで再度実行すればよいだけです。
ベンチマークやカタログは、どのモデルが試す価値があるかを教えてくれるだけです。どのモデルがあなたのビジネスに本当に合っているかは、自分自身で実際に走らせて作ったあの表が答えてくれます。陸游が「冬夜読書示子聿」に詠んだように、「紙の上で得たものはつねに浅く、このことを極めるには自ら実践するに如かず」なのです。