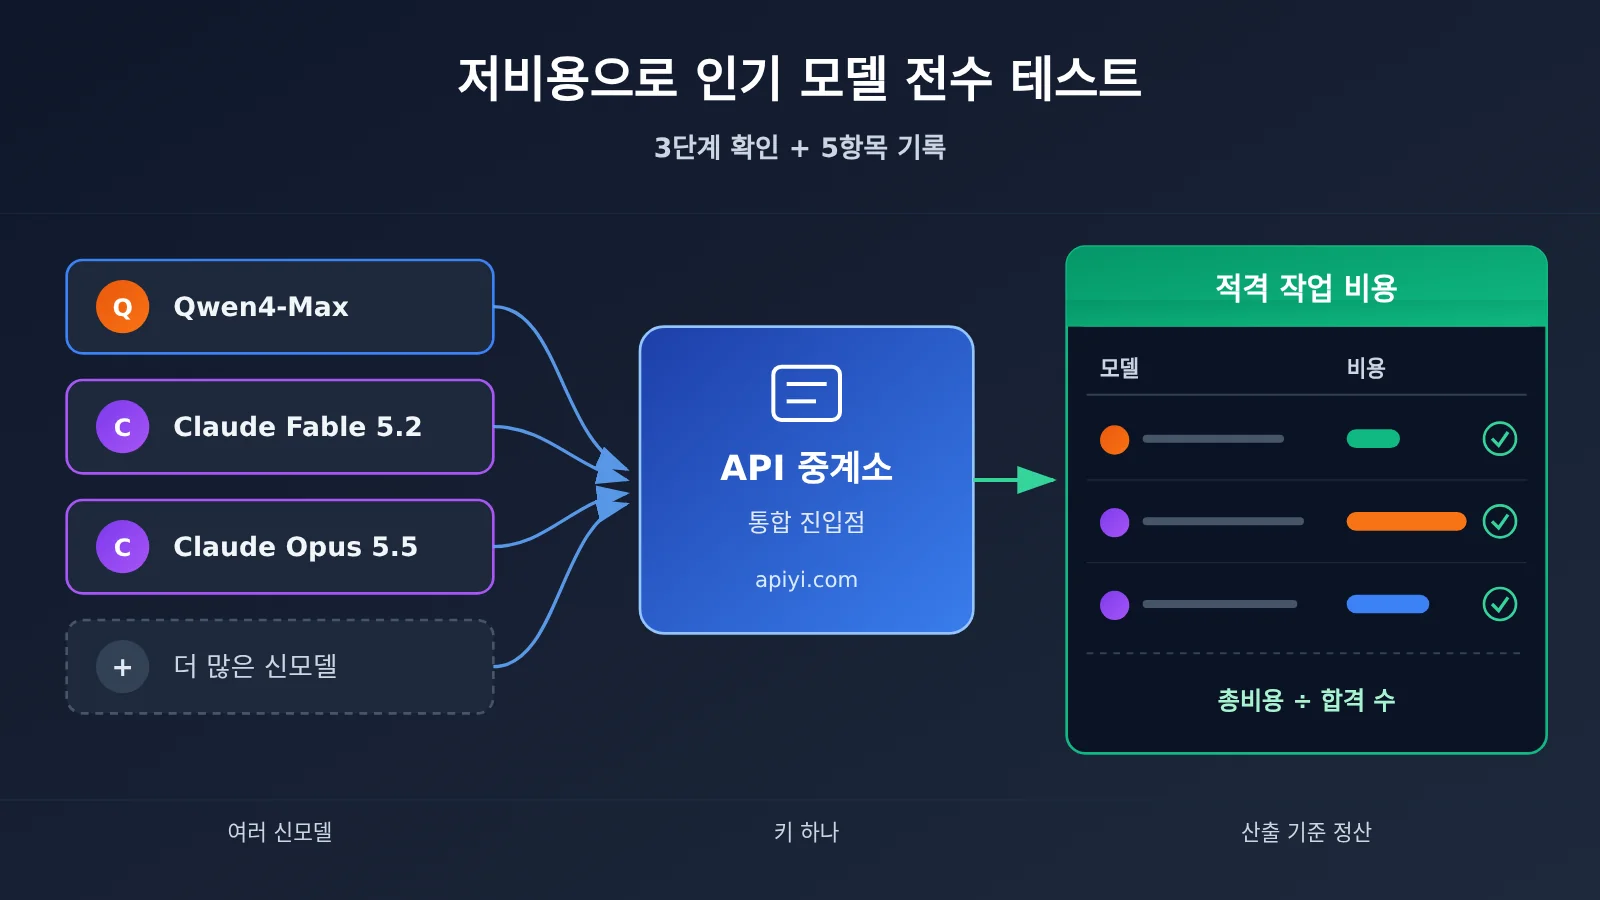
새 모델이 우르르 쏟아져 나올 때, 인기 모델을 저렴한 비용으로 하나하나 다 테스트해 보고 싶다면 가장 손이 덜 가는 방법은 하나의 통합 API 중계 서비스 엔드포인트로 접속을 마무리하는 것이에요. 이렇게 하면 업체마다 따로 가입하고, SDK를 하나씩 설정하는 반복 작업을 덜어낼 수 있어요. 다만 통합 엔드포인트는 “어떻게 연결할지”만 해결해 줄 뿐, “누구를 선택할지”는 알려 주지 않아요. 올바른 순서는 먼저 모델 카탈로그, 키 권한, 엔드포인트를 확인한 다음, 같은 실제 작업 묶음으로 합격 산출물과 총비용을 비교하는 거예요. 이 글에서는 APIYI apiyi.com을 예로 들어, 적은 예산과 명확한 검수 기준을 갖춘 체험 절차를 보여 드릴게요.
이 글을 읽고 나면 무엇을 알 수 있나요?
- 현재 카탈로그에 있는 Qwen4-Max와 Claude Fable 5.2의 정확한 모델 ID, 사용 가능한 엔드포인트와 그룹.
- 재사용할 수 있는 기본 접속 코드와, “이 키로 어떤 모델을 볼 수 있는지”부터 확인하는 방법.
- 소량 샘플 작업, usage 기록, 청구서로 체험 비용을 통제하고, “합격 작업당 비용”을 기준으로 선택을 결정하는 방법.
색인: “객관적 사실” 부분에서는 2026-11-17 기준 카탈로그 항목, 접속 조건, 체험 정책을 먼저 나열하고, 제3자 자료에 나오는 견적과 순위 점수가 각각 누구에게 귀속되는지도 설명해요. “분석과 판단” 부분에서는 세 가지를 다뤄요. 같은 문제로 소량 샘플을 어떻게 설계할지, 비용을 어떻게 기록할지, 그리고 카탈로그에서 보이는 것·호출에 성공한 것·산출물이 합격한 것 사이의 간극이에요. 마지막에는 독자가 직접 채워 넣을 기록표를 붙여 드려요.
To Know: API 중계 서비스로 인기 모델을 테스트하기 전에 필요한 개념
| 개념 | 간단한 설명 |
|---|---|
| API 중계 서비스 | 여러 벤더의 모델 요청을 하나의 서비스 진입점으로 연결해 주는 게이트웨이 |
| 모델 ID | 요청에서 모델을 정확히 지정할 때 쓰는 문자열, 예를 들어 qwen4-max |
| 엔드포인트 | 서비스가 특정 기능을 제공하는 구체적인 요청 경로, 예를 들어 chat, responses, messages |
| 토큰 그룹 | 특정 키가 어떤 모델 채널을 사용할 수 있는지, 어떤 청구 계수로 정산할지를 제한하는 설정 |
| usage | 응답에 담긴 사용량 기록으로, 이번에 실제로 소비한 토큰을 확인하는 데 쓰여요 |
| 캐시 읽기 | 이미 처리된 입력 접두사를 재사용하는 것, 새 입력과 가격이 다를 수 있어요 |
| 합격 태스크 비용 | 모든 시도의 총비용 ÷ 최종적으로 검수 기준을 충족한 태스크 수 |
영향 요약: API 중계 서비스로 모델을 테스트하는 일이 사람마다 어떤 의미인지
- 처음 접속하는 개발자: Base URL 하나에 키 하나만 있으면 모델을 전환할 수 있어요. 여러 플랫폼에서 계정과 SDK를 반복해서 설정할 필요가 없죠.
- 이미 비즈니스가 있는 팀: 자체 합격 기준으로 새 모델을 테스트할 수 있고, 다른 사람의 리더보드 결론에 의존하지 않아도 돼요. 다만 툴 호출, 비전, 추론 같은 파라미터는 여전히 따로 맞춰야 해요.
- 예산에 민감한 개인 사용자: 먼저 태스크 수와 입력 길이를 제한하고, 그다음 ‘쓸 만한 산출’을 기준으로 계산하세요. 100만 토큰당 단가만 보고 판단하지 마세요.
객관적 사실: API 중계 서비스의 현재 인기 모델 디렉터리와 접속 조건
디렉터리에 무엇이 있나: qwen4-max와 claude-fable-5-2 항목
APIYI가 공개한 기계 판독 가능한 모델 레지스트리(docs.apiyi.com/model-registry.json)가 밝힌 데이터 출처는 플랫폼 가격 책정 인터페이스이며, 생성 시각은 2026-11-17T07:54:33Z입니다. 이 표에는 총 285개의 모델 레코드가 있습니다. 주의할 점은 이것이 디렉터리 레코드 수일 뿐, 특정 계정에서 실제로 사용할 수 있는 모델 수와 같지는 않다는 것입니다. 이 글과 관련된 세 항목은 다음과 같습니다:
| 정확한 모델 ID | 디렉터리 엔드포인트 | 그룹(머신 ID) | 디렉터리 표시 가격: 입력 / 출력 / 캐시 읽기(미국 달러/백만 토큰) |
|---|---|---|---|
claude-fable-5-2 |
chat / messages | ClaudeCode / ClaudeCodeReverse / ClaudeOfficial / default / svip | 8 / 40 / 0.2 |
claude-opus-5-5 |
chat / messages | ClaudeCode / ClaudeCodeReverse / ClaudeOfficial / default / svip | 4 / 20 / 0.2 |
qwen4-max |
chat / responses / messages | ClaudeCode / CodexResponses / default / svip | 1.5 / 4.5 / 0.075 |
위 가격은 모두 2026-11-17 기준 디렉터리 표시 가격이며, 계정에서 실제로 결제하는 금액은 아닙니다. 실제 정산은 토큰 그룹 등 요인의 영향을 받습니다. 또한 이전 블로그와 오래된 공지에서는 이 두 모델이 “아직 출시되지 않았다”고 언급한 적이 있습니다. 이런 표현은 해당 발표 당시의 상태만 반영할 뿐, 오늘 호출 가능한지 여부의 결론으로 삼을 수는 없습니다.
레지스트리에는 Fable에 대해 리버스 그룹(ClaudeCodeReverse)이 나열되어 있지만, 초기 공지와 FAQ에서는 해당 그룹을 개방하지 않았습니다. 따라서 이 글에서는 default 또는 ClaudeCode 그룹을 예로 들며, 리버스 그룹의 사용 가능성은 보장하지 않습니다. 공식 포워딩 채널이 필요하다면 Fable 항목의 ClaudeOfficial 그룹을 참고하세요.
연동 방법: Base URL과 가시성 확인
빠른 시작 문서(docs.apiyi.com/getting-started, 2026-11-17 조회)에서 제시하는 기본 설정은 다음과 같아요:
- OpenAI 호환 SDK의 Base URL:
https://api.apiyi.com/v1 - Anthropic SDK의 Base URL:
https://api.apiyi.com - 먼저
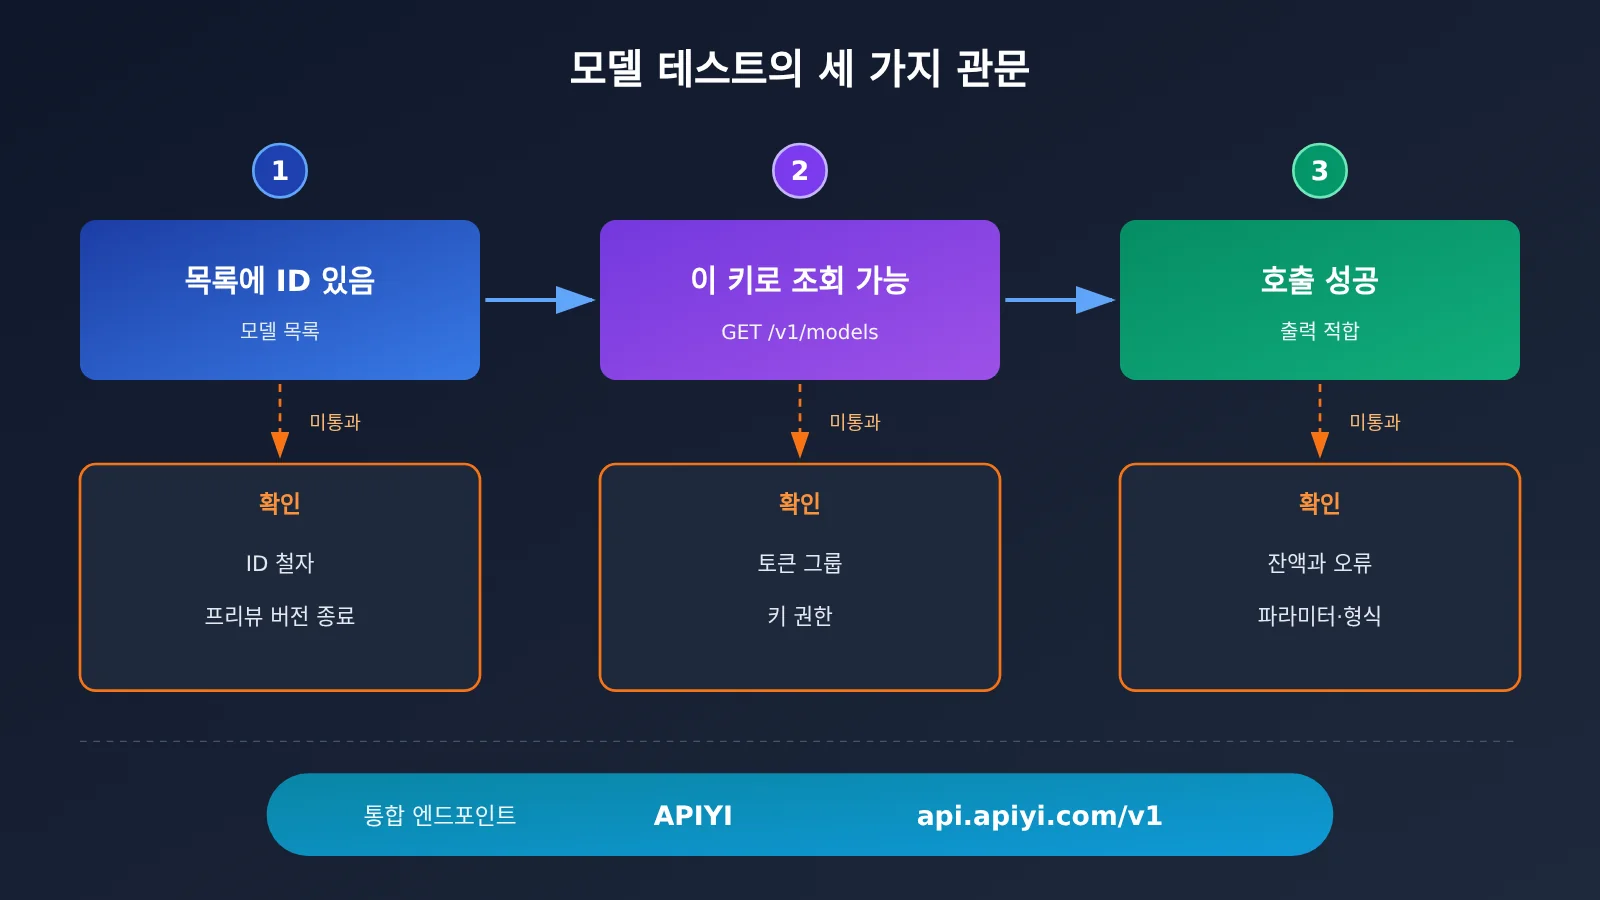
GET /v1/models를 요청해 현재 키로 볼 수 있는 모델을 확인한 뒤, 호환되는 엔드포인트를 선택하세요.
두 모델 모두 chat 엔드포인트를 지원하므로, 아래 예시는 모두 OpenAI 호환 Chat Completions를 사용합니다. 먼저 모델 가시성을 확인하고, 가장 짧은 요청을 보낸 뒤 usage를 출력해 보세요:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # APIYI OpenAI 호환 엔드포인트
)

visible = {m.id for m in client.models.list().data}
for model in ["qwen4-max", "claude-fable-5-2"]:
    if model not in visible:
        print(f"{model}: 本密钥不可见,检查令牌分组")
        continue
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是API中转站。"}],
        max_tokens=100,
    )
    print(model, r.usage, r.choices[0].message.content)
체험 크레딧: 최신 빠른 시작 페이지 기준
현재 빠른 시작 페이지에는 계정을 등록하면 0.05달러 체험 크레딧이 제공되며, 충전 없이 첫 호출을 검증할 수 있다고 나와 있어요. 초기 카드에 있던 “등록하면 300만 토큰 증정”이라는 문구는 더 이상 적용되지 않으며, 구체적인 내용은 계정 페이지에 표시되는 규칙을 기준으로 해야 해요. 덧붙여, 이 글을 쓰는 동안 유료 모델 호출은 전혀 하지 않았고, 글에 나오는 모든 “비용”은 카탈로그 가격을 기준으로 한 추정치일 뿐 실제 청구서로 확인한 금액은 아니에요.
통합 인터페이스가 공유하는 것과 공유하지 않는 것
APIYI 텍스트 생성 기능 문서에 따르면, 통합 채팅 인터페이스는 공통된 텍스트 입력·출력 부분을 비교하는 데 적합해요. 멀티턴 대화의 히스토리는 호출자가 직접 구성해야 해요. 모델마다 기능, 추론 설정, 선택 가능한 파라미터가 여전히 다르기 때문에 도구 호출, 비전 입력, 추론 강도 같은 요구 사항은 별도로 맞춰야 해요. 단순히 model 필드만 바꾼다고 해서 이런 작업이 면제되는 것은 아니에요.
서드파티 자료 읽는 법: OrcaRouter의 가격과 벤치마크 점수
최근 이 두 모델에 관한 영어 자료는 대부분 또 다른 라우팅 서비스 제공업체인 OrcaRouter의 블로그(2026-11-16 게시)에서 나왔는데, 핵심 정보는 다음과 같아요:
- 출시 시점: Qwen4-Max는 2026-11-16에 정식 출시되었고, Claude Fable 5.2의 출시 시점은 2026-11-09예요. 이른바 “Claude Fable 5.5″는 Anthropic 공식 모델 목록에 존재하지 않아요.
- 벤치마크 점수와 작업당 비용: 글에서 인용한 Artificial Analysis 데이터(2026-11-17 기준)에 따르면, Qwen4-Max의 종합 지수는 약 42.9이고, 지수 작업당 측정 비용은 3.27달러예요. Fable 5.2는 기본 medium 등급에서 지수 56.4, 작업당 비용 3.80달러예요. 글은 동시에 Qwen4-Max가 평가에서 출력 Token량이 다소 많다고 지적했어요.
- 프리뷰 버전 서비스 종료:
qwen4-max-preview등 프리뷰 ID는 2026-11-25 24:00(UTC+8)에 서비스가 중단되고, 이후 유지되는 정식 ID는qwen4-max예요.
위 숫자들은 모두 해당 서비스 제공업체와 그에 대응하는 서드파티 평가에 속하는 것으로, APIYI의 가격도 아니고 이 글의 실측 결론도 아니에요. 이들의 참고 가치는 하나의 사고방식을 제공한다는 데 있어요: 단가가 낮다고 해서 작업당 비용이 낮은 것은 아니에요.
분석과 판단: API 중계 서비스로 인기 모델을 저비용으로 전부 테스트하는 방법
먼저 과제와 검수 기준을 정한 뒤, 동일 문제의 소규모 샘플을 만드세요
단일 진입점은 접속 비용을 거의 0에 가깝게 낮췄고, 이제 진짜 비용은 ‘무엇을 테스트할지’로 옮겨갔어요. 실제 요구에서 3–5개의 작은 과제를 골라내고, 각 과제마다 입력 버전, 합격 기준, 판정 근거를 고정해두는 걸 권장해요. 예를 들어 “출력은 반드시 파싱 가능한 JSON이어야 하고 5개의 필드를 포함해야 한다”, 또는 “요약은 원문에 있는 3개의 숫자를 빠뜨려서는 안 된다” 같은 식이죠. 기준을 미리 써두지 않으면, 테스트가 끝났을 때 남는 건 대개 “어느 쪽이 더 좋은 것 같다”는 느낌뿐이에요.
다음으로, 같은 입력을 후보 모델에 각각 보내고 판정 규칙은 일관되게 유지해요: 빈 응답, 형식 오류, 잘림(truncation)은 모두 불합격이에요. 파라미터도 우선 공통 최소 집합으로 시작해서 model, messages, max_tokens만 설정해요. 도구 호출, 비전, 추론 강도 같은 요구는 별도로 한 라운드를 열어 테스트해서, “파라미터를 잘못 조정한 것”을 “모델이 안 좋다”라고 오판하지 않도록 해요.
🚀 시작 팁: 첫 라운드 소규모 샘플은 APIYI apiyi.com 가입 시 함께 제공되는 체험 크레딧으로 바로 완료할 수 있어요. 먼저 두세 개의 후보 모델이 내 키로 조회되고 호출되는지 확인한 다음, 테스트 범위를 넓히기 위해 충전할지 결정하세요.
모든 시도를 장부에 올리기: 합격 작업 비용
요청이 들어올 때마다 usage의 입력·출력·캐시 읽기(응답에 해당 필드가 돌아왔다면)를 기록하고, 재시도와 실패한 요청도 함께 남겨야 해요. 핵심 지표는 합격 작업 비용 = 전체 시도 총비용 ÷ 합격 작업 수예요. 성공한 한 번의 비용만 계산하면 “싸지만 재시도가 여러 번 필요한” 모델을 체계적으로 과소평가하게 돼요.
아래는 카탈로그 정가 기준의 순수 산술 추정이에요(실제 청구를 의미하지 않고, 그룹 계수에 따라 결과가 달라져요). 요청 1회당 입력 2,000 토큰, 출력 500 토큰이라고 가정해 볼게요.
| 모델 | 입력 비용 | 출력 비용 | 1회 추정 | 0.05달러로 대략 |
|---|---|---|---|---|
qwen4-max(1.5 / 4.5) |
0.003달러 | 0.00225달러 | 약 0.0053달러 | 약 9회 |
claude-fable-5-2(8 / 40) |
0.016달러 | 0.02달러 | 약 0.036달러 | 약 1회 |
이 표에서 두 가지 결론을 얻을 수 있어요. 첫째, 트라이얼 크레딧으로 “연결이 되는지” 검증하기에는 충분하지만, 품질을 정식으로 비교하려면 예산이 더 필요해요. 둘째, 어떤 모델의 실제 출력이 더 길거나 합격까지 두 번의 재시도를 거쳐야 한다면 단가 우위가 그대로 사라져요. 앞서 언급한 서드파티 자료에서 나온 현상이 바로 그렇고요. 그래서 예산은 두 단계로 나눠 관리해야 해요. 먼저 계정 잔액과 요청당 max_tokens로 상한을 걸고, 짧은 텍스트부터 돌려서 통과율을 확인한 다음에 긴 컨텍스트로 넘어가는 거예요.
아래는 바로 재사용할 수 있는 기록 스크립트예요. 시도할 때마다 CSV에 기록해서 나중에 합격 작업 비용을 계산하기 쉽게 해줘요.
동일 문제 소규모 샘플 기록 스크립트 보기
import csv, time
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

MODELS = ["qwen4-max", "claude-fable-5-2"]
TASKS = [
    {"id": "t1", "prompt": "把下面的会议记录整理为 JSON:...", "check": lambda s: s.strip().startswith("{")},
    # 실제 작업을 2–4개 더 추가하고, 각 태스크마다 판정 함수를 잘 작성해 두기
]

with open("trial_log.csv", "w", newline="", encoding="utf-8") as f:
    w = csv.writer(f)
    w.writerow(["model", "task", "attempt", "prompt_tokens", "completion_tokens",
                "cached_tokens", "passed", "latency_s", "error"])
    for model in MODELS:
        for t in TASKS:
            for attempt in range(1, 3):  # 최대 한 번 재시도, 실패해도 기록
                start = time.time()
                try:
                    r = client.chat.completions.create(
                        model=model,
                        messages=[{"role": "user", "content": t["prompt"]}],
                        max_tokens=800,
                    )
                    text = r.choices[0].message.content or ""
                    u = r.usage
                    details = getattr(u, "prompt_tokens_details", None)
                    cached = getattr(details, "cached_tokens", 0) if details else 0
                    ok = bool(text) and t["check"](text)
                    w.writerow([model, t["id"], attempt, u.prompt_tokens,
                                u.completion_tokens, cached, ok,
                                round(time.time() - start, 2), ""])
                    if ok:
                        break
                except Exception as e:
                    w.writerow([model, t["id"], attempt, 0, 0, 0, False,
                                round(time.time() - start, 2), str(e)[:120]])
통합 진입점이 줄여주는 것과 줄여주지 못하는 것
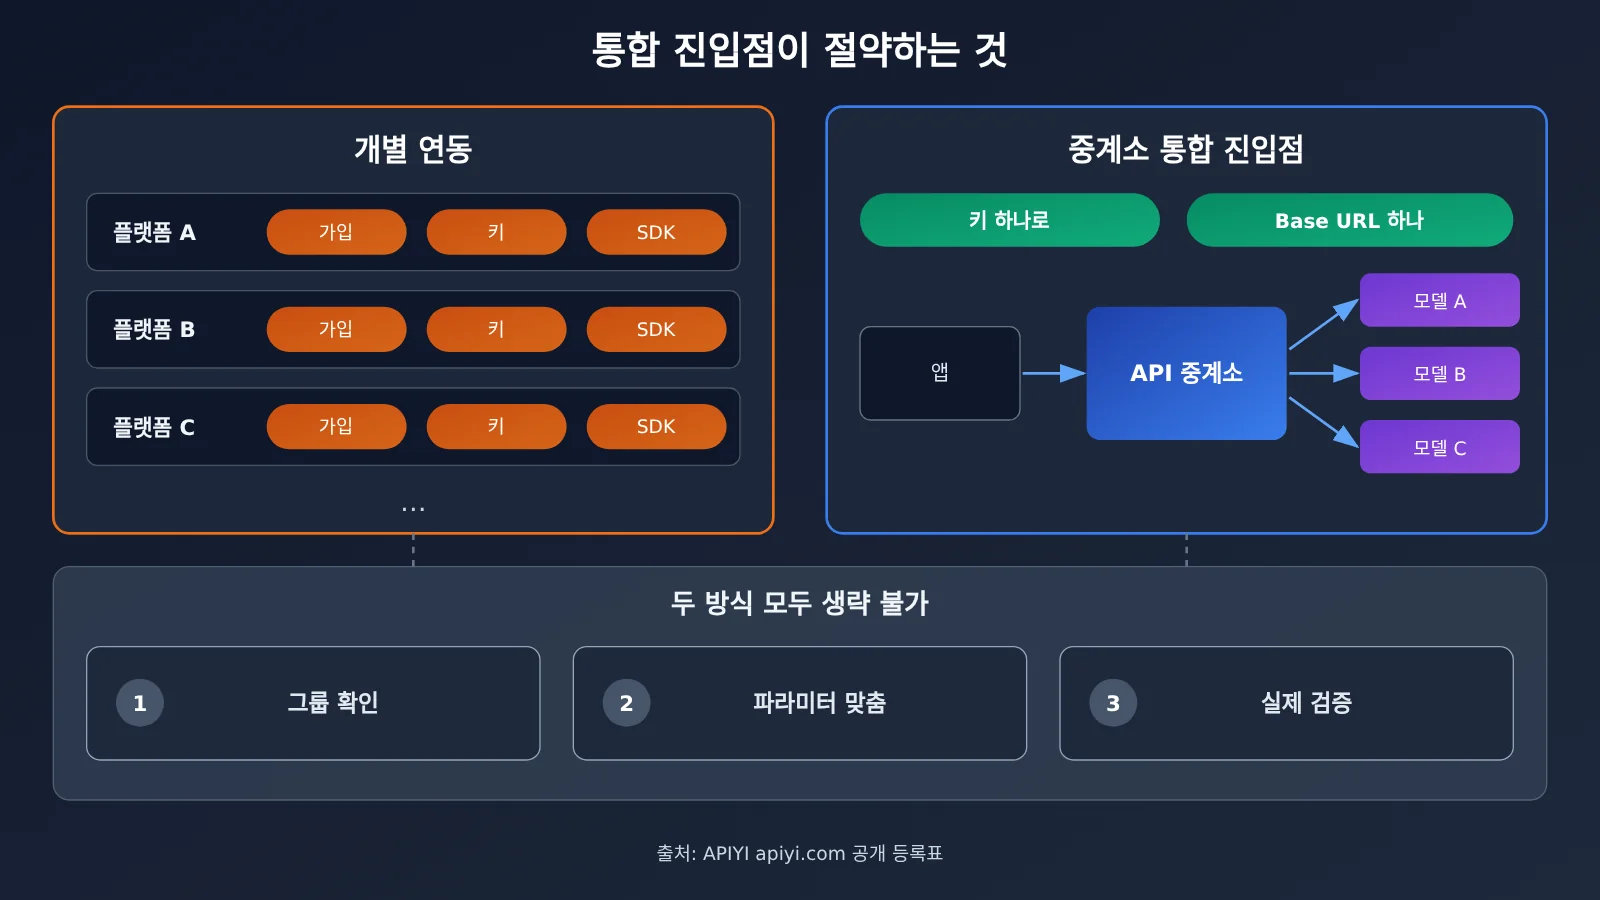
통합 진입점이 줄여주는 것은 중복된 계정, 키, SDK 설정이에요. 줄여주지 못하는 것은 세 가지입니다:
- 그룹과 가시성: 카탈로그에 있다고 해서 내 키로 볼 수 있는 건 아니에요.
- 파라미터 적응: 공통이 아닌 파라미터는 모델별로 따로 처리해야 해요.
- 결과 검수: 모델이 보인다고 해서 호출이 성공하고 산출물이合格이라는 뜻은 아니에요.
카탈로그 가시성, 키 가시성, 호출 성공, 산출물 합격은 차례로 이어지는 네 개의 관문이고, 각각을 따로 검증해야 해요. 아래 표는 테스트할 때 항목별로 체크하며 쓸 수 있어요:
| 확인 항목 | 검증 방법 | 미통과 시 흔한 원인 |
|---|---|---|
| 카탈로그에 해당 모델 ID가 존재 | 공개 레지스트리를 조회해 ID 철자가 정확한지 확인 | 미리보기 ID나 별칭을 사용 |
| 이 키로 볼 수 있음 | GET /v1/models 호출 |
토큰 그룹에 해당 채널이 포함되지 않음 |
| 엔드포인트 호환 | 카탈로그의 엔드포인트 열과 대조 | responses만 지원하는 기능을 chat으로 호출 |
| 호출 성공 | 실제로 최소 요청 발송 | 잔액 부족, 지원되지 않는 파라미터 |
| 산출물 합격 | 미리 정한 판정 규칙으로 검사 | 형식 오류, 잘림, 빈 응답 |
💡 선택 팁: APIYI apiyi.com 콘솔에서 테스트 전용 토큰을 하나 만들고, 테스트에 필요한 그룹만 체크하세요. 그러면 청구서와 usage를 프로덕션 트래픽과 분리할 수 있고, 나중에 합격 작업의 비용을 계산할 때도 더 명확해요.
직접 채워 넣는 결론 표
이 글에서는 qwen4-max와 claude-fable-5-2의 품질 순위를 매기지 않습니다. 여러분의 과제에서 직접 실험해 본 적이 없기 때문이고, 제3자 리더보드도 여러분의 비즈니스를 대변하지 못합니다. 더 신뢰할 만한 방법은 소규모 샘플을 돌린 뒤 아래 표를 직접 채워 넣고 결정하는 것입니다.
| 모델 | 시도 횟수 | 합격 수 | 총비용(청구서 기준) | 합격 과제당 비용 | 추가로 맞춰야 할 파라미터 |
|---|---|---|---|---|---|
| qwen4-max | |||||
| claude-fable-5-2 | |||||
| 현재 쓰는 모델 |
두 가지 조언을 참고용으로 드립니다. 둘 다 검증된 결론이 아니라 판단일 뿐입니다. 첫째, 현재 쓰는 모델도 같은 표에 넣어 보세요. 새 모델은 ‘합격 과제당 비용’이나 ‘합격률’에서 확실히 앞설 때만 갈아탈 가치가 있습니다. 둘째, 새 모델 출시 초기에는 ID, 가격, 파라미터 상한이 모두 바뀔 수 있습니다. 앞서 언급한 프리뷰 ID가 11월 25일에 은퇴하는 것도 그런 예입니다. 모델 ID는 하드코딩하지 말고 설정 파일에 적어 두고, 폴백 경로도 함께 남겨 두세요. 후보 범위를 넓혀야 할 때는 APIYI apiyi.com의 통합 진입점을 통해 새 모델을 계속 추가하고, 같은 과제와 판정 규칙으로 다시 돌려 보면 됩니다.
리더보드와 목록은 어떤 모델을 시도해 볼 만한지 알려줄 뿐, 어느 모델이 정말 여러분의 비즈니스에 맞는지는 직접 돌려 만든 그 표가 답합니다. 루유(陸游)가 《동야독서시자율(冬夜讀書示子聿)》에서 쓴 것처럼: “종이에서 얻은 것은 끝내 얕으니, 이 일을 깊이 알려면 몸소 실천해야 하네.”