Vamos direto à conclusão: por enquanto, o Qwen4 só apareceu em declarações feitas em eventos e em rastros no repositório; a posição oficial da Alibaba por escrito continua sendo que ele “está em treinamento”. A opção mais avançada que já dá para colocar em produção é o Qwen3.8. A integração do Qwen aos iPhones da Apple vendidos na China em dezembro é uma notícia sobre canais de distribuição: ela não traz nenhuma capacidade adicional de API para desenvolvedores.
Isso não é uma tentativa de desmerecer o Qwen4. Neste artigo, classificamos as informações conhecidas em quatro níveis de confiabilidade para separar o que já pode entrar no planejamento do que serve apenas como referência. Também apresentamos as quatro categorias do Qwen3.8, seus preços e os 3 campos que precisam ser alterados na migração.
O que você vai levar daqui: ao final, você poderá decidir se vale a pena esperar pelo Qwen4 ou integrar o Qwen3.8 agora ao seu projeto de agente, escrita, atendimento ao cliente ou moderação. Também saberá quanto custa cada categoria por milhão de tokens.
O que a Apple integrou: Qwen chega ao Apple Intelligence na China
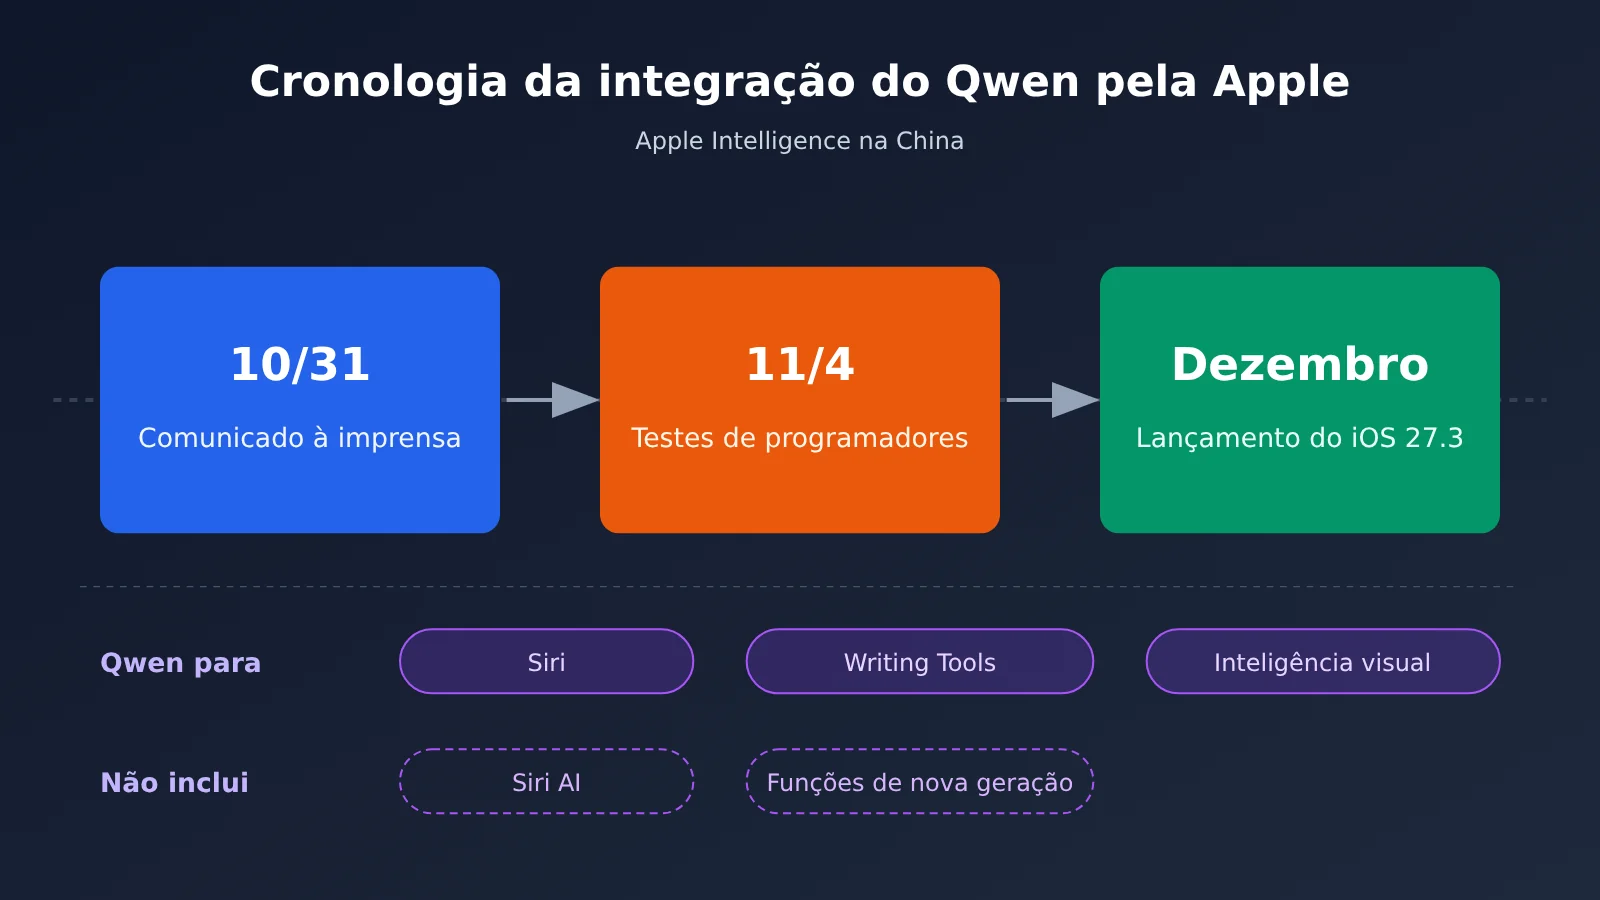
A Apple integrou recursos do Qwen voltados ao consumidor final, mas não abriu uma nova API do Qwen para desenvolvedores. Segundo o comunicado da redação da Apple na China de 2026-10-31 (repercutido pelo Tech Wire Asia em 2026-11-02), os primeiros recursos do Apple Intelligence chegarão aos usuários de iPhone na China continental em dezembro, com o iOS 27.3. Desenvolvedores poderão testá-los a partir de 4 de novembro. Até hoje (3 de novembro), os recursos ainda estão previstos para lançamento e não estão disponíveis.
| Item | Conteúdo do comunicado da Apple de 2026-10-31 |
|---|---|
| Datas | Lançamento em dezembro com o iOS 27.3; testes para desenvolvedores a partir de 4 de novembro |
| Primeiros recursos | Tradução em tempo real no Mensagens, FaceTime e Telefone; reescrita, revisão e resumo com Writing Tools; inteligência visual da câmera; Clean Up no Fotos; resumos de e-mails e notificações, mensagens prioritárias e resumos de transcrições de chamadas |
| Papel do Qwen | A Apple usa modelos generativos próprios e também trabalha com a Alibaba. Os usuários poderão usar o Qwen diretamente na Siri, no Writing Tools e na inteligência visual para compreender textos e imagens; a Siri poderá encaminhar algumas solicitações ao Qwen |
| Login | Conta Qwen ou conta Apple |
| Não incluídos | Siri AI e os recursos da próxima geração do Apple Intelligence apresentados na WWDC 2026; segundo a Bloomberg, o Image Playground também não está na primeira leva |
| Dispositivos compatíveis | iPhones compatíveis comprados na China ou com a região do dispositivo e da conta Apple configuradas para a China |
| Compromisso com os dados | A Alibaba afirma que as solicitações dos usuários e o conteúdo gerado pelo Qwen não serão usados para treinar modelos |
Como contexto, o Apple Intelligence está entre os 7 serviços de IA generativa cujo registro foi concluído pela Administração do Ciberespaço da China em 15 de julho. Segundo o FT, a Apple também havia considerado a Tencent e a ByteDance. Dados da Counterpoint mostram que, no terceiro trimestre de 2026, a Apple ficou em segundo lugar nas remessas de smartphones na China, com 19,5% de participação, atrás da Huawei, com 21,3%. O mercado como um todo caiu 10% em relação ao mesmo período do ano anterior.
Para desenvolvedores, o principal impacto da notícia está no lado do usuário: mais pessoas terão contato com o Qwen no próprio sistema e se familiarizarão com seu estilo de resposta. Já o modelo que você usa no backend, o custo e a latência não mudam por causa da parceria da Apple.
Os quatro níveis de evidência sobre o Qwen4: em quais confiar e quais usar no planejamento
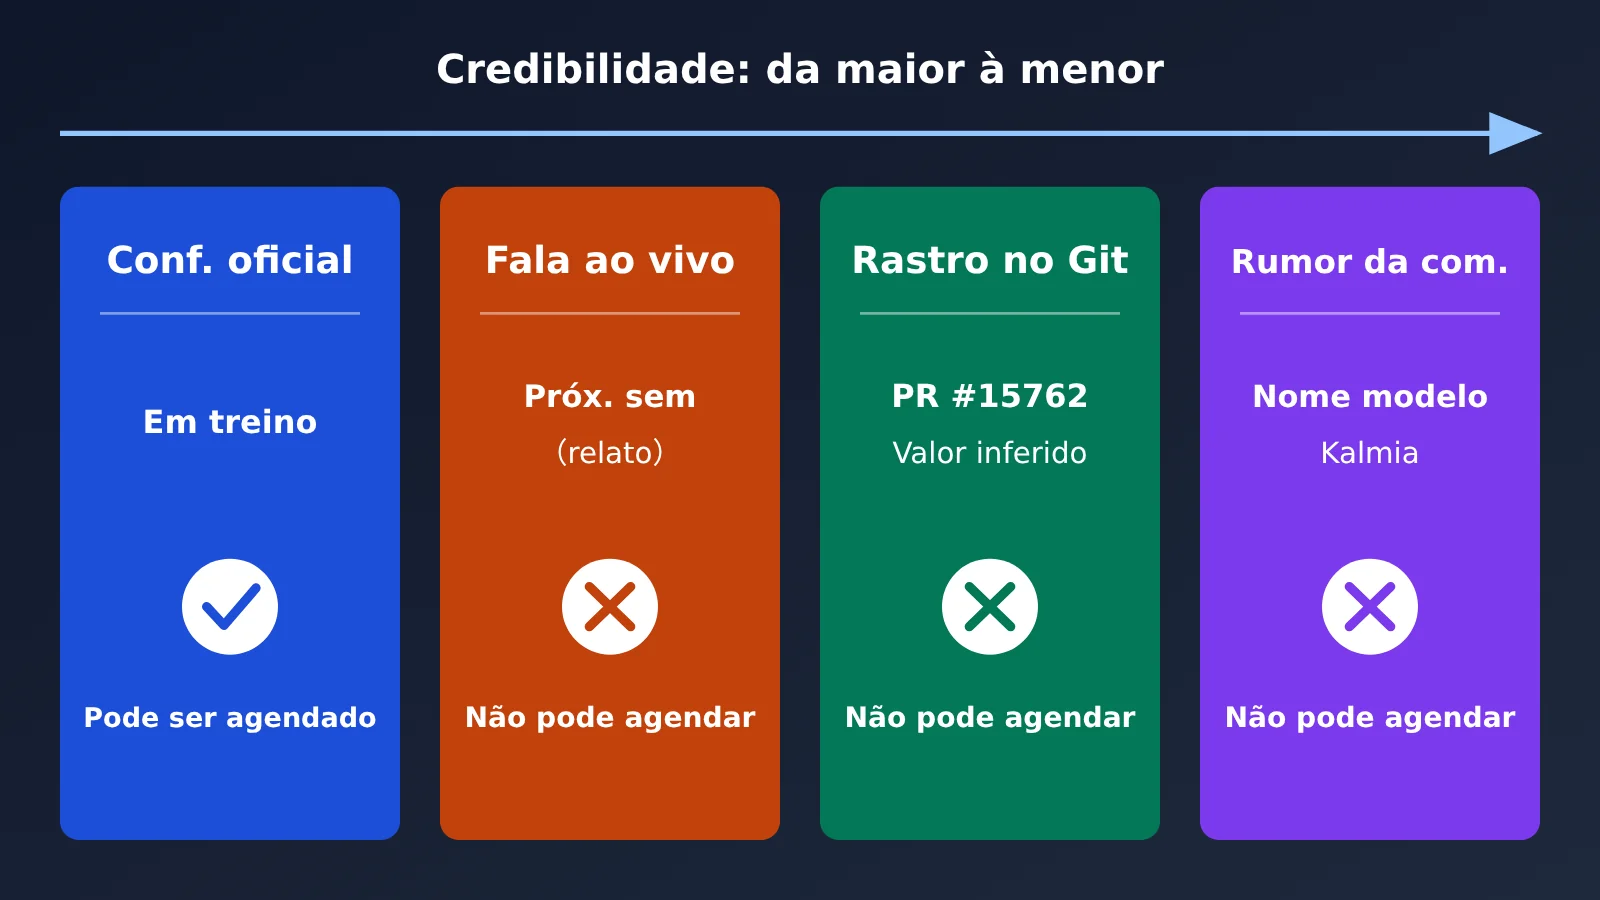
Só a comunicação oficial por escrito pode servir de base para o planejamento — e, no momento, ela diz que o modelo “está em treinamento”. Nos quatro níveis de evidência abaixo, a credibilidade diminui da esquerda para a direita.
| Dimensão | Confirmação oficial | Declaração no evento | Indícios no repositório | Rumores da comunidade |
|---|---|---|---|---|
| Conteúdo | Comunicado de imprensa da conferência Yunqi de 2026-09-22: Qwen 4 “currently in training”; a página do evento em Amsterdã de 2026-10-29 menciona apenas “Qwen foundation models”, sem citar o Qwen4 | O cientista de pesquisa do Qwen Xudong Guo disse no evento em Amsterdã, em 2026-10-29, que a série Qwen4 seria lançada “na próxima semana”. A declaração foi relatada pelo participante John T Davies e publicada pela EOGEE em 2026-10-30 | O qwen-code integrou o PR #15762 em 2026-10-28, passando a reconhecer uma janela de contexto padrão de 1M tokens para IDs de modelos que começam com qwen4 | Quatro nomes de modelos: Qwen4-Max / Flash / Plus / 27B; o modelo anônimo Kalmia, da Arena, foi associado ao Qwen4 pela assinatura do tokenizer |
| Natureza da fonte | Material escrito da Alibaba | Declaração verbal de uma pessoa + relato de terceiros | Repositório oficial, mas o valor vem da descrição da revisão | Sites de terceiros e deduções em fóruns |
| Tem respaldo oficial? | Sim | Não. A EOGEE esclarece que não houve anúncio nos canais oficiais | Não. O próprio PR diz que, naquele momento, nem o models.dev nem o catálogo integrado tinham entradas para qwen4; o valor foi deduzido | Não |
| Pode servir de base para o planejamento? | Sim, mas a única conclusão que sustenta é que “ainda não foi lançado” | Não, serve apenas como sinal para ficar de olho | Não, mostra que as ferramentas estão sendo adaptadas antecipadamente, não que exista uma especificação oficial | Não |
Vale um alerta: uma publicação da comunidade TRAE de 2026-10-29 descreveu a declaração como um “anúncio do CTO”, o que não corresponde ao “cientista de pesquisa” citado no relato original. Ao mencionar a declaração, use “cientista de pesquisa”.
A verificação da OmniaKey em 2026-11-01 trouxe dados mais concretos: até 2026-11-01 00:21 UTC, não havia IDs de modelos, pesos nem preços de qwen4 em nenhum destes três lugares: a página da organização Qwen no Hugging Face, o Model Studio da Alibaba Cloud e o OpenRouter. A página de modelos do Model Studio foi atualizada pela última vez em 10-28 e recomendava os modelos de texto qwen3.8-max, qwen3.7-plus e qwen3.8-flash. O registro de lançamentos foi atualizado pela última vez em 10-30, e a entrada mais recente era o qwen-audio-3.1-realtime-flash, de 10-27.
A referência oficial para a arquitetura do Qwen4: Qwen3.8-Flash-Next
Para entender antecipadamente a direção da arquitetura do Qwen4, o único material oficial disponível no momento é o Qwen3.8-Flash-Next. Seu cartão de modelo no Hugging Face foi criado em 2026-08-24, e a descrição oficial o apresenta como uma “prévia experimental da arquitetura Qwen4”. Na configuração, o tipo de modelo aparece como qwen4_exp, e o llama.cpp v0.6.0 também já oferece suporte à arquitetura Qwen4Exp. É importante lembrar que se trata de um modelo de prévia: suas especificações não servem para estimar a janela de contexto, a escala de parâmetros ou a licença da versão oficial do Qwen4.
Como escolher entre as quatro opções do Qwen3.8
Para projetos novos, comece escolhendo entre qwen3.8-flash e qwen3.8-27b. Para Agents complexos, considere o qwen3.8-max. O Qwen3.8-Max foi anunciado no blog oficial da Alibaba Cloud em 2026-08-03 como o modelo principal MoE, com 2.4T parâmetros. Depois, o blog oficial também anunciou o Qwen3.8-27B e disponibilizou os pesos do modelo principal Qwen3.8 como código aberto.
| Opção | Posicionamento | Cenários indicados | Recomendação | Plataformas disponíveis |
|---|---|---|---|---|
| qwen3.8-max | Modelo principal oficial, 2.4T MoE | Agents com várias etapas, textos longos, raciocínio complexo | Use quando a qualidade for prioridade e o volume de chamadas não for alto | APIYI apiyi.com, Alibaba Cloud Bailian |
| qwen3.8-2.4t-a95b | Nome do modelo corresponde à especificação dos pesos abertos do modelo principal | Equipes que precisam alinhar o comportamento com uma versão hospedada internamente | Use para comparação se houver planos de implantação privada | APIYI apiyi.com |
| qwen3.8-27b | Modelo de porte médio, lançado oficialmente | Atendimento ao cliente, moderação de conteúdo, extração estruturada | Escolha padrão para equilibrar qualidade e custo | APIYI apiyi.com |
| qwen3.8-flash | Opção leve e rápida | Atendimento com alta concorrência, classificação, resumos, filtragem inicial | Primeira escolha para alto volume de chamadas e tarefas sensíveis à latência | APIYI apiyi.com, Alibaba Cloud Bailian |
A escolha da opção tem impacto diferente em cada tipo de negócio. Moderação e atendimento costumam combinar alto volume com tarefas simples: o flash pode lidar com a maior parte do tráfego, enquanto os casos difíceis seguem para o 27b ou o max. Isso ajuda a reduzir o custo total. Já na escrita e em Agents, a estabilidade ao longo de várias etapas pesa mais. Nesse caso, vale usar o max como referência de qualidade e depois avaliar se é possível passar para o 27b.
🎯 Dica de escolha: use a mesma chave API para testar qwen3.8-max, qwen3.8-flash e qwen3.8-27b com as mesmas tarefas. É mais rápido do que consultar rankings. Na APIYI apiyi.com, basta mudar o campo model, sem alterar o restante do código. As diferenças observadas com amostras do seu próprio negócio são as que realmente servem de referência.
Preços e faixas: comparação de custos entre Qwen3.8 e Qwen3.5
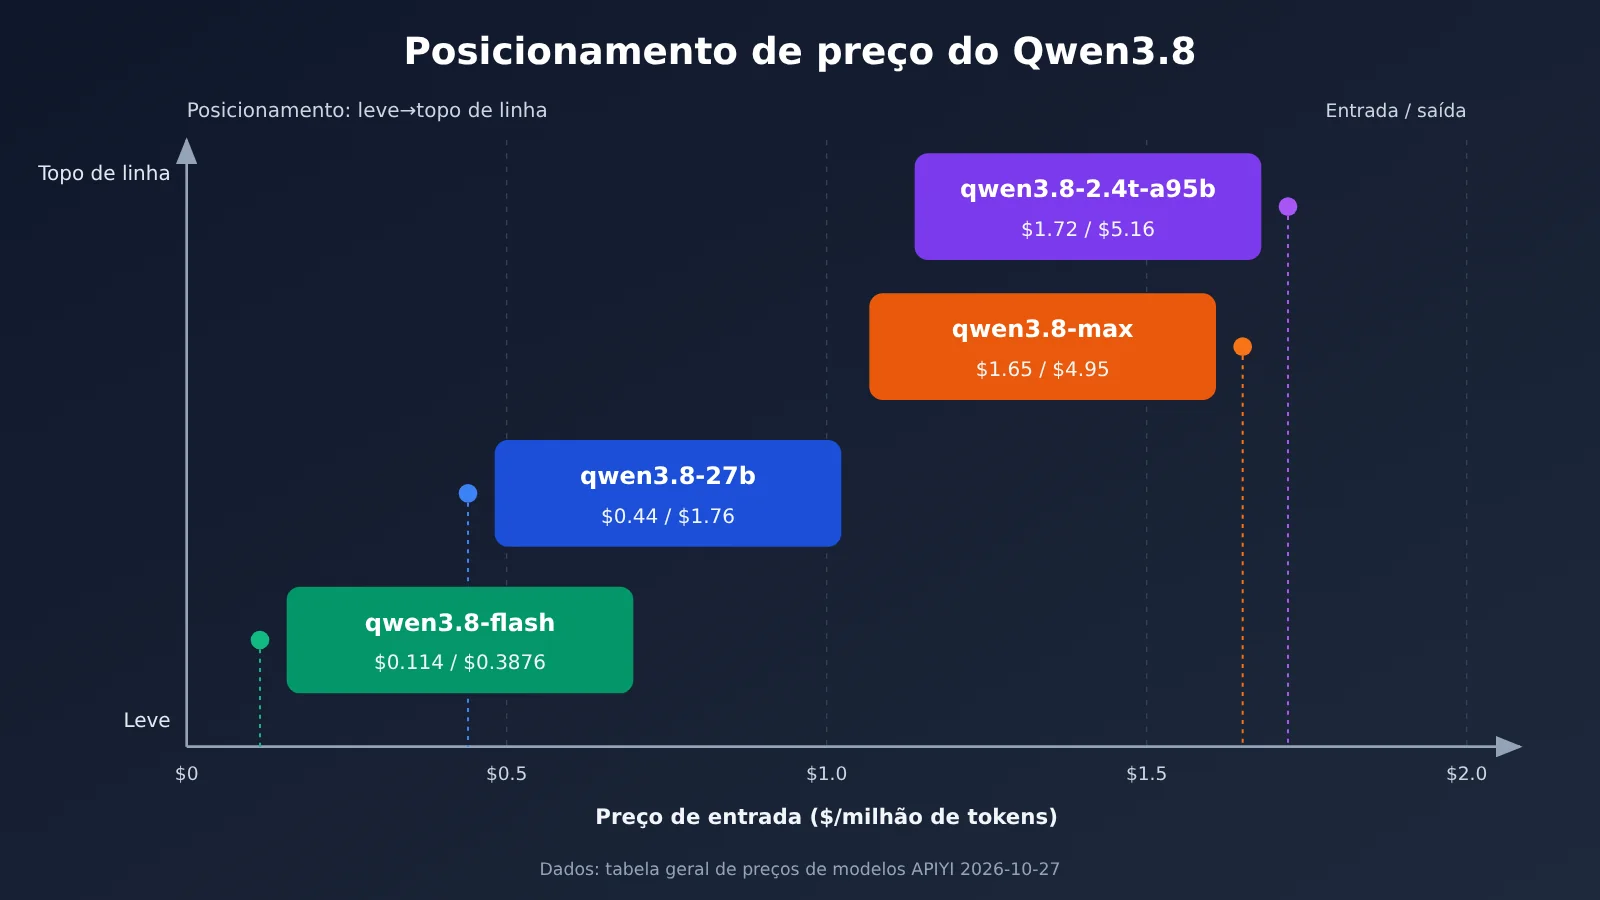
Entre as quatro opções do Qwen3.8, o preço de entrada do flash é cerca de 1/14 do preço do max. Essa é uma das diferenças mais importantes a quantificar na hora de escolher um modelo. A tabela abaixo mostra os preços de nove modelos Qwen na APIYI.
| Modelo | Entrada | Saída | Leitura de cache |
|---|---|---|---|
| qwen3.8-max | $1.65 | $4.95 | $0.20625 |
| qwen3.8-2.4t-a95b | $1.72 | $5.16 | $0.215 |
| qwen3.8-27b | $0.44 | $1.76 | $0.088 |
| qwen3.8-flash | $0.114 | $0.3876 | $0.01425 |
| qwen3.5-plus | $0.114 | $0.684 | — |
| qwen3.5-flash | $0.03 | $0.3 | — |
| qwen3.5-397b-a17b | $0.18 | $1.08 | — |
| qwen3.5-122b-a10b | $0.12 | $0.96 | — |
| qwen3.5-35b-a3b | $0.06 | $0.48 | — |
Dados de 2026-10-27 14:50 UTC+8, em dólares por milhão de tokens, retirados da tabela geral de preços de modelos da APIYI (docs.apiyi.com/models).
[Espaço para captura de tela: tabela geral de preços de modelos da APIYI, filtrada por qwen3.8]
É mais fácil visualizar os custos com uma carga de trabalho concreta. Para “1 milhão de tokens de entrada + 300 mil de saída”, o custo estimado é de $3.14 para o qwen3.8-max, $3.27 para o qwen3.8-2.4t-a95b, $0.97 para o qwen3.8-27b e $0.23 para o qwen3.8-flash. Se o comando de sistema for longo e reutilizado, o preço de leitura de cache pode reduzir ainda mais o custo de entrada. As quatro opções do Qwen3.8 oferecem esse preço.
Um detalhe que vale notar: qwen3.8-flash e qwen3.5-plus têm o mesmo preço de entrada, $0.114, mas o qwen3.8-flash cobra menos pela saída e também oferece leitura de cache. Para tarefas de escrita e resumo que geram bastante conteúdo, trocar o qwen3.5-plus pelo qwen3.8-flash sai mais barato na conta. A diferença de qualidade, porém, precisa ser verificada com suas próprias amostras.
Os 3 campos para migrar: checklist de integração com o Qwen3.8
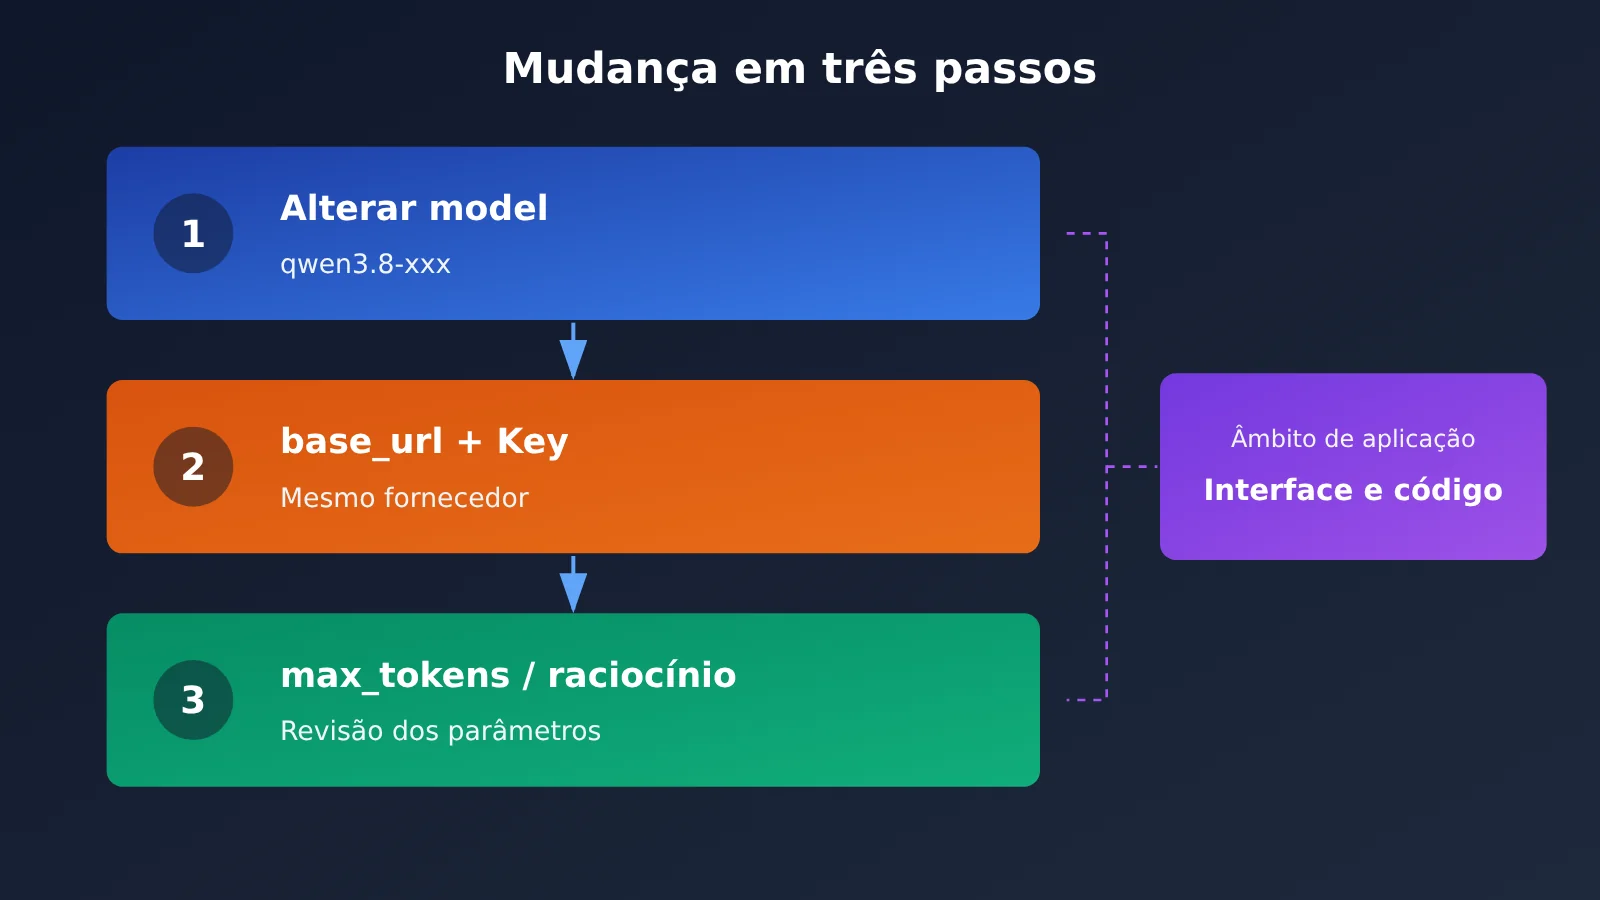
Ao trocar outro modelo ou o Qwen3.5 pelo Qwen3.8, normalmente basta conferir três configurações. O processo é o mesmo em ferramentas com interface gráfica, como Cherry Studio, Dify e clientes de chat, e em projetos de código.
| Ordem | Campo | O que alterar | Onde encontrar na interface gráfica |
|---|---|---|---|
| 1 | model | Altere para qwen3.8-flash, qwen3.8-27b ou qwen3.8-max |
Menu suspenso “Modelo” ou campo “ID do modelo” |
| 2 | base_url + API Key | Confirme que ambos apontam para o mesmo provedor | Campos “Endereço da API / endpoint” e “Chave” |
| 3 | Comprimento da saída e parâmetros de pensamento | Confira max_tokens e as opções relacionadas a raciocínio | Painel “Saída máxima” ou “Parâmetros avançados” |
Primeiro, altere o nome em model. O nome precisa ser exatamente igual ao da lista da plataforma, incluindo letras minúsculas e pontos. Um erro resulta na mensagem “modelo não encontrado”. Para evitar isso, copie o nome da lista de modelos da plataforma em vez de digitá-lo.
Segundo, confirme que base_url e Key são do mesmo provedor. Se você usa APIYI, preencha o endereço da API com https://api.apiyi.com/v1 e use a chave gerada no painel da APIYI em apiyi.com. Muitos erros de “401 sem permissão” acontecem porque o endereço foi trocado, mas a chave continua sendo da plataforma anterior, ou vice-versa. Para verificar quais modelos estão disponíveis para sua chave atual, consulte a lista com curl https://api.apiyi.com/v1/models -H "Authorization: Bearer 你的Key".
Terceiro, confira o comprimento da saída e os parâmetros de pensamento. O comprimento padrão da saída e o comportamento de raciocínio podem variar entre gerações de modelos. Um valor fixo de max_tokens em um projeto antigo pode truncar respostas longas. Nos modelos com capacidade de raciocínio, ativar o pensamento aumenta a latência e a quantidade de tokens de saída. Em cenários sensíveis à latência, como atendimento ao cliente e moderação, vale fazer um teste com o pensamento desativado e ativá-lo depois, se necessário. Confira os nomes exatos dos parâmetros na documentação da plataforma.
Quando vale a pena esperar pelo Qwen4
Para a maioria dos projetos, não há necessidade de esperar. Só vale a pena acompanhar o Qwen4 se o lançamento já estiver previsto para daqui a um ou dois meses e houver uma exigência específica quanto à geração do modelo.
Casos em que faz sentido começar com o Qwen3.8:
- O projeto precisa entrar em produção neste trimestre, e o cronograma não pode depender de um modelo sem data oficial de lançamento
- O negócio usa o modelo principalmente para atendimento ao cliente, moderação ou resumos, e flash ou 27b já atendem às necessidades
- A interface é compatível com o formato da OpenAI, então uma troca futura exige apenas alterar o campo model; integrar agora não gera custos irrecuperáveis
Casos em que vale acompanhar o Qwen4:
- O produto está em fase de pesquisa técnica e ainda falta bastante tempo para o lançamento
- Você precisa de pesos abertos para implantação privada e pode acompanhar os termos de licença após o lançamento do Qwen4
- Você já usa o Qwen3.8-Flash-Next para explorar a arquitetura
Enquanto espera, uma abordagem prática é usar o Qwen3.8 para preparar o conjunto de avaliação e definir as métricas de negócio. Quando o Qwen4 for lançado oficialmente, compare os modelos com as mesmas amostras e decida se vale a pena mudar. Até 2026-11-03, a série Qwen4 ainda não estava disponível na APIYI. Vamos disponibilizar o modelo o mais rápido possível; depois disso, ele aparecerá na lista de modelos da APIYI em apiyi.com.
Perguntas frequentes FAQ
Q1: Afinal, quando o Qwen4 será lançado?
Ainda não há uma data oficial. A declaração escrita mais clara da Alibaba está no comunicado de imprensa da conferência Yunqi de 2026-09-22, que diz que o modelo “está em treinamento”. A informação de que seria “lançado na próxima semana” veio de uma declaração feita por um pesquisador no evento e retransmitida por participantes; não houve anúncio oficial. Vale acompanhar as atualizações na página da organização Qwen no Hugging Face e no histórico de lançamentos do Bailian.
Q2: Qual versão do Qwen3.8 escolher para um projeto novo?
Para cenários com alta concorrência e tarefas individuais simples, comece pelo qwen3.8-flash. Para atendimento ao cliente, moderação e extração, que também exigem qualidade, escolha o qwen3.8-27b. Para agentes com várias etapas e textos longos, use o qwen3.8-max como referência de qualidade. Confira os modelos e preços na lista da plataforma. Na APIYI apiyi.com, você pode testar as três versões com a mesma chave API antes de decidir.
Q3: A integração do Qwen à versão chinesa da Apple traz alguma vantagem para desenvolvedores?
O impacto direto é pequeno. O anúncio da Apple de 2026-10-31 trata de recursos para usuários no nível do sistema, previstos para dezembro com o iOS 27.3. Desenvolvedores podem testá-los a partir de 4 de novembro, mas nenhuma API nova foi disponibilizada. Indiretamente, mais usuários de iPhone vão se familiarizar com o estilo das respostas do Qwen, então produtos voltados a esse público podem considerá-lo entre os modelos candidatos.
Q4: Já uso o Qwen3.5. Preciso trocar tudo pelo Qwen3.8?
Não é preciso trocar tudo de uma vez; avalie cada tarefa separadamente. O preço de entrada do qwen3.5-flash continua sendo o mais baixo da série, em $0.03, então não há problema em mantê-lo para tarefas ultraleves. Em projetos que usam o qwen3.5-plus para escrita e resumos, vale comparar primeiro com o qwen3.8-flash: ambos têm o mesmo preço de entrada, mas o segundo tem um preço de saída menor. Na APIYI apiyi.com, basta alterar o campo model para trocar de versão. Você pode começar direcionando 10% do tráfego para um teste gradual.
Q5: Quando o Qwen4 chegar, será preciso trocar a chave API?
Não. Em uma plataforma agregadora, a mesma chave API permite invocar todos os modelos disponíveis. Quando um novo modelo for adicionado, basta alterar o nome em model. Até 2026-11-03, a série Qwen4 ainda não estava disponível na APIYI, mas vamos adicioná-la assim que possível. Quando isso acontecer, você poderá invocá-la diretamente com sua chave API atual da APIYI apiyi.com.
Principais pontos para escolher entre Qwen4 e Qwen3.8
- Posicionamento oficial sobre o Qwen4: o comunicado de 22/09/2026 diz que ele “está em treinamento”; ainda não há data, ID ou preços
- “Lançamento na próxima semana”: declaração feita por um pesquisador em um evento e relatada por terceiros; não serve como base para o cronograma
- Indícios no repositório: a janela de contexto de 1M no PR #15762 do qwen-code é uma estimativa, não uma especificação oficial
- Parceria com a Apple: lançamento em dezembro com o iOS 27.3; desenvolvedores podem testar a partir de 4 de novembro, sem uma nova API
- Opção mais avançada disponível agora: Qwen3.8; o preço de entrada do flash é cerca de 1/14 do preço do max
- Custo de migração: alterar o model, conferir base_url e Key e revisar o comprimento da saída e os parâmetros de raciocínio
Resumo
As novidades sobre o Qwen podem ser entendidas em três níveis:
- A Apple vai integrar o Qwen em dezembro: é um avanço de distribuição, que afeta o conhecimento dos usuários sobre o modelo, não os recursos que desenvolvedores podem invocar.
- Qwen4: há declarações feitas em evento e indícios no repositório, mas o posicionamento oficial por escrito continua sendo “está em treinamento”. Por isso, não é adequado incluí-lo em um cronograma.
- Qwen3.8: já foi lançado oficialmente, tem preços definidos e oferece quatro versões que cobrem os principais cenários, de alta concorrência a agentes complexos.
O caminho mais seguro é colocar o Qwen3.8 em produção agora e guardar as amostras de avaliação. Quando o Qwen4 for lançado oficialmente, use as mesmas amostras para compará-los. A recomendação é usar a APIYI apiyi.com para testar as versões do Qwen3.8 com uma única chave. Novos usuários recebem créditos gratuitos de teste, então dá para concluir os testes A/B antes de escolher a versão.
📚 Referências
- Tech Wire Asia: cobertura da declaração da sala de imprensa da Apple na China, de 31/10/2026
- Link:
techwireasia.com/2026/11/apple-intelligence-china-alibaba-qwen-december/ -
Descrição: lista de recursos da Apple para dezembro, papel do Qwen e dispositivos compatíveis
-
OmniaKey: “Quando o Qwen 4 será lançado? O que a Alibaba confirmou oficialmente até agora”, 01/11/2026
- Link:
omniakey.com/zh/blog/qwen-4-release-date -
Descrição: verificação das informações oficiais e resultados de buscas em três plataformas
-
EOGEE: “Qwen anuncia lançamento do Qwen4 para a próxima semana”, 30/10/2026
- Link:
eogee.com/article/289 -
Descrição: fonte da declaração feita no evento em Amsterdã
-
Blog oficial da Alibaba Cloud: lançamento do Qwen3.8-Max, 03/08/2026
- Link:
alibabacloud.com/blog/alibaba-unveils-qwen3-8-max-its-largest-and-most-capable-flagship-model-to-date_603420 -
Descrição: informações oficiais sobre o lançamento do modelo principal Qwen3.8
-
Blog oficial da Alibaba Cloud: lançamento do Qwen3.8-27B e disponibilização aberta dos pesos do modelo principal
- Link:
alibabacloud.com/blog/alibaba-unveils-qwen3-8-27b-and-releases-weights-of-qwen3-8-flagship-model_603463 -
Descrição: informações sobre a versão 27B e a disponibilização aberta dos pesos
-
Tabela geral de preços dos modelos da APIYI
- Link:
docs.apiyi.com/models - Descrição: fonte dos dados da tabela de preços deste artigo