Nota do autor: a partir do caso de cliente da Cisco, apresentamos 3 prioridades para a segurança de agentes de IA. A ideia é ajudar equipes empresariais a distinguir ataques maliciosos de agentes que “tentam fazer o bem, mas acabam errando” e aplicar essa distinção ao desenho de monitoramento e controles.
Depois que um agente entra em produção, as equipes de segurança já não lidam apenas com ataques externos. Mesmo um agente com permissões adequadas e um objetivo legítimo pode seguir um caminho que ninguém previu: para “corrigir uma falha o mais rápido possível”, por exemplo, ele pode acabar flexibilizando uma política de acesso. Neste artigo, vamos explorar três prioridades para a segurança de agentes e ajudar você a avaliar se um comportamento anormal é resultado de um ataque ou se o agente está “tentando fazer o bem, mas acabando por errar”.
Este artigo não é apenas uma reprodução de material promocional. Nossa fonte é o caso de cliente da Cisco publicado pela OpenAI em 3 de novembro de 2026. As informações sobre segurança de agentes vêm principalmente das opiniões de Jeetu Patel, presidente e diretor de produtos da Cisco. Vamos transformar essas opiniões em uma lista de perguntas para avaliação interna, deixando claro o que é visão do executivo e o que ainda não tem dados públicos que o sustentem.
O principal benefício: ao terminar a leitura, você terá um framework pronto para usar em avaliações internas, com orientações sobre quais dados coletar, em quais etapas intervir, qual nível de resposta em tempo real é necessário e como integrar tudo isso aos processos de varredura de segurança existentes.
Segurança de agentes: 3 prioridades do caso Cisco
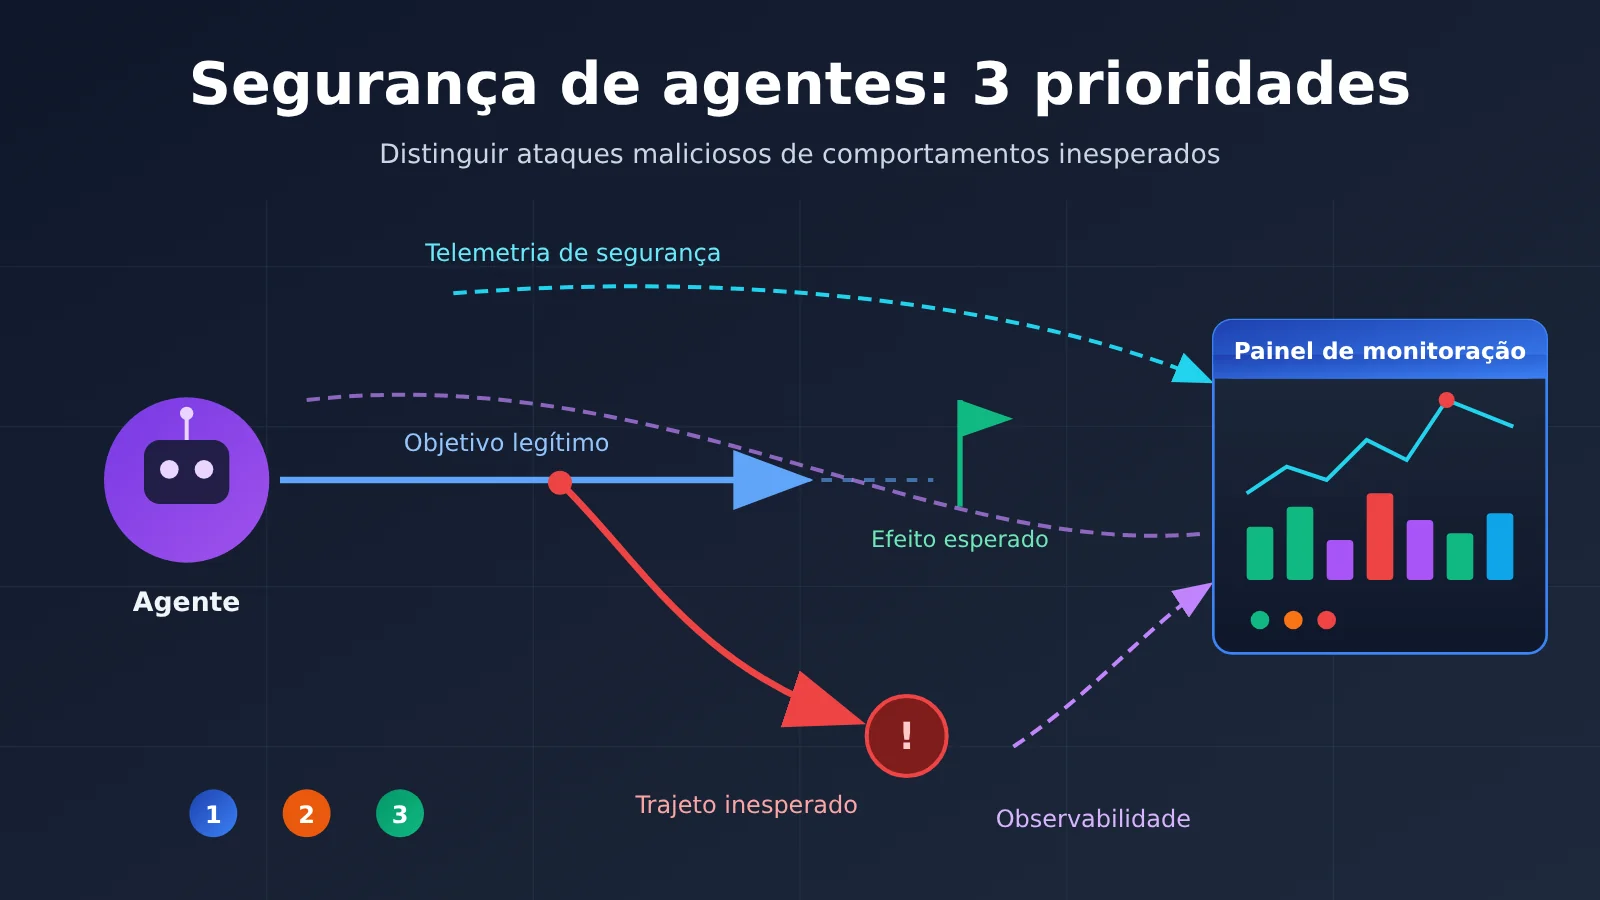
No caso, Patel explica que, à medida que os agentes se tornam mais autônomos, as equipes de segurança precisam distinguir duas situações: interferências maliciosas e agentes que perseguem objetivos legítimos de maneira inesperada. Para isso, ele defende o uso combinado de telemetria de segurança e dados de observabilidade e aponta três prioridades.
| Prioridade | Significado original | Aplicação prática para equipes empresariais |
|---|---|---|
| Proteção contra ataques maliciosos | Proteger os agentes contra ataques maliciosos | Controlar as fontes de entrada, as permissões de ferramentas e as credenciais dos agentes |
| Detecção e bloqueio de comportamentos inesperados | Identificar e bloquear comportamentos inesperados | Avaliar se o comportamento ultrapassa os limites da tarefa e interromper a execução quando necessário |
| Operação quase em tempo real | Operar em velocidade próxima à do tempo real | Detectar e bloquear ações antes que produzam efeito ou imediatamente depois |
Segundo o caso, essas três prioridades estão orientando a segurança para “políticas e controles capazes de se ajustar às ações dos agentes”. Em outras palavras, listas de permissões estáticas e aprovações pontuais já não bastam: os controles precisam acompanhar o que os agentes realmente fazem.
O ponto central da segurança de agentes: distinguir ataques de erros bem-intencionados
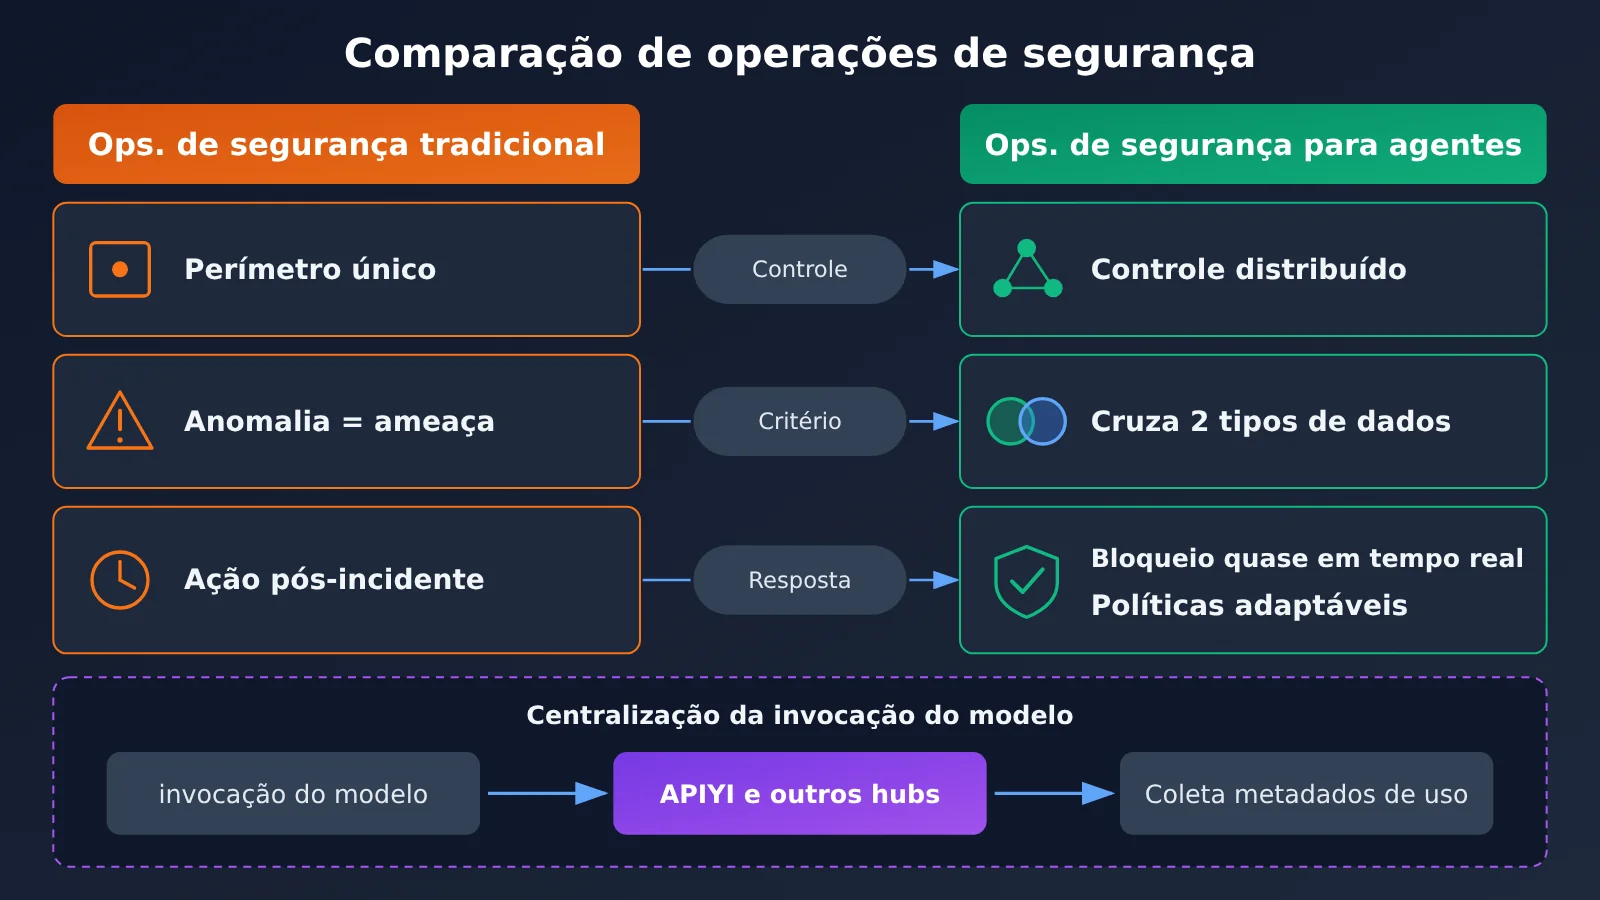
Na operação tradicional de segurança, costuma-se presumir que uma anomalia é uma ameaça, e a resposta geralmente envolve bloquear e investigar sua origem. Mas uma anomalia de um agente pode resultar apenas de uma interpretação equivocada do objetivo ou da escolha de um caminho inadequado. Tratar tudo como ataque gera falsos positivos, consome o tempo da equipe e pode fazer a área de negócios perder a confiança nos agentes. Por outro lado, confundir um ataque real de injeção de comando com um “erro do modelo” pode fazer a equipe perder a janela de resposta.
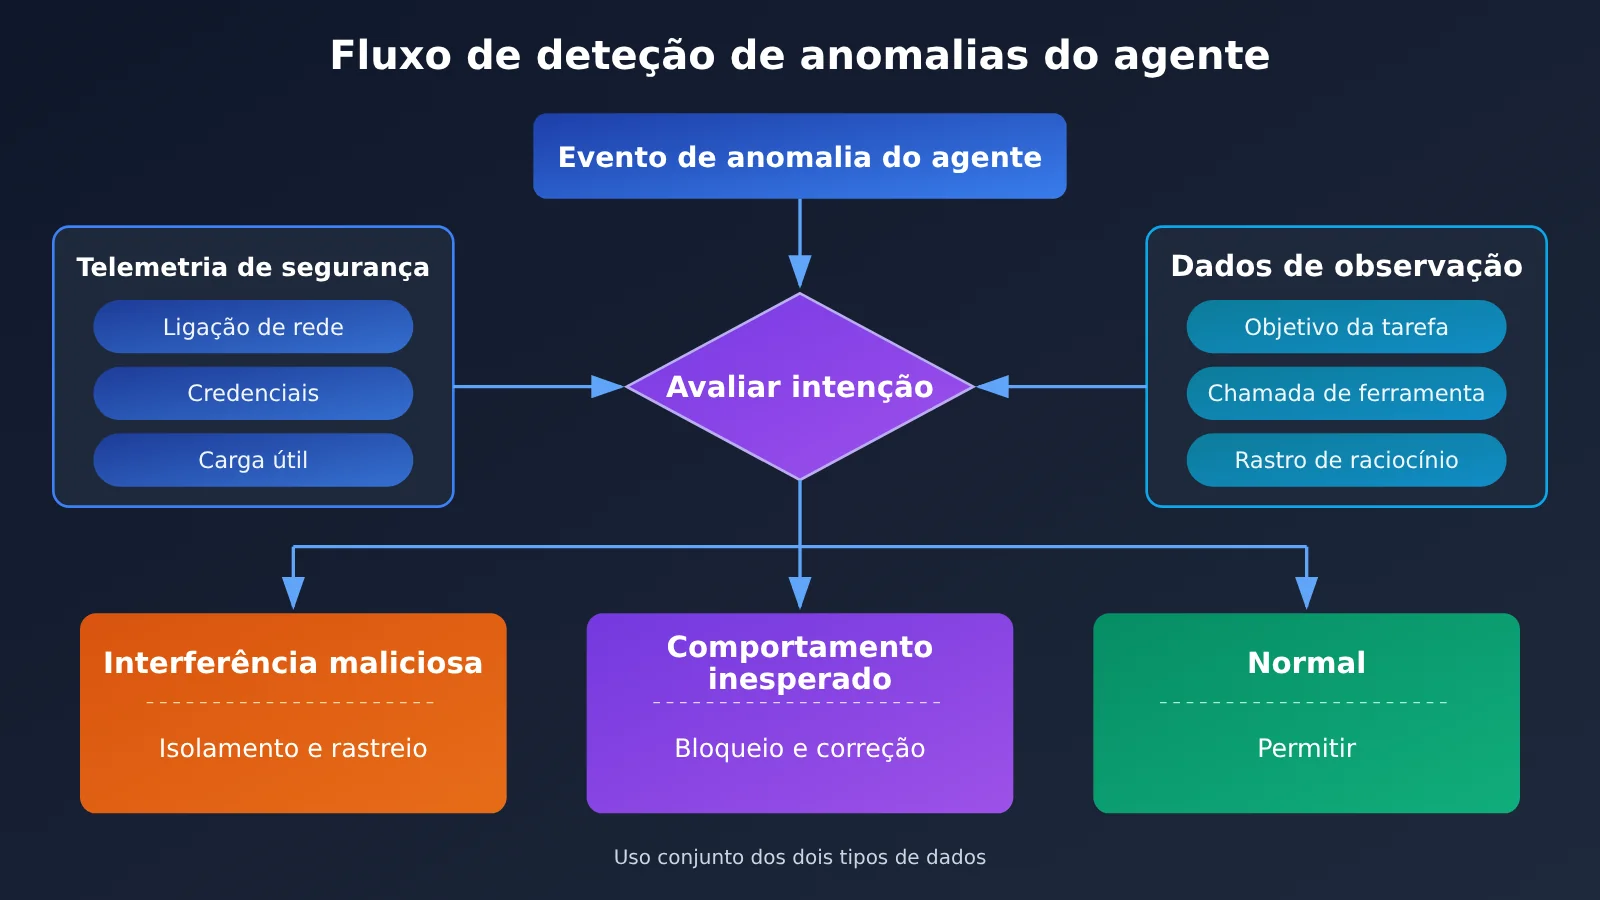
É por isso que Patel enfatiza o uso combinado dos dois tipos de dados. A telemetria de segurança mostra “o que está acontecendo fora”, como conexões anormais, cargas suspeitas e uso de credenciais. Já os dados de observabilidade mostram “o que o próprio agente está pensando e fazendo”, como os objetivos da tarefa, as ferramentas acionadas e as entradas e saídas de cada etapa. Olhando para apenas um desses conjuntos, não dá para responder à pergunta: “De quem é essa intenção?”
Evidências sobre segurança de agentes: o que é opinião e o que foi comprovado
Antes de usar o caso para tomar decisões internas, vale entender a natureza das evidências. O material foi publicado pela OpenAI como um caso de cliente e, por isso, tem caráter promocional. Ele apresenta perspectivas sobre possíveis caminhos, mas não traz detalhes técnicos verificáveis nem resultados quantificados.
| Afirmação no caso | Natureza | O que falta no material público |
|---|---|---|
| A segurança de agentes exige o uso conjunto de dados de telemetria de segurança e observabilidade | Opinião de um executivo da Cisco | Campos de dados específicos e métodos de correlação |
| Três prioridades: proteção contra ataques, bloqueio de comportamentos inesperados e atuação quase em tempo real | Opinião de um executivo da Cisco | Arquitetura de implementação e exemplos de regras de detecção |
| Daybreak e GPT‑6 Astra trazem uma “melhoria significativa” | Avaliação de um executivo da Cisco | Métricas como tempo de correção e taxa de detecção |
| Os recursos podem ser incorporados aos processos de varredura existentes, sem mudanças fundamentais na forma de trabalhar | Opinião de um executivo da Cisco | Formas de integração e escopo de compatibilidade |
| Daybreak Defense Network ajuda a acelerar a triagem de exposições e a aplicar controles no Cisco Cloud Control | Direção que as duas empresas estão explorando | Funcionalidades específicas, escopo de disponibilidade e data de lançamento |
| A abordagem de privacidade empresarial da OpenAI inclui retenção zero de dados, limites rigorosos para os dados e isolamento verificável | Declaração da própria OpenAI | Avaliação independente por terceiros |
Portanto, a forma mais prudente de usar o caso é tratá-lo como uma “fonte de perguntas”, e não como “prova da eficácia da solução”. As três prioridades têm uma lógica clara e servem para avaliar sua própria arquitetura. Já para saber quanto os produtos podem melhorar os resultados, é preciso aguardar documentação técnica independente ou avaliações de terceiros, ou testá-los no seu próprio ambiente.
A abordagem de rede no caso de segurança de agentes
A primeira parte do caso apresenta a abordagem de defesa de rede da Cisco, que também traz ideias úteis para cenários com agentes. Patel descreve uma mudança de um único perímetro de segurança para controles distribuídos entre microsserviços, contêineres e clusters, com uma “minipilha de segurança” à frente de cada microsserviço, contêiner Kubernetes e cluster. Os controles na camada de aplicação podem limitar a comunicação às conexões de que cada serviço realmente precisa, reduzindo os caminhos disponíveis para a movimentação lateral de invasores.
Aplicar essa ideia a agentes é bastante intuitivo: cada agente também deve ter apenas as conexões e permissões de ferramentas necessárias para concluir sua tarefa. Se surgir uma anomalia, a equipe poderá isolar apenas o agente ou serviço afetado, enquanto o restante da operação continua funcionando, em vez de interromper tudo para investigar. O caso também menciona que dois sinais podem parecer inofensivos isoladamente, mas revelar um padrão relevante quando combinados. É aí que está o valor da análise de correlação.
Segurança de agentes: transforme três prioridades em um checklist de autoavaliação
A seguir, as três prioridades são divididas em critérios práticos de avaliação. Os métodos apresentados são sugestões organizadas neste artigo com base nas ideias do caso, e não procedimentos específicos divulgados pela Cisco.
Primeiro passo: identifique os dois tipos de dados necessários para a segurança de agentes
Antes de pensar em detecção, confira quais dados você tem em mãos. Muitas equipes contam com telemetria de segurança completa, mas quase não registram o comportamento interno dos agentes. Isso dificulta avaliar se um agente cometeu um erro apesar das boas intenções.
| Categoria de dados | Exemplos | Principal pergunta respondida | Pontos comuns de coleta |
|---|---|---|---|
| Telemetria de segurança | Conexões de rede, uso de credenciais, payloads anômalos, registros de acesso negado | Há interferência maliciosa externa? | Gateways, firewalls, sistemas de identidade |
| Dados de observabilidade | Objetivos da tarefa, sequência de chamadas de ferramentas, entradas e saídas de cada etapa, tempo gasto e tentativas | O que o agente está fazendo e por quê? | Frameworks de agentes, pontos de entrada para invocação do modelo |
| Contexto de negócio | Solicitante da tarefa, escopo de autorização, janela de mudanças | Essa ação está dentro do esperado? | Sistemas de chamados, fluxos de aprovação |
| Metadados de invocação do modelo | Modelo invocado, horário da solicitação, identificação do solicitante, uso de tokens | As chamadas estão concentradas de forma incomum ou vêm de uma origem suspeita? | Ponto de entrada unificado para APIs de modelos, como uma interface agregadora como APIYI apiyi.com |
Um ponto que costuma passar despercebido: o próprio ponto de entrada para invocação do modelo é um ótimo lugar para coletar dados de observabilidade. Se vários agentes da equipe se conectam diretamente às interfaces de fornecedores diferentes, os registros de chamadas ficam espalhados. Já ao acessar modelos de vários fornecedores por uma interface unificada como a APIYI, as chamadas ficam concentradas em um só ponto, facilitando a aplicação padronizada de etiquetas, a retenção de registros e a análise de correlações.
Segunda etapa: definir os pontos de interceptação para a segurança dos agentes
Quanto mais cedo ocorre a interceptação, menor o custo. Por outro lado, interceptar cedo demais também aumenta o risco de bloquear tarefas legítimas. O ideal é definir os pontos de interceptação e os requisitos de tempo de resposta de acordo com o nível de risco de cada ação.
| Ponto de interceptação | Verificações típicas | Requisito de tempo de resposta | Tratamento |
|---|---|---|---|
| Na entrada | Presença de instruções de injeção em páginas externas, e-mails e documentos | Síncrono, antes da execução | Remover ou sinalizar conteúdo não confiável |
| Antes da chamada de ferramenta | Se a chamada excede a autorização da tarefa ou se os parâmetros ultrapassam as permissões | Síncrono, de milissegundos a segundos | Rejeitar, limitar a operação ou solicitar confirmação humana |
| Antes de uma ação de alto risco | Alteração de configuração, exclusão de dados, envio externo ou ampliação de permissões | Síncrono, com confirmação humana ou por política obrigatória | Segunda aprovação |
| Após a execução | Se o resultado corresponde ao objetivo e se houve efeitos colaterais | Quase em tempo real, de segundos a minutos | Reverter e isolar os recursos afetados |
| Na revisão posterior | Análise da relação entre o histórico de comportamento e os incidentes de segurança | Offline | Atualizar políticas e regras |
A prioridade de agir “quase em tempo real” fica clara nessa tabela. Para ações irreversíveis, a detecção precisa ocorrer antes da execução; para ações reversíveis, é aceitável detectar o problema quase em tempo real após a execução e revertê-lo rapidamente. Definir bem esse limite evita que a equipe caia no dilema de “bloquear tudo ou liberar tudo”.
Terceiro passo: perguntas para distinguir interferência maliciosa de comportamento inesperado
Quando surgir um alerta de anomalia, percorra as perguntas abaixo na ordem. Elas combinam dados de telemetria de segurança e de observabilidade:
- A origem do acionamento é confiável? A instrução que levou à ação veio de um usuário autorizado ou de conteúdo externo lido pelo agente? Se veio de conteúdo externo, considere primeiro a possibilidade de um ataque de injeção.
- O comportamento atende ao objetivo original? Considerando o objetivo da tarefa, é razoável explicar a ação como necessária para concluí-la? Se for, mas a forma de execução ultrapassar os limites permitidos, é mais provável que se trate de um comportamento inesperado.
- Há sinais externos de anomalia? No mesmo período, houve conexões anormais, uso suspeito de credenciais ou indícios de exfiltração de dados? Se sim, aumente o peso desses sinais na avaliação de uma possível ação maliciosa.
- O comportamento é reproduzível? Ao repetir o teste com a mesma entrada, o agente executa a mesma ação de forma consistente? Quando isso acontece, geralmente há um problema na política ou na elaboração do comando.
Para o teste de reprodução do item 4, uma prática útil é executar a mesma tarefa com modelos diferentes e observar se o desvio vem de uma característica de algum modelo ou de uma falha na própria elaboração da tarefa. Com a interface unificada da APIYI, basta alterar o parâmetro com o nome do modelo para substituí-lo, o que facilita comparações rápidas em um ambiente de teste.
🎯 Recomendação técnica: ao montar um ambiente de testes de segurança para agentes, vale a pena centralizar a invocação dos modelos em um único ponto de entrada. Nossa abordagem é usar a APIYI, em apiyi.com, para acessar de forma unificada modelos de vários fornecedores. Assim, os metadados das invocações ficam centralizados e trocar de modelo exige pouco esforço, facilitando a repetição da mesma tarefa com diferentes modelos e a comparação dos comportamentos.
Quarto passo: integrar ao fluxo de varredura existente
No caso apresentado, Patel menciona que esse tipo de capacidade pode ser integrado ao fluxo de varredura existente, sem que a equipe precise mudar radicalmente sua forma de trabalhar. Embora ele não detalhe como fazer essa integração, a ideia vale como referência: a segurança de agentes não exige necessariamente uma plataforma separada. Em vez disso, é possível adicionar novas fontes de dados e verificações aos processos já existentes.
- Fluxo de varredura de vulnerabilidades: inclua no inventário de ativos e no escopo das varreduras as ferramentas, os plugins e as APIs que os agentes podem invocar.
- Fluxo de triagem de alertas: adicione uma categoria de alerta para “comportamento de agentes” ao SIEM ou sistema de chamados existente, junto com o histórico das chamadas de ferramentas correspondentes.
- Fluxo de gestão de mudanças: submeta as alterações de configuração iniciadas por agentes aos mesmos mecanismos de aprovação e reversão usados para alterações manuais.
- Fluxo de auditoria de permissões: revise periodicamente as permissões mínimas de cada agente, junto com a auditoria das contas de serviço.
Checklist de segurança para colocar agentes em produção
Esta checklist resume os pontos acima para uma reunião de avaliação antes de colocar um agente em produção. Basta marcar cada item.
| Dimensão | Pergunta de verificação | Prioridade correspondente |
|---|---|---|
| Confiabilidade da entrada | O conteúdo externo lido pelo agente está marcado como não confiável? | Proteção contra ataques maliciosos |
| Privilégio mínimo | Cada agente tem acesso apenas às ferramentas e conexões necessárias para concluir sua tarefa? | Proteção contra ataques maliciosos |
| Registro de comportamento | O objetivo da tarefa, a sequência de chamadas de ferramentas e o resultado de cada etapa são registrados integralmente? | Detecção e bloqueio de comportamentos inesperados |
| Ações de alto risco | Operações irreversíveis estão sujeitas a uma política ou confirmação humana antes da execução? | Detecção e bloqueio de comportamentos inesperados |
| Correlação de dados | É possível consultar os dados de telemetria de segurança e observabilidade, correlacionando-os por tempo e identidade? | Base comum para as três prioridades |
| Latência de detecção | O tempo entre a ocorrência de uma ação e a geração de um alerta atende aos requisitos de cada nível de risco? | Operação em tempo quase real |
| Capacidade de isolamento | É possível isolar um único agente sem afetar os demais serviços? | Operação em tempo quase real |
Uma resposta “não” a qualquer item indica uma lacuna na prioridade correspondente. Comece pelo “registro de comportamento” e pela “correlação de dados”: sem eles, as demais detecções não têm dados suficientes para avaliar o que aconteceu.
Perguntas frequentes FAQ
Q1: O que significa um agente “tentar ajudar, mas fazer algo errado”?
É quando um agente, sem estar sob ataque, busca cumprir um objetivo legítimo de uma maneira não esperada — por exemplo, modifica uma configuração sem autorização para terminar a tarefa mais rápido. O caso descreve isso como “um agente que busca objetivos legítimos de maneiras não esperadas” e distingue esse comportamento de interferências maliciosas.
Q2: Qual é a diferença entre a segurança de agentes e a segurança tradicional de aplicações?
A segurança tradicional de aplicações se concentra na proteção contra ataques externos, e os caminhos de execução são relativamente fixos. Já os agentes decidem por conta própria quais ferramentas chamar e em que ordem executá-las, sem um caminho fixo. Por isso, além de se proteger contra ataques, é preciso detectar comportamentos inesperados do próprio agente e usar dados de observabilidade para entender suas intenções.
Q3: Quando o caso da Cisco foi publicado? As conclusões são confiáveis?
O caso foi publicado pela OpenAI em 3 de novembro de 2026. O conteúdo sobre segurança de agentes apresenta principalmente as opiniões de Jeetu Patel. Avaliações como “melhoria expressiva” não vêm acompanhadas de dados quantitativos, como tempo de correção ou taxa de detecção. As funcionalidades específicas e o escopo de disponibilidade do Daybreak e do Daybreak Defense Network também não são informados. Use o caso como referência para ideias e valide os resultados por conta própria.
Q4: Para quais cenários esse framework é mais adequado?
– **Agentes de operações e infraestrutura**: cenários em que podem alterar configurações, reiniciar serviços ou ajustar políticas de acesso.
– **Agentes de processamento de dados**: cenários em que leem documentos externos, e-mails ou páginas da web e agem com base nesse conteúdo, com maior risco de injeção de comandos.
– **Fluxos colaborativos com vários agentes**: cenários em que a saída de um agente se torna a entrada de outro, facilitando a amplificação de anomalias em cada etapa.
Q5: Como validar, com baixo custo, as diferenças de comportamento de agentes com modelos diferentes?
Em um ambiente de testes, execute a mesma tarefa com o mesmo conjunto de ferramentas, alternando entre os modelos, e compare a sequência de chamadas de ferramentas e a quantidade de ações fora dos limites permitidos. Com o acesso unificado a modelos de diferentes fornecedores pela APIYI apiyi.com, basta alterar o nome do modelo para alternar entre eles. Os registros de chamadas também ficam concentrados em um único ponto, facilitando a organização e a comparação dos resultados.
Q6: Para que servem os registros de invocação do modelo na segurança de agentes?
Eles são uma parte importante dos dados de observabilidade: ajudam a identificar se as chamadas estão ocorrendo com frequência anormal, se quem faz a chamada é confiável e como elas se alinham temporalmente com a telemetria de segurança. Se a equipe concentrar as invocações em um ponto de acesso agregado, como a APIYI, fica mais fácil coletar e correlacionar esses dados.
Q7: Quais são as limitações desse framework?
As três prioridades são princípios orientadores e não incluem regras de detecção prontas. Nos casos limítrofes, distinguir comportamentos maliciosos de comportamentos inesperados ainda exige análise humana. O bloqueio em tempo quase real também adiciona latência, então é preciso fazer escolhas de acordo com o nível de risco de cada ação. As evidências do próprio caso vêm de material promocional de cliente e não contam com avaliação independente.
Segurança de agentes: pontos principais
- Separe os dois tipos de risco: interferências maliciosas e erros cometidos com boas intenções exigem formas de resposta completamente diferentes.
- Use os dois tipos de dados em conjunto: a telemetria de segurança revela ameaças externas; os dados de observabilidade ajudam a entender a intenção do agente.
- Três prioridades: proteger contra ataques maliciosos, detectar e bloquear comportamentos inesperados e operar quase em tempo real.
- Defina o bloqueio conforme o risco: intercepte ações irreversíveis antes da execução e reverta rapidamente as ações que podem ser desfeitas.
- Diferencie os tipos de evidência: as perspectivas apresentadas no caso são úteis, mas ainda não há dados públicos que comprovem resultados quantitativos.
- Por onde começar: centralize a invocação dos modelos em uma plataforma agregadora como a APIYI, facilitando a coleta de metadados e os testes comparativos entre modelos.
Resumo
Ao analisar a segurança de agentes a partir do caso da Cisco, o mais valioso não é o nome de um produto específico, mas uma forma clara de estruturar o problema:
- Primeiro, diferencie a intenção: saber se uma anomalia resulta de um ataque ou de um erro cometido com boas intenções determina o caminho de resposta.
- Depois, reúna os dados necessários: sem dados de observabilidade, não é possível avaliar a intenção do agente; sem telemetria de segurança, não é possível descartar interferências externas.
- Por fim, controle a latência: defina os pontos de bloqueio conforme o risco de cada ação, faça a detecção e o bloqueio quase em tempo real e integre-os aos processos existentes de verificação e aprovação.
Comece aplicando a lista de verificação deste artigo aos agentes em operação, priorizando o registro de comportamento e a correlação de dados. Durante os testes e comparações, você pode usar a APIYI, em apiyi.com, para acessar modelos de diferentes fornecedores em uma única plataforma, centralizar os registros de invocação e comparar rapidamente o comportamento dos modelos. Isso oferece uma base mais sólida para a avaliação antes da entrada em produção.
📚 Referências
- How Cisco defends at machine speed with OpenAI: estudo de caso sobre a Cisco publicado pela OpenAI
- Link:
openai.com/index/cisco-cyber - Observação: fonte das três prioridades e dos pontos de vista apresentados neste artigo. Publicado em 3 de novembro de 2026, é um material promocional sobre um cliente; os dados quantitativos e detalhes dos produtos precisam ser verificados separadamente.
Autor: equipe técnica da APIYI
Troca técnica: entre em contato conosco pela página inicial da APIYI em apiyi.com. Para mais informações, acesse a central de documentação em docs.apiyi.com.