Nota do autor: uma análise da estrutura de custos de Token em tarefas longas de Agent, explicando por que os Tokens de entrada representam a maior parte da conta e como organizar o contexto para reutilizar melhor o cache de prefixo.
Muitas equipes só percebem o problema ao olhar a conta no fim do mês, depois de integrar um Agent de várias etapas ao produto: o usuário fez apenas uma solicitação, mas o consumo de Tokens foi dezenas de vezes maior que em uma conversa comum. A primeira reação costuma ser “o modelo está respondendo demais”, seguida de uma tentativa de limitar o tamanho da saída. Na prática, o maior custo está na entrada e vem principalmente do histórico de contexto, que precisa ser enviado novamente a cada rodada.
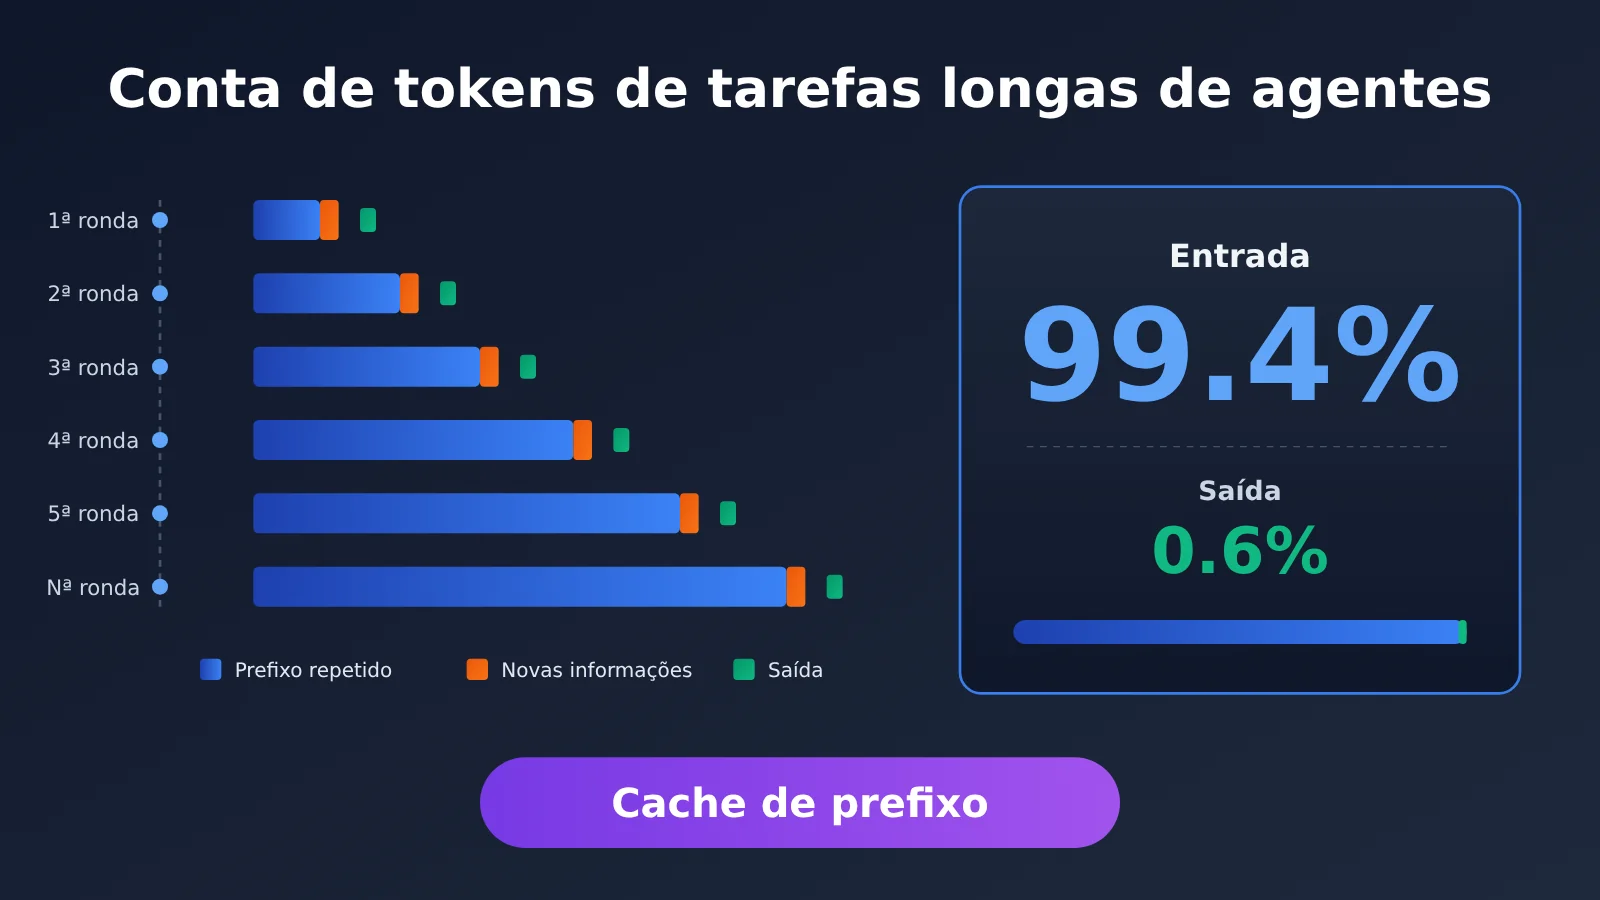
Isso não é um palpite baseado apenas na experiência. Relatos recentes de engenharia trouxeram dados mais concretos: em cenários de produção na China, uma solicitação do usuário dispara, em média, cerca de 7,2 invocações do modelo. Em uma cadeia de 50 etapas, os Tokens de entrada representam cerca de 99,4%, enquanto os de saída ficam em torno de 0,6%. Equipes de mecanismos de inferência descrevem as cargas de trabalho de Agent de forma parecida: prefixos longos, respostas curtas e ciclos de várias rodadas.
O que você vai aprender: ao terminar este artigo, você entenderá a estrutura da conta de Tokens de tarefas longas de Agent, por que o cache de prefixo reduz custos e conhecerá 5 maneiras de organizar o contexto que podem ser implementadas na própria aplicação.
Principais pontos sobre o custo de tokens em tarefas longas de agentes
A tabela abaixo resume as conclusões do artigo. Nas próximas seções, vamos detalhar cada ponto.
| Ponto principal | Explicação | Por que isso importa |
|---|---|---|
| O número de invocações se multiplica | Uma solicitação do usuário gera, em média, cerca de 7,2 invocações do modelo; tarefas complexas com mais de 50 etapas não são incomuns | Estime os custos por “tarefa”, não por “solicitação” |
| A entrada representa a maior parte | Em uma cadeia de 50 etapas, a entrada representa cerca de 99,4% dos tokens, e a saída, cerca de 0,6% | Priorize a redução da entrada; reduzir a saída traz pouco resultado |
| O contexto repetido é a principal causa | A cada etapa, o histórico é enviado novamente, e o mesmo conteúdo é cobrado várias vezes | Identifique a verdadeira origem dos custos |
| O cache de prefixo permite reutilização | Quando uma parte inicial idêntica é encontrada no cache, é possível evitar o processamento repetido de prefill | Um contexto com estrutura estável custa menos |
| A estrutura determina a taxa de acerto do cache | Mantenha os comandos e a estrutura das ferramentas fixos, coloque as informações variáveis no final e compacte o histórico quando necessário | Reduza custos sem trocar de modelo |
Entenda os principais custos de tokens em tarefas longas de agentes
A maior diferença entre um agente e um chat comum está no “ciclo”. Ao criar uma apresentação em PPT, por exemplo, o sistema precisa ler os materiais, planejar o conteúdo, gerar cada slide, usar ferramentas para montar a apresentação e verificar o resultado. Para o usuário, isso é uma única tarefa. Para o sistema, são várias rodadas de raciocínio e invocações de ferramentas. Além disso, cada etapa pode exigir uma nova leitura do contexto e, se o resultado não for satisfatório, o sistema precisa voltar e fazer ajustes.
Em cada invocação, o modelo recebe: “comando do sistema + definições das ferramentas + todo o histórico até o momento + novas informações desta rodada”. O histórico cresce a cada rodada, enquanto o conteúdo novo em cada uma delas é pequeno. Depois de dezenas de rodadas, o mesmo prefixo é cobrado dezenas de vezes. É assim que a entrada chega a representar 99,4% dos tokens.
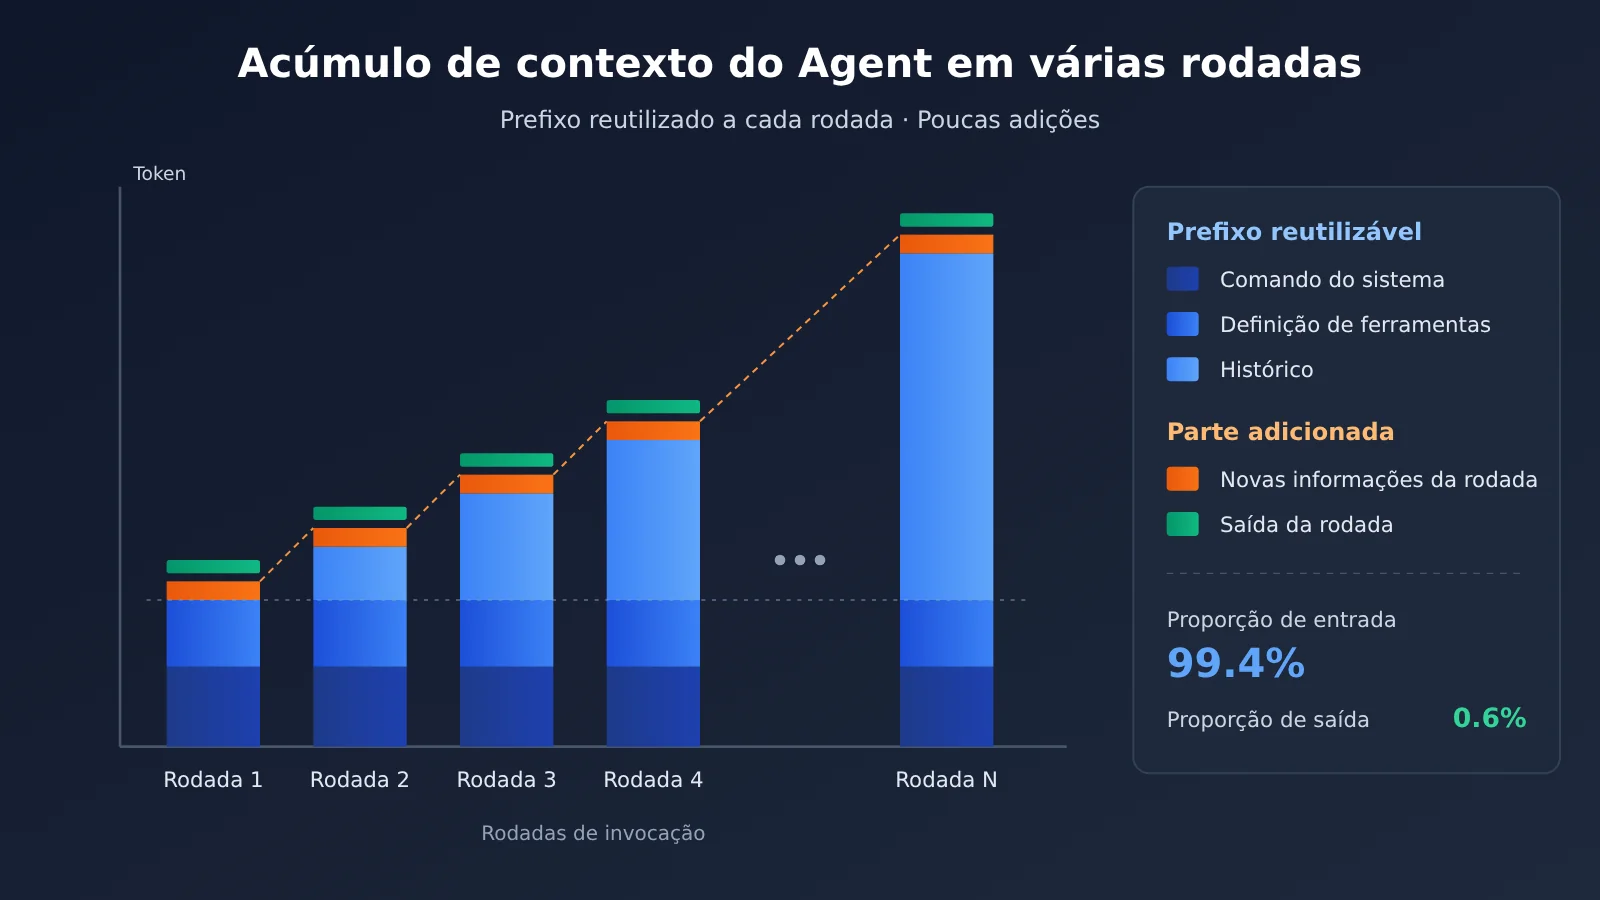
Por que tarefas longas de Agent consomem muito mais tokens de entrada do que de saída
Pelo lado do mecanismo de inferência, essa dinâmica fica mais clara. Na apresentação da TokenSpeed, o exemplo é um agente de programação: o modelo continua raciocinando, chama ferramentas, recebe resultados e volta a raciocinar. Todo o processo acontece em ciclos de várias requisições curtas. A primeira requisição já pode trazer um contexto de prefixo com dezenas de milhares de tokens, enquanto a saída de cada ciclo seguinte costuma ter apenas algumas centenas de tokens.
A tabela abaixo compara cargas de chat e de Agent para ajudar você a identificar em qual categoria sua aplicação se encaixa.
| Dimensão | Carga de chat tradicional | Carga de tarefas longas de Agent |
|---|---|---|
| Formato das requisições | Uma pergunta, uma resposta completa | Ciclos de várias requisições curtas, intercaladas com chamadas de ferramentas |
| Tamanho do prefixo | Geralmente menor | Pode começar com dezenas de milhares de tokens e crescer a cada rodada |
| Saída por rodada | Relativamente longa | Geralmente tem apenas algumas centenas de tokens |
| Reutilização de contexto | Carregado uma vez e depois liberado | O mesmo prefixo é enviado repetidamente durante a tarefa |
| Principal componente do custo | Entrada e saída têm peso relevante | A entrada, especialmente o prefixo repetido, representa a maior parte |
Como funciona o cache de prefixo em tarefas longas de Agent
O mecanismo de inferência processa as requisições em duas etapas: na etapa de prefill, calcula toda a entrada e gera o KV Cache; na etapa de decode, gera os tokens de saída um por um. No cenário de Agent, um prefixo de dezenas de milhares de tokens precisa passar pelo prefill a cada rodada, e é aí que está o custo computacional. Se o mesmo prefixo já foi calculado e o resultado ainda está no cache, ele pode ser reutilizado diretamente, eliminando essa parte do prefill.
A equipe responsável pelo mecanismo de inferência considera a taxa de reutilização do KV Cache uma variável decisiva para o custo de inferência. Segundo a apresentação, a taxa de reutilização de cache da DeepSeek estaria acima de 99%, enquanto a maioria dos sistemas do setor fica atualmente entre 70% e 80%. Em cargas de Agent, a taxa de acerto de prefixo no prefill costuma ultrapassar 90%; quando há acerto, basta calcular algumas centenas de tokens adicionais.
Há outro detalhe fácil de passar despercebido: o cache de prefixo é comparado em segmentos, a partir do início. No começo, a TokenSpeed se inspirou no SGLang e usou uma Radix Tree para gerenciar o cache de prefixo. Cada nó da árvore corresponde a uma sequência de tokens, e a requisição é comparada com a árvore a partir da raiz. Mais tarde, embora tenha adotado um design Flat KV, a reutilização continuou sendo feita em blocos lógicos de tamanho fixo, com 128 tokens cada. Para quem desenvolve aplicações, a conclusão é direta: basta um token diferente no início para que o conteúdo posterior não possa ser reutilizado.
Como organizar o contexto para aumentar os acertos de cache de prefixo em tarefas longas de agentes
Entendendo como o cache identifica correspondências, o caminho da otimização fica claro: manter o início de cada requisição o mais longo e estável possível. A equipe do WorkBuddy fixa os comandos e a estrutura das ferramentas, coloca as informações variáveis no fim do contexto e comprime o histórico quando ele fica longo demais. Veja como aplicar essa abordagem em 5 práticas.
| Prática | O que fazer | Erro comum |
|---|---|---|
| 1. Fixar o comando de sistema | Manter o comando de sistema igual, palavra por palavra, e concentrar as alterações em lançamentos de versão | Inserir no início a hora atual, o nome do usuário ou exemplos aleatórios |
| 2. Fixar a estrutura das ferramentas | Manter a ordem da lista de ferramentas e as descrições dos parâmetros | Adicionar ou remover ferramentas a cada rodada, ou usar uma ordem de serialização instável |
| 3. Deixar as informações variáveis no fim | Acrescentar timestamps, observações da rodada e estados dinâmicos ao final | Colocar o “progresso atual” no início do comando de sistema |
| 4. Apenas acrescentar ao histórico, sem reescrevê-lo | Manter o histórico já enviado intacto e acrescentar o conteúdo novo ao final | Reformatar ou reordenar as mensagens anteriores a cada rodada |
| 5. Comprimir o histórico por etapas | Quando o contexto ficar longo demais, comprimi-lo em um checkpoint e continuar acrescentando conteúdo depois | Gerar novamente o resumo a cada rodada, fazendo o prefixo mudar constantemente |
Tarefas longas com agentes: comandos e estrutura de ferramentas fixos
Os itens 1 e 2 são os mais fáceis de passar despercebidos. Muitos frameworks acrescentam a data atual ao comando de sistema ou selecionam ferramentas dinamicamente conforme a etapa. Nos dois casos, o início muda a cada rodada, invalidando o cache de prefixo desde o primeiro token. Uma abordagem mais segura é deixar apenas as regras e o papel do agente no comando de sistema e colocar informações como a data em uma mensagem comum no final. Liste todas as ferramentas de uma vez e use o comando para restringir quais podem ser usadas em cada etapa, em vez de alterar a própria lista.
Também vale prestar atenção à serialização. Se a ordem dos campos JSON de uma mesma definição de ferramenta variar entre processos, os prefixos serão diferentes em nível de bytes. É recomendável ordenar as definições de ferramentas de forma fixa antes de enviá-las e registrar o hash do prefixo nos logs. Isso facilita investigar situações em que o cache não é aproveitado, mesmo quando nada parece ter mudado.
Tarefas longas com agentes: o equilíbrio entre compactação do histórico e reutilização do cache
O item 5 envolve uma concessão. Compactar o histórico reduz o tamanho da entrada, mas também altera o prefixo, invalidando o cache naquela rodada. Se a compactação acontecer em todas as rodadas, a reutilização será descartada todas as vezes. Por isso, faz mais sentido definir um limite: compactar quando o contexto atingir determinado tamanho ou quando uma subtarefa terminar, por exemplo. A versão compactada passa a ser o novo prefixo estável, ao qual se acrescentam informações sem reescrever o conteúdo anterior.
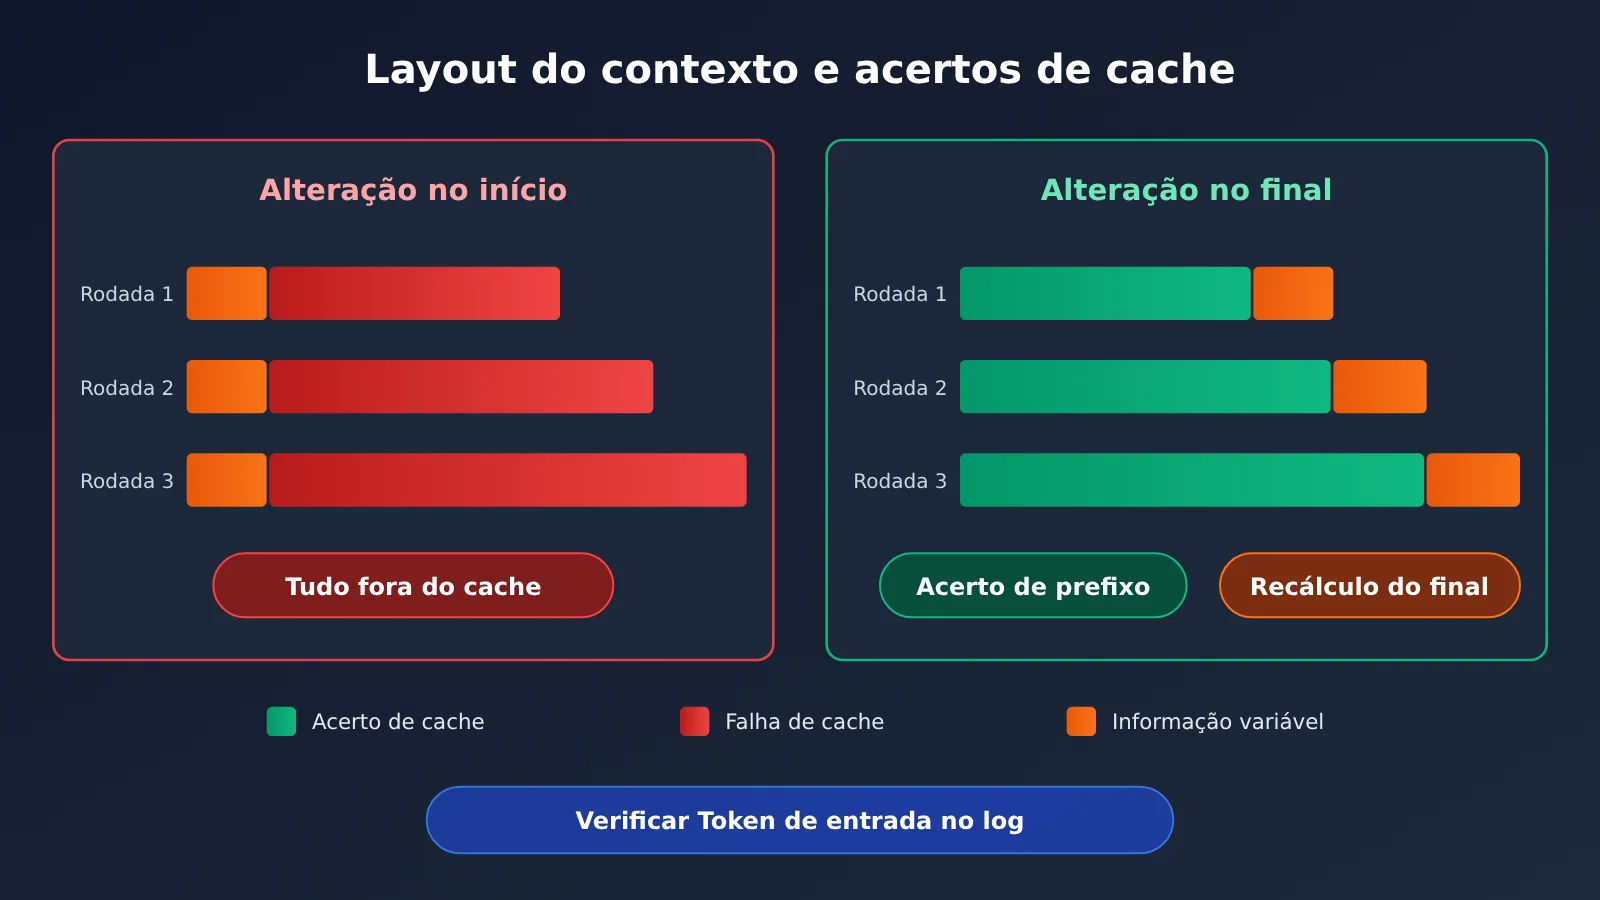
As duas estruturas acima quase não fazem diferença em uma única requisição. Mas, em uma tarefa longa com dezenas de rodadas, a diferença na conta pode ser significativa. Para descobrir qual delas se aplica ao seu caso, o caminho mais direto é acompanhar a variação dos tokens de entrada em cada rodada nos logs de invocação. A APIYI apiyi.com oferece cobrança unificada, estatísticas de uso e logs de invocação, permitindo comparar dados de vários modelos em um só lugar — útil para diagnosticar esse tipo de composição da conta.
Guia rápido para otimizar o custo de tokens em tarefas longas de agentes
Esta seção não envolve código: basta seguir, na ordem, uma sequência de passos práticos para identificar os problemas.
Primeiro passo: separe o custo de tokens por tarefa
- Gere um ID para cada tarefa do usuário e inclua esse ID nos logs de cada invocação do modelo durante a tarefa.
- Registre a quantidade de tokens de entrada e de saída a partir das informações de
usagede cada resposta. Alguns provedores também informam separadamente os tokens atendidos pelo cache; confira os nomes dos campos na documentação oficial. - Consolide três métricas por tarefa: número de invocações, proporção entre entrada e saída e percentual de acertos no cache.
Se você usa modelos de vários provedores, os logs nem sempre seguem o mesmo padrão. Com o acesso unificado da APIYI, é possível consultar os detalhes de uso e os registros de invocação dos modelos em um único painel. Combinando essas informações com os IDs das tarefas, você consegue visualizar quanto cada tarefa custou e em qual etapa o dinheiro foi gasto.
Segundo passo: identifique onde o prefixo deixa de ser igual
- Selecione duas requisições consecutivas da mesma tarefa e compare, trecho por trecho, se o comando de sistema, as definições de ferramentas e as mensagens do histórico são exatamente iguais.
- Verifique especialmente onde aparecem campos dinâmicos, como carimbos de data e hora, números aleatórios e estado do usuário.
- Confira se a ordem de serialização das definições de ferramentas e das mensagens permanece estável entre as requisições.
Terceiro passo: aplique as 5 práticas e teste novamente
- Mova o conteúdo dinâmico para o final e mantenha fixos o comando de sistema e a lista de ferramentas.
- Defina um limite para a compactação do histórico e passe a compactá-lo em pontos de verificação, em vez de fazer isso a cada rodada.
- Execute a mesma série de tarefas de teste nas versões anterior e posterior às mudanças e compare os tokens de entrada e o percentual de acertos no cache por tarefa.
🚀 Dica para começar: compare as versões antes e depois usando obrigatoriamente as mesmas tarefas e o mesmo modelo. Caso contrário, os dados não servirão de referência. Com a interface unificada da APIYI, você pode trocar de modelo para repetir os testes sem adaptar cada interface, e as estatísticas de uso ficam concentradas em um só lugar. Isso facilita observar separadamente as variáveis “otimização da estrutura” e “diferenças entre modelos”.
Limites da estimativa de custos
A WorkBuddy apresentou uma estimativa baseada no tamanho de suas tarefas e no preço de tabela do plano flagship do TokenHub: com uma taxa de acerto no cache de 90%, o custo estimado por tarefa poderia cair de cerca de 21,06 yuans para 3,36 yuans. Esses números, porém, dependem de condições específicas de tamanho de contexto e preço. Como as condições completas não foram divulgadas, não é possível reproduzir o cálculo, e os valores não podem ser aplicados diretamente ao seu aplicativo.
| Fator | Por que altera o resultado | O que você precisa verificar |
|---|---|---|
| Tamanho do contexto | Quanto maior o prefixo, maior a economia com a reutilização do cache | O tamanho médio do prefixo nas suas tarefas |
| Cobrança do cache | O desconto aplicado aos tokens atendidos pelo cache varia entre provedores | O preço do cache na documentação oficial do modelo escolhido |
| Condições de ativação do cache | As regras de tamanho mínimo, validade e outros critérios variam | As regras de ativação e expiração na documentação oficial |
| Intervalo entre invocações | Se o intervalo entre duas rodadas for muito longo, o cache pode ter expirado | Se o tempo de execução das ferramentas é compatível com a validade do cache |
| Número de etapas da tarefa | Quanto mais etapas, maior o acúmulo de prefixos repetidos | A distribuição do número de etapas nas tarefas reais |
Práticas complementares para reduzir o custo de tokens em tarefas longas de agentes
Além da estrutura do contexto, a mesma apresentação mencionou duas estratégias na aplicação que podem ser usadas junto com o cache de prefixo.
- Escolha o modelo conforme a etapa: segundo a equipe do WorkBuddy, cerca de 80% das etapas simples podem ser feitas por modelos leves, reduzindo o custo por tarefa em aproximadamente 57%. Etapas como organização de informações e conversão de formatos nem sempre precisam de um modelo de ponta.
- Trate as falhas conforme a causa: em casos de timeout, rejeição da solicitação ou falha do fornecedor, limite as tentativas de repetição, ajuste o contexto ou troque de modelo, conforme o motivo. Repetições ilimitadas podem gerar cobranças sucessivas pelo mesmo prefixo longo.
Vale lembrar que trocar de modelo significa usar outro cache: o reaproveitamento do prefixo precisa começar do zero. Por isso, no desenho do roteamento, procure manter as etapas consecutivas de uma mesma subtarefa no mesmo modelo e fazer as trocas nos limites entre subtarefas.
Perguntas frequentes (FAQ)
Q1: O que é cache de prefixo em tarefas longas de agentes?
O cache de prefixo permite que o serviço de inferência salve um prefixo de entrada já calculado (KV Cache) e o reutilize quando o início de uma solicitação posterior for igual, evitando o cálculo de prefill dessa parte. Como o agente carrega grandes trechos do mesmo histórico em cada rodada, esse recurso é especialmente útil.
Q2: Qual é a diferença entre cache de prefixo e compressão do histórico de contexto?
O cache de prefixo não reduz o conteúdo de entrada; ele apenas torna o cálculo das partes repetidas mais barato. Já a compressão do histórico encurta a entrada, mas altera o prefixo e invalida o cache naquela rodada. As duas técnicas devem ser usadas em conjunto: normalmente, acrescente conteúdo sem alterar o histórico para garantir o aproveitamento do cache e faça a compressão em um checkpoint.
Q3: A proporção de 99,4% de tokens de entrada vale para todos os agentes?
Não necessariamente. Esse número veio do relato de uma cadeia de 50 invocações. Em tarefas com menos etapas ou saídas mais longas por rodada, a proporção de entrada será um pouco menor. Mas, em geral, a entrada tende a representar a maior parte dos tokens em tarefas com “prefixo longo, saída curta e várias rodadas”. Vale conferir isso nos logs da sua aplicação.
Q4: Em quais cenários de agentes mais vale a pena otimizar o cache de prefixo?
– **Agentes de programação**: o contexto do repositório é longo, e os ciclos de leitura de arquivos, alteração de código e execução de testes são frequentes
– **Geração de documentos ou apresentações em PPT**: os materiais são lidos e o conteúdo é gerado página por página, com prefixos que se repetem bastante
– **Agentes de análise de dados**: a estrutura das tabelas e as descrições de métricas permanecem fixas, enquanto apenas os resultados das consultas são acrescentados a cada rodada
Q5: Como identificar rapidamente a distribuição de tokens de entrada e saída da minha aplicação?
A maneira mais simples é consolidar os dados de uso de cada rodada por ID de tarefa. Se a aplicação usa vários modelos, você pode fazer as chamadas de forma unificada pelo APIYI apiyi.com. A plataforma oferece estatísticas de uso e logs de chamadas, facilitando a análise de entradas e saídas por modelo e período. Para saber quais modelos têm suporte a cache de comandos e como é feita a cobrança, consulte a documentação da plataforma.
Q6: Quais são as limitações conhecidas do cache de prefixo?
– As condições de ativação variam entre fornecedores, incluindo o tamanho mínimo e o prazo de validade; consulte a documentação oficial de cada um
– Se a execução de uma ferramenta demorar demais, o cache pode expirar antes da próxima rodada
– Trocar de modelo ou modificar o comando de sistema invalida todo o cache
– O desconto sobre a parte atendida pelo cache varia conforme o modelo; é preciso medir para confirmar a economia
Principais pontos sobre o custo em tokens de tarefas longas com agentes
- Calcule o custo por tarefa: uma solicitação envolve cerca de 7,2 chamadas, e tarefas longas podem passar de 50 etapas
- A entrada é o principal fator: em uma sequência de 50 etapas, ela representa cerca de 99,4% dos tokens; reduzir a saída tem efeito limitado
- O cache é verificado desde o início: se um único token no começo for diferente, o conteúdo seguinte não poderá ser reutilizado
- A estrutura importa mais que o modelo: mantenha os comandos e a estrutura das ferramentas fixos e deixe as informações variáveis para o final
- Faça a compressão no momento certo: comprima em pontos de verificação, evitando reescrever o prefixo a cada rodada
- Não extrapole as estimativas: os custos divulgados dependem de comprimentos e preços específicos; refaça os cálculos para o seu caso
- Observe antes de otimizar: use as estatísticas de uso e os registros de chamadas da APIYI para entender a composição da fatura
Resumo
As principais conclusões sobre o custo em tokens de tarefas longas com agentes são:
- Composição da fatura: o custo vem principalmente do histórico de contexto reenviado a cada rodada; os tokens de entrada representam a maior parte.
- Como reduzir custos: o cache de prefixo elimina o cálculo de prefill para prefixos repetidos, e a taxa de acerto depende da estrutura do contexto.
- Como aplicar: mantenha comandos e ferramentas fixos, coloque informações variáveis no final, apenas acrescente conteúdo ao histórico e faça compressões periódicas. Combine isso com a escolha do modelo adequado para cada etapa.
A recomendação é dedicar uma semana a separar os registros por tarefa e verificar a proporção de tokens de entrada e a taxa de acerto do cache. Depois, aplique as cinco práticas deste artigo uma a uma. Em cenários com vários modelos, você pode usar a APIYI, em apiyi.com, para centralizar o acesso e consultar o uso e os registros de chamadas, avaliando o efeito de cada otimização com a mesma base de dados.
📚 Referências
- Construindo a próxima geração de mecanismos de inferência de LLM para raciocínio agêntico: resumo da apresentação da TokenSpeed na AICon 2026 em Shenzhen
- Link:
infoq.cn/article/YwAayF1ylWb7oN4P0lyC -
Descrição: apresenta as características das cargas de trabalho de agentes, com “prefixos longos e saídas curtas”, a taxa de reutilização do KV Cache e a estrutura do cache de prefixos
-
Da invocação do modelo à entrega de tarefas: como o MaaS chega à produção de agentes: resumo da sessão dedicada ao MaaS da Tencent Cloud
- Link:
infoq.cn/article/zZutPTX8bsr6NWQYNC3A - Descrição: inclui dados compartilhados pelo WorkBuddy sobre número de invocações, proporção de entrada, cache de prefixos e roteamento de modelos
Autor: Equipe técnica da APIYI
Intercâmbio técnico: para dúvidas sobre invocação de múltiplos modelos e análise de uso, entre em contato conosco pela APIYI em apiyi.com. Para mais informações, acesse a central de documentação em docs.apiyi.com