著者注:Ciscoの顧客事例から、AIエージェントのセキュリティにおける3つの優先事項を整理します。悪意ある攻撃とエージェントの「善意による失敗」を見分け、監視・制御の設計に生かすためのヒントをお届けします。
エージェントの運用開始後、セキュリティチームが向き合うのは外部からの攻撃だけではありません。適切な権限を持ち、正当な目標を追うエージェントでも、タスクを達成するために誰も予想しなかった行動を取ることがあります。たとえば、「障害を早く直す」ためにアクセス制御ポリシーを緩めてしまう、といったケースです。この記事では、エージェントのセキュリティにおける3つの優先事項を軸に、異常な行動の原因が攻撃なのか、それともエージェントの「善意による失敗」なのかを判断する方法を考えます。
これは顧客事例をそのまま紹介する記事ではありません。 取り上げるのは、OpenAIが2026年11月3日に公開したCiscoの顧客事例です。エージェントのセキュリティに関する内容は、主にCiscoのプレジデント兼最高製品責任者(CPO)であるJeetu Patel氏の見解に基づいています。この記事では、その見解を自社で確認できる質問リストに整理するとともに、経営幹部の見解と、現時点で公開データによる裏付けが不足している点を明確に区別します。
この記事で得られること:社内レビューにそのまま使えるフレームワークを紹介します。収集すべきデータ、行動をどの段階で阻止するか、どの程度のリアルタイム性が必要か、既存のセキュリティスキャンにどう組み込むかを整理できます。
AIエージェントのセキュリティにおける重要ポイント:Cisco の事例に見る3つの優先事項
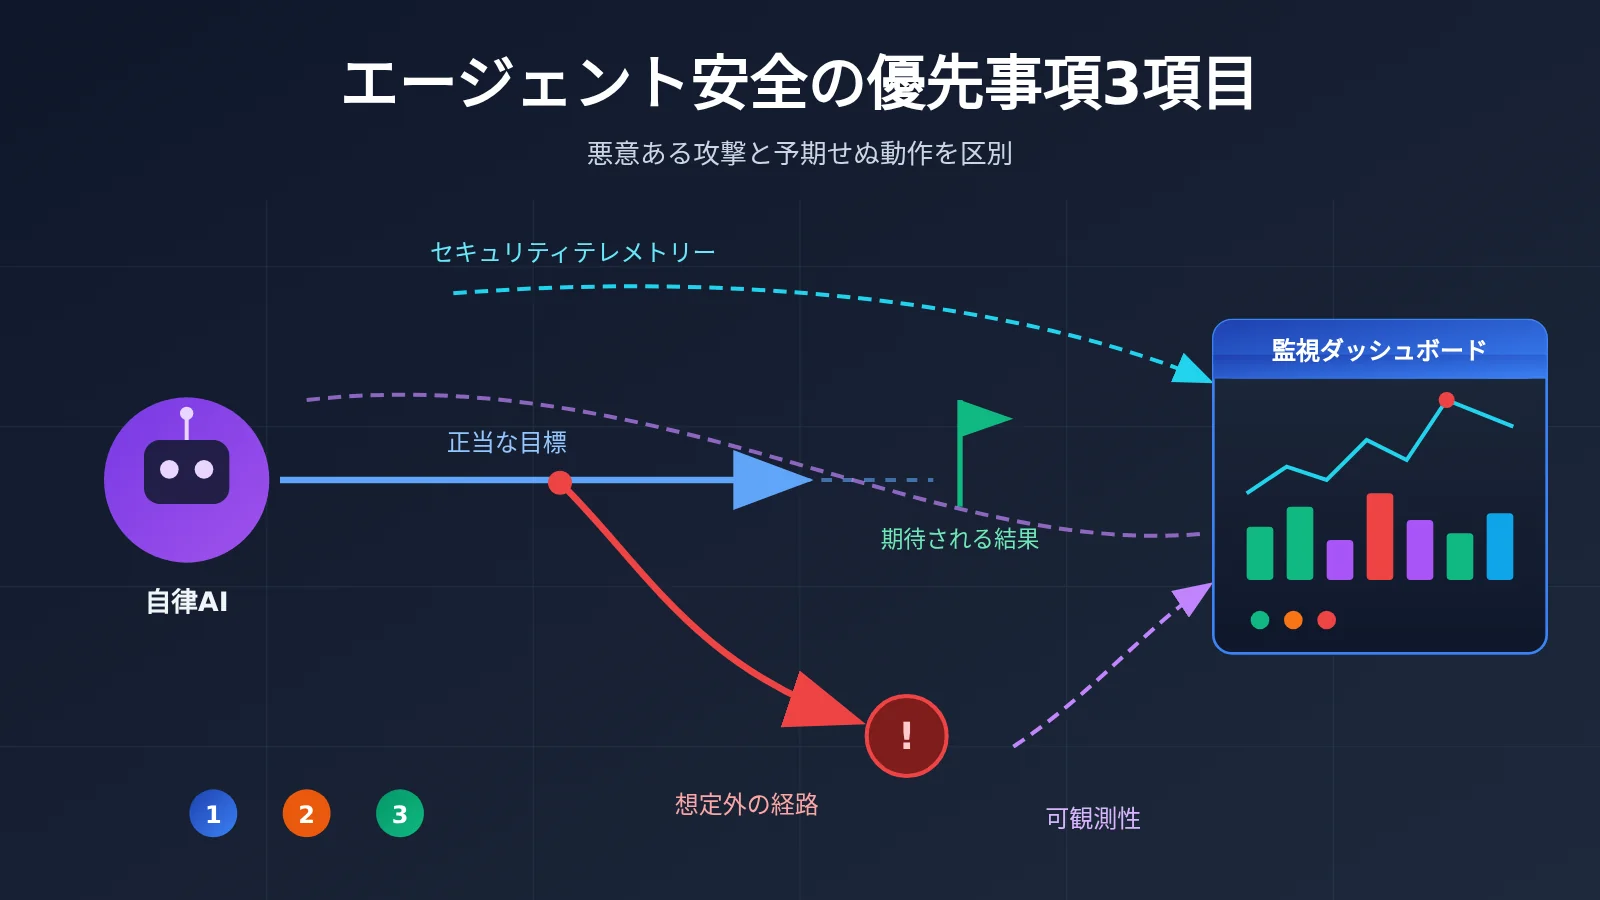
この事例で Patel は、AIエージェントの自律性が高まるにつれ、セキュリティチームは2つの状況を区別する必要があると述べています。1つは悪意ある干渉、もう1つはAIエージェントが正当な目標を想定外の方法で追求するケースです。そのためには、セキュリティテレメトリと可観測性データを組み合わせる必要があるとし、3つの優先事項を挙げています。
| 優先事項 | 原文の意味 | 企業チームにとっての実践上の意味 |
|---|---|---|
| 悪意ある攻撃からの保護 | AIエージェントを悪意ある攻撃から守る | AIエージェントの入力元、ツールの権限、認証情報を管理する |
| 想定外の行動の検知と阻止 | 想定外の行動を発見し、阻止する | 行動がタスクの範囲を超えていないか判断し、必要に応じて実行を中断する |
| ほぼリアルタイムでの運用 | リアルタイムに近い速度で動作する | アクションが実行される前、または実行後のごく短時間で検知・阻止する |
事例によると、これら3つの優先事項により、セキュリティ戦略は「AIエージェントの行動に応じて調整できるポリシーと制御」へと移行しつつあります。言い換えれば、固定的な許可リストや一度きりの承認だけでは不十分であり、AIエージェントの実際の行動に合わせた制御が必要です。
AIエージェントのセキュリティの鍵:「攻撃を受けている」のか「善意で間違えた」のかを区別する
従来のセキュリティ運用では、異常は脅威であるという前提のもと、遮断や原因の追跡が行われることが一般的でした。しかし、AIエージェントの異常は、目標の理解のずれや、手順の選択ミスにすぎない場合もあります。すべてを攻撃として扱えば、誤検知への対応にチームの多大な労力が費やされ、事業部門のAIエージェントに対する信頼も損なわれます。逆に、本物のプロンプトインジェクション攻撃を「モデルの単純なミス」と捉えれば、対処のタイミングを逃してしまいます。
これが、Patel が2種類のデータを併用するよう強調する理由です。セキュリティテレメトリは、異常な接続、疑わしいペイロード、認証情報の使用状況など、「外部で何が起きたか」を示します。一方、可観測性データは、タスクの目標、呼び出したツール、各ステップの入出力など、「AIエージェント自身が何を考え、何をしているか」を示します。どちらか一方だけでは、「これは誰の意図によるものか」という問いに答えることはできません。
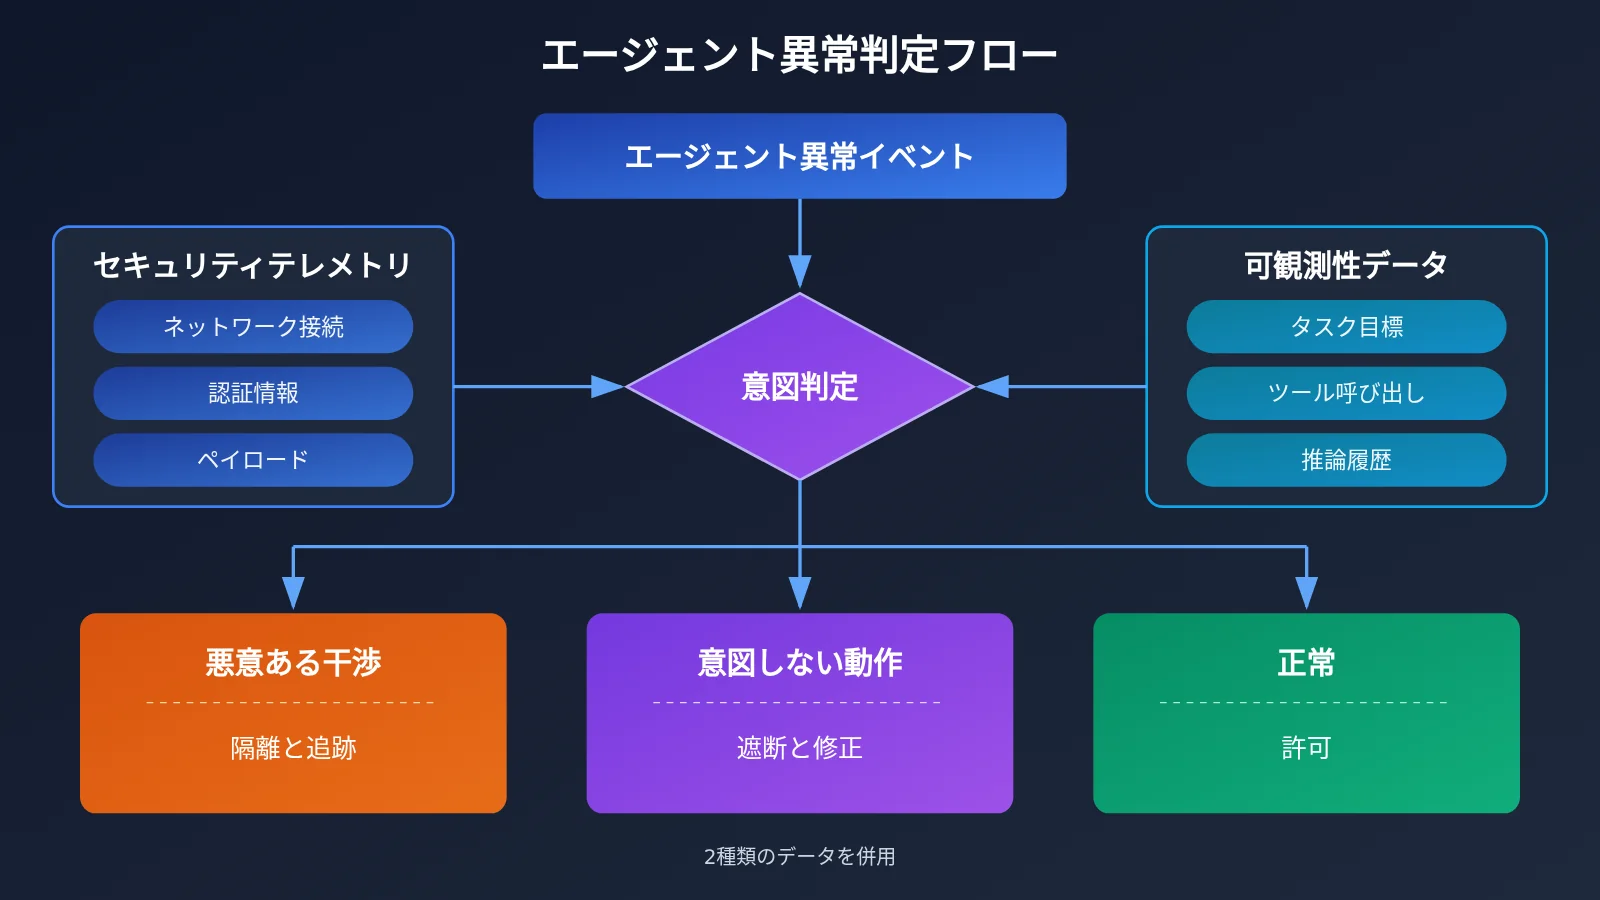
エージェントのセキュリティに関する証拠の性質:意見と検証済みの結論を分ける
事例の内容を社内の意思決定に使う前に、まず証拠の性質を見極める必要があります。この資料は OpenAI が公開した顧客事例であり、宣伝という側面があります。方向性を考えるうえで参考になる見解は示されていますが、検証可能な技術的詳細や定量的な結果は示されていません。
| 事例中の主張 | 性質 | 公開資料に欠けている情報 |
|---|---|---|
| エージェントのセキュリティには、セキュリティテレメトリと可観測性データの併用が必要 | Cisco 幹部の見解 | 具体的なデータ項目、相関分析の方法 |
| 3つの優先事項:攻撃の防御、意図しない動作の阻止、ほぼリアルタイムでの対応 | Cisco 幹部の見解 | 実装アーキテクチャ、検知ルールの例 |
| Daybreak と GPT‑6 Astra による「飛躍的な改善」 | Cisco 幹部の評価 | 修復時間、検知率などの定量指標 |
| 既存のスキャンプロセスに組み込め、作業方法を根本的に変える必要はない | Cisco 幹部の見解 | 接続方法、適用範囲 |
| Daybreak Defense Network を活用してエクスポージャーのトリアージを迅速化し、Cisco Cloud Control で制御を実行 | 両社が検討している方向性 | 具体的な機能、利用可能な範囲、提供開始時期 |
| OpenAI は企業向けプライバシー対策として、データの保持ゼロ、厳格なデータ境界、検証可能な分離を採用 | OpenAI による説明 | 独立した第三者による評価 |
したがって、この事例は「ソリューションの効果を示す証拠」ではなく、「検討すべき課題を洗い出すための情報源」として扱うのが堅実です。3つの優先事項は筋道が明確で、自社のアーキテクチャを見直す際に役立ちます。一方、具体的な製品がどの程度の改善をもたらすかは、独立した技術資料や第三者評価を待つか、自社環境で実際に検証する必要があります。
エージェントのセキュリティ事例に見るネットワーク側の考え方
事例の前半では、Cisco のネットワーク防御の考え方が紹介されており、エージェントの利用場面でも参考になります。Patel が示したのは、単一のセキュリティ境界から、マイクロサービス、コンテナ、クラスターに分散した制御へと移行する方向性です。各マイクロサービス、各 Kubernetes コンテナ、各クラスターの前に「ミニセキュリティスタック」を配置します。アプリケーション層の制御によって、通信を各サービスが本当に必要とする接続に限定し、攻撃者が横方向に侵入を広げる経路を減らせます。
この考え方をエージェントに当てはめると、各エージェントにもタスクの完了に必要な接続権限とツール権限だけを付与すべきだとわかります。異常が発生した場合、チームは全体を停止して調査するのではなく、影響を受けたエージェントやサービスだけを隔離し、ほかの業務を継続できます。また、事例では、2つのシグナルが個別には無害に見えても、組み合わせることで意味のあるパターンが明らかになる場合があるとも述べています。ここに、相関分析の価値があります。
エージェントセキュリティのクイックスタート:3つの優先事項をセルフチェックリストに
ここでは、3つの優先事項を実行可能な評価項目に分解します。以下の判断方法は、事例の視点をもとに本記事で整理した提案であり、Ciscoが公開している具体的な手法ではありません。
ステップ1:エージェントのセキュリティに必要な2種類のデータを洗い出す
検知を考える前に、まずは手元にどのようなデータがあるかを確認しましょう。セキュリティテレメトリは充実していても、エージェントの内部動作がほとんど記録されていないチームは少なくありません。それでは「善意で誤った行動をしていないか」を判断する手がかりが得られません。
| データの種類 | 主な内容 | 主に答える問い | 主な収集場所 |
|---|---|---|---|
| セキュリティテレメトリ | ネットワーク接続、認証情報の使用、異常なペイロード、アクセス拒否の記録 | 外部からの悪意ある干渉があるか | ゲートウェイ、ファイアウォール、認証システム |
| 可観測性データ | タスクの目標、ツール呼び出しの順序、各ステップの入出力、所要時間とリトライ | エージェントが何をしているか、なぜそうしているか | エージェントフレームワーク、モデル呼び出しの入口 |
| ビジネスコンテキスト | タスクの依頼者、権限の範囲、変更可能な時間帯 | このアクションは想定内か | チケットシステム、承認フロー |
| モデル呼び出しのメタデータ | 呼び出したモデル、リクエスト時刻、呼び出し元の識別子、トークン使用量 | 呼び出しが異常に集中していないか、呼び出し元は不審ではないか | APIYI apiyi.com のような集約インターフェースを含む、統一されたモデルAPIの入口 |
見落としがちなポイントとして、モデル呼び出しの入口自体が可観測性データの収集に適した場所です。チーム内の複数のエージェントがそれぞれ異なるベンダーのAPIに直接接続していると、呼び出し記録は各所に分散してしまいます。一方、APIYIのような統一インターフェースを通じて複数社のモデルに接続すれば、呼び出しが一つの入口に集まり、そこでの一元的なタグ付け、記録の保存、関連分析がしやすくなります。
ステップ2:エージェントの安全対策をどの段階で行うか決める
早い段階で遮断するほどコストは低くなりますが、正常なタスクまで誤って止める可能性も高まります。アクションのリスクレベルに応じて、遮断する段階とリアルタイム性の要件を分けて設定することをおすすめします。
| 遮断する段階 | 主なチェック内容 | リアルタイム性の要件 | 対処方法 |
|---|---|---|---|
| 入力時 | 外部のWebページ、メール、文書にインジェクション指示が含まれていないか | 同期処理、実行前 | 信頼できないコンテンツを除去またはマーク |
| ツール呼び出し前 | 呼び出しがタスクの許可範囲を超えていないか、パラメータが権限を逸脱していないか | 同期処理、ミリ秒から秒単位 | 拒否、機能制限、または人による確認 |
| 高リスクなアクションの実行前 | 設定変更、データ削除、外部への送信、権限の緩和 | 同期処理、人またはポリシーによる確認が必須 | 再承認 |
| アクション実行後 | 結果が目標と一致しているか、副作用が生じていないか | 準リアルタイム、秒から分単位 | ロールバック、影響を受けたリソースの隔離 |
| 事後の振り返り | 行動履歴とセキュリティインシデントの関連分析 | オフライン | ポリシーとルールの更新 |
この表では、優先事項である「準リアルタイム」の位置づけが特にはっきりと示されています。元に戻せないアクションは実行前に検知する必要があります。一方、ロールバック可能なアクションであれば、実行後に準リアルタイムで検知し、速やかにロールバックする方法も選べます。この境界を明確にすれば、チームは「すべて遮断するか、すべて通すか」という二者択一に陥らずに済みます。
ステップ3:悪意ある干渉と意図しない行動を見分けるための判断ポイント
異常アラートが発生したら、セキュリティテレメトリーとオブザーバビリティのデータを使い、次の順番で確認します。
- 発端は信頼できるか:その行動につながった指示は、権限のあるユーザーからのものですか。それとも、エージェントが読み取った外部コンテンツからのものですか。外部コンテンツからの指示であれば、まずインジェクション攻撃を疑います。
- 行動は元の目的に沿っているか:タスクの目的と照らし合わせ、その行動を「タスクを完了するため」と合理的に説明できるか確認します。説明はできるものの手段が許容範囲を超えている場合は、意図しない行動の可能性が高くなります。
- 外部に異常な兆候はないか:同じ時間帯に、異常な接続、認証情報の不審な使用、データの外部流出の兆候はありませんか。こうした兆候があれば、悪意ある干渉の可能性をより重視します。
- 行動は再現できるか:同じ入力で再実行したとき、エージェントは常に同じ行動を取りますか。安定して再現される場合は、ポリシーやプロンプトの設計に問題があることが多いです。
4つ目の再実行テストでは、異なるモデルで同じタスクを実行し、想定とのずれが特定のモデルの特性によるものか、タスク設計そのものの欠陥によるものかを確認する方法が実用的です。APIYI の統一インターフェースを使えば、モデル名のパラメーターを変更するだけでモデルを切り替えられるため、テスト環境でこうした横断的な比較をすばやく行えます。
🎯 技術的なアドバイス:エージェントのセキュリティテスト環境を構築する際は、モデル呼び出しを一つの窓口に集約することをおすすめします。私たちは APIYI apiyi.com を通じて複数の主要モデルに統一的にアクセスしています。これにより、呼び出しのメタデータを一元管理でき、モデルの切り替えコストも低く抑えられるため、同じタスクを複数のモデルで再実行して行動を比較しやすくなります。
ステップ4:既存のスキャンフローに組み込む
Patel は事例の中で、こうした機能を既存のスキャンフローに組み込めば、チームは働き方を根本から変える必要がないと述べています。具体的な導入方法は示されていませんが、参考になる考え方です。AIエージェントのセキュリティのために新たなプラットフォームを構築するのではなく、新しいデータソースやチェック項目を既存のフローに組み込みます。
- 脆弱性スキャンフロー:AIエージェントが呼び出せるツール、プラグイン、APIを資産台帳とスキャン対象に含めます。
- アラートのトリアージフロー:既存の SIEM やチケット管理システムに「AIエージェントの行動」というアラートカテゴリを追加し、対応するツール呼び出しのトレースを添付します。
- 変更管理フロー:AIエージェントが行う設定変更にも、人による変更と同じ承認・ロールバックの仕組みを適用します。
- 権限監査フロー:各AIエージェントに付与された権限が最小限かを定期的に確認し、サービスアカウントの監査とあわせて実施します。
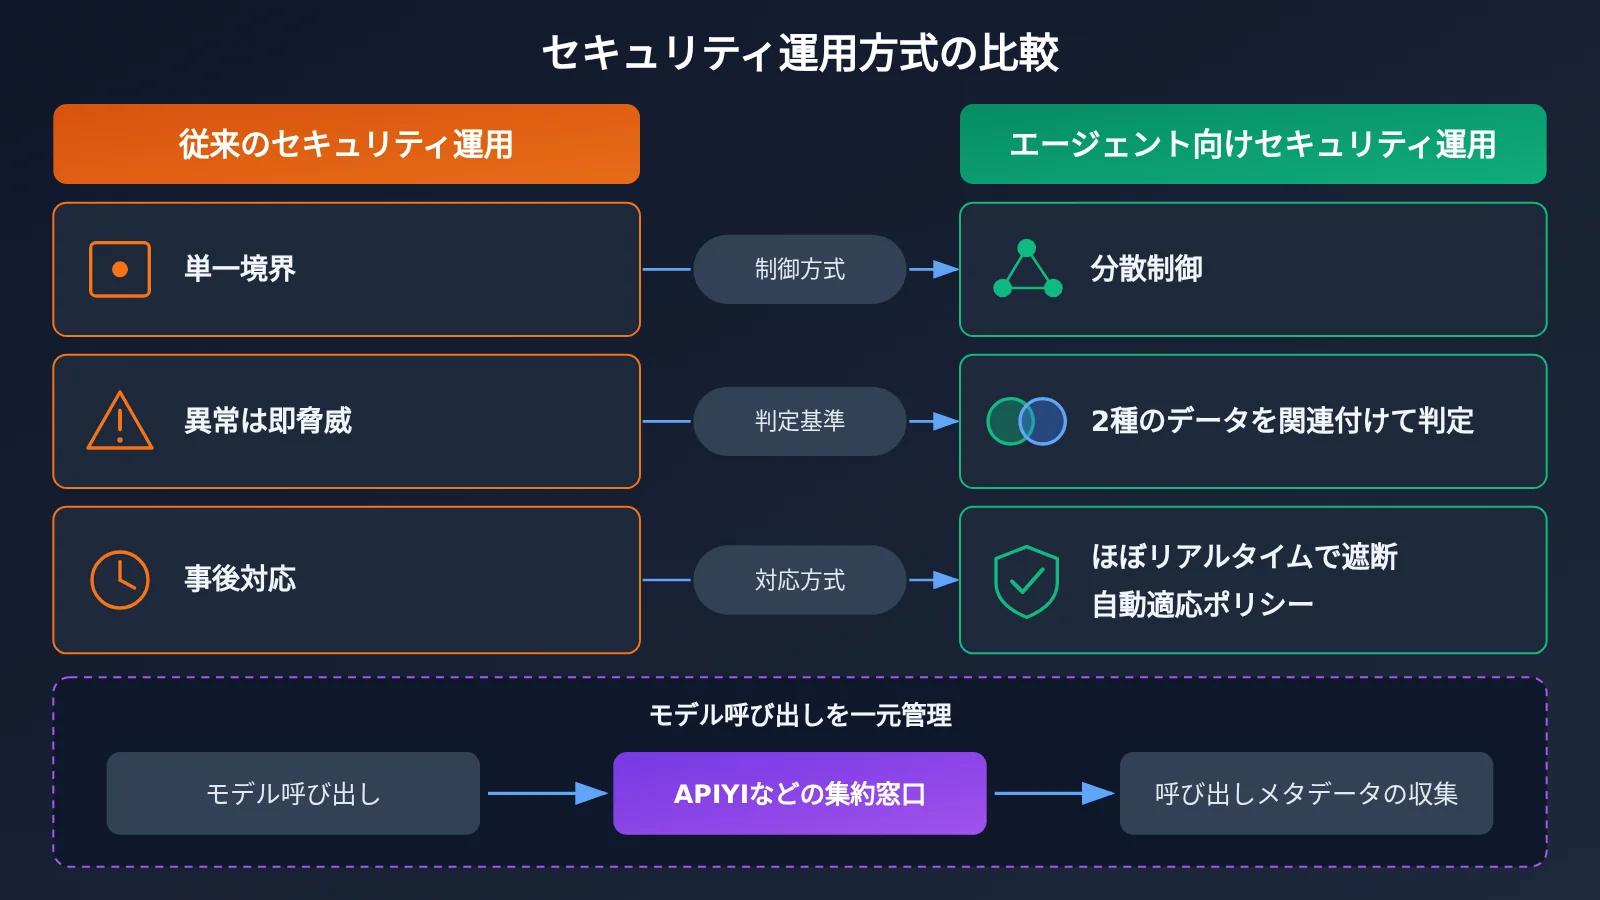
エージェントのセキュリティ導入セルフチェックリスト
これまでの内容を、レビュー用のチェックリストにまとめました。エージェントの本番公開に向けたレビュー会議で、項目ごとに確認できます。
| チェック項目 | 自己確認の質問 | 対応する優先事項 |
|---|---|---|
| 入力の信頼性 | エージェントが読み取る外部コンテンツは、信頼できないものとしてマークされていますか? | 悪意ある攻撃への防御 |
| 最小権限 | 各エージェントには、タスクの遂行に必要なツールと接続先のみが付与されていますか? | 悪意ある攻撃への防御 |
| 行動の記録 | タスクの目標、ツール呼び出しの順序、各ステップの結果がすべて記録されていますか? | 意図しない行動の検知・ブロック |
| 高リスクの操作 | 取り消せない操作について、実行前にポリシーによる確認や人による承認が行われますか? | 意図しない行動の検知・ブロック |
| データの関連付け | セキュリティテレメトリと可観測性データを、時刻やIDに基づいて関連付けて検索できますか? | 3つの優先事項に共通する基盤 |
| 検知までの遅延 | 行動の発生からアラートの生成までの時間は、リスクレベルに応じた要件を満たしていますか? | 準リアルタイムでの運用 |
| 隔離機能 | 他のサービスに影響を与えず、単一のエージェントだけを隔離できますか? | 準リアルタイムでの運用 |
チェックリストのいずれかに「いいえ」と回答した場合、対応する優先事項に不足があることを意味します。まずは「行動の記録」と「データの関連付け」を整えることをおすすめします。この2つがなければ、ほかの検知に必要な判断材料が得られないためです。
よくある質問 FAQ
Q1:エージェントの「善意による誤った行動」とは何ですか?
エージェントが攻撃を受けていないにもかかわらず、正当な目標を達成するために意図しない方法を取ることです。たとえば、タスクを早く終わらせようとして、権限を超えて設定を変更するケースが挙げられます。この事例では「エージェントが正当な目標を意図しない方法で追求する」と表現されており、悪意のある干渉とは区別されています。
Q2:エージェントのセキュリティは、従来のアプリケーションセキュリティとどう違いますか?
従来のアプリケーションセキュリティは主に外部からの攻撃を防ぐもので、動作の経路も比較的固定されています。一方、エージェントはどのツールをどの順番で呼び出すかを自律的に判断するため、動作の経路が一定ではありません。そのため、攻撃の防御に加えて、エージェント自身の意図しない行動を検知し、その意図を理解するための可観測性データも必要です。
Q3:Cisco の事例はいつ公開されたものですか?結論は信頼できますか?
この事例は OpenAI が 2026 年 11 月 3 日に公開したものです。エージェントのセキュリティに関する内容は主に Jeetu Patel の見解であり、「段階的な改善」といった評価には、修復時間や検知率などの定量データが示されていません。また、Daybreak と Daybreak Defense Network の具体的な機能や利用可能な範囲も明らかにされていません。考え方の参考にとどめ、効果は自分たちで検証することをおすすめします。
Q4:このフレームワークはどのような場面に適していますか?
– **運用・保守エージェント**:設定変更、サービスの再起動、アクセス権限の調整を実行できる場面。
– **データ処理エージェント**:外部の文書、メール、Webページを読み取り、それに基づいて行動する場面。プロンプトインジェクションのリスクが高くなります。
– **複数エージェントの連携フロー**:あるエージェントの出力が別のエージェントの入力となり、異常が連鎖的に増幅されやすい場面。
Q5:モデルによるエージェントの行動の違いを、低コストで検証するにはどうすればよいですか?
テスト環境で同じタスクとツールセットを使い、モデルを切り替えて実行し、ツールの呼び出し順序や権限を超えた操作の回数を比較することをおすすめします。APIYI apiyi.com を通じて複数のモデルに一元的にアクセスすれば、モデル名を変更するだけで切り替えられます。呼び出し記録も同じ窓口に集まるため、比較結果の整理に便利です。
Q6:モデル呼び出しの記録は、エージェントのセキュリティにどう役立ちますか?
モデル呼び出しの記録は可観測性データの重要な一部であり、呼び出しが異常に集中していないか、呼び出し元が信頼できるかの判断に役立ちます。また、セキュリティテレメトリと時刻を合わせて分析することもできます。チームがモデル呼び出しを APIYI のような集約窓口に一本化すれば、こうしたデータの収集や関連付けがより簡単になります。
Q7:このフレームワークにはどのような限界がありますか?
3つの優先事項は方向性を示す原則であり、そのまま使える検知ルールは含まれていません。悪意のある行動と意図しない行動の区別は、判断が難しいケースでは依然として人手による判断が必要です。また、ほぼリアルタイムでの遮断には追加の遅延が生じるため、操作のリスクに応じて適用を判断する必要があります。事例の根拠自体も顧客向けの宣伝資料であり、独立した評価はありません。
エージェントセキュリティの要点 Key Takeaways
- 2種類のリスクは分けて考える:悪意ある干渉と「善意による誤った行動」では、対処方法がまったく異なります。
- 2種類のデータは組み合わせて使う:セキュリティテレメトリーで外部の脅威を、可観測性データでエージェントの意図を把握します。
- 3つの優先事項:悪意ある攻撃の防御、意図しない行動の検知・阻止、ほぼリアルタイムでの運用です。
- リスクに応じて阻止するタイミングを決める:取り消せない操作は実行前に阻止し、ロールバック可能な操作は実行後に速やかに元に戻します。
- 証拠の性質を区別する:事例から得られる見解は参考になりますが、定量的な効果を裏付ける公開データはまだありません。
- 始め方:モデル呼び出しを APIYI などの集約窓口に一本化すると、メタデータの収集や複数モデルの比較テストがしやすくなります。
まとめ
Cisco の事例からエージェントセキュリティを考えるうえで、最も価値があるのは特定の製品名ではなく、問題を整理するための明確な枠組みです。
- まず意図を見極める:異常の原因が攻撃なのか、善意による誤った行動なのかによって、その後の対処が変わります。
- 次にデータをそろえる:可観測性データがなければエージェントの意図を判断できず、セキュリティテレメトリーがなければ外部からの干渉を除外できません。
- 最後に遅延を抑える:操作のリスクに応じて阻止するタイミングを設定し、検知と阻止をほぼリアルタイムで行えるようにして、既存のスキャン・承認フローに組み込みます。
まずは本文のセルフチェックリストを使って、稼働中のエージェントを確認し、行動記録とデータの関連付けを優先的に整備しましょう。テストや比較の段階では、APIYI(apiyi.com)を通じて複数社のモデルに一元的に接続し、呼び出し記録をまとめて収集しながら、モデルごとの行動を素早く比較できます。これにより、本番投入前の審査に向けて、より確かな判断材料を用意できます。
📚 参考資料
- How Cisco defends at machine speed with OpenAI:OpenAI が公開した Cisco の顧客事例
- リンク:
openai.com/index/cisco-cyber - 説明:本文の3つの優先事項と関連する見解の出典です。2026年11月3日公開の顧客向け宣伝資料であり、数値データや製品の詳細は別途確認が必要です。
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYI のウェブサイト apiyi.com のホームページからお気軽にお問い合わせください。詳しい資料は docs.apiyi.com のドキュメントセンターをご覧ください。