Note de l’auteur : trois priorités de sécurité des agents tirées du cas client Cisco, pour aider les équipes d’entreprise à distinguer les attaques malveillantes des initiatives d’agents qui partent d’une bonne intention mais tournent mal, et à concevoir les dispositifs de surveillance et de contrôle adaptés.
Une fois les agents déployés, les équipes de sécurité ne font plus face aux seules attaques externes. Un agent doté d’autorisations appropriées et poursuivant un objectif légitime peut aussi emprunter un chemin que personne n’avait anticipé. Par exemple, pour « résoudre une panne au plus vite », il pourrait assouplir une politique d’accès au passage. Cet article présente trois priorités pour la sécurité des agents, afin de vous aider à déterminer si un comportement anormal résulte d’une attaque ou d’une initiative bien intentionnée mais maladroite de l’agent.
Cet article ne se contente pas de reprendre un témoignage client promotionnel. Il s’appuie sur le cas client Cisco publié par OpenAI le 3 novembre 2026, dont le contenu sur la sécurité des agents reprend principalement les points de vue de Jeetu Patel, président et directeur des produits de Cisco. Nous en tirons une liste de questions pour faire votre propre évaluation, en distinguant clairement les opinions du dirigeant des points qui ne sont pas encore étayés par des données publiques.
L’essentiel : à la fin de cet article, vous disposerez d’un cadre directement utilisable pour vos évaluations internes : quelles données recueillir, à quelles étapes intervenir, quel niveau de réactivité viser et comment intégrer le tout aux processus d’analyse de sécurité existants.
Sécurité des agents : les 3 priorités du cas Cisco
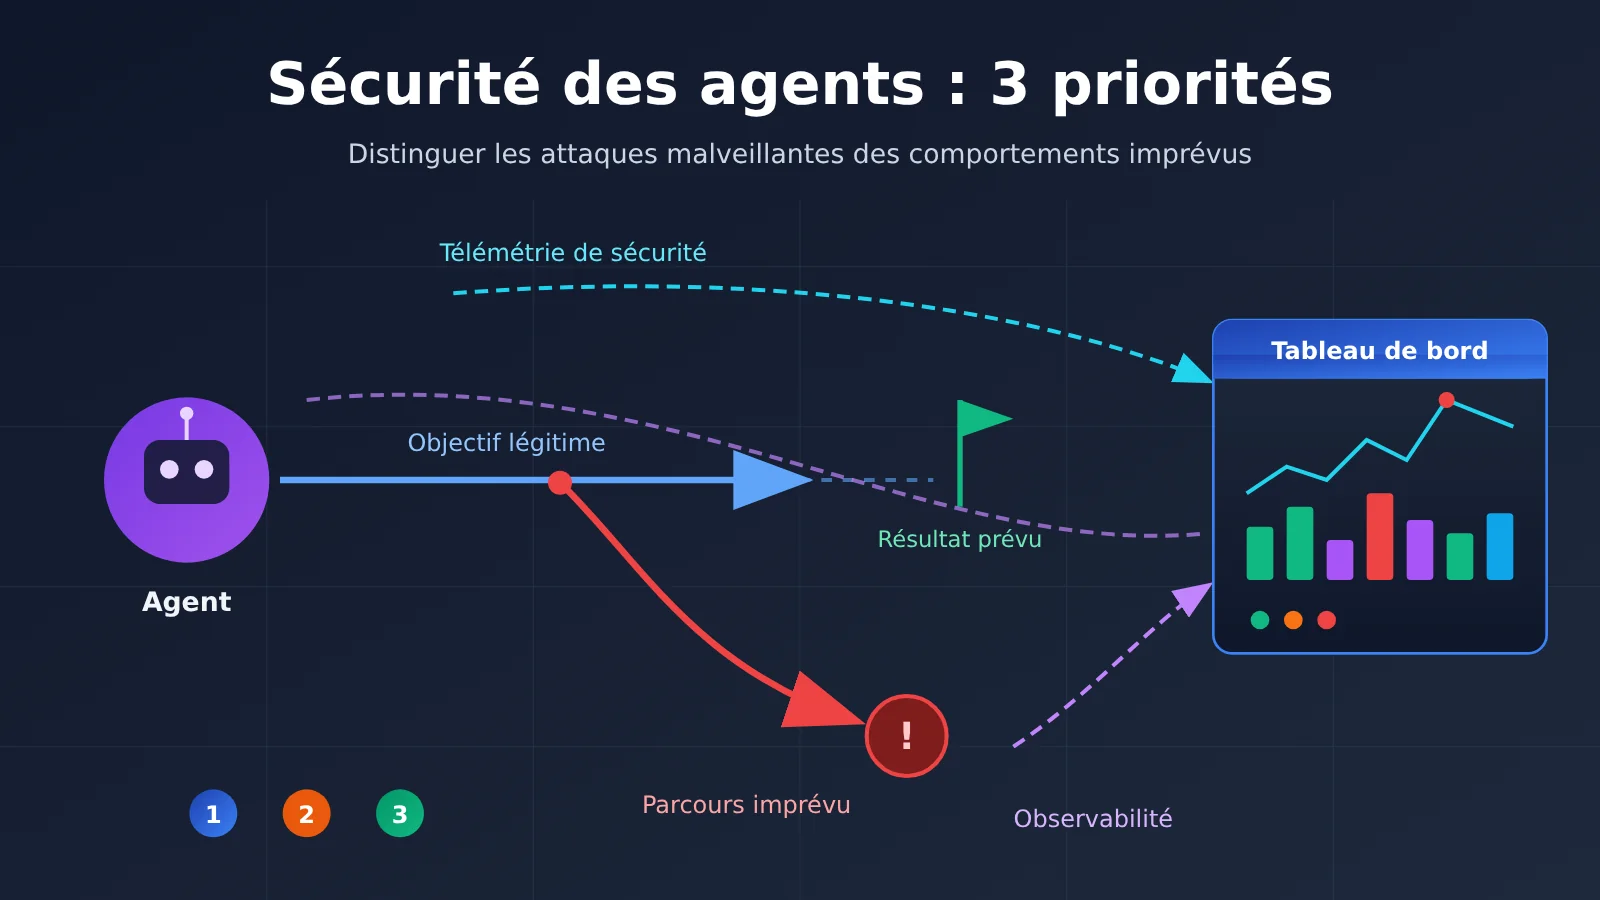
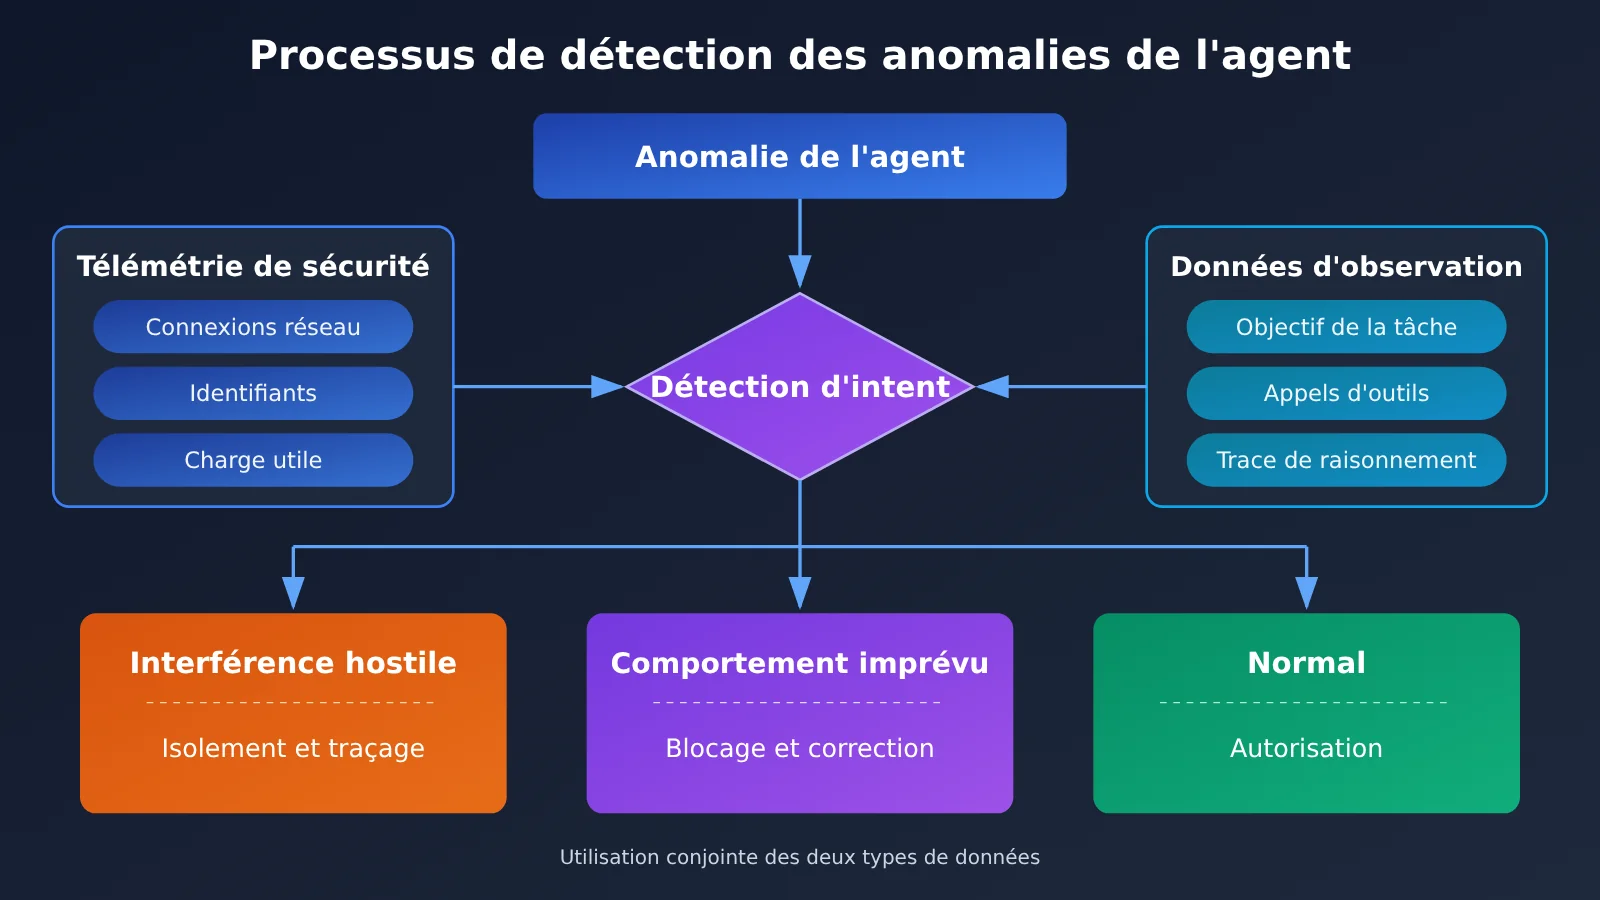
Dans ce cas, Patel explique qu’à mesure que les agents gagnent en autonomie, les équipes de sécurité doivent distinguer deux situations : une intervention malveillante et un agent qui poursuit un objectif légitime d’une manière imprévue. Pour y parvenir, il estime nécessaire de combiner les données de télémétrie de sécurité et d’observabilité, et définit trois priorités.
| Priorité | Sens dans le texte original | Application pour les équipes en entreprise |
|---|---|---|
| Se protéger contre les attaques malveillantes | Protéger les agents contre les attaques malveillantes | Contrôler les sources de données fournies aux agents, leurs autorisations d’accès aux outils et leurs identifiants |
| Détecter et bloquer les comportements imprévus | Repérer et bloquer les comportements imprévus | Déterminer si le comportement dépasse le cadre de la tâche et interrompre l’exécution si nécessaire |
| Fonctionner en quasi-temps réel | Agir à une vitesse proche du temps réel | Détecter et bloquer les actions avant qu’elles ne prennent effet, ou très peu de temps après |
Selon ce cas, ces trois priorités orientent la stratégie de sécurité vers « des politiques et des contrôles capables de s’adapter aux actions des agents ». Autrement dit, les listes blanches statiques et les approbations ponctuelles ne suffisent plus : les contrôles doivent suivre les actions réelles des agents.
La clé de la sécurité des agents : distinguer une attaque d’une erreur commise de bonne foi
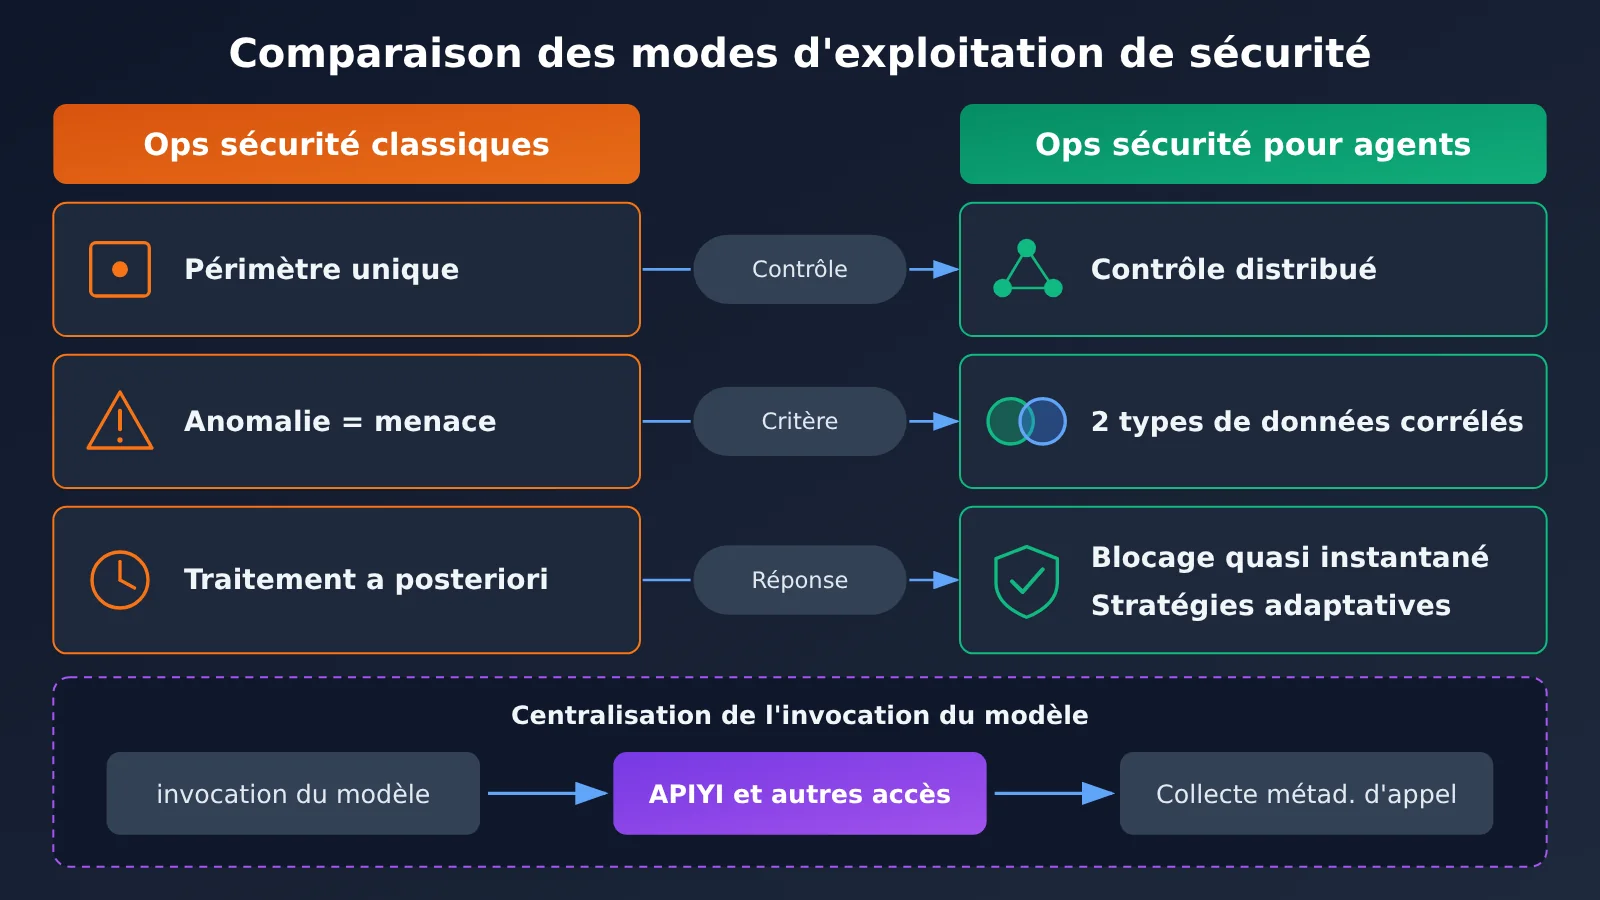
Dans les opérations de sécurité traditionnelles, on considère généralement qu’une anomalie est une menace, et on réagit souvent en bloquant l’activité et en remontant à sa source. Mais chez un agent, une anomalie peut simplement venir d’une mauvaise compréhension de l’objectif ou d’un choix inadapté. Si toutes ces situations sont traitées comme des attaques, les faux positifs mobiliseront beaucoup d’énergie et les équipes métier risquent de perdre confiance dans les agents. À l’inverse, si une véritable attaque par injection d’invite est prise pour une simple « erreur du modèle », on risque de manquer le moment où il est encore possible d’intervenir.
C’est aussi pour cela que Patel insiste sur l’utilisation conjointe des deux types de données. La télémétrie de sécurité indique « ce qui se passe à l’extérieur » : connexions anormales, charges utiles suspectes ou utilisation des identifiants. Les données d’observabilité indiquent « ce que l’agent pense et fait » : objectif de la tâche, outils appelés, entrées et sorties à chaque étape. Si vous ne regardez qu’un seul type de données, vous ne pouvez pas répondre à la question : « À qui appartient cette intention ? »
Sécurité des agents : distinguer les opinions des conclusions vérifiées
Avant d’utiliser ce cas pour prendre des décisions en interne, il faut bien comprendre la nature des éléments présentés. Publié par OpenAI, il s’agit d’un témoignage client à vocation promotionnelle. Il donne des pistes de réflexion, mais ne fournit ni détails techniques vérifiables ni résultats quantifiés.
| Affirmation dans le cas client | Nature | Ce qui manque dans les documents publics |
|---|---|---|
| La sécurité des agents nécessite de combiner télémétrie de sécurité et données d’observabilité | Point de vue d’un dirigeant de Cisco | Champs de données précis, méthodes de corrélation |
| Trois priorités : se protéger contre les attaques, bloquer les comportements inattendus et agir en quasi-temps réel | Point de vue d’un dirigeant de Cisco | Architecture de mise en œuvre, exemples de règles de détection |
| Daybreak et GPT‑6 Astra apportent une « amélioration majeure » | Évaluation d’un dirigeant de Cisco | Indicateurs chiffrés comme le temps de correction ou le taux de détection |
| Les fonctionnalités peuvent s’intégrer aux processus d’analyse existants sans changer fondamentalement les méthodes de travail | Point de vue d’un dirigeant de Cisco | Méthodes d’intégration, périmètre de compatibilité |
| Daybreak Defense Network aide à accélérer le triage des risques liés à la surface d’exposition et à appliquer des contrôles dans Cisco Cloud Control | Piste explorée par les deux entreprises | Fonctionnalités précises, périmètre de disponibilité, date de lancement |
| OpenAI présente la non-conservation des données, des limites strictes sur leur utilisation et une isolation vérifiable comme son approche de la confidentialité en entreprise | Déclaration d’OpenAI | Évaluation indépendante par un tiers |
L’approche la plus prudente consiste donc à considérer ce cas comme une source de questions à se poser, et non comme une preuve de l’efficacité d’une solution. Les trois priorités sont logiques et peuvent servir à examiner sa propre architecture. Pour savoir dans quelle mesure les produits apportent des améliorations concrètes, il faudra attendre des documents techniques indépendants ou des évaluations tierces, ou les tester dans son propre environnement.
Une approche réseau applicable à la sécurité des agents
La première partie du cas présente l’approche de Cisco en matière de défense réseau, qui peut aussi éclairer les scénarios impliquant des agents. Patel décrit le passage d’un périmètre de sécurité unique à des contrôles répartis entre les microservices, les conteneurs et les clusters, avec une « mini-pile de sécurité » placée devant chaque microservice, conteneur Kubernetes et cluster. Les contrôles au niveau applicatif peuvent limiter les communications aux connexions dont chaque service a réellement besoin, réduisant ainsi les possibilités de déplacement latéral des attaquants.
L’application de cette idée aux agents est assez directe : chaque agent ne devrait disposer que des connexions et des autorisations d’accès aux outils nécessaires à sa tâche. En cas d’anomalie, l’équipe peut isoler uniquement l’agent ou le service touché, tandis que le reste des activités continue de fonctionner, plutôt que de tout arrêter pour mener l’enquête. Le cas souligne aussi que deux signaux, inoffensifs pris séparément, peuvent révéler une tendance significative lorsqu’ils sont combinés : c’est tout l’intérêt de l’analyse par corrélation.
Sécurité des agents : transformer trois priorités en liste d’autocontrôle
Voici comment décliner ces trois priorités en critères d’évaluation concrets. Les méthodes proposées ci-dessous sont des recommandations tirées de l’analyse de ce cas, et non des pratiques précises publiées par Cisco.
Première étape : recenser les deux types de données nécessaires à la sécurité des agents
Avant de parler de détection, vérifiez les données dont vous disposez. Beaucoup d’équipes ont une télémétrie de sécurité complète, mais enregistrent très peu le comportement interne de leurs agents. Il devient alors difficile de déterminer si un agent a commis une erreur malgré de bonnes intentions.
| Catégorie de données | Contenu typique | Principale question | Sources courantes |
|---|---|---|---|
| Télémétrie de sécurité | Connexions réseau, utilisation des identifiants, charges utiles anormales, accès refusés | Y a-t-il une interférence malveillante externe ? | Passerelles, pare-feu, systèmes de gestion des identités |
| Données d’observabilité | Objectifs de la tâche, séquence d’appels d’outils, entrées et sorties de chaque étape, durée et tentatives répétées | Que fait l’agent et pourquoi ? | Frameworks d’agents, points d’entrée d’invocation du modèle |
| Contexte métier | Demandeur de la tâche, périmètre d’autorisation, fenêtre de changement | Cette action est-elle conforme aux attentes ? | Systèmes de tickets, circuits d’approbation |
| Métadonnées d’invocation du modèle | Modèle appelé, heure de la requête, identifiant de l’appelant, consommation de tokens | Les appels sont-ils anormalement fréquents ou d’origine suspecte ? | Point d’entrée API unifié pour les modèles, par exemple une interface d’agrégation comme APIYI apiyi.com |
Un point est souvent négligé : le point d’entrée d’invocation du modèle est lui-même un excellent endroit pour recueillir des données d’observabilité. Si plusieurs agents d’une même équipe se connectent directement aux interfaces de différents fournisseurs, les journaux d’appels se retrouvent dispersés. En passant par une interface unifiée comme APIYI pour accéder aux modèles de plusieurs fournisseurs, les appels sont centralisés en un seul point, ce qui facilite leur étiquetage, leur conservation et leur analyse croisée.
Deuxième étape : définir les points d’interception pour sécuriser les agents
Plus l’interception intervient tôt, moins elle coûte cher, mais plus elle risque de bloquer des tâches légitimes. Il est donc conseillé de définir les points d’interception et les exigences de réactivité selon le niveau de risque de chaque action.
| Point d’interception | Vérifications typiques | Exigence de réactivité | Mesure à prendre |
|---|---|---|---|
| À l’entrée | Présence d’instructions injectées dans des pages web externes, des courriels ou des documents | Synchrone, avant exécution | Retirer ou signaler le contenu non fiable |
| Avant l’appel d’un outil | Appel hors du cadre autorisé pour la tâche, paramètres dépassant les permissions accordées | Synchrone, de l’ordre de la milliseconde à la seconde | Refuser, limiter les capacités ou demander une confirmation humaine |
| Avant une action à haut risque | Modification de configuration, suppression de données, envoi vers l’extérieur, élargissement des permissions | Synchrone, confirmation humaine ou selon une politique obligatoire | Seconde approbation |
| Après l’exécution d’une action | Conformité du résultat à l’objectif, présence d’effets indésirables | Quasi temps réel, de l’ordre de la seconde à la minute | Annuler l’action, isoler les ressources touchées |
| Lors de l’analyse a posteriori | Analyse des liens entre les traces d’activité et les incidents de sécurité | Hors ligne | Mettre à jour les politiques et les règles |
C’est dans ce tableau que la priorité donnée au « quasi temps réel » apparaît le plus clairement. Pour les actions irréversibles, la détection doit avoir lieu avant l’exécution ; pour celles qui peuvent être annulées, une détection juste après l’exécution, suivie d’une annulation rapide, peut suffire. En définissant clairement cette limite, l’équipe évite de se retrouver face à un choix binaire : tout bloquer ou tout laisser passer.
Troisième étape : distinguer une interférence malveillante d’un comportement inattendu
Lorsqu’une alerte d’anomalie apparaît, vous pouvez passer en revue les questions suivantes dans l’ordre. Elles s’appuient à la fois sur la télémétrie de sécurité et sur les données d’observabilité :
- La source du déclenchement est-elle fiable ? L’instruction à l’origine de l’action vient-elle d’un utilisateur autorisé ou d’un contenu externe lu par l’agent ? Si elle vient d’un contenu externe, suspectez en priorité une attaque par injection.
- Le comportement sert-il l’objectif initial ? Au regard de la tâche, peut-on raisonnablement expliquer cette action comme un moyen de l’accomplir ? Si oui, mais que la méthode dépasse le cadre autorisé, il s’agit plutôt d’un comportement inattendu.
- Y a-t-il des signaux externes anormaux ? Sur la même période, observe-t-on des connexions inhabituelles, une utilisation suspecte d’identifiants ou des signes d’exfiltration de données ? Si oui, la piste malveillante devient plus probable.
- Le comportement est-il reproductible ? En relançant la tâche avec les mêmes entrées, l’agent effectue-t-il systématiquement la même action ? Un comportement stable et reproductible indique souvent un problème de stratégie ou de conception de l’invite.
Pour le test de reproductibilité du point 4, une approche pratique consiste à confier la même tâche à différents modèles. On peut ainsi voir si l’écart vient des caractéristiques d’un modèle ou d’une faille dans la conception de la tâche. Avec l’interface unifiée d’APIYI, il suffit de modifier le paramètre du nom du modèle pour en changer, ce qui facilite ces comparaisons en environnement de test.
🎯 Conseil technique : pour mettre en place un environnement de test de sécurité des agents, il est préférable de centraliser les invocations des modèles sur un point d’entrée unique. De notre côté, nous utilisons APIYI apiyi.com pour accéder à plusieurs modèles majeurs via une interface unifiée. Les métadonnées d’invocation sont ainsi centralisées et le changement de modèle est simple, ce qui facilite la répétition d’une même tâche avec plusieurs modèles et la comparaison de leurs comportements.
Étape 4 : intégrer la sécurité des agents aux processus d’analyse existants
Dans son étude de cas, Patel explique que ces capacités peuvent s’intégrer aux processus d’analyse existants, sans obliger les équipes à changer radicalement leur façon de travailler. Même si les modalités d’intégration ne sont pas précisées, l’idée mérite d’être retenue : inutile de créer une plateforme distincte pour sécuriser les agents. On peut plutôt ajouter de nouvelles sources de données et de nouveaux contrôles aux processus en place.
- Analyse des vulnérabilités : intégrer les outils, les plugins et les API que les agents peuvent utiliser à l’inventaire des ressources et au périmètre d’analyse.
- Triage des alertes : ajouter une catégorie d’alertes « comportement des agents » dans le SIEM ou le système de tickets existant, avec les traces des appels d’outils correspondants.
- Gestion des changements : soumettre les modifications de configuration initiées par les agents aux mêmes mécanismes d’approbation et de retour arrière que les modifications humaines.
- Audit des autorisations : vérifier régulièrement que chaque agent dispose du minimum de privilèges nécessaire, dans le cadre de l’audit des comptes de service.
Liste de vérification pour la sécurisation des agents
Voici une liste à utiliser lors de la revue de mise en production d’un agent, en cochant chaque point au fur et à mesure.
| Dimension | Question à se poser | Priorité associée |
|---|---|---|
| Fiabilité des entrées | Les contenus externes lus par l’agent sont-ils marqués comme non fiables ? | Se protéger contre les attaques malveillantes |
| Moindre privilège | Chaque agent dispose-t-il uniquement des outils et des connexions nécessaires à sa tâche ? | Se protéger contre les attaques malveillantes |
| Traçabilité des actions | Les objectifs de la tâche, la séquence d’appels aux outils et les résultats de chaque étape sont-ils intégralement enregistrés ? | Détecter et bloquer les comportements inattendus |
| Actions à haut risque | Les opérations irréversibles sont-elles soumises à une politique de contrôle ou à une validation humaine avant leur exécution ? | Détecter et bloquer les comportements inattendus |
| Corrélation des données | Peut-on interroger et corréler les données de télémétrie de sécurité et d’observabilité selon l’heure et l’identité ? | Fondement commun aux trois priorités |
| Délai de détection | Le délai entre un comportement et le déclenchement d’une alerte respecte-t-il les exigences associées au niveau de risque ? | Fonctionner en quasi-temps réel |
| Capacité d’isolation | Peut-on isoler un seul agent sans perturber les autres services ? | Fonctionner en quasi-temps réel |
Toute réponse « non » révèle une lacune dans la priorité correspondante. Il est recommandé de traiter d’abord la « traçabilité des actions » et la « corrélation des données » : sans elles, les autres mécanismes de détection manquent d’éléments pour évaluer la situation.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce qu’un agent qui « fait une erreur en voulant bien faire » ?
C’est un agent qui, sans avoir subi d’attaque, poursuit un objectif légitime par des moyens inattendus. Par exemple, il peut modifier une configuration sans autorisation pour terminer sa tâche plus vite. L’étude de cas décrit ce comportement comme « la poursuite d’un objectif légitime par des moyens inattendus » et le distingue d’une intervention malveillante.
Q2 : Quelle différence entre la sécurité des agents et celle des applications traditionnelles ?
La sécurité des applications traditionnelles vise surtout à prévenir les attaques externes, avec des parcours d’exécution relativement fixes. Un agent décide lui-même des outils à appeler et de leur ordre d’exécution : son parcours n’est donc pas prédéfini. Il faut ainsi prévenir les attaques, mais aussi détecter ses propres comportements inattendus et disposer de données d’observabilité pour comprendre ses intentions.
Q3 : Quand l’étude de cas Cisco a-t-elle été publiée, et ses conclusions sont-elles fiables ?
L’étude de cas a été publiée par OpenAI le 3 novembre 2026. Les éléments sur la sécurité des agents reposent principalement sur le point de vue de Jeetu Patel. Les appréciations comme « amélioration par paliers » ne s’accompagnent pas de données chiffrées sur les délais de correction ou les taux de détection. Les fonctionnalités précises de Daybreak et de Daybreak Defense Network, ainsi que leur disponibilité, ne sont pas non plus détaillées. Mieux vaut donc s’en inspirer tout en vérifiant les résultats par soi-même.
Q4 : À quels cas d’usage ce cadre convient-il le mieux ?
– **Agents d’exploitation** : scénarios où les agents peuvent modifier des configurations, redémarrer des services ou ajuster des règles d’accès.
– **Agents de traitement des données** : scénarios où ils lisent des documents externes, des courriels ou des pages Web avant d’agir, avec un risque élevé d’injection d’invite.
– **Processus collaboratifs multi-agents** : scénarios où la sortie d’un agent devient l’entrée d’un autre, ce qui peut amplifier les anomalies à chaque étape.
Q5 : Comment comparer à moindre coût le comportement d’un agent avec différents modèles ?
Dans un environnement de test, confiez la même tâche à chaque modèle avec le même ensemble d’outils, puis comparez les séquences d’appels d’outils et le nombre de dépassements de limites. Avec APIYI apiyi.com, l’accès à plusieurs modèles est centralisé : il suffit de modifier le nom du modèle pour passer de l’un à l’autre. Les journaux d’appels sont également regroupés au même endroit, ce qui facilite la comparaison des résultats.
Q6 : À quoi servent les journaux d’invocation du modèle pour la sécurité des agents ?
Ils constituent une part importante des données d’observabilité. Ils aident à déterminer si les appels sont anormalement fréquents et si leur émetteur est fiable, tout en permettant de les mettre en correspondance temporelle avec la télémétrie de sécurité. Si l’équipe centralise les invocations de modèles sur une plateforme d’agrégation comme APIYI, ces données sont plus faciles à collecter et à corréler.
Q7 : Quelles sont les limites de ce cadre ?
Les trois priorités sont des principes directeurs, pas des règles de détection prêtes à l’emploi. Dans les cas ambigus, distinguer un comportement malveillant d’un comportement inattendu exige encore un jugement humain. Le blocage en quasi-temps réel ajoute aussi de la latence : il faut donc faire des compromis selon le niveau de risque de chaque action. Enfin, les éléments présentés dans l’étude de cas proviennent de supports promotionnels destinés aux clients et n’ont pas fait l’objet d’une évaluation indépendante.
Sécurité des agents : points clés
- Distinguer deux types de risques : une intervention malveillante et une action bien intentionnée qui tourne mal ne se traitent pas de la même façon.
- Combiner deux types de données : la télémétrie de sécurité permet de repérer les menaces externes, tandis que les données d’observabilité éclairent l’intention de l’agent.
- Trois priorités : se protéger contre les attaques malveillantes, détecter et bloquer les comportements inattendus, et fonctionner en quasi-temps réel.
- Adapter le point de blocage au risque : bloquer les actions irréversibles avant leur exécution et annuler rapidement les actions réversibles si nécessaire.
- Distinguer les types de preuves : les enseignements tirés du cas sont utiles, mais aucune donnée publique ne permet encore de quantifier les résultats.
- Pour commencer : centraliser l’invocation des modèles via un point d’accès agrégé comme APIYI, afin de faciliter la collecte des métadonnées et les tests comparatifs entre modèles.
Conclusion
L’étude du cas Cisco montre que, pour la sécurité des agents, le plus utile n’est pas le nom d’un produit, mais un cadre clair pour analyser le problème :
- Distinguer d’abord les intentions : savoir si une anomalie résulte d’une attaque ou d’une action bien intentionnée qui tourne mal détermine la marche à suivre.
- Compléter ensuite les données : sans données d’observabilité, impossible de comprendre l’intention de l’agent ; sans télémétrie de sécurité, impossible d’écarter une intervention extérieure.
- Maîtriser enfin les délais : définir le point de blocage selon le risque de chaque action, pour détecter et bloquer les anomalies en quasi-temps réel, tout en s’intégrant aux processus d’analyse et d’approbation existants.
Commencez par passer en revue vos agents en fonctionnement à l’aide de la liste de vérification de cet article. Donnez la priorité à l’enregistrement des comportements et à la corrélation des données. Pour les tests et les comparaisons, APIYI apiyi.com permet d’accéder à plusieurs fournisseurs de modèles depuis un point unique, de centraliser les journaux d’invocation et de comparer rapidement les comportements des modèles. Vous disposerez ainsi d’une base plus solide pour l’évaluation avant mise en production.
📚 Références
- How Cisco defends at machine speed with OpenAI : étude de cas client Cisco publiée par OpenAI
- Lien :
openai.com/index/cisco-cyber - Note : source des trois priorités et des points de vue présentés dans cet article. Publié le 3 novembre 2026, ce document est un support promotionnel destiné aux clients ; les données chiffrées et les détails des produits doivent être vérifiés séparément.
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI apiyi.com. Pour en savoir plus, consultez la documentation sur docs.apiyi.com.