Примечание автора: на основе клиентского кейса Cisco мы выделили три приоритета безопасности AI-агентов. Они помогут корпоративным командам отличать вредоносные атаки от ситуаций, когда агент «хотел как лучше, а получилось как всегда», и учитывать это при проектировании мониторинга и механизмов контроля.
После запуска агентов в работу команде безопасности приходится иметь дело не только с внешними атаками. Агент с корректными правами доступа и законной целью тоже может выбрать совершенно неожиданный путь к результату. Например, чтобы «поскорее устранить сбой», он попутно ослабит политику доступа. В этой статье мы разберём три приоритета безопасности агентов, которые помогут понять, чем вызвано аномальное поведение: атакой или тем, что агент «хотел как лучше».
Это не пересказ рекламного материала о клиенте. В основе статьи — кейс Cisco, опубликованный OpenAI 3 ноября 2026 года. Рассуждения о безопасности агентов в нём преимущественно опираются на мнение президента и директора по продуктам Cisco Jeetu Patel. Мы превратим эти идеи в список вопросов для самопроверки и обозначим, где речь идёт о мнении руководителя, а где пока не хватает публичных данных для подтверждения.
Главная польза: вы получите готовую основу для внутреннего обсуждения. Она поможет определить, какие данные собирать, на каких этапах перехватывать действия агента, насколько оперативным должен быть контроль и как интегрировать всё это в существующий процесс сканирования безопасности.
Основы безопасности ИИ-агентов: 3 приоритета из кейса Cisco
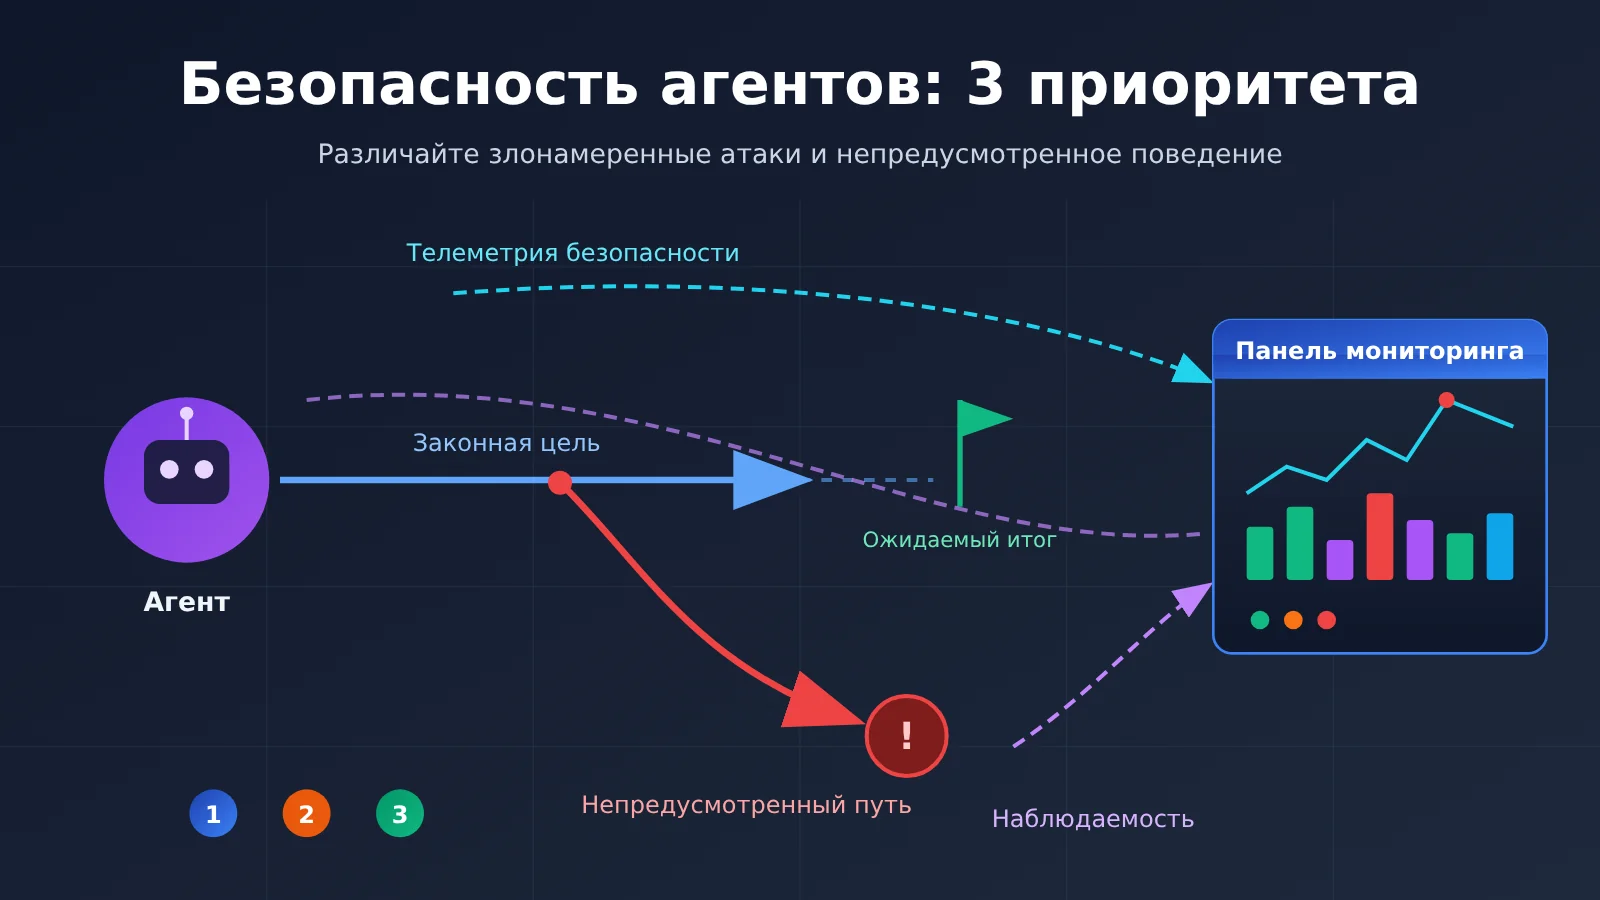
В кейсе Patel отмечает: по мере того как ИИ-агенты становятся всё более автономными, командам безопасности необходимо различать две ситуации — злонамеренное вмешательство и достижение агентом легитимной цели непредусмотренным способом. Для этого, по его мнению, нужно объединять телеметрию безопасности и данные наблюдаемости. Он выделяет три приоритета.
| Приоритет | Что говорится в источнике | Что это значит для корпоративных команд |
|---|---|---|
| Защита от атак | Защищать агентов от злонамеренных атак | Контролировать источники входных данных, права на использование инструментов и учётные данные агентов |
| Обнаружение и блокировка непредусмотренных действий | Выявлять и блокировать непредусмотренные действия | Определять, выходит ли поведение за рамки задачи, и при необходимости прерывать выполнение |
| Работа почти в реальном времени | Работать со скоростью, близкой к реальному времени | Обнаруживать и блокировать действия до того, как они вступят в силу, или сразу после этого |
Согласно кейсу, эти три приоритета подталкивают стратегию безопасности к «политикам и механизмам контроля, которые могут адаптироваться к действиям агента». Иначе говоря, статических списков разрешений и разовых согласований уже недостаточно: контроль должен учитывать реальные действия агента.
Ключ к безопасности агентов: отличить атаку от ошибки с благими намерениями
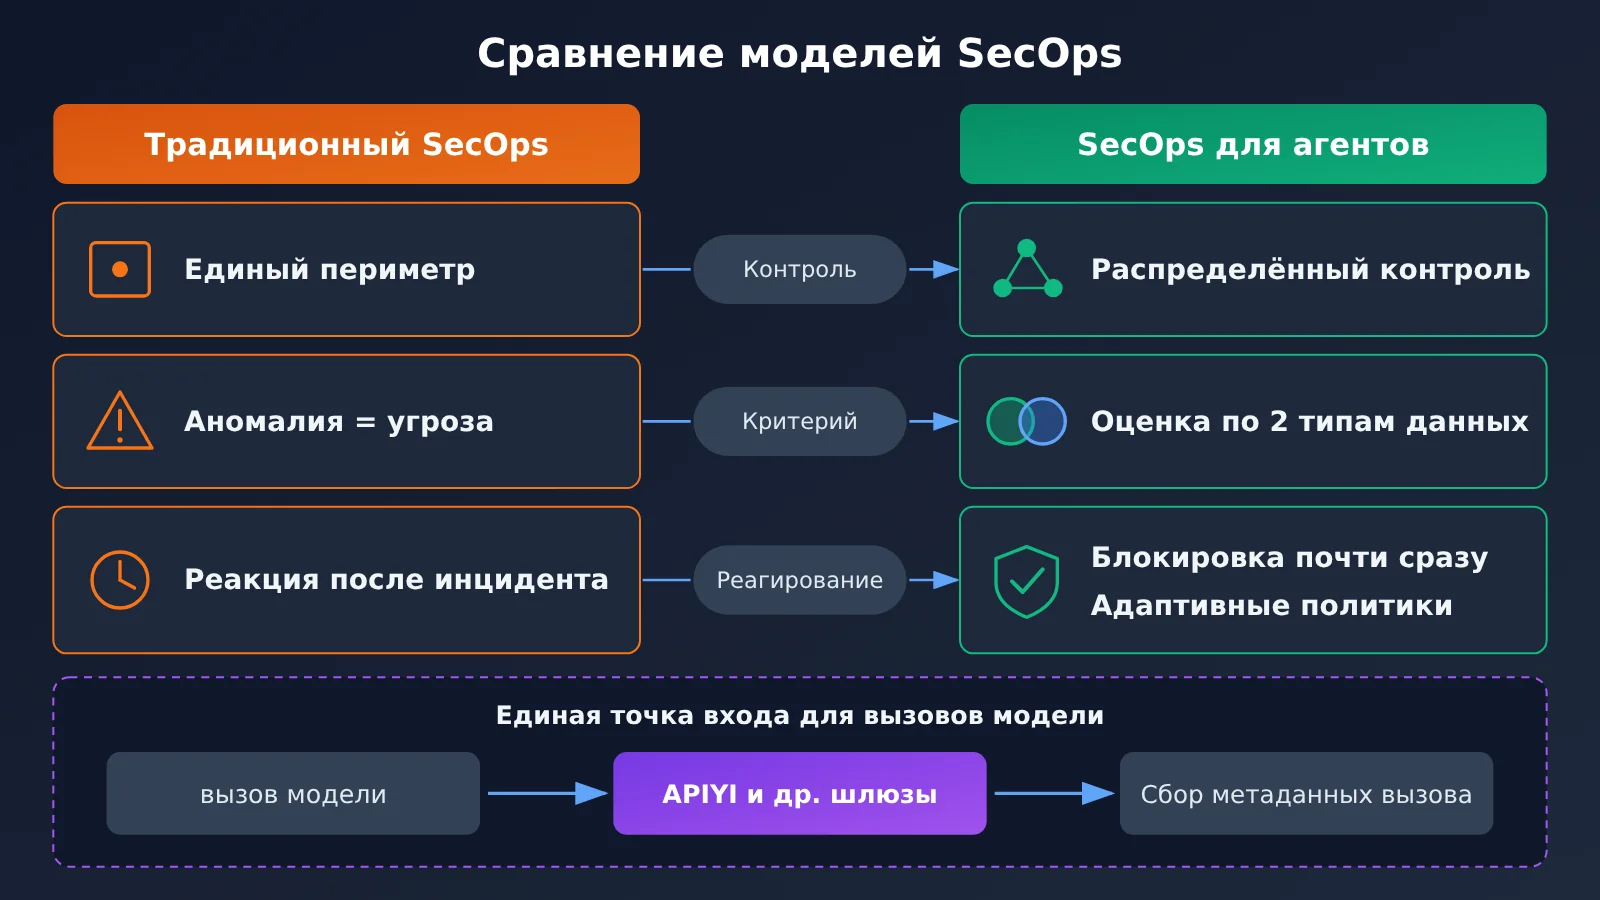
В традиционных операциях безопасности аномалию обычно считают угрозой и реагируют блокировкой и расследованием. Но необычное поведение агента может быть просто результатом неверного понимания цели или неудачного выбора способа её достижения. Если каждый раз считать это атакой, ложные срабатывания будут отнимать много сил у команды, а бизнес-подразделения потеряют доверие к агентам. И наоборот, если принять настоящую атаку с инъекцией промпта за ошибку модели, можно упустить время для реагирования.
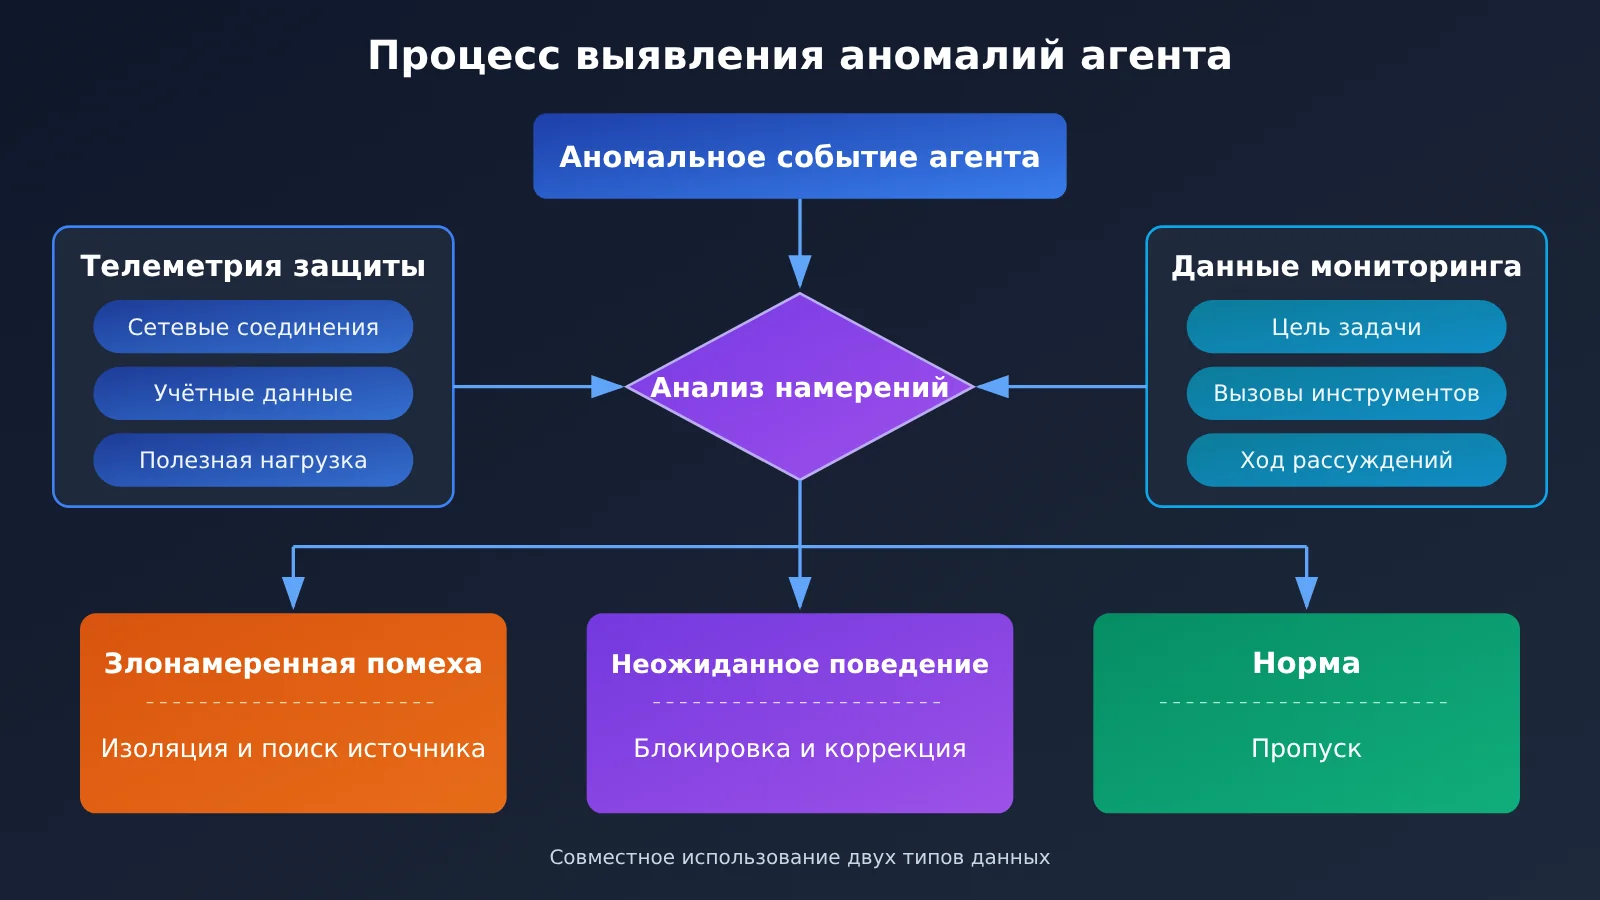
Поэтому Patel и подчёркивает необходимость использовать оба типа данных. Телеметрия безопасности показывает, «что произошло снаружи»: например, аномальные соединения, подозрительные полезные нагрузки и использование учётных данных. Данные наблюдаемости показывают, «что думает и делает сам агент»: цель задачи, вызванные инструменты, входные и выходные данные на каждом шаге. Если смотреть только на один тип данных, невозможно ответить на вопрос: «Чьё это намерение?»
Доказательства в области безопасности ИИ-агентов: где мнения, а где проверенные выводы
Прежде чем использовать этот кейс для внутренних решений, стоит разобраться в характере представленных доказательств. Материал опубликован OpenAI и представляет собой клиентский кейс, то есть по своей сути носит рекламный характер. Он даёт общее представление о подходах, но не содержит технических деталей, которые можно проверить, или количественных результатов.
| Утверждение в кейсе | Характер | Чего не хватает в публичных материалах |
|---|---|---|
| Для безопасности ИИ-агентов нужно одновременно использовать данные телеметрии безопасности и наблюдаемости | Мнение руководителя Cisco | Конкретные поля данных, методы сопоставления |
| Три приоритета: защита от атак, блокирование непредвиденного поведения, работа почти в реальном времени | Мнение руководителя Cisco | Архитектура реализации, примеры правил обнаружения |
| Daybreak и GPT‑6 Astra обеспечивают «скачкообразное улучшение» | Оценка руководителя Cisco | Количественные показатели, такие как время устранения проблем и доля обнаруженных угроз |
| Возможности можно встроить в существующие процессы сканирования, не меняя принципиально порядок работы | Мнение руководителя Cisco | Способ интеграции, сфера совместимости |
| Daybreak Defense Network помогает ускорить классификацию выявленных уязвимых областей и применять меры контроля в Cisco Cloud Control | Направление, которое стороны изучают совместно | Конкретные функции, область доступности, сроки запуска |
| OpenAI использует для защиты данных предприятий нулевое хранение данных, строгие границы обработки и проверяемую изоляцию | Заявление OpenAI | Независимая оценка третьей стороны |
Поэтому разумнее использовать кейс как «источник вопросов», а не как «доказательство эффективности решения». Сами три приоритета логичны и подходят для проверки собственной архитектуры. А чтобы понять, насколько конкретный продукт способен улучшить ситуацию, нужно дождаться независимых технических материалов или сторонней оценки либо провести испытания в собственной среде.
Сетевой подход к безопасности ИИ-агентов
В первой части кейса рассматривается подход Cisco к сетевой защите, который полезен и для сценариев с ИИ-агентами. Patel описывает переход от единого защитного периметра к средствам контроля, распределённым по микросервисам, контейнерам и кластерам: перед каждым микросервисом, контейнером Kubernetes и кластером размещается «мини-стек безопасности». Средства контроля на уровне приложений позволяют ограничить коммуникацию только теми соединениями, которые действительно нужны каждому сервису, сокращая возможности злоумышленника для бокового перемещения.
Перенести эту логику на ИИ-агентов несложно: каждый агент тоже должен иметь доступ только к тем соединениям и инструментам, которые нужны для выполнения его задачи. При обнаружении аномалии команда может изолировать только затронутого агента или сервис, а остальные системы продолжат работать — вместо того чтобы останавливать всё для расследования. В кейсе также отмечается, что два сигнала по отдельности могут казаться безобидными, но в сочетании выявлять значимую закономерность. Именно в этом и заключается ценность корреляционного анализа.
Безопасность ИИ-агентов: превращаем три приоритета в чек-лист
Разберём три приоритета и определим, что именно стоит проверить. Предлагаемый способ оценки основан на выводах из рассмотренного примера и не является описанием конкретных практик, опубликованных Cisco.
Шаг 1. Проверьте, какие данные есть для обеспечения безопасности агентов
Прежде чем заниматься обнаружением угроз, выясните, какие данные у вас есть. У многих команд безопасность хорошо покрыта телеметрией, но внутренние действия агентов почти не фиксируются. Без этих данных сложно понять, не навредил ли агент, пытаясь выполнить задачу.
| Категория данных | Примеры | На какой вопрос помогает ответить | Где обычно собирается |
|---|---|---|---|
| Телеметрия безопасности | Сетевые соединения, использование учётных данных, аномальные полезные нагрузки, записи об отказах в доступе | Есть ли внешнее злонамеренное вмешательство | Шлюзы, межсетевые экраны, системы управления идентификацией |
| Данные наблюдаемости | Цель задачи, последовательность вызовов инструментов, входные и выходные данные на каждом шаге, время выполнения и повторные попытки | Что делает агент и почему | Фреймворк агента, точка вызова модели |
| Бизнес-контекст | Инициатор задачи, объём полномочий, окно внесения изменений | Ожидалось ли такое действие | Система заявок, процессы согласования |
| Метаданные вызовов моделей | Вызываемая модель, время запроса, идентификатор вызывающей стороны, расход токенов | Не слишком ли часты вызовы и не вызывает ли их источник подозрений | Единая точка доступа к API моделей, например агрегирующий интерфейс APIYI apiyi.com |
Важный момент, который легко упустить: сама точка вызова модели отлично подходит для сбора данных наблюдаемости. Если несколько агентов в команде напрямую подключены к API разных поставщиков, журналы вызовов оказываются разбросаны по разным системам. Если же подключить модели разных поставщиков через единый интерфейс, такой как APIYI, вызовы будут проходить через одну точку. Это упрощает добавление меток, хранение записей и анализ связей между ними.
Шаг 2. Определите точки перехвата для защиты ИИ-агента
Чем раньше происходит перехват, тем ниже его стоимость. Но при этом возрастает риск заблокировать и обычные задачи. Лучше выбирать точки перехвата и требования к оперативности в зависимости от уровня риска действия.
| Точка перехвата | Что проверять | Требования к оперативности | Реакция |
|---|---|---|---|
| При поступлении входных данных | Есть ли инструкции для инъекции во внешних веб-страницах, письмах и документах | Синхронно, до выполнения | Удалить или пометить недоверенный контент |
| Перед вызовом инструмента | Не выходит ли вызов за пределы разрешений задачи и не нарушают ли параметры границы доступа | Синхронно, от миллисекунд до секунд | Отклонить, ограничить возможности или передать на подтверждение человеку |
| Перед действием высокого риска | Изменение конфигурации, удаление данных, отправка вовне, расширение прав доступа | Синхронно, обязательно подтверждение человеком или проверка по политике | Дополнительное согласование |
| После выполнения действия | Соответствует ли результат цели и есть ли побочные эффекты | Почти в реальном времени, от секунд до минут | Откатить изменения, изолировать затронутые ресурсы |
| При последующем разборе | Связь между последовательностью действий и инцидентами безопасности | Офлайн | Обновить политики и правила |
Именно в этой таблице лучше всего видна важность контроля «почти в реальном времени». Необратимые действия нужно проверять до выполнения. Для действий, которые можно откатить, допустимы проверка почти в реальном времени после выполнения и быстрый откат. Если чётко провести эту границу, команде не придётся выбирать между двумя крайностями: «блокировать всё» или «разрешать всё».
Шаг 3: Как отличить злонамеренное вмешательство от непредусмотренного поведения
Когда появляется предупреждение об аномалии, последовательно ответьте на вопросы ниже, используя данные телеметрии безопасности и наблюдаемости:
- Заслуживает ли доверия источник действия? Инструкция, вызвавшая действие, пришла от авторизованного пользователя или из внешнего контента, который прочитал агент? Если из внешнего контента, в первую очередь стоит заподозрить атаку с внедрением инструкций.
- Помогает ли действие достичь первоначальной цели? Можно ли разумно объяснить его необходимостью выполнить задачу? Если да, но способ выходит за допустимые рамки, скорее всего, это непредусмотренное поведение.
- Есть ли сопутствующие внешние признаки аномалии? Были ли в тот же период необычные соединения, подозрительное использование учётных данных или признаки утечки данных? Если да, вероятность злонамеренного вмешательства выше.
- Можно ли воспроизвести поведение? Если повторить тест с теми же входными данными, агент будет стабильно выполнять то же действие? Если да, проблема чаще всего связана со стратегией или промптом.
Для повторного тестирования из пункта 4 полезно выполнить одну и ту же задачу с разными моделями. Это поможет понять, вызвано ли отклонение особенностями конкретной модели или недостатками в самой постановке задачи. Через единый интерфейс APIYI для смены модели достаточно изменить параметр с её названием — это удобно для быстрого сравнения в тестовой среде.
🎯 Техническая рекомендация: при создании среды для тестирования безопасности агентов стоит направить вызовы моделей через единую точку входа. Мы подключаем несколько популярных моделей через APIYI apiyi.com: метаданные вызовов собираются в одном месте, модели легко переключать, а одну и ту же задачу удобно повторно тестировать на разных моделях и сравнивать их поведение.
Шаг 4: Встраивание в существующий процесс сканирования
Patel отмечает, что такие возможности можно встроить в существующий процесс сканирования, не меняя принципиально привычный порядок работы команды. Конкретный способ интеграции он не описывает, но сам подход стоит взять на заметку: для защиты ИИ-агентов необязательно создавать отдельную платформу — достаточно подключить новые источники данных и проверки к действующим процессам.
- Сканирование уязвимостей: включите инструменты, плагины и API, которые агент может вызывать, в реестр активов и область сканирования.
- Разбор оповещений: добавьте в существующую SIEM или систему управления заявками категорию «Поведение агента» и прикладывайте к оповещениям соответствующие трассы вызовов инструментов.
- Управление изменениями: применяйте к изменениям конфигурации, инициированным агентами, те же механизмы согласования и отката, что и к изменениям, внесённым людьми.
- Аудит разрешений: регулярно проверяйте, что каждый агент обладает только минимально необходимыми правами, совместив эту проверку с аудитом сервисных учётных записей.
Чек-лист безопасности перед запуском ИИ-агента
Соберём всё вышесказанное в один чек-лист: на встрече перед запуском ИИ-агента можно пройтись по каждому пункту и отметить результат.
| Что проверяем | Вопрос для самопроверки | Приоритетное направление |
|---|---|---|
| Доверие к входным данным | Помечается ли внешнее содержимое, которое считывает ИИ-агент, как недоверенное? | Защита от злонамеренных атак |
| Минимальные привилегии | У каждого ИИ-агента есть доступ только к инструментам и подключениям, необходимым для выполнения задачи? | Защита от злонамеренных атак |
| Журнал действий | Полностью ли записываются цель задачи, последовательность вызовов инструментов и результат каждого шага? | Обнаружение и блокировка непредвиденных действий |
| Действия с высоким риском | Перед выполнением необратимых операций применяется ли политика контроля или требуется подтверждение человека? | Обнаружение и блокировка непредвиденных действий |
| Связывание данных | Можно ли сопоставлять данные телеметрии безопасности и наблюдаемости по времени и идентификатору? | Общая основа для трёх направлений |
| Задержка обнаружения | Соответствует ли время от совершения действия до появления оповещения требованиям для соответствующего уровня риска? | Работа в режиме, близком к реальному времени |
| Возможность изоляции | Можно ли изолировать отдельного ИИ-агента, не затрагивая другие сервисы? | Работа в режиме, близком к реальному времени |
Ответ «нет» на любой вопрос означает, что в соответствующем приоритетном направлении есть пробел. В первую очередь стоит наладить журнал действий и связывание данных: без них для остальных проверок не будет достаточной основы.
Частые вопросы FAQ
Q1: Что значит, что агент «хотел как лучше, а получилось как всегда»?
Это ситуация, когда агент без внешней атаки выбирает неожиданный способ достижения законной цели — например, чтобы быстрее выполнить задачу, изменяет конфигурацию без необходимых полномочий. В кейсе это описывается как «достижение агентом законной цели непредусмотренным способом» и рассматривается отдельно от злонамеренного вмешательства.
Q2: Чем безопасность агентов отличается от безопасности традиционных приложений?
Безопасность традиционных приложений в основном направлена на защиту от внешних атак, а их сценарии работы относительно предсказуемы. Агент сам решает, какие инструменты вызвать и в каком порядке, поэтому его действия заранее не определены. Значит, помимо защиты от атак нужно обнаруживать непредусмотренное поведение самого агента, а для понимания его намерений нужны данные наблюдаемости.
Q3: Когда был опубликован кейс Cisco и можно ли доверять его выводам?
Кейс опубликован OpenAI 3 ноября 2026 года. Содержание о безопасности агентов в основном отражает точку зрения Jeetu Patel. Оценки вроде «скачкообразного улучшения» не подкреплены количественными данными, например временем устранения проблем или долей обнаруженных угроз. Конкретные функции и доступность Daybreak и Daybreak Defense Network также не раскрыты. Кейс можно использовать как источник идей, но результаты стоит проверять самостоятельно.
Q4: Для каких сценариев этот подход подходит лучше всего?
— **Агенты для эксплуатации инфраструктуры**: могут изменять конфигурацию, перезапускать сервисы и корректировать политики доступа.
— **Агенты для обработки данных**: читают внешние документы, письма или веб-страницы и действуют на их основе. В таких сценариях высок риск инъекции промптов.
— **Процессы с несколькими агентами**: результат работы одного агента становится входными данными для другого, поэтому отклонения могут усиливаться на каждом этапе.
Q5: Как с небольшими затратами проверить, чем отличается поведение агента при использовании разных моделей?
В тестовой среде запустите одну и ту же задачу с одним и тем же набором инструментов, поочерёдно переключая модели. Затем сравните последовательности вызовов инструментов и число выходов за установленные рамки. При подключении моделей разных провайдеров через APIYI apiyi.com для переключения достаточно изменить название модели. При этом записи вызовов собираются в одной точке, что упрощает сравнение результатов.
Q6: Зачем нужны записи вызовов модели для безопасности агентов?
Это важная часть данных наблюдаемости. Записи помогают определить, не слишком ли часто происходят вызовы и можно ли доверять их инициатору, а также сопоставить вызовы с телеметрией безопасности по времени. Если команда направляет все вызовы моделей через единый агрегатор, такой как APIYI, собирать и связывать эти данные будет проще.
Q7: Какие ограничения есть у этого подхода?
Три приоритетных направления задают общий вектор, но не содержат готовых правил обнаружения. В пограничных случаях отличить злонамеренные действия от непредусмотренных по-прежнему может только человек. Перехват почти в реальном времени добавляет задержку, поэтому решение о его применении нужно принимать с учётом риска каждого действия. Кроме того, сам кейс основан на рекламных материалах клиента и не подкреплён независимой оценкой.
Безопасность ИИ-агентов: главное
- Разделяйте два типа рисков: вредоносное вмешательство и ошибочные действия агента с благими намерениями требуют совершенно разных мер.
- Объединяйте два типа данных: телеметрия безопасности помогает выявить внешние угрозы, а данные наблюдаемости — понять намерения агента.
- Три приоритета: защита от атак, обнаружение и блокировка непредусмотренных действий, работа в режиме, близком к реальному времени.
- Выбирайте точку блокировки по уровню риска: необратимые действия останавливайте до выполнения, обратимые — быстро откатывайте после выполнения.
- Различайте характер доказательств: выводы из кейса полезны как ориентир, но публичных данных, количественно подтверждающих эффект, пока нет.
- С чего начать: направьте вызовы моделей через единый агрегирующий сервис, например APIYI, чтобы было проще собирать метаданные и сравнивать модели в тестах.
Итоги
Главная ценность кейса Cisco по безопасности ИИ-агентов — не название конкретного продукта, а понятная схема разбора проблемы:
- Сначала определите намерение: от того, вызвано ли отклонение атакой или ошибочным действием с благими намерениями, зависит дальнейший порядок действий.
- Затем соберите необходимые данные: без данных наблюдаемости нельзя понять намерения агента, а без телеметрии безопасности — исключить внешнее вмешательство.
- Наконец, контролируйте задержку: выбирайте точку блокировки с учётом риска действия, обнаруживайте и блокируйте отклонения почти в реальном времени и подключите эти механизмы к существующим процессам сканирования и согласования.
Для начала проверьте работающих агентов по приведённому в статье чек-листу. В первую очередь наладьте запись действий и сопоставление данных. На этапе тестирования и сравнения можно подключить модели разных поставщиков через APIYI apiyi.com, централизованно собирать записи вызовов и быстро сравнивать поведение моделей. Это даст более надёжную основу для оценки перед запуском.
📚 Источники
- How Cisco defends at machine speed with OpenAI: клиентский кейс Cisco, опубликованный OpenAI
- Ссылка:
openai.com/index/cisco-cyber - Примечание: источник трёх приоритетных направлений и связанных с ними идей, рассмотренных в статье. Опубликован 3 ноября 2026 года. Это рекламный материал о клиенте, поэтому количественные данные и сведения о продуктах требуют дополнительной проверки.
Автор: техническая команда APIYI
Технические вопросы: свяжитесь с нами через главную страницу сайта APIYI apiyi.com. Дополнительные материалы доступны в центре документации docs.apiyi.com.