Resumo: Este artigo usa o SDK Python da OpenAI para chamar a API do Tencent Hunyuan Hy4 de forma não streaming, conclui a primeira requisição de texto puro e explica como validar o resultado, estimar custos, conferir a fatura e lidar com erros comuns.
Resposta direta: A API do Tencent Hunyuan Hy4 pode ser acessada pela interface compatível com OpenAI da APIYI. Basta preparar três configurações para enviar a primeira requisição:
- Key: Crie em
api.apiyi.com/tokene coloque na variável de ambienteAPIYI_API_KEY. - SDK Base URL:
https://api.apiyi.com/v1. - ID do modelo:
hy4.
O endpoint HTTP correspondente é POST https://api.apiyi.com/v1/chat/completions. Em 21/11/2026, os preços do Hy4 na tabela de preços por milhão de tokens são: entrada sem cache hit $0.85, saída $2.55, leitura de cache $0.045. O faturamento real segue a tabela de preços da APIYI, em docs.apiyi.com/models (categoria Tencent).
A linha do tempo é a seguinte: a Tencent lançou a versão oficial do Hy4 em 4 de novembro e abriu os pesos em 20 de novembro. A APIYI já disponibilizou o modelo antes da abertura dos pesos; o anúncio de lançamento está em docs.apiyi.com/news/hy4-launch. O anúncio já traz um exemplo de streaming, então este artigo cobre apenas outras quatro coisas: chamada não streaming, validação de resultados, conferência de fatura e solução de falhas. O anúncio menciona que o Hy4 aceita entrada de imagens, mas este artigo demonstra apenas texto puro. Vídeo, a interface Responses e o Computer Use estão fora do escopo deste artigo, e o texto não contém nenhum dado de teste real.
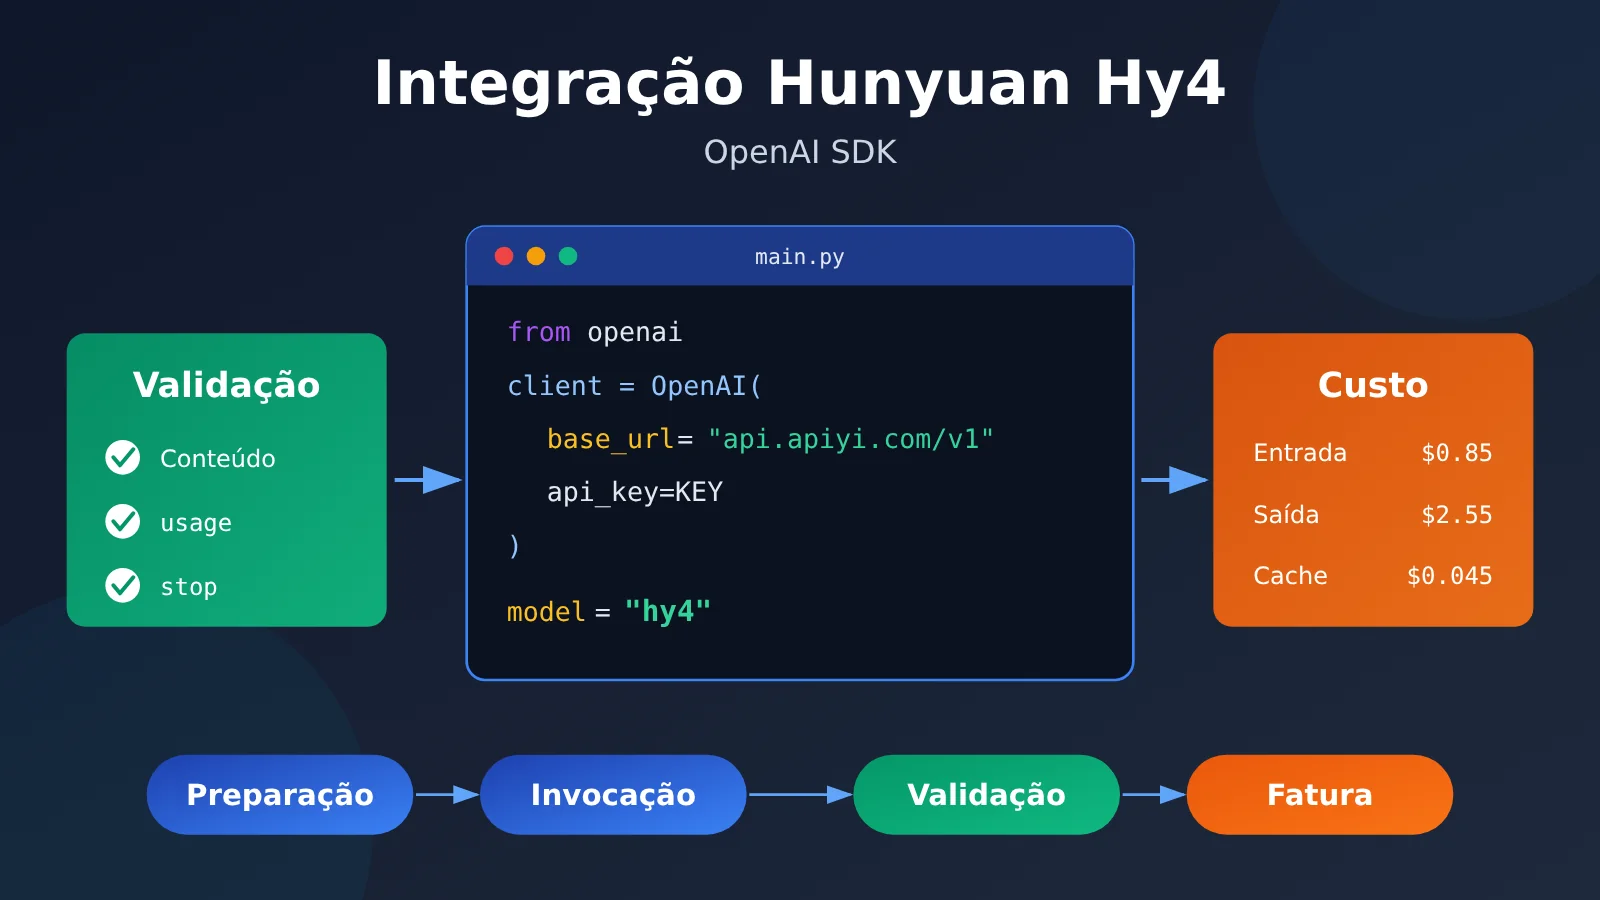
Mapa de conhecimento e ordem de leitura para a integração da API do Tencent Hunyuan Hy4
O fluxo todo tem quatro etapas, e o resultado de cada uma vira a entrada da próxima. Recomendo ler na ordem dos números. A seção 4 pode ser consultada à parte quando aparecer um erro.
| Etapa | Seção correspondente | Por que fica aqui | Critério de aceite |
|---|---|---|---|
| Preparar a requisição | 1.1, 1.2 | Se o endpoint, o nome do modelo e a Key estiverem errados, todas as etapas seguintes falham | O SDK importa, as variáveis de ambiente conseguem ler a Key e não existe Key em texto claro no código |
| Primeira invocação | 2.1, 2.2 | Primeiro use um texto curto, sem dados de cliente, só para confirmar que o caminho está funcionando | O conteúdo retornado é “产品=混元、版本=Hy4”, sem truncamento, e o usage e o request ID foram salvos |
| Conferir o consumo | 3.1, 3.2 | Só depois de o caminho estar funcionando, estimar o custo para decidir se dá para aumentar o volume de chamadas | Os valores estimados batem item por item com o log de consumo do console |
| Diagnóstico de falhas | 4 | Quando qualquer etapa falhar, localizar a causa pelo código e pelo corpo do erro | Conseguir distinguir erro de configuração, problema de permissão, rate limit e timeout, e julgar se vale tentar de novo |
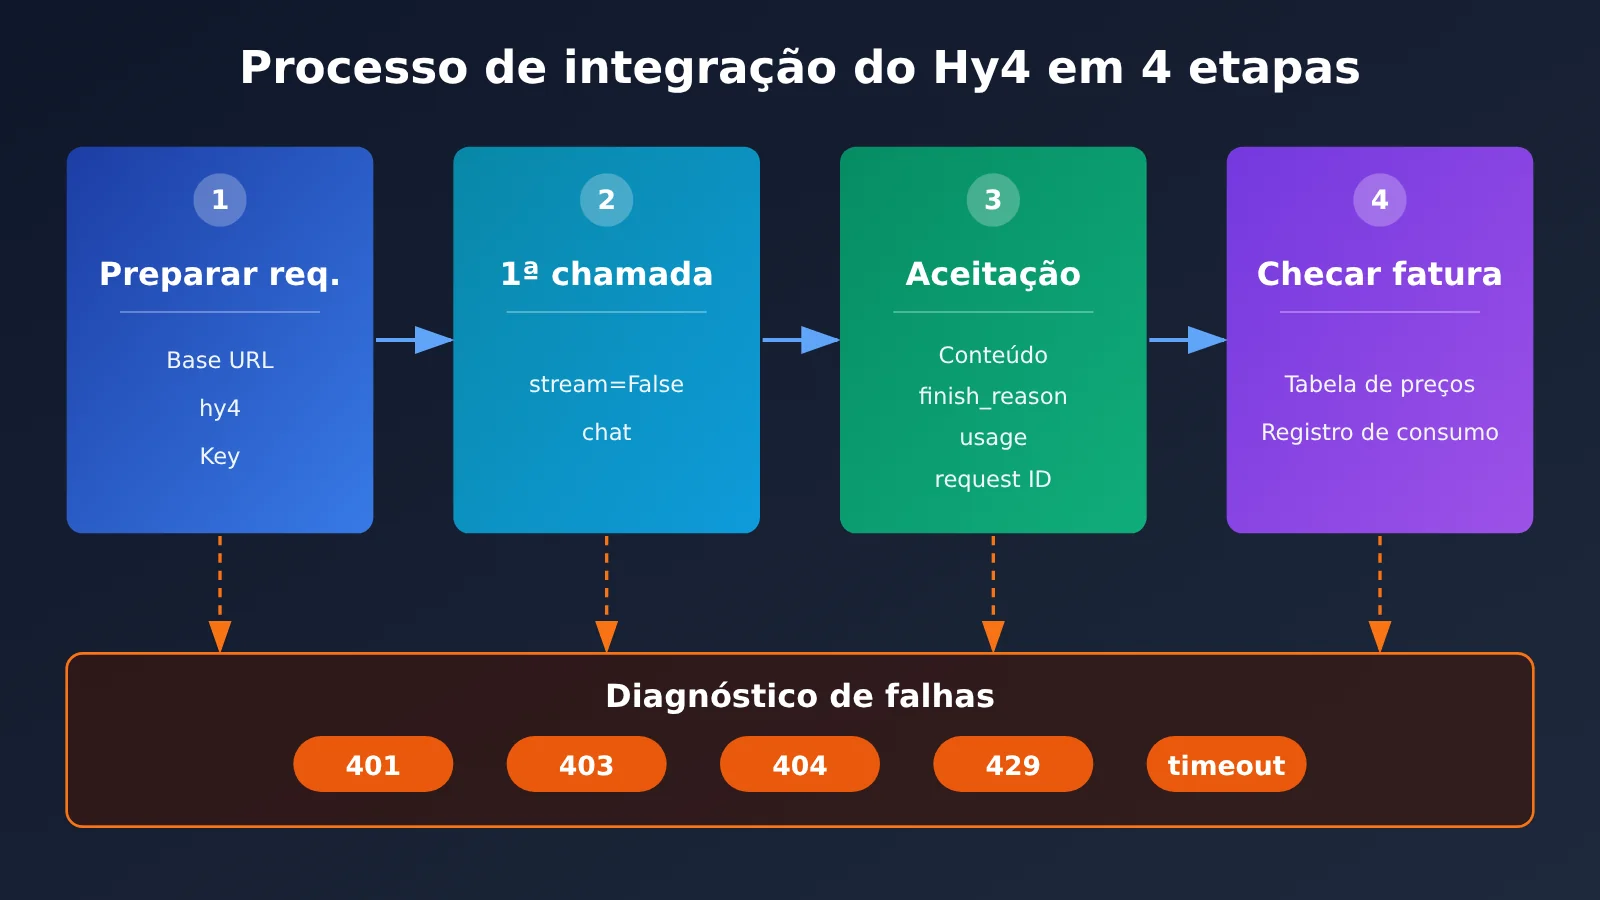
To Know: termos relacionados à API Hy4
| Termo | Explicação resumida |
|---|---|
| Não-streaming (stream=False) | O modelo retorna o resultado completo de uma vez só, depois de terminar a geração, o que facilita conferir o conteúdo e o consumo como um todo |
| finish_reason | O motivo do fim desta geração. stop indica término normal; length indica que atingiu o limite de comprimento e foi truncado |
| usage | Campo de consumo de tokens na resposta; os mais comuns são prompt_tokens (entrada) e completion_tokens (saída) |
| request ID | O identificador de uma requisição, usado para localizar essa chamada nos logs. Não vem necessariamente em toda resposta |
| Leitura de cache | A parte da entrada que acerta o cache, cobrada pelo preço específico de leitura de cache |
| Grupo (Default/SVIP) | O grupo ao qual o token pertence, que define quais modelos esse token pode chamar |
1. Preparar a requisição da API Tencent Hunyuan Hy4
1.1 Configurar o modelo Hy4 e o endpoint
Confira cada item de configuração com cuidado. A maioria das falhas na primeira invocação acontece nesta etapa.
| Item de configuração | Valor | Descrição |
|---|---|---|
| base_url do SDK | https://api.apiyi.com/v1 |
Preencha apenas até /v1; o SDK acrescenta /chat/completions automaticamente |
| Endpoint HTTP | POST https://api.apiyi.com/v1/chat/completions |
Use este endereço ao enviar a requisição HTTP diretamente, sem o SDK |
| ID do modelo | hy4 |
Nome do modelo da versão oficial; preencha exatamente em minúsculas |
| Grupos disponíveis | Default, SVIP | O grupo ao qual o token pertence precisa incluir o Hy4 |
| Modo de saída | stream=False |
Este artigo usa o modo não-streaming durante todo o texto |
O erro mais comum é colocar o endpoint completo no base_url. O SDK acrescenta /chat/completions de novo após esse endereço, causando duplicação do caminho e, por fim, retornando 404. A documentação completa da interface compatível está em docs.apiyi.com/api-capabilities/openai/compatible.
1.2 Instalar o OpenAI SDK e salvar a Key com segurança
O endereço do projeto oficial do Python SDK é github.com/openai/openai-python. Recomenda-se instalar em um ambiente virtual para evitar conflito de versões com pacotes já presentes no sistema:
python -m venv .venv
source .venv/bin/activate          # Windows: .venv\Scripts\activate
python -m pip install openai
A Key é criada em api.apiyi.com/token. Ao criar, confirme que o grupo ao qual o token pertence pode invocar o Hy4. Depois de obter a Key, escreva-a na variável de ambiente do terminal atual; não a coloque no código:
export APIYI_API_KEY="你的令牌" # Windows PowerShell: $env:APIYI_API_KEY="你的令牌"
Ao administrar a Key, observe os pontos a seguir:
- O código lê a Key apenas via
os.environ['APIYI_API_KEY']. Quando a variável de ambiente não está definida, faça a entrada interativa comgetpass; o conteúdo digitado não aparece na tela. - Se salvar a Key em um arquivo
.env, adicione-o ao.gitignorepara evitar que seja commitado no repositório. - Se a Key aparecer em capturas de tela, logs ou tickets, substitua primeiro por uma máscara como
sk-***.
Verificação: execute no terminal python -c "import openai, os; print(openai.__version__, bool(os.environ.get('APIYI_API_KEY')))". Se aparecer o número da versão e True, esta etapa está concluída.
2. Enviando a primeira requisição Hy4 com o SDK da OpenAI
2.1 Exemplo completo em Python sem streaming
Esta primeira requisição faz apenas uma coisa simples: extrair o nome do produto e o número da versão de uma frase pública, sem nenhum dado de cliente. Essa escolha de design traz dois benefícios. Primeiro, a saída é bem curta, então o custo é baixo. Segundo, a resposta é única, o que facilita verificar se está certa ou errada.
import os
import re
from getpass import getpass
from openai import OpenAI

key = os.environ.get("APIYI_API_KEY") or getpass("输入 APIYI_API_KEY:")

PROMPT = "仅从这句话提取产品和版本:腾讯混元 Hy4 正式版已上线。请只写一行:产品=…;版本=…"

with OpenAI(
    base_url="https://api.apiyi.com/v1",   # Interface compatível com OpenAI da APIYI
    api_key=key,
    timeout=60.0,
    max_retries=0,                         # Desativa a repetição automática; em caso de falha, uma pessoa decide se deve reenviar
) as client:
    result = client.chat.completions.create(
        model="hy4",
        messages=[{"role": "user", "content": PROMPT}],
        stream=False,
    )

request_id = getattr(result, "_request_id", None)
print("request_id:", request_id if request_id else "响应未提供")

if not result.choices:
    raise SystemExit("未通过:choices 为空,没有返回正文")

choice = result.choices[0]
content = (choice.message.content or "").strip()
print("finish_reason:", choice.finish_reason)
print("content:", content)

usage = getattr(result, "usage", None)
prompt_tokens = getattr(usage, "prompt_tokens", None) if usage else None
completion_tokens = getattr(usage, "completion_tokens", None) if usage else None
print("prompt_tokens:", prompt_tokens if prompt_tokens is not None else "缺失(不按 0 处理)")
print("completion_tokens:", completion_tokens if completion_tokens is not None else "缺失(不按 0 处理)")


def accept(text: str, finish_reason) -> tuple[bool, str]:
    if not text:
        return False, "正文为空"
    if finish_reason == "length":
        return False, "输出被截断"
    t = re.sub(r"\s+", "", text)
    t = t.replace(":", "=").replace(":", "=").replace(";", ";")
    prod = re.search(r"产品=([^;\n]+)", t)
    ver = re.search(r"版本=([^;\n]+)", t)
    if not prod or not ver:
        return False, "缺少产品或版本字段"
    strip_punct = lambda s: re.sub(r"[。..,,、!!??\"“”'‘’]", "", s)
    if "混元" not in strip_punct(prod.group(1)):
        return False, f"产品值错误:{prod.group(1)}"
    if strip_punct(ver.group(1)) != "Hy4":
        return False, f"版本值错误:{ver.group(1)}"
    return True, "通过"


ok, reason = accept(content, choice.finish_reason)
print("验收:", reason)
Alguns ajustes do exemplo merecem explicação:
max_retries=0desativa a repetição automática do SDK. Como veremos na seção 4, após um timeout o servidor pode já ter concluído a requisição; reenviar automaticamente pode gerar cobrança duplicada, então quem decide se deve ou não tentar de novo é uma pessoa.- A instrução
withfecha a conexão ao final da chamada. - Quando o campo
usageestá ausente, o código imprime explicitamente “缺失” em vez de tratar como 0, evitando deixar custos de fora numa eventual conferência de gastos.
Mais detalhes sobre a estrutura da resposta estão em docs.apiyi.com/api-capabilities/openai/response-handling.
2.2 Critérios de aceitação para a primeira requisição Hy4
Na verificação, olhamos apenas para dois campos em message.content: o valor do produto deve conter “混元” e o valor da versão deve ser “Hy4”. Diferenças de dois-pontos e ponto e vírgula em largura total ou meia largura, assim como de pontuação no fim da frase, são aceitáveis. Abaixo está uma linha de saída que atende aos requisitos, este é um formato ilustrativo, não é um retorno real de teste:
产品=腾讯混元;版本=Hy4
As situações a seguir são sempre reprovadas — não dá para aprovar só porque “parece quase igual”:
| Situação | Veredito | Motivo |
|---|---|---|
choices vazio, ou content como string vazia |
Reprovado | Não obtivemos o texto, o que indica que o fluxo não funcionou de fato |
finish_reason igual a length |
Reprovado | A saída foi truncada, o resultado está incompleto |
| Versão escrita como Hy3, Hunyuan ou outro valor | Reprovado | Valor do campo incorreto |
| Diferença apenas na largura total/meia largura de pontuação, espaço ou dois-pontos | Aprovado | É uma diferença de formato permitida |
Depois que a verificação passar, registre o request ID (se houver na resposta), o horário da requisição, o nome do modelo, prompt_tokens e completion_tokens. Essas informações serão usadas na seção 3.2 para conferir a fatura.
3. Estimar e verificar os custos da API Hy4
3.1 Estimar uma tarefa em lote pela tabela de preços
A entrada da primeira requisição é bem curta e o custo é desprezível — usá-la para estimar custos faz pouco sentido. A seguir, trocamos por um cenário hipotético sem relação com aquela requisição curta de exemplo: suponha uma tarefa com 100 mil tokens de entrada, todos sem acerto de cache, e 20 mil tokens de saída. Entrada e saída são calculadas com seus respectivos preços unitários:
| Item de cobrança | Uso hipotético | Preço unitário (por milhão de tokens) | Custo |
|---|---|---|---|
| Entrada sem acerto de cache | 100.000 | $0,85 | $0,085 |
| Saída | 20.000 | $2,55 | $0,051 |
| Total | — | — | $0,136 |
O cálculo é 0,1 × 0,85 + 0,02 × 2,55 = 0,136. Ao estimar, dois pontos merecem atenção:
- O preço da saída é 3 vezes o da entrada sem acerto de cache. Em tarefas com muito volume de saída, o custo é dominado pela saída.
- Se
completion_tokensjá inclui a parte de raciocínio do modelo, não acrescente uma cobrança separada de raciocínio, senão você conta duas vezes.
3.2 Distinguir o balde de cache dos logs de consumo reais
“Leitura de cache” é um item de cobrança separado, mas a forma de dividir os campos varia entre as respostas, então não existe um nome de campo universal que garanta precisão. O caminho confiável é primeiro confirmar na fatura: os tokens que acertaram o cache já estão contados dentro da entrada total?
Se a fatura confirmar que a parte de cache já está incluída na entrada total, subtraia uma vez a parte de cache da entrada total e então aplique os preços separadamente. Vamos manter o cenário hipotético de 3.1 e supor ainda que, dos 100 mil tokens de entrada, 40 mil acertaram o cache:
| Item de cobrança | Uso hipotético | Preço unitário (por milhão de tokens) | Custo |
|---|---|---|---|
| Entrada sem acerto de cache | 60.000 | $0,85 | $0,051 |
| Leitura de cache | 40.000 | $0,045 | $0,0018 |
| Saída | 20.000 | $2,55 | $0,051 |
| Total | — | — | $0,1038 |
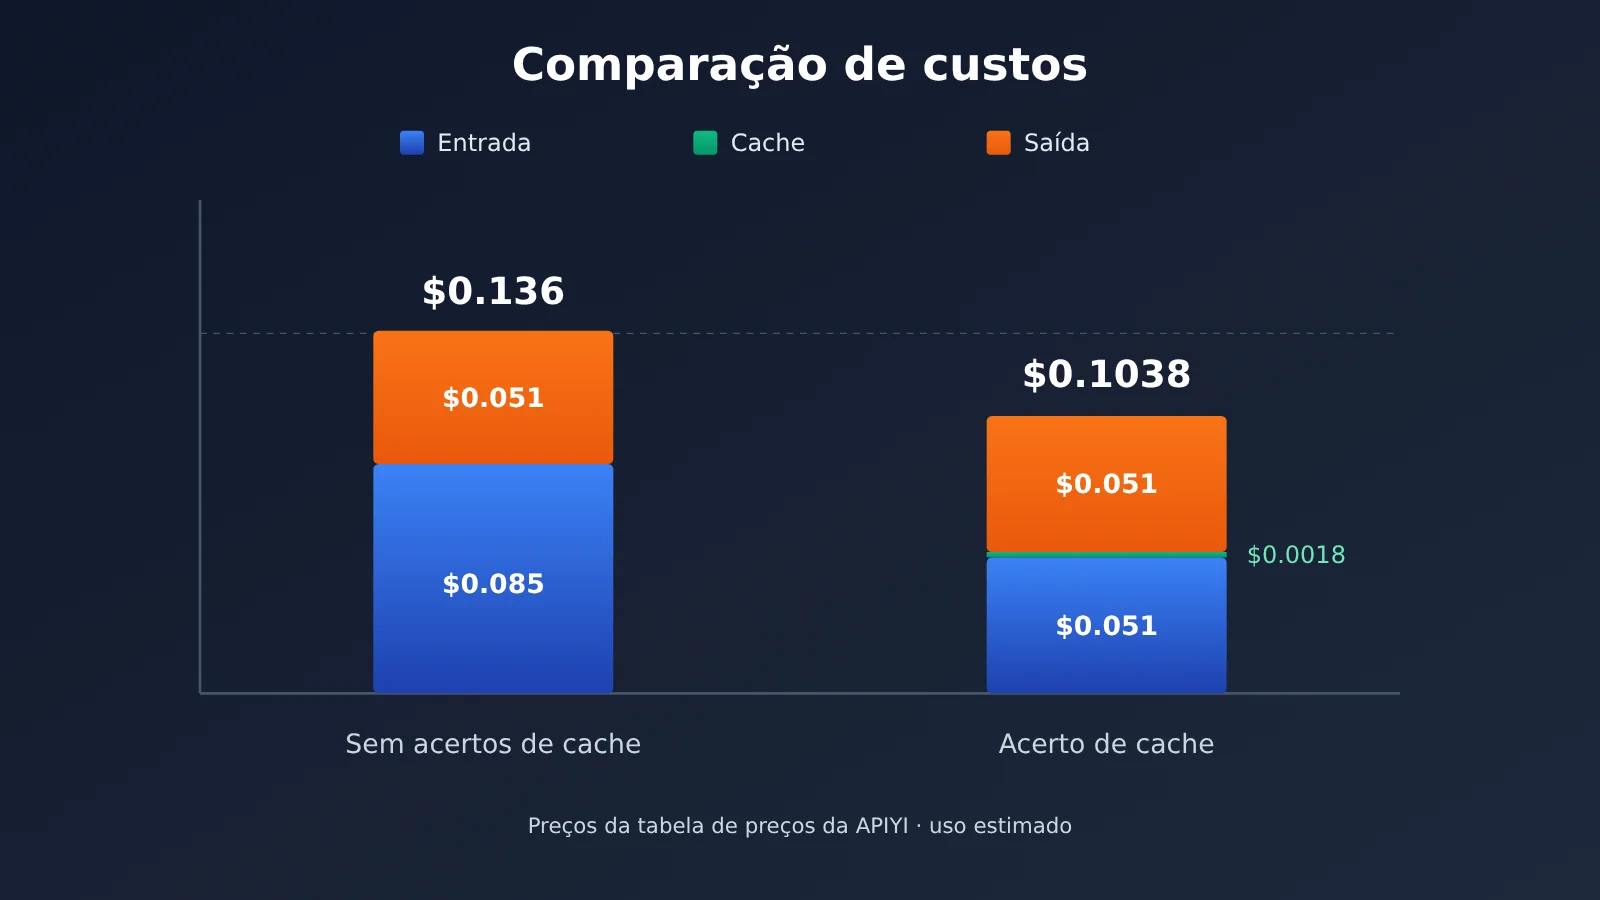
Os valores estimados servem apenas como referência — o que vale no fim é o log de consumo. Para conferir, filtre os registros correspondentes no console em api.apiyi.com/log:
- Reduza o intervalo pela hora da requisição.
- Se a resposta trouxer um request ID, use-o para localizar exatamente aquela requisição.
- Confirme que o modelo é
hy4e que o token usado é o mesmo que o código realmente utiliza. - Compare com os valores estimados os usos de entrada, cache e saída e o valor cobrado no log, para ver se batem.
O significado detalhado dos campos do log está em docs.apiyi.com/faq/log-billing-explained.
4. Solução de problemas de falha da API Hy4
Ao solucionar problemas, primeiro observe o código de status HTTP e depois leia as informações específicas no corpo do erro. Olhar apenas o código de status facilita um diagnóstico equivocado: por exemplo, dois erros 429 podem ter causas completamente diferentes. Na requisição original da seção 2.1, capture as exceções do SDK: para timeout de conexão, verifique APITimeoutError; para outras falhas de conexão, verifique APIConnectionError; ao receber uma resposta de erro, registre a partir de APIStatusError o status_code, o request_id e o corpo do erro. Primeiro avalie o resultado da requisição existente e só depois decida se deve tentar novamente; antes de enviar um feedback, anonimize o corpo do erro. A ordem de tratamento é a seguinte:
| Erro | Verificação prioritária | Tentar novamente? |
|---|---|---|
| 401 | Se a Key está correta, se já expirou e se o base_url é https://api.apiyi.com/v1 |
Não tente novamente antes de corrigir a configuração |
| 403 | Com base no corpo do erro, verifique se é um problema de permissão de grupo e confirme se o grupo ao qual o token pertence inclui o Hy4 | Não tente novamente antes de corrigir as permissões |
| 404 | Se o caminho está com /chat/completions concatenado repetidamente e se o nome do modelo é hy4 |
Não tente novamente antes de corrigir a configuração |
| 429 | Com base no corpo do erro, determine se é limitação temporária de taxa ou cota insuficiente | Para limitação temporária, é possível tentar novamente com backoff por um número limitado de vezes; para cota insuficiente, é preciso primeiro recarregar ou ajustar a cota |
| Erro de conexão | Se a rede, o proxy e o DNS estão normais, e se o protocolo e o domínio do base_url estão corretos | É possível tentar novamente após a rede se recuperar |
| Timeout | Primeiro procure em api.apiyi.com/log pelo horário e confirme se a requisição já foi executada |
Se já foi executada, não reenvie; se não foi executada, tente novamente |
É preciso explicar especialmente os casos de 429 e timeout:
- Retentativa com backoff para 429: aplica-se apenas à limitação temporária de taxa. O número de tentativas deve ter um limite máximo, com o intervalo aumentando gradualmente a cada tentativa. Quando a cota é insuficiente, não importa quantas vezes você tente, nunca dará certo.
- Timeout: o fato de o cliente não receber resposta em 60 segundos não significa que o servidor não processou a requisição. Se o servidor já terminou o processamento, reenviar diretamente fará com que seja executado mais uma vez, e a cobrança será feita novamente. Portanto, primeiro consulte os logs, confirme que a requisição não foi executada e só então reenvie.
Se precisar entrar em contato com o suporte técnico, antes de enviar, anonimize as informações sensíveis no corpo do erro e nos logs, como a Key e os dados do cliente, e anexe o código de status, o horário da requisição, o nome do modelo e o request ID. Para saber como armazenar e enviar informações de erro, consulte docs.apiyi.com/api-manual/error-reporting.
Depois de concluir toda a solução de problemas, execute novamente o exemplo da seção 2.1. O fluxo completo só é considerado aprovado se atender simultaneamente a três condições:
- A função de validação exibe “通过”.
- O finish_reason não é
length. - Nos logs do console é possível encontrar um registro no mesmo horário, com o modelo
hy4, e o uso deve ser consistente com o usage registrado localmente.