Résumé : cet article utilise le SDK Python OpenAI pour appeler l’API Tencent Hunyuan Hy4 en mode non-streaming, réalise la première requête purement textuelle, et explique comment vérifier le résultat, estimer les coûts, contrôler la facturation et gérer les erreurs courantes.
Réponse directe : l’API Tencent Hunyuan Hy4 est accessible via l’interface compatible OpenAI d’APIYI. Trois configurations suffisent pour envoyer la première requête :
- Clé : à créer sur
api.apiyi.com/token, puis à placer dans la variable d’environnementAPIYI_API_KEY. - Base URL du SDK :
https://api.apiyi.com/v1. - ID du modèle :
hy4.
L’endpoint HTTP correspondant est POST https://api.apiyi.com/v1/chat/completions. Au 21 novembre 2026, les tarifs Hy4 de la grille tarifaire sont les suivants, par million de tokens : entrée non cachée $0.85, sortie $2.55, lecture du cache $0.045. La facturation réelle fait foi selon la grille tarifaire APIYI, disponible à l’adresse docs.apiyi.com/models (catégorie Tencent).
La chronologie est la suivante : Tencent a publié la version officielle Hy4 le 4 novembre, puis ouvert les poids le 20 novembre. APIYI avait déjà mis ce modèle en ligne avant l’ouverture des poids ; l’annonce de mise en ligne se trouve sur docs.apiyi.com/news/hy4-launch. L’annonce contient déjà un exemple en streaming, c’est pourquoi cet article se concentre sur quatre autres points : l’appel non-streaming, la validation du résultat, le contrôle de la facturation et le dépannage des échecs. L’annonce indique que Hy4 accepte les entrées d’images ; cet article ne démontre toutefois que le texte pur. Les vidéos, l’interface Responses et Computer Use ne font pas partie du périmètre de cet article, qui ne contient par ailleurs aucune donnée de test réelle.
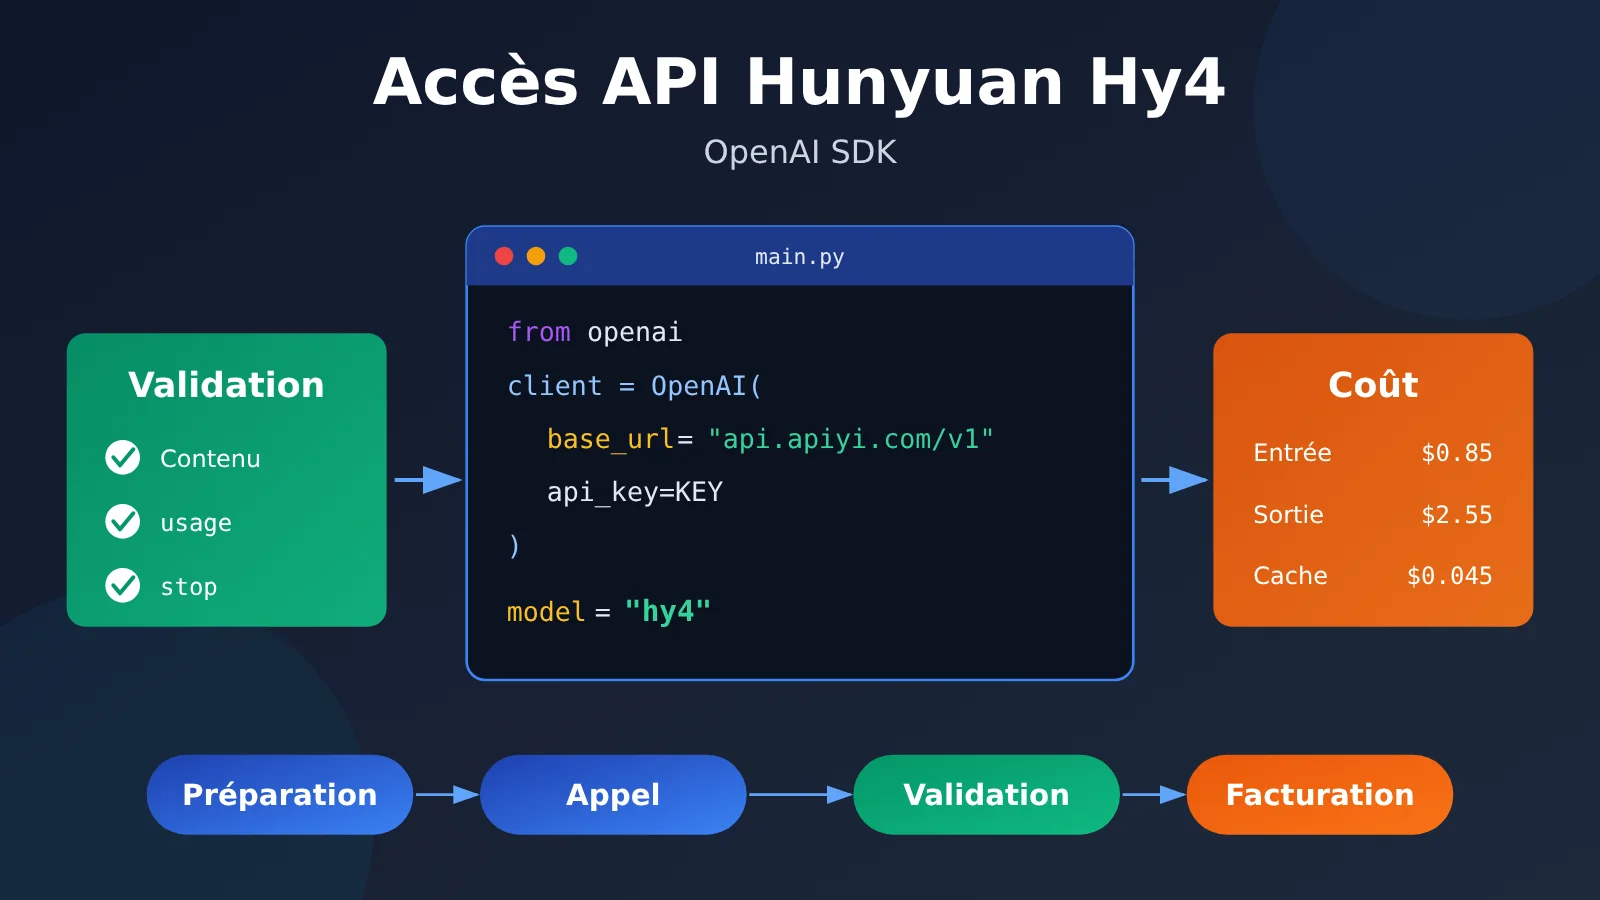
Carte des connaissances et ordre de lecture pour intégrer l’API Tencent Hunyuan Hy4
Le processus se déroule en quatre étapes, et le résultat de chaque étape alimente la suivante. Je vous conseille de lire dans l’ordre des numéros. La section 4 peut être consultée séparément, au moment où une erreur apparaît.
| Étape | Section correspondante | Pourquoi cet emplacement | Critère de validation |
|---|---|---|---|
| Préparer la requête | 1.1, 1.2 | Une erreur d’endpoint, de nom de modèle ou de clé fait échouer toutes les étapes suivantes | Le SDK s’importe, la variable d’environnement donne bien accès à la clé, et aucun secret n’apparaît en clair dans le code |
| Premier appel | 2.1, 2.2 | On commence par un texte court, sans données client, pour confirmer que la chaîne fonctionne | Le contenu renvoyé est « produit=Hunyuan, version=Hy4 », sans troncature, et l’on a conservé l’usage ainsi que le request ID |
| Vérifier la facture | 3.1, 3.2 | Une fois la chaîne validée, on estime le coût pour savoir si l’on peut augmenter le volume d’appels | L’estimation correspond point par point au journal de consommation de la console |
| Dépannage des échecs | 4 | En cas d’échec à n’importe quelle étape, on localise la cause grâce au code et au corps d’erreur | On distingue une erreur de configuration, un problème de permissions, une limitation de débit et un délai d’attente, et on sait si un nouvel essai est possible |
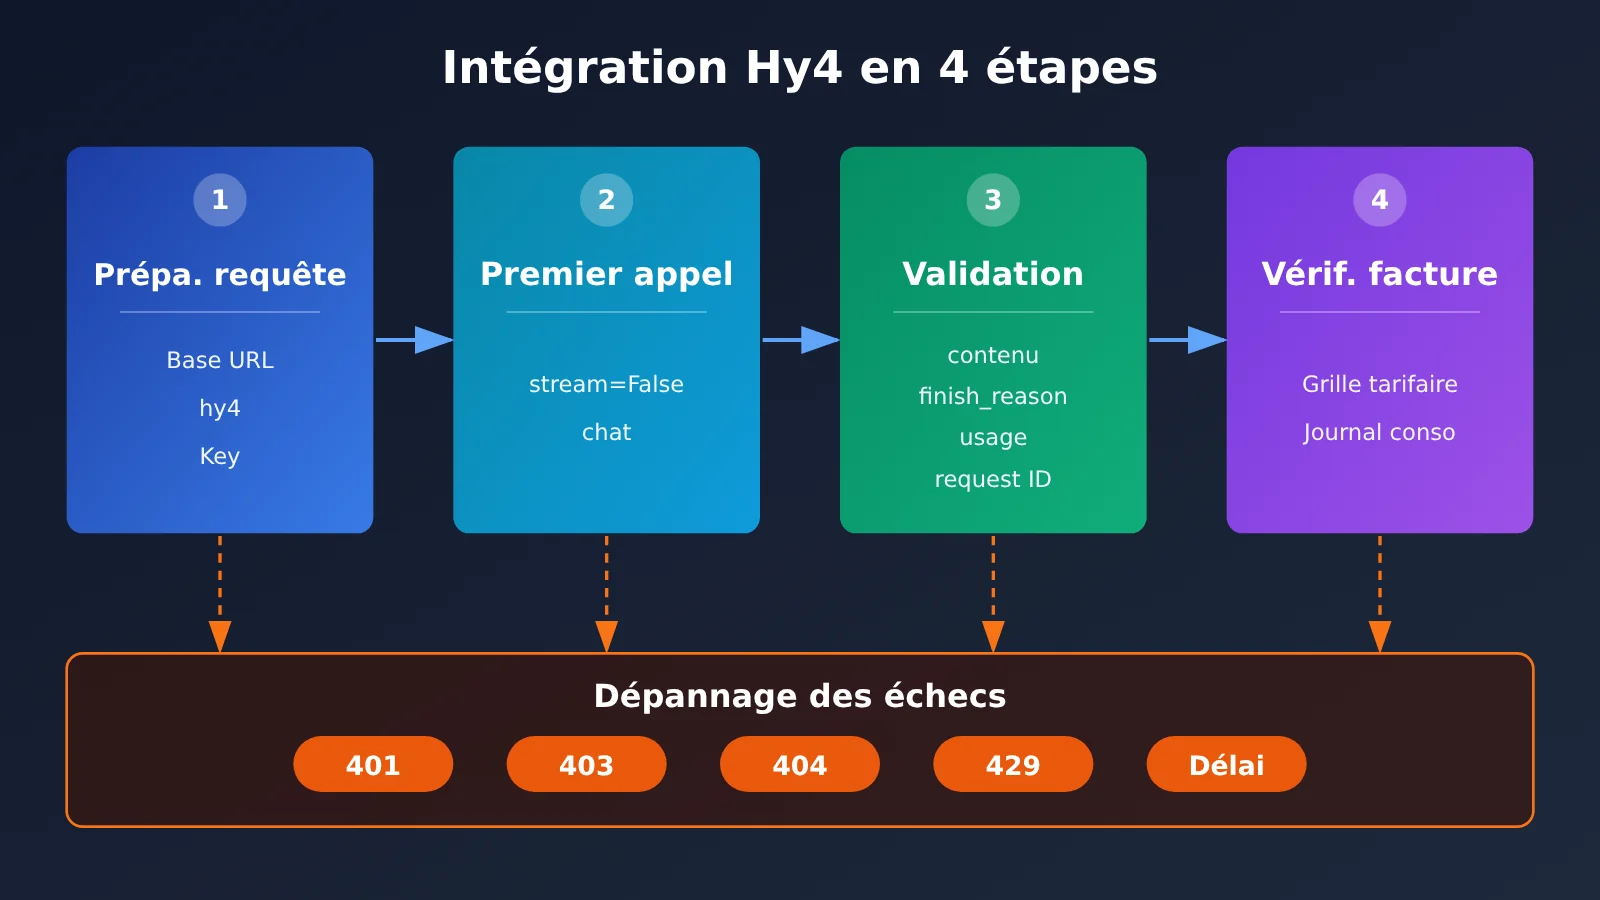
À savoir : les termes utiles de l’API Hy4
| Terme | Explication courte |
|---|---|
| Non-streaming (stream=False) | Le modèle renvoie d’un seul coup le résultat complet une fois la génération terminée, ce qui facilite la vérification globale du contenu et de l’usage |
| finish_reason | La raison de la fin de cette génération. stop signale une fin normale, length un résultat tronqué parce que la limite de longueur a été atteinte |
| usage | Le champ de consommation de tokens dans la réponse, avec notamment prompt_tokens (entrée) et completion_tokens (sortie) |
| request ID | L’identifiant d’une requête, qui sert à retrouver cet appel dans les journaux. Il n’accompagne pas forcément toutes les réponses |
| Lecture de cache | La partie de l’entrée qui touche le cache, facturée à un tarif de lecture de cache distinct |
| Groupe (Default/SVIP) | Le groupe auquel appartient le jeton, qui détermine les modèles que ce jeton peut appeler |
1. Préparer une requête API pour Tencent Hunyuan Hy4
1.1 Configurer le modèle Hy4 et le point de terminaison
Vérifiez d’abord chaque paramètre de configuration un par un. La plupart des échecs lors du premier appel viennent de cette étape.
| Paramètre | Valeur | Description |
|---|---|---|
| SDK base_url | https://api.apiyi.com/v1 |
Indiquez uniquement /v1 ; le SDK ajoutera automatiquement /chat/completions |
| Point de terminaison HTTP | POST https://api.apiyi.com/v1/chat/completions |
À utiliser lorsque vous envoyez directement une requête HTTP, sans SDK |
| ID du modèle | hy4 |
Nom du modèle de la version officielle, à saisir tel quel en minuscules |
| Groupes disponibles | Default, SVIP | Le groupe auquel appartient le jeton doit inclure Hy4 |
| Mode de sortie | stream=False |
Dans tout cet article, nous utilisons le mode non streaming |
L’erreur la plus fréquente consiste à mettre le point de terminaison complet dans base_url. Le SDK ajoute alors une seconde fois /chat/completions à cette adresse, ce qui duplique le chemin et renvoie finalement une 404. La documentation complète de l’interface compatible se trouve dans docs.apiyi.com/api-capabilities/openai/compatible.
1.2 Installer le SDK OpenAI et stocker la clé en toute sécurité
Le dépôt officiel du SDK Python se trouve à l’adresse github.com/openai/openai-python. Il est recommandé de l’installer dans un environnement virtuel pour éviter les conflits avec les versions de packages déjà présentes sur le système :
python -m venv .venv
source .venv/bin/activate          # Windows : .venv\Scripts\activate
python -m pip install openai
La clé se crée sur api.apiyi.com/token. Lors de la création, vérifiez que le groupe auquel appartient le jeton peut appeler Hy4. Une fois la clé obtenue, placez-la dans la variable d’environnement du terminal courant, sans la mettre dans un fichier de code :
export APIYI_API_KEY="你的令牌" # Windows PowerShell: $env:APIYI_API_KEY="你的令牌"
Pour gérer la clé, gardez ces quelques points en tête :
- Le code lit la clé uniquement via
os.environ['APIYI_API_KEY']. Si la variable d’environnement n’est pas définie, utilisezgetpasspour une saisie interactive ; le contenu saisi ne s’affiche pas à l’écran. - Si vous stockez la clé dans un fichier
.env, ajoutez-le à.gitignorepour éviter de la commit dans le dépôt. - Si une clé apparaît dans une capture d’écran, un journal ou un ticket, remplacez-la d’abord par un masque comme
sk-***.
Vérification : exécutez dans le terminal python -c "import openai, os; print(openai.__version__, bool(os.environ.get('APIYI_API_KEY')))". Si la sortie affiche le numéro de version et True, cette étape est terminée.
2. Envoyer la première requête Hy4 avec le SDK OpenAI
2.1 Exemple Python complet sans streaming
Cette première requête fait une seule chose simple : extraire le nom du produit et le numéro de version d’une phrase publique, sans aucune donnée client. Ce choix présente deux avantages. D’abord, la sortie est très courte, donc le coût est faible. Ensuite, la réponse est unique, ce qui facilite la vérification du résultat.
import os
import re
from getpass import getpass
from openai import OpenAI

key = os.environ.get("APIYI_API_KEY") or getpass("输入 APIYI_API_KEY:")

PROMPT = "仅从这句话提取产品和版本:腾讯混元 Hy4 正式版已上线。请只写一行:产品=…;版本=…"

with OpenAI(
    base_url="https://api.apiyi.com/v1",   # Interface OpenAI compatible d'APIYI
    api_key=key,
    timeout=60.0,
    max_retries=0,                         # Désactive les tentatives automatiques ; en cas d'échec, c'est à un humain de décider s'il faut renvoyer
) as client:
    result = client.chat.completions.create(
        model="hy4",
        messages=[{"role": "user", "content": PROMPT}],
        stream=False,
    )

request_id = getattr(result, "_request_id", None)
print("request_id:", request_id if request_id else "响应未提供")

if not result.choices:
    raise SystemExit("未通过:choices 为空,没有返回正文")

choice = result.choices[0]
content = (choice.message.content or "").strip()
print("finish_reason:", choice.finish_reason)
print("content:", content)

usage = getattr(result, "usage", None)
prompt_tokens = getattr(usage, "prompt_tokens", None) if usage else None
completion_tokens = getattr(usage, "completion_tokens", None) if usage else None
print("prompt_tokens:", prompt_tokens if prompt_tokens is not None else "缺失(不按 0 处理)")
print("completion_tokens:", completion_tokens if completion_tokens is not None else "缺失(不按 0 处理)")


def accept(text: str, finish_reason) -> tuple[bool, str]:
    if not text:
        return False, "正文为空"
    if finish_reason == "length":
        return False, "输出被截断"
    t = re.sub(r"\s+", "", text)
    t = t.replace(":", "=").replace(":", "=").replace(";", ";")
    prod = re.search(r"产品=([^;\n]+)", t)
    ver = re.search(r"版本=([^;\n]+)", t)
    if not prod or not ver:
        return False, "缺少产品或版本字段"
    strip_punct = lambda s: re.sub(r"[。..,,、!!??\"“”'‘’]", "", s)
    if "混元" not in strip_punct(prod.group(1)):
        return False, f"产品值错误:{prod.group(1)}"
    if strip_punct(ver.group(1)) != "Hy4":
        return False, f"版本值错误:{ver.group(1)}"
    return True, "通过"


ok, reason = accept(content, choice.finish_reason)
print("验收:", reason)
Quelques réglages de l’exemple méritent une explication :
max_retries=0désactive les tentatives automatiques du SDK. Comme on le verra à la section 4, après un timeout, le serveur peut avoir déjà terminé la requête ; un renvoi automatique risque donc de provoquer une double facturation. C’est donc à une personne de décider s’il faut réessayer.- L’instruction
withferme la connexion à la fin de l’appel. - Lorsque le champ usage est absent, le code affiche explicitement «缺失» (manquant) et ne le traite pas comme 0, pour éviter d’oublier des coûts lors du décompte ultérieur.
Pour plus de détails sur la structure de réponse, voir docs.apiyi.com/api-capabilities/openai/response-handling.
2.2 Critères d’acceptation de la première requête Hy4
Lors de la validation, on ne regarde que deux champs dans message.content : la valeur du produit doit contenir « 混元 » et la valeur de la version doit être « Hy4 ». Les différences entre deux-points pleine chasse et demi-chasse, entre points-virgules, ainsi que la ponctuation de fin de phrase, sont acceptables. Voici ci-dessous une ligne de sortie conforme ; il s’agit d’un format indicatif, et non d’une réponse réellement mesurée :
产品=腾讯混元;版本=Hy4
Les cas suivants sont systématiquement refusés : on ne valide pas un résultat simplement parce qu’il « ressemble » à ce qu’on attend.
| Cas | Verdict | Raison |
|---|---|---|
choices vide, ou content réduit à une chaîne vide |
Refusé | Aucun corps de réponse obtenu : la chaîne n’a pas réellement fonctionné de bout en bout |
finish_reason vaut length |
Refusé | La sortie est tronquée, le résultat est incomplet |
| La version est écrite Hy3, Hunyuan ou une autre valeur | Refusé | La valeur du champ est erronée |
| Seule la forme pleine chasse ou demi-chasse de la ponctuation, des espaces ou des deux-points diffère | Validé | Il s’agit d’une différence de format autorisée |
Une fois la validation passée, notez le request ID (s’il figure dans la réponse), l’heure de la requête, le nom du modèle, prompt_tokens et completion_tokens. Ces informations serviront à vérifier la facturation à la section 3.2.
3. Estimer et vérifier les coûts de l’API Hy4
3.1 Estimer une tâche par lot à partir de la grille tarifaire
La première requête a une entrée très courte, son coût est négligeable et l’utiliser pour estimer les coûts n’a pas vraiment de sens. Prenons plutôt un scénario hypothétique sans lien avec la requête courte de l’exemple : une tâche avec 100 000 tokens d’entrée, tous non mis en cache, et 20 000 tokens de sortie. L’entrée et la sortie sont facturées selon leur prix unitaire respectif :
| Élément facturé | Utilisation hypothétique | Prix unitaire (par million de tokens) | Coût |
|---|---|---|---|
| Entrée non mise en cache | 100 000 | $0.85 | $0.085 |
| Sortie | 20 000 | $2.55 | $0.051 |
| Total | — | — | $0.136 |
Le calcul est 0,1 × 0,85 + 0,02 × 2,55 = 0,136. Deux points sont à garder en tête lors de l’estimation :
- Le prix unitaire de la sortie est 3 fois celui de l’entrée non mise en cache. Pour une tâche avec beaucoup de sortie, le coût dépend principalement de la sortie.
- Si completion_tokens inclut déjà la partie réflexion du modèle, n’ajoutez pas une seconde fois le coût de la réflexion, sinon vous compterez double.
3.2 Distinguer les compartiments de cache et les journaux de consommation réels
La « lecture du cache » est un poste facturé à part, mais la répartition des champs peut varier d’une réponse à l’autre. Il n’existe donc pas de nom de champ universel qui garantisse un résultat exact. La méthode fiable consiste d’abord à vérifier dans la facturation si les tokens ayant bénéficié du cache sont déjà inclus dans l’entrée totale.
Si la facturation confirme que la partie en cache est déjà comprise dans l’entrée totale, déduisez une fois la partie en cache de l’entrée totale, puis appliquez les tarifs séparément. Reprenons l’hypothèse de 3.1 en supposant en plus que, sur les 100 000 tokens d’entrée, 40 000 bénéficient du cache :
| Élément facturé | Utilisation hypothétique | Prix unitaire (par million de tokens) | Coût |
|---|---|---|---|
| Entrée non mise en cache | 60 000 | $0.85 | $0.051 |
| Lecture du cache | 40 000 | $0.045 | $0.0018 |
| Sortie | 20 000 | $2.55 | $0.051 |
| Total | — | — | $0.1038 |
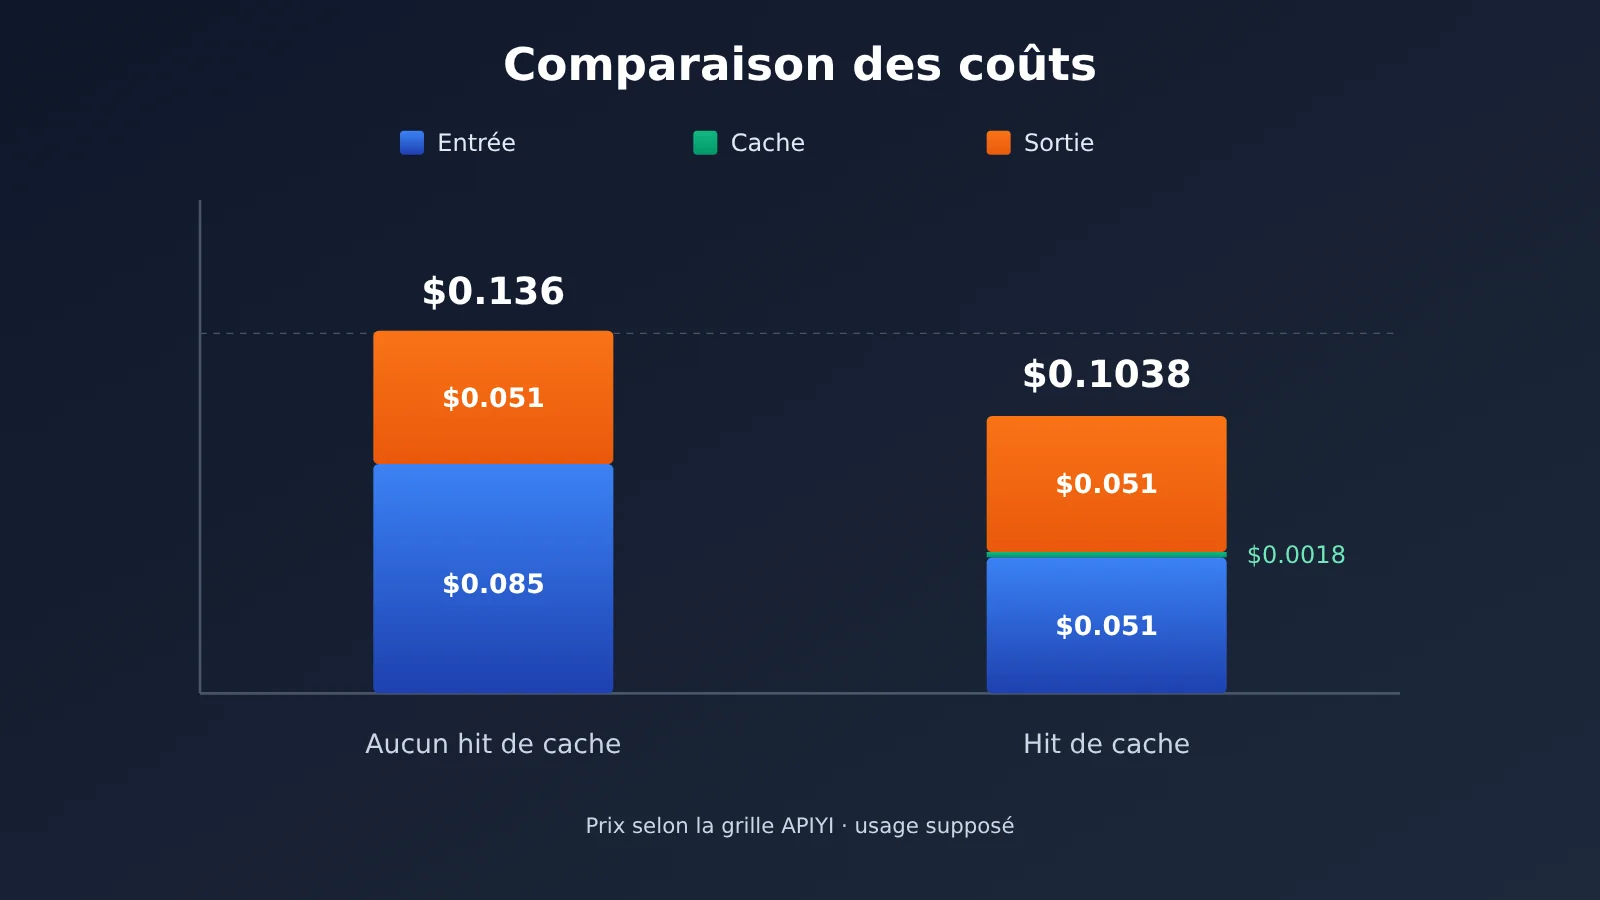
Les valeurs estimées ne servent que de référence ; c’est le journal de consommation qui fait foi. Pour vérifier, filtrez les enregistrements correspondants dans la console api.apiyi.com/log :
- Réduisez la plage par l’heure de la requête.
- Si la réponse fournit un request ID, utilisez-le pour localiser précisément cette requête.
- Vérifiez que le modèle est
hy4et que le jeton correspond bien à celui réellement utilisé dans le code. - Comparez les quantités d’entrée, de cache et de sortie ainsi que le montant débité dans le journal avec votre estimation, pour voir s’ils concordent.
La signification détaillée des champs du journal est disponible dans docs.apiyi.com/faq/log-billing-explained.
4. Dépannage des échecs de l’API Hy4
Pour le dépannage, commencez par examiner le code d’état HTTP, puis lisez les informations précises contenues dans le corps de l’erreur. Se fier uniquement au code d’état conduit facilement à un diagnostic erroné : un même 429, par exemple, peut avoir des causes totalement différentes. Au niveau de la requête originale de la section 2.1, interceptez les exceptions du SDK : pour un délai de connexion dépassé, regardez APITimeoutError ; pour les autres échecs de connexion, regardez APIConnectionError. Lorsque vous recevez une réponse d’erreur, relevez status_code, request_id et le corps de l’erreur à partir de APIStatusError. Jugez d’abord du résultat de la requête en cours, puis décidez s’il faut réessayer ; avant de faire un retour, masquez les données sensibles dans le corps de l’erreur. L’ordre de traitement est le suivant :
| Erreur | À vérifier en priorité | Faut-il réessayer |
|---|---|---|
| 401 | La clé est-elle correcte, est-elle toujours valide, et base_url est-il bien https://api.apiyi.com/v1 |
Ne pas réessayer avant d’avoir corrigé la configuration |
| 403 | D’après le corps de l’erreur, s’agit-il d’un problème d’autorisation de groupe ? Vérifiez que le groupe auquel appartient le jeton inclut bien Hy4 | Ne pas réessayer avant d’avoir corrigé les permissions |
| 404 | Le chemin concatène-t-il /chat/completions deux fois ? Le nom du modèle est-il bien hy4 ? |
Ne pas réessayer avant d’avoir corrigé la configuration |
| 429 | D’après le corps de l’erreur, s’agit-il d’une limitation de débit temporaire ou d’un quota insuffisant ? | En cas de limitation temporaire, quelques tentatives avec un délai d’attente croissant sont possibles ; si le quota est insuffisant, il faut d’abord recharger ou ajuster le quota |
| Erreur de connexion | Le réseau, le proxy et le DNS fonctionnent-ils correctement ? Le protocole et le nom de domaine de base_url sont-ils corrects ? | Réessayer est possible une fois le réseau rétabli |
| Délai dépassé | Recherchez d’abord par horodatage dans api.apiyi.com/log pour confirmer si la requête a déjà été exécutée |
Si elle a été exécutée, ne pas renvoyer ; sinon, réessayer |
Deux cas méritent une explication particulière : le 429 et le délai dépassé.
- Nouvelle tentative avec délai croissant pour un 429 : cela ne s’applique qu’à une limitation de débit temporaire. Le nombre de tentatives doit être plafonné, et l’intervalle doit augmenter progressivement. En cas de quota insuffisant, réessayer n’aboutira jamais, quel que soit le nombre de tentatives.
- Délai dépassé : le fait que le client n’ait pas reçu de réponse en 60 secondes ne signifie pas que le serveur n’a pas traité la requête. Si le serveur a déjà terminé le traitement, renvoyer directement la requête l’exécutera une seconde fois, et les frais seront débités de nouveau. Il faut donc d’abord consulter les logs pour confirmer que la requête n’a pas été exécutée, puis la renvoyer.
Si vous devez contacter le support technique, masquez d’abord les informations sensibles présentes dans le corps de l’erreur et dans les logs (clé, données client, etc.), puis joignez le code d’état, l’heure de la requête, le nom du modèle et le request ID. Pour la conservation et la transmission des messages d’erreur, voir docs.apiyi.com/api-manual/error-reporting.
Une fois le dépannage terminé, relancez une fois l’exemple de la section 2.1. L’ensemble du processus n’est validé que si les trois conditions suivantes sont réunies simultanément :
- La fonction de validation affiche « 通过 » (réussi).
finish_reasonn’est paslength.- Les logs de la console contiennent bien un enregistrement au même moment avec le modèle
hy4, et la consommation correspond à l’usageenregistré localement.