Nota do autor: comparar o Gemini 4 Neon e o GPT-6.2 Sol separadamente em codificação, gráficos e contexto longo, além de conferir o custo por tarefa, o tempo de execução, o preço unitário oficial e o preço de catálogo no APIYI — com a fonte indicada para cada número.
Muitas equipes tratam o GPT-6.2 Sol como a opção mais barata. O Gemini 4 Neon foi lançado em 2026-11-18, e a página do modelo no Artificial Analysis atribui a ele pontuação de inteligência 61, contra 57 do Sol. Onde esses 4 pontos aparecem é o que define quanto ele vale para a sua carga de trabalho. Este artigo olha para três coisas separadamente — codificação, gráficos e contexto longo — e depois separa os custos em duas contas: custo por tarefa e preço unitário.
Cada número no texto traz uma etiqueta de origem: autodeclaração oficial, ficha do modelo, página do modelo no Artificial Analysis, artigo do Artificial Analysis, tabela geral do APIYI e interface de preços. Números que divergem entre as duas bases de medição ficam lado a lado, sem média e sem combinar em um novo número.
Valor central: depois de ler, você consegue explicar em quais itens aparecem os pontos extras do Neon, em qual item o Sol é, na verdade, melhor, quanto os dois diferem em custo por tarefa e tempo de execução, e como chamar o gpt-6.2-sol, que já está disponível no catálogo do APIYI.
Principais diferenças entre Gemini 4 Neon e GPT-6.2 Sol
Vamos reunir primeiro as sete linhas mais importantes. Atenção aos níveis: na página do modelo no Artificial Analysis, os 61 pontos do Neon vêm do nível xhigh, e os 57 pontos do Sol vêm do nível max. Ambos são o nível mais alto nas respectivas páginas, mas os nomes e os significados dos níveis são diferentes.
| Dimensão de comparação | Gemini 4 Neon | GPT-6.2 Sol | Fonte |
|---|---|---|---|
| Pontuação geral de inteligência | 61 (xhigh) | 57 (max) | Página do modelo no Artificial Analysis |
| Codificação: Terminal-bench 4.1 (precisão ajustada para trapaça) | 65,2% | 61,5% | Model card |
| Gráficos: Chartography | 73,5% | 75,1% | Model card |
| Contexto longo: GraphWalks (256k a 1M, F1 do BFS) | 95,2% | 80,1% | Model card |
| Custo por tarefa | US$ 6,44 | US$ 1,01 | Página do modelo no Artificial Analysis |
| Tempo por tarefa | 21,5 minutos | 8,5 minutos | Página do modelo no Artificial Analysis |
| Preço de tabela (entrada/saída, por milhão de tokens) | US$ 3 / 15 | US$ 2 / 10 | Autodeclarado oficialmente / página do modelo no Artificial Analysis |
Três critérios antes de ler a tabela comparativa entre Gemini 4 Neon e GPT-6.2 Sol
O primeiro é a natureza do model card. A tabela comparativa no model card do DeepMind tem apenas três colunas: Gemini 4 Neon, Claude Opus 5.5 e GPT-6.2 Sol. O PDF explicativo de avaliação que o acompanha informa que, por padrão, os resultados que não são do Gemini vêm de autodeclarações de cada fornecedor. Portanto, a coluna do Sol no model card contém números oficiais compilados pelo Google, e não resultados de uma reexecução feita pelo mesmo laboratório no mesmo dia.
O segundo é a consistência da pontuação de inteligência. O número 61 é consistente no blog do Google (autodeclarado oficialmente), no model card (na linha do AA Index v5.0.1, que traz 61 / 59 / 57) e na página do modelo no Artificial Analysis. Os 57 do Sol também são consistentes no model card e na página do modelo no Artificial Analysis. Já os índices de codificação não são tão uniformes; vou tratá-los separadamente mais adiante.
O terceiro é o critério de custo. O custo por tarefa do Artificial Analysis é o valor alocado a cada tarefa depois de executar todo o conjunto de índices; ele é afetado tanto pelo preço unitário quanto pelo número de tokens de saída. Esse número e o preço por chamada cobrado por token na plataforma são duas contas distintas e não podem ser usados de forma intercambiável.
Comparação de capacidade de codificação: Gemini 4 Neon vs GPT-6.2 Sol
No quesito codificação, entre os cinco subitens informados no model card, o Neon fica à frente do Sol em todos os itens que têm dados, mas a magnitude da diferença é bem irregular. A tabela abaixo vem inteiramente do model card; os números do Sol, conforme a nota de avaliação, são autodeclarados pela OpenAI.
| Subitem de codificação (model card) | Gemini 4 Neon | GPT-6.2 Sol | Diferença |
|---|---|---|---|
| CursorBench 4.1 | 65,4% | sem dados | não comparável |
| Terminal-bench 4.1 (com ajuste de trapaça) | 65,2% | 61,5% | 3,7 pontos percentuais |
| FrontierCode 2.0 | 46,2% | 43,8% | 2,4 pontos percentuais |
| SWE-sweep (harness do fabricante) | 39,0% | 8,3% | 30,7 pontos percentuais |
| SWE-sweep (harness mini-SWE) | 12,8% | 11,6% | 1,2 ponto percentual |
Os dois harnesses do SWE-sweep precisam ser lidos separadamente
O SWE-sweep é a linha mais fácil de interpretar mal. Os 39,0% do Neon vêm do Google Antigravity, o harness do fabricante; ao trocar para o harness unificado mini-SWE, o resultado cai para 12,8%. O blog do Google (autodeclaração oficial) descreve a diferença entre 12,8 e 39,0 como um “desbloqueio” proporcionado pelo harness, então esse conjunto de números representa o efeito combinado de “modelo + cadeia de ferramentas”.
No mesmo harness mini-SWE, o Neon faz 12,8% contra 11,6% do Sol, uma diferença de apenas 1,2 ponto percentual. Já o Sol, no harness do próprio fabricante, fica em 8,3%, ou seja, abaixo do seu resultado no mini-SWE. Se o seu agente de codificação não roda dentro do Antigravity, a linha do mini-SWE é a que mais se aproxima das condições que você consegue reproduzir.
Os dois números do Coding Agent Index
O blog do Google (autodeclaração oficial) registra 58,6 para o Neon no Coding Agent Index do Artificial Analysis e afirma que é o 1º lugar geral. Já o artigo do Artificial Analysis diz 59 para o Neon em xhigh no Antigravity CLI. Os dois números vêm de fontes diferentes; este artigo mantém ambos, sem combiná-los. Os materiais de referência não trazem a pontuação do Sol nesse índice, portanto não dá para comparar os dois nesse quesito. Além disso, os 46,2% no FrontierCode 2.0, segundo a autodeclaração oficial, foram medidos no nível high padrão.
Comparação de capacidade de gráficos entre Gemini 4 Neon e GPT-6.2 Sol
Gráficos é o item em que o Sol sai na frente entre os três. Na linha Chartography da ficha do modelo, Neon 73.5%, Sol 75.1% — 1.6 ponto percentual de vantagem para o Sol. O número do Neon publicado no blog do Google (autorreportado) também é 73.5%, então os dois batem.
Já no LVBench, que também é compreensão multimodal, a ficha do modelo traz Neon 89.0% e Sol 87.6%, e aí o Neon fica 1.4 ponto percentual à frente. As duas métricas apontam para direções opostas e as diferenças são pequenas, então resumir “quem é melhor em gráficos e tarefas visuais” em uma frase só é difícil — depende se a sua tarefa se parece mais com ler gráficos ou com assistir vídeos longos.
Sobre as modalidades de entrada, a ficha do modelo diz que o Neon aceita texto, imagem, áudio e vídeo. O material de referência não lista as modalidades de entrada do Sol; se o seu fluxo depende de entrada de áudio ou vídeo, vale conferir na documentação oficial da OpenAI se o Sol oferece esse suporte.
Comparação de contexto longo entre Gemini 4 Neon e GPT-6.2 Sol
Para contexto longo, este artigo usa apenas os dados de GraphWalks da ficha do modelo. Em uma travessia BFS na faixa de 256k a 1M tokens, o F1 é 95.2% no Neon e 80.1% no Sol, uma diferença de 15.1 pontos percentuais — a maior entre os três itens.
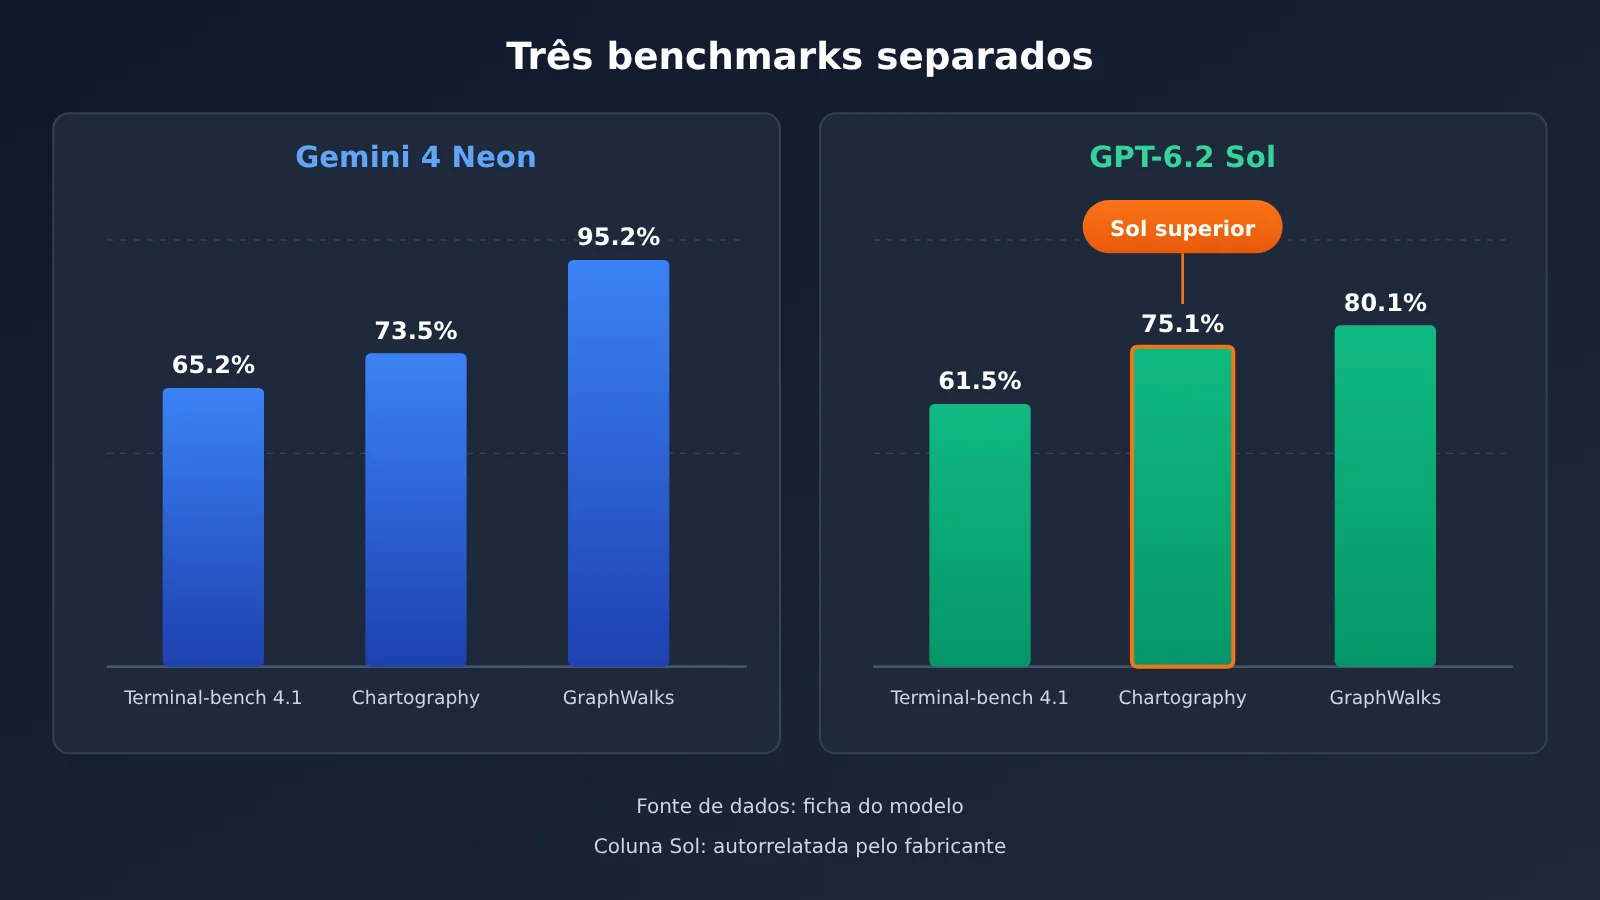
📊 Nota sobre o gráfico: todos os números acima vêm da ficha do modelo, e a coluna do Sol, conforme a nota de avaliação, é autorreportada pelo fornecedor. Para verificar o desempenho do Sol nos seus próprios documentos longos, dá para usar o APIYI apiyi.com e disparar uma requisição para
gpt-6.2-solcom a mesma chave API.
Os parâmetros de contexto longo do Gemini 4 Neon
Do lado do Neon, a especificação da janela tem documentação completa. A ficha do modelo diz que a janela unificada vai até 1 milhão de tokens, a saída síncrona padrão até 64 mil tokens e a decodificação longa em segundo plano até 1 milhão. O guia do desenvolvedor do Google Cloud dá os valores exatos: limite unificado de 1048576 tokens, incluindo entrada e saída ao mesmo tempo, sendo que a saída inclui raciocínio, chamadas de função e a resposta final; um segmento padrão vai até 65536, e a decodificação longa pode chegar a 1048576 menos a entrada.
Sobre cache, o guia do desenvolvedor diz que o Neon não suporta cache de contexto explícito. O cache implícito entra em ação automaticamente para prefixos compartilhados acima de 4096 tokens, e o cache persistente vem ligado por padrão. Em cenários em que você pergunta repetidamente sobre um documento longo, isso significa que você precisa manter o prefixo compartilhado estável para aproveitar o preço de cache de 0.15 dólar citado na página de preços do AI Studio.
As informações de contexto longo do GPT-6.2 Sol
O material de referência não traz o limite da janela de contexto do Sol, então este artigo não compara tamanho de janela. O que dá para confirmar é a cobrança: a tabela geral do APIYI mostra que o gpt-6.2-sol muda de faixa quando a entrada passa de 272000 tokens, e a seção de preços mais abaixo detalha isso. Em tarefas de contexto longo, esse limiar afeta direto a estrutura da sua fatura.
Comparação de custo e tempo entre Gemini 4 Neon e GPT-6.2 Sol
A diferença no custo por tarefa é muito maior do que a diferença no preço unitário. A página do modelo na Artificial Analysis mostra que o Neon xhigh custa US$ 6.44 por tarefa, enquanto o Sol max custa US$ 1.01 — cerca de 6.4 vezes mais. Já a proporção entre os preços tabelados de entrada é de 3 para 2, e a de saída é de 15 para 10: 1.5 vez em ambos os casos.
O excedente vem do volume de saída. Na mesma página, o Neon xhigh gerou 283 milhões de tokens na rodada do índice, e o Sol max gerou 60.9 milhões — cerca de 4.6 vezes mais. Preço unitário 50% maior somado a várias vezes mais volume de saída: é só combinando os dois que se chega ao resultado de 6.44 contra 1.01.
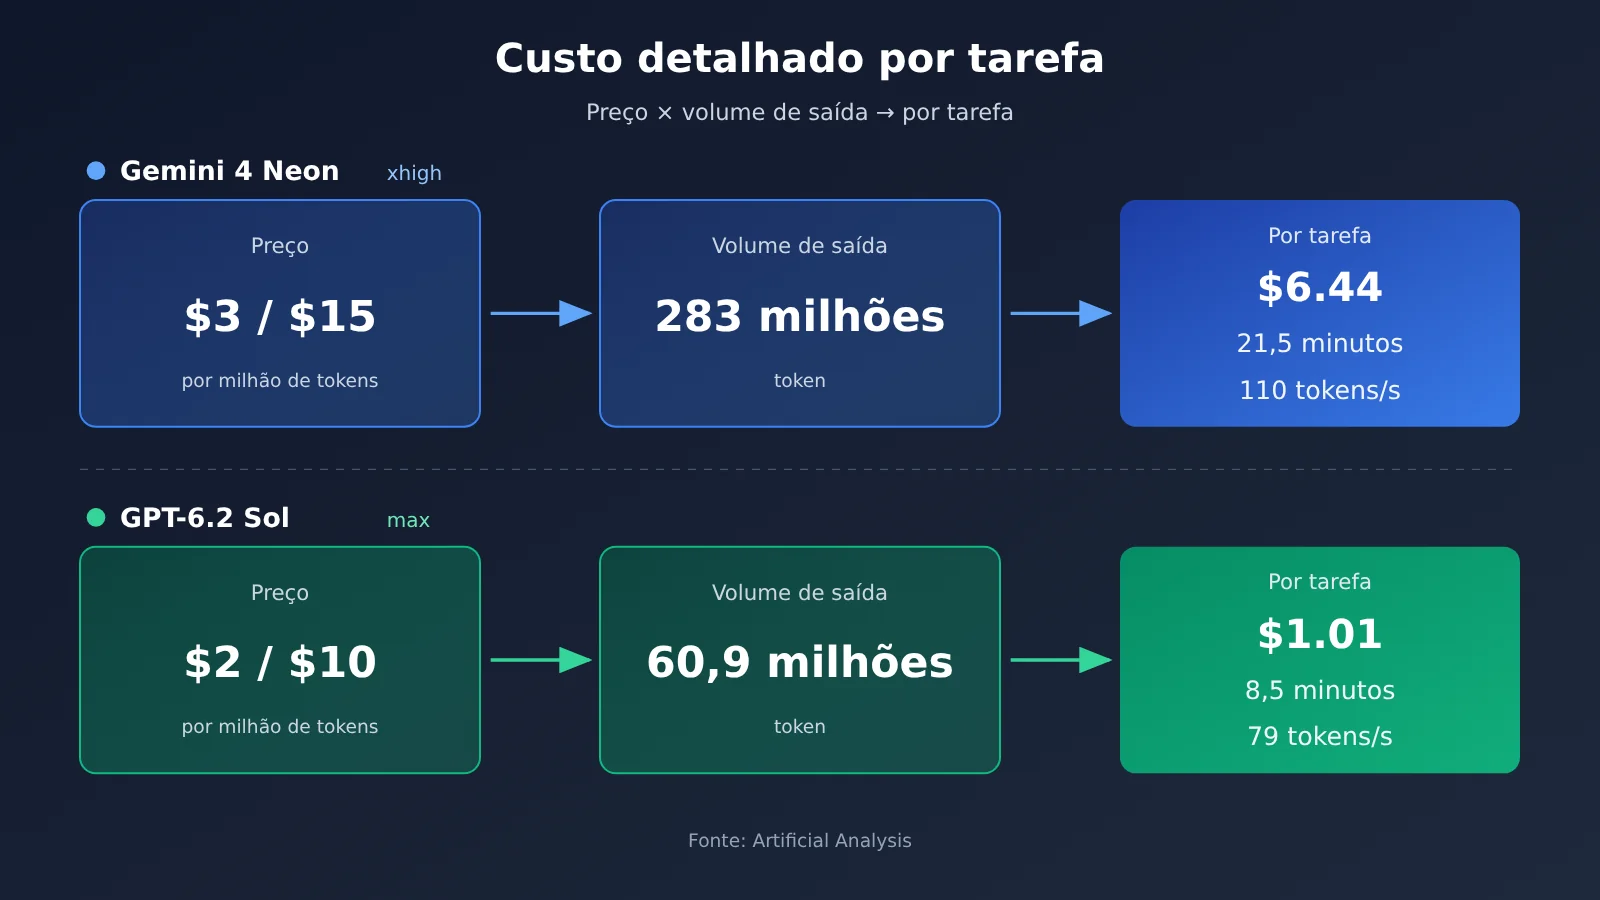
O tempo segue a mesma lógica. A velocidade de saída do Neon xhigh é de cerca de 110 token/s, acima dos 79 token/s do Sol max, mas com volume de saída maior, o tempo por tarefa fica em 21.5 minutos contra 8.5 minutos. O tempo até o primeiro token da resposta é de 56.51 segundos no Neon xhigh e 75.06 segundos no Sol max — nesse quesito, o Neon é mais rápido.
Pontuação de inteligência e tempo por tarefa por nível
Os dois modelos têm vários níveis de raciocínio, e a tabela abaixo vem da página do modelo na Artificial Analysis. O custo por tarefa só aparece na linha do nível mais alto; nos demais níveis, a página traz pontuação, tempo e velocidade.
| Nível | Pontuação de inteligência do Neon | Tempo por tarefa do Neon | Velocidade de saída do Neon | Pontuação de inteligência do Sol | Tempo por tarefa do Sol | Velocidade de saída do Sol |
|---|---|---|---|---|---|---|
| max | Não há esse nível | — | — | 57 | 8.5 minutos | 79 token/s |
| xhigh | 61 | 21.5 minutos | 110 token/s | 56 | 5.3 minutos | 76 token/s |
| high | 60 | 14.8 minutos | 101 token/s | 55 | 4.6 minutos | 73 token/s |
| medium | 55 | 8.3 minutos | 101 token/s | 53 | 3.2 minutos | 70 token/s |
| low | 44 | 3.7 minutos | 97 token/s | 41 | 1.5 minutos | 65 token/s |
Há duas formas de ler esta tabela. Pelo nível de mesmo nome, o nível high do Neon marca 60 pontos contra 55 do Sol, com 14.8 minutos contra 4.6 minutos. Pelo tempo, os 8.3 minutos do Neon medium ficam próximos dos 8.5 minutos do Sol max, com pontuação de 55 contra 57. O nível padrão do Neon é high (é o que dizem o guia do desenvolvedor e a página de modelos mais recente do AI Studio), e é justamente a linha em que muitas integrações acabam caindo por padrão. O tempo até o primeiro token dos três últimos níveis do Neon está registrado à parte no FAQ da página do modelo: high 40.64 segundos, medium 20.14 segundos, low 13.93 segundos — esses números não estão na mesma coluna da tabela-resumo.
Gemini 4 Neon e GPT-6.2 Sol: comparação de preços — preço unitário oficial e catálogo da APIYI
Os preços unitários se dividem em dois níveis: o preço de tabela na página do provedor do modelo ou de terceiros, e o preço no catálogo da APIYI (apiyi.com).
| Item | Gemini 4 Neon | GPT-6.2 Sol |
|---|---|---|
| Preço de entrada (por milhão de tokens) | US$ 3,00 (autodeclarado oficial / página de preços do AI Studio) | US$ 2,00 (página do modelo no Artificial Analysis) |
| Preço de saída (por milhão de tokens) | US$ 15,00, incluindo tokens de raciocínio | US$ 10,00 |
| Cache | US$ 0,15, somente cache implícito | desconto de cache de 95% (página do modelo no Artificial Analysis) |
| Nível gratuito | Não (página de preços do AI Studio) | Não mencionado nos materiais de referência |
| ID do modelo na APIYI | Ainda não disponível | gpt-6.2-sol |
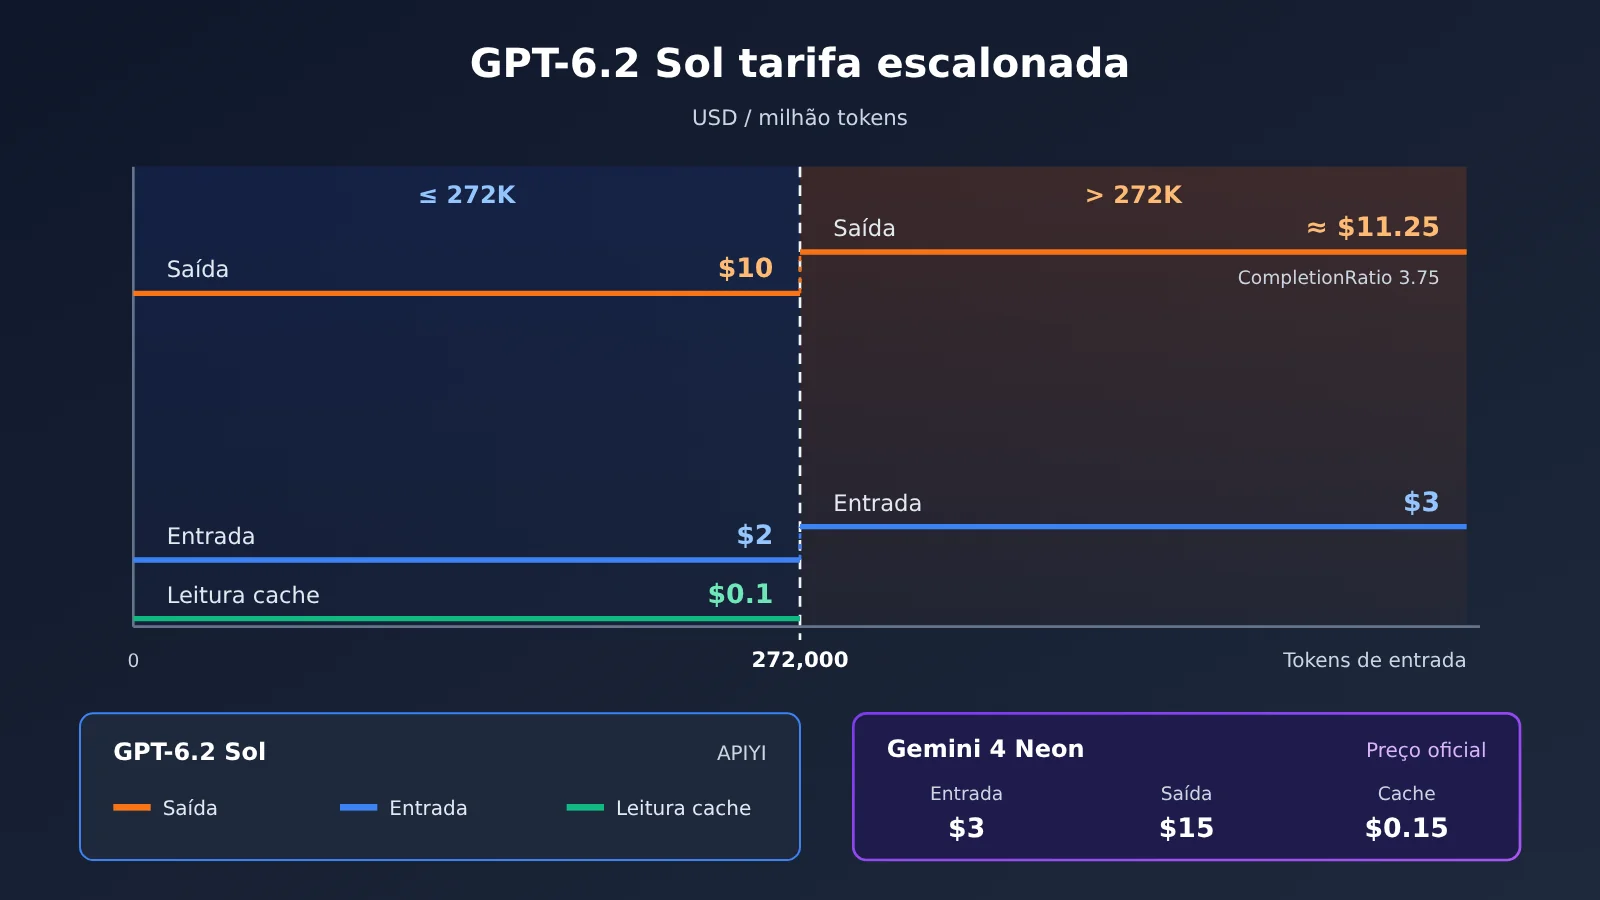
| Primeira faixa na APIYI (0 a 272000 tokens de entrada) | — | entrada US$ 2 / leitura de cache US$ 0,1 / saída US$ 10 |
| Faixa superior na APIYI (acima de 272000 tokens de entrada) | — | entrada US$ 3; saída de aproximadamente US$ 11,25 na API de preços |
| Endpoint na APIYI | — | responses (recomendado), chat |
| Plataformas disponíveis | Canais oficiais como a Gemini API do Google AI Studio | APIYI apiyi.com e outros |
O gemini-4-neon ainda não aparece na tabela geral nem na API de preços da APIYI, ou seja, ainda não está no catálogo. Vamos colocá-lo no catálogo o quanto antes; o nome do modelo e o preço devem ser conferidos na lista de modelos da plataforma.
Detalhes da mudança de faixa do gpt-6.2-sol na APIYI
A tabela geral da APIYI (com atualização indicada na página para 2026-11-16 09:39, UTC+8) informa que a primeira faixa do gpt-6.2-sol tem entrada a US$ 2, leitura de cache a US$ 0,1 e saída a US$ 10, o que bate com o preço 2/10 da página do modelo no Artificial Analysis. Quando a entrada passa de 272000 tokens, o texto da tabela geral só diz que a entrada salta de US$ 2 para US$ 3.
A API de preços consultada em 2026-11-19 (versão shell-api-modelmak-v1, com 285 modelos no total) traz informações mais completas. Nela, model_ratio igual a 1 corresponde a uma entrada de US$ 2 por milhão de tokens, e completion_ratio igual a 5 indica que a saída é 5 vezes a entrada; acima de 272000 tokens, o CompletionRatio muda de 5 para 3.75 e, considerando a entrada de US$ 3, a saída fica em cerca de US$ 11,25 por milhão de tokens — ou seja, não continua a ser cobrada a US$ 10.
Os nomes dos grupos têm pequenas diferenças de grafia entre os dois lugares: a tabela geral lista CodexResponses, Codex_Reverse, Default e SVIP; a API de preços lista CodexResponses, CodexReverse, default e svip. Vale reforçar mais uma vez: os US$ 1,01 do Artificial Analysis são o custo do índice rateado por tarefa, e não são a mesma coisa que o custo real de tokens de uma chamada sua na plataforma.
Comparação de cenários entre Gemini 4 Neon e GPT-6.2 Sol
A seguir, listamos por tipo de tarefa os números mais relevantes, para ajudar você a relacionar a avaliação com a sua própria carga de trabalho. Qual dos dois é mais adequado depende da distribuição das suas tarefas e do orçamento; aqui fazemos apenas a comparação, sem tirar conclusões.
Números relacionados a agentes de codificação
- Rodando dentro do Google Antigravity: veja a linha do harness do fornecedor no SWE-sweep, Neon 39.0% e Sol 8.3%, e lembre-se de que o próprio Google atribui essa diferença ao harness.
- Rodando em um harness genérico: veja a linha do mini-SWE, 12.8% contra 11.6%, e também 65.2% contra 61.5% no Terminal-bench 4.1.
- Pequenas alterações de alta frequência: o tempo por tarefa é mais importante; vale comparar com o tempo gasto na mesma faixa de pontuação na tabela de níveis.
Números relacionados a gráficos e documentos longos
- Perguntas e respostas sobre gráficos financeiros e capturas de tela de dashboards: no Chartography, Sol 75.1% e Neon 73.5%; neste item a direção é oposta à da pontuação geral.
- Travessia de estruturas de grafo ou de documentos na casa de centenas de milhares de tokens: no GraphWalks, Neon 95.2% e Sol 80.1%, e é preciso incluir no custo a mudança de faixa do Sol no APIYI acima de 272000 tokens.
- Compreensão de vídeos longos: no LVBench, Neon 89.0% e Sol 87.6%, e o model card indica que o Neon aceita entrada de vídeo.
Recomendações de decisão para Gemini 4 Neon vs GPT-6.2 Sol: verifique primeiro, depois escolha
Antes de escolher, recomendo checar sua situação na ordem abaixo, em vez de decidir simplesmente com base em 61 contra 57.
- Levante a proporção de cada uma das três categorias — codificação, gráficos e contexto longo — nas suas tarefas e compare cada uma com as três tabelas detalhadas acima.
- Estime o volume médio de saída por tarefa. Os dados da Artificial Analysis mostram que a diferença de custo por tarefa entre os dois vem principalmente do volume de saída; quanto mais longa for a saída das suas tarefas, mais evidente fica essa diferença.
- Verifique se o comprimento da entrada ultrapassa 272000 tokens. Ao ultrapassar, os preços unitários de entrada e saída do
gpt-6.2-solna APIYI mudam. - Confirme o nível de raciocínio. O Neon suporta apenas quatro níveis: low, medium, high e xhigh; passar
thinking_budgetouMINIMALretorna HTTP400(guia do desenvolvedor). - Rode um pequeno lote comparativo no seu próprio conjunto de amostras, registrando pontuações, tempo de execução e uso de tokens.
💡 Recomendação de escolha: cada modelo se sai melhor em itens diferentes, e no fim tudo depende da distribuição das suas tarefas e do seu orçamento. Sugiro começar conectando o
gpt-6.2-sol, que já está disponível na APIYI apiyi.com, registrar o uso de tokens e o tempo de execução nas suas próprias amostras e, quando o Neon for lançado, rodar a comparação com o mesmo script.
Como chamar o GPT-6.2 Sol rapidamente via APIYI
O endpoint recomendado pela APIYI para gpt-6.2-sol é responses, e a base_url compatível com OpenAI é https://api.apiyi.com/v1. A integração inteira leva apenas quatro passos:
- Preparar a chave: gere uma API Key no console da plataforma, coloque na variável de ambiente
APIYI_API_KEYe leia somente a partir dela no código — nada de chave em texto plano. - Definir o endereço da requisição: o endpoint Responses é
POST https://api.apiyi.com/v1/responses, com os cabeçalhosAuthorization: Bearer $APIYI_API_KEYeContent-Type: application/json. - Montar o corpo da requisição: o corpo mínimo é
{"model": "gpt-6.2-sol", "input": "请总结这份季度报告里的三张图表"}. - Chamar com o SDK da OpenAI: inicialize
OpenAI(base_url="https://api.apiyi.com/v1", api_key=os.environ["APIYI_API_KEY"])e depois chameclient.responses.create(model="gpt-6.2-sol", input=...), lendo o resultado emoutput_textdo objeto retornado.
Se o seu código atual é baseado em Chat Completions, dá para mandar o mesmo ID de modelo para o endpoint chat, no caminho /v1/chat/completions. O protocolo nativo do Gemini usa https://api.apiyi.com com a versão v1beta e vale para os modelos Gemini já disponibilizados na plataforma.
Ao fazer testes de janela de contexto longa, uma boa dica é registrar no log, junto com cada requisição, o número de tokens de entrada — assim fica fácil saber se você passou do ponto de corte de 272000. Os valores específicos dos parâmetros de nível de raciocínio devem ser conferidos na documentação oficial da OpenAI e na página do modelo na plataforma.
🚀 Início rápido: novos usuários podem resgatar créditos de teste gratuitos em APIYI apiyi.com e usar uma única chave para chamar OpenAI, Claude, Gemini e outros modelos já disponíveis. Comece colocando o fluxo
responsesdogpt-6.2-solpara rodar; depois, para trocar de modelo, basta alterar o campomodel.
Perguntas Frequentes (FAQ)
P1: Quais são os posicionamentos do Gemini 4 Neon e do GPT-6.2 Sol, respectivamente?
O Neon é uma adaptação do Gemini 4 Carbon (model card), e o guia para desenvolvedores do Google o posiciona entre o Hydrogen (ciclo diário rápido) e o Carbon (trajetos longos e complexos). O GPT-6.2 Sol está listado na página de modelo do Artificial Analysis por 2/10 dólares, com pontuação de inteligência máxima de 57 na faixa mais alta, max.
P2: Onde se concentram principalmente os 4 pontos a mais do Neon em relação ao Sol?
Olhando os subitens do model card, as maiores diferenças estão em GraphWalks de contexto longo (95,2% contra 80,1%) e em SWE-sweep sob o harness do fabricante (39,0% contra 8,3%). No item Chartography do gráfico, o Sol é maior (75,1% contra 73,5%).
P3: Quando o Gemini 4 Neon foi lançado e em quais canais está disponível?
A data de publicação no blog do Google é 2026-11-18. Segundo o post de lançamento de Sundar Pichai, ele foi disponibilizado no mesmo dia no Gemini API do Google AI Studio, no Gemini for business, no Google Antigravity das versões pagas Google AI Pro e Ultra, e no Gemini App das versões Pro e Ultra, com o ID de modelo `gemini-4-neon`.
P4: O valor de 1,01 dólar por tarefa do Sol pode ser usado como orçamento de chamadas?
Esse número é o custo rateado por tarefa após o Artificial Analysis executar o conjunto completo de índices, e o Sol max gerou 60,9 milhões de tokens nesse teste. Seu gasto real depende da sua própria quantidade de tokens de entrada e saída e da faixa de cobrança; recomenda-se estimar por conta própria com base na primeira faixa da tabela geral da APIYI, de 2 / 0,1 / 10 dólares, e ficar atento à mudança de faixa acima de 272000 tokens.
P5: Como chamar rapidamente esses dois modelos via API?
O `gpt-6.2-sol` já está disponível na APIYI. Acesse apiyi.com, cadastre-se e resgate a cota de teste, depois defina o base_url como `https://api.apiyi.com/v1` e chame o endpoint `responses`. O `gemini-4-neon` ainda não aparece nem na tabela geral nem na interface de precificação, ou seja, ainda não foi disponibilizado; vamos disponibilizá-lo o quanto antes. O modelo e o preço têm como referência a lista de modelos da plataforma.
P6: Quais são as limitações desses dados de comparação?
Basicamente são três pontos:
– **Critério**: as pontuações do Sol no model card, segundo as notas de avaliação, são auto-relatadas pelo fabricante, e não uma reexecução no mesmo dia.
– **Faixa**: no Artificial Analysis, a faixa mais alta do Neon é xhigh, e a do Sol é max, então as faixas não são totalmente equivalentes.
– **Números inconsistentes**: o Coding Agent Index é 58,6 no blog do Google e 59 no artigo do Artificial Analysis; o WebExploitBench v1.2 aparece como 51,26% no blog e 51,3% no model card, e este artigo mantém os valores originais.
Gemini 4 Neon vs GPT-6.2 Sol: principais pontos (Key Takeaways)
- Pontuação geral: na página de modelo do Artificial Analysis, o Neon xhigh marca 61 e o Sol max, 57.
- Código: no model card, o Terminal-bench 4.1 dá 65.2% contra 61.5%; a diferença no SWE-sweep depende do harness que você olha.
- Gráficos: no Chartography o Sol é melhor, 75.1% contra 73.5%.
- Contexto longo: no GraphWalks, de 256k a 1M, o F1 é 95.2% contra 80.1% — a maior diferença de todas.
- Custo e tempo: 6.44 contra 1.01 dólares por tarefa e 21.5 contra 8.5 minutos; a razão principal é o volume de saída, que é várias vezes maior.
- Preço unitário: Neon 3/15 dólares, Sol 2/10 dólares; na APIYI, o
gpt-6.2-solmuda de faixa depois de 272000 tokens de entrada.
Resumo
Quando a gente decompõe a diferença entre o Gemini 4 Neon e o GPT-6.2 Sol, ela fica bem mais clara do que a pontuação agregada sugere:
- Código: o Neon é melhor nos subitens em que o model card traz dados, mas, no mesmo harness mini-SWE, a diferença é de apenas 1.2 ponto percentual.
- Gráficos: no Chartography o Sol fica na frente; no LVBench, é o Neon que aparece um pouco melhor.
- Contexto longo: no GraphWalks, o Neon abre 15.1 pontos percentuais de vantagem — a diferença mais evidente dos três itens.
- Custo: o preço unitário difere em 1.5 vez e o custo por tarefa em cerca de 6.4 vezes; essa ampliação vem da quantidade de tokens de saída.
A escolha depende da distribuição das suas tarefas e do comprimento das saídas. A recomendação é começar integrando o gpt-6.2-sol pela APIYI (apiyi.com), registrar consumo e tempo em amostras reais e, quando o Neon estiver disponível, completar o comparativo com o mesmo procedimento.
📚 Referências
-
Blog do Google: Apresentando o Gemini 4 Neon — anúncio oficial e benchmarks autorrelatados
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Descrição: resultados gerais, de programação, científicos e posicionamento de preços são todos autorrelatados pela própria empresa
- Link:
-
Model card do DeepMind Gemini 4 Neon — fonte da tabela comparativa em três colunas
- Link:
deepmind.google/models/model-cards/gemini-4-neon - Descrição: dados detalhados de Chartography, GraphWalks, SWE-sweep etc.
- Link:
-
Guia do desenvolvedor do Google Cloud Gemini 4 Neon — regras de janela de contexto, níveis de raciocínio e cache
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Descrição: limite unificado de 1048576 tokens, regra do HTTP 400 e explicação sobre cache implícito
- Link:
-
Página de preços do Google AI Studio — preço unitário oficial do Neon
- Link:
aistudio.google.com/docs/pricing - Descrição: entrada US$ 3, saída US$ 15, cache US$ 0.15 por milhão de tokens
- Link:
-
Página do modelo no Artificial Analysis — dados de Neon e Sol por faixa
- Link:
artificialanalysis.ai/models/gemini-4-neon,artificialanalysis.ai/models/gpt-6-2-sol - Descrição: pontuação de inteligência, custo por tarefa, tempo e velocidade de saída
- Link:
-
Artigo do Artificial Analysis — interpretação das medições de terceiros do Neon
- Link:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Descrição: dados como Coding Agent Index 59 etc.
- Link:
-
Tabela geral e endpoint de preços da APIYI — modelos já disponibilizados e preços escalonados
- Link:
docs.apiyi.com/models.md,api.apiyi.com/api/pricing - Descrição: primeira faixa de
gpt-6.2-sole regra de mudança de faixa em 272000 tokens
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: Sinta-se à vontade para nos contatar pela página inicial do site APIYI. Para mais modelos e instruções de acesso, visite o centro de documentação em docs.apiyi.com.