Кратко: в этой статье мы через OpenAI Python SDK вызываем Tencent Hunyuan Hy4 API в непотоковом режиме, проходим первый чисто текстовый запрос и разбираем, как проверить результат, прикинуть расходы, сверять счёт и что делать с типичными ошибками.
Прямой ответ: к Tencent Hunyuan Hy4 API можно подключиться через OpenAI-совместимый интерфейс APIYI. Чтобы отправить первый запрос, достаточно трёх настроек:
- Ключ: создайте на
api.apiyi.com/tokenи положите в переменную окруженияAPIYI_API_KEY. - Base URL для SDK:
https://api.apiyi.com/v1. - ID модели:
hy4.
Соответствующий HTTP-эндпоинт — POST https://api.apiyi.com/v1/chat/completions. По состоянию на 2026-11-21 цены Hy4 в таблице такие (за миллион токенов): вход без попадания в кеш — $0.85, выход — $2.55, чтение из кеша — $0.045. Реальное списание считается по таблице цен APIYI, адрес — docs.apiyi.com/models (раздел Tencent).
Хронология: 4 ноября Tencent выпустила финальную версию Hy4, 20 ноября открыла веса. APIYI добавила эту модель в каталог ещё до открытия весов, анонс — docs.apiyi.com/news/hy4-launch. В анонсе уже есть пример со стримингом, так что здесь мы разберём четыре другие вещи: вызов без стриминга, приёмку результата, сверку счёта и разбор сбоев. В анонсе упоминается, что Hy4 принимает изображения на входе, — здесь мы показываем только текст. Видео, интерфейс Responses и Computer Use в статью не входят, и никаких собственных замеров в ней нет.
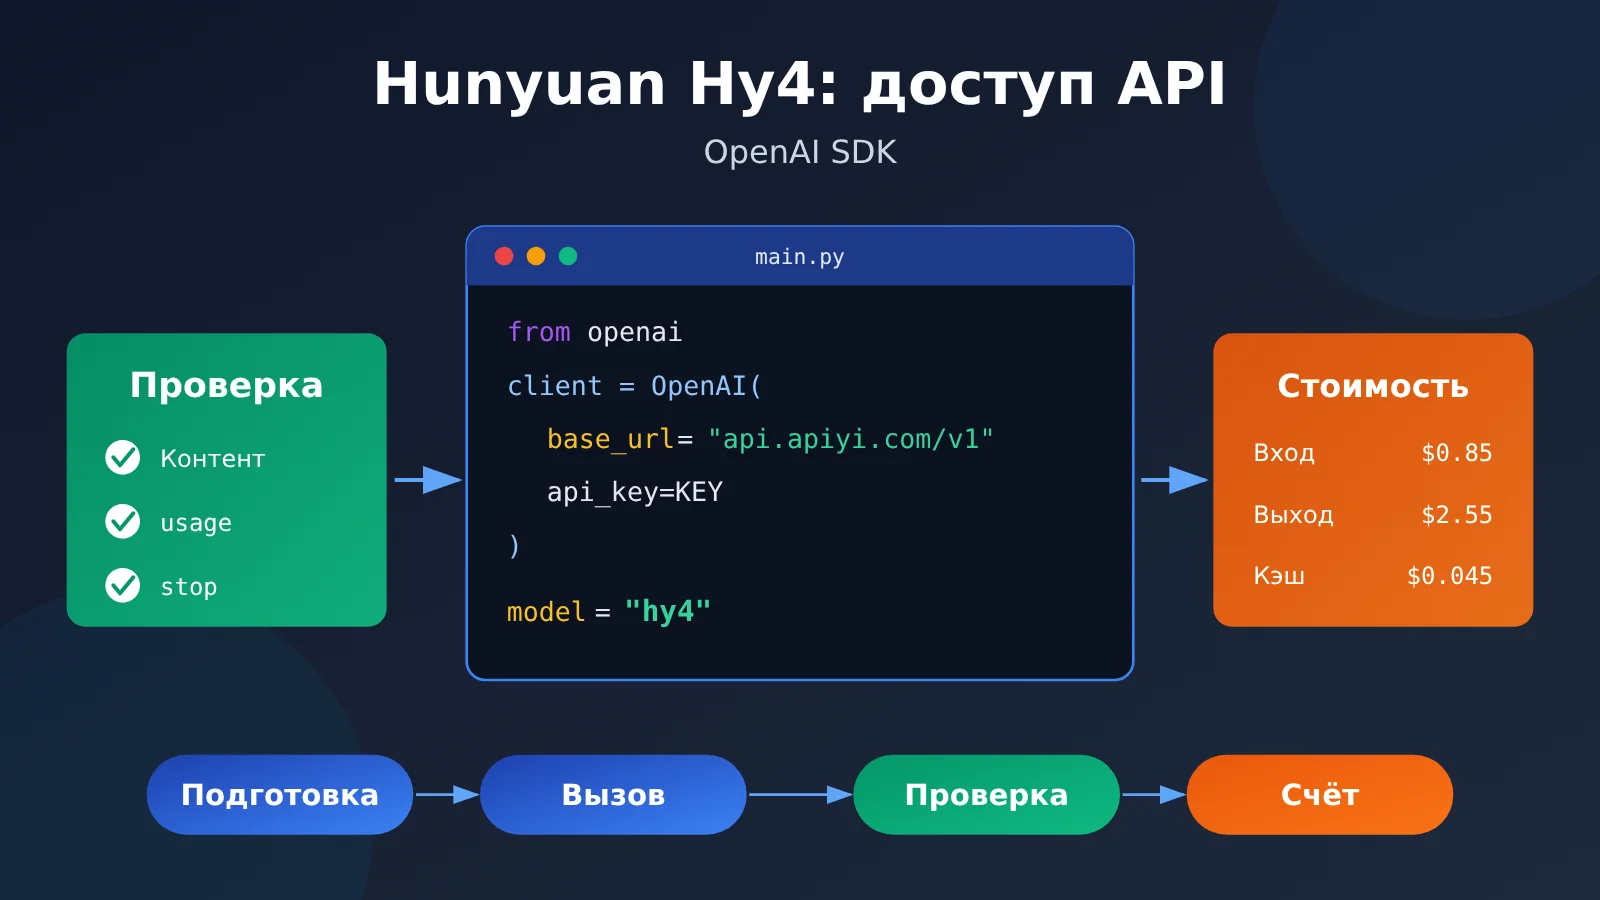
Карта знаний и порядок чтения для подключения API Tencent Hunyuan Hy4
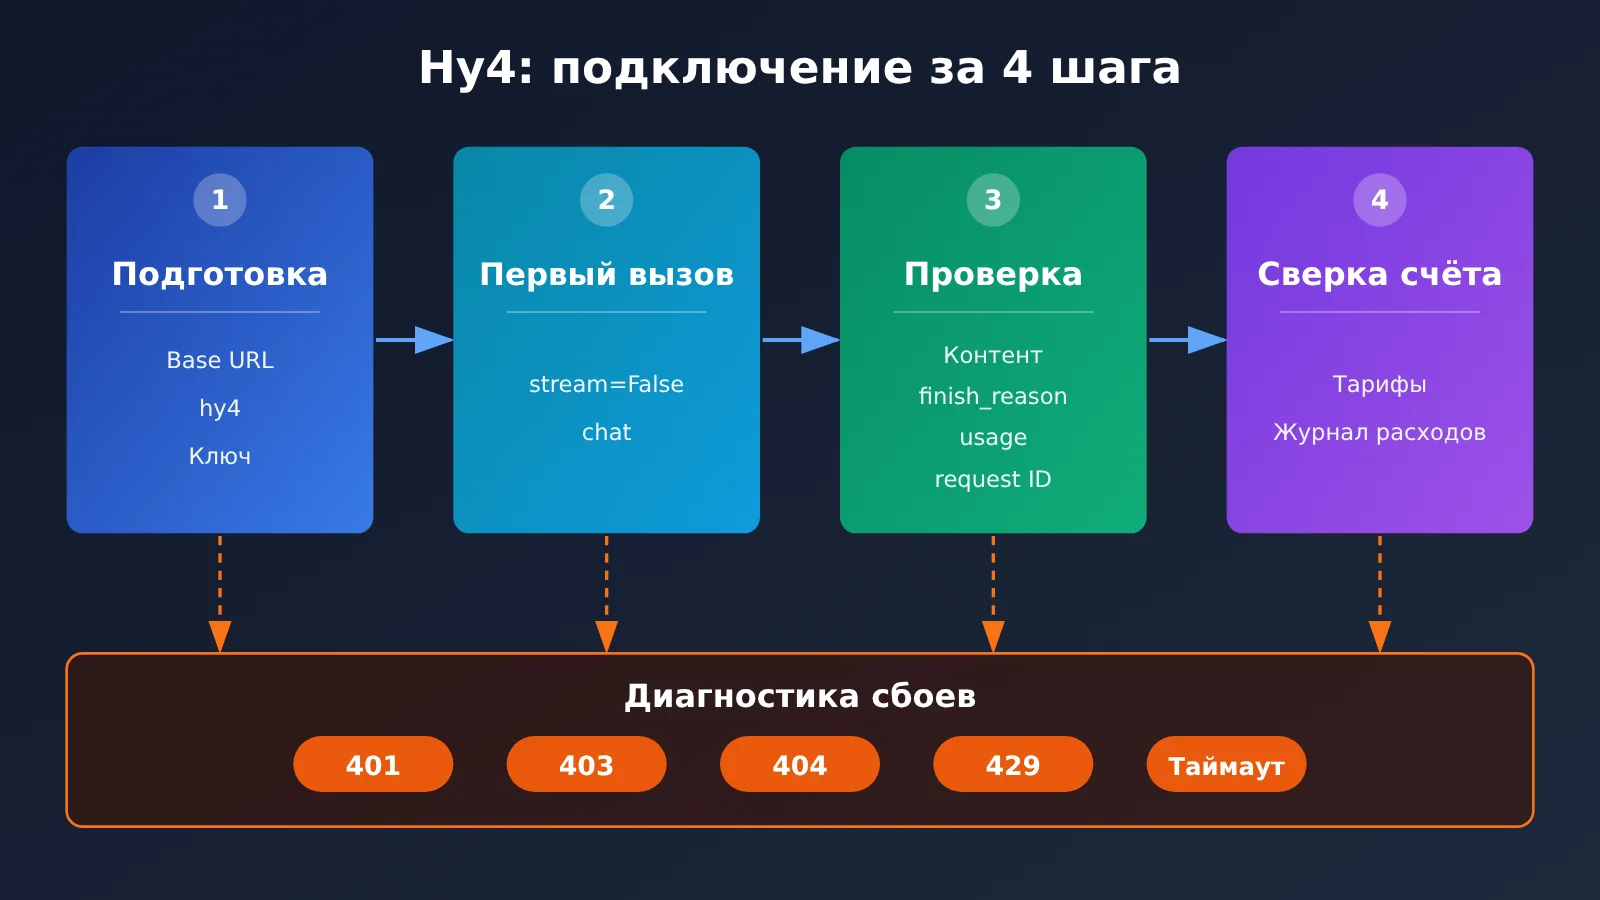
Весь процесс состоит из четырёх шагов: результат предыдущего шага становится входными данными для следующего. Рекомендую читать по порядку номеров. Раздел 4 можно отдельно открыть при возникновении ошибки.
| Шаг | Соответствующий раздел | Зачем этот шаг здесь | Критерий готовности |
|---|---|---|---|
| Подготовка запроса | 1.1, 1.2 | Если ошибка в эндпоинте, имени модели или API-ключе, все последующие шаги провалятся | SDK импортируется, API-ключ читается из переменной окружения, в коде нет ключа в открытом виде |
| Первый вызов | 2.1, 2.2 | Сначала отправьте короткий текст без клиентских данных и убедитесь, что цепочка работает | В ответе есть «product=Hunyuan, version=Hy4», ответ не обрезан, а usage и request ID сохранены |
| Сверка счёта | 3.1, 3.2 | Когда цепочка работает, оцените стоимость, чтобы понять, можно ли увеличивать объём вызовов | Оценка построчно совпадает с журналом расходов в консоли |
| Разбор ошибок | 4 | Если любой шаг завершился ошибкой, определяйте причину по коду и телу ошибки | Уметь различать ошибку конфигурации, проблему с правами, ограничение частоты и таймаут, а также решать, можно ли повторять запрос |
Что стоит знать: термины, связанные с API Hy4
| Термин | Краткое объяснение |
|---|---|
| Без потоковой передачи (stream=False) | Модель завершает генерацию и сразу возвращает полный результат — так удобнее проверять содержимое и расход токенов |
| finish_reason | Причина завершения генерации. stop означает нормальное завершение, length — достигнут лимит длины и ответ обрезан |
| usage | Поле с расходом токенов в ответе; обычно есть prompt_tokens (вход) и completion_tokens (выход) |
| request ID | Идентификатор отдельного запроса, по нему можно найти этот вызов в логах. Присутствует не в каждом ответе |
| Чтение из кэша | Часть входных данных, попавшая в кэш; тарифицируется по отдельной цене за чтение из кэша |
| Группа (Default/SVIP) | Группа, к которой относится токен; она определяет, какие модели доступны этому токену |
1. Подготовка запроса к API Tencent Hunyuan Hy4
1.1 Настройка модели Hy4 и эндпоинта
Сначала проверьте по пунктам все параметры конфигурации. Большинство провалов при первом вызове случается именно на этом шаге.
| Параметр | Значение | Описание |
|---|---|---|
| SDK base_url | https://api.apiyi.com/v1 |
Пишем только до /v1, SDK сам допишет /chat/completions |
| HTTP-эндпоинт | POST https://api.apiyi.com/v1/chat/completions |
Этот адрес нужен, если вы не используете SDK и отправляете HTTP-запросы напрямую |
| ID модели | hy4 |
Имя модели официальной версии, заполняется строчными буквами как есть |
| Доступные группы | Default, SVIP | Группа, в которой находится токен, должна включать Hy4 |
| Способ вывода | stream=False |
Во всей статье используется нестриминговый режим |
Самая частая ошибка — вписать в base_url полный эндпоинт. SDK ещё раз допишет к этому адресу /chat/completions, путь задвоится, и в ответ придёт 404. Полное описание совместимого интерфейса — в docs.apiyi.com/api-capabilities/openai/compatible.
1.2 Установка OpenAI SDK и безопасное хранение ключа
Официальный Python SDK лежит на github.com/openai/openai-python. Ставьте его в виртуальное окружение, чтобы не конфликтовать с версиями пакетов, уже установленных в системе:
python -m venv .venv
source .venv/bin/activate          # В Windows: .venv\Scripts\activate
python -m pip install openai
Ключ создаётся на api.apiyi.com/token. При создании убедитесь, что группа токена имеет доступ к Hy4. Получив ключ, запишите его в переменную окружения текущего терминала, а не в файл с кодом:
export APIYI_API_KEY="你的令牌" # Windows PowerShell: $env:APIYI_API_KEY="你的令牌"
При работе с ключом держите в голове несколько правил:
- Код читает ключ только через
os.environ['APIYI_API_KEY']. Если переменная окружения не задана, ключ вводится интерактивно черезgetpass— введённое не отображается на экране. - Если храните ключ в файле
.env, добавьте его в.gitignore, чтобы случайно не отправить в репозиторий. - Когда ключ попадает на скриншот, в лог или в тикет, сначала замените его маской вроде
sk-***.
Проверка: выполните в терминале python -c "import openai, os; print(openai.__version__, bool(os.environ.get('APIYI_API_KEY')))". Если выводятся номер версии и True — значит этот шаг пройден.
2. Отправляем первый запрос к Hy4 через OpenAI SDK
2.1 Полный пример на Python без стриминга
Первый запрос делает только одну простую вещь: вытаскивает название продукта и номер версии из одной публичной фразы — никаких клиентских данных. У такого дизайна два плюса. Во-первых, ответ короткий, а значит, и стоит копейки. Во-вторых, правильный ответ ровно один, так что легко понять, угадала модель или нет.
import os
import re
from getpass import getpass
from openai import OpenAI

key = os.environ.get("APIYI_API_KEY") or getpass("输入 APIYI_API_KEY:")

PROMPT = "仅从这句话提取产品和版本:腾讯混元 Hy4 正式版已上线。请只写一行:产品=…;版本=…"

with OpenAI(
    base_url="https://api.apiyi.com/v1",   # OpenAI-совместимый интерфейс APIYI
    api_key=key,
    timeout=60.0,
    max_retries=0,                         # отключаем авторетраи: при сбое человек сам решает, отправлять ли повторно
) as client:
    result = client.chat.completions.create(
        model="hy4",
        messages=[{"role": "user", "content": PROMPT}],
        stream=False,
    )

request_id = getattr(result, "_request_id", None)
print("request_id:", request_id if request_id else "响应未提供")

if not result.choices:
    raise SystemExit("未通过:choices 为空,没有返回正文")

choice = result.choices[0]
content = (choice.message.content or "").strip()
print("finish_reason:", choice.finish_reason)
print("content:", content)

usage = getattr(result, "usage", None)
prompt_tokens = getattr(usage, "prompt_tokens", None) if usage else None
completion_tokens = getattr(usage, "completion_tokens", None) if usage else None
print("prompt_tokens:", prompt_tokens if prompt_tokens is not None else "缺失(不按 0 处理)")
print("completion_tokens:", completion_tokens if completion_tokens is not None else "缺失(不按 0 处理)")


def accept(text: str, finish_reason) -> tuple[bool, str]:
    if not text:
        return False, "正文为空"
    if finish_reason == "length":
        return False, "输出被截断"
    t = re.sub(r"\s+", "", text)
    t = t.replace(":", "=").replace(":", "=").replace(";", ";")
    prod = re.search(r"产品=([^;\n]+)", t)
    ver = re.search(r"版本=([^;\n]+)", t)
    if not prod or not ver:
        return False, "缺少产品或版本字段"
    strip_punct = lambda s: re.sub(r"[。..,,、!!??\"“”'‘’]", "", s)
    if "混元" not in strip_punct(prod.group(1)):
        return False, f"产品值错误:{prod.group(1)}"
    if strip_punct(ver.group(1)) != "Hy4":
        return False, f"版本值错误:{ver.group(1)}"
    return True, "通过"


ok, reason = accept(content, choice.finish_reason)
print("验收:", reason)
Пара настроек из примера заслуживает пояснения:
max_retries=0отключает автоматические повторы в SDK. В разделе 4 расскажем почему: после таймаута сервер вполне может уже выполнить запрос, и автоматическая повторная отправка приведёт к двойной оплате. Так что решение о повторе должен принимать человек.- Конструкция
withзакрывает соединение после завершения вызова. - Если поле usage отсутствует, код явно печатает «отсутствует», а не подставляет 0 — чтобы потом при подсчёте расходов ничего не потерялось.
Подробнее о структуре ответа — в docs.apiyi.com/api-capabilities/openai/response-handling.
2.2 Критерии приёмки первого запроса Hy4
При приёмке смотрим только на два поля в message.content: значение продукта должно содержать «混元», значение версии — «Hy4». Различия в полноширинных или полуширинных двоеточиях, точках с запятой и знаках препинания в конце предложения допустимы. Ниже — пример строки, удовлетворяющей требованиям, это иллюстративный формат, а не реальный ответ:
产品=腾讯混元;版本=Hy4
Следующие случаи всегда считаются непройденными — нельзя пропускать их только потому, что «выглядит примерно похоже»:
| Случай | Вердикт | Причина |
|---|---|---|
choices пуст или content — пустая строка |
Не пройдено | Основной текст не получен, значит, вся цепочка так и не заработала |
finish_reason равен length |
Не пройдено | Вывод обрезан, результат неполный |
| Версия указана как Hy3, Hunyuan или другое значение | Не пройдено | Неверное значение поля |
| Отличаются только пунктуация, пробелы или полноширинность/полуширинность двоеточия | Пройдено | Это допустимое различие в форматировании |
После успешного прохождения приёмки запишите request ID (если он есть в ответе), время запроса, имя модели, prompt_tokens и completion_tokens. Эти сведения понадобятся при сверке счёта в разделе 3.2.
3. Оцениваем и сверяем расходы на Hy4 API
3.1. Оценка стоимости одной пакетной задачи по тарифной таблице
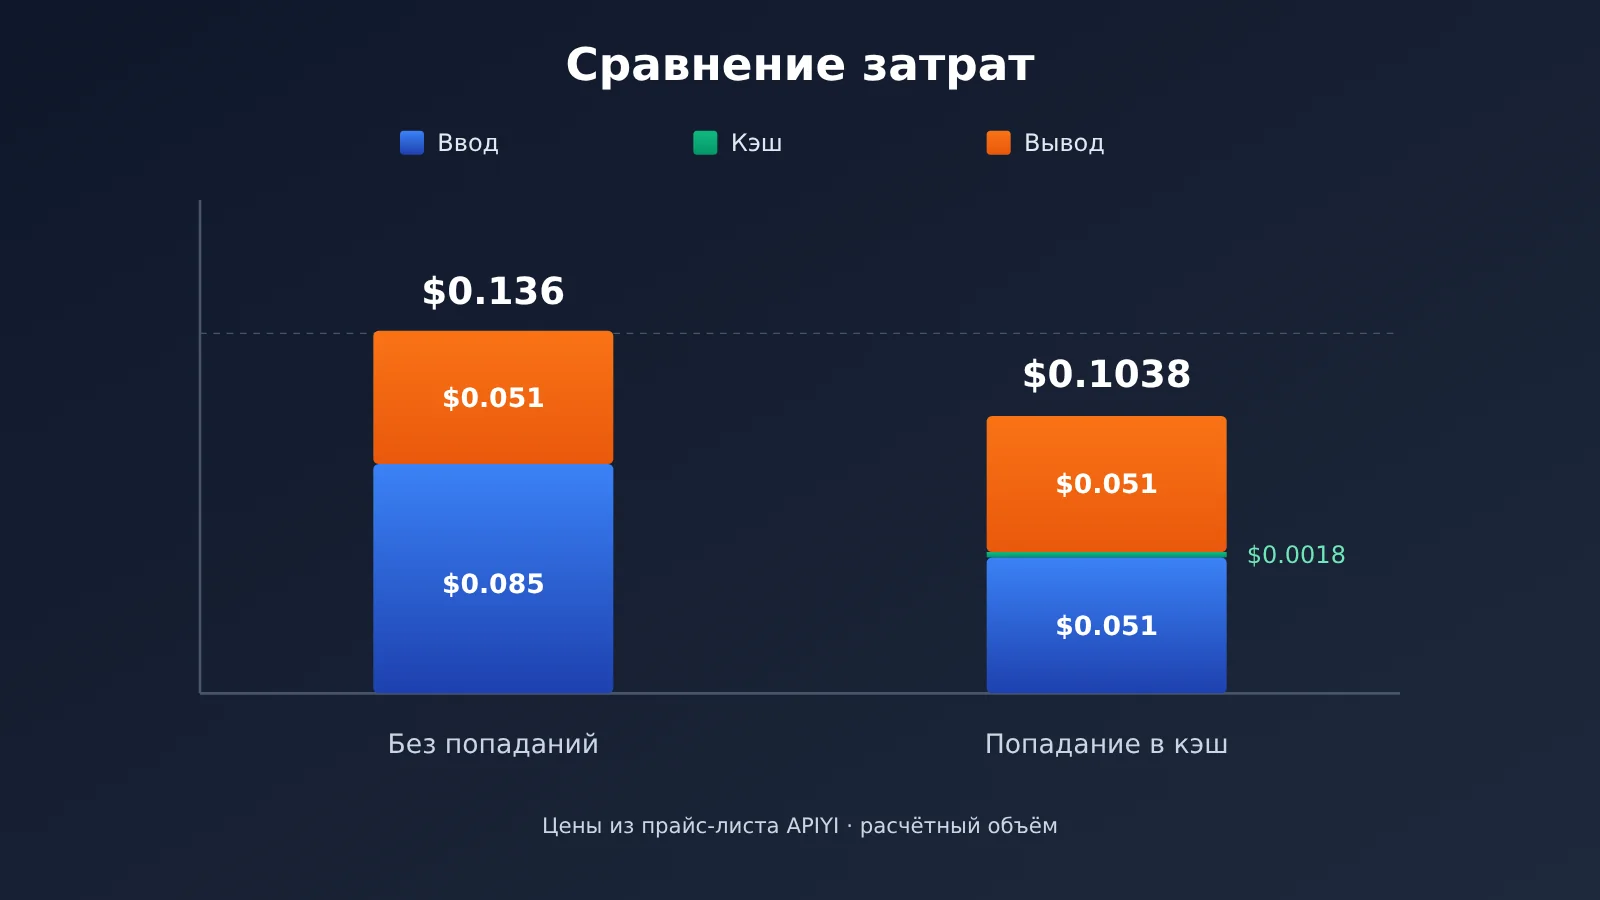
Входные данные первого запроса совсем короткие, затраты на них пренебрежимо малы, так что оценивать по нему стоимость бессмысленно. Возьмём вместо этого гипотетический сценарий, никак не связанный с коротким примером из предыдущего раздела: в одной задаче на вход подаётся 100 000 токенов, все они не попадают в кэш, а на выходе получается 20 000 токенов. Вход и выход считаем по отдельным ценам:
| Статья тарификации | Предполагаемый объём | Цена (за миллион токенов) | Стоимость |
|---|---|---|---|
| Входные токены без попадания в кэш | 100,000 | $0.85 | $0.085 |
| Выходные токены | 20,000 | $2.55 | $0.051 |
| Итого | — | — | $0.136 |
Расчёт такой: 0.1 × 0.85 + 0.02 × 2.55 = 0.136. При оценке важно помнить о двух моментах:
- Цена выходных токенов втрое выше цены входных токенов без попадания в кэш. В задачах с большим объёмом выхода именно выход определяет основную часть затрат.
- Если
completion_tokensуже включают в себя «размышления» модели, не добавляйте отдельно стоимость этих размышлений — иначе получите двойной учёт.
3.2. Разделяем кэшируемую часть и реальный журнал расходов
«Чтение из кэша» — отдельная статья тарификации, но в разных ответах поля могут разбиваться по-разному, поэтому универсального имени поля, гарантирующего точный результат, нет. Надёжный путь — сначала убедиться по счёту: входят ли токены, попавшие в кэш, в общий объём входных токенов.
Если счёт подтверждает, что кэшируемая часть уже включена в общий вход, вычтите её из общего объёма входа один раз и считайте по отдельным ценам. Ниже продолжаем гипотезу из 3.1 и дополнительно предполагаем, что из 100 000 входных токенов 40 000 попали в кэш:
| Статья тарификации | Предполагаемый объём | Цена (за миллион токенов) | Стоимость |
|---|---|---|---|
| Входные токены без попадания в кэш | 60,000 | $0.85 | $0.051 |
| Чтение из кэша | 40,000 | $0.045 | $0.0018 |
| Выходные токены | 20,000 | $2.55 | $0.051 |
| Итого | — | — | $0.1038 |
Оценка — это лишь ориентир, окончательные цифры берутся из журнала расходов. Проверять так: в консоли api.apiyi.com/log отфильтруйте нужные записи:
- Сузьте диапазон по времени запроса.
- Если в ответе есть request ID, используйте его, чтобы точно найти именно этот запрос.
- Убедитесь, что модель —
hy4, а токен совпадает с тем, который реально использовался в коде. - Сравните в журнале объёмы входных, кэшируемых и выходных токенов, а также списанную сумму — сходятся ли они с вашей оценкой.
Что означают конкретные поля журнала, описано здесь: docs.apiyi.com/faq/log-billing-explained.
4. Диагностика ошибок API Hy4
При диагностике сначала смотрите на HTTP-статус, а затем читайте конкретные сведения в теле ошибки. Ориентироваться только на статус-код легко ошибиться: например, у одного и того же 429 причины могут быть совершенно разными. В месте исходного запроса из раздела 2.1 перехватывайте исключения SDK: при таймауте соединения смотрите APITimeoutError, при других сбоях соединения — APIConnectionError; при получении ответа с ошибкой из APIStatusError записывайте status_code, request_id и тело ошибки. Сначала определите результат текущего запроса, а затем решайте, стоит ли повторять; перед отправкой отчёта обезличьте тело ошибки. Порядок действий такой:
| Ошибка | Что проверить в первую очередь | Повторять? |
|---|---|---|
| 401 | Правильность ключа, не истёк ли он, и равен ли base_url https://api.apiyi.com/v1 |
Не повторяйте до исправления конфигурации |
| 403 | По телу ошибки определить, не связана ли она с правами группы; убедиться, что группа токена включает Hy4 | Не повторяйте до исправления прав |
| 404 | Не дублируется ли в пути /chat/completions, и указано ли имя модели hy4 |
Не повторяйте до исправления конфигурации |
| 429 | По телу ошибки определить, это временное ограничение скорости или нехватка квоты | При временном ограничении можно ограниченное число раз повторить с задержкой; при нехватке квоты сначала пополните баланс или измените квоту |
| Ошибка соединения | В порядке ли сеть, прокси и DNS, а также правильны ли протокол и домен в base_url | Можно повторить после восстановления сети |
| Таймаут | Сначала найти в api.apiyi.com/log по времени и проверить, выполнен ли запрос |
Если выполнен — не отправляйте повторно; если нет — повторите |
Отдельно стоит пояснить два случая: 429 и таймаут:
- Повтор с задержкой при 429: применим только к временному ограничению скорости. Число повторов нужно ограничить, а интервал каждый раз постепенно увеличивать. При нехватке квоты сколько раз ни повторяй, успеха не будет.
- Таймаут: если клиент не получил ответ в течение 60 секунд, это не значит, что сервер не обработал запрос. Если сервер уже закончил обработку, повторная отправка выполнит запрос ещё раз и спишет деньги ещё раз. Поэтому сначала проверьте журнал и убедитесь, что запрос не выполнялся, и только потом отправляйте снова.
Если нужно обратиться в техподдержку, перед отправкой обезличьте чувствительные данные в теле ошибки и журналах — ключи, данные клиентов и т. п., — а затем приложите статус-код, время запроса, имя модели и request ID. Как хранить и отправлять информацию об ошибках, см. в docs.apiyi.com/api-manual/error-reporting.
После завершения всей диагностики повторно запустите пример из раздела 2.1. Весь процесс считается успешным только при одновременном выполнении трёх условий:
- Функция проверки выводит «通过».
- finish_reason не равен
length. - В журнале консоли есть запись с тем же временем и моделью
hy4, а расход совпадает с usage, записанным локально.