摘要:本文用 OpenAI Python SDK 以非流式方式调用腾讯混元 Hy4 API,跑通第一个纯文本请求,并说明怎样验收结果、估算费用、核对账单和处理常见报错。
直接答案:腾讯混元 Hy4 API 可以通过 API易 的 OpenAI 兼容接口接入。准备三项配置即可发出首个请求:
- Key:在
api.apiyi.com/token创建,放在环境变量APIYI_API_KEY中。 - SDK Base URL:
https://api.apiyi.com/v1。 - 模型 ID:
hy4。
对应的 HTTP 端点是 POST https://api.apiyi.com/v1/chat/completions。截至 2026-11-21,定价表中 Hy4 每百万 token 的价格为:未命中缓存的输入 $0.85,输出 $2.55,缓存读取 $0.045。实际计费以 API易 定价表为准,地址是 docs.apiyi.com/models(腾讯分类)。
时间线如下:腾讯在 11 月 4 日发布 Hy4 正式版,11 月 20 日开放权重。API易 在权重开放之前已经上架该型号,上架公告见 docs.apiyi.com/news/hy4-launch。公告中已有流式示例,所以本文只讲另外四件事:非流式调用、结果验收、账单核对和失败排障。公告提到 Hy4 支持图片输入,本文只演示纯文本。视频、Responses 接口和 Computer Use 都不在本文范围内,文中也没有任何实测数据。
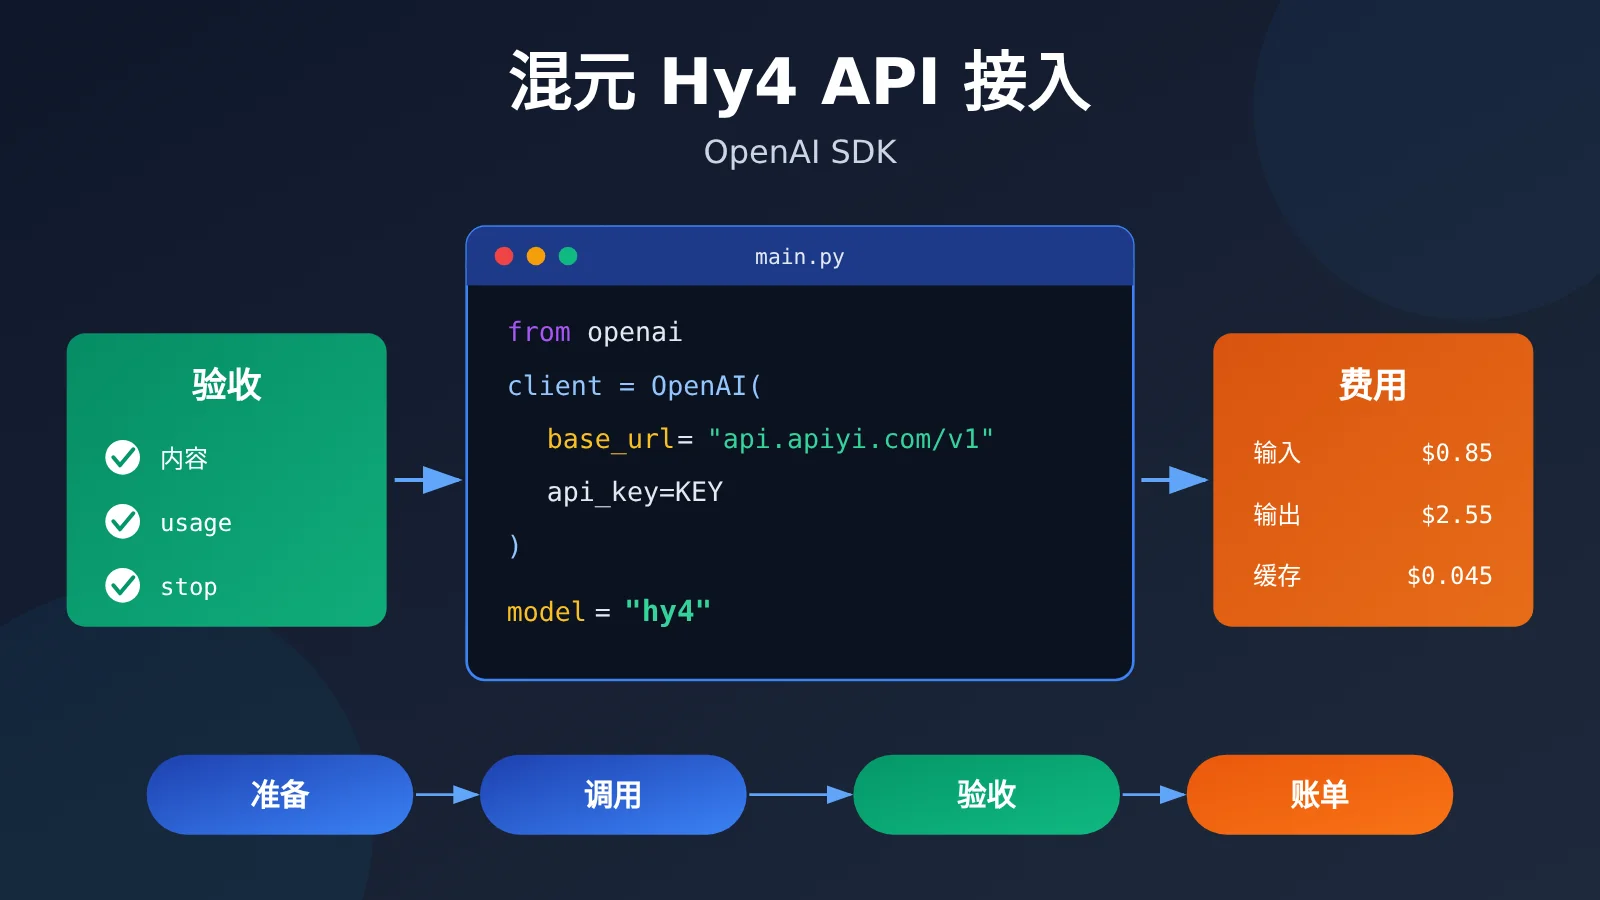
腾讯混元 Hy4 API 接入的知识地图与阅读顺序
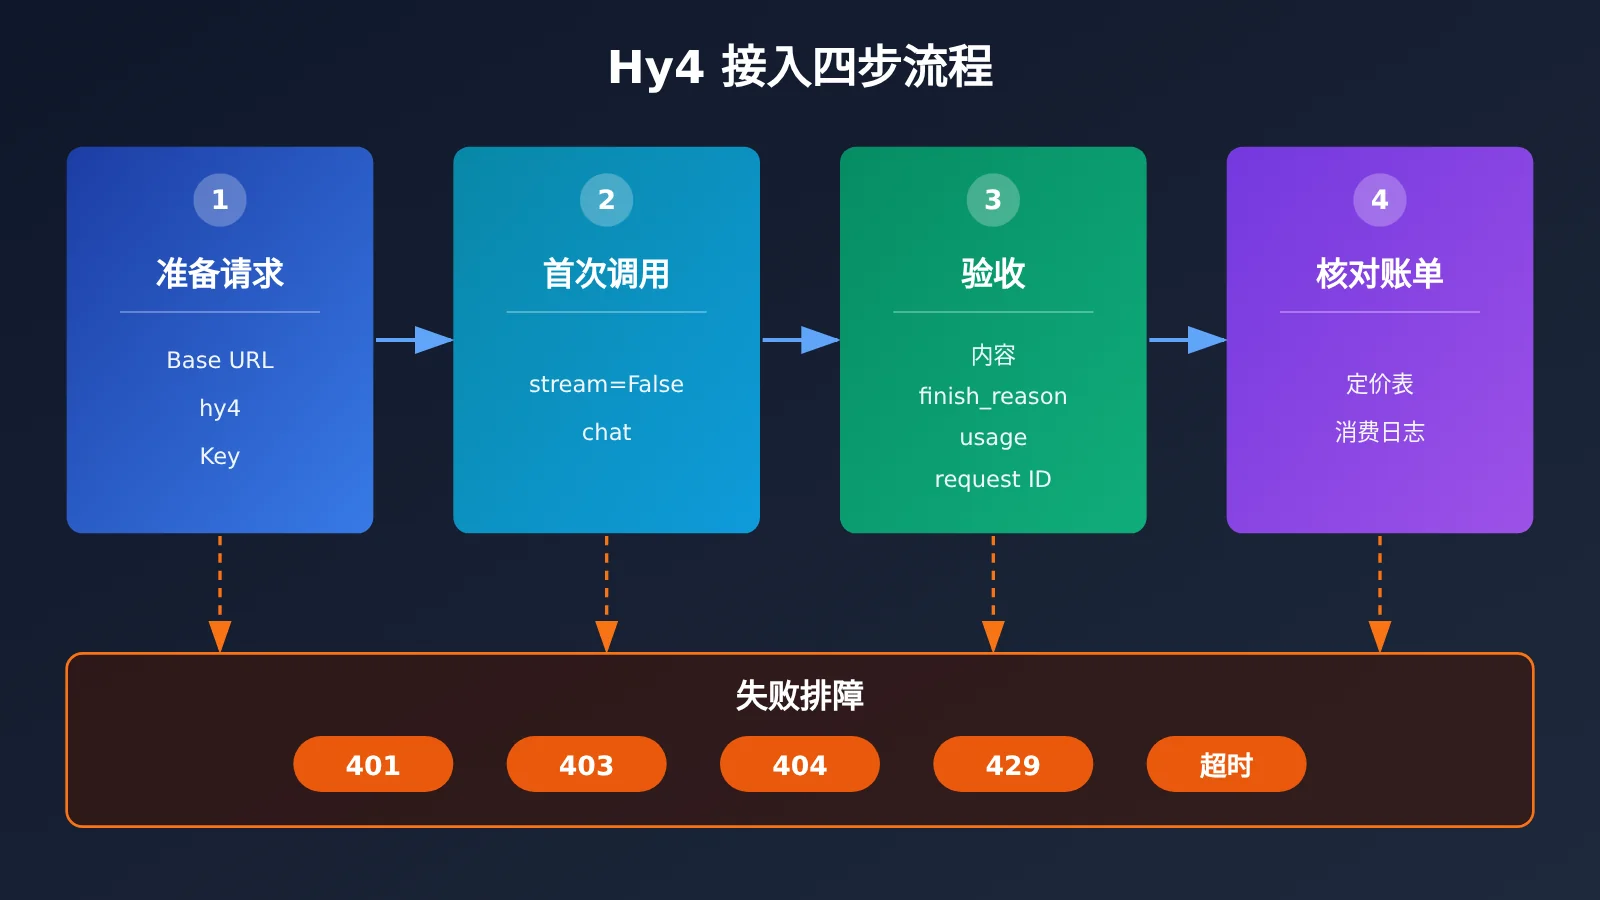
整个流程分四步,前一步的产出就是后一步的输入。建议按编号顺序阅读。第 4 节可以在报错时单独查阅。
| 步骤 | 对应正文 | 为什么放在这里 | 验收标准 |
|---|---|---|---|
| 准备请求 | 1.1、1.2 | 端点、模型名和 Key 写错,后面的步骤都会失败 | SDK 能导入,环境变量能读到 Key,代码里没有明文 Key |
| 首次调用 | 2.1、2.2 | 先用一条不含客户数据的短文本确认链路通了 | 返回内容为“产品=混元、版本=Hy4”,没有截断,并保存了 usage 和 request ID |
| 核对账单 | 3.1、3.2 | 链路通了以后再估算成本,用来判断能否放大调用量 | 估算值与控制台消费日志能逐项对上 |
| 失败排障 | 4 | 任一步失败时,按错误码和错误体定位原因 | 能分清配置错误、权限问题、限流和超时,并判断是否可以重试 |
To Know:Hy4 API 相关术语
| 术语 | 简明解释 |
|---|---|
| 非流式(stream=False) | 模型生成完毕后一次性返回完整结果,便于整体检查内容和用量 |
| finish_reason | 本次生成结束的原因。stop 表示正常结束,length 表示达到长度上限被截断 |
| usage | 响应中的 token 用量字段,常见的有 prompt_tokens(输入)和 completion_tokens(输出) |
| request ID | 单次请求的标识,用于在日志中定位这次调用。并非每次响应都一定带有 |
| 缓存读取 | 输入中命中缓存的部分,按单独的缓存读取价计费 |
| 分组(Default/SVIP) | 令牌所属的分组,决定这个令牌可以调用哪些模型 |
1. 准备腾讯混元 Hy4 API 请求
1.1 配置 Hy4 模型与端点
请先把配置项逐一核对清楚。大部分首次调用失败都出在这一步。
| 配置项 | 取值 | 说明 |
|---|---|---|
| SDK base_url | https://api.apiyi.com/v1 |
只写到 /v1,SDK 会自动拼接 /chat/completions |
| HTTP 端点 | POST https://api.apiyi.com/v1/chat/completions |
不使用 SDK、直接发 HTTP 请求时用这个地址 |
| 模型 ID | hy4 |
正式版的型号名,按小写原样填写 |
| 可用分组 | Default、SVIP | 令牌所在分组需要包含 Hy4 |
| 输出方式 | stream=False |
本文全程使用非流式 |
最常见的错误是把完整端点填进了 base_url。SDK 会在这个地址后面再拼一次 /chat/completions,导致路径重复,最后返回 404。兼容接口的完整说明见 docs.apiyi.com/api-capabilities/openai/compatible。
1.2 安装 OpenAI SDK 并安全保存 Key
官方 Python SDK 的项目地址是 github.com/openai/openai-python。建议在虚拟环境中安装,避免和系统中已有的包版本冲突:
python -m venv .venv
source .venv/bin/activate          # Windows: .venv\Scripts\activate
python -m pip install openai
Key 在 api.apiyi.com/token 创建。创建时请确认令牌所属分组可以调用 Hy4。拿到 Key 后写入当前终端的环境变量,不要写进代码文件:
export APIYI_API_KEY="你的令牌" # Windows PowerShell: $env:APIYI_API_KEY="你的令牌"
管理 Key 时注意以下几点:
- 代码只通过
os.environ['APIYI_API_KEY']读取 Key。没有设置环境变量时,用getpass交互输入,输入内容不会回显在屏幕上。 - 如果用
.env文件保存 Key,要把它加入.gitignore,避免提交到仓库。 - 截图、日志或工单中出现 Key 时,先替换成
sk-***之类的掩码。
验收:在终端运行 python -c "import openai, os; print(openai.__version__, bool(os.environ.get('APIYI_API_KEY')))"。输出版本号和 True,说明这一步完成了。
2. 用 OpenAI SDK 发出首个 Hy4 请求
2.1 完整非流式 Python 示例
这个首次请求只做一件简单的事:从一句公开的话中提取产品名和版本号,不含任何客户数据。这样设计有两个好处。一是输出很短,成本低。二是答案唯一,容易判断对错。
import os
import re
from getpass import getpass
from openai import OpenAI

key = os.environ.get("APIYI_API_KEY") or getpass("输入 APIYI_API_KEY:")

PROMPT = "仅从这句话提取产品和版本:腾讯混元 Hy4 正式版已上线。请只写一行:产品=…;版本=…"

with OpenAI(
    base_url="https://api.apiyi.com/v1",   # API易 OpenAI 兼容接口
    api_key=key,
    timeout=60.0,
    max_retries=0,                         # 关闭自动重试,失败时由人工判断是否重发
) as client:
    result = client.chat.completions.create(
        model="hy4",
        messages=[{"role": "user", "content": PROMPT}],
        stream=False,
    )

request_id = getattr(result, "_request_id", None)
print("request_id:", request_id if request_id else "响应未提供")

if not result.choices:
    raise SystemExit("未通过:choices 为空,没有返回正文")

choice = result.choices[0]
content = (choice.message.content or "").strip()
print("finish_reason:", choice.finish_reason)
print("content:", content)

usage = getattr(result, "usage", None)
prompt_tokens = getattr(usage, "prompt_tokens", None) if usage else None
completion_tokens = getattr(usage, "completion_tokens", None) if usage else None
print("prompt_tokens:", prompt_tokens if prompt_tokens is not None else "缺失(不按 0 处理)")
print("completion_tokens:", completion_tokens if completion_tokens is not None else "缺失(不按 0 处理)")


def accept(text: str, finish_reason) -> tuple[bool, str]:
    if not text:
        return False, "正文为空"
    if finish_reason == "length":
        return False, "输出被截断"
    t = re.sub(r"\s+", "", text)
    t = t.replace(":", "=").replace(":", "=").replace(";", ";")
    prod = re.search(r"产品=([^;\n]+)", t)
    ver = re.search(r"版本=([^;\n]+)", t)
    if not prod or not ver:
        return False, "缺少产品或版本字段"
    strip_punct = lambda s: re.sub(r"[。..,,、!!??\"“”'‘’]", "", s)
    if "混元" not in strip_punct(prod.group(1)):
        return False, f"产品值错误:{prod.group(1)}"
    if strip_punct(ver.group(1)) != "Hy4":
        return False, f"版本值错误:{ver.group(1)}"
    return True, "通过"


ok, reason = accept(content, choice.finish_reason)
print("验收:", reason)
示例中的几项设置需要说明:
max_retries=0关闭了 SDK 的自动重试。第 4 节会讲到,超时以后服务端可能已经执行完请求,自动重发可能造成重复计费,所以重试与否要由人来判断。with语句会在调用结束后关闭连接。- usage 字段缺失时,代码明确打印“缺失”,不会当作 0 处理,避免后面算账时漏掉费用。
响应结构的更多说明见 docs.apiyi.com/api-capabilities/openai/response-handling。
2.2 首次 Hy4 请求的验收标准
验收时只看 message.content 中的两个字段:产品值包含“混元”,版本值是“Hy4”。全角或半角的冒号、分号,以及句末标点的差异都可以接受。下面是一行符合要求的输出,这是示意格式,不是实测回包:
产品=腾讯混元;版本=Hy4
以下几种情况一律判为不通过,不能因为“看起来差不多”就放行:
| 情况 | 判定 | 原因 |
|---|---|---|
| choices 为空,或 content 为空字符串 | 不通过 | 没有拿到正文,说明链路并没有真正跑通 |
finish_reason 为 length |
不通过 | 输出被截断,结果不完整 |
| 版本写成 Hy3、Hunyuan 等其他值 | 不通过 | 字段值错误 |
| 只有标点、空格或冒号的全半角不同 | 通过 | 属于允许的格式差异 |
验收通过后,把 request ID(如果响应中有)、请求时间、模型名、prompt_tokens 和 completion_tokens 记录下来。3.2 节核对账单时会用到这些信息。
3. 估算并核对 Hy4 API 费用
3.1 按定价表估算一次批量任务
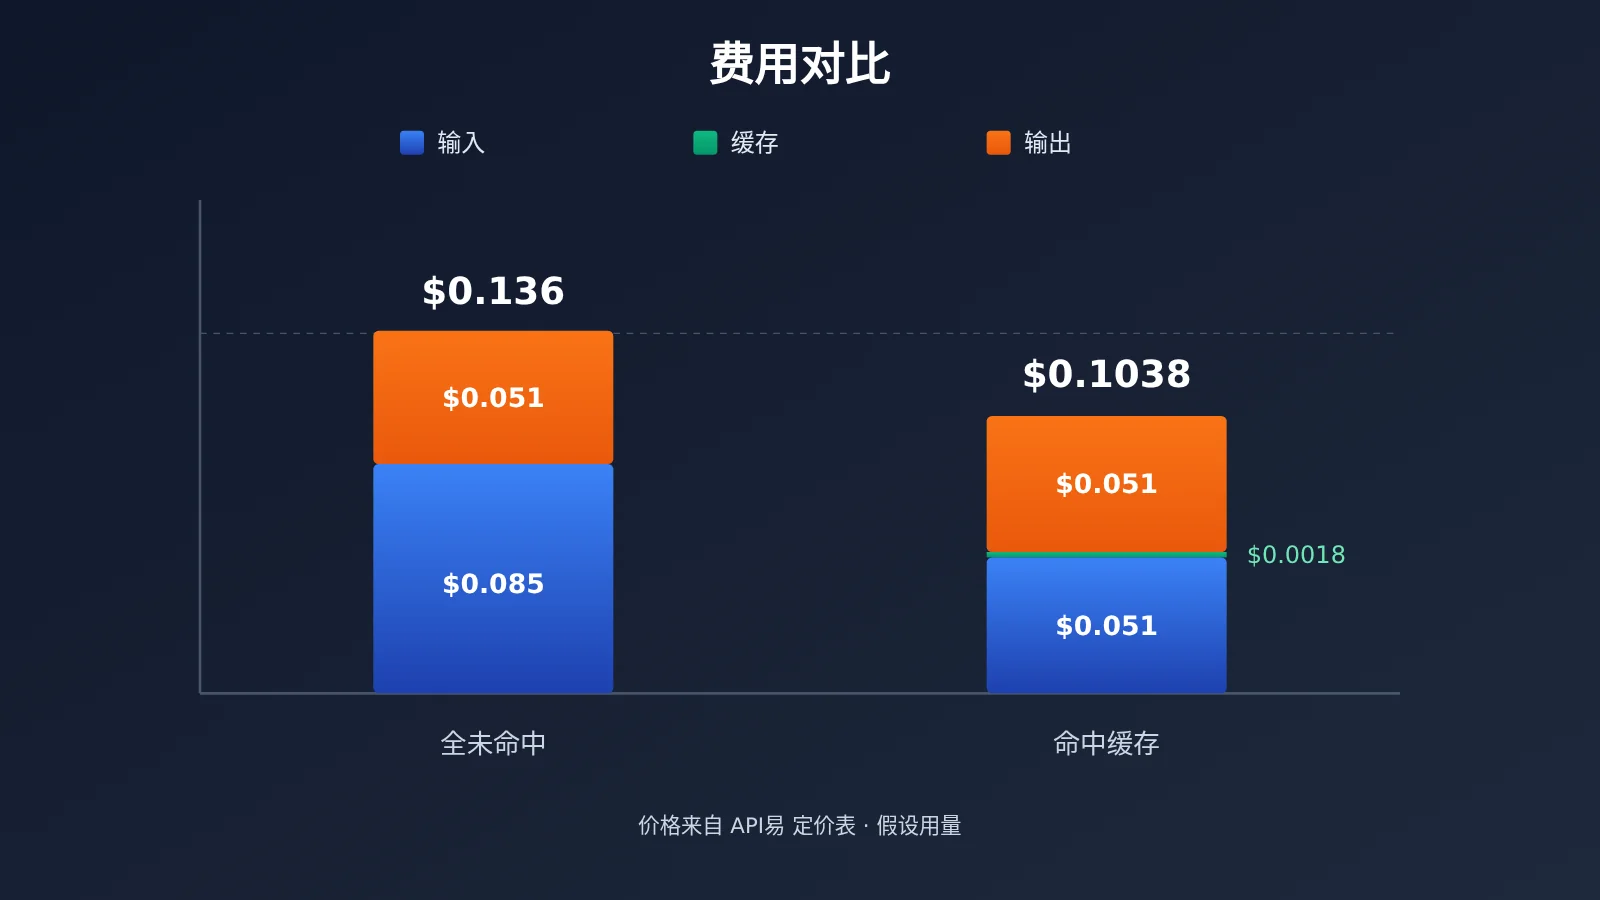
首次请求的输入很短,花费可以忽略不计,用它来估算成本意义不大。下面换成一个与示例短请求无关的假设场景:某次任务输入 10 万 token,全部未命中缓存,输出 2 万 token。输入和输出分别按各自的单价计算:
| 计费项 | 假设用量 | 单价(每百万 token) | 费用 |
|---|---|---|---|
| 未命中缓存输入 | 100,000 | $0.85 | $0.085 |
| 输出 | 20,000 | $2.55 | $0.051 |
| 合计 | — | — | $0.136 |
计算过程是 0.1 × 0.85 + 0.02 × 2.55 = 0.136。估算时要注意两点:
- 输出单价是未命中输入单价的 3 倍。输出量较大的任务,成本主要由输出决定。
- 如果 completion_tokens 已经包含模型的思考部分,就不要再单独加一次思考的费用,否则会重复计算。
3.2 区分缓存桶与实际消费日志
“缓存读取”是一个单独计费的部分,但不同响应中字段的拆分方式未必相同,所以没有一个普遍适用的字段名可以保证结果精确。可靠的做法是先在账单中确认:命中缓存的 token 是否已经计入总输入。
如果账单确认缓存部分已经包含在总输入中,就从总输入里扣除一次缓存部分,再分别计价。下面沿用 3.1 的假设,并进一步假设 10 万输入中有 4 万命中缓存:
| 计费项 | 假设用量 | 单价(每百万 token) | 费用 |
|---|---|---|---|
| 未命中缓存输入 | 60,000 | $0.85 | $0.051 |
| 缓存读取 | 40,000 | $0.045 | $0.0018 |
| 输出 | 20,000 | $2.55 | $0.051 |
| 合计 | — | — | $0.1038 |
估算值只能作为参考,最终以消费日志为准。核对方法是在控制台 api.apiyi.com/log 中筛选出对应的记录:
- 按请求时间缩小范围。
- 如果响应提供了 request ID,用它精确定位到这一次请求。
- 确认模型为
hy4,令牌与代码实际使用的令牌一致。 - 对比日志中的输入、缓存、输出用量和扣费金额,看与估算值是否一致。
日志字段的具体含义见 docs.apiyi.com/faq/log-billing-explained。
4. Hy4 API 失败排障
排障时先看 HTTP 状态码,再读错误体中的具体信息。只看状态码容易判断错误,比如同样是 429,原因可能完全不同。在第 2.1 节的原请求处捕获 SDK 异常:连接超时看 APITimeoutError,其他连接失败看 APIConnectionError;拿到错误响应时,从 APIStatusError 记录 status_code、request_id 和错误体。先判断现有请求结果,再决定要不要重试;反馈前给错误体脱敏。处理顺序如下:
| 错误 | 优先检查 | 是否重试 |
|---|---|---|
| 401 | Key 是否正确、是否已失效,以及 base_url 是否为 https://api.apiyi.com/v1 |
修正配置前不要重试 |
| 403 | 根据错误体判断是否为分组权限问题,确认令牌所在分组包含 Hy4 | 修正权限前不要重试 |
| 404 | 路径是否重复拼接了 /chat/completions,模型名是否为 hy4 |
修正配置前不要重试 |
| 429 | 根据错误体判断是临时限流还是额度不足 | 临时限流可以有限次退避重试,额度不足需要先充值或调整额度 |
| 连接错误 | 网络、代理、DNS 是否正常,以及 base_url 的协议和域名是否正确 | 网络恢复后可以重试 |
| 超时 | 先在 api.apiyi.com/log 中按时间查找,确认请求是否已经执行 |
已执行就不要重发,未执行再重试 |
需要特别说明 429 和超时两种情况:
- 429 的退避重试:只适用于临时限流。重试次数要设上限,每次间隔逐步加长。额度不足时,重试多少次都不会成功。
- 超时:客户端在 60 秒内没收到响应,并不代表服务端没有处理这个请求。如果服务端已经处理完,直接重发会再执行一次,费用也会再扣一次。所以应先查日志,确认请求没有执行,再重新发送。
如果需要联系技术支持,提交前先把错误体和日志中的 Key、客户数据等敏感信息脱敏,再附上状态码、请求时间、模型名和 request ID。错误信息的留存与提交方式见 docs.apiyi.com/api-manual/error-reporting。
全部排障完成后,用 2.1 的示例重新运行一次,整套流程需要同时满足三个条件才算通过:
- 验收函数输出“通过”。
- finish_reason 不是
length。 - 控制台日志中能找到同一时间、模型为
hy4的记录,并且用量与本地记录的 usage 一致。