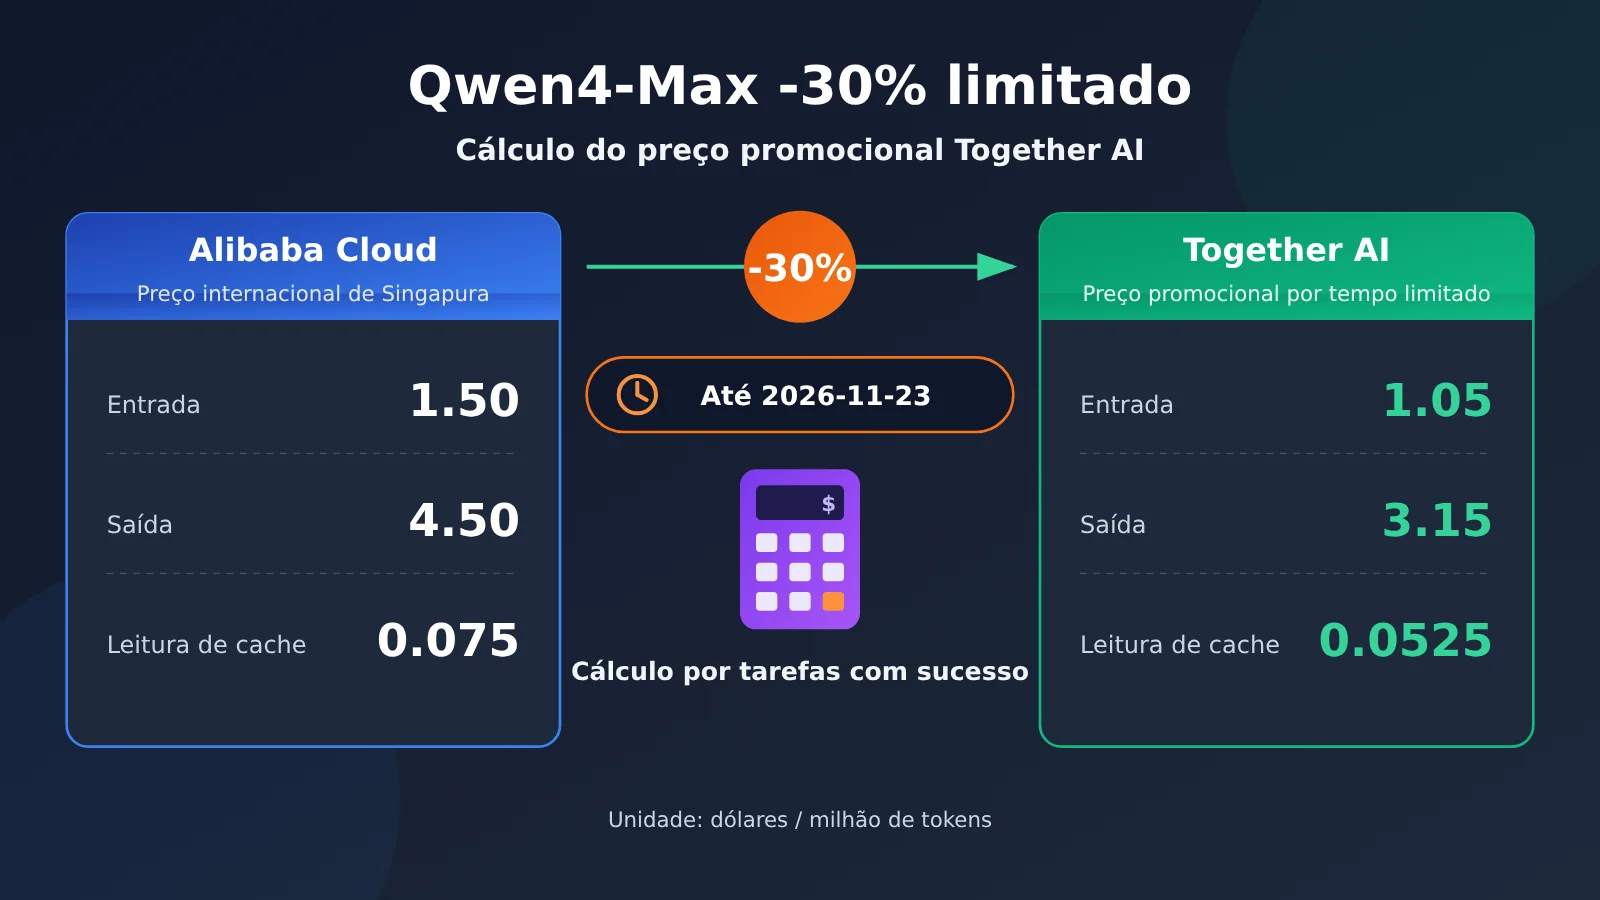
A página oficial de Pricing da Together AI reduziu por tempo limitado os preços de entrada, saída e leitura de cache do Qwen4-Max para 70% do preço da implantação internacional de Singapura do Model Studio da Alibaba Cloud. A página indica que a promoção é válida até 2026-11-23.
A conclusão é condicional: o desconto de 30% só vale a pena ser testado às pressas se a sua tarefa conseguir concluir a validação antes do prazo final, depender principalmente de entrada de texto e imagem e não esbarrar nos limites de comprimento que a Together ainda não publicou item a item. Caso contrário, você deve usar o “custo por tarefa bem-sucedida” para decidir se faz a migração, e ao mesmo tempo preparar uma segunda conta com base no preço vigente após o fim da promoção. Esse desconto de 30% é uma tabela de preços — e ainda não equivale a uma implantação que você já validou.
O que você vai aprender ao ler este artigo?
- Os valores específicos do desconto de 30% da Together AI, a base de cálculo e a data de expiração, além de de qual página vem cada um desses números.
- Como conciliar as contas quando o preço da página de detalhes do modelo da Together e o da página de Pricing divergem.
- Quais janelas, limites de saída e cobrança de cache divulgados oficialmente pela Alibaba Cloud não podem ser aplicados diretamente ao roteamento da Together.
- Um método de aceitação para a migração voltado a tarefas de texto curto, contexto longo e imagem, além de exemplos de cálculo com denominador e premissas.
- Os endpoints, grupos e preços de catálogo do
qwen4-maxlistados na APIYI, e a diferença em relação à promoção da Together.
Índice: o texto primeiro organiza os fatos verificáveis em quatro grupos: preço com desconto e prazo da Together, diferenças do modelo de mesmo nome entre páginas diferentes, especificações oficiais da Alibaba Cloud e informações de listagem da APIYI; cada número traz indicação de origem e condição. Em seguida vem a parte de análise e julgamento, com a possível mecânica de precificação por trás do desconto de 30% (todas são suposições), o método e o código para calcular o custo por tarefa bem-sucedida usando o mesmo lote de tarefas, e os itens que precisam ser verificados um a um ao considerar a APIYI como alternativa independente.
Conceitos que você precisa saber sobre o desconto de 30% no Qwen4-Max
| Conceito | Explicação breve |
|---|---|
| Inferência Serverless | As instâncias de execução são gerenciadas pelo fornecedor; o aplicativo chama por interfaces públicas e paga conforme o uso, sem precisar implantar o modelo por conta própria |
| Implantação internacional | Uma forma de definir região e implantação no serviço de modelos da Alibaba Cloud; preços e regras variam conforme a região escolhida |
| Token | Unidade de medida usada pelo modelo para processar textos e outras informações; itens de cobrança como entrada, saída e cache são calculados separadamente |
| Leitura de cache | A requisição reutiliza uma entrada já processada anteriormente e é cobrada pela tarifa de leitura; a gravação em cache tem preço e validade próprios |
| Janela de contexto | Comprimento total disponível em uma única inferência; o provedor também pode limitar separadamente a entrada máxima e a saída máxima |
| Modalidades de entrada | Tipos de dados aceitos pelo serviço de modelo, como texto, imagem e vídeo |
| Custo por tarefa bem-sucedida | O gasto total com inferência dividido pelo número de tarefas aprovadas; os gastos gerados por falhas e novas tentativas também entram na conta |
Visão rápida do impacto do desconto de 30% no Qwen4-Max
- Desenvolvedores de aplicativos e responsáveis por compras: o preço de tabela cai 30%, mas faltam só cerca de três dias para o prazo final, e a página não informa o fuso horário nem o horário exato de encerramento. Se não houver tempo para concluir a validação, planejar um orçamento de longo prazo com base no preço promocional é bastante arriscado.
- Equipes com cenários de contexto longo ou agentes: tarefas em que os tokens de entrada dominam são as que mais economizam. Mas a Together não divulga separadamente os limites máximos de entrada e saída; é preciso testar na prática onde o truncamento acontece.
- Quem precisa de compreensão de vídeo: a página oficial de modelos da Alibaba lista entrada de vídeo, mas a página de modelos da Together, por enquanto, só especifica texto e imagem. Antes de ter uma explicação clara ou resultados de testes reais, não é recomendável migrar tarefas de vídeo para lá.
Custo de integração do Qwen4-Max com 30% de desconto: fatos objetivos
Preço com 30% de desconto e data de validade do Qwen4-Max na Together AI
Os números da tabela abaixo foram verificados em 2026-11-20 e estão todos em dólares por milhão de tokens. Os números da Together vêm da página oficial de Pricing dela, que marca o Qwen4 Max como PROMO. Os números da Alibaba Cloud vêm do preço de implantação internacional em Singapura na tabela de preços do Model Studio.
| Item de cobrança | Preço promocional por tempo limitado na página Pricing da Together | Preço da implantação internacional em Singapura da Alibaba Cloud | Proporção |
|---|---|---|---|
| Entrada | 1.05 | 1.50 | 0.70 |
| Saída | 3.15 | 4.50 | 0.70 |
| Leitura de cache | 0.0525 | 0.075 | 0.70 |
| Validade | A página indica até 2026-11-23, sem fuso horário nem hora específica | Tabela de preços continuamente atualizada | — |
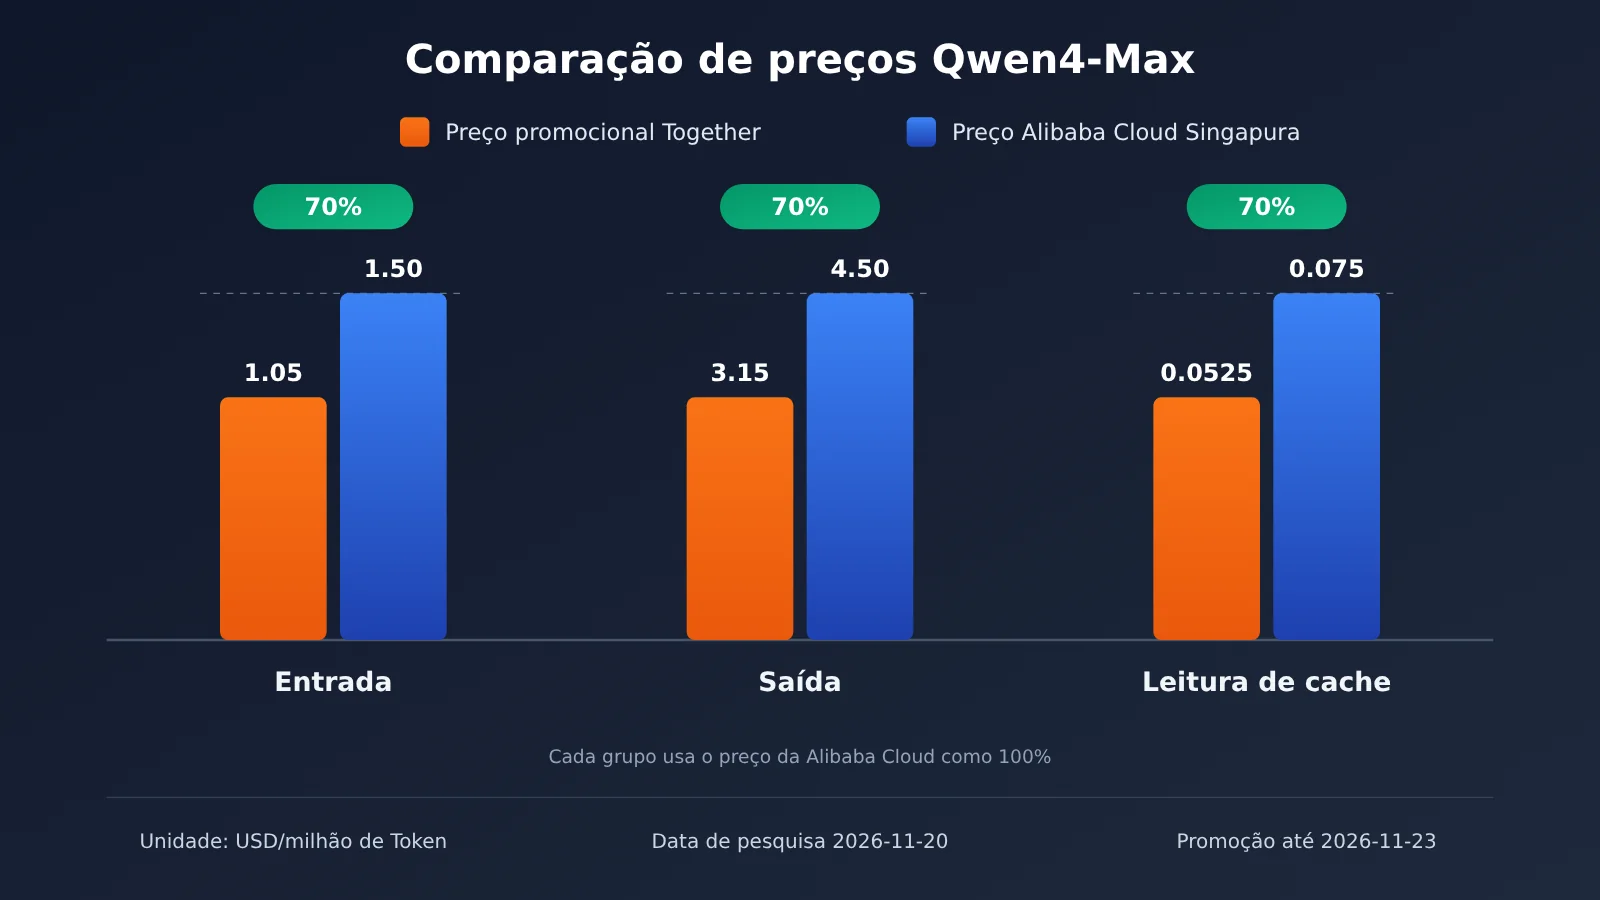
O “preço original” na página Pricing da Together é idêntico, item por item, ao preço de Singapura da Alibaba Cloud, e as três proporções são exatamente 0.70. Esse desconto de 30% vale apenas para esta base de implantação internacional em Singapura, estes três itens de cobrança e esta promoção. Se você estiver comparando com preços da Alibaba Cloud em outras regiões, ou se houver regras de cache diferentes, será preciso recalcular o desconto — não dá para simplesmente aplicar os 30%.
Essa notícia de preço apareceu pela primeira vez em um artigo do OrcaRouter de 2026-11-19, mas o texto original não citava a plataforma pelo nome, e o autor ainda esclarecia que a própria OrcaRouter não oferece esse modelo. Atualmente, a fonte em que é possível confirmar os mesmos três níveis de preço é a página Pricing da própria Together AI, então use essa página como referência ao citar.
Diferença de preço do Qwen4-Max entre a página de modelos e a página de Pricing da Together AI
A página de detalhes do modelo da Together (marcada em 2026-11-15) divulga o ID de invocação Qwen/Qwen4-Max e um exemplo de invocação Serverless, mas o preço exibido na página é de outra faixa: entrada 1,43, saída 4,28, leitura de cache 0,0713 (dólares por milhão de tokens). Como os dois sites públicos do mesmo provedor mostram números diferentes, ao citar o valor promocional de 70% do preço é preciso deixar claro que se trata do “preço promocional indicado na página oficial de Pricing” e registrar a data da consulta; a cobrança real deve ser baseada no detalhamento de uso da conta.
| Dimensão | Informações públicas da Together | Informações oficiais da Alibaba Cloud |
|---|---|---|
| ID de invocação | Qwen/Qwen4-Max, com exemplo Serverless |
Página de modelo do Model Studio |
| Modalidade de entrada | A página do modelo lista explicitamente texto e imagem | Entrada de texto, imagem e vídeo; saída de texto |
| Contexto total | Anuncia janela total de 1 milhão | Contexto total de 1 milhão de tokens |
| Entrada máxima | Não confirmado item a item | Não-pensamento 991.808 / pensamento 983.616 |
| Saída máxima | Não confirmado item a item | Não-pensamento 131.072 / pensamento 262.144 |
| Leitura de cache | Página de Pricing 0,0525; página do modelo 0,0713 | Singapura 0,075 |
| Gravação de cache | Não encontrado publicamente | 5 minutos 1,875; 1 hora 3 (dólares por milhão) |
A página oficial do modelo da Alibaba Cloud foi atualizada em 2026-11-18. De acordo com a descrição no texto do OrcaRouter, no modo de pensamento o conteúdo do pensamento e a resposta compartilham um orçamento de 262.144 tokens. Esses limites, modalidades e regras de cache pertencem à implantação da própria Alibaba Cloud, e não podem ser tomados diretamente como capacidades do roteamento da Together. Além disso, descrições anteriores mencionavam que a página da Together chegou a exibir um aviso de “aguardando lançamento”. Agora a página do modelo já fornece o ID de invocação e exemplos, mas esta rodada de verificação não confirmou se a invocação real foi bem-sucedida.
Informações de lançamento e preço de catálogo do qwen4-max na APIYI
A APIYI (apiyi.com) publicou um anúncio em 2026-11-17 às 16:07 lançando o qwen4-max. O ID também aparece no registro público de modelos gerado em 2026-11-20 às 15:17 (UTC+8). A afirmação anterior no blog da APIYI de que “ainda não estava disponível” deve ser considerada substituída por este anúncio e registro mais recentes.
| Item | Informações do catálogo público da APIYI |
|---|---|
| ID do modelo | qwen4-max |
| Endpoints | chat, responses, messages |
| Grupo de token | ClaudeCode, CodexResponses, default, svip |
| Preço de catálogo (USD / milhão de tokens) | entrada 1,50, saída 4,50, leitura de cache 0,075 |
| Método de verificação | com base no anúncio oficial e no registro; nenhuma chamada paga foi iniciada |
Esse conjunto de preços de catálogo é numericamente idêntico ao preço da implantação internacional da Alibaba Cloud em Singapura; não é uma promoção da Together, nem um desconto da APIYI. O grupo da conta, as permissões do token e a forma de cobrança da plataforma afetam tanto a possibilidade de invocação quanto o valor final efetivamente pago.
Vale a pena migrar para o Qwen4-Max com 30% de desconto: análise e avaliação
Possíveis mecanismos de precificação por trás do desconto de 30% do Qwen4-Max (especulação)
O texto original do OrcaRouter apresentou três explicações. Veja cada uma abaixo; todas são apenas especulações. A página pública da Together só confirma a própria promoção e a data de término informada, sem revelar quem assume o desconto.
- Subsídio do fornecedor (especulação): para promover o novo modelo, o fornecedor subsidia o preço de lançamento cobrado por plataformas de terceiros. Se for esse o caso, após o fim do subsídio o preço provavelmente voltará ao preço base.
- Preço de atacado (especulação): a plataforma conseguiu um preço de compra mais baixo e pode repassar o desconto por longo prazo. Mas, em geral, esse cenário não viria marcado como PROMO nem com data-limite, o que não combina muito com o que a página mostra hoje.
- Prejuízo para atrair usuários (especulação): a plataforma aceita um prejuízo de curto prazo para conquistar novos usuários. Nesse caso, a duração do desconto depende da estratégia da plataforma e não dá para prever.
O texto original usa o fim de dezembro como ponto de observação, mas o prazo já divulgado é 23 de novembro. Ao fazer orçamento, o melhor é calcular primeiro com base no vencimento em 23 de novembro e atualizar depois se houver anúncio de prorrogação.
Calculando o custo por tarefa bem-sucedida do Qwen4-Max com um mesmo lote de tarefas
Quando a comparação é feita só pelo preço por token, é fácil deixar passar os custos gerados por falhas, retentativas e truncamento. O caminho mais seguro é fixar um conjunto de tarefas, os comandos e as regras de validação, disparar esse mesmo lote de amostras para as rotas candidatas, registrar a cada chamada a entrada, a saída, os acertos de cache, as falhas, as retentativas e a latência, e então dividir o gasto total pelo número de tarefas que passaram na validação. Recomenda-se preparar pelo menos três tipos de amostra:
- Tarefas de texto curto: por exemplo, classificação, extração e reescrita, com foco na taxa de sucesso e na estabilidade do comprimento da saída.
- Tarefas de contexto longo: por exemplo, enviar uma requisição de cerca de 400.000 tokens, observar onde ocorre o truncamento e se o orçamento de saída é suficiente no modo de raciocínio.
- Tarefas com imagem: nas entradas de imagem que o Together já suporta explicitamente, verificar se o resultado do reconhecimento e a cobrança batem com o esperado.
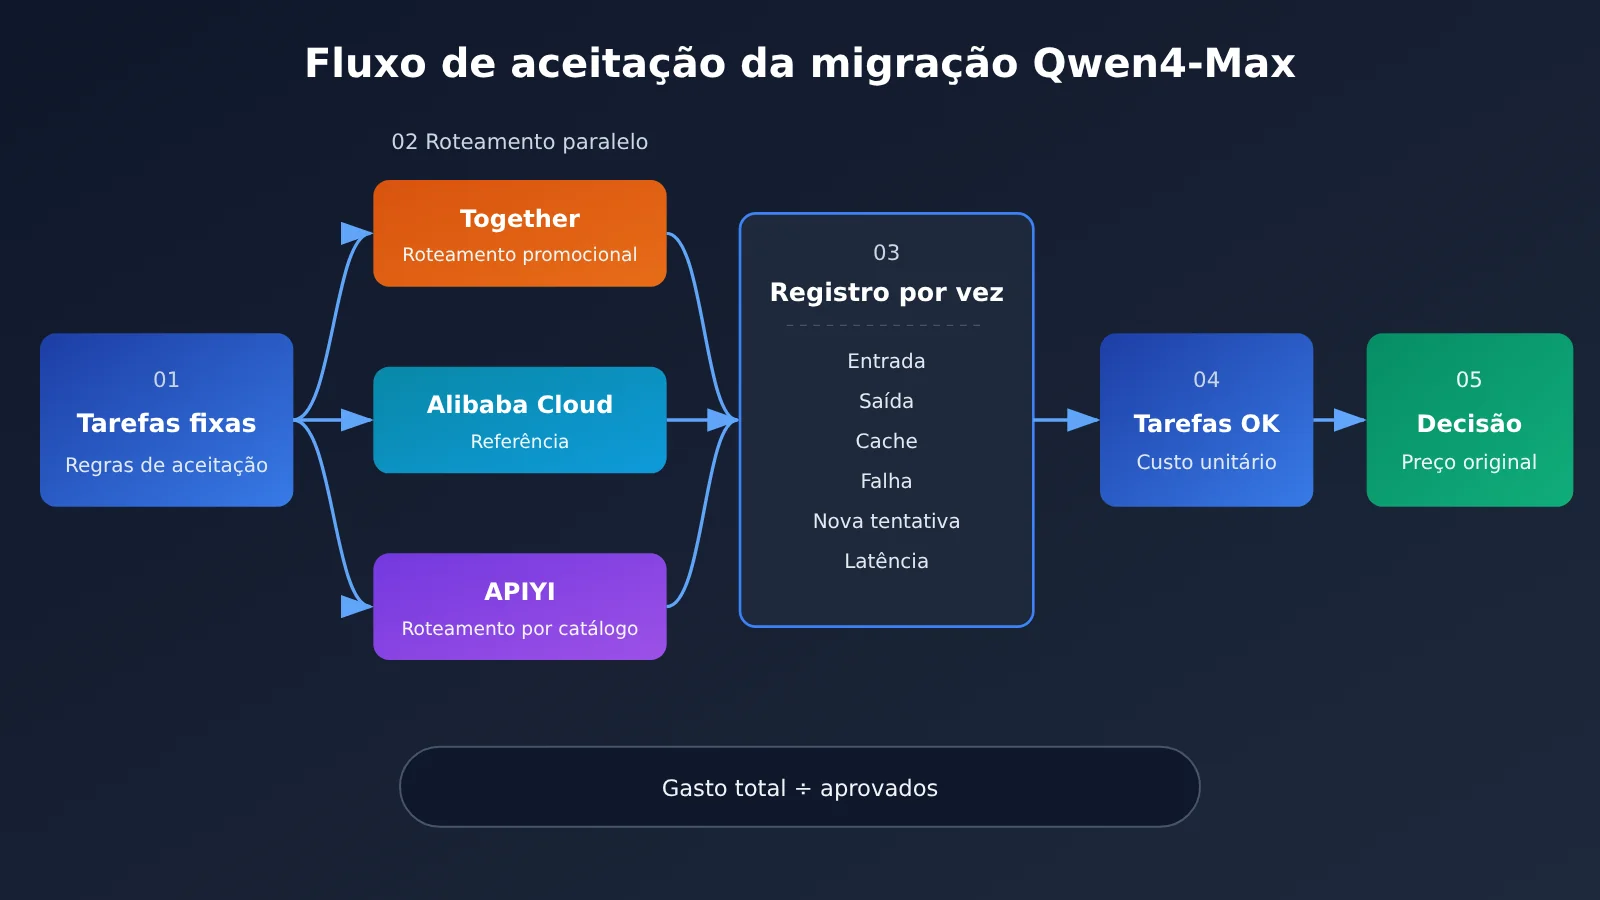
Os exemplos de texto curto da tabela abaixo são dados hipotéticos, usados para mostrar como o denominador deve ser construído. O exemplo de contexto longo parte do cálculo do OrcaRouter: 200.000 de entrada e 30.000 de saída por rodada, 40 rodadas, sem uso de cache, e ambos os lados calculados pelo preço de tabela com referência a Singapura.
| Caso de exemplo | Premissas e denominador | Preço promocional do Together | Após o fim da promoção (supondo retorno ao preço original de 1.50/4.50 da página Pricing) | Diferença |
|---|---|---|---|---|
| Texto curto (hipotético) | 2.000 de entrada e 500 de saída por chamada; 100 tarefas, 8 retentativas, 108 chamadas no total; 92 passaram na validação | 108 × 0.003675 ≈ 0.397, ÷ 92 ≈ 0.00431 por tarefa bem-sucedida | 108 × 0.00525 ≈ 0.567, ÷ 92 ≈ 0.00616 | cerca de 0.00185 por tarefa bem-sucedida |
| Agente de contexto longo (exemplo OrcaRouter) | 40 rodadas = 1 execução, sem cache, supondo sucesso em todas | 0.3045 por rodada, 12.18 por execução | 0.435 por rodada, 17.40 por execução | 5.22 por execução |
Com esse exemplo, rodando mil vezes por mês a diferença fica em torno de 5,220 dólares; rodando dez vezes, são apenas cerca de 52 dólares. Vale notar que, se ao fim da promoção o preço voltar para a faixa 1.43/4.28 da página do modelo, o resultado muda de novo. Por isso, na coluna de preço convém manter três conjuntos ao mesmo tempo: “preço promocional”, “preço original da Pricing” e “preço da página do modelo”, para depois comparar com o preço unitário real quando a fatura chegar.
Exemplo de código para teste de custo do Qwen4-Max
O exemplo mínimo abaixo mostra uma chamada compatível com OpenAI. Usando a rota da APIYI como exemplo, ao trocar para outra rota, basta alterar base_url e o ID do modelo para os valores publicados pelo provedor correspondente.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI
)

resp = client.chat.completions.create(
    model="qwen4-max",
    messages=[{"role": "user", "content": "用一句话说明缓存读计费"}]
)
print(resp.choices[0].message.content, resp.usage)
Ver o script completo que registra o custo por “tarefa bem-sucedida individual”
import time
import openai

# Unidade: dólares / milhão de tokens; os três conjuntos de preços são registrados separadamente; depois que a fatura sair, substitua pelo preço unitário efetivamente pago
PRICES = {
    "together_promo": {"in": 1.05, "out": 3.15, "cache_read": 0.0525},
    "list_price":     {"in": 1.50, "out": 4.50, "cache_read": 0.075},
    "together_model_page": {"in": 1.43, "out": 4.28, "cache_read": 0.0713},
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Substitua pela rota a ser testada
)

def run_task(prompt, validate, model="qwen4-max", max_retries=2):
    """Retorna o registro de uso de cada chamada e se a tarefa passou na validação final"""
    records = []
    for attempt in range(max_retries + 1):
        t0 = time.time()
        try:
            r = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
            )
            u = r.usage
            details = getattr(u, "prompt_tokens_details", None)
            cached = getattr(details, "cached_tokens", 0) or 0
            ok = validate(r.choices[0].message.content)
            records.append({"in": u.prompt_tokens - cached, "cache": cached,
                            "out": u.completion_tokens, "ok": ok,
                            "latency": time.time() - t0})
            if ok:
                return records, True
        except Exception as e:
            records.append({"in": 0, "cache": 0, "out": 0, "ok": False,
                            "latency": time.time() - t0, "error": str(e)})
    return records, False

def cost_per_success(all_records, passed, price):
    total = sum(r["in"] * price["in"] + r["out"] * price["out"]
                + r["cache"] * price["cache_read"] for r in all_records) / 1e6
    return total / passed if passed else float("inf")
O campo de cache no script depende de a API retornar cached_tokens. Os campos retornados podem variar entre rotas; no fim, ainda é preciso usar a fatura da plataforma como referência. O custo de gravação em cache (a Alibaba Cloud oficialmente separa duas faixas: 5 minutos e 1 hora) não tem preço público no lado da Together, então deve ser registrado separadamente durante os testes.
🚀 Sugestão de teste: O tempo até o prazo final está curto; você pode primeiro usar o crédito gratuito para novos usuários na APIYI apiyi.com para executar de ponta a ponta o conjunto de exemplos e o script de registro de custos, confirmar que as regras de validação e o formato dos logs estão corretos e, depois, apontar o mesmo script para a rota da Together para comparação. Assim, todo o tempo de teste dentro da janela promocional pode ser usado para comparar preços.
Checklist para usar o qwen4-max da APIYI como alternativa independente
O preço de catálogo da APIYI é igual ao preço da Alibaba Cloud em Singapura. A ideia não é oferecer uma opção mais barata, mas sim uma outra rota estável, cobrada a preço de catálogo, para quando a promoção terminar ou a validação da rota da Together não passar. Ao integrar pela APIYI (apiyi.com), vale a pena conferir quatro pontos:
- Conferência do catálogo: veja no registro se o endpoint e o grupo do
qwen4-maxincluem o protocolo que você vai usar, comoresponsesoumessages. - Conferência da conta: confirme se o grupo do token atual tem permissão para chamar o modelo. O modelo aparecer no catálogo não garante que sua conta consiga chamá-lo.
- Conferência da cobrança: rode um conjunto de exemplos e compare, item por item, o preço unitário efetivamente pago com o preço de catálogo.
- Conferência de capacidades: ponto de truncamento em contextos longos, saída no modo de raciocínio e suporte multimodal devem ser testados em cada rota, sem aplicar diretamente os limites oficiais da Alibaba Cloud.
Se a sua carga de trabalho conseguir passar pela validação até 2026-11-23 e o custo calculado por tarefa bem-sucedida realmente for menor, você pode rodar primeiro com o preço promocional da Together por um período, mantendo ao mesmo tempo uma rota alternativa a preço de catálogo e um segundo orçamento. Se não houver tempo hábil para validar, ou se a sua solução depender de entrada de vídeo e saídas muito longas, o caminho mais seguro é colocar o fluxo para funcionar a preço de catálogo em uma interface compatível como a APIYI (apiyi.com) e, depois que a Together anunciar uma extensão ou completar as especificações, refazer a comparação de preços.
Referências
-
Preços da Together AI: preço promocional e validade do Qwen4 Max
- Link:
together.ai/pricing - Observação: a página não indica data de publicação; a data de consulta deste artigo é 2026-11-20
- Link:
-
Página do modelo Qwen4 Max da Together AI: ID de invocação, exemplo Serverless e outra faixa de preço
- Link:
together.ai/models/qwen4-max - Observação: página marcada em 2026-11-15
- Link:
-
Preços de modelos do Alibaba Cloud Model Studio: preço de implantação internacional em Singapura e preço de gravação de cache
- Link:
alibabacloud.com/help/en/model-studio/model-pricing - Observação: tabela de preços atualizada continuamente
- Link:
-
Página do modelo Qwen4-Max da Alibaba Cloud: janela de contexto, limites de entrada e saída e modalidades
- Link:
alibabacloud.com/help/en/model-studio/qwen4-max - Observação: atualizada em 2026-11-18
- Link:
-
Texto original da OrcaRouter: fonte da notícia do desconto de 30% e exemplos de cálculo para cenários de Agent
- Link:
orcarouter.ai/blog/qwen-4-max-30-percent-price-cut-third-party - Observação: publicado em 2026-11-19; a explicação do mecanismo de preços é uma suposição do autor
- Link:
-
Anúncio de lançamento e registro de modelos da APIYI: endpoint
qwen4-max, grupos e preço de catálogo- Link:
docs.apiyi.com/live/2026-11/qwen4-max-launch - Observação: anúncio publicado em 2026-11-17, registro gerado em 2026-11-20
- Link:
Autor: Equipe técnica da APIYI
Intercâmbio técnico: fique à vontade para nos contatar pela página inicial do site oficial da APIYI, apiyi.com. Mais materiais de integração estão disponíveis no centro de documentação.