Este artigo parte de casos de migração, atendimento ao cliente e código com o GPT-6.1 Sol e o GPT-6.2 Sol para mostrar como primeiro fixar os critérios de aceitação do negócio e, só então, escolher o nível de raciocínio que entrega resultado estável — calculando também o custo de cada tarefa aprovada.
Adiantando a conclusão: ao mudar de nível, o que deve ser comparado é “quanto custa e quanto tempo leva cada tarefa aprovada”; o preço de tabela de uma única chamada é apenas um dos fatores. Nos testes públicos com amostra pequena, o nível low do GPT-6.2 Sol alcançou o mesmo número de aprovações que o medium tanto nas questões de política de atendimento quanto em um conjunto de questões de código, e ainda assim levou menos tempo. Nas questões de código, o custo convertido do preço de tabela do low ficou em cerca de 70% do medium. Para essa conclusão valer, duas condições precisam ser atendidas: suas tarefas devem ser suficientemente parecidas com as tarefas do teste, e o critério de aceitação não pode se limitar à taxa de aprovação — é preciso checar também links inventados, campos de valor monetário e retrabalho. Já em tarefas com conflito entre fontes, dependência complexa de ferramentas ou que tendem a deixar restrições de fora, ainda vale validar separadamente o medium e níveis acima.
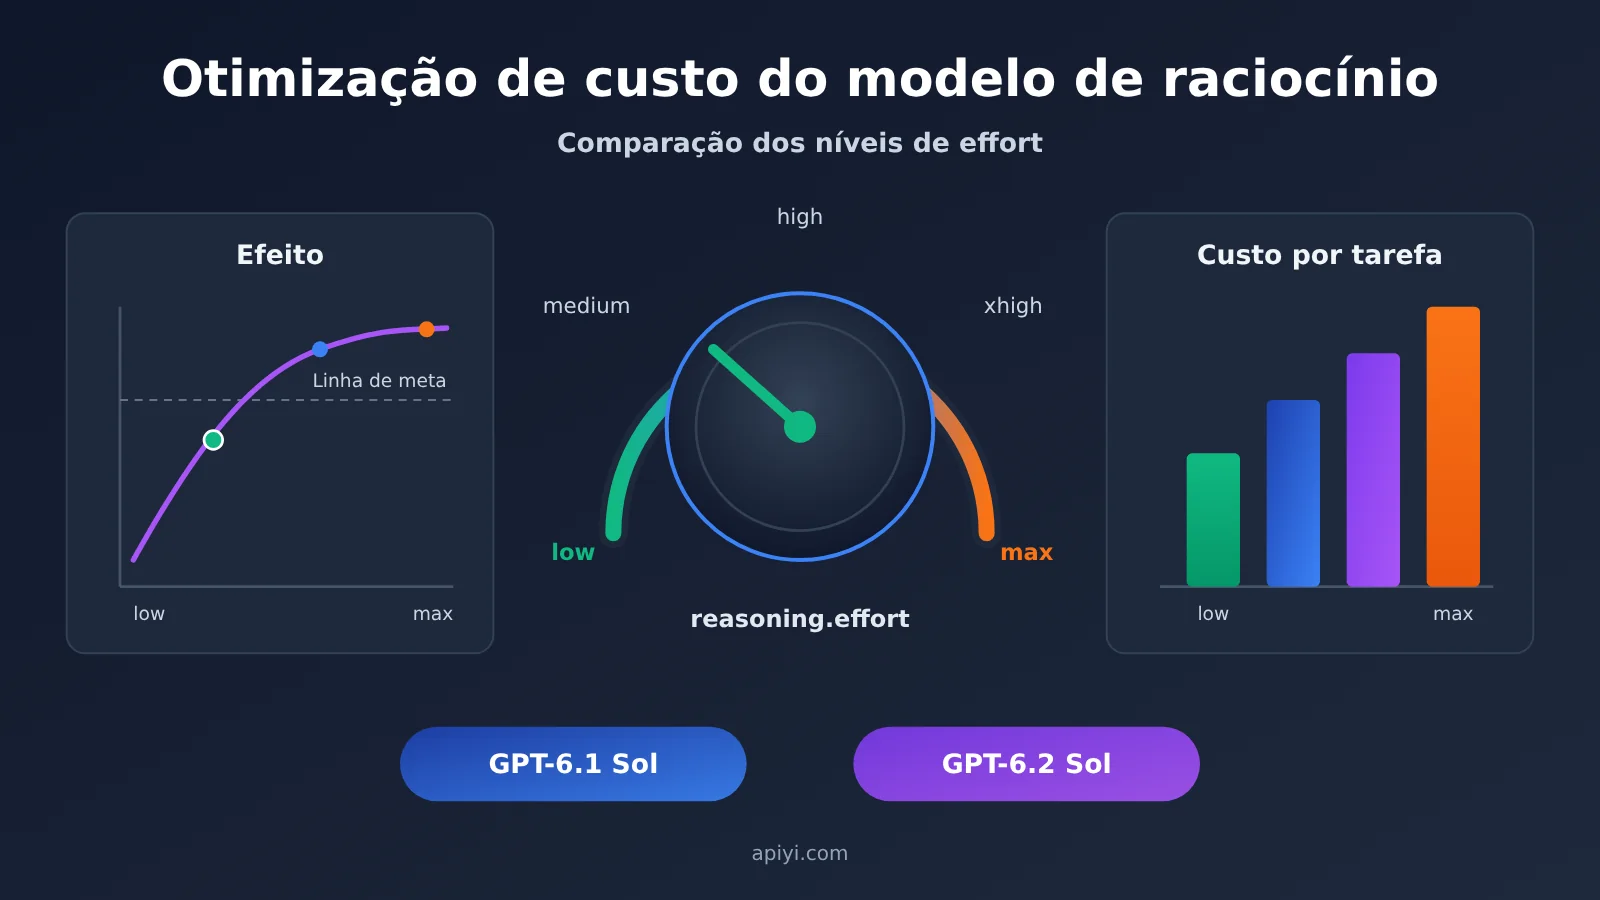
Visão rápida da comparação de níveis de effort em modelos de raciocínio
A tabela abaixo resume os conjuntos de evidências usados neste artigo, com a fonte e os critérios indicados em cada linha. Números de fontes diferentes não podem ser somados nem misturados diretamente.
| Dimensão de comparação | GPT-6.1 Sol | GPT-6.2 Sol | O que a diferença significa |
|---|---|---|---|
| Níveis disponíveis (documentação da OpenAI) | low, medium, high, xhigh, max | mesmos cinco níveis, recusa none |
Ao migrar de modelos que aceitam none/minimal, é preciso ajustar o nível inicial |
| Preço de tabela da APIYI para contexto curto (tabela geral de 2026-11-20, USD/milhão de tokens) | entrada $2, leitura de cache $0,10, saída $10 | mesmo valor | Em contexto curto, as duas gerações têm preço igual; a diferença de custo vem principalmente do volume de uso |
| Preço de entrada acima de 272.000 tokens de entrada | APIYI e OpenAI Standard listam $4 | APIYI lista $3, OpenAI Standard lista $4 | Em cenários de entrada longa, surge diferença de preço entre os canais |
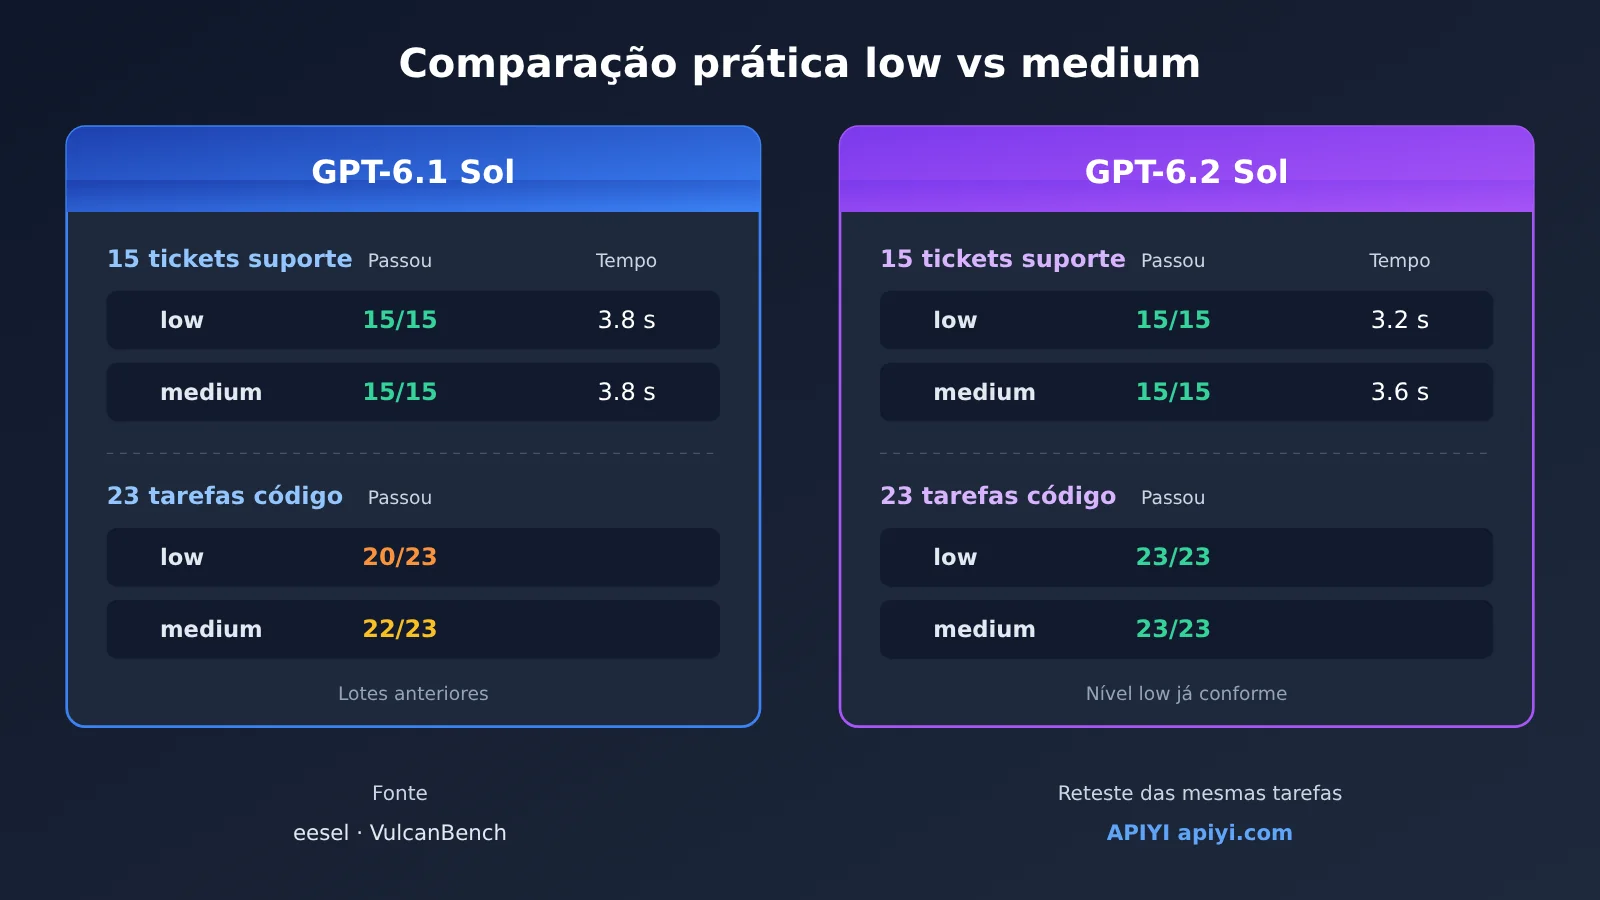
| 15 tickets de suporte da eesel (low / medium) | 15/15, 3,8 segundos; 15/15, 3,8 segundos | 15/15, 3,2 segundos; 15/15, 3,6 segundos | Taxa de aprovação igual; a diferença de custo entre níveis é pequena |
| 23 problemas de código do VulcanBench (low / medium) | 20/23; 22/23 (lote histórico) | 23/23; 23/23 | O nível low do 6.2 Sol já atinge a meta; números entre versões vêm de lotes diferentes |
| Índice Artificial Analysis (citado via OrcaRouter, low / medium) | 35; 46 | 41; 53 | Índice agregado de terceiros; os rótulos de nível são mapeados pelo próprio benchmark |
O texto segue a seguinte ordem: a seção 1 confirma se é possível integrar e como funciona a cobrança; a seção 2 mostra os resultados medidos nas mesmas tarefas; a seção 3 apresenta os passos de migração e aceitação; a seção 4 trata da troca de nível no meio de conversas com múltiplos turnos. Se você já confirmou o roteamento de modelos e os preços, pode começar a leitura pela seção 2.
Termos que você precisa saber sobre níveis de esforço de raciocínio
| Termo | Explicação |
|---|---|
reasoning.effort |
Campo da Responses API usado para definir a intensidade de raciocínio do modelo |
| Tokens de raciocínio | Uso de raciocínio consumido pelo modelo para chegar à resposta. Está incluído nos output_tokens cobrados e precisa ser distinguido da saída visível ao usuário |
low / medium |
Dois níveis de raciocínio. Mesmo ao trocar para uma nova versão no mesmo nível, ainda é necessário validar novamente |
| Preço unitário de leitura de cache | Aplica-se apenas à parte da entrada que corresponde a um prefixo reutilizável em cache; não é possível calculá-lo diretamente pelo número total de tokens |
| Prefixo da requisição | O contexto já existente antes da mensagem atual. Alterar o histórico inicial afeta o cache e a reutilização dos itens de raciocínio |
configuration_update |
Item de entrada usado, em sessões Responses compatíveis com esse recurso, para ajustar configurações posteriores |
| Limite de aceitação | Nível mínimo aceitável definido para correção de políticas, aprovação de funcionalidades ou nível de retrabalho |
| Custo por tarefa aprovada | Custo total de chamadas, novas tentativas, ferramentas e retrabalho manual do teste inteiro, dividido pelo número de tarefas aprovadas |
1. Antes de otimizar o custo de modelos de raciocínio: quando vale a pena ajustar o nível de esforço
1.1 Situação de integração das duas gerações do Sol na APIYI
De acordo com as atualizações da plataforma APIYI, o GPT-6.1 Sol foi lançado em 2026-09-30, e o lançamento do GPT-6.2 Astra e do Sol foi anunciado em 2026-11-18. A tabela geral de preços de 2026-11-20 mostra que as duas gerações do Sol oferecem, ao mesmo tempo, as rotas responses e chat, e os grupos envolvidos são CodexResponses, Codex_Reverse, Default e SVIP. As capacidades que a conta pode realmente invocar dependem do grupo em que o token está.
Segundo a documentação da OpenAI, as duas gerações do Sol suportam Chat Completions e Responses, mas as chamadas de ferramentas precisam usar Responses, e o nível é configurado via reasoning.effort. Portanto, se o negócio tiver etapas com ferramentas, como consulta de pedidos e execução de código, tanto a avaliação quanto a entrada em produção devem usar a rota Responses de forma uniforme, para evitar que diferenças de comportamento entre as duas rotas contaminem os resultados da comparação.
1.2 Duas bases de preço: preço listado pela APIYI e preço padrão do upstream
| ID do modelo (tabela geral da APIYI, 2026-11-20) | Entrada normal | Leitura de cache | Saída | Plataformas disponíveis |
|---|---|---|---|---|
gpt-6.2-sol |
$2 | $0.10 | $10 | APIYI apiyi.com, OpenAI oficial |
gpt-6.1-sol |
$2 | $0.10 | $10 | APIYI apiyi.com, OpenAI oficial |
gpt-6-sol |
$2 | $0.20 | $10 | APIYI |
gpt-6.2-astra |
$8 | $0.40 | $40 | APIYI |
A tabela acima traz os preços padrão para contexto curto, em dólares por milhão de tokens. A tabela de preços do upstream compilada pela OrcaRouter lista os mesmos preços de entrada, leitura de cache e saída para as duas gerações do Sol e, à parte, a escrita de cache a $2.50. Contextos longos precisam ser verificados separadamente: quando a entrada de gpt-6.2-sol ultrapassa 272.000 tokens, a APIYI atualmente lista $3, e a OpenAI oficial Standard lista $4; para gpt-6.1-sol, ambos listam $4. Para os preços de cache e saída na faixa longa, consulte as regras de cobrança em tempo real de cada canal.
1.3 O custo deve ser lido da resposta real e da fatura
O preço de tabela serve apenas para estimar. A seguir, usamos um conjunto de exemplos hipotéticos para mostrar como o custo se decompõe. Suponha 12.000 Tokens de entrada por rodada, sem gravação de cache e sem taxa de ferramentas:
- Prefixo preservado: leitura de cache 9.000, saída total 1.000, estimativa de cerca de $0.0169.
- Prefixo alterado: leitura de cache cai para 3.000, saída total sobe para 1.600, estimativa de cerca de $0.0343.
Na diferença entre os dois casos, cerca de $0.0114 vem dos 6.000 Tokens de entrada que voltam do preço de cache para o preço normal, e cerca de $0.0060 vem dos 600 Tokens de saída extras. Estes são dados hipotéticos; a diferença real deve ser conferida no usage. Se houver gravação de cache cobrada em linha separada, calcule entrada normal, leitura de cache e gravação de cache como três categorias mutuamente exclusivas.
Como conferir a cobrança real: use o x-request-id do cabeçalho da resposta para correlacionar com o registro type=2 no log de consumo do APIYI, converta quota ÷ 500,000 para obter o valor em dólares efetivamente cobrado e, ao mesmo tempo, registre o modelo, o grupo de tokens, a janela de tempo da chamada, o uso de entrada e saída e o número de tentativas.
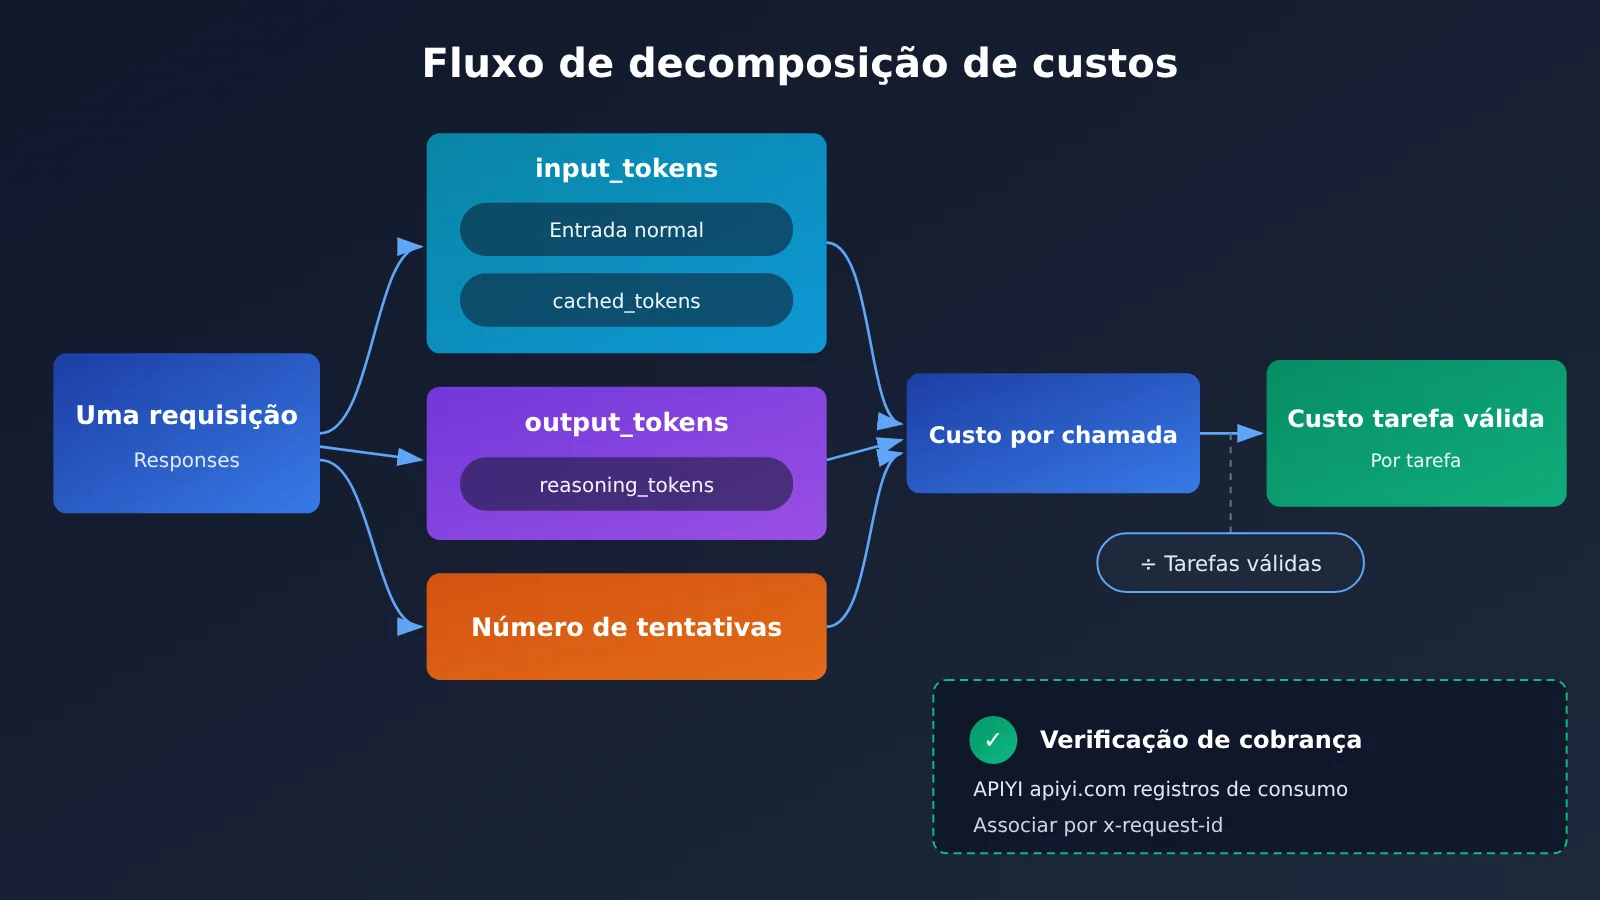
Abaixo está um exemplo de chamada mínima que já lê os campos de uso necessários para o diagnóstico:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI do APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "low"},
    input=[{"role": "user", "content": "根据退款政策判断工单 #1024 是否可退"}],
)

u = resp.usage
print(resp.output_text)
print("输入:", u.input_tokens, "缓存命中:", u.input_tokens_details.cached_tokens)
print("总输出:", u.output_tokens, "其中推理:", u.output_tokens_details.reasoning_tokens)
🚀 Início rápido: vale a pena rodar primeiro o exemplo acima no APIYI apiyi.com com o crédito gratuito para novos usuários, confirmar que o grupo desejado retorna corretamente
cached_tokensereasoning_tokense só então começar a avaliação em lote.
2. Comparação na mesma tarefa: resultados reais dos níveis low e medium
2.1 Chamados de suporte: o ganho com o nível low é pequeno
Em 2026-11-18, os testadores da eesel fizeram 60 chamadas no total pela Responses API, testando os níveis low e medium em cada uma das duas gerações do Sol. Cada configuração cobriu os mesmos 15 chamados, com temas como reembolsos, consultas de rastreamento e falhas na ferramenta de pedidos, e foi avaliada manualmente com base em uma política fictícia de SaaS.
| Configuração (eesel, 15 chamados) | Aprovadas | Tempo médio | Preço de tabela por mil chamadas |
|---|---|---|---|
| GPT-6.1 Sol low | 15/15 | 3.8 s | $1.32 |
| GPT-6.1 Sol medium | 15/15 | 3.8 s | $1.35 |
| GPT-6.2 Sol low | 15/15 | 3.2 s | $1.41 |
| GPT-6.2 Sol medium | 15/15 | 3.6 s | $1.42 |
Nesses dados, a diferença entre low e medium por mil chamadas é de apenas alguns centavos; a escolha do nível se baseia mais na latência do que no custo. Além disso, convertendo pelo uso medido, o GPT-6.2 Sol acabou ficando um pouco mais caro que o 6.1 Sol nesse conjunto de tarefas de suporte. Mais importante: embora as quatro configurações tenham atingido pontuação máxima de aprovação, o autor ainda observou que o 6.2 Sol gerava links de rastreamento que não existiam nas respostas das ferramentas. Isso mostra que, se a validação de suporte olhar apenas para “acertar a política”, esse tipo de problema passa despercebido; a origem dos links e dos campos precisa ser verificada separadamente. Essas evidências se aplicam apenas a este conjunto de chamados, a este critério de avaliação e ao ambiente de testes da OpenAI.
2.2 Tarefas de código: o custo por questão nas configurações baixas merece um teste real
Em 2026-11-19, o VulcanBench executou o Codex com o GPT-6.2 Sol, configuração por configuração, no mesmo conjunto de 23 questões, totalizando 115 execuções. Os valores da tabela abaixo foram convertidos a partir dos recibos de execução com base no preço de tabela da API e não representam a liquidação real na conta APIYI.
| Configuração (VulcanBench, 23 questões) | Aprovações | Tempo médio | Custo por questão (preço de tabela) | Pontuação composta |
|---|---|---|---|---|
| GPT-6.2 Sol low | 23/23 | 2.8 minutos | $0.23 | 88.44 |
| GPT-6.2 Sol medium | 23/23 | 4.4 minutos | $0.33 | 88.94 |
| GPT-6.2 Sol max | — | 11.3 minutos | $0.55 | 88.74 |
| GPT-6.1 Sol low (lote histórico) | 20/23 | 6.9 minutos | $0.31 | — |
| GPT-6.1 Sol medium (lote histórico) | 22/23 | 10.6 minutos | $0.40 | — |
Olhando apenas o grupo GPT-6.2 Sol: low e medium têm o mesmo número de aprovações; em low, o custo por questão é cerca de 30% menor e o tempo também é mais curto. Já a pontuação composta de max não superou a de medium. Comparações entre versões exigem cautela: os dados do 6.1 Sol vêm de uma avaliação histórica do mesmo conjunto de questões, portanto pertencem a um lote de teste diferente. A pontuação composta é uma avaliação da qualidade do código, e a taxa de aprovação nos testes é outra métrica; uma não substitui a outra.
O Artificial Analysis Index v5.0.1 citado pelo OrcaRouter (lido em 2026-11-20) oferece outra perspectiva: na faixa low, o 6.2 Sol marca 41 pontos e $0.18 por tarefa, enquanto o 6.1 Sol fica em 35 pontos e $0.16; na faixa medium, são, respectivamente, 53 pontos e $0.41, e 46 pontos e $0.36. Os rótulos de faixa desse ranking abrangente seguem o mapeamento do próprio avaliador, e o framework que você usa pode não adotar o mesmo mapeamento.
💡 Sugestão de escolha: os dois testes acima mostram que o limiar de aprovação, a taxa de novas tentativas e o retrabalho manual podem mudar qual é a “faixa mais vantajosa”, mas nenhum deles representa a conta do seu próprio negócio. A recomendação é refazer o teste na APIYI apiyi.com, com o mesmo grupo e a mesma amostra, antes de decidir.
3. Ordem de migração e critérios de aceitação para otimização de custos em modelos de raciocínio
3.1 Primeiro mantenha a linha de base, depois ajuste o nível
Conforme a recomendação do guia “Using GPT-6.2” da OpenAI, na migração mude apenas uma variável de cada vez:
- Se hoje você usa 6.1 Sol
low: primeiro troque para 6.2 Sollowcomo base de comparação, depois testemediumseparadamente. - Se hoje você usa 6.1 Sol
medium: primeiro troque o modelo mantendomedium; depois que a aceitação passar, compare comlowusando o mesmo lote de tarefas. - Integração nova: comece com
medium. - Migração de modelos que permitem
noneouminimal: comece testando o GPT-6.2 Sol comlow.
Para tarefas simples com restrições claras, dá para começar validando com low; para tarefas compostas, vá subindo de nível conforme os resultados. Durante a avaliação, mantenha fixos o comando, as definições de ferramentas, o agrupamento e as amostras de teste. Ao mesmo tempo, segundo a documentação oficial, remova os parâmetros que não se aplicam mais, como temperature, top_p e top_logprobs nas requisições Responses.
3.2 Defina os critérios de aceitação por cenário
| Cenário | Critérios de aceitação | Quando considerar subir de nível |
|---|---|---|
| Atendimento ao cliente comum | Consistência com as políticas, campos de valor corretos, condições de escalonamento para humano; links e números de pedido precisam vir do retorno da ferramenta | Quando envolver conflitos entre políticas ou encadeamento de várias ferramentas |
| Alteração de código | Testes passando, funcionalidades-chave completas, volume de retrabalho na revisão de código | Quando a taxa de aprovação no nível baixo cair ou o retrabalho aumentar claramente |
| Conteúdo curto | Cumprimento das restrições, campos factuais, tempo de edição humana | Quando surgirem restrições não cumpridas ou erros factuais |
O custo por tarefa aprovada é calculado assim: some os custos de chamadas, reexecuções, ferramentas e retrabalho humano, e depois divida pelo número de tarefas aprovadas. Desde que o low atinja o critério combinado, você pode escolher low; se o low exigir muitas reexecuções ou remediação humana, a economia no papel pode ser anulada.
💰 Otimização de custos: ao comparar níveis, você pode criar um token separado no APIYI apiyi.com só para a avaliação; assim os logs podem ser filtrados diretamente por token e modelo, o que facilita calcular o gasto real de toda a bateria de testes.
4. Ajuste do nível de effort no meio de uma conversa de múltiplos turnos
4.1 Usar configuration_update para ajustar o nível e preservar o prefixo
Em uma sessão de agente único do OpenAI HTTP Responses que ofereça suporte a esse recurso, mantenha o reasoning.effort no nível da requisição com o valor inicial inalterado e coloque o item abaixo antes da próxima mensagem do usuário:
{"type": "configuration_update", "reasoning": {"effort": "medium"}}
Essa configuração permanece em vigor até a próxima atualização. A vantagem é não precisar reescrever o histórico anterior, mantendo o prefixo da requisição inalterado. Segundo a documentação da OpenAI, a partir do GPT-6.2, editar o histórico anterior pode acionar prefix_mismatch, fazendo com que itens de raciocínio existentes sejam removidos; trocar de família de modelos ou mudar para um modelo de capacidade menor também pode remover itens de raciocínio. O custo de reescrever o prefixo tem duas partes: a leitura de cache pode diminuir e, após perder itens de raciocínio utilizáveis, podem surgir novas saídas de raciocínio. Conforme as instruções oficiais, excluir um item completo e manter os demais inalterados, ou acrescentar novos itens após os itens de raciocínio, não aciona essa remoção, mas o volume de acertos de cache ainda pode mudar. Além disso, no GPT-6.2, o instructions de nível superior é anexado após o input e cobrado como entrada não cacheada.
4.2 Compactação de contexto e observações sobre o roteamento da APIYI
Ao usar context_management no lado do servidor, a configuração atualizada pode continuar valendo. Se você entregar diretamente ao endpoint independente /responses/compact um histórico que contém um configuration_update antigo, a requisição será rejeitada; a abordagem correta é, conforme as instruções oficiais, separar primeiro os itens de configuração e, após concluir a compactação, acrescentar uma configuração mais recente.
Na APIYI, atualmente a abordagem segura é gerenciar você mesmo o histórico de input, sem depender de previous_response_id. O motivo é que o guia de invocação nativa da APIYI é inconsistente nesse ponto: o corpo do texto diz que a continuação em cadeia não funciona, enquanto o FAQ registra que, em 2026-09-02, isso foi testado e funcionou. A documentação da APIYI também não lista, no momento, os resultados de validação do configuration_update em cada grupo. Portanto, configurações específicas como essa, o retorno de itens de raciocínio criptografados e os campos de diagnóstico de cache devem primeiro ser validados separadamente no canal desejado, com sessões curtas; só depois de confirmar que funcionam é que você deve integrá-los ao fluxo de trabalho oficial.
🎯 Sugestão técnica: primeiro execute um conjunto de sessões curtas de dois turnos na rota Responses da APIYI apiyi.com, comparando
cached_tokens,reasoning_tokense tempo gasto entre duas amostras: “apenas acrescentar” e “reescrever o prefixo”. Depois de confirmar o comportamento, decida como implementar o ajuste de nível no meio da conversa.
Consideração final: A base para escolher o nível deve ser o custo por tarefa que atende aos critérios sob um limiar de aceitação fixo. Na APIYI apiyi.com, rodar uma comparação com seus próprios exemplos e sua fatura esclarece mais do que qualquer ranking.
Referências
- OpenAI “Using GPT-6.2”: sugestões de migração e de configuração inicial
- Link:
developers.openai.com/api/docs/guides/latest-model
- Link:
- OpenAI “Reasoning models”: reutilização de
configuration_updatee dos itens de raciocínio- Link:
developers.openai.com/api/docs/guides/reasoning
- Link:
- OpenAI “Compaction”: regras de compactação de contexto
- Link:
developers.openai.com/api/docs/guides/compaction
- Link:
- OpenAI “Keep the prefix unchanged”: diagnóstico de prefixo e cache
- Link:
developers.openai.com/api/docs/guides/keep-prefix-unchanged
- Link:
- eesel AI “GPT-6.2 Sol: what’s new, pricing, benchmarks”: teste real com tickets de atendimento ao cliente, 2026-11-18
- Link:
eesel.ai/blog/gpt-6-2-sol
- Link:
- VulcanBench “GPT-6.2 Sol across effort levels”: avaliação de problemas de código nível por nível, 2026-11-19
- Link:
vulcanbench.com/benchmarks/swe-v4-gpt62-sol-v331.html
- Link:
- OrcaRouter “GPT-6.2 vs GPT-6.1 Sol”: tabela de preços e citação do índice agregado, 2026-11-20
- Link:
orcarouter.ai/blog/gpt-6-2-vs-gpt-6-1-sol
- Link:
- APIYI “Tabela geral de preços de modelos”: dados atualizados em 2026-11-20
- Link:
docs.apiyi.com/models
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: fale com a gente pela página inicial da APIYI apiyi.com; mais instruções de integração estão disponíveis no centro de documentação em docs.apiyi.com