Resumen: este artículo usa el SDK de Python de OpenAI para invocar la API de Tencent Hunyuan Hy4 en modo no streaming, completar con éxito la primera solicitud de solo texto y explicar cómo validar el resultado, estimar el costo, revisar la facturación y manejar los errores más comunes.
Respuesta directa: se puede acceder a la API de Tencent Hunyuan Hy4 mediante la interfaz compatible con OpenAI de APIYI. Solo necesitas preparar tres configuraciones para enviar la primera solicitud:
- Clave API: créala en
api.apiyi.com/tokeny colócala en la variable de entornoAPIYI_API_KEY. - URL base del SDK:
https://api.apiyi.com/v1. - ID del modelo:
hy4.
El endpoint HTTP correspondiente es POST https://api.apiyi.com/v1/chat/completions. A fecha de 2026-11-21, en la tabla de precios, Hy4 cuesta por cada millón de tokens: entrada sin caché $0.85, salida $2.55 y lectura de caché $0.045. La facturación real se rige por la tabla de precios de APIYI, disponible en docs.apiyi.com/models (categoría Tencent).
La cronología es la siguiente: Tencent lanzó la versión oficial de Hy4 el 4 de noviembre y publicó los pesos el 20 de noviembre. APIYI ya tenía listado este modelo antes de que se publicaran los pesos; consulta el anuncio de disponibilidad en docs.apiyi.com/news/hy4-launch. El anuncio ya incluye un ejemplo de streaming, así que este artículo se centra solo en otros cuatro puntos: invocación no streaming, validación de resultados, verificación de facturación y diagnóstico de fallos. El anuncio menciona que Hy4 admite entrada de imágenes; este artículo solo muestra texto. Video, la API Responses y Computer Use quedan fuera del alcance de este artículo, y tampoco se incluyen datos de pruebas reales.
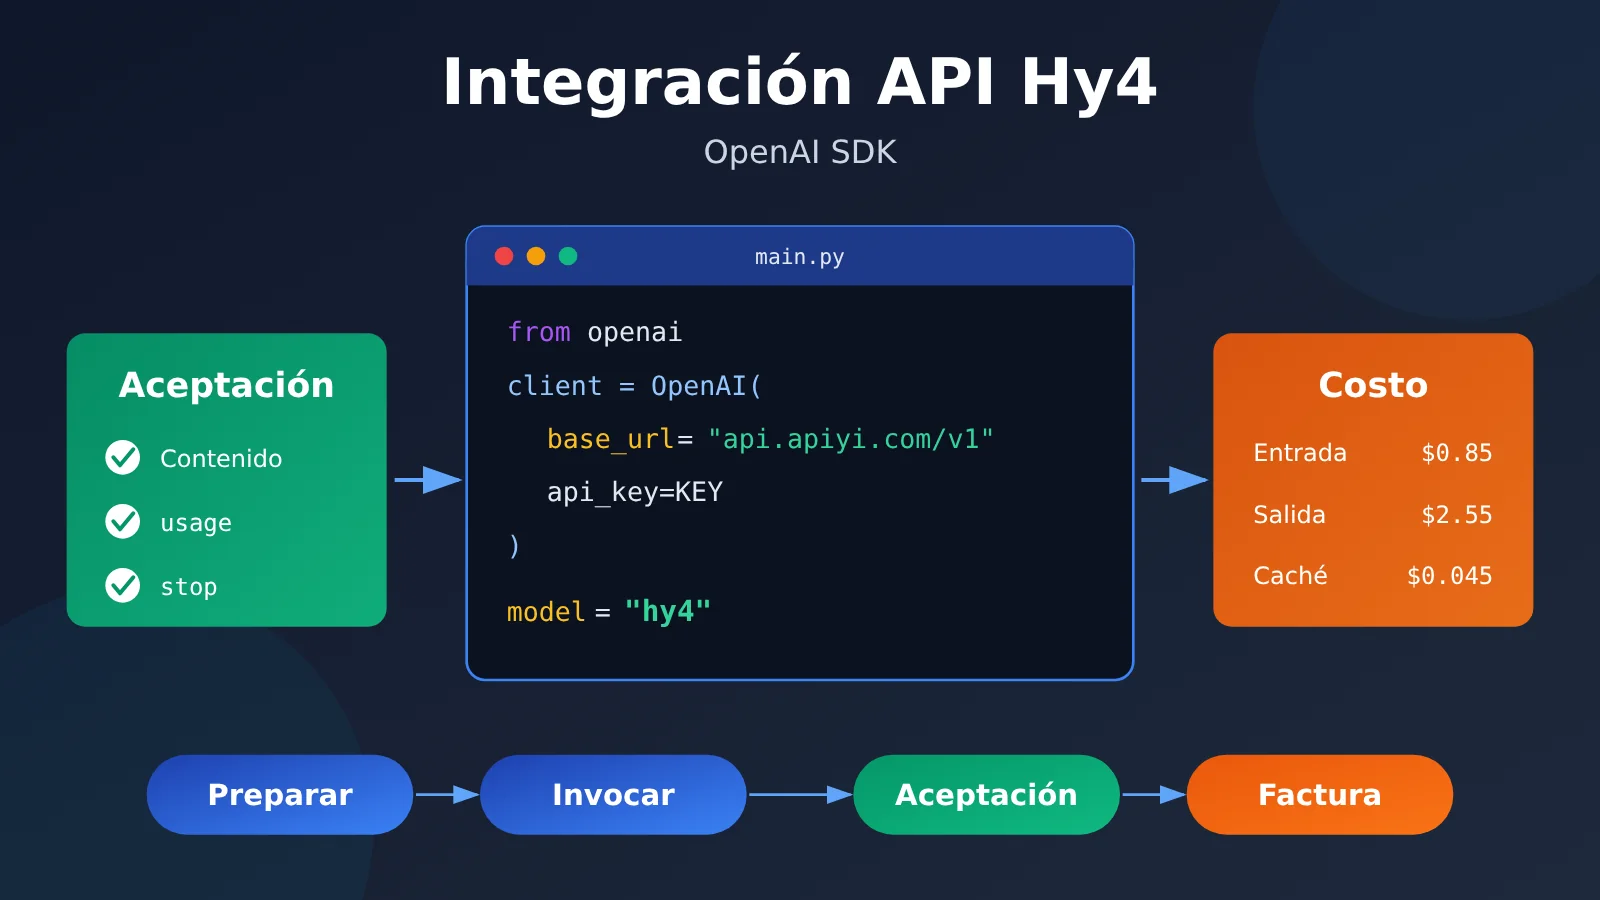
Mapa de conocimiento y orden de lectura para la integración de la API de Tencent Hunyuan Hy4
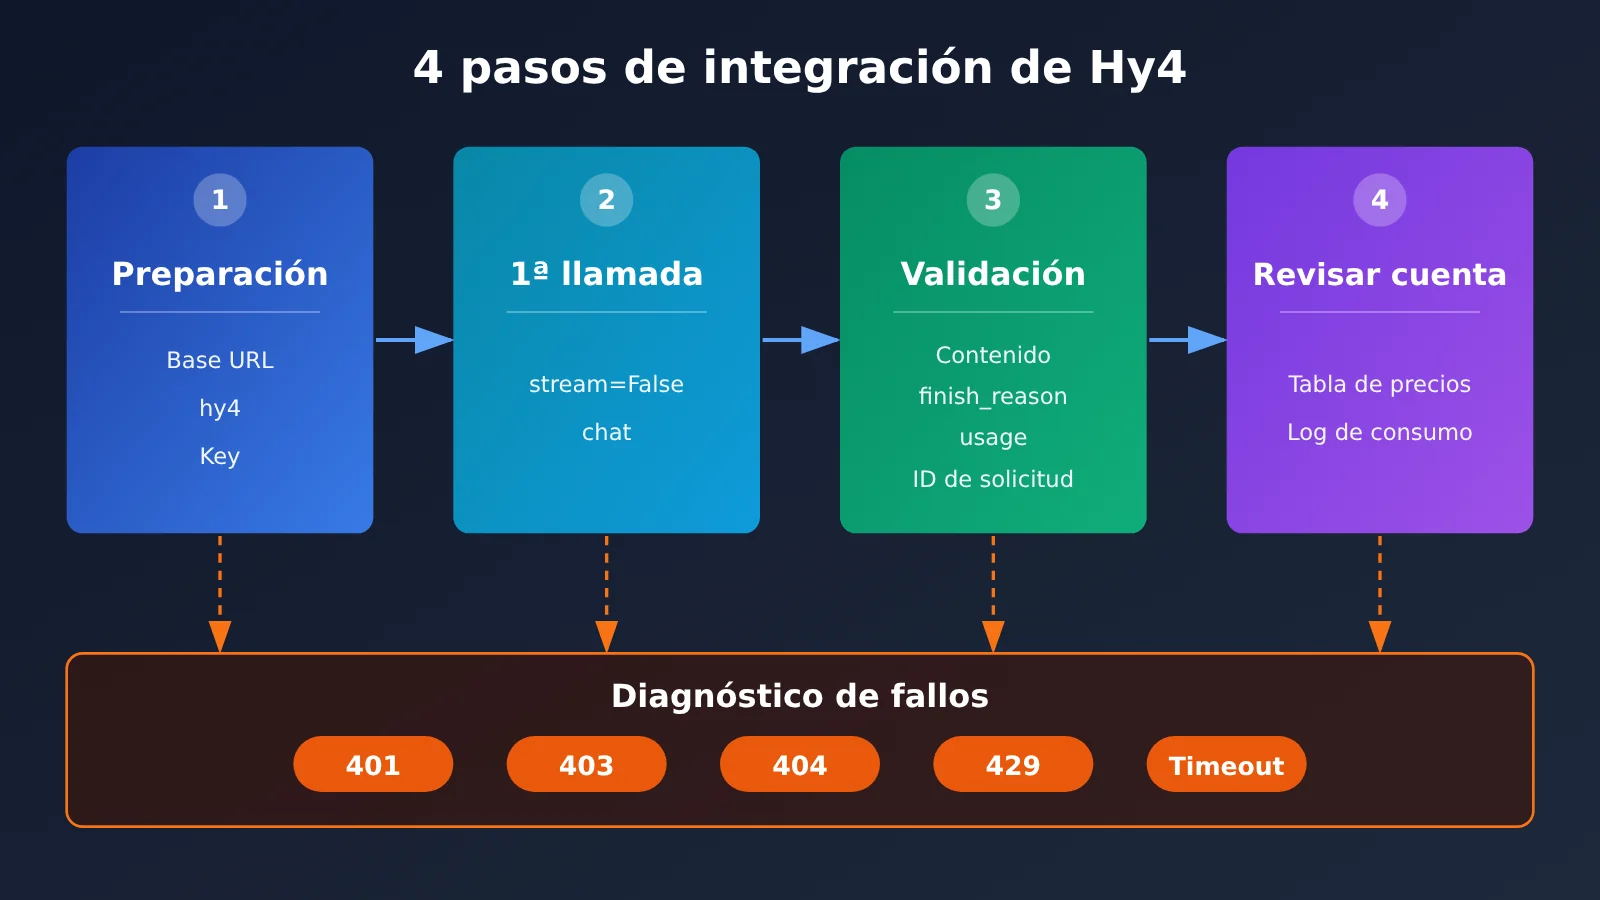
El flujo completo tiene cuatro pasos; la salida de cada paso es la entrada del siguiente. Se recomienda leer en el orden numerado. La sección 4 se puede consultar por separado cuando aparezca un error.
| Paso | Sección correspondiente | Por qué está aquí | Criterio de aceptación |
|---|---|---|---|
| Preparar la solicitud | 1.1 y 1.2 | Si el endpoint, el nombre del modelo o la clave API están mal escritos, los pasos siguientes fallarán | El SDK se puede importar, la variable de entorno puede leer la clave API y no hay ninguna clave API en texto plano en el código |
| Primera llamada | 2.1 y 2.2 | Primero usar un texto corto que no contenga datos del cliente para confirmar que la conexión funciona | El contenido devuelto es «产品=混元、版本=Hy4», no está truncado y se guardaron usage y request ID |
| Verificar la facturación | 3.1 y 3.2 | Una vez que la conexión funciona, estimar el costo para decidir si se puede escalar el volumen de llamadas | La estimación coincide partida por partida con el registro de consumo de la consola |
| Diagnóstico de fallos | 4 | Cuando falle cualquiera de los pasos, localizar la causa según el código y el cuerpo del error | Poder distinguir errores de configuración, problemas de permisos, limitación de frecuencia y tiempos de espera agotados, y determinar si se puede reintentar |
Para saber: términos relacionados con la API de Hy4
| Término | Explicación breve |
|---|---|
| Sin streaming (stream=False) | El modelo devuelve el resultado completo de una vez después de terminar la generación, lo que facilita revisar el contenido y el consumo en su conjunto |
| finish_reason | Motivo por el que terminó esta generación. stop indica una finalización normal; length indica que se truncó al alcanzar el límite de longitud |
| usage | Campo de consumo de tokens en la respuesta; los más comunes son prompt_tokens (entrada) y completion_tokens (salida) |
| request ID | Identificador de una solicitud individual, que sirve para localizar esta llamada en los registros. No todas las respuestas lo incluyen necesariamente |
| Lectura de caché | La parte de la entrada que acierta en la caché, facturada según la tarifa independiente de lectura de caché |
| Grupo (Default/SVIP) | Grupo al que pertenece el token, que determina qué modelos puede invocar dicho token |
1. Preparar la solicitud a la API de Tencent Hunyuan Hy4
1.1 Configurar el modelo Hy4 y el endpoint
Verifica cada elemento de configuración uno por uno. La mayoría de los fallos en la primera llamada ocurren justo en este paso.
| Elemento de configuración | Valor | Descripción |
|---|---|---|
| SDK base_url | https://api.apiyi.com/v1 |
Solo hasta /v1; el SDK añadirá /chat/completions automáticamente |
| Endpoint HTTP | POST https://api.apiyi.com/v1/chat/completions |
Usa esta dirección cuando no utilices el SDK y envíes la solicitud HTTP directamente |
| ID del modelo | hy4 |
Nombre del modelo de la versión oficial; escríbelo en minúsculas tal cual |
| Grupos disponibles | Default, SVIP | El grupo al que pertenece el token debe incluir Hy4 |
| Modo de salida | stream=False |
En este artículo se usa el modo no streaming en todo momento |
El error más común es colocar el endpoint completo en base_url. El SDK volverá a añadir /chat/completions detrás de esa dirección, lo que duplica la ruta y termina devolviendo un 404. La documentación completa de la interfaz compatible está en docs.apiyi.com/api-capabilities/openai/compatible.
1.2 Instalar el SDK de OpenAI y guardar la Key de forma segura
La dirección del proyecto oficial del SDK de Python es github.com/openai/openai-python. Se recomienda instalarlo en un entorno virtual para evitar conflictos de versión con paquetes ya existentes en el sistema:
python -m venv .venv
source .venv/bin/activate          # Windows: .venv\Scripts\activate
python -m pip install openai
La Key se crea en api.apiyi.com/token. Al crearla, asegúrate de que el grupo al que pertenece el token pueda invocar Hy4. Una vez tengas la Key, guárdala en la variable de entorno del terminal actual; no la escribas en el archivo de código:
export APIYI_API_KEY="tu token" # Windows PowerShell: $env:APIYI_API_KEY="tu token"
Al gestionar la Key, ten en cuenta los siguientes puntos:
- El código lee la Key únicamente a través de
os.environ['APIYI_API_KEY']. Si la variable de entorno no está definida, usagetpasspara solicitarla de forma interactiva; lo que introduzcas no se mostrará en pantalla. - Si guardas la Key en un archivo
.env, añádelo a.gitignorepara evitar subirlo al repositorio. - Si la Key aparece en capturas de pantalla, logs o tickets, sustitúyela primero por una máscara como
sk-***.
Verificación: ejecuta en el terminal python -c "import openai, os; print(openai.__version__, bool(os.environ.get('APIYI_API_KEY')))". Si se muestra el número de versión y True, significa que este paso está completado.
2. Enviar la primera solicitud a Hy4 con el SDK de OpenAI
2.1 Ejemplo completo en Python sin streaming
Esta primera solicitud hace solo algo muy simple: extraer el nombre del producto y el número de versión de una frase pública, sin incluir ningún dato de cliente. Este diseño tiene dos ventajas. Primera, la salida es muy corta y el costo bajo. Segunda, la respuesta es única, así que es fácil saber si acertó o no.
import os
import re
from getpass import getpass
from openai import OpenAI

key = os.environ.get("APIYI_API_KEY") or getpass("输入 APIYI_API_KEY:")

PROMPT = "仅从这句话提取产品和版本:腾讯混元 Hy4 正式版已上线。请只写一行:产品=…;版本=…"

with OpenAI(
    base_url="https://api.apiyi.com/v1",   # Interfaz compatible con OpenAI de APIYI
    api_key=key,
    timeout=60.0,
    max_retries=0,                         # Desactiva el reintento automático; si falla, una persona decide si reenviar
) as client:
    result = client.chat.completions.create(
        model="hy4",
        messages=[{"role": "user", "content": PROMPT}],
        stream=False,
    )

request_id = getattr(result, "_request_id", None)
print("request_id:", request_id if request_id else "响应未提供")

if not result.choices:
    raise SystemExit("未通过:choices 为空,没有返回正文")

choice = result.choices[0]
content = (choice.message.content or "").strip()
print("finish_reason:", choice.finish_reason)
print("content:", content)

usage = getattr(result, "usage", None)
prompt_tokens = getattr(usage, "prompt_tokens", None) if usage else None
completion_tokens = getattr(usage, "completion_tokens", None) if usage else None
print("prompt_tokens:", prompt_tokens if prompt_tokens is not None else "缺失(不按 0 处理)")
print("completion_tokens:", completion_tokens if completion_tokens is not None else "缺失(不按 0 处理)")


def accept(text: str, finish_reason) -> tuple[bool, str]:
    if not text:
        return False, "正文为空"
    if finish_reason == "length":
        return False, "输出被截断"
    t = re.sub(r"\s+", "", text)
    t = t.replace(":", "=").replace(":", "=").replace(";", ";")
    prod = re.search(r"产品=([^;\n]+)", t)
    ver = re.search(r"版本=([^;\n]+)", t)
    if not prod or not ver:
        return False, "缺少产品或版本字段"
    strip_punct = lambda s: re.sub(r"[。..,,、!!??\"“”'‘’]", "", s)
    if "混元" not in strip_punct(prod.group(1)):
        return False, f"产品值错误:{prod.group(1)}"
    if strip_punct(ver.group(1)) != "Hy4":
        return False, f"版本值错误:{ver.group(1)}"
    return True, "通过"


ok, reason = accept(content, choice.finish_reason)
print("验收:", reason)
Algunos ajustes del ejemplo merecen una explicación:
max_retries=0desactiva el reintento automático del SDK. En la sección 4 veremos que, después de un timeout, el servidor puede haber ejecutado ya la solicitud, y reenviarla de forma automática podría generar un cobro duplicado; por eso, si se reintenta o no, debe decidirlo una persona.- La sentencia
withcierra la conexión cuando termina la llamada. - Cuando falta el campo usage, el código imprime explícitamente «缺失» y no lo trata como 0, para que más adelante no se pierdan costos al hacer cuentas.
Para más detalles sobre la estructura de la respuesta, consulta docs.apiyi.com/api-capabilities/openai/response-handling.
2.2 Criterios de aceptación para la primera solicitud Hy4
Al validar, solo hay que fijarse en dos campos de message.content: el valor de producto debe contener “混元” y el valor de versión debe ser “Hy4”. Se aceptan diferencias entre dos puntos y punto y coma de ancho completo o medio, así como diferencias de puntuación al final de la frase. A continuación, una línea de salida que cumple los requisitos; esto es un formato ilustrativo, no una respuesta real:
产品=腾讯混元;版本=Hy4
Los siguientes casos se consideran siempre no aprobados; no se deben dar por válidos solo porque «parecen casi correctos»:
| Caso | Veredicto | Motivo |
|---|---|---|
choices está vacío, o content es una cadena vacía |
No aprobado | No se obtuvo el cuerpo del mensaje, lo que indica que la ruta de la llamada no funcionó realmente |
finish_reason es length |
No aprobado | La salida quedó truncada; el resultado está incompleto |
| La versión está escrita como Hy3, Hunyuan u otro valor | No aprobado | El valor del campo es incorrecto |
| Solo cambian el ancho completo o medio de los signos de puntuación, los espacios o los dos puntos | Aprobado | Es una diferencia de formato permitida |
Una vez aprobada la validación, registre el request ID (si aparece en la respuesta), la hora de la solicitud, el nombre del modelo, prompt_tokens y completion_tokens. Esta información será necesaria al revisar la facturación en la sección 3.2.
3. Estimar y verificar los costes de la API Hy4
3.1 Estimar una tarea por lotes con la tabla de precios
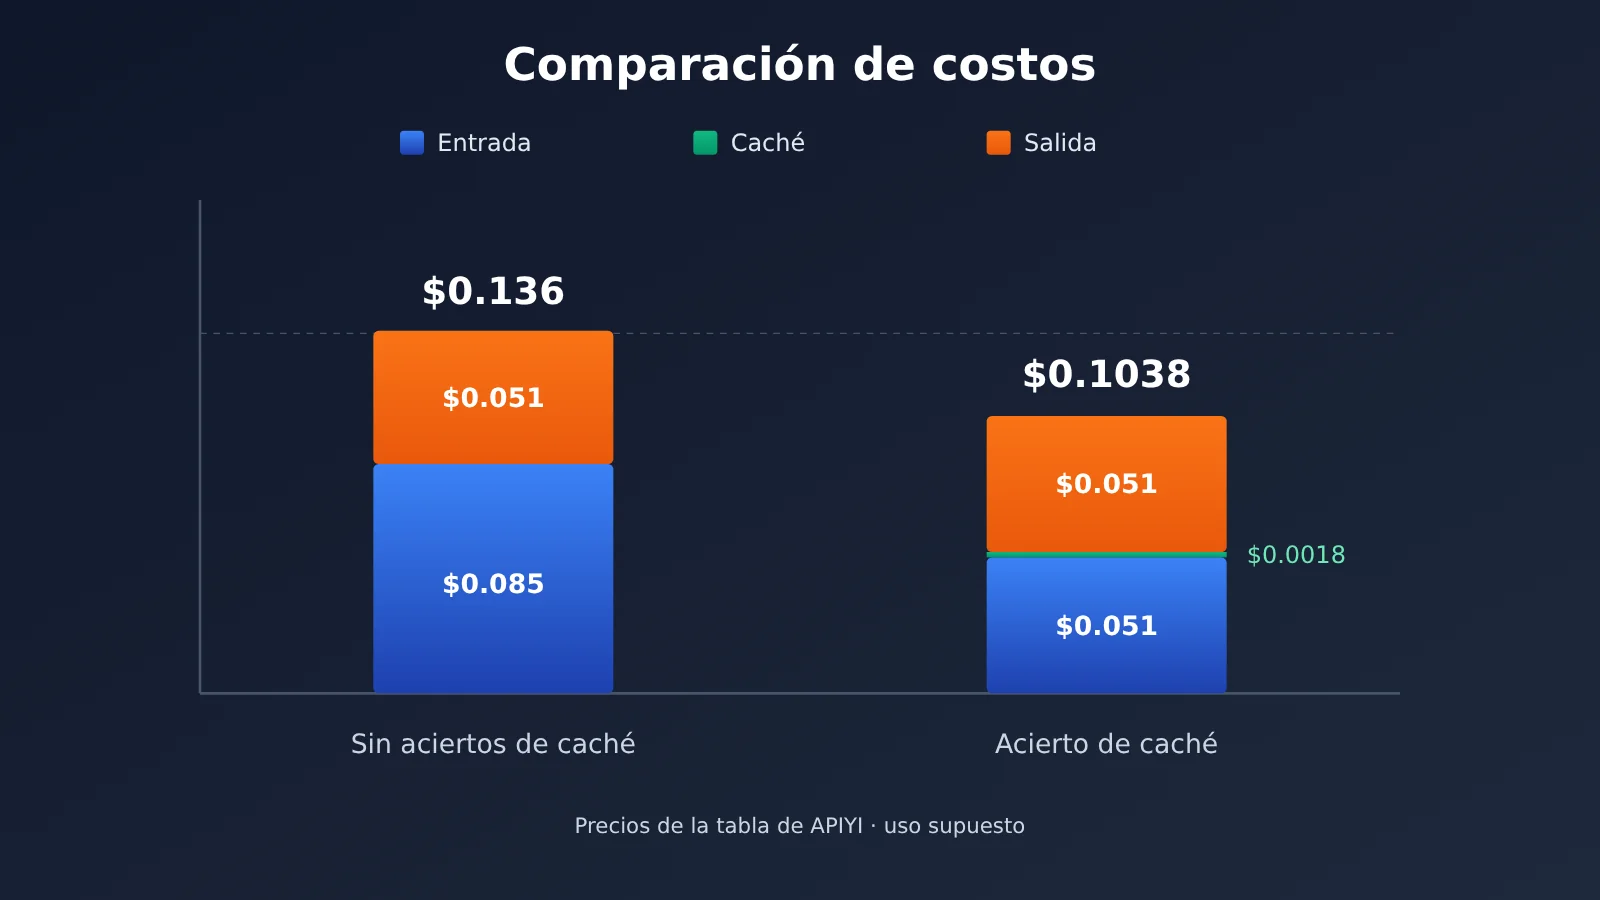
La entrada de la primera solicitud es muy corta, así que su coste resulta insignificante y usarla para estimar el gasto no tiene mucho sentido. Cambiemos a un escenario hipotético que no tiene nada que ver con aquella solicitud corta del ejemplo: supongamos una tarea con 100 000 tokens de entrada, ninguno con acierto de caché, y 20 000 tokens de salida. La entrada y la salida se calculan cada una con su propio precio unitario:
| Concepto de facturación | Uso supuesto | Precio unitario (por millón de tokens) | Coste |
|---|---|---|---|
| Entrada sin acierto de caché | 100,000 | $0.85 | $0.085 |
| Salida | 20,000 | $2.55 | $0.051 |
| Total | — | — | $0.136 |
El cálculo es 0.1 × 0.85 + 0.02 × 2.55 = 0.136. A la hora de estimar hay que tener en cuenta dos cosas:
- El precio de la salida triplica el de la entrada sin acierto de caché. En tareas con mucho volumen de salida, el coste lo determina sobre todo la salida.
- Si completion_tokens ya incluye la parte de razonamiento del modelo, no añadas aparte un coste de razonamiento, porque lo contarías dos veces.
3.2 Distinguir el bucket de caché del registro real de consumo
La «lectura de caché» es un concepto que se factura aparte, pero la forma de desglosar los campos no tiene por qué ser la misma en todas las respuestas, así que no existe un nombre de campo universal que garantice un resultado exacto. Lo fiable es comprobar primero en la factura si los tokens con acierto de caché ya están incluidos en la entrada total.
Si la factura confirma que la parte de caché ya está dentro de la entrada total, resta esa parte de caché una vez del total de entrada y luego aplica cada precio por separado. Mantengamos el supuesto de 3.1 y añadamos que, de los 100 000 tokens de entrada, 40 000 tienen acierto de caché:
| Concepto de facturación | Uso supuesto | Precio unitario (por millón de tokens) | Coste |
|---|---|---|---|
| Entrada sin acierto de caché | 60,000 | $0.85 | $0.051 |
| Lectura de caché | 40,000 | $0.045 | $0.0018 |
| Salida | 20,000 | $2.55 | $0.051 |
| Total | — | — | $0.1038 |
Los valores estimados solo sirven de referencia; lo que cuenta al final es el registro de consumo. Para verificarlo, filtra los registros correspondientes en la consola api.apiyi.com/log:
- Acota el rango por la hora de la solicitud.
- Si la respuesta proporciona un request ID, úsalo para localizar con precisión esa solicitud.
- Confirma que el modelo es
hy4y que el token coincide con el que usa realmente el código. - Compara el uso de entrada, caché y salida, y el importe cobrado que aparecen en el registro, para ver si coinciden con los valores estimados.
El significado concreto de los campos del registro se explica en docs.apiyi.com/faq/log-billing-explained.
4. Resolución de problemas de fallos en la API Hy4
Al solucionar problemas, primero revisa el código de estado HTTP y luego lee la información específica del cuerpo del error. Quedarse solo con el código de estado facilita diagnósticos erróneos; por ejemplo, un 429 puede deberse a causas completamente distintas. En la solicitud original de la sección 2.1, captura las excepciones del SDK: para tiempos de espera de conexión revisa APITimeoutError, para otras fallas de conexión revisa APIConnectionError; cuando obtengas una respuesta de error, registra desde APIStatusError el status_code, el request_id y el cuerpo del error. Primero determina el resultado de la solicitud existente y luego decide si vale la pena reintentar; antes de enviar comentarios, anonimiza el cuerpo del error. El orden de procesamiento es el siguiente:
| Error | Verificación prioritaria | ¿Reintentar? |
|---|---|---|
| 401 | Si la Key es correcta, si ya caducó, y si base_url es https://api.apiyi.com/v1 |
No reintentar antes de corregir la configuración |
| 403 | Según el cuerpo del error, determinar si es un problema de permisos de grupo; confirmar que el grupo del token incluya Hy4 | No reintentar antes de corregir los permisos |
| 404 | Si la ruta concatenó /chat/completions de forma duplicada, y si el nombre del modelo es hy4 |
No reintentar antes de corregir la configuración |
| 429 | Según el cuerpo del error, determinar si es limitación temporal de tasa o cuota insuficiente | La limitación temporal admite reintentos con backoff limitados; la cuota insuficiente requiere recargar o ajustar la cuota primero |
| Error de conexión | Si la red, el proxy y el DNS funcionan correctamente, y si el protocolo y dominio de base_url son correctos | Se puede reintentar tras restablecerse la red |
| Tiempo de espera | Primero busca por hora en api.apiyi.com/log para confirmar si la solicitud ya se ejecutó |
Si ya se ejecutó, no reenviar; si no se ejecutó, entonces reintentar |
Cabe explicar especialmente los casos de 429 y tiempo de espera:
- Reintento con backoff para 429: solo aplica a limitación temporal de tasa. El número de reintentos debe tener un límite superior, y el intervalo debe aumentar gradualmente en cada intento. Cuando la cuota es insuficiente, por muchos reintentos que hagas, nunca tendrán éxito.
- Tiempo de espera: que el cliente no reciba respuesta en 60 segundos no significa que el servidor no haya procesado la solicitud. Si el servidor ya terminó de procesarla, reenviarla directamente la ejecutará de nuevo, y también se cobrará otra vez. Por eso, primero revisa los logs, confirma que la solicitud no se ejecutó, y luego reenvíala.
Si necesitas contactar al soporte técnico, antes de enviar anonimiza la Key, los datos del cliente y demás información sensible en el cuerpo del error y los logs, y luego adjunta el código de estado, la hora de la solicitud, el nombre del modelo y el request ID. Para saber cómo conservar y enviar la información de error, consulta docs.apiyi.com/api-manual/error-reporting.
Una vez completada toda la resolución de problemas, vuelve a ejecutar el ejemplo de 2.1. Todo el flujo solo se considera aprobado si cumple las tres condiciones siguientes al mismo tiempo:
- La función de aceptación imprime «通过».
- finish_reason no es
length. - En los logs de la consola se puede encontrar un registro con la misma hora y el modelo
hy4, y el uso coincide con el usage registrado localmente.