Nota do autor: usar a mesma chave API e o mesmo endpoint compatível com OpenAI para alternar entre Modelos de Linguagem Grandes, explicando com clareza quais campos, estados e critérios de aceitação exigem adaptação individual ao integrar imagens e embeddings entre modelos diferentes.
Neste artigo, vamos fazer a alternância entre modelos de texto puro funcionar de ponta a ponta com uma única chave API e um único endpoint compatível com OpenAI e, em seguida, por meio de dois exemplos — imagem e vetores — mostrar quais campos, estados e critérios de aceitação precisam ser adaptados individualmente na integração entre modelos. Essa conclusão tem uma premissa: quando você usa, no mesmo endpoint, apenas os parâmetros comuns suportados pelos dois modelos, alternar de modelo geralmente exige mudar apenas o campo model. Assim que entram parâmetros proprietários de raciocínio, chamadas de ferramentas, dimensões de imagem ou dimensões de vetor, é preciso conferir cada modelo separadamente.
Este não é um texto promocional do tipo “mude uma linha de código e tudo se resolve”. Vamos separar com clareza as partes que a interface unificada da APIYI permite reutilizar daquelas que precisam ser revalidadas, e também vamos cobrir os cenários de falha.
Valor central: ao terminar a leitura, você será capaz de alternar modelos de texto usando o mesmo esquema de autenticação e o mesmo código, saberá quais parâmetros alterar ao trocar de modelo para imagens e embeddings, e terá em mãos um método prático de validação para a alternância.
9 termos que você precisa entender antes de trocar de Modelo de Linguagem Grande pela interface unificada da APIYI
A maioria dos problemas que aparecem na hora de trocar de modelo vem de interpretações divergentes dos termos. Por exemplo, escrever o Base URL com /v1 duplicado, ou achar que vetores de mesma dimensão podem ser misturados. Padronize primeiro o conjunto de conceitos abaixo — todos os passos das próximas seções partem dessas definições.
| Termo | Significado real | O que observar na troca |
|---|---|---|
| Base URL | O endereço raiz que o SDK usa para montar o caminho dos endpoints | No SDK da OpenAI, preencha até /v1 para evitar concatenação duplicada |
| API Key | A credencial de autenticação das requisições à API | Guarde apenas na configuração do servidor ou em variáveis de ambiente |
| ID do modelo | O modelo indicado na requisição, podendo incluir informações de versão ou de canal | Copie o ID original do registro de modelos, não digite à mão |
| Agrupamento de tokens | Define quais modelos, canais e condições de cobrança estão disponíveis para a Key atual | Se o modelo não estiver no agrupamento, a resposta será 401/403 ou 404 |
| Chat Completions | O protocolo de interface para conversas em texto baseado em um array de mensagens | A porta de entrada principal para trocas somente com texto |
| Responses | O protocolo de interface que suporta múltiplos tipos de saída e chamadas de ferramentas | As chamadas de ferramentas do GPT-6.2 precisam passar por aqui |
| Embedding | Codifica o conteúdo em vetores de dimensão fixa, usados em busca por similaridade, recuperação e afins | Trocar de modelo equivale a trocar de espaço vetorial |
| Índice vetorial | Estrutura que localiza itens similares com base numa dimensão e num espaço vetorial específicos | Qualquer mudança de dimensão ou de modelo exige reconstrução |
| Latência até o primeiro token visível | O tempo de espera entre o envio da requisição e o primeiro trecho útil de conteúdo gerado exibido ao usuário | O tempo de raciocínio dos modelos de inferência alonga essa métrica |
Dentre todos, o agrupamento de tokens é o mais fácil de ficar de fora. Na mesma conta, Keys de agrupamentos diferentes podem enxergar listas de modelos distintas. Por isso, ao investigar um erro de “modelo não encontrado”, confirme primeiro o agrupamento ao qual a Key pertence, em vez de desconfiar logo do código.
Pontos essenciais para alternar Modelos de Linguagem Grande com a interface unificada da APIYI
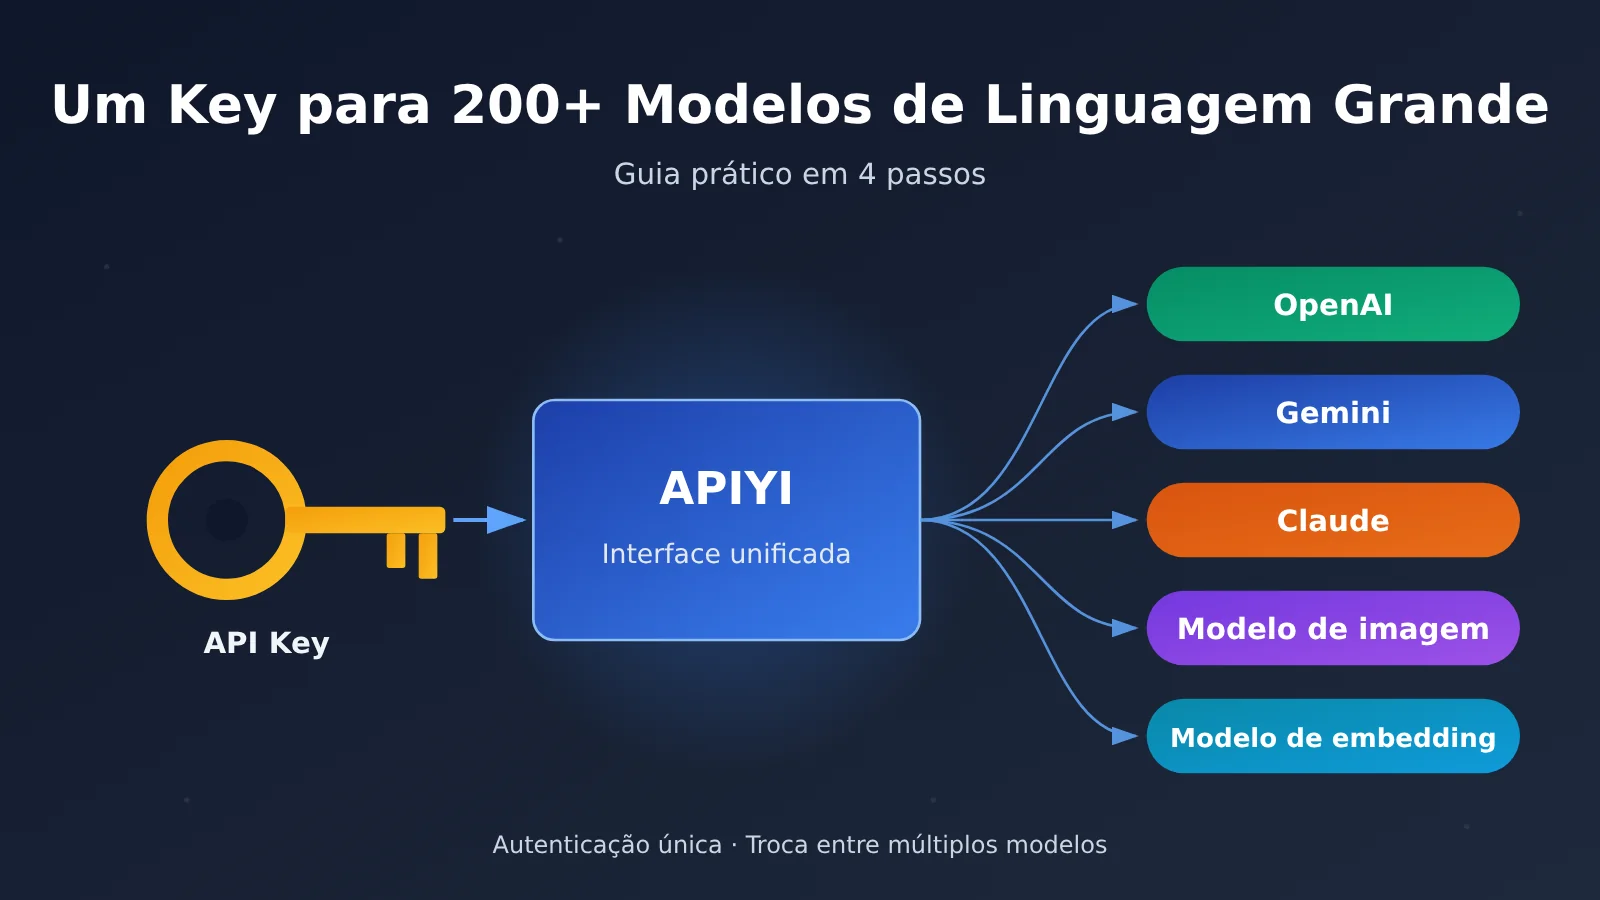
O que a integração unificada realmente economiza é o “trabalho repetitivo”: você não precisa criar uma conta separada para cada fornecedor, gerenciar várias chaves nem adaptar múltiplos SDKs. Segundo a introdução básica e a documentação de início rápido da APIYI (apiyi.com), uma única configuração de autenticação mais um ponto de entrada compatível com OpenAI já são suficientes para acessar os modelos disponíveis de diferentes fornecedores.
| Camada | O que pode ser reaproveitado | O que precisa ser verificado por modelo |
|---|---|---|
| Autenticação | A mesma chave API, o mesmo conjunto de cabeçalhos de requisição | Se o grupo de tokens ao qual a chave pertence inclui o modelo-alvo |
| Ponto de entrada | O mesmo Base URL | Quais endpoints o modelo-alvo suporta (conversa / Responses / imagem / vetores) |
| Corpo da requisição | Campos comuns como model, messages básico e input |
Níveis de raciocínio, ferramentas, saída estruturada, tamanho da imagem, dimensão dos vetores |
| Processamento da resposta | Lógica de análise de choices, finish_reason e usage |
Retornos especiais, como corpo vazio, apenas chamadas de ferramenta e filtragem de segurança |
| Faturamento | Saldo e faturas da mesma conta | Preço unitário, faixa de preço e forma de cobrança de cache variam entre os modelos |
200+ e 289: as duas contagens de modelos da APIYI
Na introdução pública da APIYI, o número divulgado é de mais de 200 modelos selecionados. Já no registro público de modelos gerado em 20/11/2026, o campo model_count registra 289. Os dois números não se contradizem: a contagem do registro inclui diferentes versões do mesmo modelo e variantes de rotas alternativas, por isso o total de entradas é maior que o número de “modelos selecionados”.
Vale lembrar que a lista de modelos que um único token consegue realmente invocar ainda passa por uma tripla restrição: grupo, autorização do modelo e endpoint. Um ID existir no registro não significa que a chave que você tem em mãos conseguirá invocá-lo.
Ordem de verificação antes de alternar
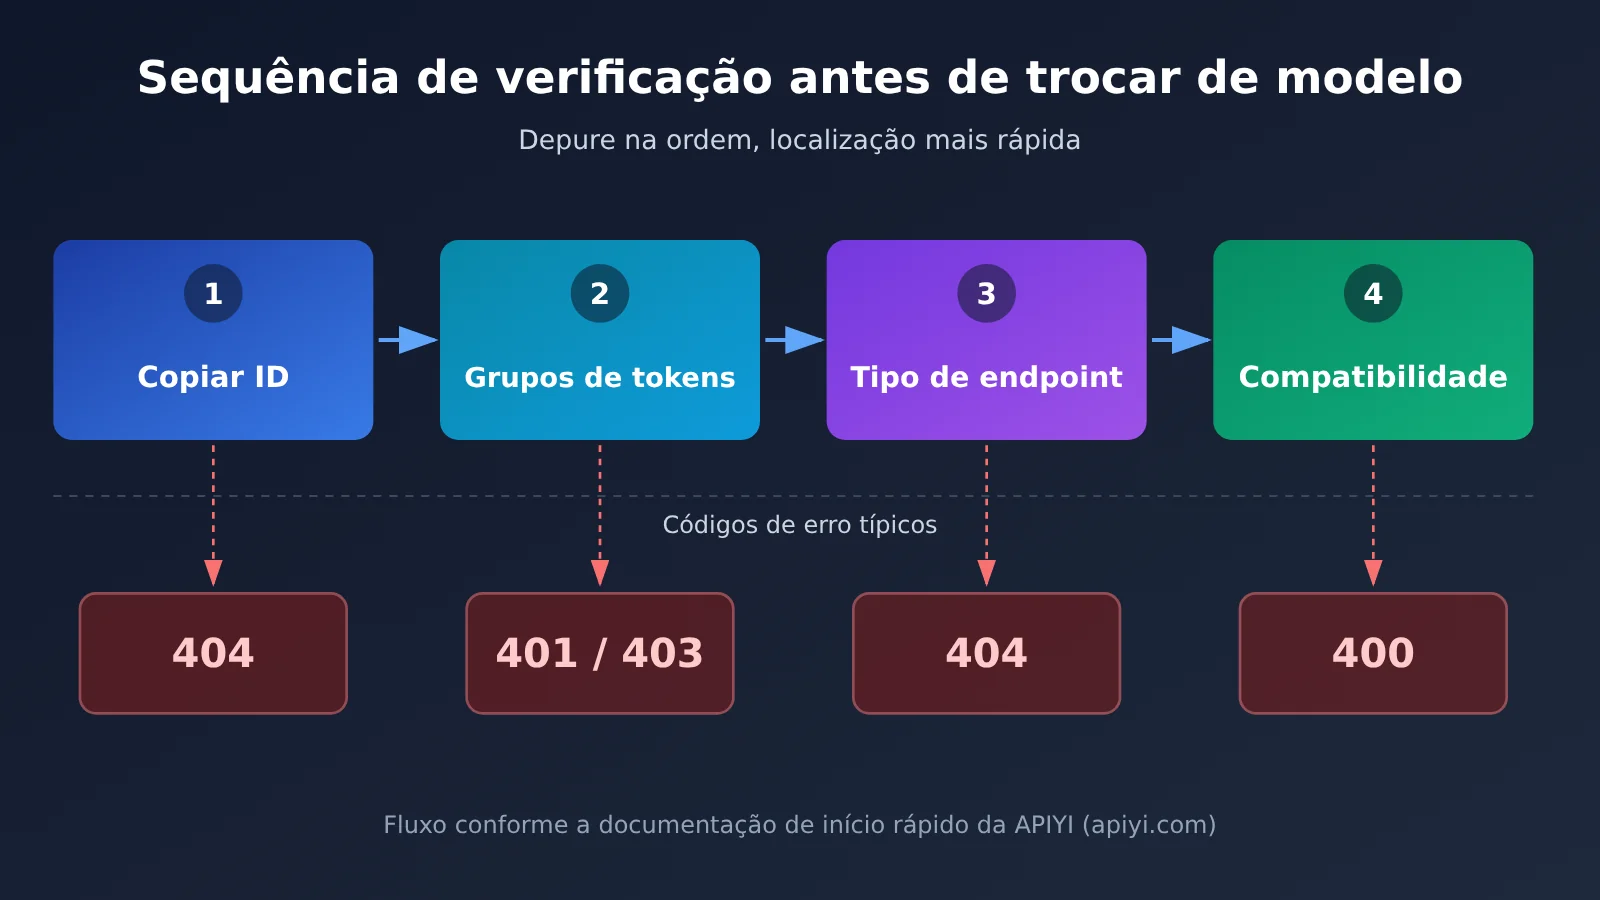
Recomendo verificar sempre na mesma ordem ao introduzir um novo modelo, para não ter que investigar várias frentes ao mesmo tempo quando algo der errado:
- Verifique o ID do modelo: copie o ID original do registro de modelos do dia e confirme se maiúsculas, minúsculas e hífens estão exatamente iguais.
- Verifique o grupo do token: confirme se o grupo ao qual a chave atual pertence liberou esse modelo — alguns modelos ficam disponíveis apenas em grupos específicos.
- Verifique o endpoint: confirme se o modelo suporta o tipo de interface que você quer invocar; os endpoints de texto, imagem e vetores são diferentes entre si.
- Verifique os parâmetros: mantenha apenas os parâmetros comuns que ambos os modelos suportam e readicione os parâmetros exclusivos um a um para validar.
Como alternar rapidamente entre Modelos de Linguagem Grandes de texto usando a interface unificada da APIYI
A seguir, vamos usar como exemplo dois modelos de texto acessados via Chat Completions: gemini-4-neon e gpt-6.2-sol. Os dois utilizam POST /v1/chat/completions e, quando você trabalha apenas com o messages básico, trocar de modelo se resume a substituir o campo model. O único pré-requisito é que o grupo da sua chave tenha visibilidade desses dois modelos — antes de fazer a chamada, confirme isso no registro de modelos.
Exemplo minimalista: alternar entre dois modelos com o mesmo código
Defina a Base URL como https://api.apiyi.com/v1 e leia a chave API a partir de uma variável de ambiente:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],     # mantenha apenas nas variáveis de ambiente do servidor
    base_url="https://api.apiyi.com/v1",     # endpoint compatível com OpenAI da APIYI
)

for model in ["gemini-4-neon", "gpt-6.2-sol"]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是向量索引"}],
    )
    choice = resp.choices[0]
    print(model, "| finish_reason:", choice.finish_reason, "| usage:", resp.usage)
    print(choice.message.content or "<空正文>")
Verifique os campos da resposta, não confie apenas no HTTP 200
Depois de receber a resposta, confira pelo menos três pontos: se choices[0].message.content está vazio; se finish_reason terminou com stop ou foi interrompido por truncamento de comprimento ou outro motivo; e se o consumo de tokens em usage está dentro do esperado. Nos modelos de raciocínio, o processo de pensamento também consome o orçamento de saída — quando esse orçamento é muito pequeno, pode ocorrer o caso de “HTTP 200 mas com corpo vazio”.
Além disso, o nome com que o modelo se identifica no corpo da resposta não serve como base para verificar qual é o modelo real do backend. Quando precisar confirmar qual modelo foi realmente invocado, priorize a consulta ao ID da requisição, aos metadados da resposta e aos logs de faturamento.
Ver o código de implementação completo: inclui latência do primeiro token em streaming, novas tentativas com backoff e registro de métricas
import os
import time
import random
from openai import OpenAI, RateLimitError, APIStatusError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",   # interface unificada da APIYI
)

def call_once(model: str, prompt: str, max_retries: int = 3) -> dict:
    """Faz uma chamada em streaming, registrando a latência do primeiro token visível, o tempo total e o motivo de conclusão"""
    for attempt in range(max_retries + 1):
        start = time.perf_counter()
        first_token_at = None
        parts, finish_reason, usage = [], None, None
        try:
            stream = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
                stream=True,
                stream_options={"include_usage": True},
            )
            for chunk in stream:
                if chunk.usage:
                    usage = chunk.usage
                if not chunk.choices:
                    continue
                delta = chunk.choices[0].delta
                if delta and delta.content:
                    if first_token_at is None:
                        first_token_at = time.perf_counter()
                    parts.append(delta.content)
                if chunk.choices[0].finish_reason:
                    finish_reason = chunk.choices[0].finish_reason
            end = time.perf_counter()
            return {
                "model": model,
                "ok": bool(parts),
                "ttft_s": round(first_token_at - start, 3) if first_token_at else None,
                "total_s": round(end - start, 3),
                "finish_reason": finish_reason,
                "usage": usage,
                "text": "".join(parts),
            }
        except RateLimitError:
            # aplica backoff exponencial com jitter, apenas para rate limits de curto prazo e por um número limitado de tentativas
            if attempt == max_retries:
                raise
            time.sleep((2 ** attempt) + random.uniform(0, 0.5))
        except APIStatusError as e:
            # 400/401/403/404 indicam problemas de configuração ou de parâmetros; não adianta tentar novamente
            return {"model": model, "ok": False, "status": e.status_code,
                    "error": str(e)[:300]}

if __name__ == "__main__":
    prompt = "用三句话说明向量索引为什么要和 Embedding 模型绑定"
    for m in ["gemini-4-neon", "gpt-6.2-sol"]:
        r = call_once(m, prompt)
        print({k: v for k, v in r.items() if k != "text"})
🚀 Início rápido: recomendo primeiro rodar o exemplo minimalista acima na APIYI (apiyi.com) usando o crédito de teste gratuito para novos usuários, confirmando que ambos os IDs de modelo conseguem retornar o corpo da resposta no seu grupo de tokens, e só depois integrar ao código da aplicação.
Parâmetros proprietários exigem verificação separada
O exemplo acima usou deliberadamente apenas campos comuns. Mas assim que você adicionar qualquer um dos parâmetros abaixo, já não dá para presumir que “basta trocar o model”:
- Série GPT-6.2: na OpenAI API, tanto
gpt-6.2-astraquantogpt-6.2-solsuportam Chat Completions e Responses. No Chat Completions, o campo do nível de raciocínio éreasoning_effort; no Responses, éreasoning.effort. Ambos rejeitam o valornone. Quando precisar de chamadas de ferramentas, é obrigatório migrar para o Responses. - Série Gemini 4: o
gemini-4-neonsuporta o esquema nativo do Gemini da APIYI e também o chat compatível com OpenAI. No REST nativo, usa-se/v1beta/models/{id}:generateContent, e o nível de raciocínio é definido emgenerationConfig.thinkingConfig.thinkingLevel, com as opçõeslow,medium,highexhigh, sendohigho padrão. O antigothinkingBudgete o valorminimalnão se aplicam ao Gemini 4; a documentação do Google também registra que o Gemini 4 ignoratemperatureetopP. - Saída estruturada e ferramentas: as restrições de JSON Schema e o formato de definição de ferramentas dos dois lados podem não ser idênticos — valide item por item conforme a documentação do modelo de destino.
Vale destacar que as notas de lançamento do Neon da APIYI mencionam que, na estreia, apenas a interface de preços foi conferida, sem chamadas reais de teste antes do lançamento. Por isso, o suporte aos dois endpoints e às chamadas de ferramentas descrito acima é um comportamento documentado — antes de colocar em produção, valide por conta própria com requisições mínimas.
APIYI: alternância entre capacidades na interface unificada — comparação entre imagem e Embedding
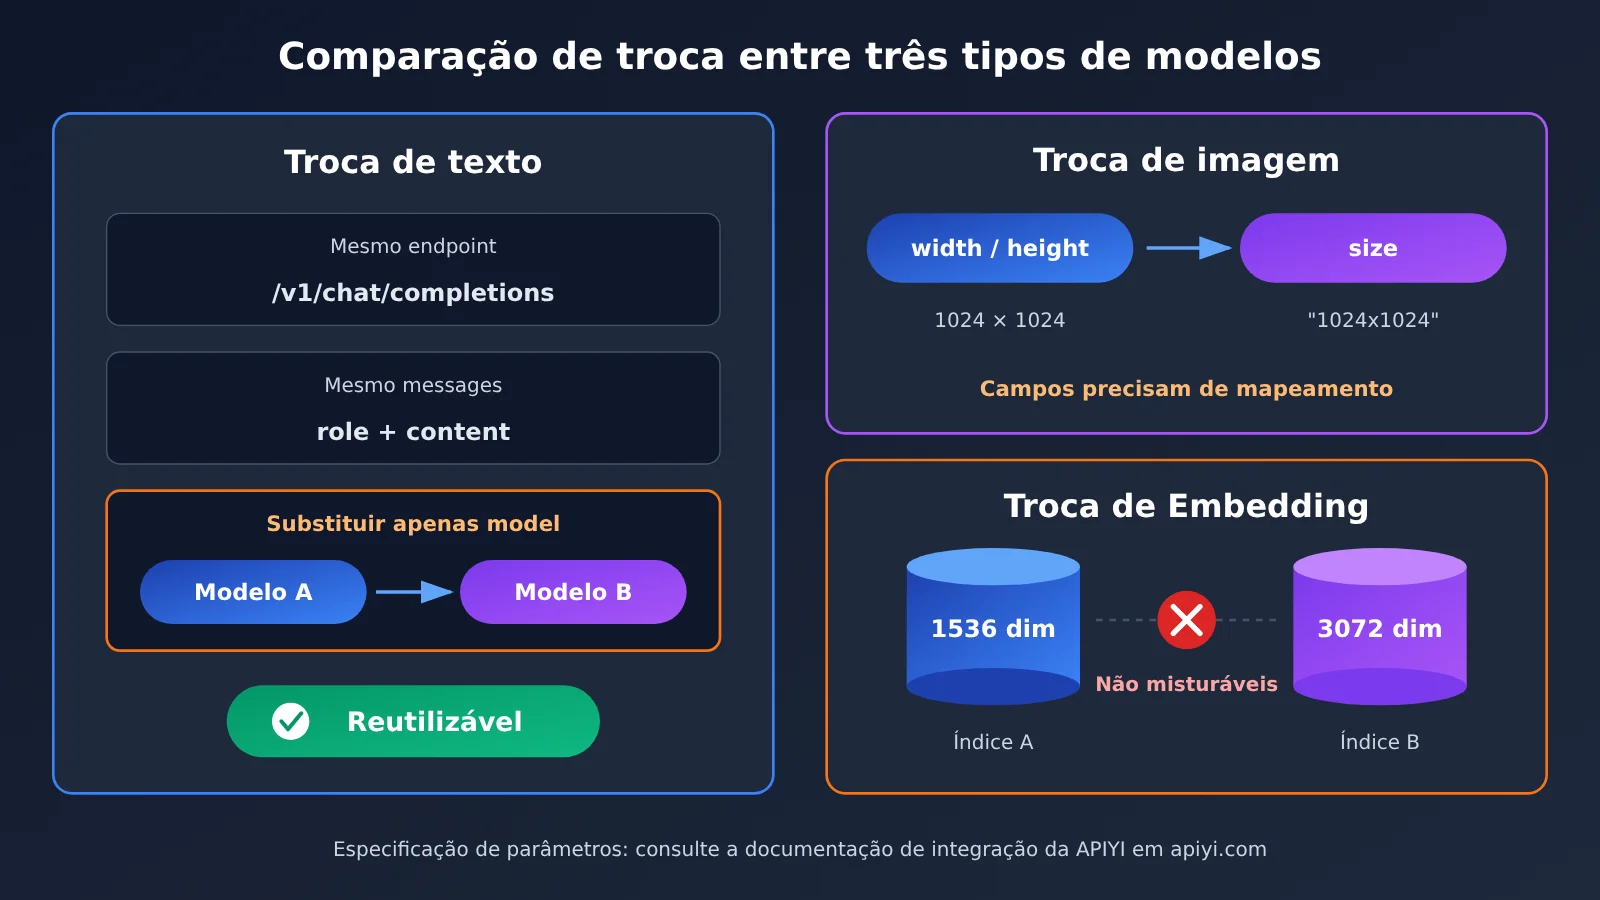
Além do diálogo em texto, imagens e vetores são os cenários entre modelos mais comuns — e também onde a ideia de “só trocar o model” mais facilmente falha. Os dois exemplos a seguir correspondem, cada um, a um tipo clássico de problema: “estrutura de parâmetros diferente” e “espaço de resultados diferente”.
Alternância entre modelos de imagem: MAI-Image-2.7 e Seedream 5.5
Os dois modelos podem ser chamados pela capacidade de Images com a mesma chave API, mas a forma de definir tamanho, imagem de referência e saída transparente é completamente diferente:
| Dimensão | MAI-Image-2.7 | Seedream 5.5 |
|---|---|---|
| Endpoint | A geração vai em generations, a edição em edits |
Texto puro e imagem de referência vão em generations |
| Parâmetro de tamanho | width e height controlam o total de pixels; limite anunciado de 4.194.304 pixels |
size escolhe a faixa de preço; se omitido, assume a faixa 2K |
| Imagem de referência | Até 5 imagens de referência na edição | A imagem de referência vai no campo image |
| Saída transparente | background: "transparent", retorna PNG com canal alfa |
É preciso especificar junto background: "transparent" e output_format: "png" |
| Preço | Cobrança independente | Cobrado de forma independente por faixa de size |
| Plataforma disponível | APIYI apiyi.com (conforme o registro e os grupos) | APIYI (conforme o registro e os grupos) |
Na hora de chamar, a recomendação é manter uma função de mapeamento de parâmetros para cada modelo, em vez de montar os campos direto na camada de negócio:
# Reutilize o client das seções anteriores; copie o ID do modelo a partir do registro do dia
def build_image_kwargs(model: str, prompt: str, transparent: bool = False) -> dict:
    if model.startswith("MAI-Image"):
        body = {"width": 1024, "height": 1024}
        if transparent:
            body["background"] = "transparent"
        return {"model": model, "prompt": prompt, "extra_body": body}
    # Seedream 5.5: o size define a faixa de preço; os valores válidos seguem a documentação de integração
    body = {"size": "2K"}
    if transparent:
        body.update({"background": "transparent", "output_format": "png"})
    return {"model": model, "prompt": prompt, "extra_body": body}

img = client.images.generate(**build_image_kwargs("MAI-Image-2.7", "扁平风格的钥匙图标", True))
As imagens transparentes, o efeito das imagens de referência, o formato de resposta e o custo precisam ser validados separadamente para cada modelo — o resultado de aceitação de um não substitui o do outro.
Troca de modelo de Embedding: small e large não podem ser misturados diretamente
A forma de invocação da vetorização realmente é unificada: tudo passa por POST /v1/embeddings, bastando enviar model e input.
for m in ["text-embedding-3-small", "text-embedding-3-large"]:
    e = client.embeddings.create(model=m, input=["统一接口切换模型"])
    print(m, "维度:", len(e.data[0].embedding))   # por padrão, 1536 e 3072, respectivamente
O problema está no resultado. O text-embedding-3-small gera 1536 dimensões por padrão, enquanto o text-embedding-3-large gera 3072 — e vetores com dimensões diferentes não podem ser colocados no mesmo índice. Mesmo usando o parâmetro dimensions para reduzir o large a 1536 dimensões, os espaços vetoriais dos dois modelos continuam incompatíveis, e a similaridade entre os vetores dos documentos antigos e os vetores das novas consultas simplesmente não faz sentido.
Por isso, a forma correta de trocar o modelo de embedding é: criar um novo índice vetorial, vetorizar novamente todos os documentos antigos, trocar o modelo também no lado das consultas e, por fim, recalibrar o limiar de similaridade com um lote de amostras rotuladas. Esse custo é muito maior do que alterar uma linha de model e já deveria ser levado em conta na fase de escolha da tecnologia.
Como validar a troca de modelos na interface unificada da APIYI
Antes de colocar a troca em produção, é preciso elevar o critério de “consegue chamar” para “pode ser validado”. A validação se divide em duas partes: investigação de códigos de erro e comparação de métricas.
Tabela de referência para investigação de códigos de erro
O pré-requisito da investigação é fixar primeiro uma requisição mínima, reproduzindo o problema de forma estável com a mesma chave, o mesmo nó, o mesmo endpoint e o mesmo ID de modelo:
| Sintoma | Causas comuns | Verificação e correção |
|---|---|---|
| 400 | Campos exclusivos do modelo antigo, parâmetros de ferramentas, saída estruturada ou formato de imagem incompatíveis | Remova os campos não essenciais e reinsira-os um a um para localizar a causa |
| 401/403 | Formato de token incorreto, o grupo não inclui o modelo ou o modelo está fora da lista de permissões | Confira a chave, o grupo do token e a lista de permissões de modelos |
| 404 | SDK concatenando /v1 em duplicidade, ou modelo que não pertence a esse tipo de interface |
O Base URL do SDK da OpenAI deve incluir /v1; o SDK do Google GenAI usa o endereço raiz sem /v1 e configura v1beta; copie o ID original do modelo |
| 429 | Limite de taxa de curto prazo, concorrência excedida ou cota insuficiente | Leia primeiro o corpo do erro; para limite de taxa de curto prazo, use um número limitado de tentativas com backoff exponencial e jitter; resolva a questão da cota antes de reenviar |
| 200 mas corpo vazio | Orçamento de saída esgotado pelo raciocínio (thinking), filtragem de segurança ou retorno apenas de chamadas de ferramenta | Verifique o motivo de conclusão e o tipo de retorno, aumente o orçamento de saída; use a requisição mais curta e sem ferramentas como contraprova |
Para fluxos de ferramentas em múltiplas rodadas do Gemini 4, verifique também se o thoughtSignature presente na resposta foi repassado de volta exatamente como recebido, e se as chamadas de ferramenta correspondem uma a uma aos resultados das ferramentas.
Registrar métricas e separar a diferença de modelo do overhead do canal
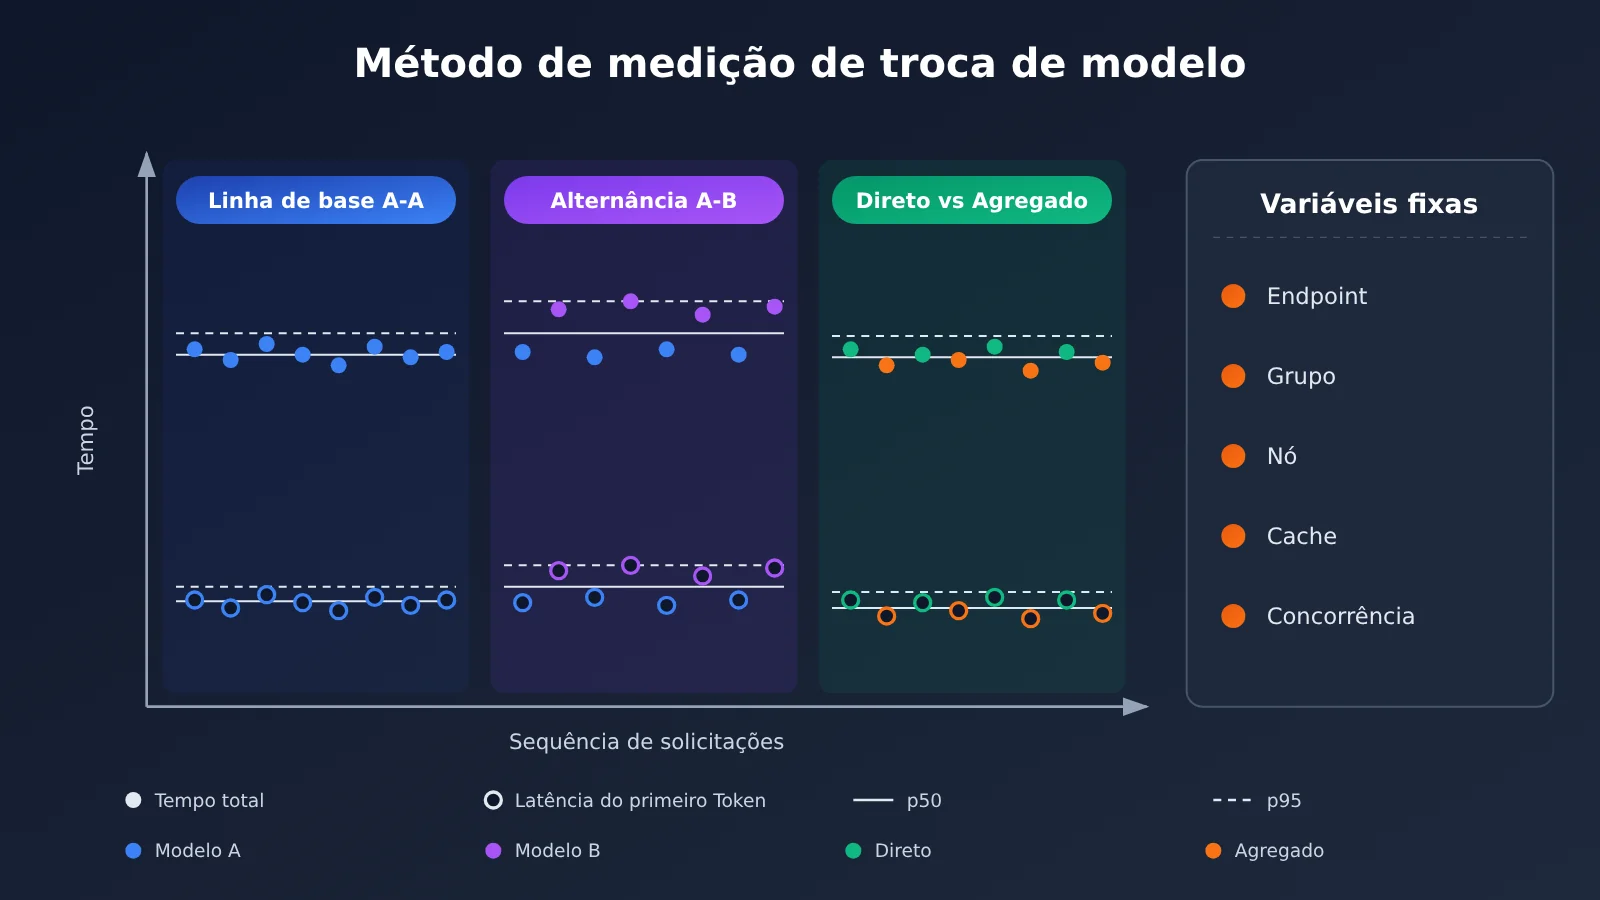
Até hoje, nos materiais públicos disponíveis, ainda não existe nenhum conjunto de dados emparelhados coletado sob a mesma chave API, o mesmo grupo, a mesma região e com entradas e carga idênticas, capaz de isolar individualmente a perda introduzida ao “trocar o modelo” ou pelo “encaminhamento pelo gateway”. Benchmarks de terceiros conseguem comparar modelos diferentes ou provedores diferentes, mas não permitem atribuir a diferença diretamente à troca de modelo feita na APIYI. Por isso, em vez de citar números dos outros, é melhor medir você mesmo seguindo o método abaixo:
| Métrica | Como registrar | Finalidade |
|---|---|---|
| Motivo de conclusão | Contabilizar a distribuição de finish_reason a cada requisição |
Detectar truncamento, filtragem e interrupções por ferramentas |
| Latência do primeiro token visível | Tempo até o primeiro trecho de conteúdo não vazio na resposta em streaming | Medir a experiência de espera do usuário |
| Tempo total p50/p95 | Percentis do tempo de cada requisição completa | Avaliar estabilidade e cauda longa |
| Taxa de falha | Contagem classificada por código de erro | Separar erros de configuração de falhas temporárias |
| Tokens reais e cobrança | Conferir item por item o campo usage com a fatura |
Calcular o custo real |
| Taxa de aprovação da validação de negócio | Avaliar amostras fixas com regras ou revisão manual | Verificar se a qualidade atinge o padrão esperado |
Quanto aos passos da medição, sugiro organizar assim: primeiro fixe o endpoint, o grupo, o nó e os parâmetros da requisição; depois use requisições repetidas A-A com o mesmo modelo para estabelecer a linha de base; em seguida, alterne entre A e B trocando apenas o modelo de cada vez; se precisar avaliar o overhead do canal, faça uma comparação à parte, com o mesmo modelo, entre conexão direta e canal agregado. Ao mesmo tempo, controle o estado do cache (frio ou quente), o limite de saída e o nível de concorrência; caso contrário, a velocidade do modelo, os cache miss e o overhead do canal vão se misturar e ficará impossível distinguir uns dos outros.
Riscos adicionais em fluxos de ferramentas com estado
Se você usa a API Responses para chamadas de ferramentas em várias rodadas, trocar de modelo no meio do processo também traz problemas de estado. A documentação de migração do GPT-6.2 da OpenAI explica que alternar para determinados modelos durante a sessão (incluindo downgrades) pode fazer com que os itens de raciocínio originais sejam removidos, e, ao restaurar o contexto, o modelo pode precisar raciocinar de novo. Na prática, isso significa que não dá para prometer “perda zero de estado” após a troca — e a variação de custo também não segue uma proporção fixa.
Na hora de validar esse tipo de fluxo, verifique se os itens do histórico e o contexto podem ser reutilizados corretamente pelo novo modelo, e trate “trocar de modelo no meio da mesma sessão” como um caso de teste à parte.
Perguntas Frequentes (FAQ)
Q1: O que é a interface unificada da APIYI?
É um ponto de entrada de API compatível com OpenAI: com uma única chave API e o mesmo Base URL, você pode invocar modelos de diferentes fornecedores como OpenAI, Claude e Gemini. Você não precisa registrar contas e manter chaves separadas para cada fornecedor — ao trocar de modelo, basta modificar o campo `model` na requisição e conferir os parâmetros proprietários de acordo com cada modelo.
Q2: Qual é a diferença entre trocar modelos pela interface unificada e integrar-se separadamente aos SDKs oficiais de cada fornecedor?
Os SDKs oficiais oferecem a cobertura mais completa das capacidades proprietárias, mas usar vários ao mesmo tempo exige manter múltiplos conjuntos de autenticação, SDKs e contas de cobrança. A interface unificada consolida autenticação, ponto de entrada e faturamento em um único conjunto, e em cenários com parâmetros comuns o custo de troca é muito baixo. A contrapartida é que os parâmetros proprietários precisam ter a compatibilidade confirmada um a um; por exemplo, o mapeamento do campo nativo de raciocínio do Gemini na interface compatível exige uma validação separada.
Q3: Quando os modelos mencionados no artigo ficarão disponíveis na APIYI?
Conforme o registro dinâmico em tempo real da APIYI: GPT-6.2 Astra e Sol foram lançados em 2026-11-18 e liberados em três grupos; Gemini 4 Neon foi anunciado pela Google em 18 de novembro, e a APIYI o integrou em 20 de novembro nos grupos `default`/`svip`; Seedream 5.5 foi lançado em 13 de novembro. Como a lista de modelos muda rapidamente, consulte o registro do dia.
Q4: Quais cenários são mais adequados para trocar modelos pela interface unificada?
– **Comparação A/B entre múltiplos modelos**: avaliar desempenho e custo do mesmo comando em diferentes modelos.
– **Fallback em falhas**: trocar para um modelo alternativo quando um modelo ou rota estiver com recursos sobrecarregados.
– **Distribuição por tarefa**: usar modelos econômicos para perguntas e respostas simples e modelos de ponta para raciocínio complexo.
– **Geração de imagens em múltiplos estilos**: escolher entre vários modelos de imagem conforme a necessidade, atentando ao mapeamento de parâmetros.
Q5: Como começar o mais rápido possível a invocar múltiplos modelos pela interface unificada?
1. Acesse a APIYI em apiyi.com e registre uma conta — novos usuários recebem créditos gratuitos para teste.
2. Crie uma chave API e confirme se o grupo do seu token inclui o modelo desejado.
3. Execute o exemplo minimalista deste artigo, substituindo o campo `model` conforme o registro para validar.
O modelo de cobrança por uso facilita comparar vários modelos com pouco tráfego antes de decidir qual será sua solução principal.
Q6: Qual é o preço e a janela de contexto do gemini-4-neon?
De acordo com o registro de modelos gerado pela APIYI em 2026-11-20, o `gemini-4-neon` custa $3 por milhão de tokens de entrada, $15 de saída e $0.15 de leitura de cache; o boletim da APIYI indica preço igual ao oficial, e a cobrança efetiva prevalece conforme a fatura da conta. Tanto a Artificial Analysis quanto o anúncio da Google marcam 1M de janela de contexto, compartilhada entre entrada, raciocínio e saída; a documentação de lançamento da APIYI lista um limite de geração síncrona de aproximadamente 64K.
Q7: Quais são as limitações conhecidas da troca pela interface unificada?
– **Parâmetros proprietários não são universais**: níveis de raciocínio, invocação de ferramentas e saída estruturada precisam ser verificados modelo por modelo.
– **Vetores não podem ser misturados**: trocar o modelo de Embedding exige re-vetorizar os dados e reconstruir o índice.
– **Fluxos com estado sofrem perdas**: trocar de modelo no meio de uma sessão do Responses pode fazer você perder itens de raciocínio.
– **Escopo de visibilidade restrito**: a lista de modelos é limitada pelo grupo de tokens, pela autorização e pelo endpoint; em caso de problemas, consulte a documentação de códigos de erro da APIYI em apiyi.com.
APIYI: principais conclusões sobre trocar Modelo de Linguagem Grande pela interface unificada
- Trocar só o model tem precondições: só funciona no mesmo endpoint e usando apenas parâmetros comuns suportados por ambos os modelos.
- Duas formas de contagem: 200+ refere-se ao total de modelos selecionados; o registro com 289 entradas inclui variantes de versão e de rota.
- A verificação tem uma ordem: ID do modelo → grupo de tokens → endpoint → parâmetros, eliminando item por item.
- Parâmetros de imagem exigem mapeamento: MAI usa
width/height, Seedream usasize, e a forma de definir transparência é diferente entre eles. - Trocar o modelo de vetores exige reconstrução: small e large têm dimensões padrão diferentes, e mesmo com a mesma dimensão os vetores não são interoperáveis.
- HTTP 200 não significa sucesso: verifique o motivo da conclusão, corpos vazios e retornos que contêm apenas chamadas de ferramenta.
- Desempenho precisa ser medido por você: use uma linha de base A-A com medições alternadas A-B; na APIYI (apiyi.com) dá para fazer essa comparação usando a mesma chave API.
Resumo
Pontos essenciais para alternar entre Modelos de Linguagem Grandes com a interface unificada do APIYI:
- Reutilize a autenticação e o ponto de entrada: uma chave API e um Base URL cobrem várias categorias de capacidades, como texto, imagem e vetores.
- Diferencie parâmetros comuns de parâmetros proprietários: os parâmetros comuns podem ser trocados diretamente; os proprietários devem ser verificados item a item antes de serem adicionados.
- Transforme a troca em uma operação verificável: use a tabela de correspondência de códigos de erro para diagnóstico e registre latência, taxa de falhas e cobranças com um método fixo.
A sugestão é começar rodando os dois modelos com a requisição de texto puro mais curta possível e, em seguida, expandir gradualmente para os cenários de negócio seguindo esta ordem: “mapeamento de parâmetros de imagem”, “reconstrução do índice vetorial” e “fluxo de ferramentas com estado”. Recomendamos usar a cota gratuita de testes do APIYI em apiyi.com para concluir essas verificações antes de decidir o modelo principal e a solução de fallback.
📚 Referências
-
Central de Documentação do APIYI: introdução básica, início rápido, registro de modelos, vetorização de texto e notas sobre versões de modelos
- Link:
docs.apiyi.com - Descrição: fonte primária sobre IDs de modelos, grupos, endpoints e preços; para o registro de modelos, considere sempre a versão gerada no dia
- Link:
-
OpenAI Using GPT-6.2: migração para o GPT-6.2 e explicação dos parâmetros
- Link:
developers.openai.com/api/docs/guides/latest-model - Descrição: invocação de ferramentas no Responses, campos de níveis de raciocínio e ciclo de vida dos itens de inferência
- Link:
-
Documentação de solução de problemas e assinaturas de raciocínio da API Google Gemini: solução de problemas de invocação do Gemini 4
- Link:
aistudio.google.com/docs/troubleshooting - Descrição: níveis de raciocínio, retorno do
thoughtSignaturee erros comuns
- Link:
-
Introdução ao Gemini 4 no Google Cloud: notas sobre decodificação longa do Gemini 4 e versões da API
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/start/get-started-with-gemini-4 - Descrição: entenda as versões da API para decodificação longa e as condições de retomada
- Link:
-
Página de comparação de modelos da Artificial Analysis: benchmarks de modelos de terceiros e métodos de medição de latência
- Link:
artificialanalysis.ai/models/comparisons/gemini-4-neon-vs-gpt-6-2-sol - Descrição: serve como referência comparativa entre modelos, mas não deve ser usada para atribuir custos de canal
- Link:
Autor: Equipe Técnica do APIYI
Interação técnica: entre em contato conosco pela página inicial do site do APIYI; mais materiais de integração estão disponíveis na central de documentação docs.apiyi.com