Note de l’auteur : cet article montre comment changer de grand modèle de langage avec une seule clé API et un point d’entrée compatible OpenAI, et explique clairement quels champs, états et critères d’acceptation exigent une adaptation spécifique lors de l’intégration multi-modèles pour les images et les Embeddings.
Ici, on fait d’abord fonctionner le changement de modèles purement textuels avec une seule clé API et un point d’entrée compatible OpenAI, puis, à travers deux exemples — image et vecteurs —, on identifie les champs, états et critères d’acceptation qui nécessitent une adaptation dédiée dans une intégration multi-modèles. Cette conclusion a toutefois un prérequis : tant que vous restez sur un même endpoint en n’utilisant que les paramètres communs supportés par les deux modèles, changer de modèle revient généralement à modifier le champ model. Dès que des paramètres de raisonnement propriétaires, des appels d’outils, la taille des images ou la dimension des vecteurs entrent en jeu, la vérification doit se faire modèle par modèle.
Ce n’est pas un article promotionnel du genre « une ligne de code et tout est réglé ». Nous allons clairement distinguer ce que l’interface unifiée d’APIYI permet de réutiliser de ce qui doit être revalidé, et nous passerons également en revue les scénarios d’échec.
Ce que vous y gagnez : à la fin de votre lecture, vous saurez basculer entre modèles de texte avec la même authentification et le même code, vous connaîtrez les paramètres à ajuster pour changer de modèle côté image et Embeddings, et vous disposerez d’une méthode d’acceptation du changement de modèle concrète et directement applicable.
9 termes à connaître avant de changer de grand modèle de langage via l’interface unifiée d’APIYI
La plupart des problèmes rencontrés lors d’un changement de modèle viennent d’une compréhension incohérente de la terminologie. Par exemple, saisir une Base URL contenant deux fois /v1, ou croire que des vecteurs de même dimension sont interchangeables. Commençons par harmoniser ces quelques concepts : toutes les étapes qui suivent s’appuient sur ces définitions.
| Terme | Signification concrète | Point d’attention lors du changement |
|---|---|---|
| Base URL | L’adresse racine utilisée par le SDK pour construire les chemins d’API | Avec le SDK OpenAI, renseignez l’URL jusqu’à /v1 inclus, pour éviter une concaténation en double |
| API Key | Les identifiants d’authentification des requêtes API | À stocker uniquement dans la configuration côté serveur ou dans les variables d’environnement |
| ID de modèle | Le modèle indiqué dans la requête, pouvant contenir des informations de version ou de canal | Copiez l’ID original depuis le registre des modèles, ne le tapez jamais à la main |
| Groupe de jetons | Détermine les modèles, canaux et conditions de facturation accessibles avec la clé actuelle | Un modèle hors du groupe renvoie une erreur 401/403 ou 404 |
| Chat Completions | Le protocole d’API pour les dialogues textuels basés sur un tableau de messages | Le point d’entrée principal pour les changements en texte pur |
| Responses | Le protocole d’API prenant en charge plusieurs types de sorties et les appels d’outils | Les appels d’outils de GPT-6.2 doivent passer par là |
| Embedding | Encoder du contenu sous forme de vecteurs à dimension fixe, pour la recherche et les correspondances de similarité | Changer de modèle équivaut à changer d’espace vectoriel |
| Index vectoriel | Une structure qui retrouve les éléments similaires selon une dimension et un espace vectoriel donnés | À reconstruire dès que la dimension ou le modèle change |
| Latence du premier token visible | Le temps d’attente entre l’envoi de la requête et l’affichage par l’utilisateur du premier contenu généré exploitable | Le temps de réflexion des modèles de raisonnement allonge cette métrique |
Parmi ces termes, le « groupe de jetons » est celui qu’on oublie le plus souvent. Sous un même compte, les clés de différents groupes ne voient pas forcément la même liste de modèles. Donc, quand vous dépannez une erreur « modèle introuvable », vérifiez d’abord le groupe auquel appartient votre clé, au lieu de suspecter tout de suite votre code.
Changer de grand modèle de langage via l’interface unifiée d’APIYI : l’essentiel à retenir
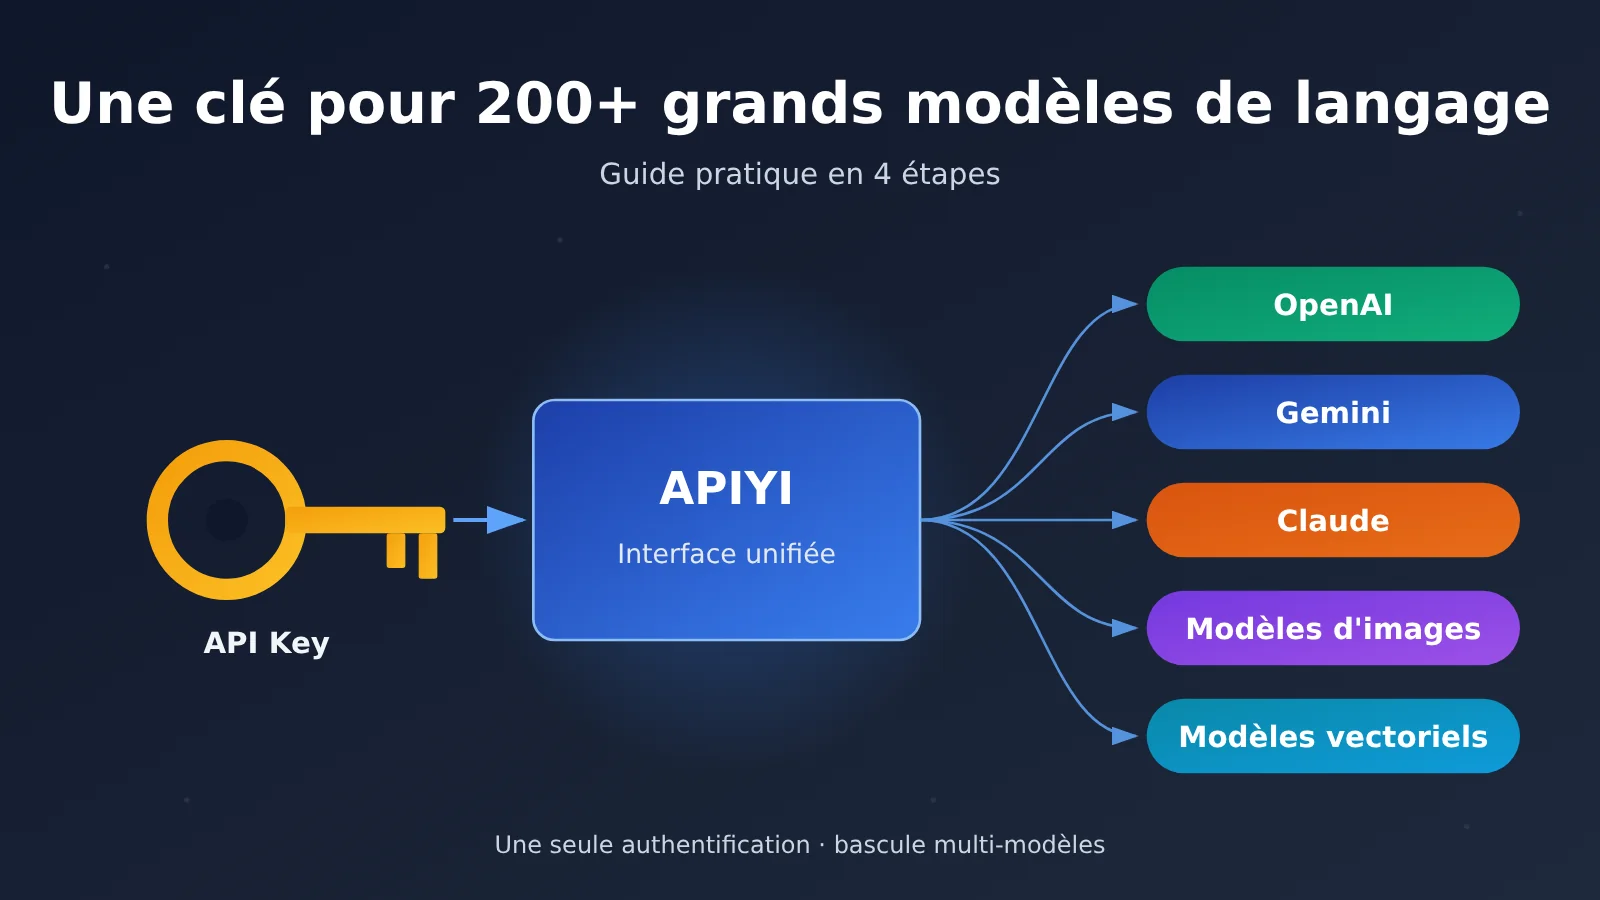
Ce que l’accès unifié permet vraiment d’économiser, c’est le « travail répétitif » : plus besoin de créer un compte chez chaque fournisseur, de gérer plusieurs jeux de clés ni d’adapter plusieurs SDK. D’après la présentation générale et la documentation de démarrage rapide d’APIYI (apiyi.com), une seule configuration d’authentification et un point d’entrée compatible OpenAI suffisent pour accéder aux modèles disponibles chez les différents fournisseurs.
| Aspect | Réutilisable tel quel | À vérifier pour chaque modèle |
|---|---|---|
| Authentification | La même clé API, les mêmes en-têtes de requête | Le groupe de jetons de la clé inclut-il le modèle cible |
| Point d’entrée | La même URL de base (Base URL) | Les endpoints pris en charge par le modèle cible (conversation / Responses / images / vecteurs) |
| Corps de la requête | model, messages de base, input et autres champs communs |
Niveaux de raisonnement, outils, sorties structurées, dimensions d’image, dimension des vecteurs |
| Traitement des réponses | La logique d’analyse de choices, finish_reason, usage |
Retours particuliers : corps vide, appel d’outils uniquement, filtrage de sécurité, etc. |
| Facturation | Le même solde de compte et les mêmes factures | Prix unitaire, paliers tarifaires et mode de facturation du cache propres à chaque modèle |
200+ et 289 : les deux comptages du nombre de modèles d’APIYI
Dans sa présentation publique, APIYI annonce plus de 200 modèles sélectionnés. Pourtant, dans le registre public des modèles généré le 2026-11-20, le champ model_count affiche 289. Rien de contradictoire entre les deux chiffres : le registre compte également les différentes versions d’un même modèle ainsi que les variantes de routage, d’où un nombre d’entrées supérieur à celui des « modèles sélectionnés ».
À garder en tête : la liste réellement appelable depuis un jeton donné dépend d’une triple contrainte — le groupe, l’autorisation par modèle et l’endpoint. Le fait qu’un ID figure dans le registre ne garantit pas que votre clé pourra l’appeler.
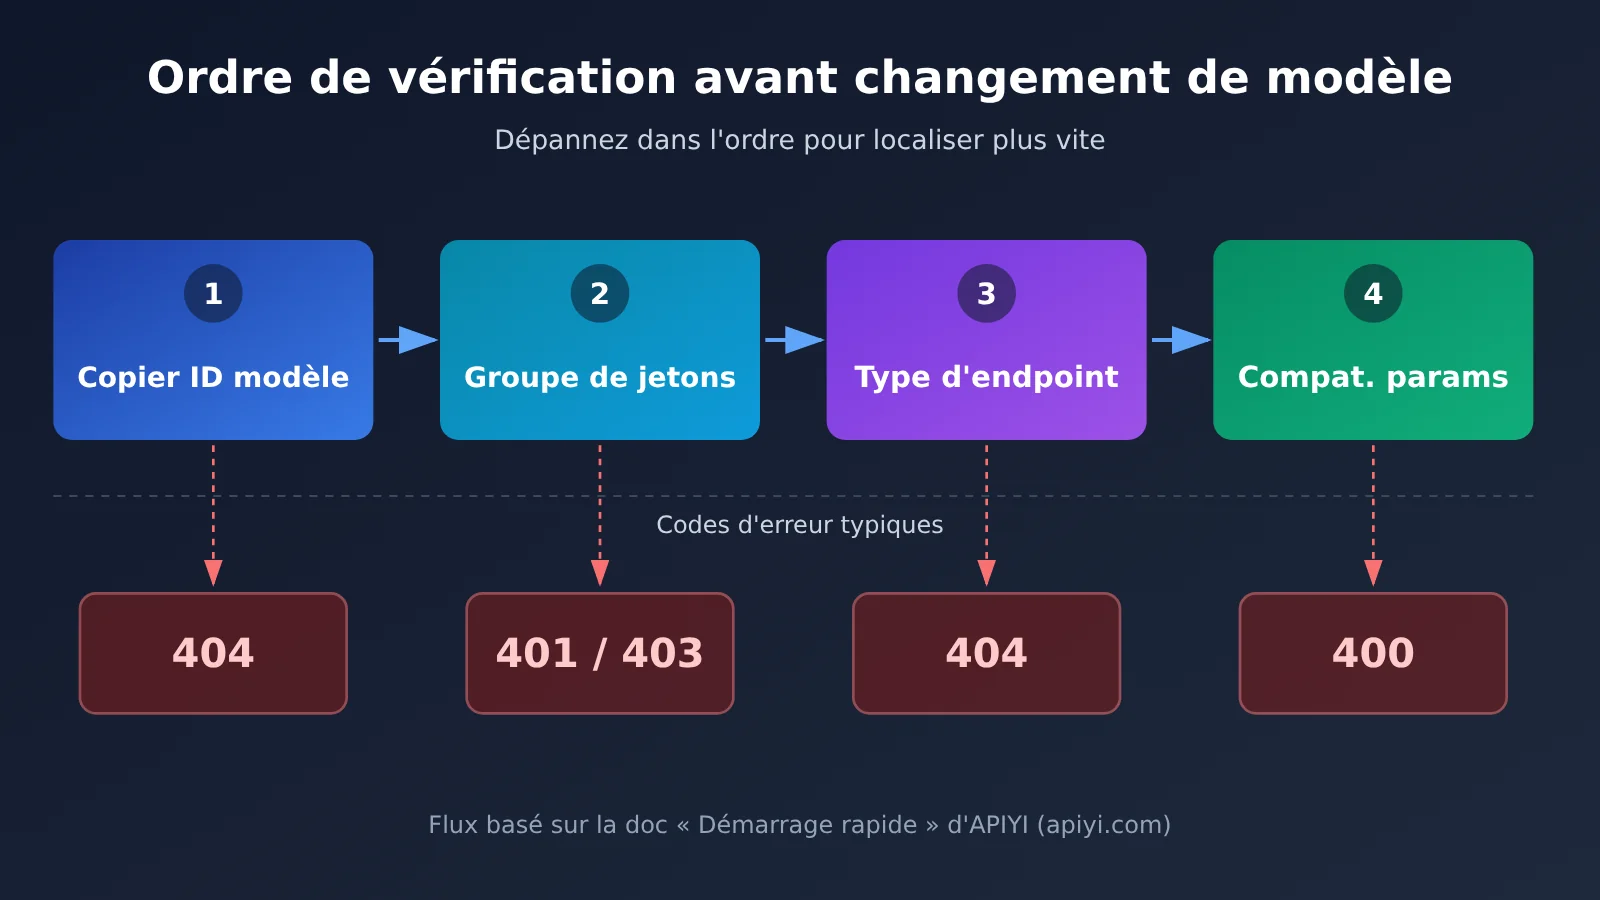
L’ordre des vérifications avant de basculer
Il est conseillé de procéder aux vérifications toujours dans le même ordre à chaque intégration d’un nouveau modèle, afin d’éviter de devoir chercher dans toutes les directions en cas d’erreur :
- Vérifier l’ID du modèle : copiez l’ID exact depuis le registre du jour et assurez-vous que majuscules et tirets correspondent parfaitement.
- Vérifier le groupe du jeton : confirmez que le groupe auquel appartient votre clé actuelle autorise ce modèle — certains modèles ne sont disponibles que dans des groupes spécifiques.
- Vérifier l’endpoint : assurez-vous que le modèle prend en charge le type d’API que vous souhaitez appeler ; les endpoints pour le texte, les images et les vecteurs diffèrent.
- Vérifier les paramètres : ne conservez que les paramètres communs aux deux modèles, puis réajoutez un par un les paramètres spécifiques pour les valider.
Comment basculer rapidement entre grands modèles de langage avec l’interface unifiée d’APIYI
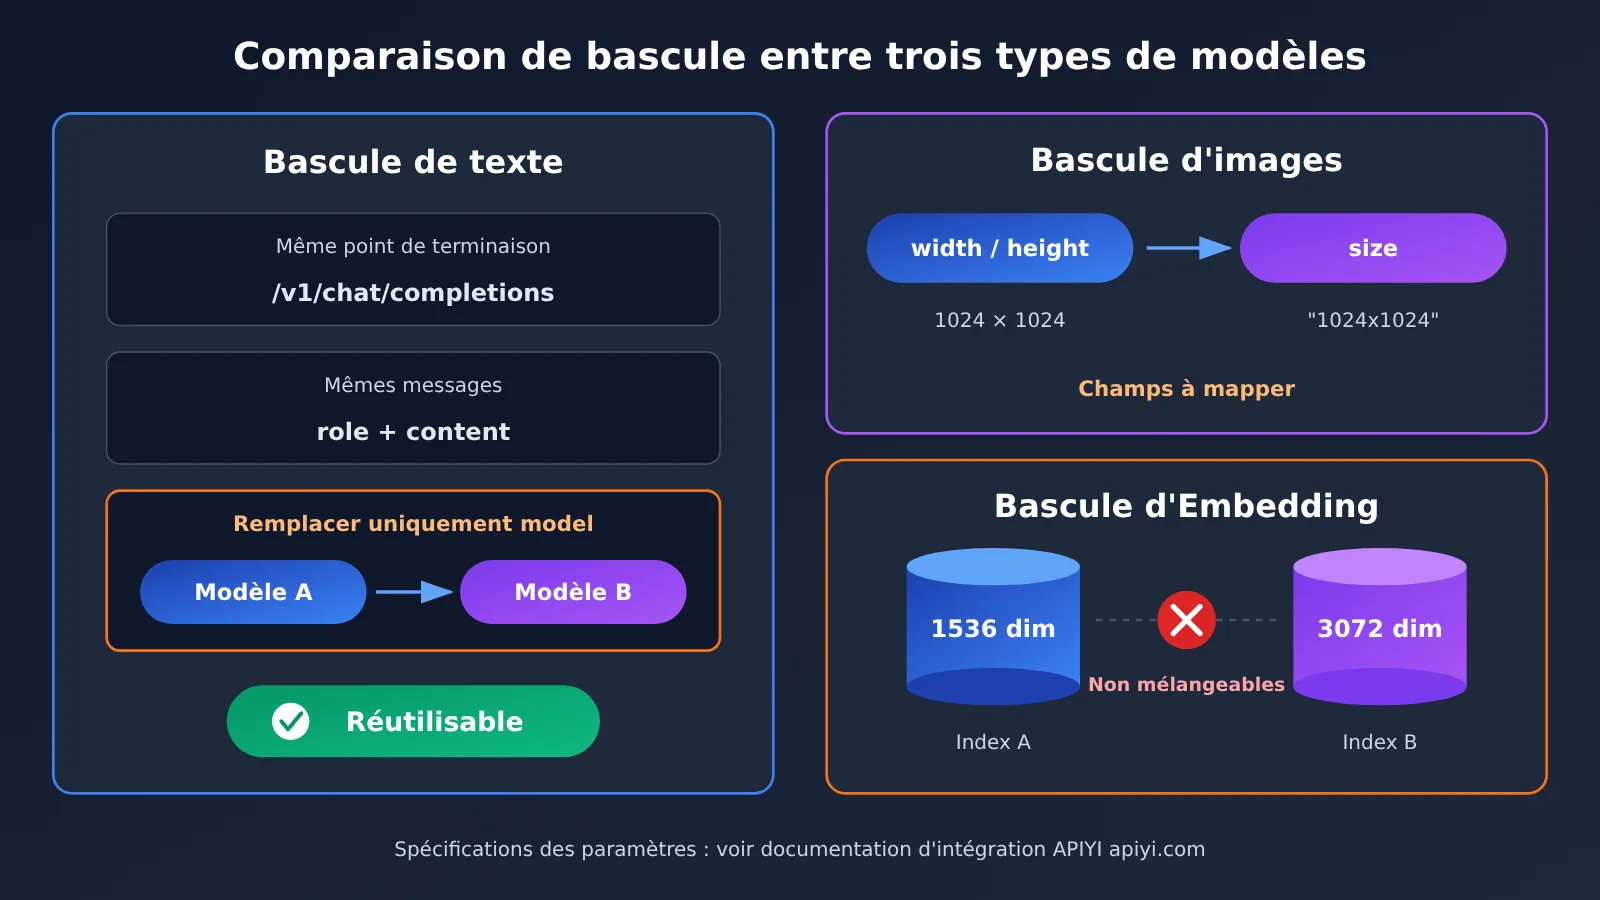
Prenons comme exemple deux modèles de texte accessibles via Chat Completions : gemini-4-neon et gpt-6.2-sol. Tous deux utilisent POST /v1/chat/completions ; tant que vous vous en tenez au simple champ messages, changer de modèle revient à remplacer le champ model. Seule condition : votre groupe de clés doit donner accès à ces deux modèles — pensez à le vérifier dans le registre avant tout appel.
Exemple minimal : le même code pour passer d’un modèle à l’autre
Définissez l’URL de base sur https://api.apiyi.com/v1 et lisez la clé API depuis les variables d’environnement :
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],     # à stocker uniquement dans les variables d'environnement côté serveur
    base_url="https://api.apiyi.com/v1",     # point d'entrée compatible OpenAI d'APIYI
)

for model in ["gemini-4-neon", "gpt-6.2-sol"]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是向量索引"}],
    )
    choice = resp.choices[0]
    print(model, "| finish_reason:", choice.finish_reason, "| usage:", resp.usage)
    print(choice.message.content or "<空正文>")
Vérifiez les champs de la réponse, ne vous contentez pas du HTTP 200
Une fois la réponse reçue, vérifiez au minimum trois points : est-ce que choices[0].message.content est vide ; est-ce que finish_reason vaut stop ou si la génération s’est arrêtée pour une autre raison (troncature due à la limite de longueur, etc.) ; est-ce que la consommation de tokens indiquée dans usage est plausible. Les modèles de raisonnement, par exemple, consument également du budget de sortie pendant leur phase de réflexion : si ce budget est trop faible, il arrive qu’on obtienne un « HTTP 200 avec un corps de réponse vide ».
Par ailleurs, le nom que le modèle se donne dans le corps de sa réponse ne peut pas servir de preuve pour déterminer le modèle backend réellement utilisé. Quand vous devez confirmer quel modèle a été invoqué, fiez-vous plutôt à l’ID de requête, aux métadonnées de la réponse et aux journaux de facturation.
Voir le code d’implémentation complet : latence du premier token en streaming, réessais avec backoff et enregistrement des métriques
import os
import time
import random
from openai import OpenAI, RateLimitError, APIStatusError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",   # Interface unifiée APIYI
)

def call_once(model: str, prompt: str, max_retries: int = 3) -> dict:
    """Un appel en streaming : enregistre la latence du premier token visible, la durée totale et la raison de fin"""
    for attempt in range(max_retries + 1):
        start = time.perf_counter()
        first_token_at = None
        parts, finish_reason, usage = [], None, None
        try:
            stream = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
                stream=True,
                stream_options={"include_usage": True},
            )
            for chunk in stream:
                if chunk.usage:
                    usage = chunk.usage
                if not chunk.choices:
                    continue
                delta = chunk.choices[0].delta
                if delta and delta.content:
                    if first_token_at is None:
                        first_token_at = time.perf_counter()
                    parts.append(delta.content)
                if chunk.choices[0].finish_reason:
                    finish_reason = chunk.choices[0].finish_reason
            end = time.perf_counter()
            return {
                "model": model,
                "ok": bool(parts),
                "ttft_s": round(first_token_at - start, 3) if first_token_at else None,
                "total_s": round(end - start, 3),
                "finish_reason": finish_reason,
                "usage": usage,
                "text": "".join(parts),
            }
        except RateLimitError:
            # Backoff exponentiel avec jitter et nombre de tentatives limité, uniquement pour les limites de débit temporaires
            if attempt == max_retries:
                raise
            time.sleep((2 ** attempt) + random.uniform(0, 0.5))
        except APIStatusError as e:
            # 400/401/403/404 correspondent à des problèmes de configuration ou de paramètres : inutile de réessayer
            return {"model": model, "ok": False, "status": e.status_code,
                    "error": str(e)[:300]}

if __name__ == "__main__":
    prompt = "用三句话说明向量索引为什么要和 Embedding 模型绑定"
    for m in ["gemini-4-neon", "gpt-6.2-sol"]:
        r = call_once(m, prompt)
        print({k: v for k, v in r.items() if k != "text"})
🚀 Démarrage rapide : commencez par exécuter l’exemple minimal ci-dessus sur APIYI apiyi.com avec les crédits de test gratuits offerts aux nouveaux utilisateurs ; vérifiez que les deux ID de modèles renvoient bien un contenu sous votre groupe de tokens, puis intégrez le code à votre logique métier.
Paramètres propriétaires : une vérification séparée s’impose
L’exemple ci-dessus n’utilise volontairement que des champs communs. Dès que vous ajoutez l’un des paramètres suivants, impossible de continuer à supposer que « changer le model suffit » :
- Série GPT-6.2 : dans l’API OpenAI,
gpt-6.2-astracommegpt-6.2-solprennent en charge à la fois Chat Completions et Responses. Dans Chat Completions, le champ du niveau de raisonnement s’appellereasoning_effort, tandis que dans Responses il s’agit dereasoning.effort; les deux modèles rejettent la valeurnone. Dès que vous avez besoin d’appels d’outils, passez par Responses. - Série Gemini 4 :
gemini-4-neonest disponible via la solution Gemini native d’APIYI et via l’interface de dialogue compatible OpenAI. Le REST natif s’appuie sur/v1beta/models/{id}:generateContent, et le niveau de raisonnement se règle dansgenerationConfig.thinkingConfig.thinkingLevel, aveclow,medium,highouxhighcomme options,highétant la valeur par défaut. L’ancien paramètrethinkingBudgetet la valeurminimalne s’appliquent pas à Gemini 4 ; la documentation de Google signale d’ailleurs que Gemini 4 ignoretemperatureettopP. - Sorties structurées et outils : les contraintes JSON Schema et le format de définition des outils ne sont pas forcément identiques des deux côtés ; vérifiez chaque élément dans la documentation du modèle cible.
À noter : les notes de mise en ligne de Neon chez APIYI précisent que seul l’endpoint de tarification a été vérifié au moment du lancement, sans appel réel avant la mise en production. Les doubles endpoints et les appels d’outils décrits ci-dessus relèvent donc d’un comportement documenté — avant toute utilisation en production, faites vos propres vérifications avec des requêtes minimales.
APIYI : changer de capacité via une interface unifiée — comparaison entre images et Embedding
Au-delà du dialogue textuel, les images et les vecteurs constituent les scénarios inter-modèles les plus courants — et aussi ceux où la simple modification du model échoue le plus souvent. Les deux exemples ci-dessous illustrent respectivement deux catégories de problèmes : « structures de paramètres différentes » et « espaces de résultats différents ».
Bascule entre modèles d’images : MAI-Image-2.7 et Seedream 5.5
Les deux modèles sont appelables via la capacité Images de la même clé, mais l’écriture diffère complètement pour la taille, l’image de référence et la sortie transparente :
| Dimension | MAI-Image-2.7 | Seedream 5.5 |
|---|---|---|
| Point de terminaison | la génération passe par generations, l’édition par edits |
texte seul comme images de référence passent par generations |
| Paramètre de taille | width et height contrôlent le nombre total de pixels, plafond annoncé à 4 194 304 pixels |
size sélectionne le palier tarifaire ; en cas d’omission, le palier 2K s’applique |
| Image de référence | l’édition accepte jusqu’à 5 images de référence | l’image de référence se place dans le champ image |
| Sortie transparente | background: "transparent", renvoie un PNG avec canal alpha |
il faut spécifier à la fois background: "transparent" et output_format: "png" |
| Tarification | tarification indépendante | tarification indépendante selon le palier de size |
| Plateforme disponible | APIYI apiyi.com (selon le registre et les groupes en vigueur) | APIYI (selon le registre et les groupes en vigueur) |
Lors de l’appel, il est recommandé de maintenir une fonction de mappage de paramètres pour chaque modèle, plutôt que d’assembler les champs directement dans la couche métier :
# Réutilise le client défini plus haut ; copiez l'ID du modèle depuis le registre du jour
def build_image_kwargs(model: str, prompt: str, transparent: bool = False) -> dict:
    if model.startswith("MAI-Image"):
        body = {"width": 1024, "height": 1024}
        if transparent:
            body["background"] = "transparent"
        return {"model": model, "prompt": prompt, "extra_body": body}
    # Seedream 5.5 : size détermine le palier tarifaire, les valeurs admises dépendent de la documentation d'intégration
    body = {"size": "2K"}
    if transparent:
        body.update({"background": "transparent", "output_format": "png"})
    return {"model": model, "prompt": prompt, "extra_body": body}

img = client.images.generate(**build_image_kwargs("MAI-Image-2.7", "扁平风格的钥匙图标", True))
Les images transparentes, le rendu des images de référence, le format de réponse et les coûts doivent être validés séparément pour chaque modèle : les résultats d’acceptation de l’un ne peuvent pas se substituer à ceux de l’autre.
Changer de modèle d’Embedding : small et large ne sont pas directement interchangeables
Côté appel, la vectorisation est effectivement unifiée : tout passe par POST /v1/embeddings, il suffit de transmettre model et input.
for m in ["text-embedding-3-small", "text-embedding-3-large"]:
    e = client.embeddings.create(model=m, input=["统一接口切换模型"])
    print(m, "维度:", len(e.data[0].embedding))   # par défaut respectivement 1536 et 3072
Le problème se situe au niveau du résultat. text-embedding-3-small produit par défaut des vecteurs à 1536 dimensions, text-embedding-3-large à 3072 dimensions, et des vecteurs de dimensions différentes ne peuvent pas cohabiter dans un même index. Même en utilisant le paramètre dimensions pour ramener large à 1536 dimensions, les espaces vectoriels des deux modèles ne communiquent pas : la similarité entre les vecteurs des anciens documents et ceux des nouvelles requêtes n’a plus aucun sens.
La bonne méthode pour changer de modèle d’Embedding consiste donc à : créer un nouvel index vectoriel, re-vectoriser l’intégralité des anciens documents, basculer le modèle côté requêtes en même temps, puis recalibrer le seuil de similarité à l’aide d’un lot d’échantillons annotés. Ce coût dépasse largement la modification d’une simple ligne model, et doit être pris en compte dès la phase de sélection.
Comment valider la bascule de modèles via l’interface unifiée APIYI
Avant la mise en production d’une bascule, il faut passer du stade « la requête passe » à celui de « le résultat est validé ». La validation se décompose en deux volets : le diagnostic des codes d’erreur et la comparaison des métriques.
Tableau de référence pour le diagnostic des codes d’erreur
Le préalable à tout diagnostic est de figer une requête minimale, afin de reproduire le problème de manière stable avec la même clé API, le même nœud, le même point de terminaison et le même ID de modèle :
| Symptôme | Cause fréquente | Vérification et correction |
|---|---|---|
| 400 | Champs propres à l’ancien modèle, paramètres d’outils, sortie structurée ou format d’image incompatibles | Retirez les champs non essentiels, puis rajoutez-les un par un pour isoler le coupable |
| 401 / 403 | Format de jeton invalide, groupe n’incluant pas ce modèle, ou modèle absent de la liste blanche | Vérifiez la clé API, le groupe du jeton et la liste blanche des modèles |
| 404 | Le SDK concatène deux fois /v1, ou le modèle n’appartient pas à ce type d’interface |
Avec le SDK OpenAI, la Base URL doit inclure /v1 ; avec le SDK Google GenAI, utilisez l’URL racine sans /v1 et configurez v1beta ; copiez l’ID de modèle exact |
| 429 | Limitation de débit à court terme, dépassement de la concurrence ou quota insuffisant | Lisez d’abord le corps de l’erreur ; en cas de rate limiting temporaire, utilisez un backoff exponentiel avec jitter sur un nombre de tentatives limité ; corrigez le problème de quota avant de renvoyer la requête |
| 200 mais corps vide | Budget de sortie entièrement consommé par la réflexion, filtrage de sécurité, ou réponse limitée aux appels d’outils | Vérifiez le motif d’achèvement et le type de retour, augmentez le budget de sortie ; faites un test témoin avec la requête minimale sans outil |
Pour les flux d’outils multi-tours de Gemini 4, vérifiez également que le thoughtSignature présent dans la réponse est bien renvoyé tel quel, et que chaque appel d’outil correspond exactement à un résultat d’outil.
Enregistrer les métriques pour distinguer les écarts de modèle de l’overhead du canal
À ce jour, aucune ressource publique ne propose de données groupées permettant d’isoler séparément les pertes induites par un « changement de modèle » ou par « le transfert via une passerelle » — sur une même clé, dans le même groupe, la même région, avec des entrées et une charge identiques. Les benchmarks tiers permettent certes de comparer différents modèles ou différents fournisseurs, mais impossible d’attribuer directement un écart au simple fait d’avoir changé de modèle sur APIYI. Alors, plutôt que de citer les chiffres des autres, autant mesurer vous-même avec la méthode ci-dessous :
| Métrique | Mode de relevé | Objectif |
|---|---|---|
| Raison d’achèvement | Comptabiliser la distribution des finish_reason à chaque requête |
Détecter les troncatures, les filtrages et les interruptions d’outils |
| Latence du premier token visible | Le moment où arrive le premier segment de contenu non vide dans une requête en streaming | Mesurer l’expérience d’attente de l’utilisateur |
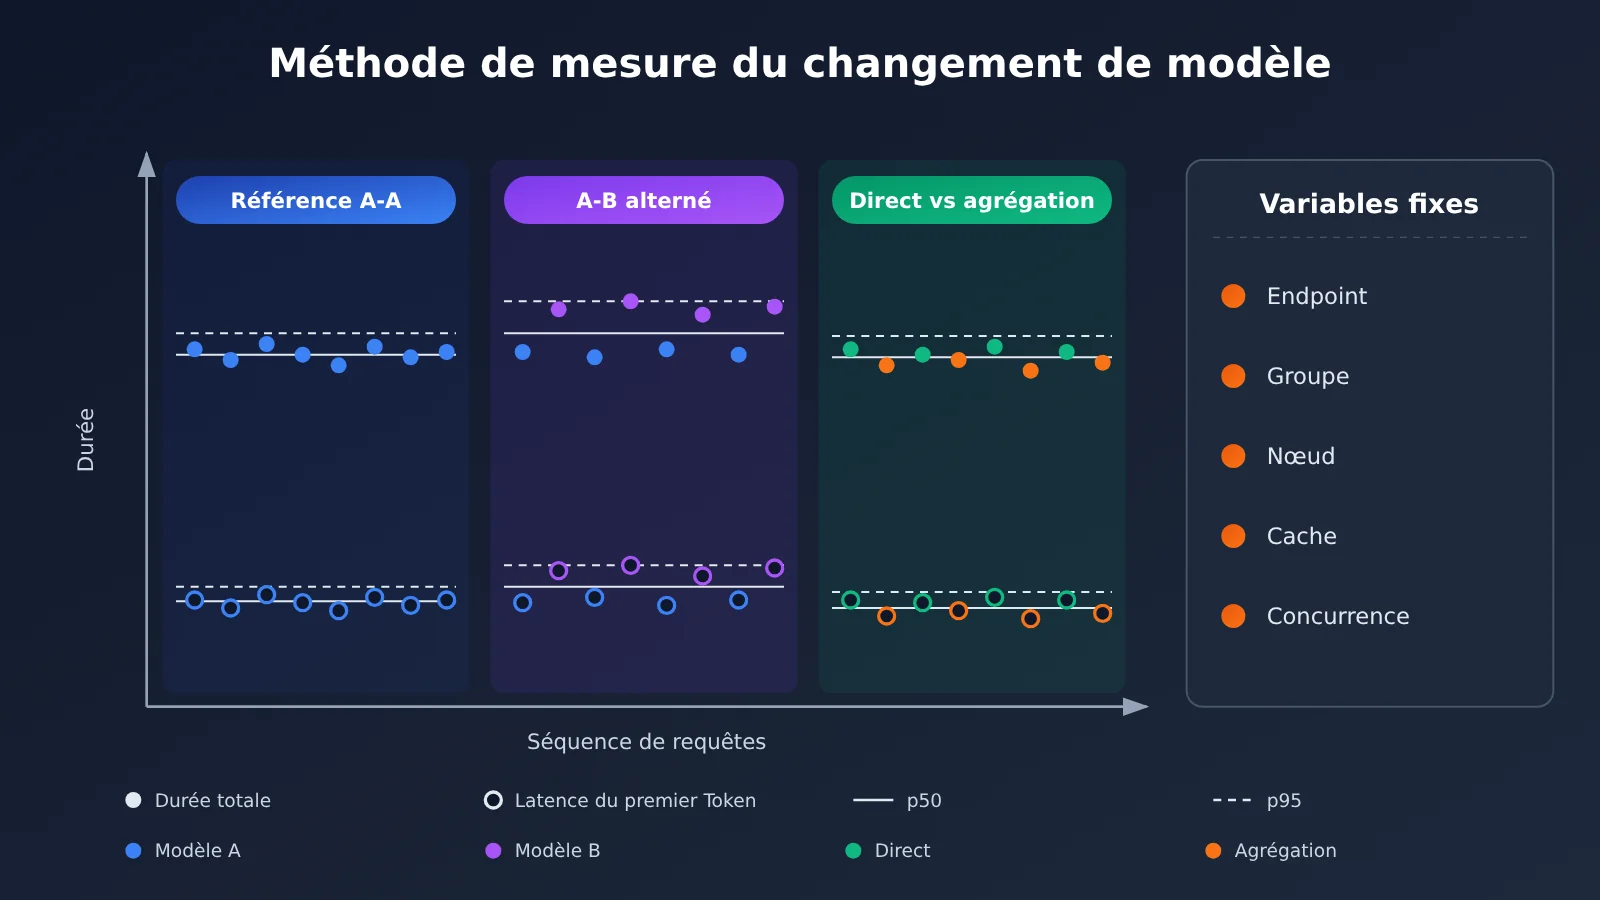
| Durée totale p50/p95 | Quantiles de durée calculés sur chaque requête complète | Évaluer la stabilité et la longue traîne |
| Taux d’échec | Comptage catégorisé par code d’erreur | Distinguer les erreurs de configuration des incidents temporaires |
| Tokens réels et facturation | Rapprocher le champ usage de la facture, ligne par ligne |
Calculer le coût réel |
| Taux de réussite de la validation métier | Noter un échantillon fixe, manuellement ou par règles | Déterminer si la qualité est au niveau requis |
Voici comment organiser les étapes de mesure : commencez par figer le point de terminaison, le groupe, le nœud et les paramètres de requête ; établissez une ligne de base en répétant des requêtes A-A sur le même modèle ; alternez ensuite des cycles A-B en ne changeant qu’un seul élément, le modèle ; si vous devez évaluer l’overhead du canal, comparez séparément, sur un même modèle, une connexion directe et un canal d’agrégation. Contrôlez également l’état du cache (froid ou chaud), la limite de sortie et le niveau de concurrence — sinon, la vitesse du modèle, les échecs de cache et l’overhead du canal se mélangeront au point de devenir impossibles à démêler.
Risques supplémentaires des flux d’outils avec état
Si vous utilisez l’API Responses pour des appels d’outils multi-tours, changer de modèle en cours de route fait en outre apparaître des problèmes d’état. La documentation de migration GPT-6.2 d’OpenAI indique que basculer en plein milieu d’une session vers certains modèles (y compris vers une version inférieure) peut entraîner la suppression des éléments de raisonnement existants : au moment de restaurer le contexte, le modèle peut devoir raisonner à nouveau. Autrement dit, impossible de promettre « aucune perte d’état » après le basculement, et la variation des coûts ne suit aucun ratio fixe non plus.
Lors des tests d’acceptation de ce type de flux, vérifiez que les éléments d’historique et le contexte peuvent être correctement réutilisés par le nouveau modèle, et traitez « changer de modèle en cours de session » comme un cas de test à part entière.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que l’interface unifiée d’APIYI ?
Il s’agit d’un point d’entrée API compatible OpenAI : avec une seule clé API et la même Base URL, vous pouvez invoquer les modèles d’OpenAI, de Claude, de Gemini et d’autres fournisseurs. Pas besoin de créer un compte et de gérer des clés séparément chez chaque fournisseur : pour changer de modèle, il suffit principalement de modifier le champ `model` de la requête, puis de vérifier les paramètres spécifiques propres à chaque modèle.
Q2 : Quelle est la différence entre changer de modèle via l’interface unifiée et intégrer directement les SDK officiels de chaque fournisseur ?
Les SDK officiels offrent la couverture la plus complète en matière de capacités spécifiques, mais les utiliser en parallèle oblige à maintenir plusieurs systèmes d’authentification, plusieurs SDK et plusieurs comptes de facturation. L’interface unifiée regroupe l’authentification, le point d’entrée et la facturation en un seul ensemble, ce qui rend le changement de modèle très peu coûteux dans les scénarios à paramètres communs. La contrepartie : il faut vérifier la compatibilité des paramètres spécifiques un par un — par exemple, le mapping du champ de réflexion natif de Gemini sur l’interface compatible demande une validation dédiée.
Q3 : Quand les modèles mentionnés dans cet article seront-ils disponibles sur APIYI ?
D’après l’archive en temps réel des annonces d’APIYI : GPT-6.2 Astra et Sol sont arrivés le 2026-11-18 et sont ouverts sur trois groupes ; Gemini 4 Neon a été annoncé par Google le 18 novembre, et APIYI l’a intégré le 20 novembre dans les groupes `default` / `svip` ; Seedream 5.5 est arrivé le 13 novembre. La liste des modèles évolue assez vite : référez-vous au registre du jour.
Q4 : Dans quels scénarios l’interface unifiée est-elle la plus adaptée pour changer de modèle ?
– **Comparaison A/B multi-modèles** : comparer les résultats et les coûts d’une même invite entre différents modèles.
– **Repli en cas d’incident** : basculer vers un modèle de secours quand les ressources d’un modèle ou d’une route se font rares.
– **Répartition par tâche** : un modèle économique pour les questions-réponses simples, un modèle phare pour le raisonnement complexe.
– **Génération d’images multi-styles** : choisir parmi plusieurs modèles d’images selon vos besoins, en restant attentif au mapping des paramètres.
Q5 : Comment démarrer le plus rapidement possible avec l’interface unifiée pour invoquer plusieurs modèles ?
1. Rendez-vous sur APIYI (apiyi.com) pour créer un compte ; les nouveaux utilisateurs obtiennent un quota de test gratuit.
2. Créez une clé API et vérifiez que le groupe de jetons auquel elle appartient inclut le modèle cible.
3. Exécutez l’exemple minimaliste de cet article, remplacez le champ `model` selon le registre et validez.
La facturation à l’usage facilite la comparaison de plusieurs modèles à faible volumétrie, avant de trancher sur votre solution principale.
Q6 : Quels sont le prix et le contexte de gemini-4-neon ?
Selon le registre des modèles d’APIYI généré le 2026-11-20, `gemini-4-neon` coûte 3 $ par million de tokens en entrée, 15 $ en sortie et 0,15 $ en lecture de cache ; les annonces d’APIYI indiquent un tarif identique aux prix officiels, et seuls les montants réellement débités font foi, tels qu’affichés sur la facture de votre compte. Artificial Analysis et l’annonce de Google indiquent tous deux 1M de contexte — il s’agit d’une fenêtre de contexte partagée entre l’entrée, la réflexion et la sortie ; la documentation de mise en service d’APIYI mentionne une limite de génération synchrone d’environ 64K.
Q7 : Quelles sont les limites connues du changement de modèle via l’interface unifiée ?
– **Les paramètres propriétaires ne sont pas universels** : les niveaux de réflexion, l’appel d’outils et les sorties structurées doivent être vérifiés modèle par modèle.
– **Les vecteurs ne sont pas interchangeables** : changer de modèle d’embedding impose de re-vectoriser et de reconstruire l’index.
– **Les flux à état peuvent subir des pertes** : changer de modèle en cours de route dans Responses risque de faire perdre des éléments de raisonnement.
– **Visibilité restreinte** : la liste des modèles dépend des groupes de jetons, des autorisations et des endpoints ; en cas de souci, consultez la documentation de dépannage des codes d’erreur sur APIYI (apiyi.com).
Changer de grand modèle de langage via l’interface unifiée APIYI : les points clés
- Changer uniquement le paramètre model a ses conditions : cela ne vaut que sur un même endpoint, en se limitant aux paramètres communs supportés par les deux modèles.
- Deux décomptes différents : « 200+ » correspond aux modèles sélectionnés, tandis que le registre compte 289 entrées, versions et variantes de routes incluses.
- Une vérification dans le bon ordre : ID du modèle → groupe de jetons → endpoint → paramètres, en écartant les causes une par une.
- Les paramètres d’image demandent un mappage : MAI utilise
width/height, Seedream utilisesize, et la transparence ne s’écrit pas de la même façon. - Changement de modèle vectoriel = reconstruction obligatoire : small et large n’ont pas les mêmes dimensions par défaut, et même à dimensions égales, les vecteurs restent incompatibles.
- HTTP 200 ne veut pas dire succès : pensez à vérifier la raison d’achèvement, les corps de réponse vides et les retours limités aux seuls appels d’outils.
- Mesurez les performances vous-même : baseline A-A puis mesures alternées A-B ; sur APIYI (apiyi.com), vous pouvez mener la comparaison avec une seule et même clé.
Résumé
Les points clés pour basculer entre grands modèles de langage grâce à l’interface unifiée d’APIYI :
- Réutiliser l’authentification et le point d’entrée : une seule clé API et un seul Base URL suffisent pour couvrir le texte, les images, les vecteurs et bien d’autres types de capacités.
- Distinguer les paramètres communs des paramètres spécifiques : les paramètres communs se basculent directement, tandis que les paramètres spécifiques doivent être validés un par un avant d’être ajoutés.
- Transformer le basculement en opération vérifiable : déboguez à l’aide de la table de correspondance des codes d’erreur et enregistrez la latence, le taux d’échec et la facturation selon une méthode fixe.
Conseil : commencez par faire fonctionner les deux modèles avec la requête en texte brut la plus courte possible, puis étendez progressivement à vos scénarios métier dans cet ordre : « mappage des paramètres d’image », « reconstruction de l’index vectoriel », « flux d’outils avec état ». Nous vous recommandons d’effectuer d’abord ces vérifications via le quota de test gratuit d’APIYI sur apiyi.com, avant de choisir votre modèle principal et votre solution de repli.
📚 Références
-
Centre de documentation APIYI : présentation générale, démarrage rapide, registre des modèles, vectorisation de texte et notes de version des modèles
- Lien :
docs.apiyi.com - Description : source de première main sur les ID de modèles, les groupes, les points de terminaison et la tarification ; pour le registre, reportez-vous à la version générée du jour
- Lien :
-
OpenAI Using GPT-6.2 : migration vers GPT-6.2 et description des paramètres
- Lien :
developers.openai.com/api/docs/guides/latest-model - Description : appels d’outils Responses, champ des niveaux de réflexion et cycle de vie des éléments de raisonnement
- Lien :
-
Dépannage et signatures de réflexion de l’API Google Gemini : résolution des problèmes d’invocation de Gemini 4
- Lien :
aistudio.google.com/docs/troubleshooting - Description : niveaux de réflexion, renvoi de
thoughtSignatureet erreurs courantes
- Lien :
-
Prise en main de Gemini 4 sur Google Cloud : décodage long de Gemini 4 et versions d’API
- Lien :
docs.cloud.google.com/gemini-enterprise-agent-platform/models/start/get-started-with-gemini-4 - Description : à consulter pour connaître les versions d’API prenant en charge le décodage long et les conditions de reprise
- Lien :
-
Page de comparaison des modèles d’Artificial Analysis : benchmarks de modèles tiers et méthodes de mesure de latence
- Lien :
artificialanalysis.ai/models/comparisons/gemini-4-neon-vs-gpt-6-2-sol - Description : utile comme référence comparative entre modèles, mais ne permet pas d’attribuer les surcoûts à un canal en particulier
- Lien :
Auteur : Équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI ; pour plus de ressources d’intégration, rendez-vous sur le centre de documentation docs.apiyi.com