Autorenhinweis: Wir zeigen, wie sich der Wechsel großer Sprachmodelle mit einem einzigen API-Key und einem OpenAI-kompatiblen Endpunkt umsetzen lässt – und klären, welche Felder, Statuswerte und Abnahmekriterien bei der modellübergreifenden Integration von Bild- und Embedding-Modellen separat angepasst werden müssen.
In diesem Artikel bringen wir den Modellwechsel für reine Textmodelle mit einem API-Key und einem OpenAI-kompatiblen Endpunkt zum Laufen. Anschließend zeigen wir anhand zweier Beispiele – Bilderzeugung und Embeddings –, welche Felder, Statuswerte und Abnahmekriterien bei der modellübergreifenden Integration eine separate Anpassung brauchen. Diese Schlussfolgerung gilt unter einer Voraussetzung: Wenn Sie unter demselben Endpunkt nur gemeinsame Parameter verwenden, die beide Modelle unterstützen, genügt es meist, das Feld model zu ändern. Sobald proprietäre Reasoning-Parameter, Tool-Aufrufe, Bildabmessungen oder Vektordimensionen ins Spiel kommen, müssen Sie die Details je Modell einzeln nachprüfen.
Dies ist kein Werbeartikel nach dem Motto „Eine Zeile Code ändern – und alles läuft“. Wir erklären sauber getrennt, welche Teile sich über die vereinheitlichte APIYI-Schnittstelle wiederverwenden lassen und welche Teile neu validiert werden müssen – auch auf die Fehlerszenarien gehen wir ein.
Kernnutzen: Nach der Lektüre dieses Artikels können Sie Textmodelle mit derselben Authentifizierung und demselben Code wechseln, wissen, welche Parameter Sie beim Wechsel der Bild- bzw. Embedding-Modelle anpassen müssen, und beherrschen ein praxistaugliches Verfahren zur Abnahme des Modellwechsels.
9 Begriffe, die Sie kennen sollten, bevor Sie über die einheitliche APIYI-Schnittstelle große Sprachmodelle wechseln
Die meisten Probleme beim Modellwechsel entstehen durch ein uneinheitliches Verständnis der Begriffe. Beispielsweise eine Base URL, in der /v1 doppelt vorkommt, oder die Annahme, Vektoren gleicher Dimension ließen sich beliebig mischen. Klären wir zunächst die folgenden Begriffe – alle Schritte im weiteren Verlauf bauen auf diesen Definitionen auf.
| Begriff | Tatsächliche Bedeutung | Worauf beim Wechsel zu achten ist |
|---|---|---|
| Base URL | Basisadresse, an die das SDK die Schnittstellenpfade anhängt | Beim OpenAI SDK nur bis /v1 eintragen, um doppeltes Anhängen zu vermeiden |
| API Key | Authentifizierungsnachweis für API-Anfragen | Nur in der Serverkonfiguration oder in Umgebungsvariablen speichern |
| Modell-ID | Das in der Anfrage angegebene Modell, kann Versions- oder Kanalinformationen enthalten | Original-ID aus der Modellregistrierung kopieren, nicht von Hand eintippen |
| Token-Gruppierung | Legt fest, welche Modelle, Kanäle und Abrechnungsbedingungen für den aktuellen Key verfügbar sind | Liegt das Modell nicht in der Gruppe, erhält man 401, 403 oder 404 zurück |
| Chat Completions | Schnittstellenprotokoll für Textdialoge auf Basis eines Nachrichten-Arrays | Haupteinstieg für den Modellwechsel mit reinem Text |
| Responses | Schnittstellenprotokoll mit Unterstützung für verschiedene Ausgabetypen und Tool-Aufrufe | Tool-Aufrufe von GPT-6.2 müssen über diese Schnittstelle laufen |
| Embedding | Kodiert Inhalte in Vektoren fester Dimension, z. B. für Ähnlichkeitssuche beim Retrieval | Ein Modellwechsel bedeutet einen Wechsel des Vektorraums |
| Vektorindex | Struktur zum Auffinden ähnlicher Einträge anhand einer bestimmten Dimension und eines Vektorraums | Muss bei Änderung der Dimension oder des Modells neu aufgebaut werden |
| Latenz bis zum ersten sichtbaren Token | Wartezeit vom Absenden der Anfrage bis die Nutzer die erste nutzbare generierte Ausgabe sehen | Bei Reasoning-Modellen verlängert die Denkzeit diesen Wert |
Am leichtesten wird die Token-Gruppierung übersehen. Innerhalb desselben Kontos können Keys aus verschiedenen Gruppen unterschiedliche Modelllisten sehen. Wer also dem Fehler „Modell existiert nicht“ auf den Grund geht, sollte zuerst prüfen, zu welcher Gruppe der Key gehört – und nicht gleich den Code in Verdacht ziehen.
APIYI: Kernpunkte für den Wechsel großer Sprachmodelle über die einheitliche Schnittstelle
Was die einheitliche Anbindung wirklich einspart, ist die doppelte Arbeit: Sie müssen sich nicht für jeden Anbieter separat registrieren, nicht mehrere Schlüssel verwalten und nicht mehrere SDKs anpassen. Laut der Grundlagen- und Schnellstart-Dokumentation von APIYI (apiyi.com) genügen eine einzige Authentifizierungskonfiguration plus ein OpenAI-kompatibler Zugangspunkt, um auf die verfügbaren Modelle verschiedener Anbieter zuzugreifen.
| Ebene | Lässt sich wiederverwenden | Muss modellabhängig geprüft werden |
|---|---|---|
| Authentifizierung | Derselbe API-Schlüssel, dieselben Request-Header | Enthält die Token-Gruppe des Schlüssels das Zielmodell? |
| Zugang | Dieselbe Base URL | Welche Endpunkte unterstützt das Zielmodell (Chat / Responses / Bilder / Embeddings)? |
| Anfragetext | Gemeinsame Felder wie model, Basis-messages und input |
Reasoning-Stufen, Tools, strukturierte Ausgaben, Bildgrößen, Embedding-Dimensionen |
| Antwortverarbeitung | Parsing-Logik für choices, finish_reason und usage |
Sonderfälle wie leerer Antwortkörper, ausschließlich Tool-Aufrufe, Sicherheitsfilter |
| Abrechnung | Dasselbe Kontoguthaben und dieselbe Abrechnung | Einzelpreise, Preisstufen und Cache-Abrechnung unterscheiden sich je Modell |
200+ gegenüber 289: Zwei Zählweisen der Modellanzahl bei APIYI
In der öffentlichen Darstellung von APIYI ist von über 200 kuratierten Modellen die Rede. Im öffentlichen Modellregister mit Stand 2026-11-20 beträgt das Feld model_count hingegen 289. Beide Zahlen widersprechen sich nicht: Das Register zählt auch unterschiedliche Versionen desselben Modells sowie verschiedene Routing-Varianten mit, daher liegt die Anzahl der Einträge über der Zahl der „kuratierten Modelle“.
Zu beachten ist, dass die Liste der Modelle, die ein einzelnes Token tatsächlich aufrufen kann, einer dreifachen Einschränkung unterliegt: durch die Gruppe, die Modellautorisierung und die Endpunkte. Dass eine ID im Register existiert, bedeutet nicht, dass Ihr Schlüssel sie zwangsläufig aufrufen kann.
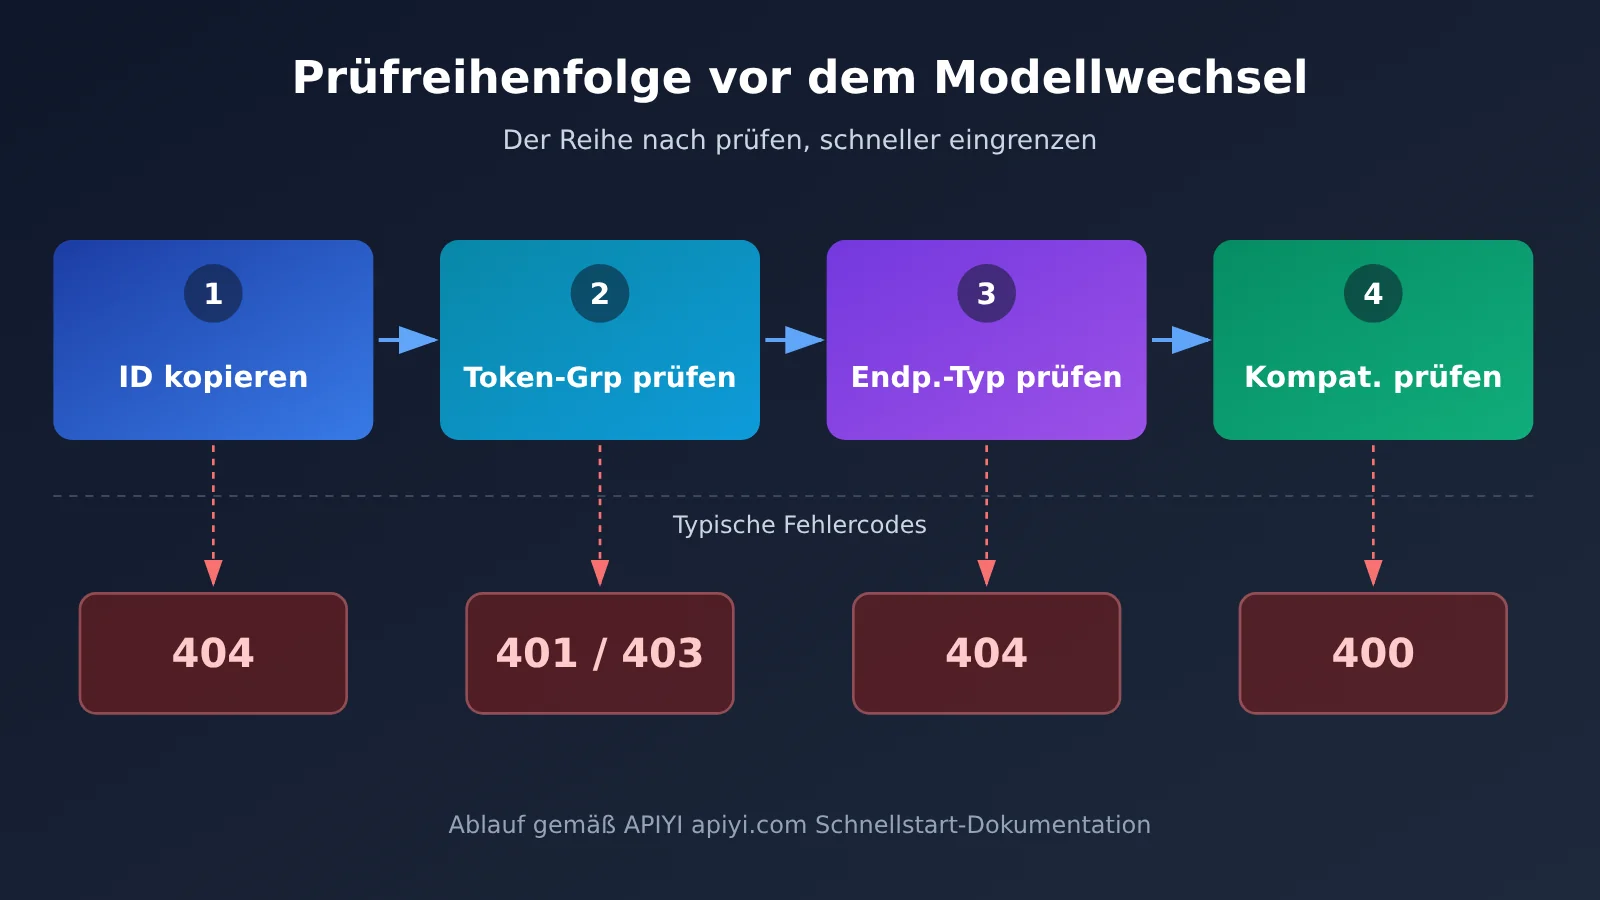
Prüfreihenfolge vor dem Wechsel
Es empfiehlt sich, bei jeder Einführung eines neuen Modells in fester Reihenfolge zu prüfen, damit Sie im Fehlerfall nicht in alle Richtungen gleichzeitig suchen müssen:
- Modell-ID prüfen: Kopieren Sie die Original-ID aus dem tagesaktuellen Modellregister und stellen Sie sicher, dass Groß- und Kleinschreibung sowie Bindestriche exakt übereinstimmen.
- Token-Gruppe prüfen: Vergewissern Sie sich, dass die Gruppe Ihres aktuellen Schlüssels das Modell freigeschaltet hat – manche Modelle sind nur in bestimmten Gruppen verfügbar.
- Endpunkt prüfen: Bestätigen Sie, dass das Modell den gewünschten Schnittstellentyp unterstützt; die Endpunkte für Text, Bilder und Embeddings unterscheiden sich.
- Parameter prüfen: Behalten Sie zunächst nur die gemeinsamen Parameter, die beide Modelle unterstützen, und fügen Sie modellspezifische Parameter einzeln wieder hinzu, um sie zu verifizieren.
So wechseln Sie über die einheitliche APIYI-Schnittstelle schnell zwischen großen Sprachmodellen
Im Folgenden verwenden wir zwei über Chat Completions zugängliche Textmodelle als Beispiel: gemini-4-neon und gpt-6.2-sol. Beide nutzen POST /v1/chat/completions; solange Sie nur die grundlegenden messages verwenden, genügt für den Wechsel das Austauschen des Felds model. Voraussetzung ist, dass Ihre Schlüsselgruppe Zugriff auf beide Modelle hat – bitte prüfen Sie das vor dem Aufruf in der Modell-Registry.
Minimalbeispiel: Zwei Modelle mit ein und demselben Code wechseln
Setzen Sie die Base URL auf https://api.apiyi.com/v1 und lesen Sie den API-Schlüssel aus einer Umgebungsvariable:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],     # Nur in serverseitigen Umgebungsvariablen speichern
    base_url="https://api.apiyi.com/v1",     # OpenAI-kompatibler Einstiegspunkt von APIYI
)

for model in ["gemini-4-neon", "gpt-6.2-sol"]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是向量索引"}],
    )
    choice = resp.choices[0]
    print(model, "| finish_reason:", choice.finish_reason, "| usage:", resp.usage)
    print(choice.message.content or "<空正文>")
Antwortfelder prüfen, statt nur auf HTTP 200 zu achten
Sobald Sie die Antwort erhalten haben, sollten Sie mindestens drei Stellen prüfen: ob choices[0].message.content leer ist; ob finish_reason auf stop steht oder die Ausgabe z. B. wegen Erreichen der Längengrenze vorzeitig beendet wurde; und ob die Token-Nutzung in usage plausibel ist. Auch der Denkprozess von Reasoning-Modellen verbraucht das Ausgabebudget – ist dieses zu knapp bemessen, kann es passieren, dass Sie zwar ein „HTTP 200“ erhalten, der Antworttext aber leer bleibt.
Außerdem taugt der Name, mit dem sich das Modell im Antworttext selbst bezeichnet, nicht als Nachweis für das tatsächlich verwendete Backend-Modell. Wenn Sie klären möchten, welches Modell wirklich aufgerufen wurde, schauen Sie zuerst in die Request-ID, die Antwort-Metadaten und die Abrechnungslogs.
Vollständigen Implementierungscode ansehen: mit Time-to-First-Token beim Streaming, Backoff-Retries und Metrik-Protokollierung
import os
import time
import random
from openai import OpenAI, RateLimitError, APIStatusError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",   # Einheitliche APIYI-Schnittstelle
)

def call_once(model: str, prompt: str, max_retries: int = 3) -> dict:
    """Ein einzelner Streaming-Aufruf; erfasst die Zeit bis zum ersten sichtbaren Token, die Gesamtlaufzeit und den Abschlussgrund"""
    for attempt in range(max_retries + 1):
        start = time.perf_counter()
        first_token_at = None
        parts, finish_reason, usage = [], None, None
        try:
            stream = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
                stream=True,
                stream_options={"include_usage": True},
            )
            for chunk in stream:
                if chunk.usage:
                    usage = chunk.usage
                if not chunk.choices:
                    continue
                delta = chunk.choices[0].delta
                if delta and delta.content:
                    if first_token_at is None:
                        first_token_at = time.perf_counter()
                    parts.append(delta.content)
                if chunk.choices[0].finish_reason:
                    finish_reason = chunk.choices[0].finish_reason
            end = time.perf_counter()
            return {
                "model": model,
                "ok": bool(parts),
                "ttft_s": round(first_token_at - start, 3) if first_token_at else None,
                "total_s": round(end - start, 3),
                "finish_reason": finish_reason,
                "usage": usage,
                "text": "".join(parts),
            }
        except RateLimitError:
            # Nur bei kurzfristigen Rate-Limits: endliche Anzahl von Versuchen mit exponentiellem Backoff und Jitter
            if attempt == max_retries:
                raise
            time.sleep((2 ** attempt) + random.uniform(0, 0.5))
        except APIStatusError as e:
            # 400/401/403/404 sind Konfigurations- oder Parameterfehler – ein Retry bringt nichts
            return {"model": model, "ok": False, "status": e.status_code,
                    "error": str(e)[:300]}

if __name__ == "__main__":
    prompt = "用三句话说明向量索引为什么要和 Embedding 模型绑定"
    for m in ["gemini-4-neon", "gpt-6.2-sol"]:
        r = call_once(m, prompt)
        print({k: v for k, v in r.items() if k != "text"})
🚀 Schnellstart: Spielen Sie das obige Minimalbeispiel am besten zuerst auf APIYI (apiyi.com) mit dem kostenlosen Testguthaben für Neukunden durch und vergewissern Sie sich, dass beide Modell-IDs in der Gruppe Ihres API-Schlüssels tatsächlich einen Antworttext zurückgeben, bevor Sie den Code in Ihre Anwendung integrieren.
Proprietäre Parameter müssen separat geprüft werden
Die obigen Beispiele nutzen bewusst nur gemeinsame Felder. Sobald die folgenden Parameter hinzukommen, können Sie nicht mehr davon ausgehen, dass „einfach nur das model ändern“ genügt:
- GPT-6.2-Serie: In der OpenAI API unterstützen sowohl
gpt-6.2-astraals auchgpt-6.2-solChat Completions und Responses. Bei Chat Completions heißt das Feld für die Reasoning-Stufereasoning_effort, bei Responsesreasoning.effort; beide Modelle lehnen den Wertnoneab. Wenn Sie Tool-Aufrufe benötigen, müssen Sie auf Responses ausweichen. - Gemini-4-Serie:
gemini-4-neonunterstützt sowohl das native Gemini-Schema von APIYI als auch OpenAI-kompatible Dialoge. Die native REST-Variante nutzt/v1beta/models/{id}:generateContent, die Reasoning-Stufe wird ingenerationConfig.thinkingConfig.thinkingLevelfestgelegt – möglich sindlow,medium,highundxhigh, Standard isthigh. Das älterethinkingBudgetsowieminimalgelten nicht für Gemini 4; laut Google-Dokumentation ignoriert Gemini 4 außerdemtemperatureundtopP. - Strukturierte Ausgaben und Tools: Die JSON-Schema-Constraints und das Format der Tool-Definitionen stimmen auf beiden Seiten nicht zwangsläufig überein – prüfen Sie diese anhand der Dokumentation des jeweiligen Zielmodells Punkt für Punkt nach.
Wichtig zu wissen: In den Release-Hinweisen von APIYI zu Neon heißt es, dass beim Go-live nur die Preisschnittstelle geprüft wurde – echte Testaufrufe vor dem Start gab es nicht. Die oben beschriebenen Dual-Endpunkte und Tool-Aufrufe sind also dokumentiertes Verhalten. Bitte verifizieren Sie daher vor dem produktiven Einsatz selbst mit minimalen Anfragen.
APIYI: Wechsel zwischen Fähigkeiten über die einheitliche Schnittstelle – Bild und Embedding im Vergleich
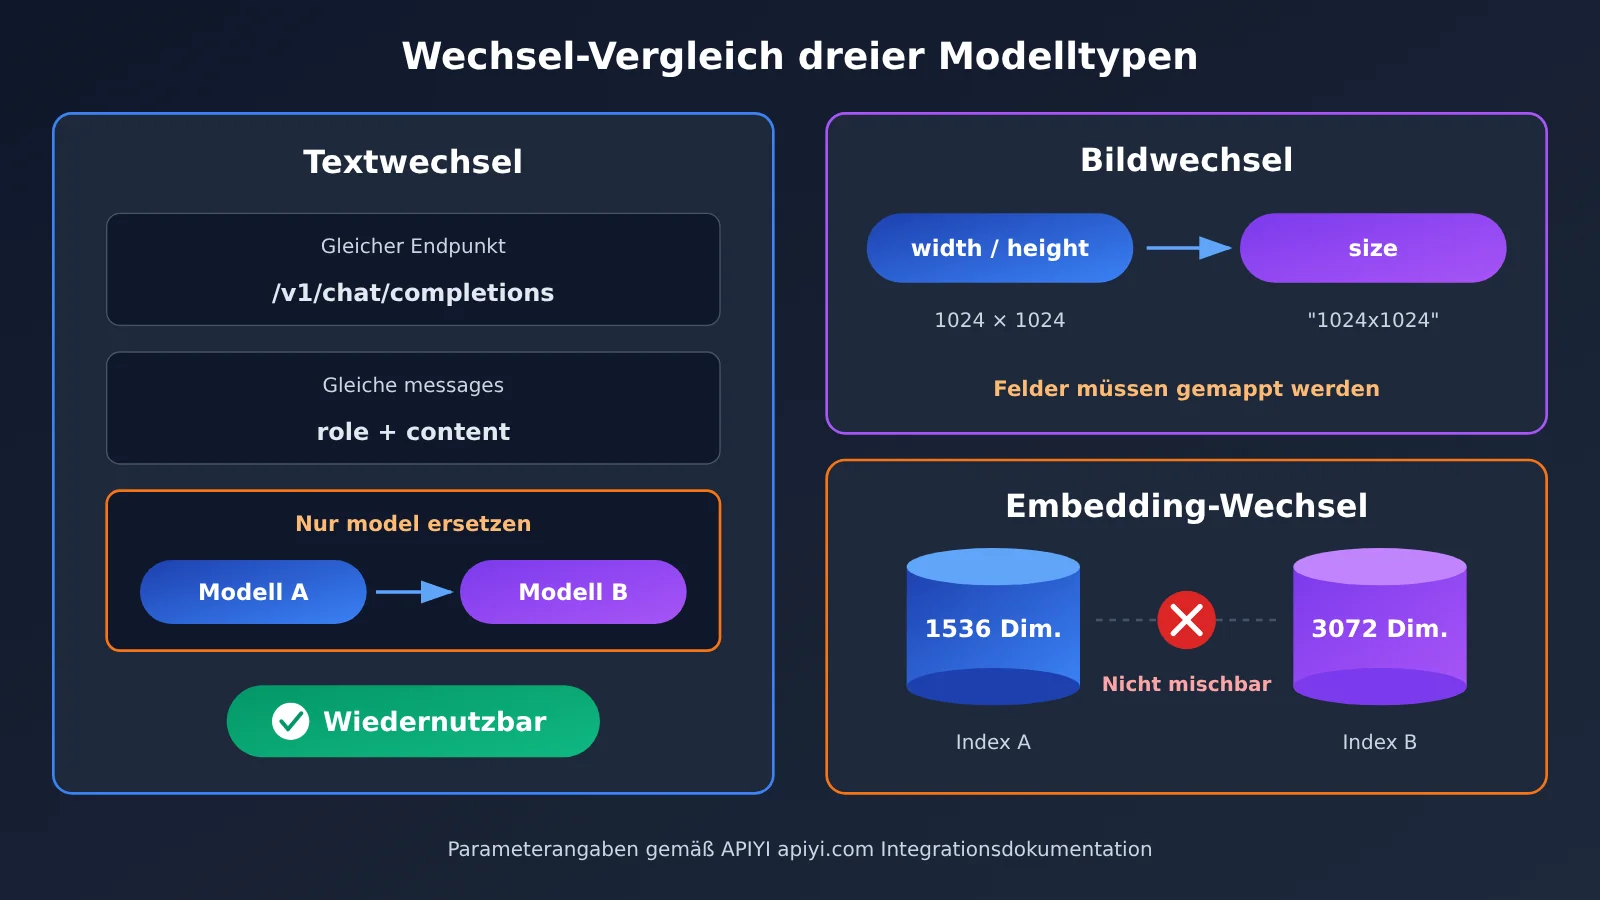
Neben Textdialogen sind Bilder und Vektoren die häufigsten Szenarien für den Wechsel zwischen Modellen – und zugleich die Stelle, an der „nur model ändern“ am ehesten scheitert. Die beiden folgenden Beispiele stehen exemplarisch für die zwei Problemtypen „unterschiedliche Parameterstruktur“ und „unterschiedlicher Ergebnisraum“.
Wechsel zwischen Bildmodellen: MAI-Image-2.7 und Seedream 5.5
Beide Modelle lassen sich mit demselben Key über die Images-Fähigkeit aufrufen, doch bei Größe, Referenzbild und transparenter Ausgabe unterscheidet sich die Schreibweise komplett:
| Dimension | MAI-Image-2.7 | Seedream 5.5 |
|---|---|---|
| Endpunkt | Erzeugung über generations, Bearbeitung über edits |
Reiner Text und Referenzbilder laufen beide über generations |
| Größenparameter | width und height steuern die Gesamtpixelzahl, laut Ankündigung max. 4.194.304 Pixel |
size wählt die Preisstufe, ohne Angabe gilt die 2K-Stufe |
| Referenzbild | Bearbeitung mit bis zu 5 Referenzbildern | Referenzbilder stehen im Feld image |
| Transparente Ausgabe | background: "transparent", Ausgabe als PNG mit Alpha-Kanal |
Zusätzlich müssen background: "transparent" und output_format: "png" gesetzt werden |
| Abrechnung | Unabhängige Abrechnung | Unabhängige Abrechnung nach size-Preisstufe |
| Verfügbare Plattform | APIYI apiyi.com (maßgeblich sind Registry und Gruppen) | APIYI (maßgeblich sind Registry und Gruppen) |
Für den Aufruf empfiehlt es sich, pro Modell eine eigene Parameter-Mapping-Funktion zu pflegen, statt die Felder direkt in der Geschäftslogik zusammenzubauen:
# Client wie im vorherigen Abschnitt; Modell-ID bitte aus der tagesaktuellen Registry kopieren
def build_image_kwargs(model: str, prompt: str, transparent: bool = False) -> dict:
    if model.startswith("MAI-Image"):
        body = {"width": 1024, "height": 1024}
        if transparent:
            body["background"] = "transparent"
        return {"model": model, "prompt": prompt, "extra_body": body}
    # Seedream 5.5: size bestimmt die Preisstufe, gültige Werte laut Integrationsdokumentation
    body = {"size": "2K"}
    if transparent:
        body.update({"background": "transparent", "output_format": "png"})
    return {"model": model, "prompt": prompt, "extra_body": body}

img = client.images.generate(**build_image_kwargs("MAI-Image-2.7", "扁平风格的钥匙图标", True))
Transparente Bilder, Ergebnisse mit Referenzbild, Antwortformat und Kosten müssen für beide Modelle separat validiert werden – das Abnahmeergebnis des einen Modells darf nicht als Ersatz für das andere dienen.
Embedding-Modellwechsel: small und large lassen sich nicht direkt mischen
Die Aufrufform für die Vektorisierung ist tatsächlich einheitlich: Beide laufen über POST /v1/embeddings, übergeben werden nur model und input.
for m in ["text-embedding-3-small", "text-embedding-3-large"]:
    e = client.embeddings.create(model=m, input=["统一接口切换模型"])
    print(m, "维度:", len(e.data[0].embedding))   # standardmäßig 1536 bzw. 3072
Das Problem liegt im Ergebnis. text-embedding-3-small liefert standardmäßig 1536 Dimensionen, text-embedding-3-large standardmäßig 3072 – Vektoren unterschiedlicher Dimensionszahl lassen sich nicht in denselben Index aufnehmen. Selbst wenn man large mit dem Parameter dimensions auf 1536 Dimensionen reduziert, bleiben die Vektorräume der beiden Modelle inkompatibel: Die Ähnlichkeit zwischen Vektoren alter Dokumente und neuen Abfragevektoren wäre dann bedeutungslos.
Der richtige Weg, das Embedding-Modell zu wechseln, ist daher: einen neuen Vektorindex anlegen, sämtliche alten Dokumente neu vektorisieren, das Modell auf der Abfrageseite zeitgleich umstellen und anschließend mit einem Satz annotierter Beispiele den Ähnlichkeitsschwellenwert neu kalibrieren. Dieser Aufwand übersteigt bei weitem das Ändern einer einzigen model-Zeile und sollte bereits bei der Modellauswahl einkalkuliert werden.
Wie Sie Modellwechsel über die einheitliche Schnittstelle von APIYI abnehmen
Bevor Sie den Wechsel live schalten, müssen Sie die Messlatte von „lässt sich aufrufen“ auf „lässt sich abnehmen“ anheben. Die Abnahme umfasst zwei Teile: die Fehlercode-Diagnose und den Abgleich der Metriken.
Referenztabelle zur Fehlercode-Diagnose
Voraussetzung für die Fehlersuche ist ein festgelegter Minimal-Request, der sich mit demselben Key, demselben Knoten, demselben Endpunkt und derselben Modell-ID zuverlässig reproduzieren lässt:
| Symptom | Häufige Ursachen | Prüfung und Behebung |
|---|---|---|
| 400 | Felder, die nur das alte Modell kannte, Tool-Parameter, strukturierte Ausgaben oder Bildformate sind inkompatibel | Nicht benötigte Felder entfernen und dann einzeln wieder ergänzen, um die Ursache einzugrenzen |
| 401/403 | Falsches Token-Format, die Gruppe enthält das Modell nicht oder das Modell steht nicht auf der Whitelist | Key, Token-Gruppe und Modell-Whitelist prüfen |
| 404 | Das SDK hängt /v1 doppelt an, oder das Modell passt nicht zum Schnittstellentyp |
Beim OpenAI SDK die Base URL mit /v1 angeben; beim Google GenAI SDK die Root-Adresse ohne /v1 verwenden und v1beta konfigurieren; die ursprüngliche Modell-ID kopieren |
| 429 | Kurzfristiges Rate Limiting, überschrittene Concurrency-Limits oder unzureichendes Guthaben | Zuerst den Antwortkörper der Fehlermeldung lesen; bei kurzfristigem Rate Limiting Wiederholungen in begrenzter Anzahl mit exponentiellem Backoff inklusive Jitter einsetzen; bei Guthabenproblemen erst nach der Korrektur erneut senden |
| 200 mit leerem Antwortkörper | Ausgabebudget durch Thinking aufgebraucht, Sicherheitsfilter greifen oder es werden nur Tool-Aufrufe zurückgegeben | Abschlussgrund (finish reason) und Rückgabetyp prüfen, Ausgabebudget erhöhen; zum Vergleich einen minimalen Request ohne Tools senden |
Bei mehrstufigen Tool-Workflows mit Gemini 4 sollten Sie außerdem prüfen, ob die thoughtSignature aus der Antwort unverändert zurückgeschickt wird und ob Tool-Aufrufe und Tool-Ergebnisse eins zu eins zugeordnet sind.
Metriken erfassen, um Modellunterschiede vom Kanal-Overhead zu trennen
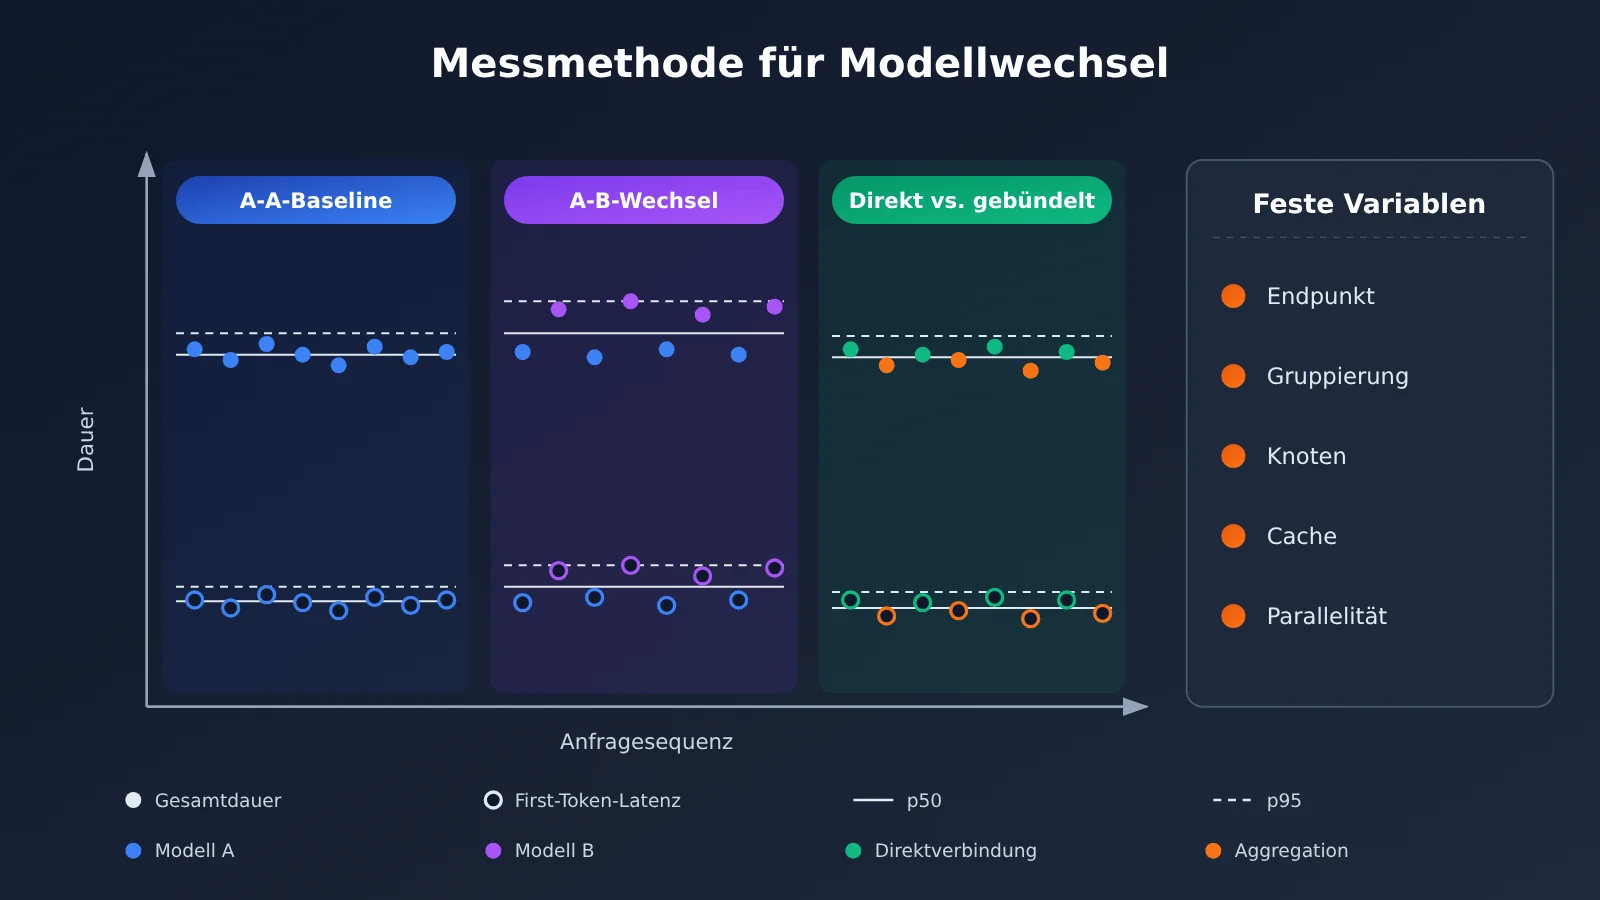
In den öffentlich zugänglichen Quellen gibt es bislang keine gruppierten Daten, die unter identischen Bedingungen – gleicher Key, gleiche Gruppe, gleiche Region, gleiche Eingaben und Last – die Verluste isolieren, die ausschließlich durch einen Modellwechsel oder die Gateway-Weiterleitung entstehen. Drittanbieter-Benchmarks können verschiedene Modelle oder Anbieter miteinander vergleichen, aber die Differenz lässt sich nicht direkt darauf zurückführen, dass auf APIYI ein anderes Modell zum Einsatz kam. Statt fremde Zahlen zu zitieren, sollten Sie daher lieber selbst nach der folgenden Methode messen:
| Metrik | Erfassungsmethode | Zweck |
|---|---|---|
| Fertigstellungsgrund | Verteilung von finish_reason über alle Anfragen |
Erkennt Abbrüche, Filterungen und Tool-Unterbrechungen |
| Latenz bis zum ersten sichtbaren Token | Zeitpunkt des ersten nicht-leeren Inhalts bei Streaming-Anfragen | Misst das Warteempfinden der Nutzer |
| Gesamtdauer p50/p95 | Dauerquantile aller vollständigen Anfragen | Misst Stabilität und Long-Tail-Verhalten |
| Fehlerrate | Zählung, klassifiziert nach Fehlercodes | Trennt Konfigurationsfehler von vorübergehenden Störungen |
| Tatsächliche Token und Abrechnung | usage-Feld Posten für Posten mit der Abrechnung abgleichen |
Ermittelt die realen Kosten |
| Quote bestandener Abnahmetests | Feste Stichproben manuell oder regelbasiert bewerten | Beurteilt, ob die Qualität die Anforderungen erfüllt |
Für die Messung empfiehlt sich folgendes Vorgehen: Zuerst Endpoint, Gruppe, Knoten und Anfrageparameter fixieren; dann mit wiederholten A-A-Anfragen an dasselbe Modell eine Baseline aufbauen; danach im Wechsel A-B-Tests durchführen, bei denen nur das Modell getauscht wird. Um den Kanal-Overhead zu bewerten, vergleichen Sie dasselbe Modell gesondert über eine Direktverbindung und über einen aggregierten Kanal. Kontrollieren Sie dabei auch kalten und warmen Cache, Ausgabelimit und Parallelität – sonst vermischen sich Modellgeschwindigkeit, Cache-Misses und Kanal-Overhead und lassen sich nicht mehr voneinander trennen.
Zusätzliche Risiken bei zustandsbehafteten Tool-Workflows
Wenn Sie Responses für mehrstufige Tool-Aufrufe verwenden, kommt beim Modellwechsel mitten in der Sitzung ein weiteres Problem hinzu: der Sitzungszustand. Die Migrationsdokumentation von OpenAI zu GPT-6.2 beschreibt, dass ein Wechsel zu bestimmten Modellen während einer laufenden Sitzung (auch ein Downgrade) dazu führen kann, dass bereits vorhandene Reasoning-Items entfernt werden. Wird der Kontext anschließend wiederhergestellt, muss das Modell den Reasoning-Prozess möglicherweise erneut durchführen. Das heißt: Ein Versprechen wie „kein Zustandsverlust nach dem Wechsel“ lässt sich nicht geben, und auch für die Kostenänderung gibt es keinen festen Umrechnungsschlüssel.
Bei der Abnahme solcher Workflows sollten Sie prüfen, ob Verlaufseinträge und Kontext vom neuen Modell korrekt wiederverwendet werden können — und den Fall „Modellwechsel mitten in derselben Sitzung“ als eigenen Testfall führen.
Häufige Fragen (FAQ)
Q1: Was ist die einheitliche APIYI-Schnittstelle?
Es handelt sich um einen OpenAI-kompatiblen API-Einstiegspunkt: Mit einem einzigen API-Schlüssel und derselben Base URL können Sie Modelle verschiedener Anbieter wie OpenAI, Claude und Gemini aufrufen. Sie müssen nicht für jeden Anbieter separate Konten registrieren und Schlüssel pflegen – beim Modellwechsel ändern Sie hauptsächlich das Feld `model` in der Anfrage und prüfen modellspezifische Parameter.
Q2: Worin unterscheidet sich der Modellwechsel über die einheitliche Schnittstelle von der separaten Anbindung an die offiziellen SDKs?
Offizielle SDKs decken die proprietären Funktionen am vollständigsten ab, doch bei der parallelen Nutzung mehrerer Anbieter müssen Sie mehrere Authentifizierungen, SDKs und Abrechnungskonten pflegen. Die einheitliche Schnittstelle fasst Authentifizierung, Einstiegspunkt und Abrechnung in einem System zusammen – bei Standardparametern ist der Wechselaufwand sehr gering. Der Nachteil: Proprietäre Parameter müssen einzeln auf Kompatibilität geprüft werden, beispielsweise muss die Zuordnung der nativen Thinking-Felder von Gemini über die kompatible Schnittstelle separat abgenommen werden.
Q3: Wann sind die im Artikel erwähnten Modelle auf APIYI verfügbar?
Laut der Echtzeit-Statistik von APIYI: GPT-6.2 Astra und Sol gingen am 2026-11-18 online und sind in drei Gruppen verfügbar; Gemini 4 Neon wurde von Google am 18. November angekündigt, APIYI nahm es am 20. November in die Gruppen `default` und `svip` auf; Seedream 5.5 ging am 13. November online. Die Modellliste ändert sich schnell, maßgeblich ist die Registertabelle des jeweiligen Tages.
Q4: Für welche Szenarien eignet sich der Modellwechsel über die einheitliche Schnittstelle am besten?
– **A/B-Vergleich mehrerer Modelle**: Dieselbe Eingabeaufforderung wird über verschiedene Modelle hinweg hinsichtlich Leistung und Kosten verglichen.
– **Ausfallabsicherung**: Wenn ein Modell oder eine Leitung stark ausgelastet ist, wechseln Sie zu einem Ersatzmodell.
– **Aufgabenaufteilung**: Einfache Fragen mit einem günstigen Modell beantworten, komplexe Schlussfolgerungen mit einem Flaggschiff-Modell.
– **Bilderzeugung in mehreren Stilen**: Je nach Bedarf zwischen mehreren Bildmodellen wählen und dabei auf die Parameterzuordnung achten.
Q5: Wie starten Sie am schnellsten mit der einheitlichen Schnittstelle in den Modellaufruf?
1. Besuchen Sie APIYI unter apiyi.com und registrieren Sie ein Konto – neue Nutzer erhalten ein kostenloses Testguthaben.
2. Erstellen Sie einen API-Schlüssel und vergewissern Sie sich, dass die Token-Gruppe das Zielmodell enthält.
3. Führen Sie das Minimalbeispiel aus diesem Artikel aus und ersetzen Sie das Feld `model` gemäß der Registertabelle, um es zu verifizieren.
Die nutzungsbasierte Abrechnung erleichtert es, bei geringem Volumen zunächst mehrere Modelle zu vergleichen, bevor Sie sich für eine Hauptlösung entscheiden.
Q6: Wie hoch sind Preis und Kontextfenster von gemini-4-neon?
Laut der von APIYI am 2026-11-20 generierten Modellregistertabelle kostet `gemini-4-neon` pro Million Token: $3 für Eingabe, $15 für Ausgabe und $0.15 für Cache-Lesezugriffe. In den APIYI-Updates wird Preisgleichheit mit dem offiziellen Angebot vermerkt; die tatsächliche Abrechnung richtet sich nach Ihrer Kontoabrechnung. Sowohl Artificial Analysis als auch die Google-Ankündigung geben 1M Kontext an – ein gemeinsam genutztes Fenster für Eingabe, Thinking und Ausgabe; die APIYI-Dokumentation zum Launch nennt eine Obergrenze von etwa 64K für die synchrone Generierung.
Q7: Welche bekannten Einschränkungen gibt es beim Wechsel über die einheitliche Schnittstelle?
– **Proprietäre Parameter gelten nicht modellübergreifend**: Reasoning-Stufen, Tool-Aufrufe und strukturierte Ausgaben müssen für jedes Modell einzeln geprüft werden.
– **Vektoren sind nicht mischbar**: Beim Wechsel des Embedding-Modells müssen die Daten neu vektorisiert und der Index neu aufgebaut werden.
– **Zustandsbehaftete Abläufe können Daten verlieren**: Wechselt man mitten in einer Responses-Sequenz das Modell, gehen möglicherweise Reasoning-Elemente verloren.
– **Eingeschränkte Sichtbarkeit**: Die Modellliste hängt von Token-Gruppen, Berechtigungen und Endpunkten ab. Bei Problemen hilft die Dokumentation zur Fehlersuche anhand von Fehlercodes auf APIYI (apiyi.com).
Key Takeaways: Wechsel großer Sprachmodelle über die einheitliche APIYI-Schnittstelle
- Nur
modelzu ändern hat Voraussetzungen: Das funktioniert nur bei gleichem Endpunkt und ausschließlich mit gemeinsamen Parametern, die beide Modelle unterstützen. - Zwei verschiedene Zählweisen: Die Angabe 200+ bezieht sich auf kuratierte Modelle; die Registrierung umfasst 289 Einträge inklusive Versions- und Routenvarianten.
- Prüfung in fester Reihenfolge: Modell-ID → Token-Gruppe → Endpunkt → Parameter – der Reihe nach ausschließen.
- Bildparameter müssen gemappt werden: MAI verwendet
width/height, Seedream verwendetsize; auch die Schreibweise für Transparenz unterscheidet sich. - Vektor-Modellwechsel erfordert Neuaufbau: small und large haben unterschiedliche Standarddimensionen, und selbst bei gleicher Dimension sind die Vektoren nicht interoperabel.
- HTTP 200 bedeutet nicht automatisch Erfolg: Fertigstellungsgrund, leere Antwortkörper und Rückgaben, die nur Tool-Aufrufe enthalten, müssen geprüft werden.
- Performance selbst messen: Mit einer A-A-Baseline und alternierenden A-B-Messungen – auf APIYI (apiyi.com) lässt sich der Vergleich mit demselben API-Schlüssel durchführen.
Zusammenfassung
Die wichtigsten Punkte, um mit der einheitlichen Schnittstelle von APIYI zwischen großen Sprachmodellen zu wechseln:
- Authentifizierung und Zugangspunkt wiederverwenden: Ein Key, eine Base URL – damit decken Sie Text, Bilder, Vektoren und weitere Fähigkeiten ab.
- Allgemeine und modellspezifische Parameter unterscheiden: Allgemeine Parameter lassen sich direkt übernehmen, modellspezifische Parameter erst einzeln prüfen und dann hinzufügen.
- Den Wechsel zu einem nachprüfbaren Vorgang machen: Fehler mithilfe einer Fehlercode-Referenztabelle eingrenzen und Latenz, Fehlerrate und Abrechnung nach einer festen Methode dokumentieren.
Wir empfehlen, zuerst mit einer möglichst kurzen reinen Textanfrage beide Modelle zum Laufen zu bringen und dann in dieser Reihenfolge schrittweise auf Ihre Geschäftsszenarien auszuweiten: „Bildparameter-Mapping“, „Neuaufbau des Vektor-Index“ und „zustandsbehaftete Tool-Abläufe“. Am besten schließen Sie diese Verifikation zunächst über das kostenlose Testguthaben bei APIYI auf apiyi.com ab, bevor Sie sich für Ihr Hauptmodell und die Fallback-Lösung entscheiden.
📚 Referenzen
-
APIYI Dokumentationszentrum: Grundlegende Einführung, Schnellstart, Modell-Registry, Text-Vektorisierung und Hinweise zu Modellversionen
- Link:
docs.apiyi.com - Hinweis: Primärquelle für Modell-IDs, Gruppierungen, Endpunkte und Preise; nutzen Sie die Registry in der jeweils tagesaktuell generierten Version
- Link:
-
OpenAI Using GPT-6.2: Migration zu GPT-6.2 und Erläuterungen zu den Parametern
- Link:
developers.openai.com/api/docs/guides/latest-model - Hinweis: Tool-Aufrufe über Responses, Felder für Denkstufen und der Lebenszyklus von Reasoning-Elementen
- Link:
-
Google Gemini API Troubleshooting und Thinking-Signature-Dokumentation: Fehlerbehebung bei Gemini-4-Aufrufen
- Link:
aistudio.google.com/docs/troubleshooting - Hinweis: Denkstufen, Rückgabe von
thoughtSignatureund häufige Fehlermeldungen
- Link:
-
Google Cloud Gemini 4 – Erste Schritte: Long Decoding bei Gemini 4 und Hinweise zu den API-Versionen
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/start/get-started-with-gemini-4 - Hinweis: Informationen dazu, welche API-Versionen Long Decoding unterstützen und unter welchen Bedingungen eine Fortsetzung möglich ist
- Link:
-
Artificial Analysis Modellvergleichsseite: Benchmarks von Drittanbietern und Methoden zur Latenzmessung
- Link:
artificialanalysis.ai/models/comparisons/gemini-4-neon-vs-gpt-6-2-sol - Hinweis: Nützlich für den direkten Vergleich zwischen Modellen, aber nicht geeignet, um Kanal-Overhead bestimmten Anbietern zuzuschreiben
- Link:
Autor: APIYI Technik-Team
Technischer Austausch: Sie erreichen uns gerne über die Startseite der APIYI-Website; weitere Integrationsmaterialien finden Sie im Dokumentationszentrum unter docs.apiyi.com