作者注:用同一个 API Key 和 OpenAI 兼容入口完成大模型切换,并讲清图像、Embedding 跨模型集成时需要单独适配的字段、状态与验收条件。
本文用一个 API Key 和一个 OpenAI 兼容入口跑通纯文本模型切换,再通过图像和向量两个例子,说明跨模型集成中哪些字段、状态和验收条件需要单独适配。结论有前提:同一端点下只使用两款模型都支持的公共参数时,切换模型通常只需改 model 字段。一旦涉及专有思考参数、工具调用、图像尺寸或向量维度,就要按模型单独核对。
这不是一篇“改一行代码万事大吉”的宣传稿。我们会把 API易统一接口能复用的部分和必须重新验证的部分分开讲清楚,失败场景也会一并说明。
核心价值:读完本文,你能用同一套鉴权和代码切换文本模型,知道图像与 Embedding 换模型时要改哪些参数,并掌握一套可落地的切换验收方法。
API易统一接口切换大模型前要懂的 9 个术语
切换模型时出现的问题,多数是术语理解不一致导致的。例如把 Base URL 写成带两次 /v1,或者以为同维度的向量可以混用。先统一下面这组概念,后文所有步骤都建立在这些定义之上。
| 术语 | 实际含义 | 切换时的关注点 |
|---|---|---|
| Base URL | SDK 拼接接口路径时使用的根地址 | OpenAI SDK 填到 /v1 为止,避免重复拼接 |
| API Key | API 请求的鉴权凭证 | 只保存在服务端配置或环境变量中 |
| 模型 ID | 请求中指明的模型,可能包含版本或通道信息 | 从模型注册表复制原始 ID,不要手敲 |
| 令牌分组 | 决定当前 Key 可用的模型、通道及计费条件 | 模型不在分组内会返回 401/403 或 404 |
| Chat Completions | 基于消息数组进行文本对话的接口协议 | 纯文本切换的主要入口 |
| Responses | 支持多类输出和工具调用的接口协议 | GPT-6.2 的工具调用需走这里 |
| Embedding | 把内容编码为固定维度向量,用于检索等相似匹配 | 换模型等于换向量空间 |
| 向量索引 | 按特定维度与向量空间查找相似项的结构 | 维度或模型变化都要重建 |
| 首个可见 Token 时延 | 从发出请求到用户看到第一段有效生成内容的等待时间 | 推理模型的思考时间会拉长这一指标 |
其中“令牌分组”最容易被忽略。同一个账号下,不同分组的 Key 看到的模型清单可能不同,所以排查“模型不存在”时,应先确认 Key 所在分组,而不是先怀疑代码。
API易统一接口切换大模型核心要点
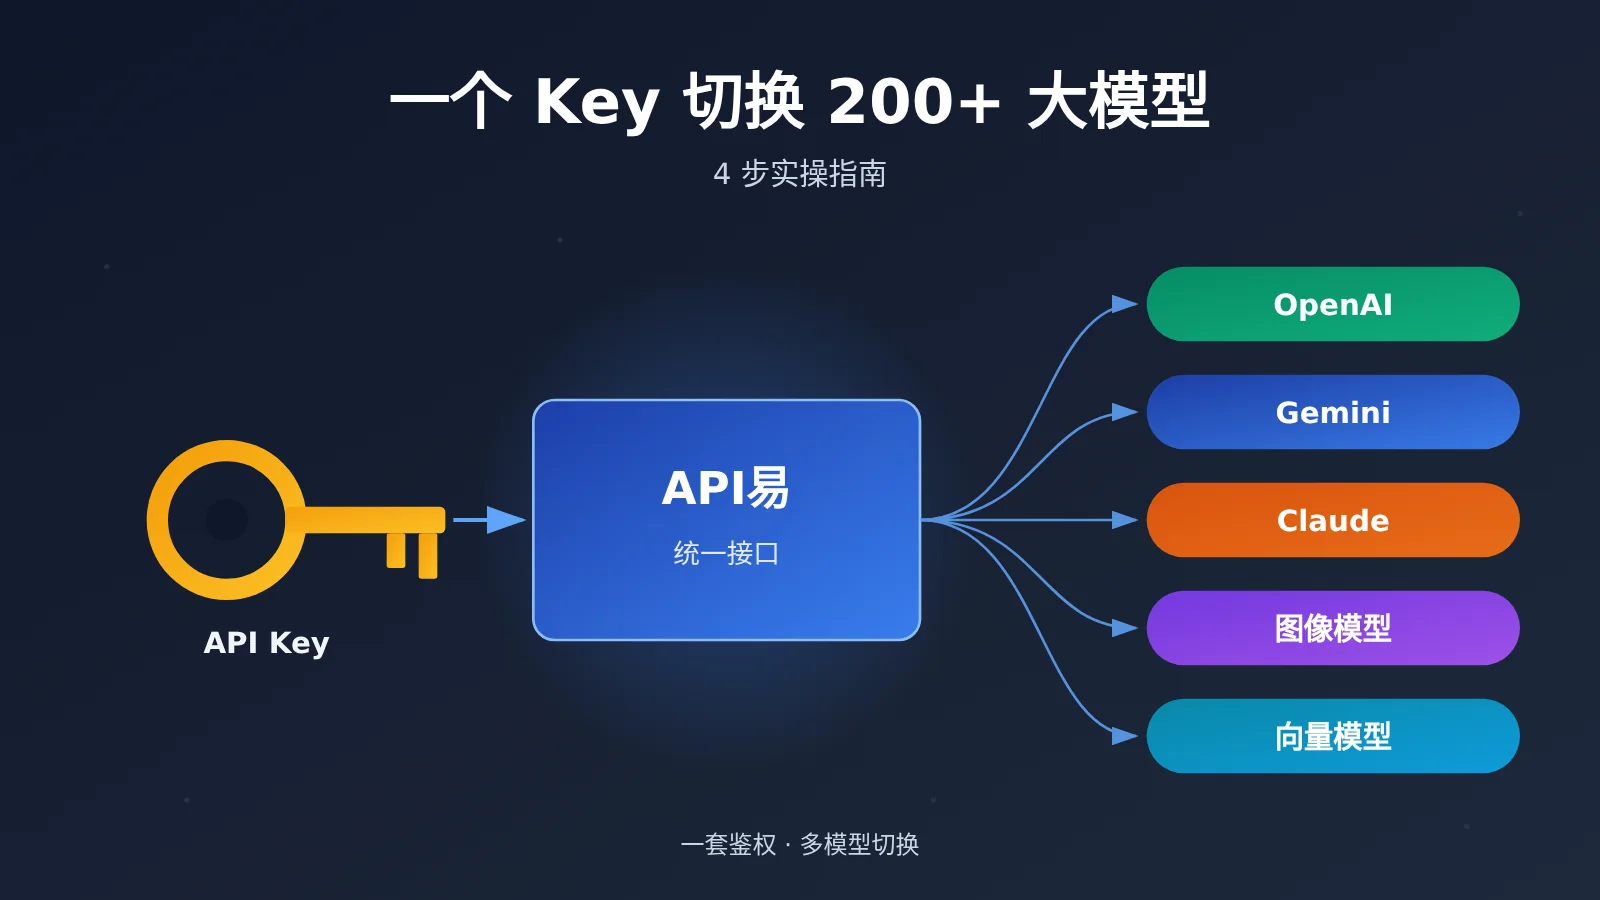
统一接入真正节省的是“重复劳动”:不必为每家厂商单独注册账号、管理多套密钥、适配多套 SDK。根据 API易 apiyi.com 的基本介绍和快速开始文档,一套鉴权配置加一个 OpenAI 兼容入口,就能访问不同厂商的可用模型。
| 层面 | 可以复用 | 需要按模型核对 |
|---|---|---|
| 鉴权 | 同一个 API Key、同一套请求头 | Key 所在令牌分组是否包含目标模型 |
| 入口 | 同一个 Base URL | 目标模型支持哪些端点(对话/Responses/图像/向量) |
| 请求体 | model、基础 messages、input 等公共字段 |
思考档位、工具、结构化输出、图像尺寸、向量维度 |
| 响应处理 | choices、finish_reason、usage 的解析逻辑 |
空正文、仅工具调用、安全过滤等特殊返回 |
| 计费 | 同一账户余额与账单 | 各模型单价、价档和缓存计费方式不同 |
200+ 与 289:API易模型数量的两种口径
API易公开介绍中的口径是接入 200+ 精选模型。而 2026-11-20 生成的公开模型注册表中,model_count 字段为 289。两个数字并不矛盾:注册表计数包含同一模型的不同版本和不同线路变体,因此条目数会多于“精选模型”数。
需要注意的是,单个令牌实际能调用的清单还受分组、模型授权和端点三重约束。注册表里存在某个 ID,不等于你手上的 Key 一定能调用它。
切换前的核对顺序
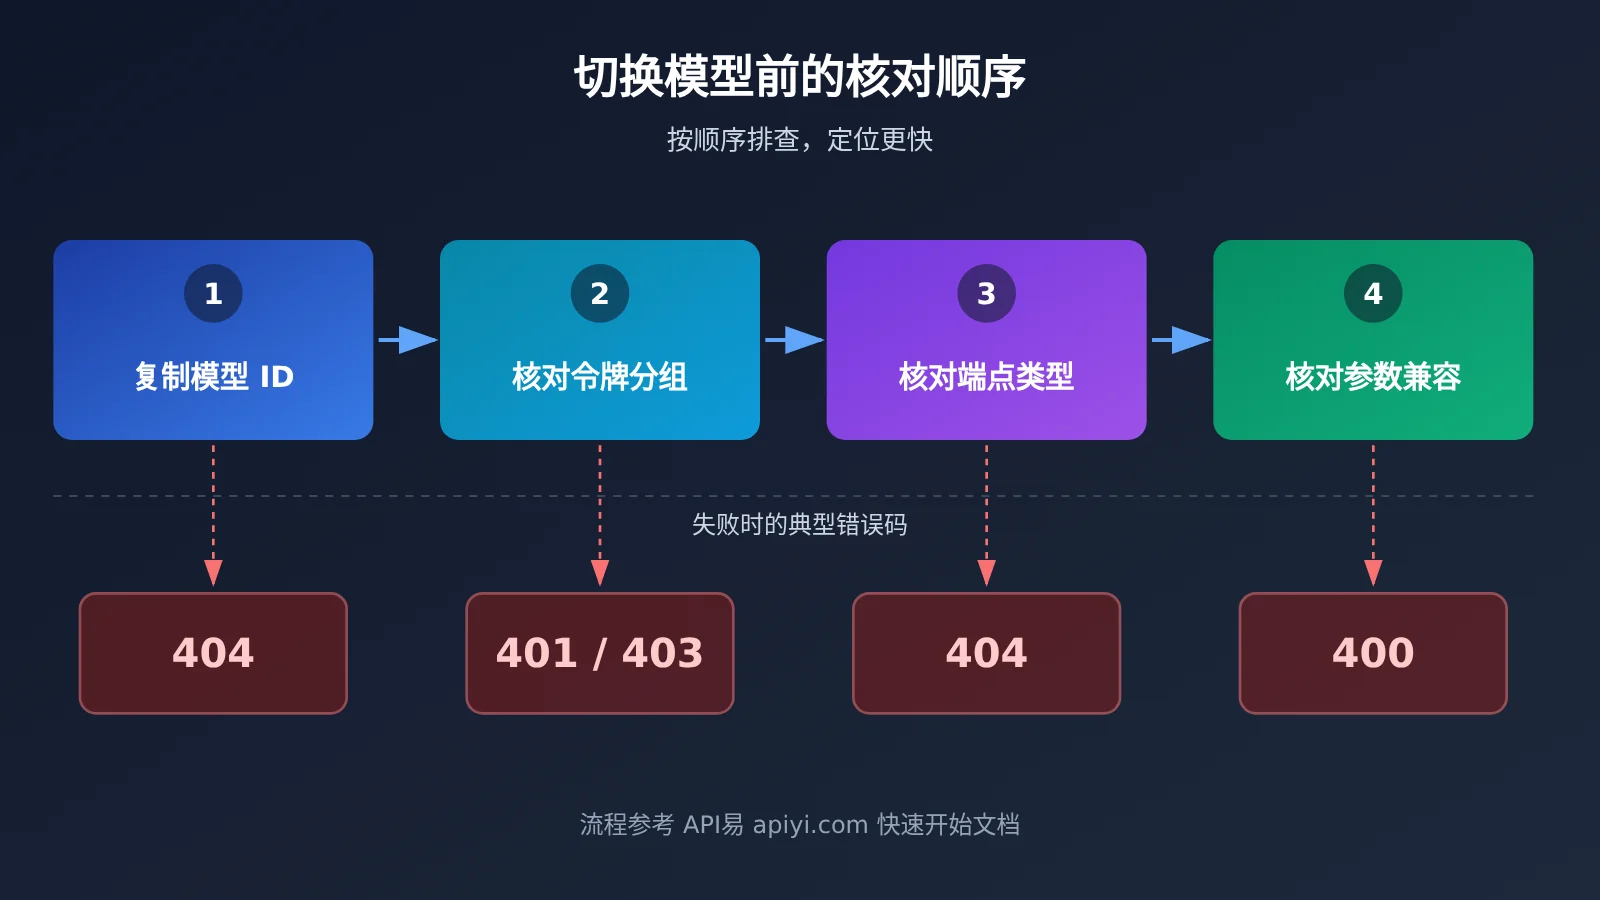
建议每次引入新模型时按固定顺序检查,避免出错后在多个方向同时排查:
- 核对模型 ID:从当天的模型注册表复制原始 ID,确认大小写与连字符完全一致。
- 核对令牌分组:确认当前 Key 所在分组开放了该模型,例如某些模型只在特定分组上线。
- 核对端点:确认该模型支持你要调用的接口类型,文本、图像、向量的端点各不相同。
- 核对参数:只保留两款模型都支持的公共参数,专有参数逐个加回验证。
如何用 API易统一接口快速切换文本大模型
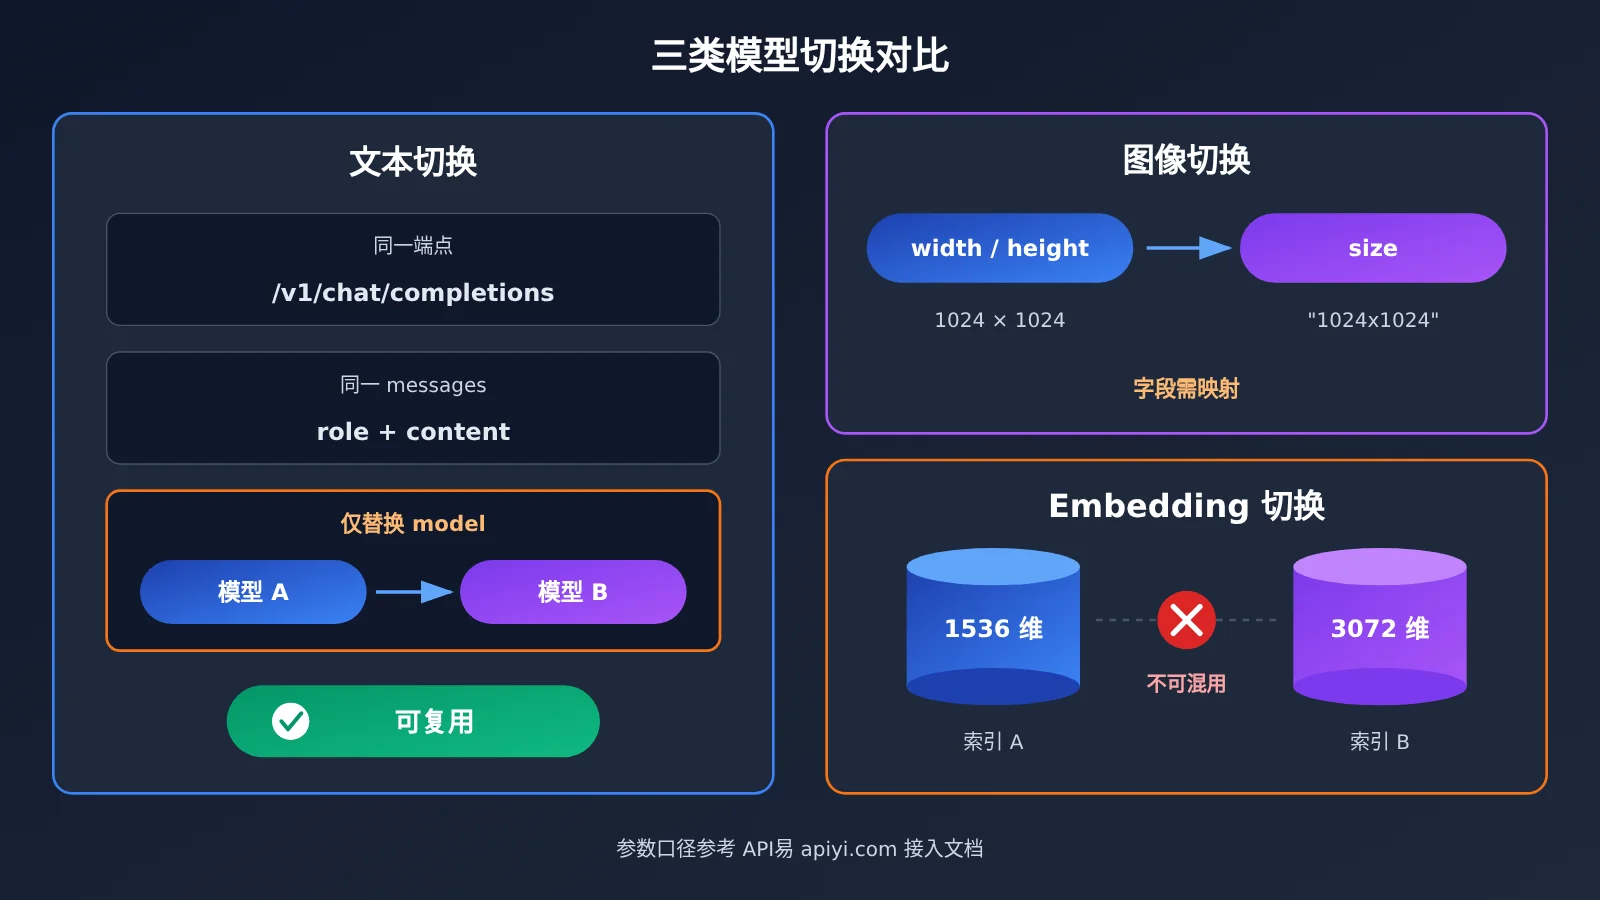
下面以两款通过 Chat Completions 访问的文本模型为例:gemini-4-neon 与 gpt-6.2-sol。两者都使用 POST /v1/chat/completions,在仅使用基础 messages 时,切换只需替换 model 字段。前提是你的 Key 分组能看到这两个模型,调用前请先在注册表中确认。
极简示例:同一段代码切换两个模型
把 Base URL 设为 https://api.apiyi.com/v1,API Key 从环境变量读取:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],     # 只放在服务端环境变量
    base_url="https://api.apiyi.com/v1",     # API易 OpenAI 兼容入口
)

for model in ["gemini-4-neon", "gpt-6.2-sol"]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是向量索引"}],
    )
    choice = resp.choices[0]
    print(model, "| finish_reason:", choice.finish_reason, "| usage:", resp.usage)
    print(choice.message.content or "<空正文>")
检查响应字段,不要只看 HTTP 200
拿到返回后,至少检查三个位置。choices[0].message.content 是否为空;finish_reason 是 stop 还是因长度截断等原因结束;usage 中的 token 用量是否合理。推理类模型的思考过程也会消耗输出预算,预算过小时可能出现“HTTP 200 但正文为空”的情况。
另外,回复正文里模型自称的名字不能作为核验后端型号的依据。需要确认实际调用的是哪个模型时,应优先查看请求 ID、响应元数据和计费日志。
查看完整实现代码:含流式首 Token 时延、退避重试与指标记录
import os
import time
import random
from openai import OpenAI, RateLimitError, APIStatusError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",   # API易统一接口
)

def call_once(model: str, prompt: str, max_retries: int = 3) -> dict:
    """流式调用一次,记录首个可见 token 时延、总耗时与完成原因"""
    for attempt in range(max_retries + 1):
        start = time.perf_counter()
        first_token_at = None
        parts, finish_reason, usage = [], None, None
        try:
            stream = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
                stream=True,
                stream_options={"include_usage": True},
            )
            for chunk in stream:
                if chunk.usage:
                    usage = chunk.usage
                if not chunk.choices:
                    continue
                delta = chunk.choices[0].delta
                if delta and delta.content:
                    if first_token_at is None:
                        first_token_at = time.perf_counter()
                    parts.append(delta.content)
                if chunk.choices[0].finish_reason:
                    finish_reason = chunk.choices[0].finish_reason
            end = time.perf_counter()
            return {
                "model": model,
                "ok": bool(parts),
                "ttft_s": round(first_token_at - start, 3) if first_token_at else None,
                "total_s": round(end - start, 3),
                "finish_reason": finish_reason,
                "usage": usage,
                "text": "".join(parts),
            }
        except RateLimitError:
            # 仅对短时限流做有限次数、带抖动的指数退避
            if attempt == max_retries:
                raise
            time.sleep((2 ** attempt) + random.uniform(0, 0.5))
        except APIStatusError as e:
            # 400/401/403/404 属于配置或参数问题,重试无意义
            return {"model": model, "ok": False, "status": e.status_code,
                    "error": str(e)[:300]}

if __name__ == "__main__":
    prompt = "用三句话说明向量索引为什么要和 Embedding 模型绑定"
    for m in ["gemini-4-neon", "gpt-6.2-sol"]:
        r = call_once(m, prompt)
        print({k: v for k, v in r.items() if k != "text"})
🚀 快速开始:建议先在 API易 apiyi.com 用新用户免费测试额度跑通上面的极简示例,确认两个模型 ID 都能在你的令牌分组下返回正文,再接入业务代码。
专有参数需要单独核对
上面的示例刻意只用了公共字段。一旦加入下列参数,就不能再假设“只改 model 就行”:
- GPT-6.2 系列:在 OpenAI API 中,
gpt-6.2-astra与gpt-6.2-sol同时支持 Chat Completions 和 Responses。Chat Completions 中思考档位字段为reasoning_effort,Responses 中为reasoning.effort;两款都会拒绝none这个取值。需要工具调用时要改走 Responses。 - Gemini 4 系列:
gemini-4-neon支持 API易的 Gemini 原生方案和 OpenAI 兼容对话。原生 REST 使用/v1beta/models/{id}:generateContent,思考档位写在generationConfig.thinkingConfig.thinkingLevel,可选low、medium、high、xhigh,默认high。旧版的thinkingBudget与minimal不适用于 Gemini 4;Google 文档还记录了 Gemini 4 会忽略temperature、topP。 - 结构化输出与工具:两边的 JSON Schema 约束和工具定义格式未必一致,需按目标模型文档逐项验证。
需要说明的是,API易的 Neon 上线说明提到上线时只核对了定价接口,并未做上线前实调。因此上述双端点与工具调用属于文档化行为,正式使用前请自行用最小请求验证。
API易统一接口跨能力切换:图像与 Embedding 对照
文本对话之外,图像和向量是最常见的跨模型场景,也是“只改 model”最容易失效的地方。下面两个例子分别对应“参数结构不同”和“结果空间不同”两类问题。
图像模型切换:MAI-Image-2.7 与 Seedream 5.5
两款模型都能用同一个 Key 的 Images 能力调用,但尺寸、参考图、透明输出的写法完全不同:
| 维度 | MAI-Image-2.7 | Seedream 5.5 |
|---|---|---|
| 端点 | 生成走 generations,编辑走 edits |
纯文本和参考图都走 generations |
| 尺寸参数 | width、height 控制总像素,公告上限 4,194,304 像素 |
size 选择价档,省略时按 2K 档 |
| 参考图 | 编辑最多 5 张参考图 | 参考图放在 image 字段 |
| 透明输出 | background: "transparent",返回带 alpha 的 PNG |
需同时指定 background: "transparent" 与 output_format: "png" |
| 计价 | 独立计价 | 按 size 价档独立计价 |
| 可用平台 | API易 apiyi.com(以注册表与分组为准) | API易(以注册表与分组为准) |
调用时建议为每个模型维护一个参数映射函数,而不是在业务层直接拼字段:
# 沿用前文的 client;模型 ID 请从当天注册表复制
def build_image_kwargs(model: str, prompt: str, transparent: bool = False) -> dict:
    if model.startswith("MAI-Image"):
        body = {"width": 1024, "height": 1024}
        if transparent:
            body["background"] = "transparent"
        return {"model": model, "prompt": prompt, "extra_body": body}
    # Seedream 5.5:size 决定价档,取值以接入文档为准
    body = {"size": "2K"}
    if transparent:
        body.update({"background": "transparent", "output_format": "png"})
    return {"model": model, "prompt": prompt, "extra_body": body}

img = client.images.generate(**build_image_kwargs("MAI-Image-2.7", "扁平风格的钥匙图标", True))
两款模型的透明图、参考图效果、响应格式和费用都要分别校验,不能用一款的验收结果代替另一款。
Embedding 模型切换:small 与 large 不能直接混用
向量化的调用形式确实统一:都走 POST /v1/embeddings,传 model 和 input 即可。
for m in ["text-embedding-3-small", "text-embedding-3-large"]:
    e = client.embeddings.create(model=m, input=["统一接口切换模型"])
    print(m, "维度:", len(e.data[0].embedding))   # 默认分别为 1536 与 3072
问题在于结果。text-embedding-3-small 默认 1536 维,text-embedding-3-large 默认 3072 维,维度不同的向量无法放进同一个索引。即使用 dimensions 参数把 large 缩减到 1536 维,两个模型的向量空间也不互通,旧文档向量和新查询向量之间的相似度没有意义。
因此切换 Embedding 模型的正确做法是:新建向量索引,重新向量化全部旧文档,查询侧同步切换模型,再用一批标注样本重新标定相似度阈值。这部分成本远大于改一行 model,在选型阶段就应计入。
如何验收 API易统一接口下的模型切换
切换上线前,需要把“能调通”升级为“可验收”。验收分两部分:错误码排查和指标对照。
错误码排查对照表
排查的前提是先固化一个最小请求,用同一 Key、同一节点、同一端点、同一模型 ID 稳定复现:
| 现象 | 常见原因 | 核对与修复 |
|---|---|---|
| 400 | 旧模型专属字段、工具参数、结构化输出或图片格式不兼容 | 去掉非必需字段,再逐个加回定位 |
| 401/403 | 令牌格式错误、分组不含该模型、模型不在白名单 | 核对 Key、令牌分组与模型白名单 |
| 404 | SDK 重复拼接 /v1,或模型不属于该接口类型 |
OpenAI SDK 的 Base URL 带 /v1;Google GenAI SDK 用不带 /v1 的根地址并配置 v1beta;复制原始模型 ID |
| 429 | 短时限流、并发超限或额度不足 | 先读错误体;短时限流用有限次数、带抖动的指数退避,额度问题修正后再发 |
| 200 但正文空 | 输出预算被思考占满、安全过滤、仅返回工具调用 | 检查完成原因和返回类型,加大输出预算;用最短无工具请求做对照 |
对 Gemini 4 的多轮工具流程,还要检查是否原样回传了响应中的 thoughtSignature,以及工具调用与工具结果是否一一对应。
记录指标,区分模型差异与渠道开销
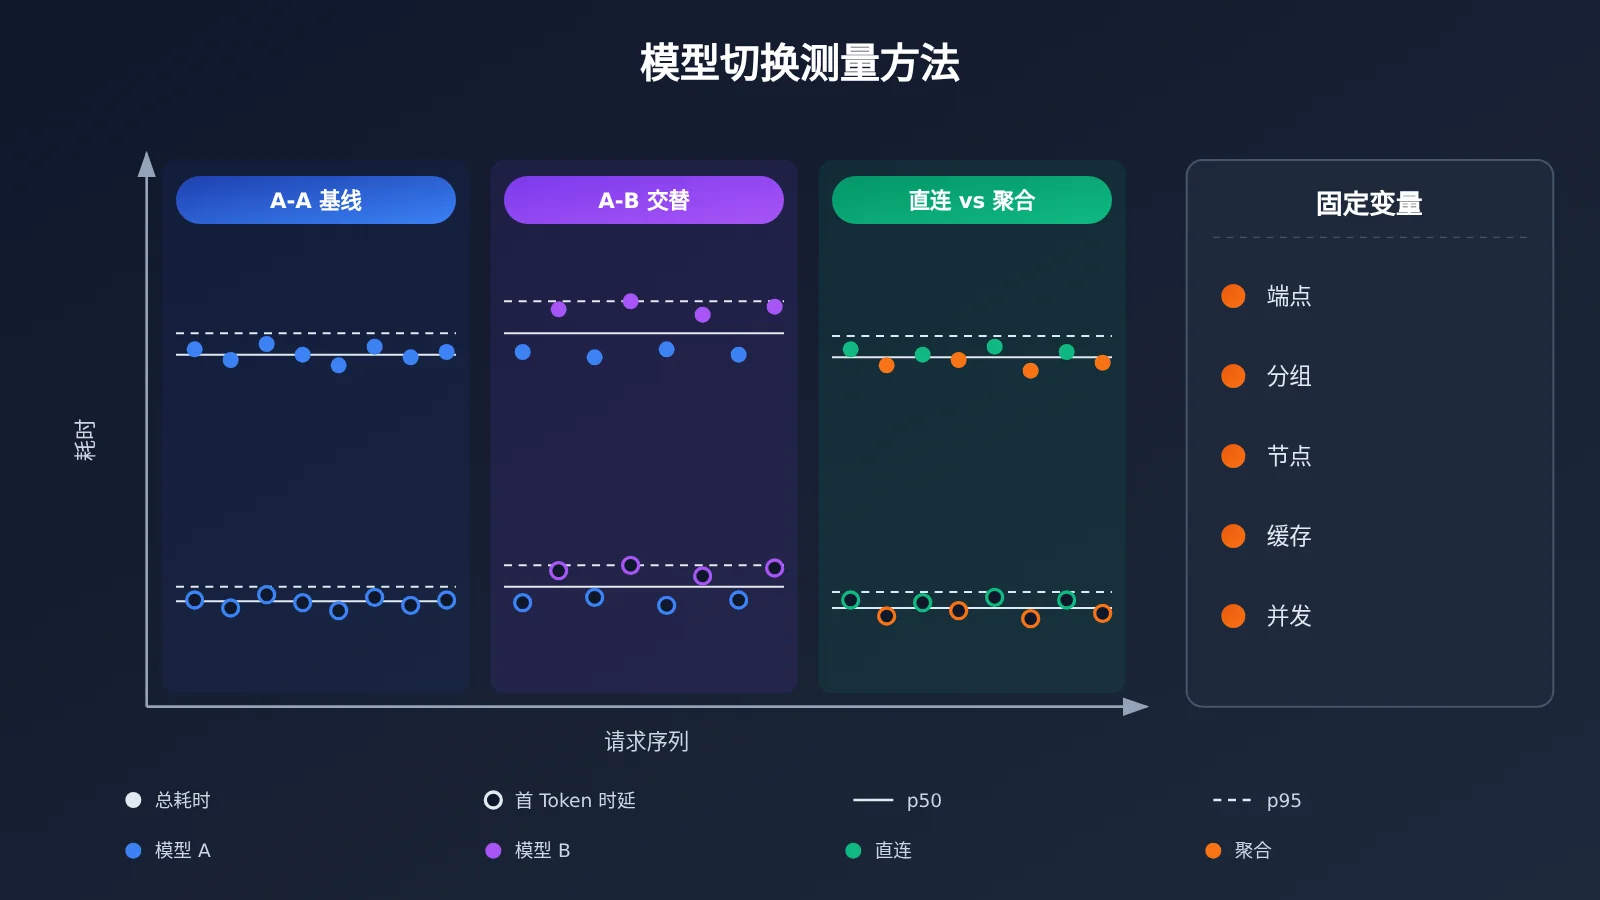
目前公开资料中,还没有在同一 Key、同一分组、同一区域、相同输入与负载下,能单独隔离“更换模型”或“网关转发”所引入损耗的成组数据。第三方基准可以比较不同模型或不同提供方,但不能把差值直接归因于在 API易 上换了模型。所以与其引用别人的数字,不如自己按下面的方法测:
| 指标 | 记录方式 | 用途 |
|---|---|---|
| 完成原因 | 统计每次的 finish_reason 分布 |
发现截断、过滤、工具中断 |
| 首个可见 Token 时延 | 流式请求中第一段非空内容的时间 | 衡量用户等待体验 |
| 总耗时 p50/p95 | 每次完整请求的耗时分位数 | 衡量稳定性与长尾 |
| 失败率 | 按错误码分类计数 | 区分配置错误与临时故障 |
| 实际 token 与扣费 | usage 字段与账单逐条对照 |
核算真实成本 |
| 业务验收通过率 | 用固定样本人工或规则评分 | 判断质量是否达标 |
测量步骤建议这样安排:先固定端点、分组、节点和请求参数;用 A-A 同模型重复请求建立基线;再交替执行 A-B 单项换模型;如需评估渠道开销,单独对同一模型做直连与聚合渠道的比较。同时控制缓存冷暖、输出上限和并发数,否则模型速度、缓存未命中和渠道开销会混在一起无法区分。
有状态工具流程的额外风险
如果使用 Responses 做多轮工具调用,中途换模型还会带来状态问题。OpenAI 的 GPT-6.2 迁移文档说明,会话中途切换到部分模型(包括降级)可能导致原有推理项被移除,恢复上下文时模型可能需要重新推理。这意味着不能承诺切换后“无状态损失”,费用变化也没有固定比例。
验收这类流程时,要检查历史项和上下文能否被新模型正确复用,并把“同一会话中途换模型”单独列为测试用例。
常见问题 FAQ
Q1:什么是 API易统一接口?
它是一个 OpenAI 兼容的 API 入口:用一个 API Key 和同一个 Base URL,即可调用 OpenAI、Claude、Gemini 等不同厂商的模型。你不需要为每家厂商分别注册账号和维护密钥,换模型时主要修改请求中的 `model` 字段,并按模型核对专有参数。
Q2:统一接口切换模型和分别对接各家官方 SDK 有什么区别?
官方 SDK 在专有能力上覆盖最完整,但多家并用时要维护多套鉴权、SDK 和计费账户。统一接口把鉴权、入口和账单合并为一套,公共参数场景下切换成本很低。代价是专有参数需要逐个确认兼容性,例如 Gemini 原生思考字段在兼容接口上的映射需要单独验收。
Q3:文中提到的模型何时在 API易 上线?
按 API易 实时动态归档:GPT-6.2 Astra 与 Sol 于 2026-11-18 上线并在三个分组开放;Gemini 4 Neon 由 Google 于 11 月 18 日公布,API易 于 11 月 20 日在 `default`/`svip` 分组接入;Seedream 5.5 于 11 月 13 日上线。模型清单变化较快,请以当天注册表为准。
Q4:哪些场景最适合用统一接口切换模型?
– **多模型 A/B 对比**:同一提示词在不同模型间比较效果与成本。
– **故障兜底**:某个模型或线路资源紧张时切换到备选模型。
– **按任务分流**:简单问答用经济模型,复杂推理用旗舰模型。
– **图像多风格生成**:在多款图像模型间按需求选择,注意参数映射。
Q5:如何最快开始用统一接口调用多个模型?
1. 访问 API易 apiyi.com 注册账号,新用户可获得免费测试额度。
2. 创建 API Key,确认所在令牌分组包含目标模型。
3. 运行本文极简示例,按注册表替换 `model` 字段验证。
按量计费的方式便于在小流量下先对比多个模型,再决定主力方案。
Q6:gemini-4-neon 的价格和上下文是多少?
根据 API易 2026-11-20 生成的模型注册表,`gemini-4-neon` 每百万 token 输入 $3、输出 $15、缓存读取 $0.15,API易 动态中标注与官方同价,实际扣费以账户账单为准。Artificial Analysis 与 Google 公告均标为 1M 上下文,这是输入、思考与输出共享的窗口;API易 上线文档列出的同步生成上限约 64K。
Q7:统一接口切换有哪些已知限制?
– **专有参数不通用**:思考档位、工具调用、结构化输出需按模型核对。
– **向量不可混用**:换 Embedding 模型必须重新向量化并重建索引。
– **有状态流程有损失**:Responses 中途换模型可能丢失推理项。
– **可见范围受限**:模型清单受令牌分组、授权与端点约束,遇到问题可查阅 API易 apiyi.com 的错误码排查文档。
API易统一接口切换大模型 Key Takeaways
- 只改 model 有前提:同一端点、仅用双方都支持的公共参数时才成立。
- 两种数量口径:200+ 是精选模型口径,注册表 289 条含版本与线路变体。
- 核对有顺序:模型 ID → 令牌分组 → 端点 → 参数,逐项排除。
- 图像参数需映射:MAI 用
width/height,Seedream 用size,透明写法不同。 - 向量换模必重建:small 与 large 默认维度不同,同维度也不互通。
- HTTP 200 不等于成功:要检查完成原因、空正文与仅工具调用的返回。
- 性能要自己测:用 A-A 基线加 A-B 交替测量,可在 API易 apiyi.com 用同一 Key 完成对照。
总结
用 API易统一接口切换大模型的核心要点:
- 复用鉴权与入口:一个 Key、一个 Base URL 覆盖文本、图像、向量等多类能力。
- 区分公共与专有参数:公共参数直接切换,专有参数逐项验证后再加入。
- 把切换变成可验收操作:用错误码对照表排查,用固定方法记录时延、失败率与扣费。
建议先用最短的纯文本请求跑通两个模型,再按“图像参数映射”“向量重建索引”“有状态工具流程”的顺序逐步扩展到业务场景。推荐通过 API易 apiyi.com 的免费测试额度先完成上述验证,再决定主力模型和兜底方案。
📚 参考资料
-
API易 文档中心:基本介绍、快速开始、模型注册表、文本向量化、模型版本说明
- 链接:
docs.apiyi.com - 说明: 模型 ID、分组、端点与计价的一手口径,注册表请以当天生成版本为准
- 链接:
-
OpenAI Using GPT-6.2:GPT-6.2 迁移与参数说明
- 链接:
developers.openai.com/api/docs/guides/latest-model - 说明: Responses 工具调用、思考档位字段与推理项生命周期
- 链接:
-
Google Gemini API 排障与思维签名文档:Gemini 4 调用问题排查
- 链接:
aistudio.google.com/docs/troubleshooting - 说明: 思考档位、
thoughtSignature回传与常见报错
- 链接:
-
Google Cloud Gemini 4 入门:Gemini 4 长解码与接口版本说明
- 链接:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/start/get-started-with-gemini-4 - 说明: 了解长解码的接口版本与续传条件
- 链接:
-
Artificial Analysis 模型比较页:第三方模型基准与延迟测量方法
- 链接:
artificialanalysis.ai/models/comparisons/gemini-4-neon-vs-gpt-6-2-sol - 说明: 用于模型间横向参考,不能用于归因渠道开销
- 链接:
作者:API易 技术团队
技术交流:欢迎在 API易 网站首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心