Catatan penulis: menggunakan satu API Key dan satu titik masuk kompatibel OpenAI untuk menyelesaikan pergantian Model Bahasa Besar, sekaligus membedah field, status, dan kriteria penerimaan mana saja yang perlu disesuaikan secara terpisah saat integrasi lintas model untuk gambar dan Embedding.
Artikel ini menunjukkan cara menjalankan pergantian model teks murni dengan satu API Key dan satu titik masuk kompatibel OpenAI, lalu melalui dua contoh—gambar dan vektor—menjelaskan field, status, dan kriteria penerimaan mana saja dalam integrasi lintas model yang butuh penyesuaian terpisah. Kesimpulannya punya prasyarat: selama di endpoint yang sama hanya menggunakan parameter umum yang didukung kedua model, pergantian model biasanya cukup dengan mengubah field model. Namun begitu melibatkan parameter thinking proprietary, tool calling, ukuran gambar, atau dimensi vektor, semuanya harus diverifikasi ulang per model.
Ini bukan artikel promosi semacam “ubah satu baris kode, semua langsung beres”. Kami akan memisahkan dengan jelas antara bagian yang bisa dipakai ulang dari antarmuka terpadu APIYI dan bagian yang wajib diverifikasi ulang, termasuk pembahasan skenario kegagalan yang mungkin terjadi.
Nilai inti: Setelah membaca artikel ini, kamu bisa mengganti model teks dengan satu set autentikasi dan kode yang sama, tahu parameter mana saja yang perlu diubah saat mengganti model untuk gambar dan Embedding, serta menguasai metode uji penerimaan pergantian model yang bisa langsung dipraktikkan.
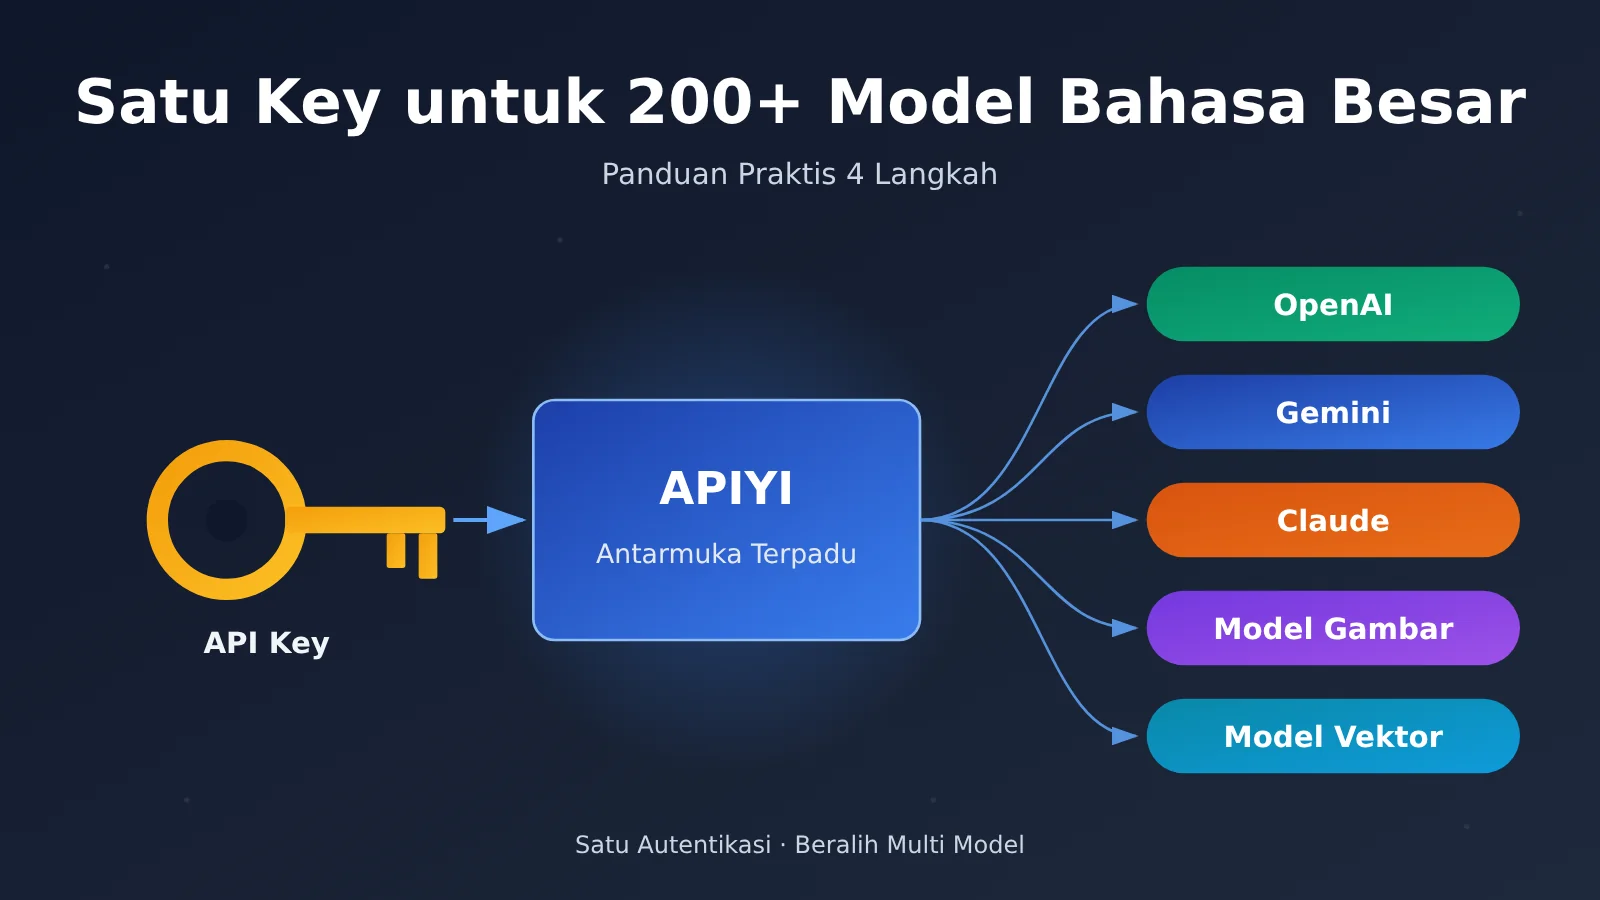
9 Istilah yang Perlu Dipahami Sebelum Berganti Model Bahasa Besar lewat Antarmuka Terpadu APIYI
Masalah yang muncul saat berganti model sebagian besar disebabkan oleh perbedaan pemahaman istilah. Misalnya, Base URL ditulis sehingga /v1 tergabung dua kali, atau mengira vektor berdimensi sama bisa dipakai silang. Sinkronkan dulu pemahaman atas konsep-konsep di bawah ini, karena semua langkah pada bagian selanjutnya dibangun di atas definisi-definisi ini.
| Istilah | Makna Sebenarnya | Hal yang Perlu Diperhatikan Saat Berganti |
|---|---|---|
| Base URL | Alamat dasar yang dipakai SDK untuk merangkai jalur API | Pada OpenAI SDK, isi sampai /v1 saja, hindari penggabungan ganda |
| API Key | Kredensial autentikasi untuk permintaan API | Simpan hanya di konfigurasi sisi server atau variabel lingkungan (environment variable) |
| ID Model | Model yang ditentukan dalam permintaan, bisa memuat info versi atau kanal | Salin ID asli dari registri model, jangan ketik manual |
| Grup Token | Menentukan model, kanal, serta ketentuan penagihan yang tersedia untuk Key saat ini | Model yang tidak berada dalam grup akan mengembalikan 401/403 atau 404 |
| Chat Completions | Protokol API untuk percakapan teks berbasis array pesan | Pintu masuk utama untuk kasus teks murni |
| Responses | Protokol API yang mendukung beragam jenis keluaran dan pemanggilan tool | Pemanggilan tool GPT-6.2 harus melalui protokol ini |
| Embedding | Mengodekan konten menjadi vektor berdimensi tetap, dipakai untuk pencarian dan pencocokan kemiripan | Ganti model sama artinya dengan ganti ruang vektor |
| Indeks Vektor | Struktur untuk mencari item serupa berdasarkan dimensi dan ruang vektor tertentu | Harus dibangun ulang setiap kali dimensi atau model berubah |
| Latensi Token Pertama yang Terlihat | Waktu tunggu sejak permintaan dikirim hingga pengguna melihat potongan konten hasil generasi pertama yang valid | Waktu “berpikir” model penalaran akan memperpanjang metrik ini |
Dari semuanya, “Grup Token” adalah yang paling sering diabaikan. Dalam satu akun yang sama, Key di grup berbeda bisa melihat daftar model yang berbeda pula. Jadi saat menelusuri error “model tidak ditemukan”, konfirmasi dulu grup tempat Key itu berada, jangan buru-buru mencurigai kode.
Poin-Poin Inti Beralih Model Bahasa Besar Lewat Antarmuka Terpadu APIYI
Akses terpadu sebenarnya menghemat “pekerjaan berulang”: kamu tidak perlu mendaftar akun terpisah untuk tiap vendor, mengelola banyak set kunci API, atau menyesuaikan banyak SDK. Berdasarkan pengantar dasar dan dokumentasi memulai cepat dari APIYI apiyi.com, cukup satu konfigurasi autentikasi plus satu titik akses kompatibel OpenAI untuk mengakses model yang tersedia dari berbagai vendor.
| Aspek | Bisa dipakai ulang | Perlu dicek per model |
|---|---|---|
| Autentikasi | Kunci API yang sama, set header permintaan yang sama | Apakah grup token tempat Key berada mencakup model tujuan |
| Titik akses | Base URL yang sama | Endpoint apa saja yang didukung model tujuan (chat/Responses/gambar/vektor) |
| Body permintaan | Field umum seperti model, messages dasar, input |
Tingkat penalaran, tools, output terstruktur, ukuran gambar, dimensi vektor |
| Penanganan respons | Logika parsing choices, finish_reason, usage |
Respons khusus seperti body kosong, hanya tool call, filter keamanan, dll. |
| Penagihan | Saldo dan tagihan akun yang sama | Harga satuan tiap model, tingkatan harga, dan cara penagihan cache berbeda-beda |
200+ dan 289: Dua Versi Angka Jumlah Model APIYI
Dalam pengantar publik APIYI, angka yang disebut adalah 200+ model pilihan. Sementara dalam registri model publik yang dibuat pada 2026-11-20, field model_count berisi angka 289. Kedua angka ini tidak saling bertentangan: hitungan registri mencakup berbagai versi dan varian jalur dari model yang sama, sehingga jumlah entrinya lebih banyak daripada jumlah “model pilihan”.
Perlu diingat, daftar model yang benar-benar bisa dipanggil oleh satu token tetap terkendala tiga hal sekaligus: grup, otorisasi model, dan endpoint. Adanya sebuah ID di registri tidak berarti Key di tanganmu pasti bisa memanggilnya.
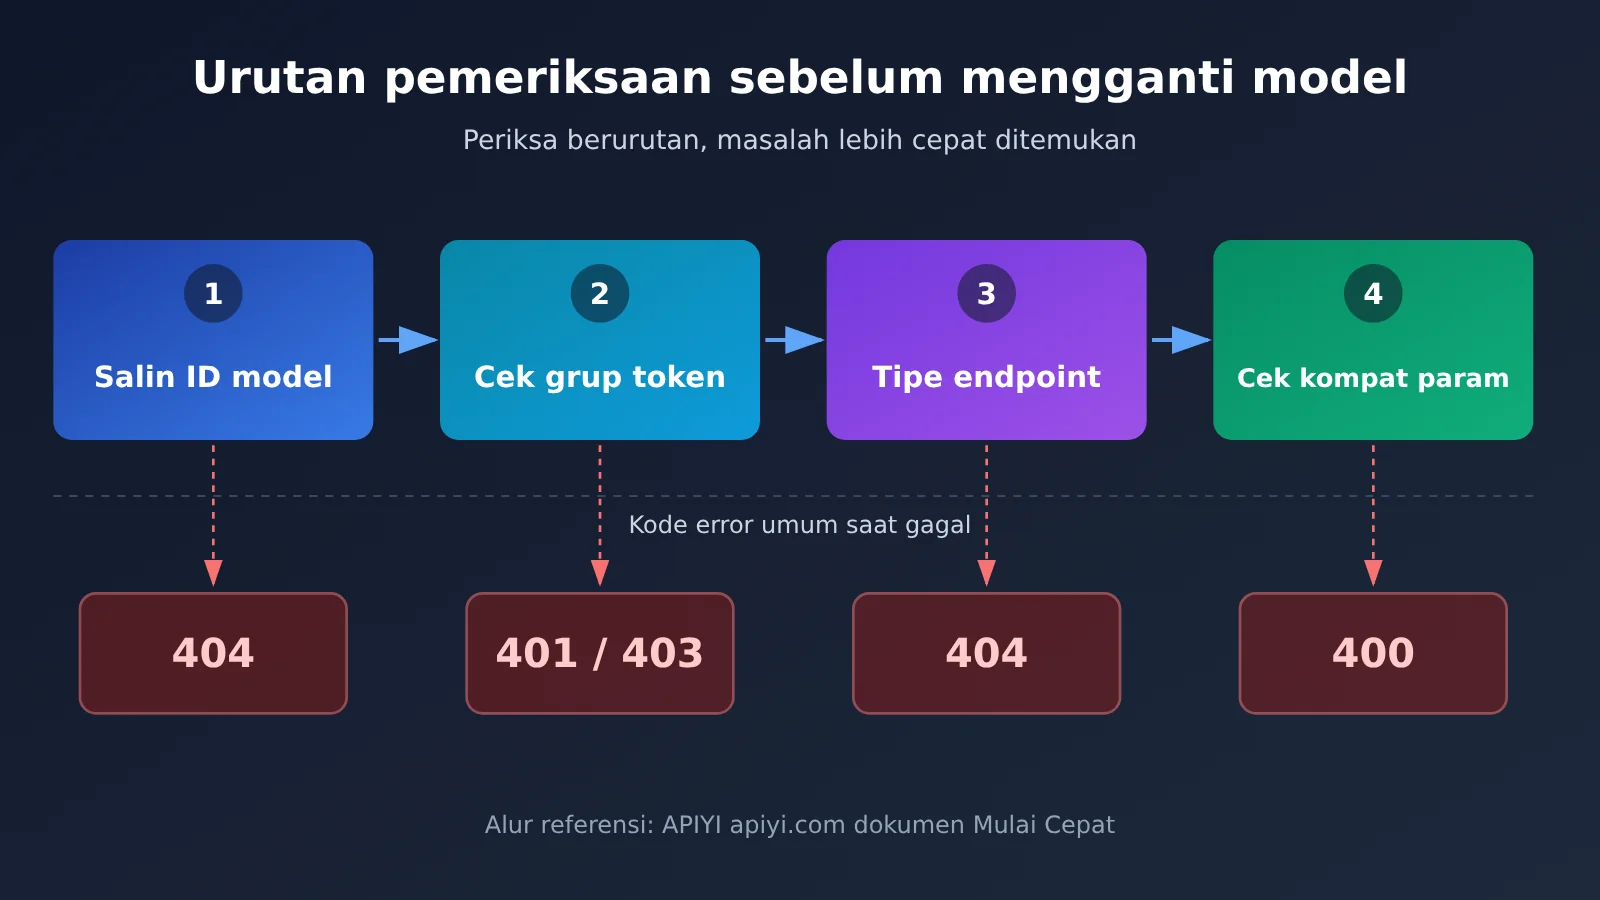
Urutan Pengecekan Sebelum Beralih Model
Sebaiknya setiap kali menambahkan model baru, lakukan pengecekan sesuai urutan yang tetap supaya kalau terjadi error, kamu tidak perlu menyelidiki banyak arah sekaligus:
- Cek ID model: Salin ID aslinya dari registri model hari itu, pastikan huruf besar/kecil dan tanda hubung sama persis.
- Cek grup token: Pastikan grup tempat Key saat ini berada sudah membuka model tersebut, misalnya ada model yang hanya tersedia di grup tertentu.
- Cek endpoint: Pastikan model tersebut mendukung jenis API yang mau kamu panggil, karena endpoint teks, gambar, dan vektor berbeda-beda.
- Cek parameter: Pertahankan hanya parameter umum yang didukung kedua model, lalu tambahkan kembali parameter khusus satu per satu untuk diverifikasi.
Cara Cepat Ganti Model Bahasa Besar Teks Lewat Antarmuka Terpadu APIYI
Berikut ini kita ambil dua model teks yang diakses melalui Chat Completions sebagai contoh: gemini-4-neon dan gpt-6.2-sol. Keduanya memakai endpoint POST /v1/chat/completions, dan selama hanya menggunakan messages dasar, pergantian model cukup dilakukan dengan mengganti field model. Syaratnya, grup kunci API kamu harus bisa melihat kedua model ini—jadi pastikan dulu di daftar model (registry) sebelum melakukan pemanggilan.
Contoh sesederhana mungkin: kode yang sama untuk dua model
Atur Base URL ke https://api.apiyi.com/v1, dan baca kunci API dari environment variable:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],     # simpan hanya di environment variable sisi server
    base_url="https://api.apiyi.com/v1",     # endpoint kompatibel OpenAI dari APIYI
)

for model in ["gemini-4-neon", "gpt-6.2-sol"]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是向量索引"}],
    )
    choice = resp.choices[0]
    print(model, "| finish_reason:", choice.finish_reason, "| usage:", resp.usage)
    print(choice.message.content or "<空正文>")
Cek Field Respons, Jangan Berhenti di HTTP 200 Saja
Setelah respons diterima, periksa setidaknya tiga titik: apakah choices[0].message.content kosong; apakah finish_reason bernilai stop atau justru berhenti karena alasan lain seperti pemotongan panjang; dan apakah penggunaan token pada usage masih wajar. Proses “berpikir” model reasoning juga mengonsumsi anggaran output — kalau anggarannya terlalu kecil, bisa muncul kondisi “HTTP 200 tapi isi respons kosong”.
Selain itu, nama yang diklaim model di dalam isi balasan tidak bisa dijadikan dasar untuk memverifikasi model di backend. Kalau perlu memastikan model mana yang benar-benar dipanggil, utamakan pemeriksaan request ID, metadata respons, dan log penagihan.
Lihat kode implementasi lengkap: termasuk latensi token pertama saat streaming, retry dengan backoff, dan pencatatan metrik
import os
import time
import random
from openai import OpenAI, RateLimitError, APIStatusError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",   # Antarmuka terpadu APIYI
)

def call_once(model: str, prompt: str, max_retries: int = 3) -> dict:
    """Satu kali pemanggilan streaming, catat latensi token pertama yang terlihat, total durasi, dan alasan penyelesaian"""
    for attempt in range(max_retries + 1):
        start = time.perf_counter()
        first_token_at = None
        parts, finish_reason, usage = [], None, None
        try:
            stream = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
                stream=True,
                stream_options={"include_usage": True},
            )
            for chunk in stream:
                if chunk.usage:
                    usage = chunk.usage
                if not chunk.choices:
                    continue
                delta = chunk.choices[0].delta
                if delta and delta.content:
                    if first_token_at is None:
                        first_token_at = time.perf_counter()
                    parts.append(delta.content)
                if chunk.choices[0].finish_reason:
                    finish_reason = chunk.choices[0].finish_reason
            end = time.perf_counter()
            return {
                "model": model,
                "ok": bool(parts),
                "ttft_s": round(first_token_at - start, 3) if first_token_at else None,
                "total_s": round(end - start, 3),
                "finish_reason": finish_reason,
                "usage": usage,
                "text": "".join(parts),
            }
        except RateLimitError:
            # Exponential backoff dengan jitter, hanya untuk rate limit sementara dan dengan jumlah percobaan terbatas
            if attempt == max_retries:
                raise
            time.sleep((2 ** attempt) + random.uniform(0, 0.5))
        except APIStatusError as e:
            # 400/401/403/404 berarti ada masalah di konfigurasi atau parameter, mencoba ulang tidak berguna
            return {"model": model, "ok": False, "status": e.status_code,
                    "error": str(e)[:300]}

if __name__ == "__main__":
    prompt = "用三句话说明向量索引为什么要和 Embedding 模型绑定"
    for m in ["gemini-4-neon", "gpt-6.2-sol"]:
        r = call_once(m, prompt)
        print({k: v for k, v in r.items() if k != "text"})
🚀 Mulai Cepat: Sebaiknya jalankan dulu contoh minimal di atas di APIYI apiyi.com memakai kuota uji coba gratis pengguna baru, pastikan kedua ID model bisa mengembalikan isi respons di bawah grup token kamu, baru kemudian integrasikan ke kode bisnis.
Parameter Propietari Perlu Diverifikasi Secara Terpisah
Contoh di atas sengaja hanya memakai field publik. Begitu parameter-parameter berikut disertakan, Anda tidak bisa lagi berasumsi bahwa “cukup ganti model saja”:
- Seri GPT-6.2: Di OpenAI API,
gpt-6.2-astradangpt-6.2-solsama-sama mendukung Chat Completions maupun Responses. Pada Chat Completions, field tingkat reasoning-nya bernamareasoning_effort, sedangkan di Responses menjadireasoning.effort; kedua model sama-sama menolak nilainone. Kalau butuh pemanggilan tool (tool calling), Anda wajib beralih ke Responses. - Seri Gemini 4:
gemini-4-neonmendukung solusi native Gemini dari APIYI sekaligus endpoint chat yang kompatibel dengan OpenAI. REST native-nya memakai/v1beta/models/{id}:generateContent, dengan tingkat reasoning ditulis digenerationConfig.thinkingConfig.thinkingLevel, pilihannyalow,medium,high, danxhigh, serta default-nyahigh. Field versi lama sepertithinkingBudgetbeserta nilaiminimaltidak berlaku untuk Gemini 4; dokumentasi Google juga mencatat bahwa Gemini 4 akan mengabaikantemperaturedantopP. - Structured output dan tool: Batasan JSON Schema serta format definisi tool di kedua sisi belum tentu identik, jadi masing-masing perlu diverifikasi mengikuti dokumentasi model tujuan.
Perlu dicatat, pengumuman rilis Neon dari APIYI menyebutkan bahwa saat peluncuran hanya endpoint harga yang diverifikasi, tanpa ada uji pemanggilan nyata sebelum rilis. Jadi, dukungan dua endpoint dan tool calling di atas masih sebatas yang tertulis di dokumentasi; sebelum dipakai secara resmi, sebaiknya verifikasi sendiri dengan request seminimal mungkin.
Pergantian Lintas Kemampuan melalui Antarmuka Terpadu APIYI: Perbandingan Gambar dan Embedding
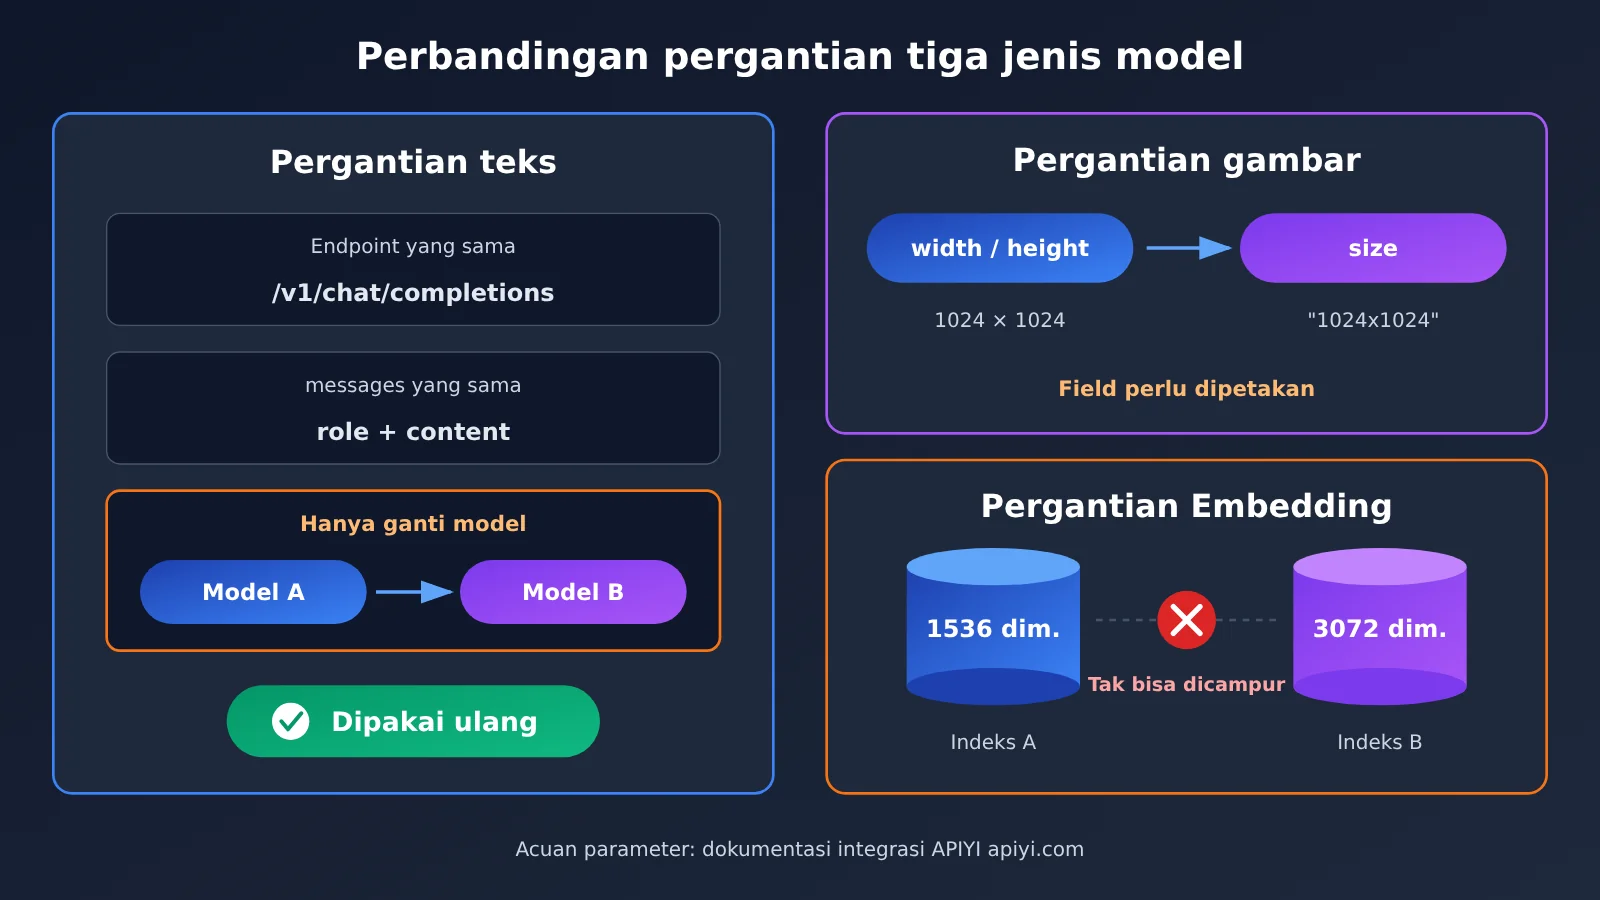
Di luar percakapan teks, gambar dan vektor adalah dua skenario lintas model yang paling umum, sekaligus titik di mana pendekatan “cukup ganti model” paling sering gagal. Dua contoh di bawah ini masing-masing mewakili dua jenis masalah: “struktur parameter berbeda” dan “ruang hasil berbeda”.
Pergantian Model Gambar: MAI-Image-2.7 vs Seedream 5.5
Kedua model bisa dipanggil melalui kemampuan Images dengan kunci API yang sama, tetapi cara menulis ukuran, gambar referensi, dan output transparan benar-benar berbeda:
| Dimensi | MAI-Image-2.7 | Seedream 5.5 |
|---|---|---|
| Endpoint | Pembuatan gambar melalui generations, pengeditan melalui edits |
Teks murni maupun gambar referensi sama-sama melalui generations |
| Parameter ukuran | width dan height mengontrol total piksel, batas atas sesuai pengumuman: 4.194.304 piksel |
size memilih tier harga; jika dihilangkan otomatis mengikuti tier 2K |
| Gambar referensi | Pengeditan menerima maksimal 5 gambar referensi | Gambar referensi diletakkan di kolom image |
| Output transparan | background: "transparent", mengembalikan PNG dengan alpha |
Harus menentukan background: "transparent" sekaligus output_format: "png" |
| Penetapan harga | Dihitung terpisah | Dihitung terpisah berdasarkan tier harga size |
| Platform tersedia | APIYI apiyi.com (mengacu pada registry dan pengelompokan yang berlaku) | APIYI (mengacu pada registry dan pengelompokan yang berlaku) |
Saat melakukan pemanggilan model, sebaiknya siapkan satu fungsi pemetaan parameter untuk setiap model, alih-alih merakit field secara langsung di lapisan bisnis:
# Masih memakai client dari bagian sebelumnya; ID model mohon disalin dari registry hari itu
def build_image_kwargs(model: str, prompt: str, transparent: bool = False) -> dict:
    if model.startswith("MAI-Image"):
        body = {"width": 1024, "height": 1024}
        if transparent:
            body["background"] = "transparent"
        return {"model": model, "prompt": prompt, "extra_body": body}
    # Seedream 5.5: size menentukan tier harga; nilainya mengikuti dokumentasi integrasi
    body = {"size": "2K"}
    if transparent:
        body.update({"background": "transparent", "output_format": "png"})
    return {"model": model, "prompt": prompt, "extra_body": body}

img = client.images.generate(**build_image_kwargs("MAI-Image-2.7", "扁平风格的钥匙图标", True))
Gambar transparan, efek gambar referensi, format respons, dan biaya kedua model harus diverifikasi satu per satu; hasil validasi dari satu model tidak bisa dipakai sebagai pengganti model lainnya.
Penggantian Model Embedding: small dan large Tidak Bisa Dicampur Langsung
Bentuk pemanggilan vektorisasinya memang sudah seragam: sama-sama lewat POST /v1/embeddings, cukup kirimkan model dan input.
for m in ["text-embedding-3-small", "text-embedding-3-large"]:
    e = client.embeddings.create(model=m, input=["统一接口切换模型"])
    print(m, "维度:", len(e.data[0].embedding))   # default masing-masing 1536 dan 3072
Masalahnya ada di hasilnya. text-embedding-3-small secara default menghasilkan vektor 1536 dimensi, sedangkan text-embedding-3-large 3072 dimensi. Vektor dengan dimensi berbeda tidak bisa dimasukkan ke dalam indeks yang sama. Bahkan jika parameter dimensions dipakai untuk memperkecil large menjadi 1536 dimensi, ruang vektor kedua model tetap tidak saling terhubung, sehingga skor similarity antara vektor dokumen lama dan vektor kueri baru menjadi tidak bermakna.
Karena itu, cara yang benar untuk mengganti model Embedding adalah: buat indeks vektor baru, vektorisasi ulang seluruh dokumen lama, ganti model di sisi kueri secara serentak, lalu kalibrasi ulang ambang batas similarity menggunakan kumpulan sampel berlabel. Biayanya jauh lebih besar daripada sekadar mengubah satu baris model, jadi sebaiknya sudah diperhitungkan sejak tahap pemilihan model.
Cara Melakukan Uji Penerimaan Pergantian Model pada Antarmuka Terpadu APIYI
Sebelum pergantian model diaktifkan (go-live), standar keberhasilannya perlu dinaikkan dari sekadar “bisa terpanggil” menjadi “lulus uji penerimaan”. Uji penerimaan terdiri dari dua bagian: penelusuran kode kesalahan dan perbandingan metrik.
Tabel Referensi Penelusuran Kode Kesalahan
Prasyarat penelusuran adalah menetapkan (freeze) satu permintaan minimal terlebih dahulu, lalu mereproduksi masalah secara konsisten dengan Key yang sama, node yang sama, endpoint yang sama, dan ID model yang sama:
| Gejala | Penyebab Umum | Cara Memeriksa dan Memperbaiki |
|---|---|---|
| 400 | Field khusus model lama, parameter tool, structured output, atau format gambar yang tidak kompatibel | Hapus field yang tidak wajib terlebih dahulu, lalu tambahkan kembali satu per satu untuk menemukan field penyebabnya |
| 401/403 | Format token salah, grup token tidak mencakup model tersebut, atau model tidak ada dalam whitelist | Periksa Key, grup token, dan whitelist model |
| 404 | SDK menambahkan /v1 dua kali, atau model tidak termasuk dalam tipe antarmuka tersebut |
Base URL OpenAI SDK harus menyertakan /v1; Google GenAI SDK memakai alamat root tanpa /v1 dengan konfigurasi v1beta; salin ID model asli |
| 429 | Rate limit jangka pendek, jumlah concurrency melebihi batas, atau kuota tidak mencukupi | Baca isi error terlebih dahulu; untuk rate limit jangka pendek, gunakan exponential backoff dengan jitter dan jumlah percobaan terbatas; kirim ulang setelah masalah kuota diperbaiki |
| 200 tetapi body kosong | Anggaran output habis untuk proses berpikir (thinking), filter keamanan, atau hanya mengembalikan tool call | Periksa finish reason dan tipe respons yang dikembalikan, lalu perbesar anggaran output; gunakan permintaan terpendek tanpa tool sebagai pembanding |
Untuk alur pemanggilan tool multi-putaran pada Gemini 4, Anda juga perlu memeriksa apakah thoughtSignature dari respons dikembalikan apa adanya, serta apakah pemanggilan tool dan hasil tool-nya saling berpasangan satu-satu.
Mencatat metrik, membedakan perbedaan model dari overhead kanal
Sampai hari ini, di sumber publik belum ada data berkelompok yang mampu mengisolasi secara terpisah kerugian yang ditimbulkan oleh “penggantian model” atau “penerusan gateway” — dengan Key yang sama, grup yang sama, wilayah yang sama, serta input dan beban yang identik. Benchmark pihak ketiga memang bisa membandingkan antar model atau antar penyedia, tapi selisihnya tidak bisa langsung diatribusikan ke pergantian model di APIYI. Jadi alih-alih mengutip angka orang lain, lebih baik lakukan pengukuran sendiri dengan metode di bawah ini:
| Metrik | Cara pencatatan | Kegunaan |
|---|---|---|
| Alasan penyelesaian | Hitung distribusi finish_reason di setiap permintaan |
Mendeteksi pemotongan, penyaringan, dan pemutusan tool |
| Latensi token pertama yang tampak | Waktu kemunculan potongan konten non-kosong pertama pada permintaan streaming | Mengukur pengalaman menunggu pengguna |
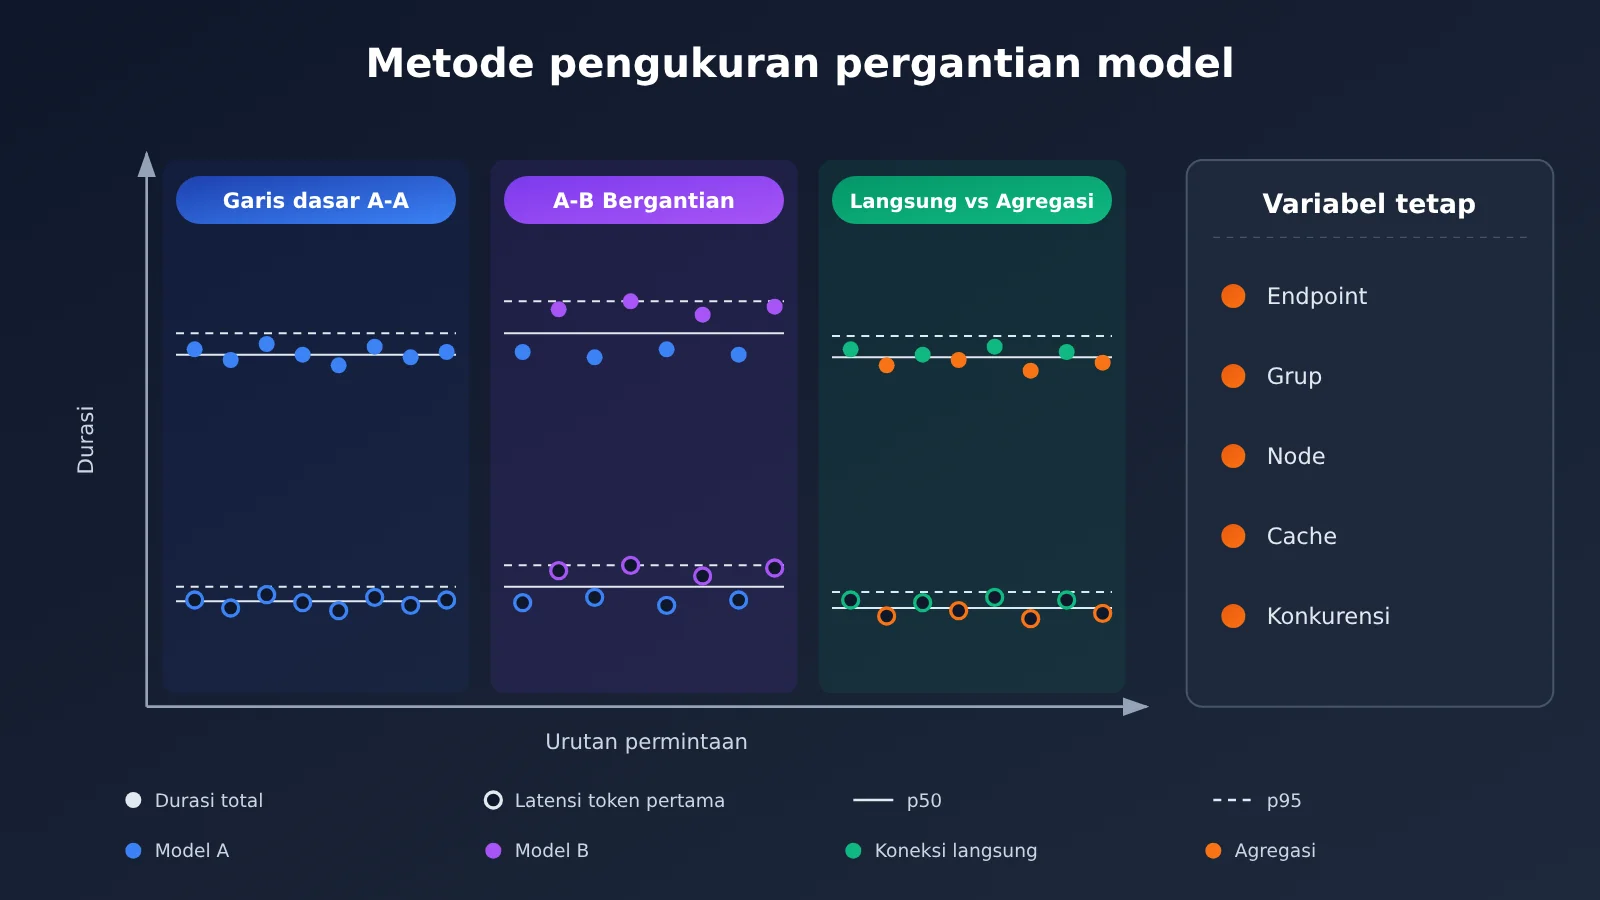
| Total durasi p50/p95 | Kuantil durasi setiap permintaan lengkap | Mengukur stabilitas dan kasus ekor panjang |
| Tingkat kegagalan | Hitung per kategori kode error | Membedakan salah konfigurasi dan gangguan sementara |
| Token aktual dan pemotongan biaya | Cocokkan field usage dengan tagihan satu per satu |
Menghitung biaya riil |
| Tingkat kelulusan uji terima bisnis | Beri nilai pada sampel tetap secara manual atau lewat aturan | Menilai apakah kualitas sudah memenuhi standar |
Urutan langkah pengukurannya disarankan seperti ini: kunci dulu endpoint, grup, node, dan parameter permintaan; bangun baseline dengan pola A-A, yaitu permintaan berulang pada model yang sama; lalu bergantian jalankan A-B dengan mengganti satu variabel saja, yaitu modelnya; kalau perlu mengevaluasi overhead kanal, lakukan perbandingan tersendiri antara koneksi langsung dan kanal agregasi pada model yang sama. Sekaligus kendalikan kondisi cache panas/dingin, batas output, dan jumlah konkurensi — kalau tidak, kecepatan model, cache miss, dan overhead kanal akan tercampur jadi satu dan tidak bisa dibedakan.
Risiko Tambahan pada Alur Tool Call Berstatus (Stateful)
Jika Anda menggunakan Responses untuk pemanggilan tool multi-putaran, mengganti model di tengah jalan juga akan memunculkan masalah state. Dokumen migrasi GPT-6.2 dari OpenAI menjelaskan bahwa beralih ke sebagian model di tengah sesi (termasuk downgrade) bisa menyebabkan item reasoning yang sudah ada dihapus, dan saat konteks dipulihkan, model mungkin perlu menalar ulang. Artinya, Anda tidak bisa menjanjikan “tanpa kehilangan state” setelah penggantian, dan perubahan biayanya juga tidak punya rasio yang tetap.
Saat melakukan uji penerimaan untuk alur semacam ini, pastikan item riwayat dan konteks bisa digunakan ulang dengan benar oleh model baru, dan cantumkan skenario “mengganti model di tengah sesi yang sama” sebagai kasus uji tersendiri.
FAQ: Pertanyaan yang Sering Diajukan
Q1: Apa itu antarmuka terpadu APIYI?
Ini adalah pintu masuk API yang kompatibel dengan OpenAI: cukup dengan satu kunci API dan Base URL yang sama, kamu sudah bisa memanggil model dari berbagai vendor seperti OpenAI, Claude, dan Gemini. Kamu tidak perlu mendaftar akun dan mengelola kunci terpisah untuk setiap vendor—saat ingin mengganti model, kamu cukup mengubah field `model` di request, lalu memeriksa parameter spesifik sesuai model yang dipakai.
Q2: Apa bedanya mengganti model lewat antarmuka terpadu dengan mengintegrasikan SDK resmi masing-masing vendor?
SDK resmi memang punya cakupan paling lengkap untuk kemampuan spesifik tiap vendor, tapi kalau dipakai bersamaan, kamu harus merawat beberapa set autentikasi, SDK, dan akun penagihan sekaligus. Antarmuka terpadu menggabungkan autentikasi, pintu masuk, dan tagihan menjadi satu, sehingga biaya pergantian sangat rendah untuk skenario dengan parameter umum. Konsekuensinya, parameter spesifik harus diverifikasi kompatibilitasnya satu per satu—misalnya, pemetaan field thinking native Gemini di antarmuka kompatibel perlu diuji tersendiri.
Q3: Kapan model-model yang disebut di artikel ini tersedia di APIYI?
Berdasarkan arsip pembaruan real-time APIYI: GPT-6.2 Astra dan Sol dirilis pada 2026-11-18 dan dibuka di tiga grup; Gemini 4 Neon diumumkan Google pada 18 November, lalu APIYI mengintegrasikannya di grup `default`/`svip` pada 20 November; Seedream 5.5 dirilis pada 13 November. Daftar model berubah cukup cepat, jadi selalu gunakan registri yang berlaku di hari tersebut.
Q4: Skenario apa yang paling cocok untuk mengganti model lewat antarmuka terpadu?
– **Perbandingan A/B multi-model**: membandingkan kualitas dan biaya dengan petunjuk yang sama di berbagai model.
– **Fallback saat gangguan**: beralih ke model cadangan ketika model atau jalur tertentu sedang kekurangan kapasitas.
– **Pembagian berdasarkan tugas**: model ekonomis untuk tanya jawab sederhana, model flagship untuk penalaran kompleks.
– **Pembuatan gambar multi-gaya**: pilih di antara beberapa model gambar sesuai kebutuhan, dan perhatikan pemetaan parameternya.
Q5: Bagaimana cara tercepat mulai memanggil banyak model lewat antarmuka terpadu?
1. Kunjungi APIYI di apiyi.com untuk mendaftarkan akun; pengguna baru mendapatkan kuota uji coba gratis.
2. Buat kunci API, dan pastikan grup token tempat kunci kamu berada mencakup model yang dituju.
3. Jalankan contoh minimal di artikel ini, lalu ganti field `model` sesuai registri untuk verifikasi.
Skema bayar sesuai pemakaian memudahkan kamu membandingkan beberapa model dengan trafik kecil terlebih dulu, baru kemudian menentukan solusi utama.
Q6: Berapa harga dan jendela konteks gemini-4-neon?
Berdasarkan registri model APIYI yang dibuat pada 2026-11-20, `gemini-4-neon` dihargai $3 per juta token untuk input, $15 untuk output, dan $0.15 untuk pembacaan cache; pembaruan APIYI mencantumkan harga yang sama dengan harga resmi, sedangkan pemotongan biaya aktual mengikuti tagihan akun. Baik Artificial Analysis maupun pengumuman Google mencantumkan konteks 1M—yaitu jendela yang dipakai bersama untuk input, thinking, dan output; dokumen rilis APIYI mencantumkan batas pembuatan sinkron sekitar 64K.
Q7: Apa saja keterbatasan yang diketahui dari penggantian model lewat antarmuka terpadu?
– **Parameter spesifik tidak universal**: level thinking, pemanggilan tool, dan output terstruktur perlu diperiksa per model.
– **Vektor tidak bisa dicampur**: mengganti model Embedding berarti harus melakukan vektorisasi ulang dan membangun ulang indeks.
– **Alur stateful berisiko kehilangan data**: mengganti model di tengah sesi Responses bisa membuat item reasoning hilang.
– **Jangkauan terbatas**: daftar model dibatasi oleh grup token, otorisasi, dan endpoint; kalau menemui masalah, cek dokumentasi penelusuran kode error di APIYI apiyi.com.
Key Takeaways: Beralih Model Bahasa Besar lewat Antarmuka Terpadu APIYI
- Mengganti model saja punya syarat: hanya berlaku jika endpoint-nya sama dan hanya menggunakan parameter umum yang didukung kedua model.
- Ada dua angka berbeda: 200+ adalah hitungan model terkurasi, sedangkan tabel registry berisi 289 entri termasuk varian versi dan jalur.
- Pemeriksaan punya urutan: ID model → grup token → endpoint → parameter, eliminasi satu per satu.
- Parameter gambar perlu dipetakan: MAI memakai
width/height, Seedream memakaisize, dan penulisan untuk efek transparan juga berbeda. - Ganti model vektor wajib rebuild: small dan large punya dimensi default berbeda; bahkan jika dimensinya sama, datanya tetap tidak saling kompatibel.
- HTTP 200 belum tentu sukses: periksa juga alasan penyelesaian (finish reason), body yang kosong, serta respons yang hanya berisi tool call.
- Kinerja harus diuji sendiri: gunakan baseline A-A ditambah pengukuran bergantian A-B; semuanya bisa dilakukan di APIYI apiyi.com dengan satu kunci API yang sama.
Kesimpulan
Poin inti dalam beralih Model Bahasa Besar dengan antarmuka terpadu APIYI:
- Pakai ulang autentikasi dan pintu masuk: satu kunci API dan satu Base URL sudah mencakup berbagai kemampuan — teks, gambar, vektor, dan lainnya.
- Bedakan parameter umum dan parameter khusus: parameter umum bisa langsung dialihkan, sedangkan parameter khusus diverifikasi satu per satu sebelum ditambahkan.
- Jadikan proses peralihan sebagai operasi yang bisa diverifikasi: gunakan tabel pembanding kode error untuk menelusuri masalah, serta metode yang konsisten untuk mencatat latensi, tingkat kegagalan, dan pemotongan biaya.
Saran praktis: mulai dengan request teks murni sesederhana mungkin untuk memastikan kedua model bisa berjalan, lalu perluas bertahap ke skenario bisnis dengan urutan “pemetaan parameter gambar” → “membangun ulang indeks vektor” → “alur tool stateful”. Disarankan memanfaatkan kuota uji gratis di APIYI apiyi.com untuk menyelesaikan verifikasi di atas terlebih dahulu, baru kemudian menentukan model utama dan rencana cadangan (fallback).
📚 Referensi
-
Pusat Dokumentasi APIYI: Pengenalan dasar, panduan memulai cepat, registri model, vektorisasi teks, dan penjelasan versi model
- Tautan:
docs.apiyi.com - Keterangan: Sumber primer untuk ID model, grup, endpoint, dan harga; untuk registri, gunakan versi yang dihasilkan pada hari tersebut sebagai acuan
- Tautan:
-
OpenAI Using GPT-6.2: Migrasi GPT-6.2 dan penjelasan parameter
- Tautan:
developers.openai.com/api/docs/guides/latest-model - Keterangan: Pemanggilan tool di Responses, field tingkat berpikir, dan siklus hidup item penalaran
- Tautan:
-
Dokumen Pemecahan Masalah dan Thought Signature Google Gemini API: Menangani masalah pemanggilan Gemini 4
- Tautan:
aistudio.google.com/docs/troubleshooting - Keterangan: Tingkat berpikir, cara mengirim kembali
thoughtSignature, dan pesan error yang umum terjadi
- Tautan:
-
Memulai dengan Gemini 4 di Google Cloud: Penjelasan long decoding dan versi API Gemini 4
- Tautan:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/start/get-started-with-gemini-4 - Keterangan: Pelajari versi API yang mendukung long decoding serta syarat agar proses bisa dilanjutkan (resume)
- Tautan:
-
Halaman Perbandingan Model Artificial Analysis: Benchmark model pihak ketiga dan metode pengukuran latensi
- Tautan:
artificialanalysis.ai/models/comparisons/gemini-4-neon-vs-gpt-6-2-sol - Keterangan: Cocok sebagai referensi perbandingan antar model, tetapi tidak dapat dipakai untuk mengatribusikan overhead kanal
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman beranda situs APIYI, dan untuk materi integrasi lainnya, kunjungi pusat dokumentasi di docs.apiyi.com