著者注:同じ1つのAPIキーとOpenAI互換エンドポイントで大規模言語モデルの切り替えを行い、画像やEmbeddingをモデル横断で統合する際に個別対応が必要となるフィールド・ステータス・受け入れ条件を明確にします。
本記事では、まず1つのAPIキーと1つのOpenAI互換エンドポイントでテキストモデルの切り替えを通しで動作させ、そのうえで画像とベクトル(Embedding)の2つの例を通じて、モデル横断統合においてどのフィールド・ステータス・受け入れ条件を個別に適合させる必要があるかを解説します。結論には前提条件があります。同一エンドポイントで、両モデルが対応する共通パラメータだけを使う場合、モデルの切り替えは通常 model フィールドを変えるだけで済みます。しかし、独自の思考(thinking)パラメータ、ツール呼び出し、画像サイズ、ベクトルの次元数が絡むと、モデルごとに個別の確認が必要になります。
これは「1行修正すれば万事解決」といった類の宣伝記事ではありません。APIYIの統一インターフェースでそのまま使い回せる部分と、再検証が必須となる部分をきちんと切り分けて説明し、失敗しやすいシナリオについても併せて取り上げます。
この記事で得られること:読み終える頃には、同一の認証情報とコードのままでテキストモデルを切り替えられるようになり、画像やEmbeddingでモデルを変更する際にどのパラメータを修正すべきかがわかり、現場で実際に使える切り替え後の受け入れ確認の進め方を身につけられます。
APIYI の統一インターフェースで大規模言語モデルを切り替える前に知っておきたい 9 つの用語
モデルを切り替える際に発生するトラブルの多くは、用語の理解にズレがあることが原因です。たとえば、Base URL に /v1 が二重についた形で記述してしまったり、同じ次元のベクトルなら混用できると思い込んでしまったりするケースです。まずは以下の概念の意味を揃えておきましょう。この後のすべての手順は、これらの定義を土台にしています。
| 用語 | 実際の意味 | 切り替え時の注意点 |
|---|---|---|
| Base URL | SDK が API パスを組み立てる際に使うルートアドレス | OpenAI SDK では /v1 までを指定し、パスの重複連結を避ける |
| APIキー | API リクエストの認証情報 | サーバー側の設定ファイルまたは環境変数にのみ保存する |
| モデル ID | リクエストで指定するモデル。バージョンやチャネル情報が含まれる場合もある | モデルレジストリから元の ID をコピーし、手入力は避ける |
| トークングループ | 現在の Key で利用できるモデル・チャネル・課金条件を決めるもの | モデルがグループ外だと 401/403 または 404 が返る |
| Chat Completions | メッセージ配列に基づいてテキスト対話を行う API プロトコル | テキストのみの切り替えにおける主な入り口 |
| Responses | 多様な出力形式やツール呼び出しに対応する API プロトコル | GPT-6.2 のツール呼び出しはこちらを使う |
| Embedding | コンテンツを固定次元のベクトルにエンコードし、検索などの類似マッチングに使うもの | モデルを変えることは、ベクトル空間を変えることと同じ |
| ベクトルインデックス | 特定の次元とベクトル空間に基づいて類似項目を検索するための構造 | 次元やモデルが変わったら再構築が必要 |
| 初回可視トークンのレイテンシ | リクエスト送信から、ユーザーが最初の有効な生成内容を目にするまでの待ち時間 | 推論モデルの思考時間がこの指標を長引かせる |
この中で最も見落とされがちなのが「トークングループ」です。同じアカウントでも、グループの異なる Key では参照できるモデル一覧が異なることがあります。そのため「モデルが存在しない」という問題を切り分けるときは、コードを疑う前に、まず Key が属するグループを確認しましょう。
APIYI統一インターフェースで大規模言語モデルを切り替える際の要点
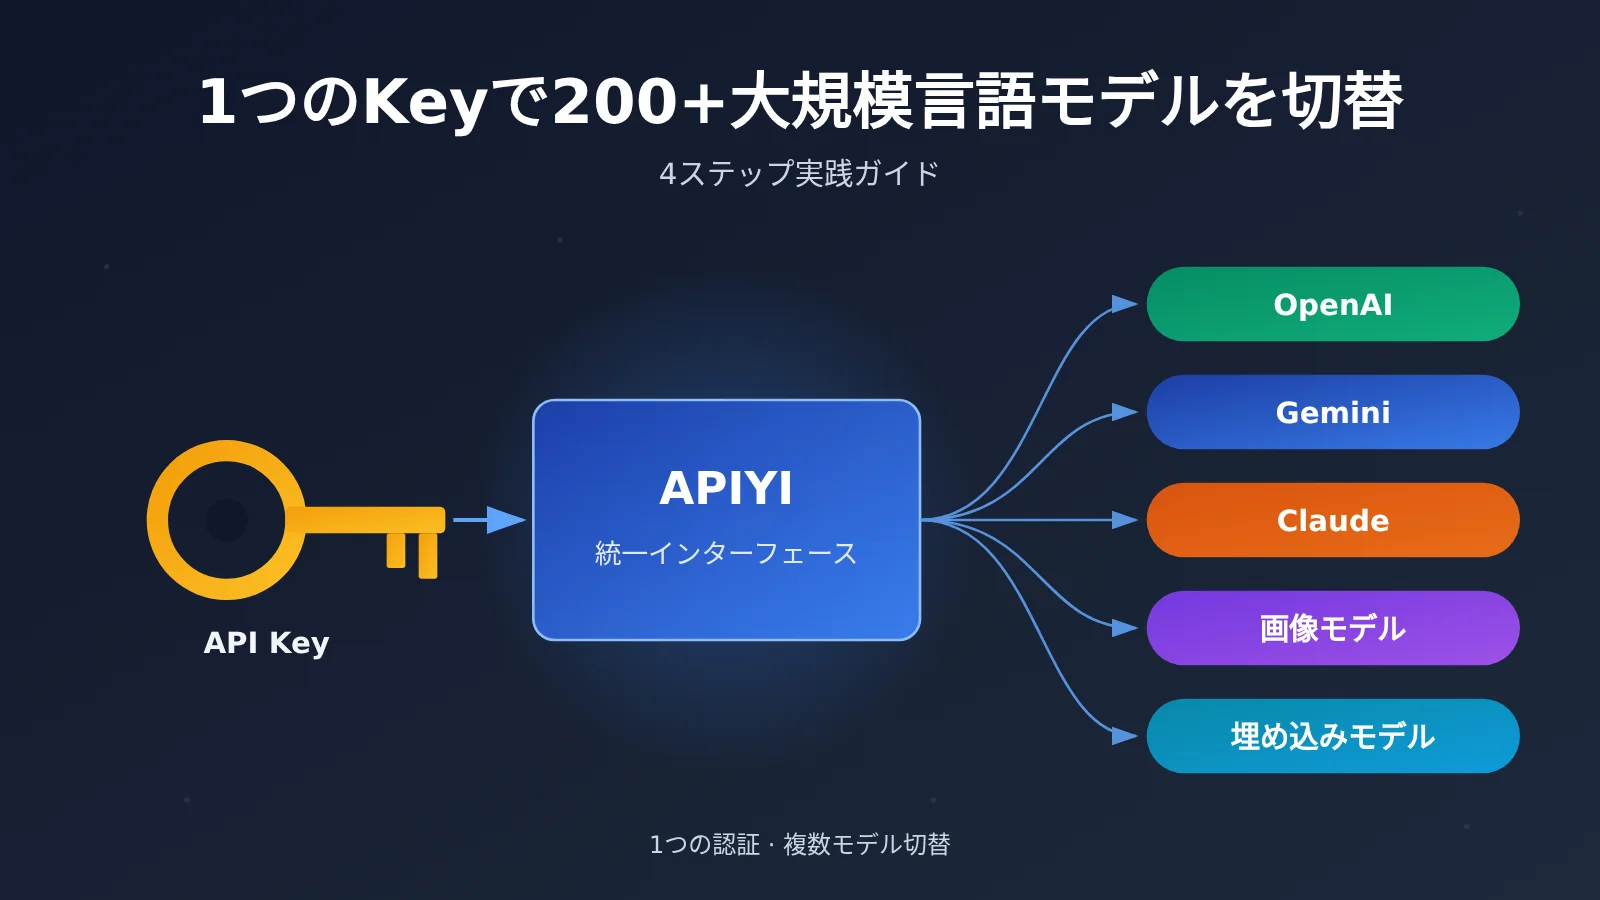
モデル接続を統一して本当に節約できるのは、「同じ作業を何度も繰り返す手間」です。ベンダーごとにアカウント登録をしたり、複数のキーを管理したり、複数のSDKに対応したりする必要がなくなります。APIYI(apiyi.com)の基本紹介とクイックスタートドキュメントによれば、認証設定を1回行い、OpenAI互換のエンドポイントを1つ用意するだけで、各ベンダーの利用可能なモデルへアクセスできます。
| 項目 | 使い回せるもの | モデルごとに確認が必要なもの |
|---|---|---|
| 認証 | 同じAPIキー、同じリクエストヘッダー | キーが属するトークングループに対象モデルが含まれているか |
| 接続先 | 同じBase URL | 対象モデルが対応するエンドポイントの種類(チャット/Responses/画像/埋め込み) |
| リクエストボディ | model、基本的なmessagesやinputなどの共通フィールド |
思考レベル、ツール、構造化出力、画像サイズ、埋め込み次元 |
| レスポンス処理 | choices、finish_reason、usageのパース処理 |
空の本文、ツール呼び出しのみ、安全フィルターなどの特殊なレスポンス |
| 課金 | 同じアカウントの残高と請求 | モデルごとに単価・価格帯・キャッシュ課金方式が異なる |
200+と289:APIYIのモデル数に関する2つの数え方
APIYIの公開紹介では、接続モデル数は「200+の厳選モデル」とされています。一方、2026-11-20に生成された公開モデルレジストリでは、model_count フィールドが289になっています。この2つの数字は矛盾していません。レジストリのカウントには、同じモデルの異なるバージョンや異なる回線のバリアントも含まれるため、エントリ数は「厳選モデル」の数より多くなるのです。
注意したいのは、1つのトークンが実際に呼び出せるモデル一覧は、グループ・モデルごとのアクセス権限・エンドポイントという三重の制約を受けるという点です。レジストリにIDが存在していても、手元のキーで必ずそのモデルを呼び出せるとは限りません。
切り替え前の確認手順
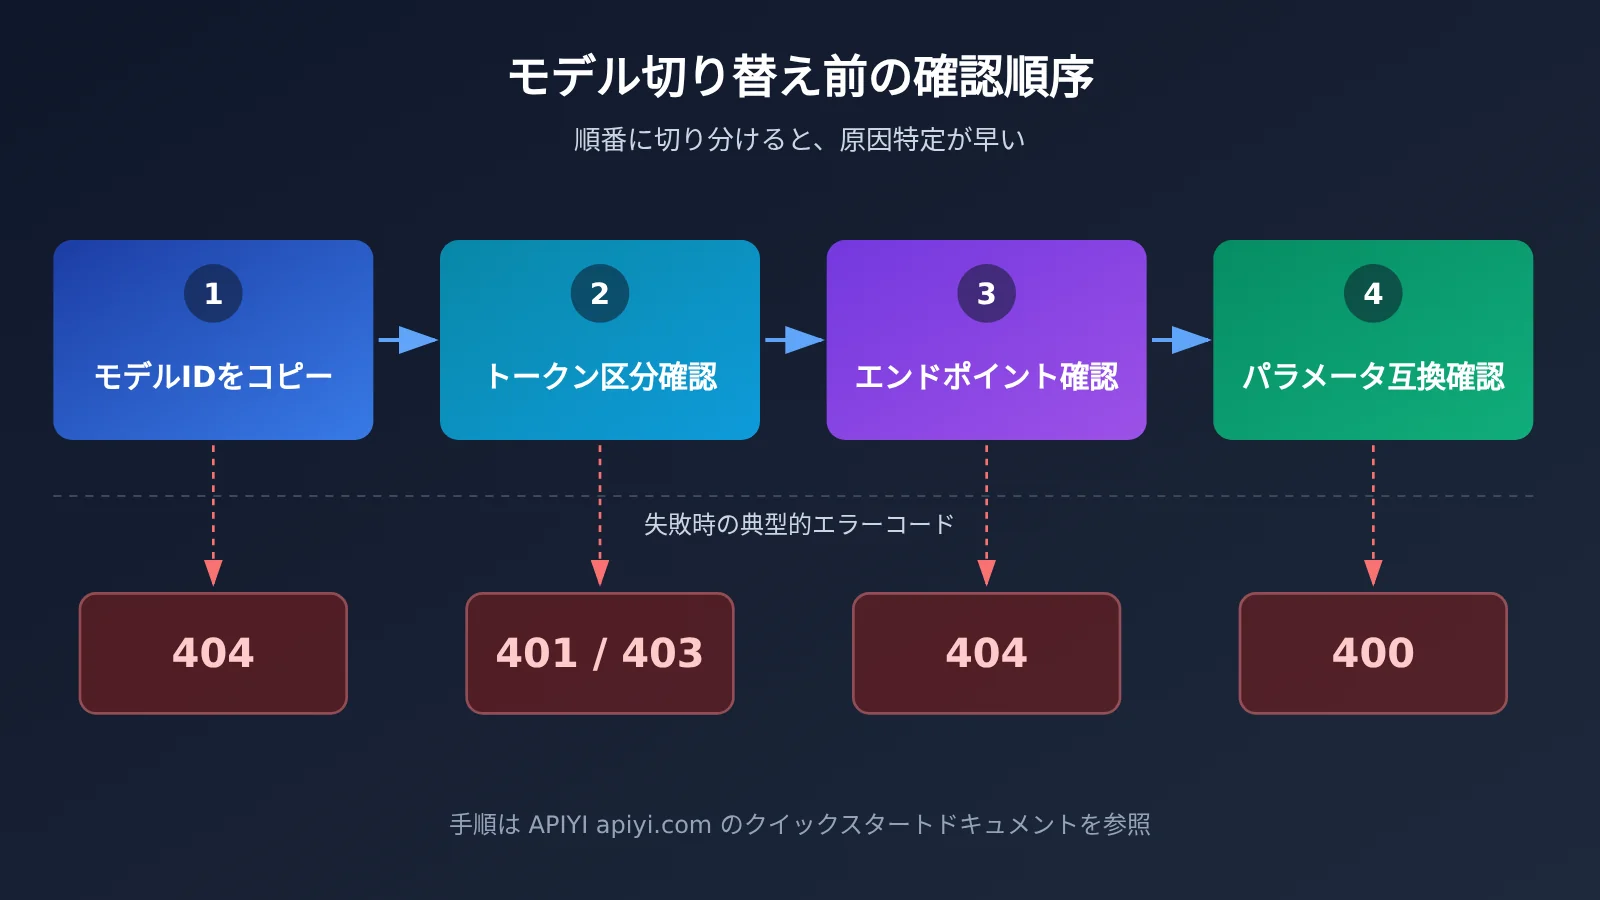
新しいモデルを導入するときは、毎回同じ順序でチェックするのがおすすめです。問題が起きたときに、あちこちを同時に疑って調査する手間を省けます:
- モデルIDの確認:当日のモデルレジストリから元のIDをコピーし、大文字・小文字やハイフンが完全に一致していることを確認します。
- トークングループの確認:現在のキーが属するグループでそのモデルが利用可能になっているか確認します。たとえば、一部のモデルは特定のグループでのみ提供されます。
- エンドポイントの確認:そのモデルが、呼び出したいインターフェースの種類に対応しているか確認します。テキスト・画像・埋め込みではエンドポイントが異なります。
- パラメータの確認:両方のモデルが対応している共通パラメータだけを残し、固有パラメータは1つずつ追加して動作を検証します。
APIYIの統一インターフェースでテキスト大規模言語モデルを手早く切り替える方法
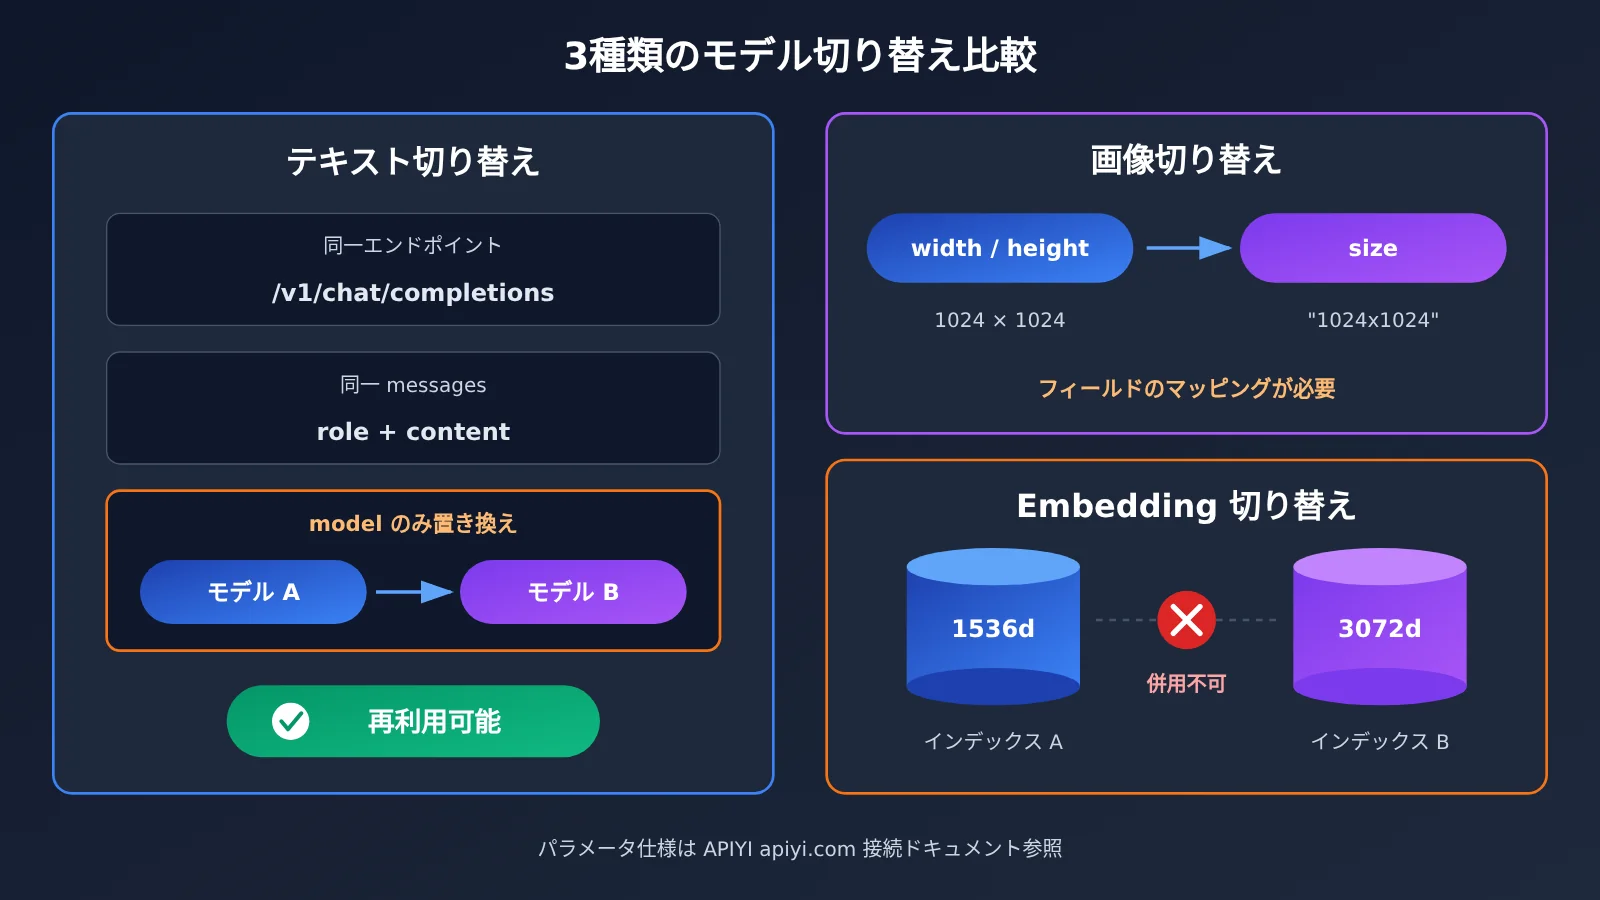
以下では、Chat Completions経由でアクセスできる2つのテキストモデルを例に取り上げます。gemini-4-neon と gpt-6.2-sol です。どちらも POST /v1/chat/completions を使うため、基本的な messages だけを扱うのであれば、モデルの切り替えは model フィールドを差し替えるだけで済みます。ただし、お使いのAPIキーが属するグループからこれら2つのモデルが利用できることが前提なので、呼び出し前にモデル一覧で必ず確認しておきましょう。
最小サンプル:同じコードで2つのモデルを切り替える
Base URLを https://api.apiyi.com/v1 に設定し、APIキーは環境変数から読み込みます。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],     # サーバー側の環境変数にのみ置く
    base_url="https://api.apiyi.com/v1",     # APIYIのOpenAI互換エンドポイント
)

for model in ["gemini-4-neon", "gpt-6.2-sol"]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是向量索引"}],
    )
    choice = resp.choices[0]
    print(model, "| finish_reason:", choice.finish_reason, "| usage:", resp.usage)
    print(choice.message.content or "<空正文>")
HTTP 200 だけを見ず、レスポンスフィールドを確認する
レスポンスを受け取ったら、最低でも3つの箇所をチェックしましょう。choices[0].message.content が空になっていないか。finish_reason が stop なのか、それとも長さ制限による切り詰めなどの理由で終わっていないか。そして、usage のトークン使用量が妥当な水準かどうか。推論系モデルは思考プロセス自体も出力トークンの予算を消費するため、予算が小さすぎると「HTTP 200 が返ってきたのに本文が空」という現象が起こることがあります。
また、返答本文でモデルが自称する名前は、バックエンドのモデルを検証する根拠にはなりません。実際にどのモデルが呼び出されたのかを確認したいときは、リクエスト ID・レスポンスのメタデータ・課金ログを優先的に確認しましょう。
完全な実装コードを見る:ストリーミング初回トークンレイテンシ、バックオフリトライ、メトリクス記録を含む
import os
import time
import random
from openai import OpenAI, RateLimitError, APIStatusError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",   # APIYI 統一インターフェース
)

def call_once(model: str, prompt: str, max_retries: int = 3) -> dict:
    """ストリーミングで1回呼び出し、最初の可視トークンまでのレイテンシ、総所要時間、完了理由を記録する"""
    for attempt in range(max_retries + 1):
        start = time.perf_counter()
        first_token_at = None
        parts, finish_reason, usage = [], None, None
        try:
            stream = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
                stream=True,
                stream_options={"include_usage": True},
            )
            for chunk in stream:
                if chunk.usage:
                    usage = chunk.usage
                if not chunk.choices:
                    continue
                delta = chunk.choices[0].delta
                if delta and delta.content:
                    if first_token_at is None:
                        first_token_at = time.perf_counter()
                    parts.append(delta.content)
                if chunk.choices[0].finish_reason:
                    finish_reason = chunk.choices[0].finish_reason
            end = time.perf_counter()
            return {
                "model": model,
                "ok": bool(parts),
                "ttft_s": round(first_token_at - start, 3) if first_token_at else None,
                "total_s": round(end - start, 3),
                "finish_reason": finish_reason,
                "usage": usage,
                "text": "".join(parts),
            }
        except RateLimitError:
            # 短時間のレート制限に対してのみ、ジッター付きの指数バックオフを有限回行う
            if attempt == max_retries:
                raise
            time.sleep((2 ** attempt) + random.uniform(0, 0.5))
        except APIStatusError as e:
            # 400/401/403/404 は設定やパラメータの問題であり、リトライしても無意味
            return {"model": model, "ok": False, "status": e.status_code,
                    "error": str(e)[:300]}

if __name__ == "__main__":
    prompt = "用三句话说明向量索引为什么要和 Embedding 模型绑定"
    for m in ["gemini-4-neon", "gpt-6.2-sol"]:
        r = call_once(m, prompt)
        print({k: v for k, v in r.items() if k != "text"})
🚀 クイックスタート:まずは APIYI apiyi.com の新規ユーザー向け無料テストクレジットを使って上記の最小構成サンプルを動かし、2つのモデル ID がどちらも自分のトークングループで本文を返せることを確認してから、業務コードに組み込むのがおすすめです。
固有パラメータは個別の確認が必要
上記のサンプルでは、意図的に共通フィールドだけを使いました。しかし、ここから先のパラメータを追加すると、「model を変えるだけで済む」という前提は通用しなくなります。
- GPT-6.2 シリーズ:OpenAI API では、
gpt-6.2-astraとgpt-6.2-solが Chat Completions と Responses の両方に対応しています。Chat Completions での思考レベルのフィールドはreasoning_effort、Responses ではreasoning.effortとなり、いずれのモデルもnoneという値を受け付けません。ツール呼び出しが必要な場合は Responses に切り替えましょう。 - Gemini 4 シリーズ:
gemini-4-neonは、APIYI の Gemini ネイティブ方式と OpenAI 互換チャットの両方に対応しています。ネイティブ REST では/v1beta/models/{id}:generateContentを使用し、思考レベルはgenerationConfig.thinkingConfig.thinkingLevelに指定します。選択できる値はlow、medium、high、xhighの4つで、デフォルトはhighです。旧仕様のthinkingBudgetとminimalは Gemini 4 では使えません。さらに Google のドキュメントには、Gemini 4 がtemperatureとtopPを無視することも明記されています。 - 構造化出力とツール:JSON Schema の制約やツール定義の形式は、両者で必ずしも一致するとは限りません。対象モデルのドキュメントに沿って、一つずつ確認する必要があります。
なお、APIYI の Neon 提供開始のお知らせには、リリース時に確認したのは料金系エンドポイントのみで、リリース前の実際の呼び出しテストは行っていないと記載されています。つまり、上記のデュアルエンドポイント対応やツール呼び出しはあくまでドキュメント上の挙動です。本番利用の前に、最小限のリクエストでご自身による検証を行うのが安全です。
APIYI 統一インターフェースでの能力横断切り替え:画像と Embedding の比較
テキスト対話以外では、画像とベクトルは最も一般的なモデル横断のユースケースであり、「model を書き換えるだけ」のアプローチが最も破綻しやすい箇所でもあります。以下の2つの例は、それぞれ「パラメータ構造が異なる」という問題と「結果空間が異なる」という問題に対応しています。
画像モデルの切り替え:MAI-Image-2.7 と Seedream 5.5
どちらのモデルも、同じ APIキーの Images 機能で呼び出せますが、サイズ、参照画像、透過出力の指定方法はまったく異なります。
| 項目 | MAI-Image-2.7 | Seedream 5.5 |
|---|---|---|
| エンドポイント | 生成は generations、編集は edits を使用 |
テキストのみでも参照画像ありでも generations を使用 |
| サイズパラメータ | width と height で総ピクセル数を指定、公表上の上限は 4,194,304 ピクセル |
size で価格帯を選択、省略時は 2K が適用 |
| 参照画像 | 編集では参照画像を最大5枚まで | 参照画像は image フィールドに指定 |
| 透過出力 | background: "transparent" を指定すると、アルファ付き PNG が返る |
background: "transparent" と output_format: "png" の同時指定が必要 |
| 課金 | 独立した課金体系 | size の価格帯ごとに独立課金 |
| 利用可能なプラットフォーム | APIYI apiyi.com(登録表とグループ設定による) | APIYI(登録表とグループ設定による) |
呼び出しの際は、ビジネス層でフィールドを直接組み立てるのではなく、モデルごとにパラメータ変換関数を1つ用意して管理することをおすすめします。
# 前節の client をそのまま使用。モデル ID は当日の登録表からコピーしてください
def build_image_kwargs(model: str, prompt: str, transparent: bool = False) -> dict:
    if model.startswith("MAI-Image"):
        body = {"width": 1024, "height": 1024}
        if transparent:
            body["background"] = "transparent"
        return {"model": model, "prompt": prompt, "extra_body": body}
    # Seedream 5.5:size が価格帯を決定。指定できる値は接続ドキュメントに準拠
    body = {"size": "2K"}
    if transparent:
        body.update({"background": "transparent", "output_format": "png"})
    return {"model": model, "prompt": prompt, "extra_body": body}

img = client.images.generate(**build_image_kwargs("MAI-Image-2.7", "扁平风格的钥匙图标", True))
透過画像、参照画像の効果、レスポンス形式、料金については、両モデルそれぞれで個別に検証する必要があります。一方のモデルの検証結果でもう一方を代用することはできません。
Embeddingモデルの切り替え:small と large はそのままでは混用できない
ベクトル化の呼び出し形式は確かに統一されています。どのモデルでも POST /v1/embeddings を使うので、model と input を渡すだけで済みます。
for m in ["text-embedding-3-small", "text-embedding-3-large"]:
    e = client.embeddings.create(model=m, input=["统一接口切换模型"])
    print(m, "维度:", len(e.data[0].embedding))   # デフォルトはそれぞれ 1536 と 3072
問題は結果のほうです。text-embedding-3-small のデフォルトは 1536 次元、text-embedding-3-large のデフォルトは 3072 次元あり、次元数が異なるベクトルは同じインデックスに格納できません。dimensions パラメータで large を 1536 次元に縮小したとしても、両モデルのベクトル空間は互いに独立しているため、既存ドキュメントのベクトルと新しいクエリベクトルの間で類似度を計算しても意味がありません。
したがって、Embeddingモデルを切り替える正しい手順は、新しいベクトルインデックスを作成し、既存ドキュメントをすべて再ベクトル化し、クエリ側でも同じタイミングでモデルを切り替え、さらにラベル付きサンプルを使って類似度のしきい値を再調整する、という流れになります。このコストは model の 1 行を書き換えるよりもはるかに大きいため、モデル選定の段階であらかじめ織り込んでおくべきです。
APIYI統一インターフェースでのモデル切り替えを受け入れ検証する方法
切り替えをリリースする前には、「とりあえず呼び出せる」状態を「検証に合格できる」状態へ引き上げておく必要があります。検証は「エラーコードの切り分け」と「メトリックの突き合わせ」の2つのパートに分かれます。
エラーコード切り分け対照表
切り分けの前提として、まず最小構成のリクエストを1つ固定し、同一のAPIキー・同一ノード・同一エンドポイント・同一モデルIDで安定して再現できるようにします。
| 現象 | 主な原因 | 確認と修正 |
|---|---|---|
| 400 | 旧モデル固有のフィールド、ツールパラメータ、構造化出力、画像フォーマットの非互換 | 必須以外のフィールドを外し、1つずつ戻しながら原因を特定 |
| 401/403 | トークン形式の誤り、グループにそのモデルが含まれていない、モデルがホワイトリストに未登録 | APIキー、トークンのグループ、モデルのホワイトリストを確認 |
| 404 | SDKで/v1が二重に付与されている、またはモデルがそのインターフェース種別に属していない |
OpenAI SDKのBase URLは/v1付きに。Google GenAI SDKは/v1なしのルートアドレスを使い、v1betaを設定。元のモデルIDをそのままコピー |
| 429 | 短時間のレート制限、同時実行数の超過、クレジット不足 | まずエラー本文を確認。短時間のレート制限には試行回数を絞ったジッター付きの指数バックオフを使用。クレジットの問題は解消してから再送 |
| 200だが本文が空 | 思考(thinking)で出力予算を使い切った、安全性フィルターの発動、ツール呼び出しのみの返却 | 完了理由と返却タイプを確認し、出力予算を増やす。ツールなしの最短リクエストを比較用に用意 |
Gemini 4のマルチターンツールフローでは、レスポンスで受け取ったthoughtSignatureをそのまま送り返しているか、ツール呼び出しとツール結果が1対1で対応しているかも併せて確認してください。
指標を記録して、モデル差とチャネルオーバーヘッドを切り分ける
現在公開されている資料には、同一のAPIキー・同一グループ・同一リージョン・同一の入力と負荷という条件をそろえたうえで、「モデルの変更」や「ゲートウェイ中継」がもたらす損失だけを切り出して比較したデータはまだ存在しません。サードパーティのベンチマークは、異なるモデルや異なるプロバイダー同士を比較することはできますが、その差分を「APIYIでモデルを変えたから」と直接結びつけることはできません。それなら他人の数字を引用するより、次の方法で自分で測ってしまうほうが確実です。
| 指標 | 記録方法 | 用途 |
|---|---|---|
| 完了理由 | 毎回の finish_reason の分布を集計 |
切り詰め、フィルタ、ツール中断の検出 |
| 最初の可視トークンまでのレイテンシ | ストリーミング応答で最初の空でないコンテンツが届くまでの時間 | ユーザーの待ち時間体験の評価 |
| 総所要時間 p50/p95 | リクエスト1回ごとの所要時間の分位点 | 安定性とロングテールの評価 |
| 失敗率 | エラーコード別に分類してカウント | 設定ミスと一時的な障害の区別 |
| 実トークン数と課金 | usage フィールドと請求明細を1件ずつ突き合わせ |
実コストの算出 |
| 業務受け入れ合格率 | 固定サンプルを人手またはルールで採点 | 品質が基準に達しているかの判断 |
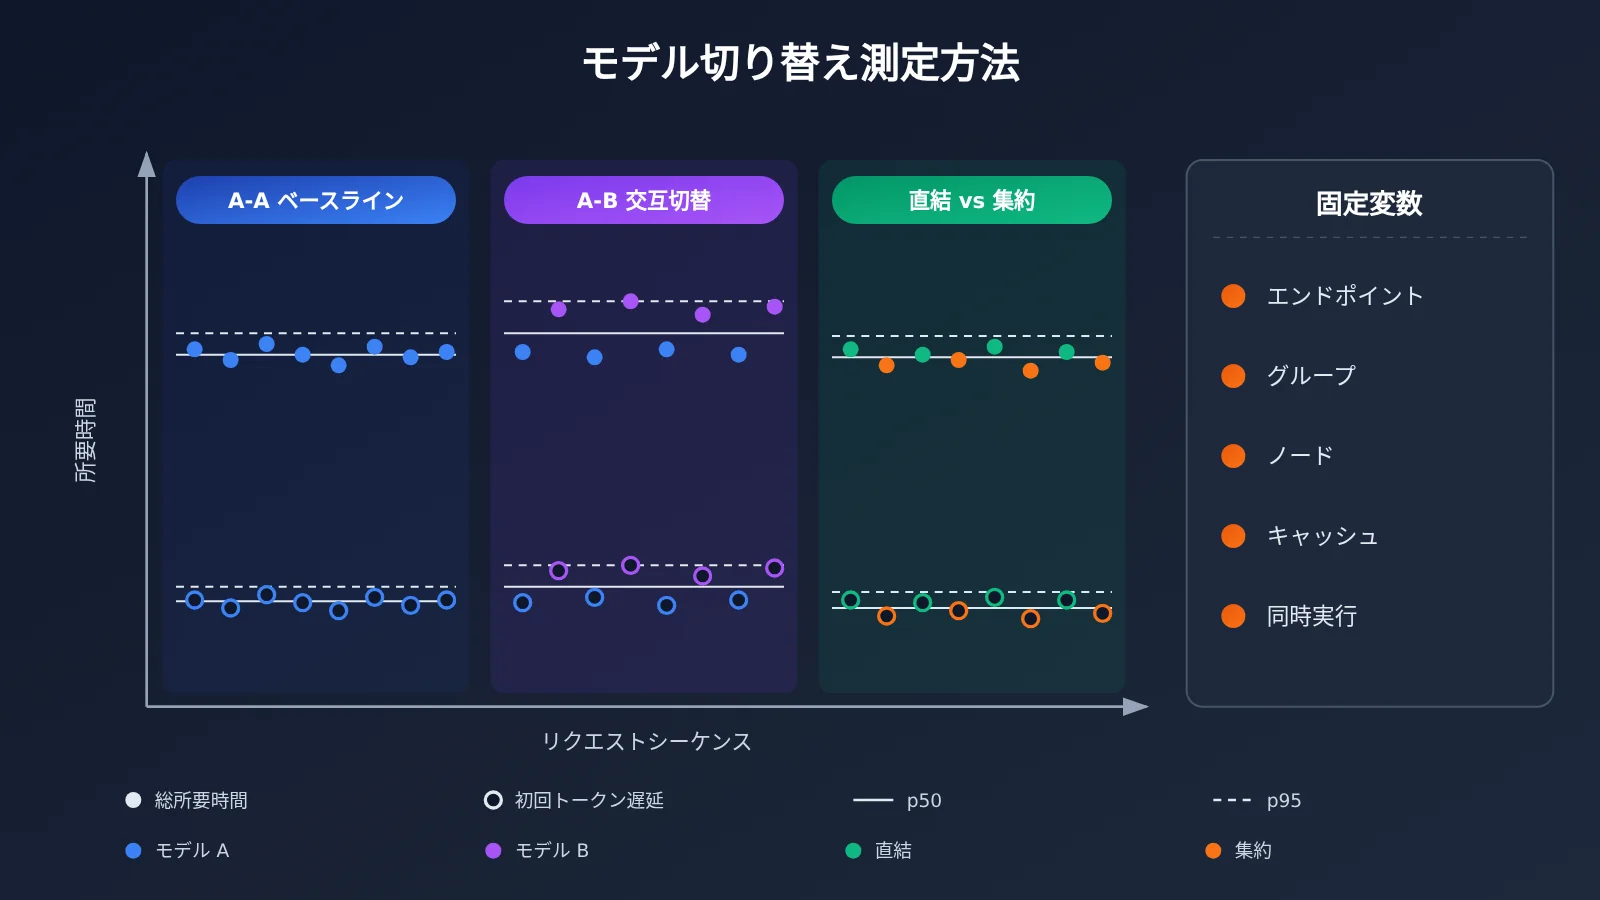
測定の手順は、次の順序で進めるのがおすすめです。まずエンドポイント・グループ・ノード・リクエストパラメータを固定します。次にA-A(同一モデルで繰り返しリクエスト)でベースラインを確立し、そのうえでA-B(モデルという1項目だけを差し替えた比較)を交互に実行します。チャネルオーバーヘッドも評価したい場合は、同一モデルについて直接接続と中継チャネルの比較を別途行います。あわせて、キャッシュのウォーム/コールド、出力上限、同時実行数も制御してください。さもないと、モデルの速度差・キャッシュミス・チャネルオーバーヘッドが混ざり合って、切り分けられなくなってしまいます。
ステートフルなツールフローの追加リスク
Responses API でマルチターンのツール呼び出しを行っている場合、途中でモデルを切り替えると、状態まわりの問題も発生します。OpenAI の GPT-6.2 移行ドキュメントによれば、セッションの途中で一部のモデル(ダウングレードを含む)へ切り替えると、既存の推論項目が削除される可能性があり、コンテキストを復元する際にモデルが推論をやり直す必要が生じることがあります。つまり、切り替え後に「状態は失われない」と約束することはできませんし、費用の変化も一定の割合にはなりません。
こうしたフローを受け入れ検証する際は、履歴項目やコンテキストが新しいモデルで正しく再利用できるかを確認するとともに、「同一セッションの途中でモデルを切り替える」ケースを独立したテストケースとして必ずリストアップしましょう。
よくある質問(FAQ)
Q1:APIYIの統一インターフェースとは何ですか?
OpenAI互換のAPIエントリーポイントです。1つのAPIキーと共通のBase URLだけで、OpenAI、Claude、Geminiなど各ベンダーのモデルを呼び出せます。ベンダーごとにアカウント登録やキー管理をする必要はなく、モデルを切り替えるときは、基本的にリクエスト内の `model` フィールドを変更して、モデルごとの固有パラメータを確認するだけで済みます。
Q2:統一インターフェースでのモデル切り替えは、各社の公式SDKを個別に使うのと何が違いますか?
公式SDKは固有機能の対応範囲が最も広いものの、複数社を併用すると認証まわり・SDK・課金アカウントを何セットも管理することになります。統一インターフェースは認証・エントリーポイント・請求を1つにまとめられるため、共通パラメータだけで済むケースでは切り替えコストが非常に低くなります。その代わり、固有パラメータは1つずつ互換性を確認する必要があります。たとえばGeminiのネイティブな思考フィールドが互換インターフェース上でどうマッピングされるかは、個別に検証しておきましょう。
Q3:本文で紹介したモデルは、いつからAPIYIで使えるようになりますか?
APIYIのリアルタイム情報アーカイブによると、GPT-6.2 AstraとSolは2026-11-18にリリースされ、3つのグループで利用可能になりました。Gemini 4 NeonはGoogleが11月18日に発表し、APIYIは11月20日に `default`/`svip` グループで対応を開始しています。Seedream 5.5は11月13日リリースです。モデル一覧は変化が速いため、当日の登録表を基準にご確認ください。
Q4:統一インターフェースでのモデル切り替えが最も向いているシーンは?
– **複数モデルのA/B比較**:同一のプロンプトを異なるモデル間で回し、効果とコストを比較します。
– **障害時のフォールバック**:特定のモデルや回線がリソース逼迫したときに、代替モデルへ切り替えます。
– **タスクごとの使い分け**:簡単な質疑応答は低コストモデル、複雑な推論はフラッグシップモデルを使います。
– **画像の多スタイル生成**:複数の画像モデルからニーズに合わせて選択します。パラメータのマッピングには注意が必要です。
Q5:統一インターフェースで複数モデルを最速で使い始めるには?
1. APIYI(apiyi.com)にアクセスしてアカウント登録します。新規ユーザーには無料テストクレジットが付与されます。
2. APIキーを作成し、キーが属するトークングループに目的のモデルが含まれているか確認します。
3. 本記事の最小サンプルを実行し、登録表に従って `model` フィールドを差し替えて動作を確認します。
従量課金方式なので、少ないトラフィックでまず複数のモデルを比べてから、本命の構成を決められます。
Q6:gemini-4-neonの価格とコンテキストはどれくらい?
APIYIが2026-11-20に生成したモデル登録表によると、`gemini-4-neon` は100万トークンあたり入力$3・出力$15・キャッシュ読み取り$0.15で、APIYIのリアルタイム情報では公式と同価格と明記されています。実際の課金額はアカウントの請求明細をご確認ください。Artificial AnalysisとGoogleの発表はどちらも1Mコンテキストとされており、これは入力・思考・出力で共有されるコンテキストウィンドウです。なお、APIYIのリリースドキュメントには同期生成の上限が約64Kと記載されています。
Q7:統一インターフェースでの切り替えには、どんな既知の制限がありますか?
– **固有パラメータは共通ではない**:思考レベル、ツール呼び出し、構造化出力はモデルごとに確認が必要です。
– **ベクトルは混用不可**:Embeddingモデルを変更する場合は、再ベクトル化とインデックス再構築が必須です。
– **ステートフルなフローでは損失が発生し得る**:Responsesで途中からモデルを切り替えると、推論項目が失われる可能性があります。
– **参照できる範囲が制限される**:モデル一覧はトークングループ・認可・エンドポイントの制約を受けます。問題が発生した場合は、APIYI(apiyi.com)のエラーコード・トラブルシューティングドキュメントをご確認ください。
APIYI 統一インターフェースで大規模言語モデルを切り替える Key Takeaways
- model だけの変更には前提条件がある:同一エンドポイントで、双方が対応している共通パラメータのみを使う場合に限り成立します。
- モデル数には 2 つの数え方がある:200+ は厳選モデルベースの数字、レジストリの 289 件にはバージョンやルートのバリエーションも含まれます。
- 切り分けには順序がある:モデル ID → トークングループ → エンドポイント → パラメータの順に、一つずつ潰していきます。
- 画像パラメータはマッピングが必要:MAI は
width/height、Seedream はsizeを使い、透過の指定方法も異なります。 - ベクトルはモデル変更時に再構築が必須:small と large ではデフォルトの次元数が異なり、同じ次元数でも互換性はありません。
- HTTP 200 は成功とは限らない:完了理由(finish_reason)、空の本文、ツール呼び出しのみの返却をチェックしましょう。
- 性能は自分で測る:A-A ベースラインに A-B 交互測定を組み合わせれば、APIYI apiyi.com で同じ APIキーを使って比較検証が可能です。
まとめ
APIYI の統一インターフェースで大規模言語モデルを切り替えるうえで押さえたいポイント:
- 認証と接続先の再利用:1 つの APIキー、1 つの Base URL でテキスト・画像・ベクトルなど多彩な機能をカバーできます。
- 共通パラメータと固有パラメータを区別する:共通パラメータはそのまま切り替え、固有パラメータは一つずつ検証してから追加します。
- 切り替えを検証可能な作業にする:エラーコード対応表で切り分けを行い、決めた手順でレイテンシ・失敗率・課金額を記録します。
まずは最短のテキストのみのリクエストで 2 つのモデルが動くことを確認し、その後「画像パラメータのマッピング」→「ベクトルインデックスの再構築」→「ステートフルなツールフロー」の順に、実際の業務シナリオへ段階的に広げていくのがおすすめです。上記の検証は、まず APIYI apiyi.com の無料テストクレジットで済ませてから、メインモデルとフォールバック先を決めるとよいでしょう。
📚 参考資料
-
APIYI ドキュメントセンター:基本紹介、クイックスタート、モデルレジストリ、テキスト埋め込み、モデルバージョンの説明
- リンク:
docs.apiyi.com - 説明: モデルID、グループ、エンドポイント、料金に関する一次情報源。モデルレジストリは当日生成されたバージョンを基準にしてください
- リンク:
-
OpenAI Using GPT-6.2:GPT-6.2 への移行とパラメータの説明
- リンク:
developers.openai.com/api/docs/guides/latest-model - 説明: Responses のツール呼び出し、思考レベルフィールド、推論項目のライフサイクル
- リンク:
-
Google Gemini API トラブルシューティング&思考シグネチャのドキュメント:Gemini 4 の呼び出し問題の切り分けと対処
- リンク:
aistudio.google.com/docs/troubleshooting - 説明: 思考レベル、
thoughtSignatureの返送、よくあるエラー
- リンク:
-
Google Cloud Gemini 4 スタートガイド:Gemini 4 の長文デコードとAPIバージョンの説明
- リンク:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/start/get-started-with-gemini-4 - 説明: 長文デコードのAPIバージョンと再開条件について確認できます
- リンク:
-
Artificial Analysis モデル比較ページ:サードパーティ製モデルのベンチマークとレイテンシ測定方法
- リンク:
artificialanalysis.ai/models/comparisons/gemini-4-neon-vs-gpt-6-2-sol - 説明: モデル間の横断比較の参考用であり、API中継チャネルのコスト帰属には使用できません
- リンク:
著者:APIYI テクニカルチーム
技術交流:APIYI サイトのトップページからお気軽にお問い合わせください。その他の導入資料は docs.apiyi.com ドキュメントセンターをご覧ください