Nota do autor: este artigo mostra como enviar a primeira requisição ao Gemini 4 Neon na APIYI usando dois protocolos, e quais campos e logs conferir depois que a requisição for bem-sucedida.
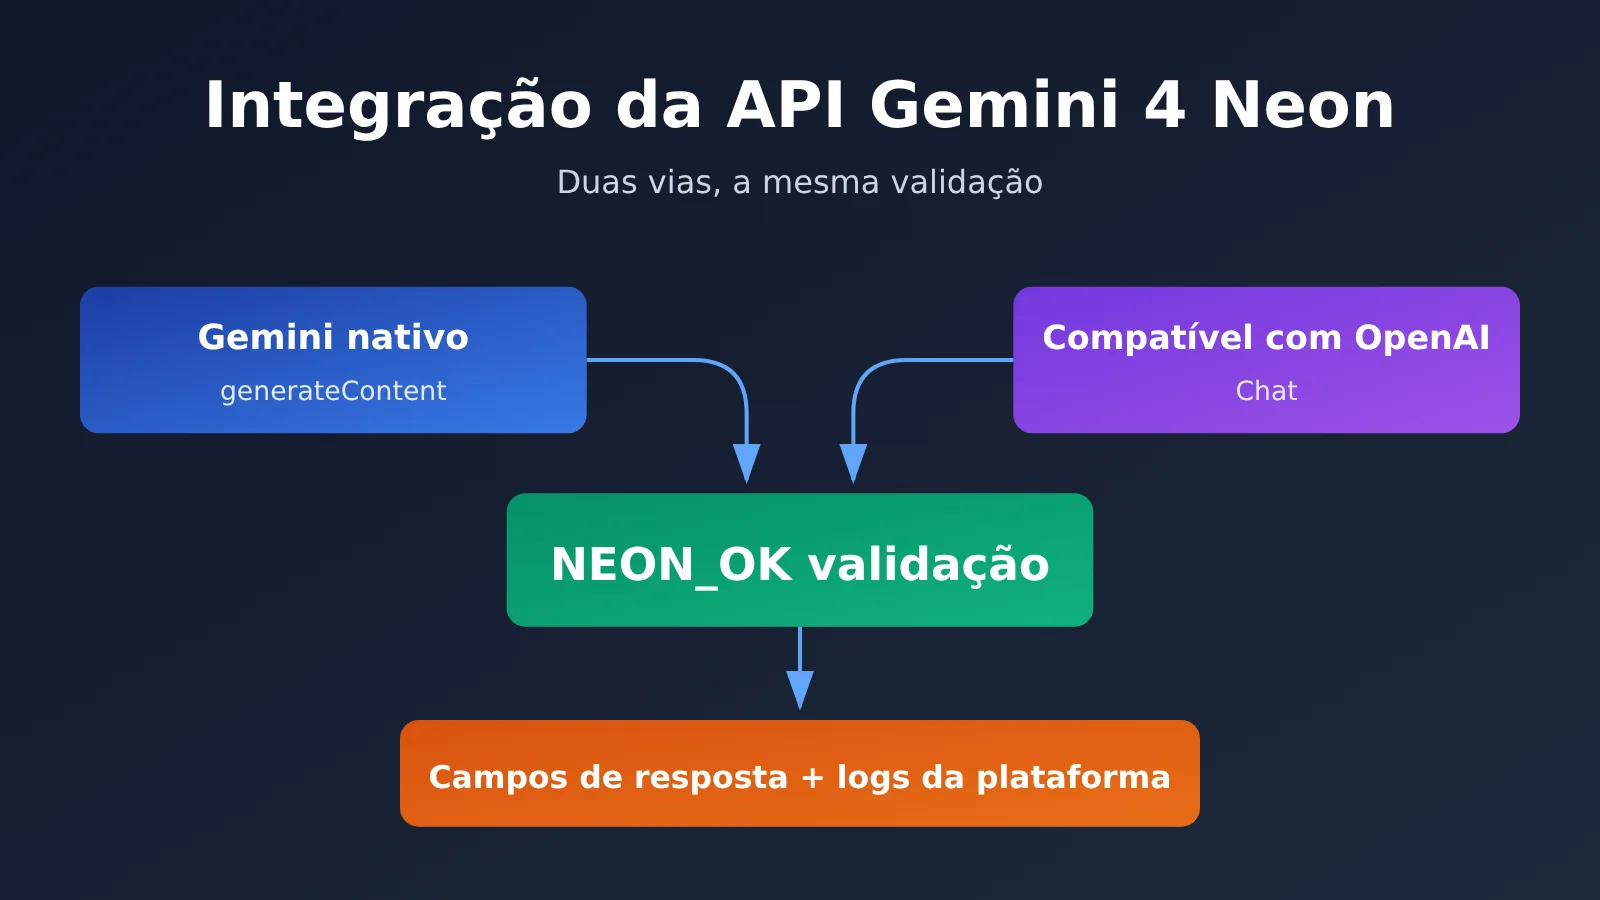
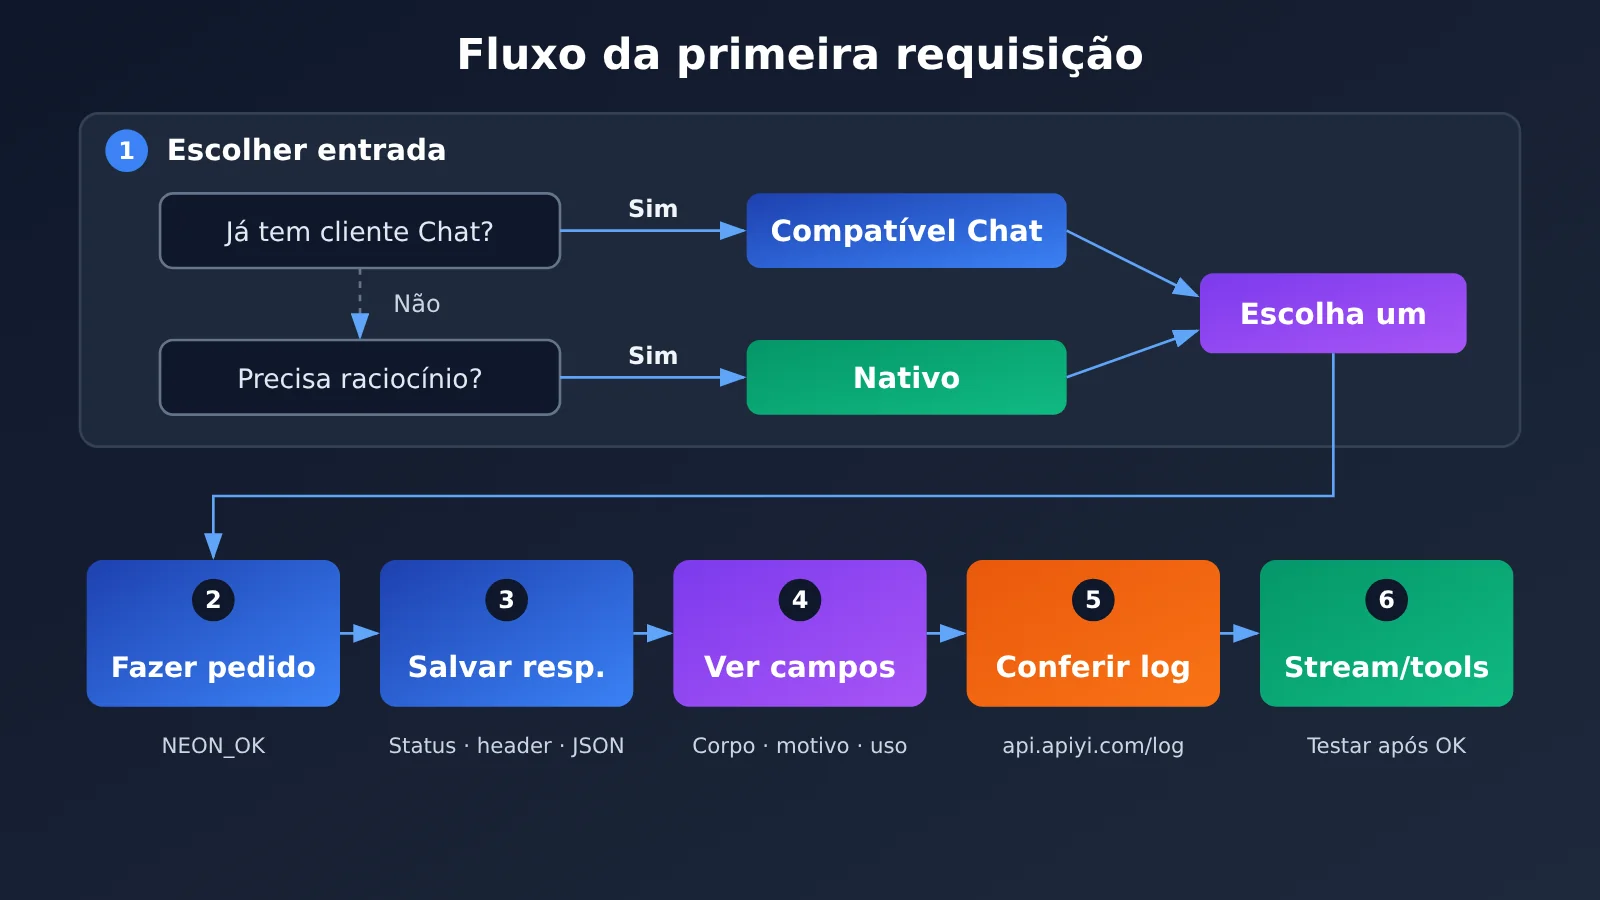
Conclusão antecipada: se o projeto já tem um cliente OpenAI Chat, use o endpoint Chat Completions compatível com OpenAI e troque apenas base_url e o nome do modelo. Se precisar definir explicitamente o nível de raciocínio do Gemini, use o endpoint nativo generateContent do Gemini e informe isso em generationConfig.thinkingConfig.thinkingLevel. Não importa o caminho escolhido: primeiro faça um teste de ponta a ponta com texto puro usando o mesmo comando curto; em seguida, valide com base no status HTTP, no corpo da resposta, no motivo de parada, no consumo e nos logs da plataforma. Depois que a validação passar, teste capacidades como saída em streaming e chamada de ferramentas.
O contexto é este. O Google publicou o Gemini 4 Neon no changelog do AI Studio em 18 de novembro de 2026 e anunciou sua disponibilidade geral (GA). A APIYI confirmou a disponibilização em 2026-11-20 às 11:45, horário de Pequim; o modelo gemini-4-neon aparece no catálogo público de preços, e os grupos disponíveis são default e svip. Os exemplos deste artigo foram escritos com base na documentação da APIYI e na documentação do SDK; nenhum endpoint pago foi chamado e o texto não traz estatísticas de testes reais.
Mapa de conhecimento e índice de integração da API Gemini 4 Neon
Todo o processo de integração tem três etapas: escolher o endpoint, enviar a requisição e conferir a saída e os logs. O resultado de cada etapa é a entrada da próxima. A tabela abaixo reúne a ordem dessas três etapas, a justificativa do arranjo e o objetivo de cada uma; ela serve tanto como mapa de conhecimento quanto como índice de leitura.
| Número | Etapa | O que a etapa anterior fornece | Por que está nessa ordem | Objetivo desta etapa |
|---|---|---|---|---|
| 1 | Escolher o endpoint (1.1 Chat compatível / 1.2 Nativo e nível de raciocínio) | Sua stack de código atual e a necessidade de definir o nível de raciocínio | O endpoint define a URL, a forma de autenticação e a estrutura dos campos; todas as etapas seguintes dependem dele | Definir um único protocolo e não tentar depurar dois caminhos ao mesmo tempo |
| 2 | Enviar a mesma requisição curta (2.1 cURL nativo / 2.2 SDK Python) | O endpoint e o formato de requisição já definidos | Usar um comando curto fixo permite eliminar diferenças de capacidade do modelo e testar apenas se o caminho está funcionando | Obter o código de status, os cabeçalhos e o corpo da resposta completos |
| 3 | Validação (3.1 Campos / 3.2 Identidade e logs / 3.3 Evidências de falha) | A resposta bruta salva na etapa 2 | Primeiro olhar a própria resposta, depois comparar com os logs da plataforma; as evidências vão do mais próximo ao mais distante | Determinar se o “sucesso textual” se confirma; se não, deixar evidências rastreáveis |
Sugestão de leitura: se você usa apenas um dos protocolos, depois de ler a subseção correspondente na seção 1, vá direto para 2.1 ou 2.2; a seção 3 precisa ser lida por inteiro.
Para saber: termos essenciais da API Gemini 4 Neon
| Termo | Explicação breve |
|---|---|
generateContent |
Endpoint de geração não streaming nativo do Gemini; o corpo da requisição organiza o conteúdo com contents e parts |
thinkingLevel |
Campo de nível de raciocínio dentro de generationConfig.thinkingConfig no endpoint nativo; nos exemplos deste artigo, usamos high |
| thought part | Parte da resposta nativa marcada como conteúdo de raciocínio; deve ser excluída ao montar o texto final |
finishReason / finish_reason |
Campos de motivo de parada dos endpoints nativo e compatível, respectivamente |
X-Shellapi-Request-Id |
Identificador de requisição retornado pelo APIYI no cabeçalho da resposta bruta ou na mensagem de erro, usado para solução de problemas |
1 Escolha do ponto de entrada para a API do Gemini 4 Neon
As duas entradas apontam para o mesmo modelo; a diferença está no formato do protocolo e nos parâmetros que podem ser controlados. A seguir, mostro primeiro uma comparação e depois explico os motivos da escolha em duas subseções.
| Item de comparação | Chat compatível com OpenAI | Gemini nativo |
|---|---|---|
| Endereço | https://api.apiyi.com/v1 + Chat Completions |
https://api.apiyi.com/v1beta/models/gemini-4-neon:generateContent |
| Indicado para | Projetos que já têm OpenAI SDK ou cliente Chat | Projetos que precisam controlar explicitamente parâmetros do Gemini |
| Nível de pensamento | Este artigo não envia os parâmetros relacionados | thinkingConfig.thinkingLevel |
| Local do texto principal | choices[0].message.content |
O text que não seja thought dentro de candidates[0].content.parts |
| Identificador do modelo | model na resposta |
modelVersion na resposta (se for retornado) |
1.1 Entrada compatível do Gemini 4 Neon: continue usando o cliente Chat atual
Quando o código existente já se baseia no OpenAI Python SDK ou em outro cliente Chat Completions, a abordagem com menos alterações é trocar base_url para https://api.apiyi.com/v1, usar o nome de modelo gemini-4-neon e não mexer na estrutura das mensagens. A vantagem é que o código da camada de negócios quase não muda e, quando surge um problema, fica mais fácil identificar se ele está na rede, na autenticação ou no modelo.
Há alguns limites que precisam ficar claros nesse caminho. Primeiro, não envie reasoning_effort. A própria camada de compatibilidade do Google faz um mapeamento para ele, mas isso não significa que a entrada compatível da APIYI também assuma o mesmo compromisso. Segundo, este artigo não usa a interface /v1/responses. Terceiro, a antiga forma de escrever thinkingBudget e o nível minimal também ficam fora do escopo deste artigo. Se você realmente precisa controlar o nível de pensamento, use a entrada nativa da seção 1.2.
1.2 Entrada nativa do Gemini 4 Neon: defina explicitamente o nível de pensamento
A entrada nativa usa a estrutura de requisição do próprio Gemini. O nível de pensamento é passado explicitamente por generationConfig.thinkingConfig.thinkingLevel; no caso de uso específico da APIYI, o valor usado é "high". A resposta nativa também separa o conteúdo de pensamento e o texto principal em partes diferentes; por isso, ao ler o texto principal, é preciso filtrar ativamente. A seção 2.1 mostra como fazer isso na prática.
Em relação à autenticação, este caso de uso nativo usa o cabeçalho Authorization: Bearer, sem usar o formato comum da API oficial do Gemini com o parâmetro key. Ao migrar código nativo existente, confira esse ponto primeiro.
2 Enviar a mesma requisição curta para a API Gemini 4 Neon
Os dois protocolos usam o mesmo prompt: Reply with exactly NEON_OK and nothing else. A saída esperada deste prompt é bem curta, então o resultado é fácil de avaliar. Se o retorno não for NEON_OK, isso já indica que há um problema na cadeia de chamada ou na etapa de análise, o que permite descartar interferências do tipo “o estilo de resposta do modelo é diferente”. A chave API deve sempre ser lida da variável de ambiente APIYI_API_KEY, nunca escrita no código nem no histórico de comandos.
2.1 cURL nativo do Gemini 4 Neon e extração de valores do JSON
O comando abaixo salva separadamente o código de status HTTP, os cabeçalhos de resposta e o corpo da resposta JSON. Os três serão usados na aceitação da seção 3.
curl -sS -X POST "https://api.apiyi.com/v1beta/models/gemini-4-neon:generateContent" \
  -H "Authorization: Bearer ${APIYI_API_KEY}" \
  -H "Content-Type: application/json" \
  -D neon_native_headers.txt \
  -o neon_native_body.json \
  -w "%{http_code}\n" \
  -d '{
    "contents": [
      {"role": "user", "parts": [{"text": "Reply with exactly NEON_OK and nothing else."}]}
    ],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "high"}
    }
  }' > neon_native_status.txt
Ao ler o corpo, é preciso concatenar todos os text que não são de thought em candidates[0].content.parts, e não apenas pegar o primeiro part. O exemplo abaixo usa jq; se você não tiver o jq instalado, pode usar qualquer outra ferramenta de análise de JSON:
# Corpo: concatenar os text que não são thought
jq -r '[.candidates[0].content.parts[]? | select(.thought != true) | .text // empty] | join("")' neon_native_body.json

# Motivo de parada, uso e versão do modelo (quando o campo não existe, a saída é null; não preencha valores por conta própria)
jq '{finishReason: .candidates[0].finishReason, usageMetadata, modelVersion}' neon_native_body.json

# Identificador da requisição da plataforma
grep -i "x-shellapi-request-id" neon_native_headers.txt
2.2 Chamada do Gemini 4 Neon com o SDK Python da OpenAI e leitura do retorno
O endpoint compatível usa with_raw_response, assim você obtém tanto o objeto já analisado quanto os cabeçalhos de resposta originais. O max_retries=0 serve para desativar as novas tentativas automáticas do SDK, evitando que uma falha seja mascarada por uma nova tentativa e também impedindo que apareçam vários logs na plataforma, dificultando saber qual deles corresponde a qual requisição.
import os
from openai import OpenAI, APIStatusError, APIConnectionError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",  # Endpoint compatível com OpenAI da APIYI
    max_retries=0,
    timeout=120.0,
)

try:
    raw = client.chat.completions.with_raw_response.create(
        model="gemini-4-neon",
        messages=[{"role": "user", "content": "Reply with exactly NEON_OK and nothing else."}],
        max_tokens=4096,
    )
    print("HTTP:", raw.status_code)
    print("X-Shellapi-Request-Id:", raw.headers.get("x-shellapi-request-id"))

    completion = raw.parse()
    if not completion.choices:
        print("choices 为空,不读取正文")
    else:
        choice = completion.choices[0]
        print("content:", choice.message.content)
        print("finish_reason:", choice.finish_reason)
    print("usage:", completion.usage)
    print("model:", completion.model)

except APIStatusError as e:
    print("HTTP:", e.status_code)
    print("X-Shellapi-Request-Id:", e.response.headers.get("x-shellapi-request-id"))
    print("error:", e.message)  # Antes de registrar, confirme que não contém chaves ou outras informações sensíveis
except APIConnectionError as e:
    print("未拿到 HTTP 响应:", type(e).__name__)
Há um ponto que merece atenção especial neste código: quando choices está vazio, não escreva choices[0] diretamente, senão será lançado um erro de índice que mascara o problema real. Erros de conexão não têm código de status HTTP nem cabeçalhos de resposta, então precisam ser tratados separadamente dos APIStatusError.
3 Verificação da primeira requisição da API Gemini 4 Neon
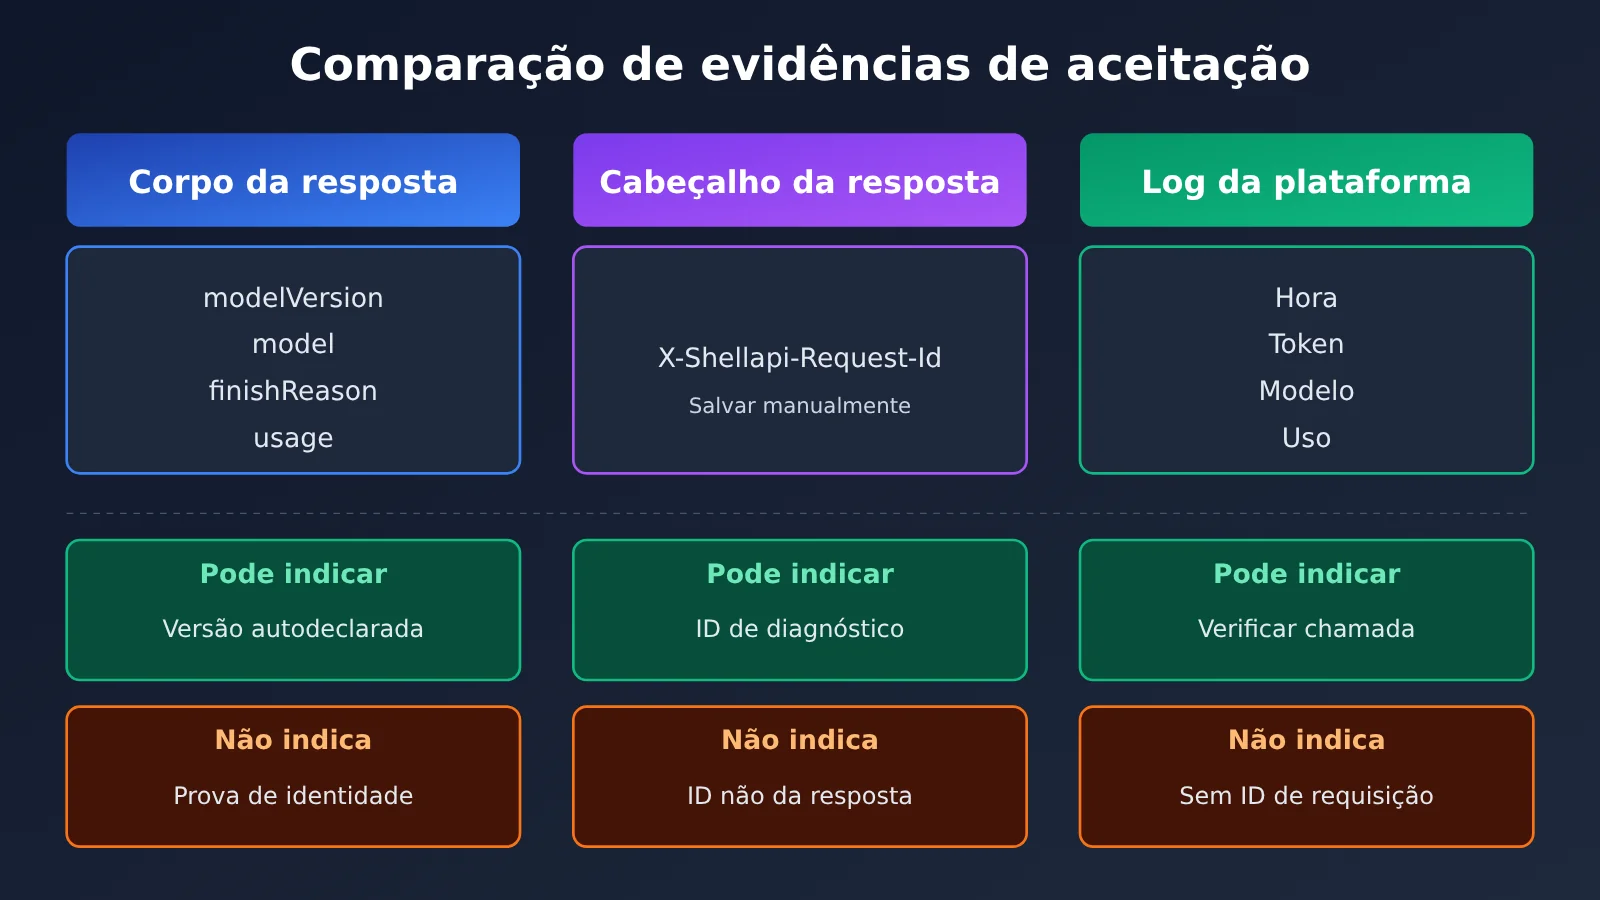
O objetivo da verificação é determinar se “a requisição de texto puro foi bem-sucedida” de fato. Um status HTTP 2xx com o corpo sendo o NEON_OK esperado apenas indica que essa única requisição de texto funcionou. Isso não comprova a identidade do modelo, nem serve como resultado de teste de desempenho.
3.1 Status HTTP, corpo, motivo de parada e uso
| Item de verificação | Campo nativo | Campo compatível | Condição de aprovação |
|---|---|---|---|
| Status HTTP | status salvo | raw.status_code |
2xx |
| Corpo | concatenação de text que não seja thought |
choices[0].message.content |
igual a NEON_OK |
| Motivo de parada | candidates[0].finishReason |
choices[0].finish_reason |
registrado e consistente com a situação do corpo |
| Uso | usageMetadata |
usage |
registrado, para comparação com os logs |
Se algum campo não existir na resposta, registre-o como “não retornado” e não tente deduzir seu valor por experiência. O motivo de parada deve ser analisado junto com o corpo. Quando o corpo está vazio e o motivo de parada não é um encerramento normal, o problema geralmente está no processo de geração, não no código de parsing.
3.2 O que o modelVersion nativo, o model compatível e os logs podem comprovar
Essas informações têm alcances diferentes de comprovação. Ao registrá-las, não trate uma como substituta da outra:
| Informação | Origem | Pode comprovar | Não pode comprovar |
|---|---|---|---|
modelVersion |
corpo da resposta nativa (se retornado) | a versão do modelo informada pela própria resposta | não serve, sozinho, como prova de identidade |
model |
corpo da resposta compatível | o nome do modelo informado pela própria resposta | o mesmo acima |
| Logs da plataforma | api.apiyi.com/log |
conferir esta chamada por horário, token, modelo e uso | o console não exibe o ID da requisição |
X-Shellapi-Request-Id |
cabeçalho da resposta original ou mensagem de erro | identificador da requisição usado pela plataforma para diagnóstico | não é o responseId, nem o id do Chat, nem o _request_id do SDK |
Ao conferir os logs, use o horário em que a requisição foi enviada, o token utilizado, o nome do modelo gemini-4-neon e os números de uso para fazer a correspondência. Como o console não exibe o ID da requisição, o X-Shellapi-Request-Id precisa ser salvo por você mesmo a partir dos cabeçalhos da resposta; depois, não será possível consultá-lo no console.
3.3 Gemini 4 Neon: como preservar evidências quando não há corpo de resposta ou a requisição falha
Quando a requisição falhar ou não houver corpo de resposta, não tente novamente de imediato. Siga a ordem abaixo para guardar as evidências:
- Salve o código de status HTTP. Se for erro de conexão, anote o tipo de exceção.
- Salve os cabeçalhos brutos da resposta e extraia deles o
X-Shellapi-Request-Id. - Salve o corpo bruto da resposta ou a mensagem de erro, removendo conteúdos sensíveis como a chave API.
- Registre o motivo de parada e o uso (se houver), além do horário em que a requisição foi enviada, o nome do token usado e o nome do modelo.
- Acesse
api.apiyi.com/log, encontre o registro correspondente por horário e token e, com os materiais acima em mãos, siga a documentação de solução de problemas por request ID da plataforma.
Sobre a resposta nativa há mais um ponto de atenção: se os parts contiverem apenas conteúdo de thought, o corpo filtrado ficará vazio. Nesse caso, registre fielmente “corpo filtrado vazio” e não trate o conteúdo de thought como corpo só para conseguir uma saída.
Depois que a verificação de texto puro em um único turno passar conforme explicado acima, valide, conforme a necessidade do projeto, recursos como saída em streaming e chamada de ferramentas. A cada recurso adicionado, faça uma verificação separada usando o método “mesma requisição, salvar a resposta bruta, conferir com o log”. Este artigo não trata de benchmarks nem de preços; para essas informações, consulte os anúncios oficiais e o catálogo público da APIYI.
Referências
- Changelog do Google AI Studio (2026-11-18):
aistudio.google.com/docs/changelog - Estrutura do GenerateContentResponse do Gemini:
aistudio.google.com/api-reference/generate-content - Comunicado de lançamento do Gemini 4 Neon na APIYI e exemplos dos dois protocolos:
docs.apiyi.com/news/gemini-4-neon-launch.md - Tratamento de resposta do Gemini na APIYI:
docs.apiyi.com/api-capabilities/gemini/response-handling - Tratamento de resposta compatível com OpenAI na APIYI:
docs.apiyi.com/api-capabilities/openai/response-handling - Solução de problemas por request ID na APIYI:
docs.apiyi.com/faq/request-id-troubleshooting - Acesso à resposta bruta no openai-python:
github.com/openai/openai-python
Uma jornada de mil milhas começa com um único passo. — Tao Te Ching