Nota del autor: en este artículo logramos cambiar de Modelo de Lenguaje Grande usando la misma clave API y un punto de entrada compatible con OpenAI, y explicamos con claridad los campos, los estados y los criterios de aceptación que requieren adaptación individual al integrar imágenes y Embeddings entre distintos modelos.
En este artículo usaremos una sola clave API y un punto de entrada compatible con OpenAI para dejar funcionando el cambio entre modelos de solo texto; después, con dos ejemplos —imágenes y vectores—, explicaremos qué campos, estados y criterios de aceptación de la integración entre modelos exigen una adaptación individual. Eso sí, la conclusión tiene una condición previa: mientras en el mismo endpoint se utilicen únicamente parámetros comunes que ambos modelos admitan, cambiar de modelo normalmente solo requiere modificar el campo model. En cuanto entren en juego parámetros de razonamiento propietarios, llamadas a herramientas, tamaños de imagen o dimensiones de vector, habrá que verificar cada punto según el modelo.
Este no es un artículo promocional del estilo «cambia una línea de código y todo quedará resuelto». Vamos a separar con claridad lo que puede reutilizarse gracias a la interfaz unificada de APIYI de lo que hay que volver a validar, y también describiremos los escenarios de fallo.
Valor clave: al terminar de leer este artículo, podrás cambiar de modelos de texto con la misma autenticación y el mismo código, sabrás qué parámetros ajustar al cambiar de modelo en imágenes y Embeddings, y contarás con un método práctico de validación de cambios de modelo, listo para aplicar.
9 términos clave antes de cambiar de Modelo de Lenguaje Grande con la interfaz unificada de APIYI
La mayoría de los problemas que aparecen al cambiar de modelo se deben a interpretaciones distintas de una misma terminología. Por ejemplo, escribir la Base URL con /v1 dos veces, o creer que vectores de la misma dimensión se pueden mezclar. Primero unifica este conjunto de conceptos: todos los pasos que siguen se apoyan en estas definiciones.
| Término | Significado real | Qué tener en cuenta al cambiar |
|---|---|---|
| Base URL | Dirección raíz que el SDK utiliza para construir las rutas de la API | En el SDK de OpenAI, complétala solo hasta /v1 para evitar duplicarla |
| API Key | Credencial de autenticación para las solicitudes a la API | Guárdala únicamente en la configuración del servidor o en variables de entorno |
| ID del modelo | Modelo especificado en la solicitud; puede incluir información de versión o de canal | Copia el ID original desde el registro de modelos; no lo escribas a mano |
| Grupo de tokens | Determina los modelos, canales y condiciones de facturación disponibles para la clave actual | Si el modelo no está en el grupo, se devuelve 401/403 o 404 |
| Chat Completions | Protocolo de interfaz para conversaciones de texto basadas en un array de mensajes | Puerta de entrada principal para cambios de solo texto |
| Responses | Protocolo de interfaz compatible con múltiples tipos de salida y llamadas a herramientas | Las llamadas a herramientas de GPT-6.2 deben ir por aquí |
| Embedding | Codifica el contenido en vectores de dimensión fija, utilizados para búsquedas y otras tareas de similitud | Cambiar de modelo equivale a cambiar de espacio vectorial |
| Índice vectorial | Estructura que busca elementos similares según una dimensión y un espacio vectorial concretos | Debe reconstruirse ante cualquier cambio de dimensión o de modelo |
| Latencia del primer token visible | Tiempo de espera desde que se envía la solicitud hasta que el usuario ve el primer fragmento válido de contenido generado | El tiempo de razonamiento de los modelos de inferencia alarga esta métrica |
De todos ellos, el «grupo de tokens» es el que más se suele pasar por alto. Con una misma cuenta, las claves de distintos grupos pueden ver listas de modelos diferentes; por eso, al depurar un error de «el modelo no existe», lo primero es verificar el grupo al que pertenece la clave, en lugar de sospechar directamente del código.
Puntos clave para cambiar entre Modelos de Lenguaje Grandes con la interfaz unificada de APIYI
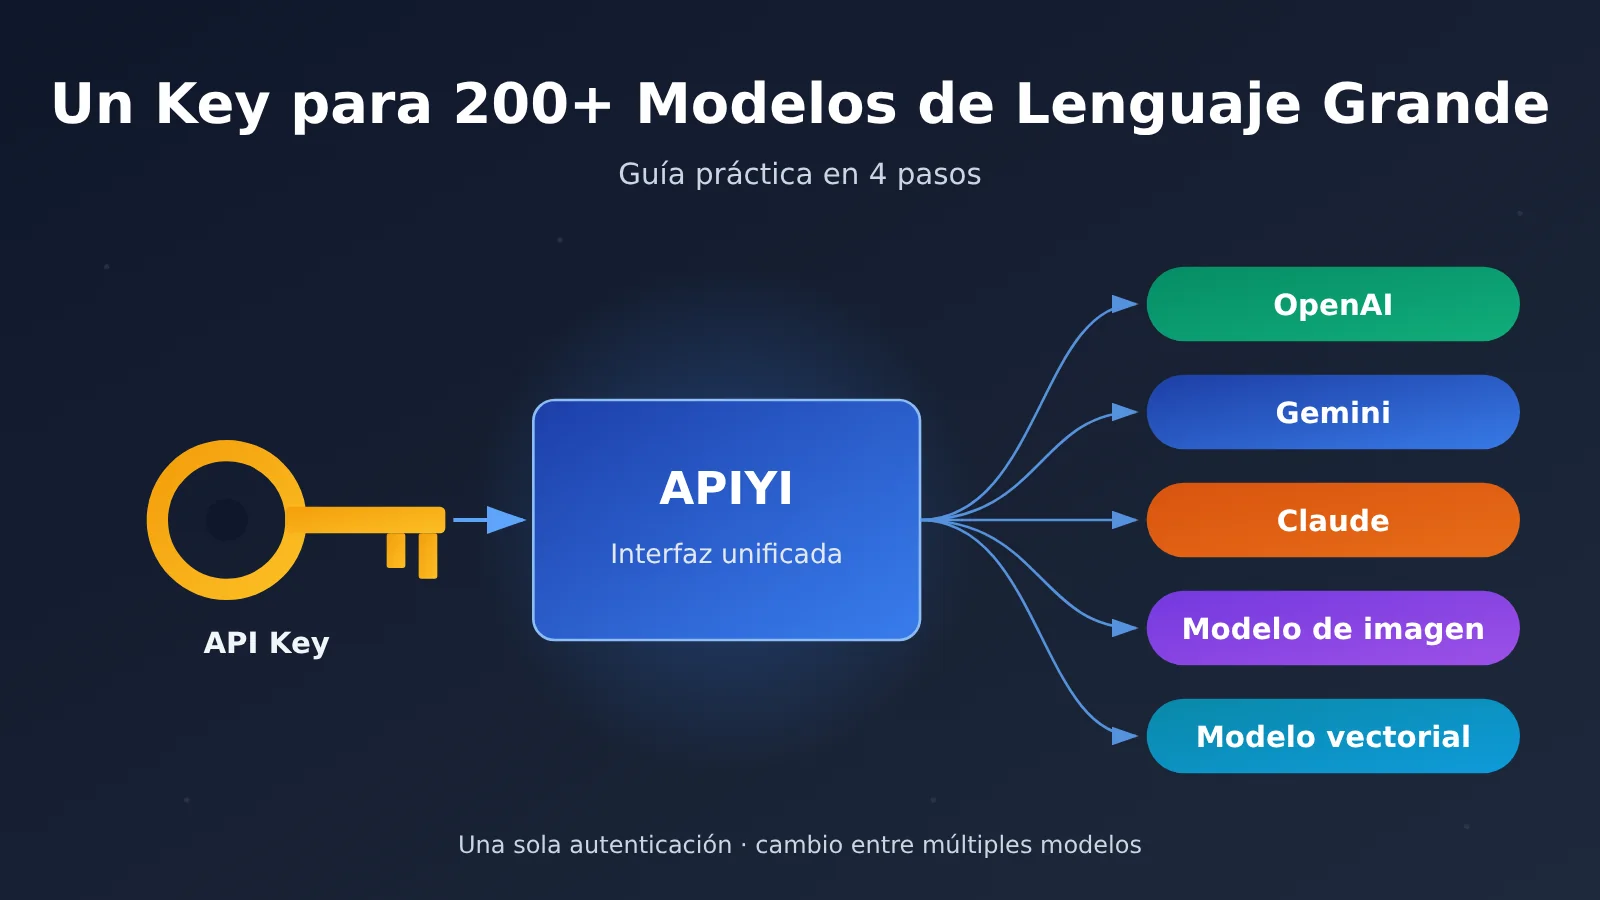
Lo que la integración unificada realmente ahorra es el «trabajo repetitivo»: no hace falta registrarse por separado en cada proveedor, gestionar varias claves ni adaptarse a múltiples SDK. Según la introducción básica y la documentación de inicio rápido de APIYI (apiyi.com), con una sola configuración de autenticación y un punto de acceso compatible con OpenAI ya puedes acceder a los modelos disponibles de distintos proveedores.
| Aspecto | Qué se puede reutilizar | Qué hay que verificar según el modelo |
|---|---|---|
| Autenticación | La misma clave API y el mismo conjunto de cabeceras | Si el grupo de tokens al que pertenece la clave incluye el modelo objetivo |
| Punto de acceso | La misma Base URL | Qué endpoints admite el modelo objetivo (chat / Responses / imágenes / embeddings) |
| Cuerpo de la solicitud | Campos comunes como model, messages básico, input |
Niveles de razonamiento, herramientas, salidas estructuradas, tamaño de imagen, dimensiones de embeddings |
| Manejo de la respuesta | La lógica de análisis de choices, finish_reason, usage |
Casos especiales: cuerpo vacío, solo llamadas a herramientas, filtrado de seguridad, etc. |
| Facturación | El mismo saldo y las mismas facturas de la cuenta | El precio unitario, los niveles de precio y el método de facturación de caché varían según el modelo |
200+ y 289: las dos cifras sobre el número de modelos de APIYI
En su introducción pública, APIYI indica que integra más de 200 modelos seleccionados. Sin embargo, en el registro público de modelos generado el 2026-11-20, el campo model_count muestra 289. Ambas cifras no se contradicen: el conteo del registro incluye distintas versiones del mismo modelo y diferentes variantes de línea, por lo que el número de entradas supera al de «modelos seleccionados».
Ten en cuenta que la lista que un token puede invocar en la práctica está sujeta a una triple restricción: el grupo, la autorización de modelos y los endpoints. Que cierto ID figure en el registro no significa que la clave que tienes pueda invocarlo necesariamente.
Orden de verificación antes de cambiar
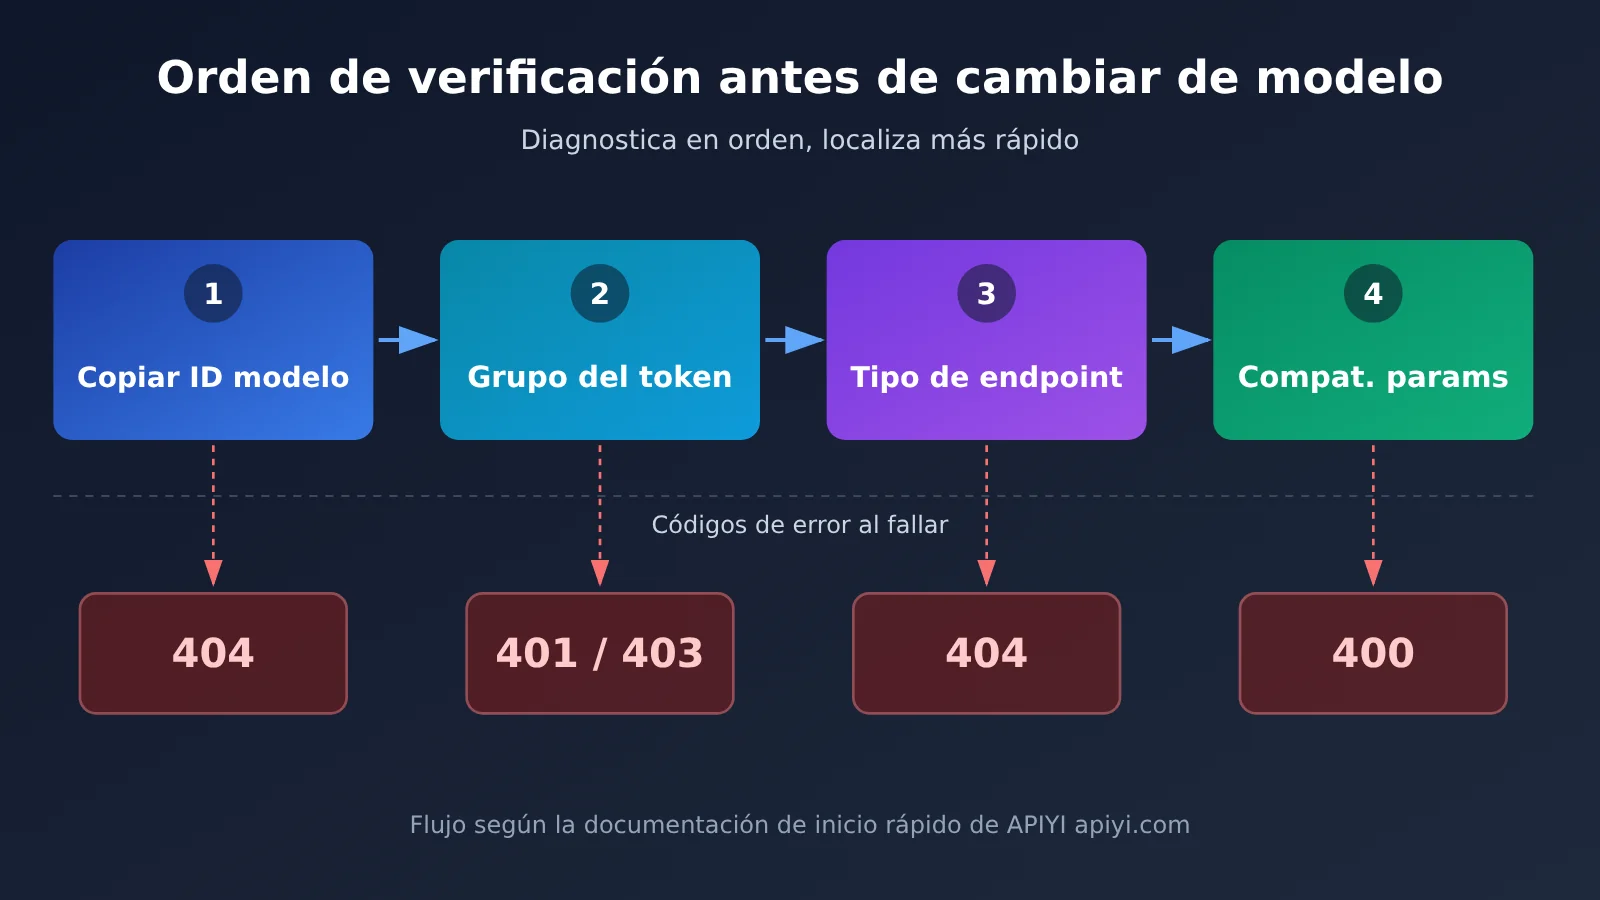
Se recomienda comprobar siempre en el mismo orden cada vez que incorpores un nuevo modelo, para evitar tener que depurar en varias direcciones a la vez cuando surge un error:
- Verificar el ID del modelo: copia el ID original del registro de modelos del día y confirma que mayúsculas, minúsculas y guiones coincidan exactamente.
- Verificar el grupo del token: confirma que el grupo al que pertenece tu clave actual tenga habilitado ese modelo; por ejemplo, algunos modelos solo se publican en grupos específicos.
- Verificar los endpoints: confirma que el modelo admita el tipo de interfaz que quieres invocar; los endpoints de texto, imágenes y embeddings son distintos entre sí.
- Verificar los parámetros: conserva solo los parámetros comunes que ambos modelos admitan y vuelve a añadir los parámetros propietarios uno a uno para validarlos.
Cómo cambiar rápidamente de Modelo de Lenguaje Grande de texto con la interfaz unificada de APIYI
A continuación, tomemos como ejemplo dos modelos de texto accesibles a través de Chat Completions: gemini-4-neon y gpt-6.2-sol. Ambos usan POST /v1/chat/completions; cuando solo trabajas con el parámetro básico messages, cambiar de uno a otro se reduce a sustituir el campo model. Eso sí: tu grupo de claves debe tener visibilidad sobre estos dos modelos, así que confírmalo en el registro antes de hacer la invocación.
Ejemplo mínimo: cambiar entre dos modelos con el mismo código
Configura la Base URL como https://api.apiyi.com/v1 y lee la clave API desde una variable de entorno:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],     # guardar solo en variables de entorno del servidor
    base_url="https://api.apiyi.com/v1",     # punto de entrada de APIYI compatible con OpenAI
)

for model in ["gemini-4-neon", "gpt-6.2-sol"]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是向量索引"}],
    )
    choice = resp.choices[0]
    print(model, "| finish_reason:", choice.finish_reason, "| usage:", resp.usage)
    print(choice.message.content or "<空正文>")
Revisa los campos de la respuesta, no te fíes solo del HTTP 200
Una vez que recibes la respuesta, revisa al menos tres puntos: si choices[0].message.content está vacío; si finish_reason terminó con stop o por truncamiento de longitud u otra causa; y si el consumo de tokens indicado en usage es razonable. Los modelos de razonamiento también consumen parte del presupuesto de salida con su proceso de pensamiento, así que cuando el presupuesto es muy pequeño puede darse el caso de «HTTP 200 pero con el cuerpo vacío».
Además, el nombre con el que el modelo se identifica en el cuerpo de la respuesta no sirve como base para verificar el modelo real que hay detrás. Cuando necesites confirmar qué modelo se invocó realmente, lo primero es revisar el ID de la solicitud, los metadatos de la respuesta y los registros de facturación.
Ver el código de implementación completo: con latencia del primer token en streaming, reintentos con backoff y registro de métricas
import os
import time
import random
from openai import OpenAI, RateLimitError, APIStatusError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",   # Interfaz unificada de APIYI
)

def call_once(model: str, prompt: str, max_retries: int = 3) -> dict:
    """Realiza una invocación en streaming y registra la latencia del primer token visible, el tiempo total y el motivo de finalización"""
    for attempt in range(max_retries + 1):
        start = time.perf_counter()
        first_token_at = None
        parts, finish_reason, usage = [], None, None
        try:
            stream = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
                stream=True,
                stream_options={"include_usage": True},
            )
            for chunk in stream:
                if chunk.usage:
                    usage = chunk.usage
                if not chunk.choices:
                    continue
                delta = chunk.choices[0].delta
                if delta and delta.content:
                    if first_token_at is None:
                        first_token_at = time.perf_counter()
                    parts.append(delta.content)
                if chunk.choices[0].finish_reason:
                    finish_reason = chunk.choices[0].finish_reason
            end = time.perf_counter()
            return {
                "model": model,
                "ok": bool(parts),
                "ttft_s": round(first_token_at - start, 3) if first_token_at else None,
                "total_s": round(end - start, 3),
                "finish_reason": finish_reason,
                "usage": usage,
                "text": "".join(parts),
            }
        except RateLimitError:
            # Backoff exponencial con jitter y un número limitado de intentos, solo para límites de tasa temporales
            if attempt == max_retries:
                raise
            time.sleep((2 ** attempt) + random.uniform(0, 0.5))
        except APIStatusError as e:
            # 400/401/403/404 son problemas de configuración o de parámetros; reintentar no sirve de nada
            return {"model": model, "ok": False, "status": e.status_code,
                    "error": str(e)[:300]}

if __name__ == "__main__":
    prompt = "用三句话说明向量索引为什么要和 Embedding 模型绑定"
    for m in ["gemini-4-neon", "gpt-6.2-sol"]:
        r = call_once(m, prompt)
        print({k: v for k, v in r.items() if k != "text"})
🚀 Inicio rápido: te recomendamos ejecutar primero el ejemplo minimalista de arriba en APIYI (apiyi.com) con el crédito de prueba gratuito para nuevos usuarios, y comprobar que ambos IDs de modelo devuelven contenido bajo el grupo de tu token, antes de integrarlo en el código de tu aplicación.
Los parámetros propietarios requieren verificación por separado
Los ejemplos anteriores usaron deliberadamente solo campos comunes. En cuanto agregues los siguientes parámetros, ya no puedes asumir que «con cambiar el model basta»:
- Serie GPT-6.2: en la API de OpenAI,
gpt-6.2-astraygpt-6.2-soladmiten tanto Chat Completions como Responses. En Chat Completions, el campo del nivel de razonamiento esreasoning_effort, mientras que en Responses esreasoning.effort; ambos modelos rechazan el valornone. Si necesitas llamadas a herramientas, debes pasar a Responses. - Serie Gemini 4:
gemini-4-neonadmite tanto la solución nativa de Gemini de APIYI como el modo de chat compatible con OpenAI. El REST nativo usa/v1beta/models/{id}:generateContent, y el nivel de razonamiento se especifica engenerationConfig.thinkingConfig.thinkingLevel, con los valores posibleslow,medium,highyxhigh, siendohighel predeterminado. El antiguothinkingBudgety el valorminimalno aplican a Gemini 4; la documentación de Google también indica que Gemini 4 ignoratemperatureytopP. - Salidas estructuradas y herramientas: las restricciones de JSON Schema y los formatos de definición de herramientas pueden no coincidir entre ambos lados; verifícalos uno por uno según la documentación del modelo de destino.
Vale la pena aclarar que, según las notas de lanzamiento de APIYI sobre Neon, al momento de la puesta en marcha solo se verificó la interfaz de precios y no se realizaron invocaciones reales previas. Por lo tanto, el comportamiento de los dobles endpoints y de las llamadas a herramientas descrito arriba se basa en la documentación: antes de usarlo en producción, haz tu propia verificación con solicitudes mínimas.
Cambio entre capacidades con la interfaz unificada de APIYI: comparación de imagen y Embedding
Más allá del diálogo por texto, las imágenes y los vectores son los escenarios entre modelos más habituales, y también donde «cambiar solo el model» falla con mayor facilidad. Los dos ejemplos siguientes corresponden, respectivamente, a dos tipos de problemas: «estructura de parámetros distinta» y «espacio de resultados distinto».
Cambio entre modelos de imagen: MAI-Image-2.7 y Seedream 5.5
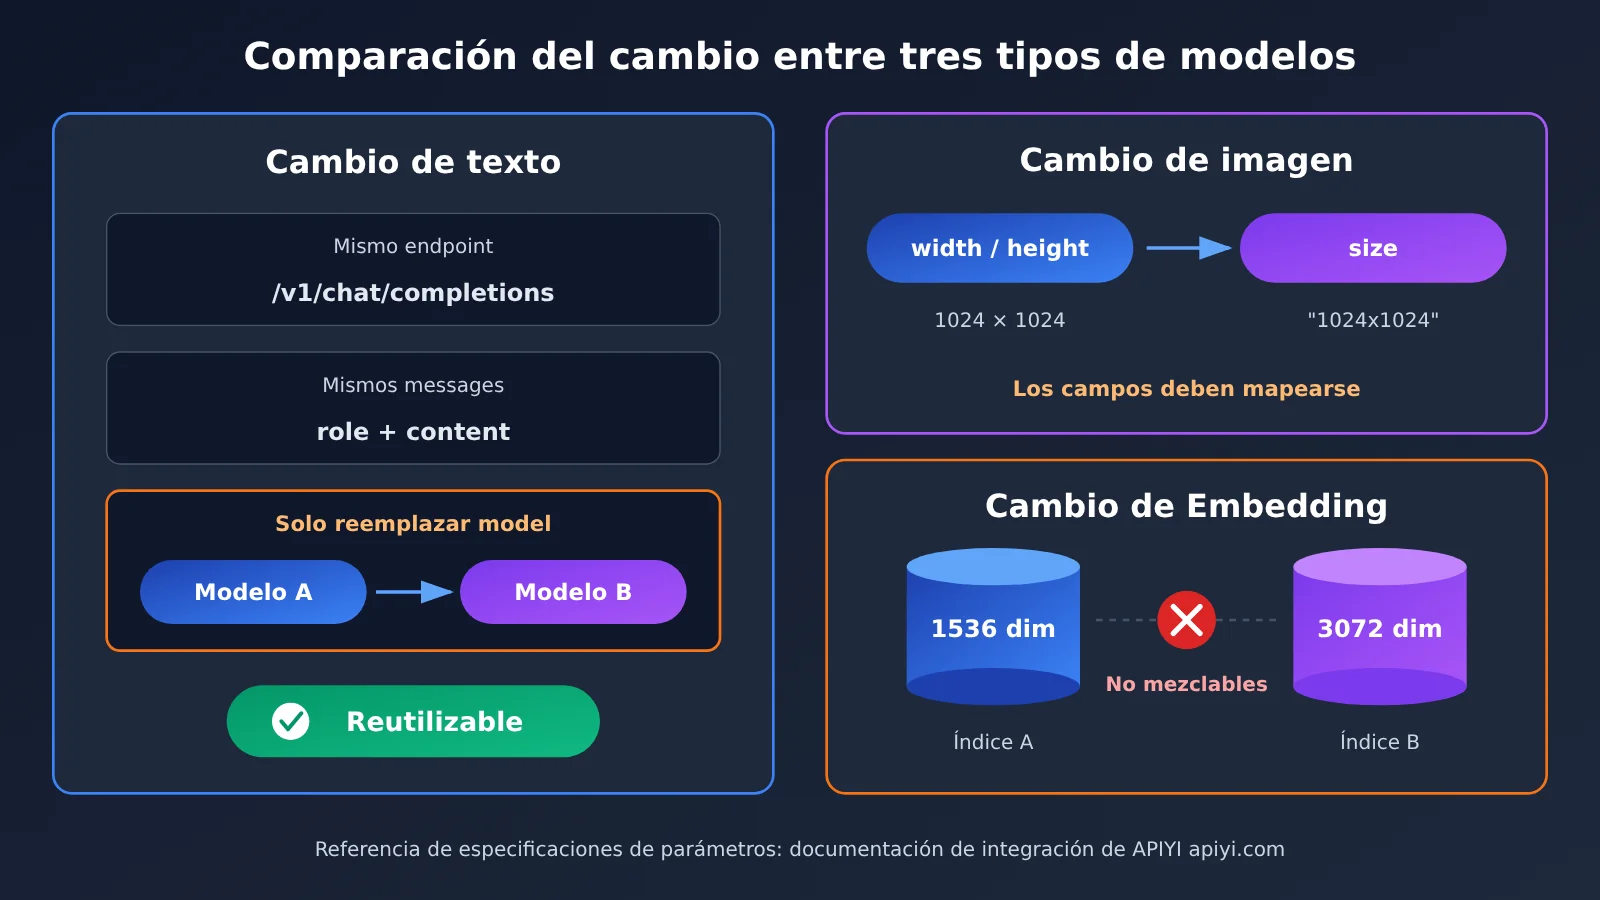
Ambos modelos se pueden invocar con la capacidad Images de la misma clave API, pero la forma de escribir el tamaño, las imágenes de referencia y la salida transparente es completamente distinta:
| Dimensión | MAI-Image-2.7 | Seedream 5.5 |
|---|---|---|
| Endpoint | La generación va por generations y la edición por edits |
Tanto el texto puro como las imágenes de referencia van por generations |
| Parámetro de tamaño | width y height controlan el total de píxeles; el límite anunciado es de 4,194,304 píxeles |
size selecciona el nivel de precio; si se omite, se aplica la tarifa 2K |
| Imagen de referencia | Hasta 5 imágenes de referencia en modo edición | La imagen de referencia va en el campo image |
| Salida transparente | background: "transparent", devuelve un PNG con canal alfa |
Debe indicarse a la vez background: "transparent" y output_format: "png" |
| Precios | Facturación independiente | Facturación independiente según el nivel de size |
| Plataformas disponibles | APIYI apiyi.com (conforme al registro y a los grupos) | APIYI (conforme al registro y a los grupos) |
Al invocarlos, conviene mantener una función de mapeo de parámetros por modelo, en lugar de armar los campos directamente en la capa de negocio:
# Reutiliza el client de la sección anterior; copia el ID del modelo desde el registro del día
def build_image_kwargs(model: str, prompt: str, transparent: bool = False) -> dict:
    if model.startswith("MAI-Image"):
        body = {"width": 1024, "height": 1024}
        if transparent:
            body["background"] = "transparent"
        return {"model": model, "prompt": prompt, "extra_body": body}
    # Seedream 5.5: size determina el nivel de precio; los valores válidos figuran en la documentación de integración
    body = {"size": "2K"}
    if transparent:
        body.update({"background": "transparent", "output_format": "png"})
    return {"model": model, "prompt": prompt, "extra_body": body}

img = client.images.generate(**build_image_kwargs("MAI-Image-2.7", "扁平风格的钥匙图标", True))
En ambos modelos hay que validar por separado las imágenes transparentes, el efecto de las imágenes de referencia, el formato de respuesta y los costos; los resultados de aceptación de uno no pueden sustituir a los del otro.
Cambiar de modelo de Embedding: small y large no se pueden mezclar directamente
La forma de invocación para vectorizar sí está unificada: ambas pasan por POST /v1/embeddings, y basta con enviar model e input.
for m in ["text-embedding-3-small", "text-embedding-3-large"]:
    e = client.embeddings.create(model=m, input=["统一接口切换模型"])
    print(m, "维度:", len(e.data[0].embedding))   # por defecto son 1536 y 3072 respectivamente
El problema está en el resultado. text-embedding-3-small genera 1536 dimensiones por defecto y text-embedding-3-large 3072, y vectores con dimensiones distintas no pueden convivir en el mismo índice. Aunque uses el parámetro dimensions para reducir large a 1536 dimensiones, los espacios vectoriales de ambos modelos no son compatibles entre sí: la similitud entre los vectores de los documentos antiguos y los vectores de las consultas nuevas no significa nada.
Por eso, la forma correcta de cambiar de modelo de Embedding es: crear un índice vectorial nuevo, volver a vectorizar todos los documentos antiguos, cambiar de modelo también en el lado de las consultas y, por último, recalibrar el umbral de similitud con un lote de muestras etiquetadas. Este costo supera con creces el de cambiar una línea de model, y conviene tenerlo en cuenta desde la fase de selección.
Cómo validar el cambio de modelo con la interfaz unificada de APIYI
Antes de poner el cambio en producción, hay que pasar de «que la llamada funcione» a «que se pueda validar». La validación tiene dos partes: la depuración de códigos de error y la comparación de métricas.
Tabla de referencia para depurar códigos de error
Para depurar, lo primero es fijar una solicitud mínima y reproducirla de forma estable con la misma Key, el mismo nodo, el mismo endpoint y el mismo ID de modelo:
| Síntoma | Causa habitual | Verificación y corrección |
|---|---|---|
| 400 | Campos exclusivos del modelo anterior, parámetros de herramientas, salida estructurada o formatos de imagen incompatibles | Elimina los campos no imprescindibles y vuelve a añadirlos uno a uno para localizar el problema |
| 401/403 | Formato de token incorrecto, el grupo no incluye ese modelo o el modelo no está en la lista blanca | Verifica la Key, el grupo del token y la lista blanca de modelos |
| 404 | El SDK concatena /v1 dos veces, o el modelo no corresponde a ese tipo de interfaz |
En el SDK de OpenAI la Base URL lleva /v1; con el SDK de Google GenAI usa la dirección raíz sin /v1 y configura v1beta; copia el ID original del modelo |
| 429 | Límite de peticiones a corto plazo, concurrencia excedida o cuota insuficiente | Lee primero el cuerpo del error; ante un límite de peticiones a corto plazo, usa un número limitado de reintentos con backoff exponencial y jitter; si es un problema de cuota, corrígelo antes de reenviar |
| 200 pero con cuerpo vacío | El presupuesto de salida se agotó en el razonamiento, filtro de seguridad o solo se devolvió la llamada a la herramienta | Revisa el motivo de finalización y el tipo de retorno, y amplía el presupuesto de salida; haz una prueba de control con la solicitud más corta sin herramientas |
En los flujos de herramientas de varias rondas con Gemini 4, comprueba además que el thoughtSignature de la respuesta se devuelve tal cual, y que las llamadas a herramientas y sus resultados se correspondan uno a uno.
Registrar métricas para distinguir las diferencias entre modelos y la sobrecarga del canal
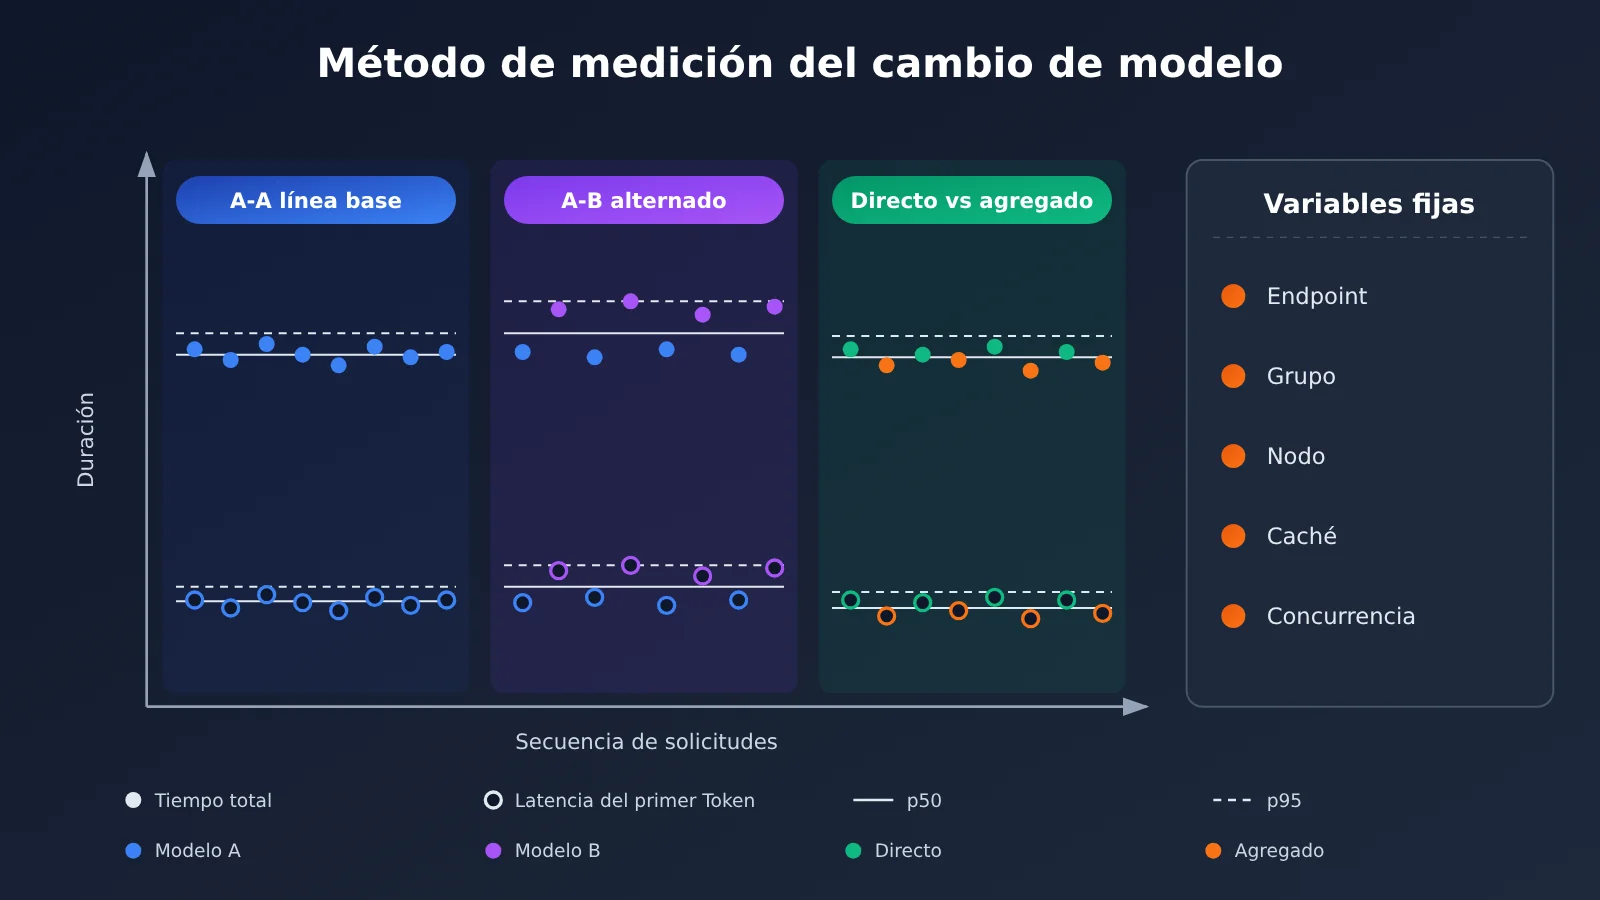
En los materiales públicos disponibles hasta hoy, no existen datos agrupados que permitan aislar por separado las pérdidas introducidas por «cambiar de modelo» o por «el reenvío a través de una puerta de enlace» usando la misma clave, el mismo grupo, la misma región y las mismas entradas y cargas. Las pruebas comparativas de terceros pueden comparar distintos modelos o distintos proveedores, pero no sirven para atribuir directamente esa diferencia al hecho de haber cambiado de modelo en APIYI. Así que, en lugar de citar cifras ajenas, mejor haz tus propias mediciones siguiendo el método que te muestro a continuación:
| Métrica | Forma de registro | Para qué sirve |
|---|---|---|
| Motivo de finalización | Registrar la distribución de finish_reason en cada llamada |
Detectar truncamientos, filtrados e interrupciones de herramientas |
| Latencia del primer token visible | Tiempo hasta el primer fragmento de contenido no vacío en peticiones en streaming | Medir la experiencia de espera del usuario |
| Tiempo total p50/p95 | Percentiles del tiempo de cada petición completa | Evaluar la estabilidad y la cola larga |
| Tasa de fallos | Conteo clasificado por código de error | Distinguir errores de configuración de fallos temporales |
| Tokens reales y facturación | Cotejar el campo usage con el detalle de la factura, elemento por elemento |
Calcular el costo real |
| Tasa de aprobación de la aceptación de negocio | Puntuar una muestra fija de forma manual o mediante reglas | Determinar si la calidad alcanza el nivel esperado |
Se recomienda organizar los pasos de medición así: primero fija el endpoint, el grupo, el nodo y los parámetros de la petición; usa peticiones repetidas A-A con el mismo modelo para establecer la línea base; después alterna pruebas A-B donde solo cambias el modelo; y si necesitas evaluar la sobrecarga del canal, haz una comparación aparte entre conexión directa y canal agregado, siempre con el mismo modelo. Al mismo tiempo, controla el estado de la caché (fría o caliente), el límite de salida y el nivel de concurrencia; de lo contrario, la velocidad del modelo, los fallos de caché y la sobrecarga del canal se mezclarán y no podrás distinguirlos.
Riesgos adicionales en los flujos de herramientas con estado
Si usas Responses para invocaciones de herramientas en varios turnos, cambiar de modelo a mitad de la conversación también introduce problemas de estado. La documentación de migración de GPT-6.2 de OpenAI indica que cambiar a ciertos modelos en plena sesión (incluidas las degradaciones) puede provocar que los elementos de razonamiento originales se eliminen, y que el modelo tenga que razonar de nuevo al restaurar el contexto. Esto significa que no se puede prometer una «pérdida de estado cero» tras el cambio, ni existe una proporción fija en la variación de costos.
Al validar este tipo de flujos, hay que verificar si el nuevo modelo reutiliza correctamente los elementos del historial y el contexto, y tratar «cambiar de modelo a mitad de la misma sesión» como un caso de prueba aparte.
Preguntas frecuentes (FAQ)
Q1: ¿Qué es la interfaz unificada de APIYI?
Es un punto de entrada de API compatible con OpenAI: con una sola clave API y el mismo Base URL ya puedes invocar modelos de distintos proveedores como OpenAI, Claude o Gemini. No necesitas registrarte ni mantener claves por separado para cada proveedor; al cambiar de modelo básicamente modificas el campo `model` de la solicitud y revisas los parámetros específicos según el modelo.
Q2: ¿Qué diferencia hay entre cambiar de modelo con la interfaz unificada y integrar por separado el SDK oficial de cada proveedor?
Los SDK oficiales ofrecen la cobertura más completa de las capacidades propias de cada modelo, pero usar varios a la vez implica mantener múltiples sistemas de autenticación, SDK y cuentas de facturación. La interfaz unificada fusiona autenticación, punto de entrada y facturación en un solo conjunto, así que en escenarios con parámetros comunes el coste de cambiar de modelo es muy bajo. La contrapartida es que los parámetros específicos hay que verificarlos uno por uno; por ejemplo, la asignación del campo de razonamiento nativo de Gemini en la interfaz compatible requiere una validación aparte.
Q3: ¿Cuándo estarán disponibles en APIYI los modelos mencionados en el artículo?
Según el registro dinámico en tiempo real de APIYI: GPT-6.2 Astra y Sol se lanzaron el 2026-11-18 y están abiertos en tres grupos; Gemini 4 Neon fue anunciado por Google el 18 de noviembre, y APIYI lo integró el 20 de noviembre en los grupos `default`/`svip`; Seedream 5.5 se lanzó el 13 de noviembre. La lista de modelos cambia con rapidez, así que guíate por el registro del día.
Q4: ¿En qué escenarios conviene más usar la interfaz unificada para cambiar de modelo?
– **Comparación A/B entre modelos**: compara el rendimiento y el coste de una misma indicación en distintos modelos.
– **Respaldo ante fallos**: cambia a un modelo alternativo cuando un modelo o un canal esté saturado.
– **Reparto por tareas**: modelos económicos para preguntas sencillas y modelos insignia para razonamiento complejo.
– **Generación de imágenes en varios estilos**: elige entre varios modelos de imagen según tus necesidades y presta atención a la asignación de parámetros.
Q5: ¿Cuál es la forma más rápida de empezar a invocar varios modelos con la interfaz unificada?
1. Visita APIYI en apiyi.com y crea una cuenta; los usuarios nuevos obtienen un crédito de prueba gratuito.
2. Crea una clave API y confirma que el grupo de tokens al que pertenece incluye los modelos de destino.
3. Ejecuta el ejemplo minimalista de este artículo y sustituye el campo `model` según el registro para verificarlo.
Con la facturación por consumo es fácil comparar varios modelos con poco tráfico antes de decidir cuál será tu opción principal.
Q6: ¿Cuál es el precio y la ventana de contexto de gemini-4-neon?
Según el registro de modelos que generó APIYI el 2026-11-20, `gemini-4-neon` cuesta $3 por millón de tokens de entrada, $15 de salida y $0.15 por lectura de caché; el registro dinámico de APIYI indica que tiene el mismo precio que el oficial, y el cobro real se rige por la factura de tu cuenta. Tanto Artificial Analysis como el anuncio de Google lo marcan con 1M de contexto, una ventana compartida entre entrada, razonamiento y salida; la documentación de lanzamiento de APIYI lista un límite de unos 64K para la generación síncrona.
Q7: ¿Qué limitaciones conocidas tiene cambiar de modelo con la interfaz unificada?
– **Los parámetros propietarios no son universales**: los niveles de razonamiento, las llamadas a herramientas y las salidas estructuradas hay que verificarlos modelo por modelo.
– **Los vectores no se pueden mezclar**: al cambiar de modelo de Embedding es obligatorio re-vectorizar y reconstruir el índice.
– **Los flujos con estado sufren pérdidas**: cambiar de modelo a mitad de una sesión en Responses puede provocar que se pierdan los elementos de razonamiento.
– **La visibilidad está restringida**: la lista de modelos depende de los grupos de tokens, la autorización y el endpoint; si surge algún problema, puedes consultar la documentación de códigos de error de APIYI en apiyi.com.
Puntos clave para cambiar de Modelo de Lenguaje Grande con la interfaz unificada de APIYI
- Cambiar solo el model tiene condiciones: solo funciona con el mismo endpoint y usando únicamente los parámetros comunes que ambos admiten.
- Dos formas de contar los modelos: los 200+ corresponden a la selección de modelos destacados, mientras que el registro tiene 289 entradas, incluidas las variantes de versión y de ruta.
- La verificación sigue un orden: ID del modelo → grupos de tokens → endpoint → parámetros, descartando punto por punto.
- Los parámetros de imagen requieren mapeo: MAI usa
width/height, Seedream usasize, y la transparencia se escribe de forma distinta. - Cambiar el modelo de vectores obliga a reconstruir: small y large tienen dimensiones predeterminadas distintas, y aunque coincidan, no son interoperables.
- Un HTTP 200 no significa éxito: hay que revisar la causa de finalización, los cuerpos vacíos y las respuestas que solo contienen llamadas a herramientas.
- El rendimiento debes medirlo tú: usa una línea base A-A junto con mediciones alternadas A-B; puedes completar la comparación en APIYI (apiyi.com) con la misma clave API.
Resumen
Los puntos clave para cambiar entre Modelos de Lenguaje Grandes con la interfaz unificada de APIYI:
- Reutilizar la autenticación y el punto de entrada: una clave API y un Base URL cubren múltiples tipos de capacidades como texto, imágenes y vectores.
- Distinguir parámetros comunes de parámetros propietarios: los comunes se cambian directamente; los propietarios se validan uno por uno antes de incorporarlos.
- Convertir el cambio en una operación verificable: usa la tabla de códigos de error para diagnosticar problemas y un método fijo para registrar latencia, tasa de fallos y cobros.
Se recomienda primero probar ambos modelos con la solicitud de texto plano más corta posible y luego expandirse gradualmente hacia escenarios de negocio siguiendo el orden: «mapeo de parámetros de imagen», «reconstrucción de índices vectoriales» y «flujos de herramientas con estado». Te sugerimos aprovechar la cuota de prueba gratuita de APIYI (apiyi.com) para completar estas verificaciones antes de decidir el modelo principal y el plan de respaldo.
📚 Referencias
-
Centro de documentación de APIYI: introducción básica, inicio rápido, registro de modelos, vectorización de texto y notas sobre versiones de modelos
- Enlace:
docs.apiyi.com - Descripción: fuente primaria sobre IDs de modelos, grupos, endpoints y precios; para el registro de modelos, consulta siempre la versión generada del día
- Enlace:
-
OpenAI Using GPT-6.2: migración a GPT-6.2 y descripción de parámetros
- Enlace:
developers.openai.com/api/docs/guides/latest-model - Descripción: llamadas a herramientas en Responses, campos de niveles de razonamiento y ciclo de vida de los ítems de razonamiento
- Enlace:
-
Documentación de solución de problemas y firma de pensamiento de Google Gemini API: diagnóstico de problemas al invocar Gemini 4
- Enlace:
aistudio.google.com/docs/troubleshooting - Descripción: niveles de razonamiento, devolución de
thoughtSignaturey errores comunes
- Enlace:
-
Introducción a Gemini 4 de Google Cloud: decodificación larga de Gemini 4 y notas sobre versiones de la interfaz
- Enlace:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/start/get-started-with-gemini-4 - Descripción: conoce las versiones de la interfaz para decodificación larga y las condiciones de reanudación
- Enlace:
-
Página de comparación de modelos de Artificial Analysis: benchmarks de modelos de terceros y métodos de medición de latencia
- Enlace:
artificialanalysis.ai/models/comparisons/gemini-4-neon-vs-gpt-6-2-sol - Descripción: útil como referencia comparativa entre modelos; no debe usarse para atribuir costos al canal
- Enlace:
Autor: Equipo técnico de APIYI
Intercambio técnico: contáctanos desde la página principal del sitio de APIYI; para más material de integración, visita el centro de documentación en docs.apiyi.com