ملاحظة المؤلف: يشرح هذا المقال كيفية إتمام التبديل بين نماذج اللغة الكبيرة باستخدام مفتاح API واحد ومدخل متوافق مع OpenAI، مع توضيح مفصّل للحقول والحالات ومعايير القبول التي تتطلب تكييفًا مستقلًا عند دمج الصور وEmbedding عبر النماذج المختلفة.
في هذا المقال، سننجح في تشغيل التبديل بين نماذج النصوص البحتة باستخدام مفتاح API واحد ومدخل واحد متوافق مع OpenAI، ثم نستعرض مثالين اثنين، هما الصور والمتجهات، لنوضح الحقول والحالات ومعايير القبول التي تحتاج إلى تكييف مستقل عند التكامل بين النماذج. لكن تبقى هذه الخلاصة مشروطة: عند استخدام نقطة النهاية نفسها مع الاقتصار على المعاملات المشتركة التي يدعمها كلا النموذجين، يقتصر تبديل النموذج عادةً على تعديل حقل model فحسب. أما بمجرد تعلّق الأمر بمعاملات التفكير الخاصة بكل نموذج، أو استدعاء الأدوات، أو أبعاد الصور، أو أبعاد المتجهات، فيلزم مراجعة كل نموذج على حدة.
هذا المقال ليس من النوع الذي يَعِدك بأن تغيير سطر واحد من الشيفرة سيحل كل شيء. سنفصل بوضوح بين الأجزاء القابلة لإعادة الاستخدام من واجهة APIYI الموحدة والأجزاء التي تستوجب إعادة تحقق، وسنستعرض أيضًا سيناريوهات الفشل المحتملة.
القيمة الأساسية: بنهاية هذا المقال، ستتمكن من التبديل بين نماذج النصوص باستخدام نظام المصادقة والشيفرة نفسيهما، وستعرف أي المعاملات ينبغي تعديلها عند تغيير النماذج في توليد الصور وEmbedding، كما ستكتسب منهجية عملية قابلة للتطبيق للتحقق من قبول التبديل.
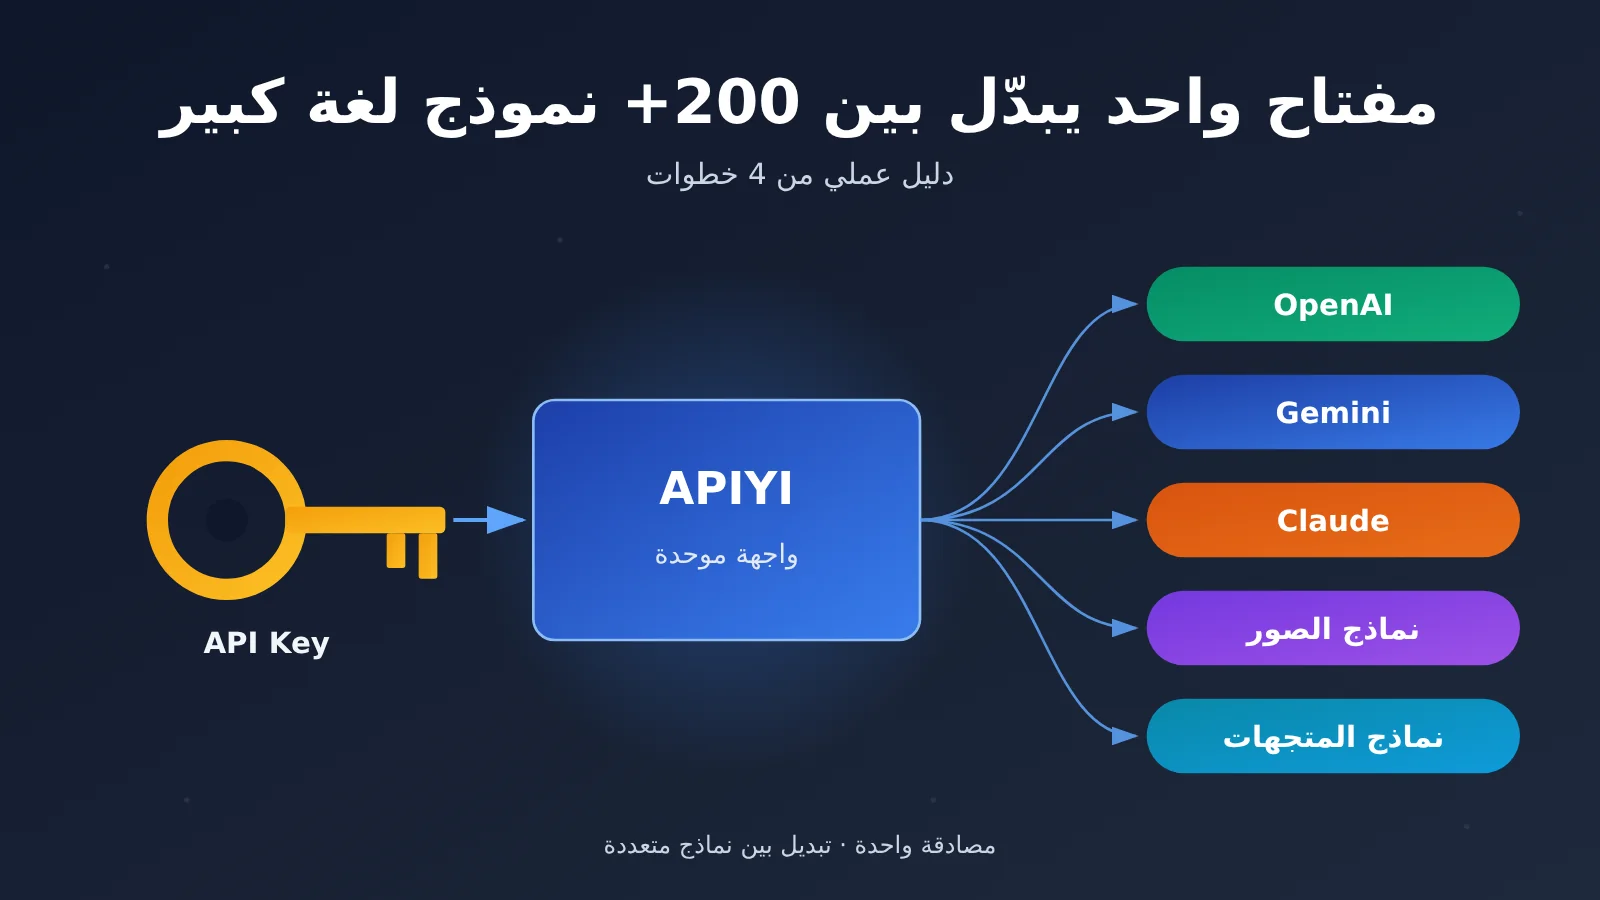
9 مصطلحات يجب فهمها قبل التبديل بين النماذج اللغوية الكبيرة عبر واجهة APIYI الموحدة
معظم المشكلات التي تظهر عند تبديل النماذج سببها اختلاف فهم المصطلحات. فمثلًا، كتابة Base URL بحيث يتكرر فيه /v1 مرتين، أو الظن بأن المتجهات ذات البُعد نفسه يمكن استخدامها بالتبادل. وحِّد أولًا المجموعة التالية من المفاهيم، فجميع الخطوات اللاحقة في المقال مبنية على هذه التعريفات.
| المصطلح | المعنى الفعلي | ما يجب الانتباه إليه عند التبديل |
|---|---|---|
| Base URL | العنوان الجذري الذي تعتمد عليه SDK عند بناء مسار الواجهة | في OpenAI SDK يُكتب العنوان حتى /v1 فقط، وتجنّب تكرار الإلحاق |
| API Key | بيانات الاعتماد الخاصة بمصادقة طلبات API | يُحفظ فقط في إعدادات الخادم أو متغيرات البيئة |
| معرّف النموذج | النموذج المحدد في الطلب، وقد يتضمن معلومات عن الإصدار أو القناة | انسخ المعرّف الأصلي من سجل النماذج ولا تكتبه يدويًا |
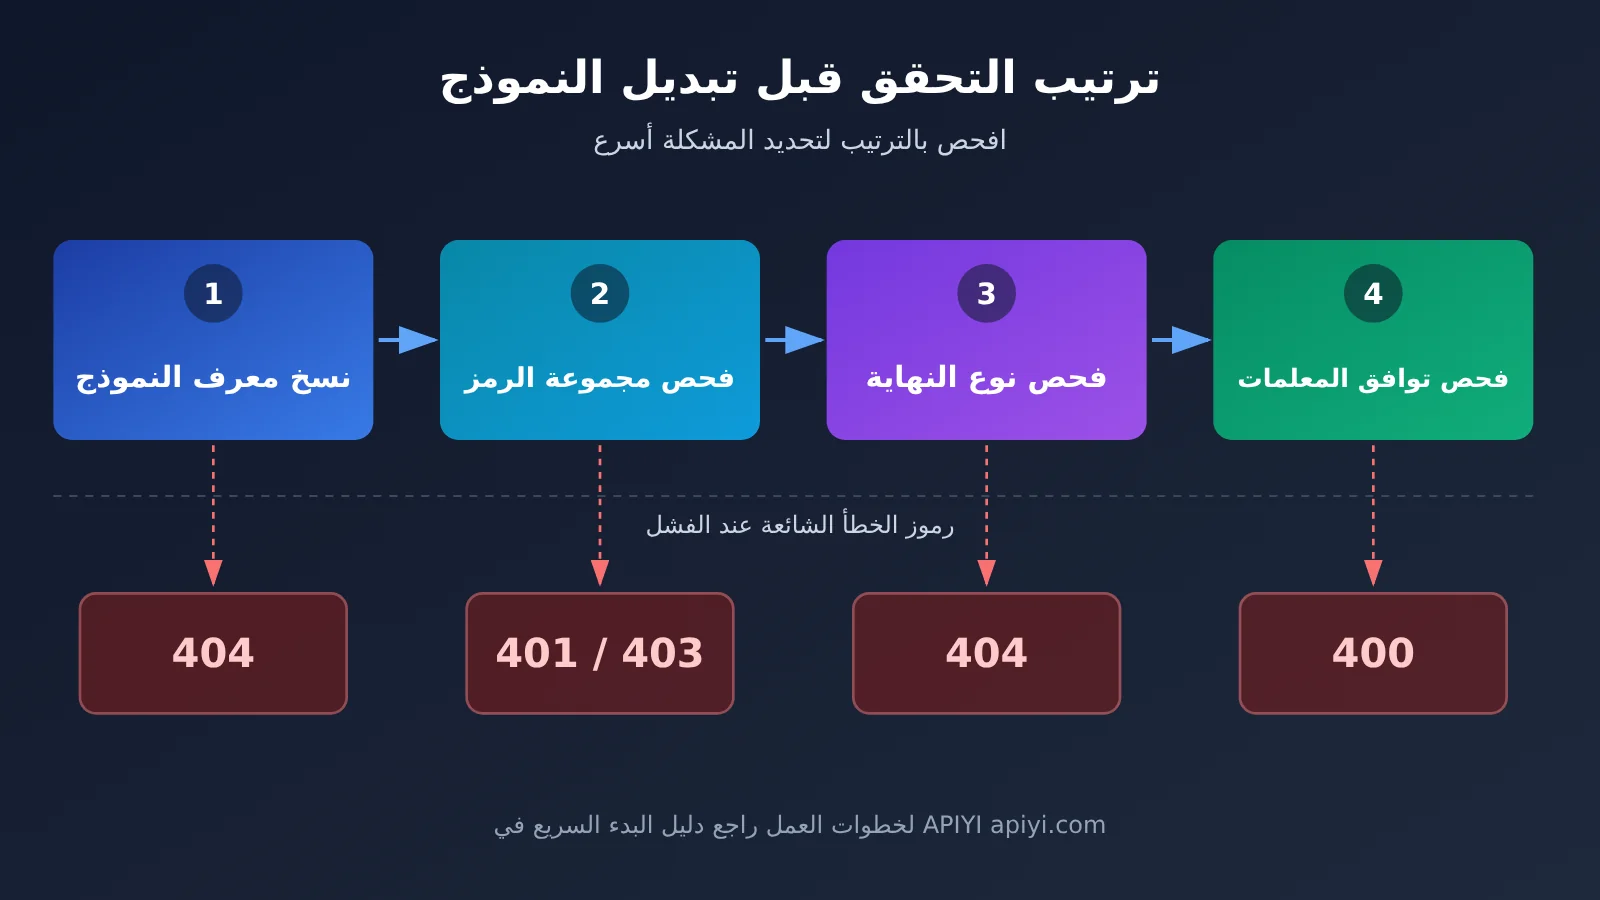
| مجموعة المفتاح | تحدد النماذج والقنوات وشروط الفوترة المتاحة للمفتاح الحالي | إذا لم يكن النموذج ضمن المجموعة فسيظهر الخطأ 401/403 أو 404 |
| Chat Completions | بروتوكول واجهة لإجراء محادثات نصية عبر مصفوفة الرسائل | المدخل الرئيسي للتبديل في حالات النص الخالص |
| Responses | بروتوكول واجهة يدعم أنواعًا متعددة من المخرجات واستدعاء الأدوات | استدعاء الأدوات في GPT-6.2 يجب أن يمر عبر هذا البروتوكول |
| Embedding | ترميز المحتوى إلى متجه ذي بُعد ثابت يُستخدم في الاسترجاع والمطابقة التشابهية | تغيير النموذج يعني تغيير فضاء المتجهات بالكامل |
| فهرس المتجهات | بنية تُستخدم للبحث عن العناصر المتشابهة وفق بُعد وفضاء متجهات محددين | أي تغيير في البُعد أو النموذج يستلزم إعادة بنائه |
| زمن ظهور أول رمز مرئي | الوقت المنتظر من إرسال الطلب حتى يرى المستخدم أول مقطع صالح من المحتوى المولّد | وقت التفكير في نماذج الاستدلال يرفع قيمة هذا المؤشر |
من بين هذه المصطلحات، «مجموعة المفتاح» هي الأكثر عرضة للإغفال. فتحت الحساب نفسه، قد تختلف قائمة النماذج التي يراها كل مفتاح باختلاف مجموعته؛ لذلك عند معالجة خطأ «النموذج غير موجود»، ابدأ بالتحقق من مجموعة المفتاح الذي تستخدمه، لا بالشك في الكود من البداية.
النقاط الجوهرية للتبديل بين نماذج اللغة الكبيرة عبر الواجهة الموحدة في APIYI
ما توفره الواجهة الموحدة فعليًا هو التخلص من “الأعمال المتكررة”: لن تضطر إلى إنشاء حساب منفصل لدى كل مزوّد، أو إدارة عدة مفاتيح، أو التعامل مع عدة حزم تطوير (SDK). وفقًا للمقدمة الأساسية لـ APIYI على apiyi.com ووثائق البدء السريع، يكفيك إعداد مصادقة واحد ونقطة دخول واحدة متوافقة مع OpenAI للوصول إلى النماذج المتاحة لدى مختلف المزوّدين.
| الجانب | ما يمكن إعادة استخدامه | ما يحتاج إلى مراجعة حسب كل نموذج |
|---|---|---|
| المصادقة | مفتاح API نفسه وترويسات الطلب نفسها | ما إذا كانت مجموعة الرمز (Token) التي ينتمي إليها المفتاح تتضمن النموذج المستهدف |
| نقطة الدخول | عنوان Base URL نفسه | نقاط النهاية التي يدعمها النموذج المستهدف (المحادثة / Responses / الصور / المتجهات) |
| جسم الطلب | الحقول المشتركة مثل model وmessages الأساسية وinput |
مستويات التفكير، الأدوات، المخرجات المهيكلة، أبعاد الصورة، أبعاد المتجهات |
| معالجة الاستجابة | منطق تحليل choices وfinish_reason وusage |
الاستجابات الخاصة مثل المحتوى الفارغ، أو استدعاء الأدوات فقط، أو التصفية الأمنية |
| الفوترة | رصيد الحساب نفسه وفواتيره | أسعار كل نموذج وشرائح التسعير وطريقة احتساب فوترة التخزين المؤقت تختلف من نموذج لآخر |
200+ مقابل 289: طريقتان لعدّ نماذج APIYI
تشير المقدمة المنشورة لـ APIYI إلى دعم أكثر من 200 نموذج مختار. أما في سجل النماذج العام الصادر بتاريخ 2026-11-20، فيبلغ حقل model_count قيمة 289. الرقمان لا يتعارضان: يشمل عدّ السجل الإصدارات المختلفة للنموذج نفسه وبدائل المسارات المختلفة، ولهذا يكون عدد الإدخالات أكبر من عدد “النماذج المختارة”.
تجدر الإشارة إلى أن قائمة ما يمكن لرمز واحد استدعاؤه فعليًا تخضع لثلاثة قيود مجتمعة: التجميع، وتفويض النماذج، ونقاط النهاية. فوجود معرّف ما في السجل لا يعني بالضرورة أن المفتاح بين يديك قادر على استدعائه.
ترتيب المراجعة قبل التبديل
يُنصح بفحص الأمور بالترتيب الثابت نفسه في كل مرة تُدخل فيها نموذجًا جديدًا، حتى لا تجد نفسك تتعقب الخطأ في عدة اتجاهات دفعة واحدة عند حدوثه:
- التحقق من معرّف النموذج: انسخ المعرّف الأصلي من سجل النماذج لليوم نفسه، وتأكد من تطابق الأحرف الكبيرة والصغيرة والشرطات تمامًا.
- التحقق من مجموعة الرمز: تأكد من أن المجموعة التي ينتمي إليها مفتاحك الحالي قد فعّلت هذا النموذج، فبعض النماذج لا تتاح إلا ضمن مجموعات محددة.
- التحقق من نقطة النهاية: تأكد من أن النموذج يدعم نوع الواجهة التي تريد استدعاءها؛ فنقاط نهاية النصوص والصور والمتجهات مختلفة عن بعضها.
- التحقق من المعاملات: احتفظ فقط بالمعاملات المشتركة التي يدعمها النموذجان معًا، ثم أعد إضافة المعاملات الخاصة واحدًا تلو الآخر للتحقق منها.
كيفية التبديل السريع بين نماذج اللغة الكبيرة النصية عبر الواجهة الموحدة لـ APIYI
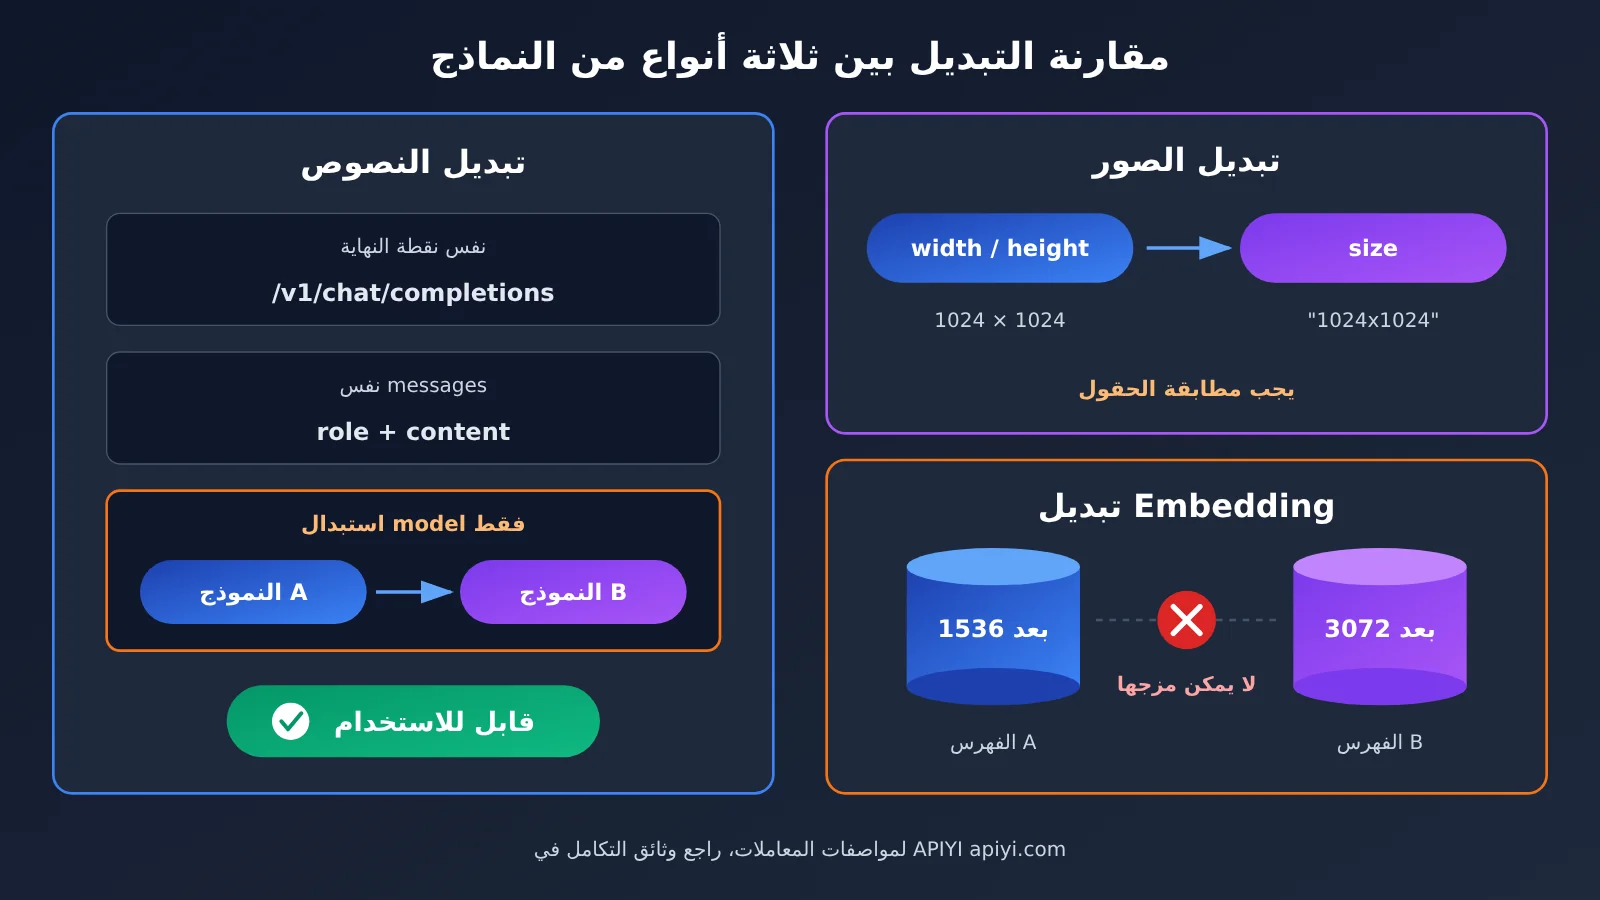
فيما يلي نموذجان نصيان يمكن الوصول إليهما عبر Chat Completions: gemini-4-neon و gpt-6.2-sol. يستخدم كلاهما الطلب POST /v1/chat/completions، وعند الاكتفاء بحقل messages الأساسي، لا يتطلب التبديل بينهما سوى استبدال قيمة حقل model. يُشترط أن تتيح مجموعة المفاتيح (Key) الخاصة بك إمكانية الاطلاع على هذين النموذجين، لذا تحقق من ذلك في سجل النماذج قبل إجراء الاستدعاء.
مثال مبسّط للغاية: التبديل بين نموذجين بنفس الشفرة البرمجية
اضبط Base URL على القيمة https://api.apiyi.com/v1، واقرأ مفتاح API من متغيرات البيئة:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],     # يوضع في متغيرات البيئة على جانب الخادم فقط
    base_url="https://api.apiyi.com/v1",     # نقطة الدخول المتوافقة مع OpenAI من APIYI
)

for model in ["gemini-4-neon", "gpt-6.2-sol"]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是向量索引"}],
    )
    choice = resp.choices[0]
    print(model, "| finish_reason:", choice.finish_reason, "| usage:", resp.usage)
    print(choice.message.content or "<空正文>")
تحقّق من حقول الاستجابة، ولا تكتفِ برمز HTTP 200
بعد استلام الردّ، تحقّق من ثلاثة مواضع على الأقل: هل choices[0].message.content فارغ؛ وهل finish_reason يساوي stop أم انتهى لسبب آخر مثل الاقتطاع بسبب الطول؛ وهل استهلاك الرموز (token) في usage يبدو منطقيًا. فنماذج الاستدلال تستهلك عملية التفكير جزءًا من ميزانية الإخراج أيضًا، لذا قد يظهر موقف «HTTP 200 لكن المتن فارغ» عندما تكون الميزانية صغيرة جدًا.
بالإضافة إلى ذلك، لا يصلح الاسم الذي يدّعيه النموذج لنفسه داخل متن الردّ دليلًا للتحقق من الطراز الفعلي في الواجهة الخلفية. فعندما تريد التأكد من النموذج الذي استُدعي فعلًا، ابدأ بفحص معرّف الطلب (Request ID) والبيانات الوصفية للاستجابة وسجلّات الفوترة.
عرض كود التنفيذ الكامل: زمن وصول أول رمز في البث، وإعادة المحاولة بالتراجع التدريجي، وتسجيل المقاييس
import os
import time
import random
from openai import OpenAI, RateLimitError, APIStatusError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",   # واجهة APIYI الموحدة
)

def call_once(model: str, prompt: str, max_retries: int = 3) -> dict:
    """استدعاء بالبث مرة واحدة، مع تسجيل زمن وصول أول رمز مرئي والزمن الكلي وسبب الإنجاز"""
    for attempt in range(max_retries + 1):
        start = time.perf_counter()
        first_token_at = None
        parts, finish_reason, usage = [], None, None
        try:
            stream = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
                stream=True,
                stream_options={"include_usage": True},
            )
            for chunk in stream:
                if chunk.usage:
                    usage = chunk.usage
                if not chunk.choices:
                    continue
                delta = chunk.choices[0].delta
                if delta and delta.content:
                    if first_token_at is None:
                        first_token_at = time.perf_counter()
                    parts.append(delta.content)
                if chunk.choices[0].finish_reason:
                    finish_reason = chunk.choices[0].finish_reason
            end = time.perf_counter()
            return {
                "model": model,
                "ok": bool(parts),
                "ttft_s": round(first_token_at - start, 3) if first_token_at else None,
                "total_s": round(end - start, 3),
                "finish_reason": finish_reason,
                "usage": usage,
                "text": "".join(parts),
            }
        except RateLimitError:
            # إعادة محاولة محدودة العدد مع تراجع أُسّي مصحوب بعشوائية (jitter)، للتقييد قصير الأمد فقط
            if attempt == max_retries:
                raise
            time.sleep((2 ** attempt) + random.uniform(0, 0.5))
        except APIStatusError as e:
            # الأخطاء 400/401/403/404 تعود لمشكلات في الإعداد أو المعاملات، وإعادة المحاولة بلا جدوى
            return {"model": model, "ok": False, "status": e.status_code,
                    "error": str(e)[:300]}

if __name__ == "__main__":
    prompt = "用三句话说明向量索引为什么要和 Embedding 模型绑定"
    for m in ["gemini-4-neon", "gpt-6.2-sol"]:
        r = call_once(m, prompt)
        print({k: v for k, v in r.items() if k != "text"})
🚀 بداية سريعة: ننصحك أولًا بتجربة المثال المبسّط أعلاه على APIYI عبر apiyi.com مستفيدًا من رصيد الاختبار المجاني للمستخدمين الجدد، وتأكّد من أن كلا معرّفَي النموذجين يُرجعان متنًا فعليًا ضمن مجموعة مفتاح API الخاص بك، قبل دمج الكود في تطبيقك الفعلي.
المعاملات الخاصة تحتاج إلى تحقق منفصل
استخدمت الأمثلة أعلاه الحقول العامة فقط عن قصد. أما بمجرد إضافة المعاملات التالية، فلن يمكنك بعد الآن الافتراض بأن “تغيير model وحده يكفي”:
- سلسلة GPT-6.2: في OpenAI API، يدعم كل من
gpt-6.2-astraوgpt-6.2-solبروتوكولَي Chat Completions و Responses معًا. حقل مستوى التفكير في Chat Completions هوreasoning_effort، أما في Responses فهوreasoning.effort؛ وكلا النموذجين يرفض القيمةnone. وعند الحاجة إلى استدعاء الأدوات يجب التحول إلى Responses. - سلسلة Gemini 4: يدعم
gemini-4-neonمخطط Gemini الأصلي من APIYI والمحادثة المتوافقة مع OpenAI. يستخدم REST الأصلي المسار/v1beta/models/{id}:generateContent، ويُحدد مستوى التفكير فيgenerationConfig.thinkingConfig.thinkingLevel، مع الخياراتlowوmediumوhighوxhigh، والقيمة الافتراضيةhigh. أماthinkingBudgetوminimalمن الإصدار القديم فلا ينطبقان على Gemini 4؛ وتشير وثائق Google أيضًا إلى أن Gemini 4 يتجاهلtemperatureوtopP. - المخرجات المهيكلة والأدوات: قيود JSON Schema وتنسيق تعريف الأدوات قد لا تتطابق بين الطرفين بالضرورة، لذا تحتاج إلى التحقق منها بندًا بندًا وفق وثائق النموذج المستهدف.
تجدر الإشارة إلى أن ملاحظات إطلاق Neon لدى APIYI تذكر أنه عند الإطلاق جرى التحقق من واجهة التسعير فقط، دون إجراء استدعاءات فعلية قبل الإطلاق. لذلك فإن نقاط النهاية المزدوجة واستدعاء الأدوات المذكورة أعلاه هي سلوك موثق، ويُرجى التحقق منها بنفسك باستخدام أبسط طلب ممكن قبل الاستخدام الفعلي.
التبديل بين القدرات عبر واجهة APIYI الموحدة: مقارنة بين الصور و Embedding
إلى جانب المحادثة النصية، تُعد الصور والمتجهات (vectors) من أكثر سيناريوهات الانتقال بين النماذج شيوعًا، وهي أيضًا أكثر الحالات التي تتعثر فيها طريقة “تغيير model فقط”. المثالان أدناه يمثلان نوعين من المشكلات: “اختلاف بنية المعاملات” و”اختلاف فضاء النتائج”.
التبديل بين نماذج الصور: MAI-Image-2.7 و Seedream 5.5
يمكن استدعاء كلا النموذجين عبر قدرة Images باستخدام نفس المفتاح، لكن طريقة كتابة الأبعاد والصورة المرجعية والمخرجات الشفافة تختلف تمامًا:
| الجانب | MAI-Image-2.7 | Seedream 5.5 |
|---|---|---|
| نقطة النهاية | التوليد يمر عبر generations، والتعديل عبر edits |
النص الخالص والصور المرجعية كلاهما يمر عبر generations |
| معامل الأبعاد | يتحكم width و height في إجمالي البكسلات، بحد أقصى معلن يبلغ 4,194,304 بكسل |
يختار size شريحة السعر، وعند إغفاله تُعتمد شريحة 2K |
| الصور المرجعية | التعديل يقبل حتى 5 صور مرجعية | توضع الصورة المرجعية في الحقل image |
| المخرجات الشفافة | background: "transparent" وتُعاد صورة PNG بقناة alpha |
يتطلب تحديد background: "transparent" و output_format: "png" معًا |
| التسعير | تسعير مستقل | تسعير مستقل وفق شريحة size |
| المنصات المتاحة | APIYI على apiyi.com (اعتمد على سجل النماذج والمجموعات الرسمية) | APIYI (اعتمد على سجل النماذج والمجموعات الرسمية) |
عند الاستدعاء، يُنصح بإنشاء دالة ربط معاملات لكل نموذج على حدة، بدلًا من تجميع الحقول مباشرة في طبقة منطق العمل:
# نستخدم نفس الـ client المذكور سابقًا؛ انسخ معرف النموذج من سجل اليوم
def build_image_kwargs(model: str, prompt: str, transparent: bool = False) -> dict:
    if model.startswith("MAI-Image"):
        body = {"width": 1024, "height": 1024}
        if transparent:
            body["background"] = "transparent"
        return {"model": model, "prompt": prompt, "extra_body": body}
    # في Seedream 5.5: يحدد size شريحة السعر، والقيم الصحيحة وفق وثائق الربط
    body = {"size": "2K"}
    if transparent:
        body.update({"background": "transparent", "output_format": "png"})
    return {"model": model, "prompt": prompt, "extra_body": body}

img = client.images.generate(**build_image_kwargs("MAI-Image-2.7", "扁平风格的钥匙图标", True))
يجب التحقق من كل نموذج على حدة فيما يخص الصور الشفافة وجودة الصور المرجعية وصيغة الاستجابة والتكلفة، فلا يمكن استبدال نتائج فحص نموذج بنتائج النموذج الآخر.
التبديل بين نماذج Embedding: لا يجوز خلط small و large بشكل مباشر
صحيح أن شكل الاستدعاء للتحويل المتجهي موحّد: كلاهما يمر عبر POST /v1/embeddings، ويكفي تمرير model و input.
for m in ["text-embedding-3-small", "text-embedding-3-large"]:
    e = client.embeddings.create(model=m, input=["统一接口切换模型"])
    print(m, "维度:", len(e.data[0].embedding))   # الأبعاد الافتراضية هي 1536 و3072 على التوالي
المشكلة تكمن في النتيجة. يُنتج text-embedding-3-small افتراضيًا متجهات ذات 1536 بُعدًا، بينما يُنتج text-embedding-3-large متجهات ذات 3072 بُعدًا، ولا يمكن وضع متجهات مختلفة الأبعاد في الفهرس نفسه. وحتى لو استخدمتَ معامل dimensions لتقليص أبعاد large إلى 1536 بُعدًا، فستبقى فضاءا المتجهات الخاصان بالنموذجين منفصلين تمامًا، وستفقد درجة التشابه بين متجهات المستندات القديمة ومتجهات الاستعلامات الجديدة معناها.
لذلك، الطريقة الصحيحة لتبديل نموذج Embedding هي: إنشاء فهرس متجهات جديد، وإعادة تحويل جميع المستندات القديمة إلى متجهات، وتبديل النموذج في جهة الاستعلام في الوقت نفسه، ثم إعادة معايرة عتبة التشابه باستخدام مجموعة من العينات الموسومة. وتفوق هذه التكلفة بكثير مجرد تعديل قيمة model في سطر واحد، لذا يجب أخذها في الحسبان منذ مرحلة اختيار النموذج.
كيفية التحقق من تبديل النماذج عبر الواجهة الموحدة في APIYI
قبل طرح التبديل في الإنتاج، عليك الانتقال من مستوى “الاستدعاء يعمل” إلى مستوى “النتيجة قابلة للتحقق من القبول”. ينقسم التحقق إلى جزأين: تشخيص رموز الأخطاء ومقارنة المؤشرات.
جدول تشخيص رموز الأخطاء
يبدأ التشخيص بتثبيت طلب بأصغر حجم ممكن، باستخدام نفس المفتاح (Key) ونفس العقدة ونفس نقطة النهاية ونفس معرّف النموذج لإعادة إنتاج المشكلة بشكل مستقر:
| العَرَض | السبب الشائع | الفحص والإصلاح |
|---|---|---|
| 400 | حقول خاصة بالنموذج القديم أو معاملات أدوات أو مخرجات مهيكلة أو تنسيق صور غير متوافقة | أزل الحقول غير الضرورية، ثم أعِد إضافتها واحدًا تلو الآخر لتحديد مصدر المشكلة |
| 401/403 | تنسيق الرمز (Token) خاطئ، أو أن المجموعة لا تتضمن هذا النموذج، أو أن النموذج غير مدرج في القائمة البيضاء | تحقق من المفتاح ومجموعة الرموز والقائمة البيضاء للنماذج |
| 404 | إلحاق /v1 بشكل مكرر في SDK، أو أن النموذج لا ينتمي إلى هذا النوع من الواجهات |
يتضمن Base URL في OpenAI SDK على /v1؛ بينما تستخدم Google GenAI SDK العنوان الجذري بدون /v1 مع تكوين v1beta؛ انسخ معرّف النموذج الأصلي |
| 429 | تقييد المعدل قصير المدى أو تجاوز حد التزامن أو عدم كفاية الحصة | اقرأ جسم الخطأ أولًا؛ عند التقييد قصير المدى استخدم عددًا محدودًا من المحاولات مع التراجع الأُسّي المزوّد بالاهتزاز (jitter)، وبعد معالجة مشكلة الحصة أعد الإرسال |
| 200 مع جسم فارغ | استهلاك التفكير لكامل ميزانية الإخراج، أو التصفية الأمنية، أو إرجاع استدعاءات الأدوات فقط | تحقق من سبب الإنهاء ونوع الاستجابة، وارفع ميزانية الإخراج؛ واستخدم أقصر طلب بدون أدوات كمرجع للمقارنة |
فيما يتعلق بسير عمل الأدوات متعدد الجولات في Gemini 4، تحقق أيضًا من إعادة إرسال thoughtSignature الوارد في الاستجابة كما هو تمامًا دون أي تغيير، ومن التطابق التام بين كل استدعاء أداة ونتيجته المقابلة.
تسجيل المقاييس: التمييز بين فروق النماذج والعبء الإضافي للقنوات
في المصادر المتاحة للعموم حتى الآن، لا توجد بيانات مقارنة مقترنة تستطيع عزل الخسائر التي تُحدثها “تغييرات النموذج” أو “إعادة التوجيه عبر البوابة” بشكل منفصل، عند ثبات المفتاح والمجموعة والمنطقة والمدخلات والأحمال نفسها. فالمعايير المرجعية من أطراف ثالثة تتيح المقارنة بين نماذج مختلفة أو مزودين مختلفين، لكنها لا تمكّن من إرجاع الفروق مباشرة إلى تغيير النموذج على APIYI. لذلك، وبدلًا من الاستشهاد بأرقام الآخرين، من الأفضل أن تجري القياس بنفسك وفق الطريقة التالية:
| المقياس | طريقة التسجيل | الغرض |
|---|---|---|
| سبب الإكمال | إحصاء توزيع finish_reason في كل طلب |
اكتشاف الاقتطاع والتصفية وانقطاع الأدوات |
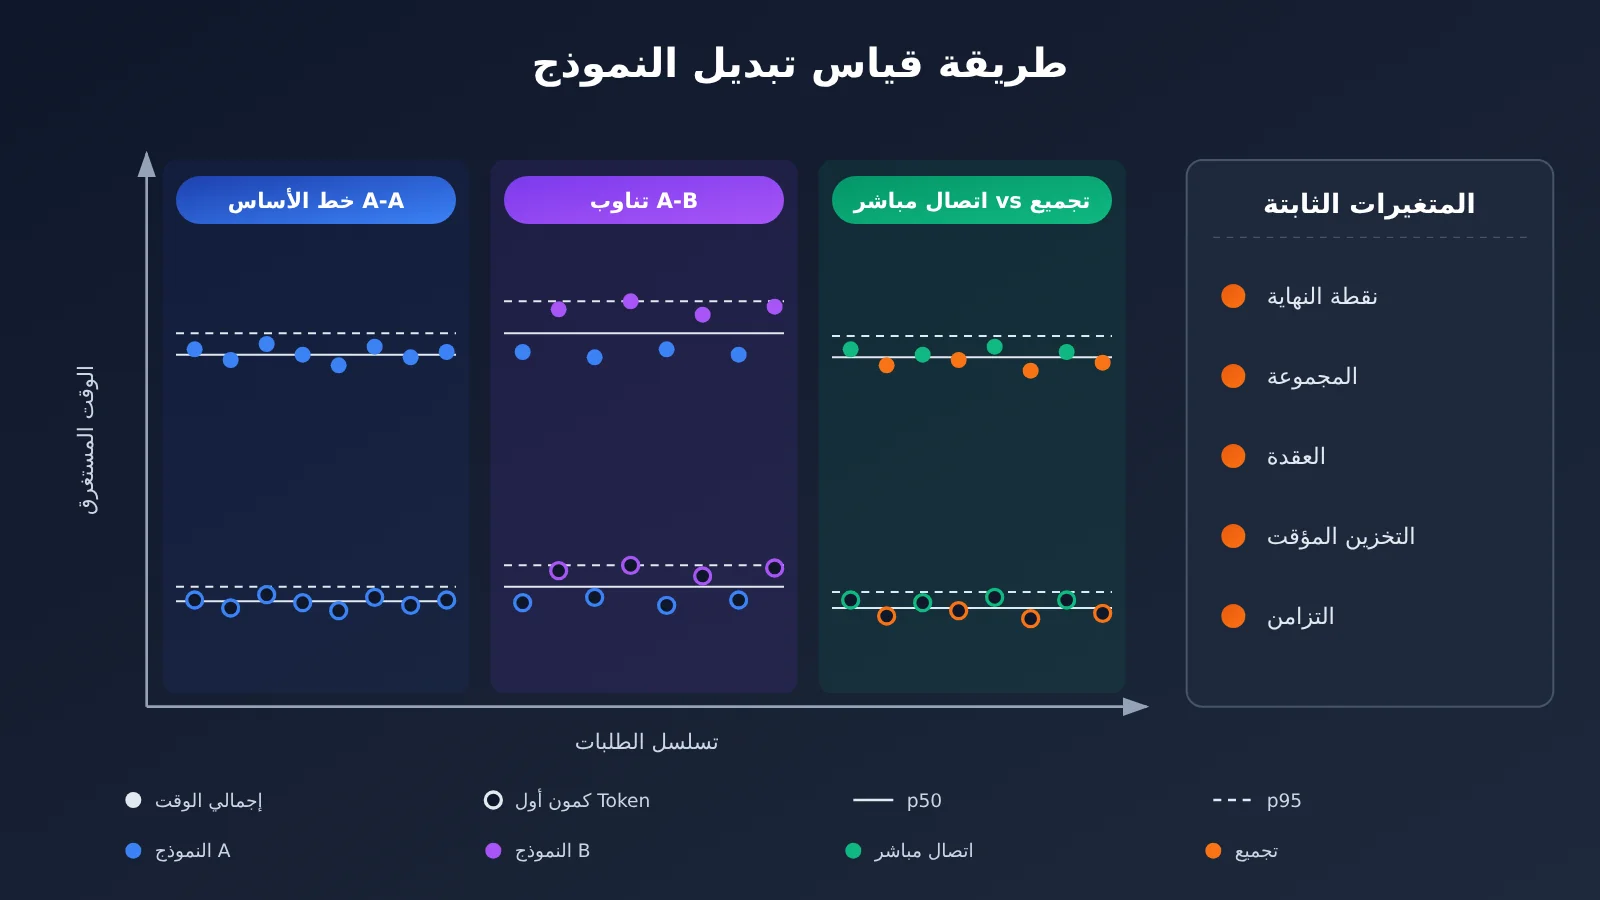
| زمن الوصول لأول Token مرئي | قياس وقت أول مقطع محتوى غير فارغ في الطلبات المتدفقة | تقييم تجربة انتظار المستخدم |
| إجمالي زمن التنفيذ p50/p95 | حساب النسب المئوية لزمن كل طلب كامل | قياس الاستقرار والذيل الطويل |
| معدل الفشل | عدّ الإخفاقات مصنّفة حسب رموز الأخطاء | التمييز بين أخطاء التهيئة والأعطال المؤقتة |
| الـ tokens الفعلية والمبالغ المخصومة | مطابقة حقل usage مع الفاتورة بندًا ببند |
حساب التكلفة الحقيقية |
| معدل اجتياز قبول الأعمال | تقييم عينات ثابتة يدويًا أو وفق قواعد محددة | الحكم على استيفاء الجودة للمستوى المطلوب |
يُقترح ترتيب خطوات القياس على النحو التالي: ثبّت أولًا نقطة النهاية والمجموعة والعقدة ومعاملات الطلب؛ ثم أنشئ خط الأساس عبر تكرار طلبات A-A على النموذج نفسه؛ بعد ذلك بدّل بالتنفيذ بين اختبارات A-B مع تغيير النموذج وحده في كل مرة؛ وإذا أردت تقييم العبء الإضافي للقنوات، فقارن بشكل منفصل بين الاتصال المباشر والقناة المجمعة على النموذج ذاته. وتحكّم في الوقت نفسه في حالة الكاش (بارد أو ساخن) وفي حد الإخراج وعدد الطلبات المتزامنة، وإلا فستختلط سرعة النموذج مع حالات عدم إصابة الكاش والعبء الإضافي للقنوات ويستحيل التمييز بينها.
مخاطر إضافية في تدفقات الأدوات ذات الحالة
إذا كنت تستخدم Responses لإجراء استدعاءات الأدوات عبر عدة أدوار، فإن تبديل النموذج في منتصف العملية يضيف مشكلات متعلقة بالحالة أيضًا. فوثائق الترحيل إلى GPT-6.2 من OpenAI توضح أن الانتقال في منتصف الجلسة إلى بعض النماذج (بما في ذلك خفض المستوى) قد يؤدي إلى إزالة عناصر الاستدلال الأصلية، وعند استعادة السياق قد يحتاج النموذج إلى إعادة الاستدلال من جديد. ويعني هذا أنه لا يمكن الوعود بأن يكون التبديل «بلا فقدان في الحالة»، كما أن تغير التكلفة لا يخضع لنسبة ثابتة.
وعند اختبار قبول مثل هذه التدفقات، تحقق من أن النموذج الجديد يستطيع إعادة استخدام عناصر السجل والسياق بشكل سليم، وضَع «تبديل النموذج في منتصف الجلسة نفسها» كحالة اختبار مستقلة بذاتها.
الأسئلة الشائعة (FAQ)
س1: ما هي الواجهة الموحدة من APIYI؟
إنها نقطة دخول API متوافقة مع OpenAI: باستخدام مفتاح API واحد وعنوان Base URL واحد، يمكنك استدعاء نماذج من مزودين مختلفين مثل OpenAI وClaude وGemini. لن تحتاج إلى تسجيل حسابات ومفاتيح منفصلة لدى كل مزود على حدة، فعند تبديل النموذج يكفي أساسًا تعديل حقل `model` في الطلب، ثم مراجعة المعلمات الخاصة وفقًا لكل نموذج.
س2: ما الفرق بين تبديل النماذج عبر الواجهة الموحدة وبين التكامل مع حزم SDK الرسمية لكل مزود على حدة؟
حزم SDK الرسمية تظل الأكثر اكتمالًا في تغطية القدرات الخاصة، لكن استخدام عدة مزودين معًا يستلزم صيانة أنظمة مصادقة وحزم SDK وحسابات فوترة متعددة. أما الواجهة الموحدة فتجمع المصادقة ونقطة الدخول والفواتير في نظام واحد، ما يجعل تكلفة التبديل منخفضة جدًا في سيناريوهات المعلمات المشتركة. الثمن هو أن المعلمات الخاصة تحتاج إلى التحقق من توافقها واحدًا تلو الآخر؛ فمثلًا يحتاج تعيين حقل التفكير الأصلي لـ Gemini عبر الواجهة المتوافقة إلى اختبار قبول منفصل.
س3: متى تتوفر النماذج المذكورة في المقال على APIYI؟
وفقًا لأرشيف APIYI الفوري للمستجدات: طرح نموذجا GPT-6.2 Astra وSol بتاريخ 2026-11-18 وأصبحا متاحين في ثلاث مجموعات؛ وأعلنت Google عن Gemini 4 Neon في 18 نوفمبر، ثم دمجته APIYI في 20 نوفمبر ضمن مجموعتي `default` و`svip`؛ أما Seedream 5.5 فقد صار متاحًا بتاريخ 13 نوفمبر. قائمة النماذج تتغير بسرعة، فيرجى اعتماد سجل اليوم نفسه دائمًا.
س4: ما السيناريوهات الأنسب لاستخدام الواجهة الموحدة لتبديل النماذج؟
– **مقارنة A/B بين نماذج متعددة**: تجربة الموجه نفسه عبر نماذج مختلفة لمقارنة الأداء والتكلفة.
– **الاحتياط عند الأعطال**: التبديل إلى نموذج بديل عند ضغط الموارد على نموذج أو مسار معين.
– **التوزيع حسب المهمة**: نموذج اقتصادي للأسئلة والإجابات البسيطة، ونموذج رائد لمهام الاستدلال المعقدة.
– **توليد الصور بأنماط متعددة**: الاختيار بين عدة نماذج لتوليد الصور حسب احتياجك، مع الانتباه إلى تعيين المعلمات.
س5: كيف أبدأ بأسرع طريقة في استدعاء نماذج متعددة عبر الواجهة الموحدة؟
1. زر موقع APIYI على apiyi.com وسجّل حسابًا؛ سيحصل المستخدمون الجدد على رصيد اختبار مجاني.
2. أنشئ مفتاح API، وتأكد من أن المجموعة التي ينتمي إليها مفتاحك تتضمن النموذج المستهدف.
3. شغّل المثال المبسط الوارد في هذه المقالة، واستبدل حقل `model` وفقًا للسجل للتحقق من عمله.
نظام الدفع حسب الاستخدام يتيح لك مقارنة عدة نماذج عند حجم استخدام صغير أولًا، قبل أن تحسم قرارك بشأن الحل الرئيسي.
س6: ما سعر نموذج gemini-4-neon وما حجم نافذة السياق لديه؟
وفقًا لسجل النماذج الذي أنشأته APIYI بتاريخ 2026-11-20، يبلغ سعر النموذج `gemini-4-neon` 3 دولارات لكل مليون توكن من المدخلات، و15 دولارًا للمخرجات، و0.15 دولارًا لقراءة الكاش، وقد أشارت تحديثات APIYI إلى أن سعره مطابق للسعر الرسمي، مع أن الخصم الفعلي يُحتسب وفق ما يظهر في فاتورة حسابك. ويشير كلٌّ من Artificial Analysis وإعلانات Google إلى نافذة سياق بحجم 1M توكن، وهي نافذة يتقاسمها المدخلات ومراحل التفكير والمخرجات؛ بينما تحدد وثائق الإطلاق لدى APIYI حدًا أقصى للتوليد المتزامن يقارب 64K.
س7: ما هي القيود المعروفة عند التبديل عبر الواجهة الموحدة؟
– **المعاملات الخاصة غير موحدة**: مستويات التفكير، واستدعاء الأدوات، والمخرجات المهيكلة تتطلب التحقق منها لكل نموذج على حدة.
– **لا يمكن خلط المتجهات**: عند تغيير نموذج Embedding يجب إعادة توليد المتجهات وإعادة بناء الفهرس بالكامل.
– **التدفقات ذات الحالة تفقد أجزاءً منها**: قد يؤدي تبديل النموذج في منتصف مسار Responses إلى فقدان عناصر الاستدلال.
– **نطاق الظهور محدود**: تخضع قائمة النماذج لقيود مجموعات مفاتيح API والصلاحيات ونقاط النهاية، وإذا واجهتك مشكلة فراجع وثائق استكشاف رموز الأخطاء وإصلاحها من APIYI على apiyi.com.
أبرز النقاط حول التبديل بين نماذج اللغة الكبيرة عبر واجهة APIYI الموحدة
- تغيير model فقط له شروط مسبقة: لا يتحقق ذلك إلا عند استخدام نقطة النهاية نفسها والاقتصار على المعاملات العامة التي يدعمها الطرفان.
- طريقتان مختلفتان في عدّ النماذج: رقم 200+ يمثل النماذج المنتقاة، بينما يحتوي السجل على 289 مدخلاً تشمل الإصدارات ومتغيرات المسارات.
- للتحقق تسلسل محدد: معرّف النموذج ← مجموعة الرمز ← نقطة النهاية ← المعاملات، مع استبعاد كل بند على حدة.
- معاملات الصور تحتاج إلى مطابقة: يستخدم MAI
widthوheight، بينما يعتمد Seedream علىsize، كما تختلف طريقة كتابة الشفافية بين النموذجين. - تبديل نموذج المتجهات يستلزم إعادة البناء بالضرورة: النموذجان small وlarge لهما أبعاد افتراضية مختلفة، وحتى عند تطابق الأبعاد لا تتوافق المخرجات بينهما.
- وجود HTTP 200 لا يعني النجاح: يجب فحص سبب الإكمال، والاستجابات ذات الجسم الفارغ، والاستجابات التي تقتصر على استدعاء الأدوات.
- اختبر الأداء بنفسك: اعتمد خط أساس A-A مع القياس المتناوب A-B، ويمكنك إتمام هذه المقارنة عبر APIYI على apiyi.com باستخدام المفتاح نفسه.
الخلاصة
أبرز النقاط عند التبديل بين نماذج اللغة الكبيرة عبر الواجهة الموحدة من APIYI:
- إعادة استخدام المصادقة ونقطة الوصول: مفتاح واحد ونقطة Base URL واحدة تغطيان قدرات متعددة تشمل النصوص والصور والمتجهات.
- التمييز بين المعاملات العامة والخاصة: تُبدَّل المعاملات العامة مباشرةً، أما المعاملات الخاصة فيجب التحقق من كل منها قبل إضافتها.
- جعل التبديل عملية قابلة للاختبار والقبول: استخدم جدول مقارنة رموز الأخطاء في التشخيص، وسجّل بمنهجية ثابتة زمن الاستجابة ومعدل الفشل والمبالغ المخصومة.
ننصحك أولاً بتشغيل النموذجين بنجاح عبر أبسط طلب نصي بحت، ثم التوسع تدريجياً إلى سيناريوهات الأعمال وفق الترتيب التالي: «مطابقة معاملات الصور»، ثم «إعادة بناء فهرس المتجهات»، ثم «تدفقات الأدوات ذات الحالة». ونوصي بالاستفادة من حصة الاختبار المجانية عبر APIYI على apiyi.com لإتمام عمليات التحقق المذكورة، قبل تحديد النموذج الأساسي والخطة الاحتياطية.
📚 المراجع
-
مركز وثائق APIYI: المقدمة الأساسية، البدء السريع، سجل النماذج، تحويل النصوص إلى متجهات، ملاحظات إصدارات النماذج
- الرابط:
docs.apiyi.com - الوصف: المصدر الأول للمعلومات حول معرّفات النماذج (Model ID) والمجموعات ونقاط النهاية والتسعير، ويُرجى الاعتماد في سجل النماذج على النسخة المُنشأة في اليوم نفسه
- الرابط:
-
OpenAI Using GPT-6.2: شرح الترحيل إلى GPT-6.2 والمعاملات الخاصة به
- الرابط:
developers.openai.com/api/docs/guides/latest-model - الوصف: استدعاء الأدوات في Responses، وحقل مستويات التفكير، ودورة حياة عناصر الاستدلال
- الرابط:
-
وثائق استكشاف أخطاء Google Gemini API وتوقيعات التفكير وإصلاحها: استكشاف مشكلات استدعاء Gemini 4
- الرابط:
aistudio.google.com/docs/troubleshooting - الوصف: مستويات التفكير، وإعادة إرسال
thoughtSignature، والأخطاء الشائعة
- الرابط:
-
بدء الاستخدام مع Google Cloud Gemini 4: شرح فك الترميز الطويل وإصدارات الواجهة البرمجية لـ Gemini 4
- الرابط:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/start/get-started-with-gemini-4 - الوصف: تعرّف على إصدارات الواجهة الخاصة بفك الترميز الطويل وشروط استئناف النقل
- الرابط:
-
صفحة مقارنة النماذج من Artificial Analysis: معايير قياس أداء النماذج من جهات خارجية وطرق قياس زمن الاستجابة
- الرابط:
artificialanalysis.ai/models/comparisons/gemini-4-neon-vs-gpt-6-2-sol - الوصف: تُستخدم للمقارنة المرجعية بين النماذج، ولا يصلح استخدامها لتعيين تكاليف القنوات إلى مصادرها
- الرابط:
الكاتب: فريق APIYI التقني
للتبادل التقني: يسعدنا تواصلكم عبر الصفحة الرئيسية لموقع APIYI، ولمزيد من مواد الربط والتكامل يمكنكم زيارة مركز الوثائق docs.apiyi.com