Nota do autor: o GPT-6.2 Sol mantém o preço por token Standard da geração anterior e, em vários testes públicos, melhorou os resultados ou reduziu o custo por tarefa. Antes de atualizar sistemas existentes, ainda é preciso testar separadamente perguntas e respostas sobre base de código, análises complexas e conversas com múltiplas rodadas.
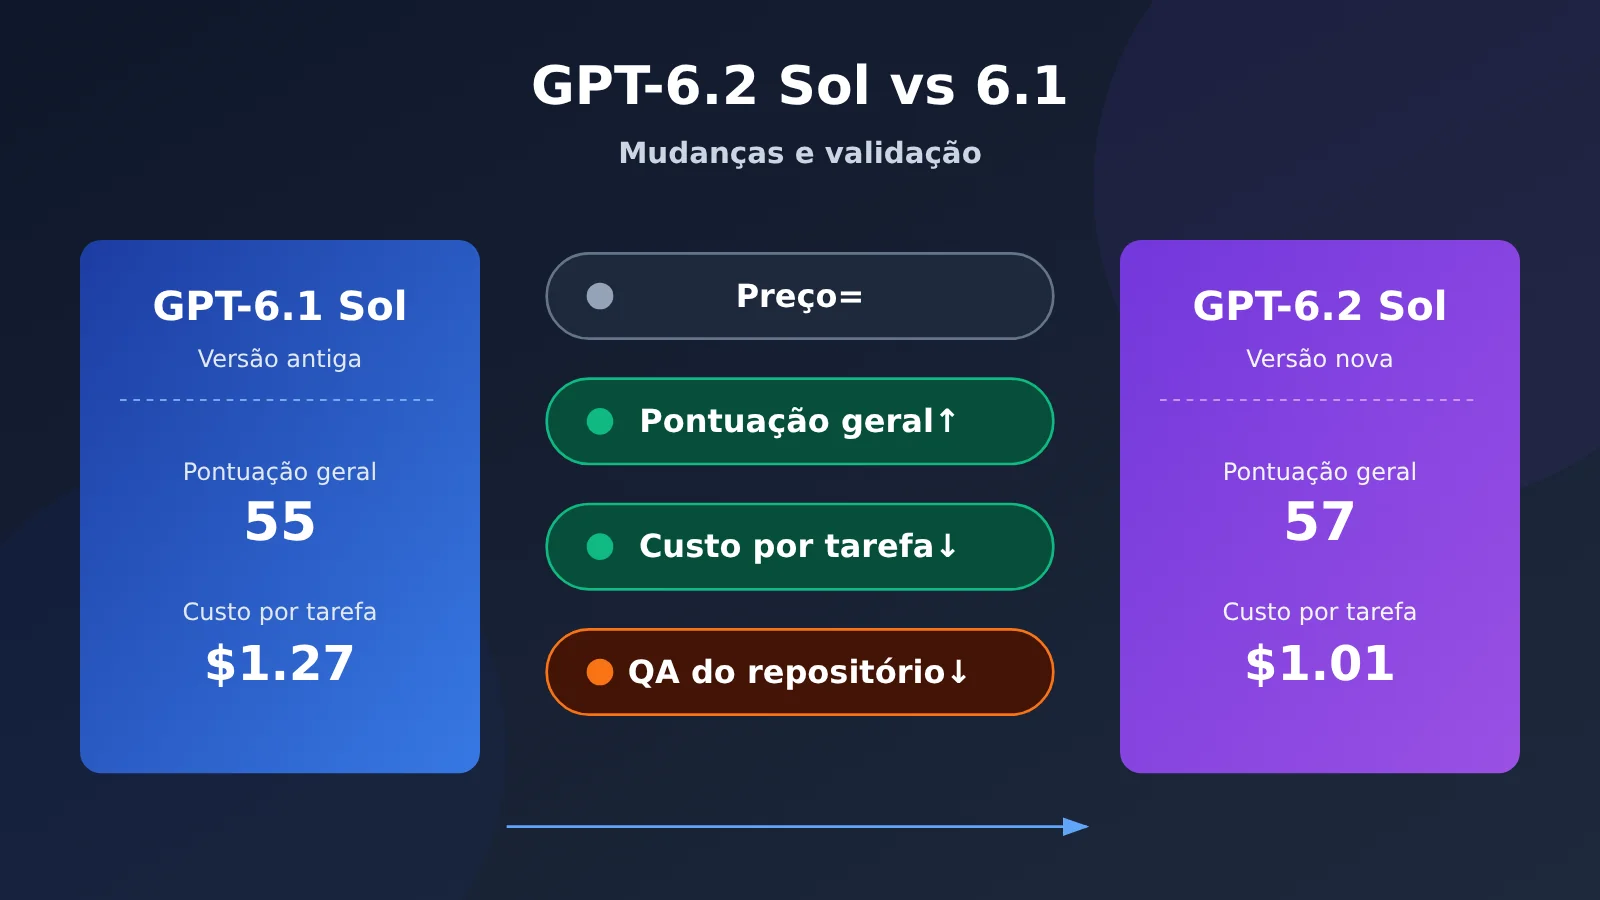
Resumo: o preço unitário Standard de contexto curto do GPT-6.2 Sol é exatamente igual ao do GPT-6.1 Sol; nas avaliações abrangentes, a pontuação é maior e o custo por tarefa é menor, mas há perdas claras em perguntas e respostas sobre base de código e em alguns problemas difíceis. Para ambos, os preços por milhão de tokens para entrada comum, leitura em cache e saída são US$ 2, US$ 0.10 e US$ 10. A pontuação geral do nível Max no Artificial Analysis subiu de 55 para 57, e o custo médio por tarefa caiu de US$ 1.27 para US$ 1.01. No teste de agente de código da mesma instituição, porém, o subitem de perguntas e respostas sobre base de código caiu de 60 para 46, e o teste de análise de dados com Plotly também caiu da pontuação máxima de 43/43 para 40/43.
Portanto, esta atualização é adequada para avançar gradualmente por tipo de tarefa, e não para uma substituição total direta. Modificações de código verificáveis, operações de terminal e análises de rotina podem ser testadas primeiro. Perguntas e respostas sobre base de código, problemas difíceis de padrões ocultos e processamento em lote que depende do Flex precisam primeiro de testes de regressão complementares. Além disso, a Responses API do GPT-6.2 mudou o comportamento em conversas com múltiplas rodadas e no posicionamento de instruções; aplicações multirrodada que usam a versão antiga não podem apenas trocar o ID do modelo.
Comparação rápida entre GPT-6.2 Sol e GPT-6.1 Sol
A tabela abaixo mostra apenas as dimensões úteis para decidir se vale a pena atualizar. Especificações e preços vêm do model card oficial da OpenAI, da página de preços e do changelog. Os preços estão em USD por milhão de tokens.
| Dimensão da comparação | GPT-6.1 Sol | GPT-6.2 Sol | O que a diferença significa |
|---|---|---|---|
| ID do modelo / data de lançamento | gpt-6.1-sol / 2026-09-29 |
gpt-6.2-sol / 2026-11-17 |
Modelo novo, recém-lançado; é preciso observar por um tempo |
| Contexto / saída máxima | 1.050.000 / 128.000 | 1.050.000 / 128.000 | Capacidade inalterada |
| Entrada máxima | Não listada separadamente no model card | 922.000 | Tarefas com entradas muito longas precisam ser verificadas conforme o novo limite |
| Data de corte do conhecimento | 2026-04-30 | 2026-06-01 | Cerca de um mês mais recente |
| Preço Standard para contexto curto | entrada $2 / leitura de cache $0,10 / saída $10 | Igual | Com a mesma combinação de tokens, a cobrança é igual |
| Processamento Flex | Compatível | Não compatível | Usuários do Flex antigo precisam mudar para outro modo de processamento |
| Janela de desconto para processamento em segundo plano | Não abordado nos materiais desta análise | Janela de 2 horas: -30%; janela de 8 horas: -40% | Tarefas que toleram atraso têm uma nova opção de economia |
| Pontuação geral (AA, nível Max) | 55 | 57 | Um pouco melhor no geral |
| Q&A de repositório de código (AA, Codex + Max) | 60 | 46 | Regressão clara; requer validação específica |
🚀 Comparação rápida: as duas gerações podem ser alternadas e comparadas na mesma interface. A tabela pública de modelos da APIYI apiyi.com já inclui
gpt-6.2-sole indica as entradas responses e chat, o que é adequado para rodar testes de regressão entre versões antiga e nova com a mesma chave API.
Sugestão de leitura: na seção 1 do texto, confirme primeiro preços e opções de processamento, pois isso define a base da cobrança. A seção 2 compara avanços e perdas em testes públicos para decidir quais tarefas vale a pena atualizar. A seção 3 verifica mudanças no comportamento da API para avaliar se os serviços atuais podem migrar sem transtornos. A seção 4 traz um plano de validação por tarefa. Se você só se interessa por agentes de programação, pode ir direto para 2.2 e a seção 4.
Termos que você precisa conhecer antes de comparar o GPT-6.2 Sol
| Termo | Explicação resumida |
|---|---|
| Preço padrão por token | Preços públicos da faixa Standard da OpenAI por milhão de tokens de entrada, saída e diferentes usos de cache |
| Custo da tarefa | Custo de modelo e ferramentas para concluir uma tarefa; na validação de negócio, também pode incluir reexecuções e revisão humana |
| Nível de raciocínio | Configuração que controla o orçamento de raciocínio do modelo; valores comuns são Low, Medium, High, Xhigh e Max. Testes comparativos devem usar o mesmo nível |
| GDPval v2 | Avaliação interna da OpenAI para trabalho intelectual complexo, com foco em entregas de processos longos baseadas em tipos de projeto reais |
| Coding Agent Index | Índice abrangente de agentes calculado pelo Artificial Analysis com base em subitens como alteração de código, operação de terminal e Q&A de repositório de código |
| SWE-Atlas-QnA-AA | Subitem de Q&A de repositório de código do índice acima, que verifica se os fatos necessários para a resposta estão completos |
| Prefixo de sessão / leitura de cache | Conteúdo no início de solicitações de múltiplos turnos que mantém a ordem consistente; após o serviço identificar um prefixo reutilizável, a parte com acerto é cobrada pela taxa de leitura |
1. GPT-6.2 Sol vs GPT-6.1 Sol: especificações básicas e preço
1.1 As especificações do GPT-6.2 Sol basicamente mantêm as da geração anterior
Os dois modelos podem ser chamados tanto via Responses quanto via Chat Completions, e chamadas de função e ferramentas integradas usam o caminho Responses. Ambos aceitam entrada de texto e imagem, geram texto nativamente, têm janela de contexto de 1,050,000 tokens e saída máxima de 128,000 tokens. O model card do 6.2 Sol lista separadamente uma entrada máxima de 922,000 tokens.
Há uma diferença sutil no posicionamento. A página do modelo 6.1 Sol enfatiza concluir tarefas complexas de código, operações de computador e tarefas profissionais com custo inferior ao do Astra; já a página do 6.2 Sol pende para código do dia a dia e trabalho de agentes em escala. Ou seja, o 6.2 Sol é mais explicitamente voltado para cenários de alta frequência e em lote.
1.2 O preço Standard do GPT-6.2 Sol é o mesmo da geração anterior
A cobrança oficial do Standard é a seguinte. As duas gerações usam o limite de 272K tokens de entrada por requisição: acima disso, as tarifas de entrada e de cache de toda a requisição passam a ser calculadas em 2x, e a saída em 1.5x.
| Categoria de cobrança Standard | Contexto curto (≤272K) | Contexto longo (>272K) |
|---|---|---|
| Entrada normal | $2.00 | $4.00 |
| Leitura de cache | $0.10 | $0.20 |
| Escrita de cache de 30 minutos | $2.50 | $5.00 |
| Escrita de cache de 12 horas | $5.00 | $10.00 |
| Saída (inclui tokens de raciocínio) | $10.00 | $15.00 |
Preço unitário igual não significa fatura igual. Ao concluir a mesma tarefa, o número de tokens de saída, a quantidade de chamadas de ferramentas e as taxas de acerto de cache do 6.2 Sol podem variar, então o custo real precisa ser calculado por tarefa. A escrita de cache deve ser calculada pela tarifa integral correspondente, sem somar novamente o preço de entrada normal dos mesmos tokens. O total de saída pode ser lido em usage.output_tokens do Responses, e o uso de raciocínio normalmente aparece na subchave output_tokens_details.reasoning_tokens.
Sobre chamadas no mercado interno: em 2026-11-20, no endpoint público de preços do APIYI apiyi.com, o preço da faixa curta do gpt-6.2-sol é igual ao oficial; na faixa longa, entrada normal, leitura de cache, escrita de cache e saída são, respectivamente, $3, $0.15, $3.75 e $11.25. Essa é a expressão de preço divulgada publicamente; a cobrança efetiva depende do grupo da conta e da configuração atual da plataforma.
1.3 Flex e a escolha entre a janela de desconto em background
As mudanças nas opções de processamento são as mais fáceis de passar despercebidas. O 6.1 Sol ainda está na lista de modelos elegíveis para o Flex; o 6.2 Sol não oferece suporte ao Flex. Como alternativa, o 6.2 Sol pode usar a janela de desconto em background do Responses: para requisições elegíveis, a tarifa de tokens do modelo é 30% menor que a Standard na janela de 2 horas e 40% menor na janela de 8 horas.
Se um sistema antigo depende do Flex para rodar processamento em lote offline, na migração é preciso escolher de novo com base no prazo de entrega e nas condições de acesso. Tarefas que aceitam entrega em algumas horas podem considerar a janela em background; tarefas que exigem retorno imediato só podem ser cobradas pela Standard.
2. GPT-6.2 Sol vs GPT-6.1 Sol: avanços e perdas nos testes públicos
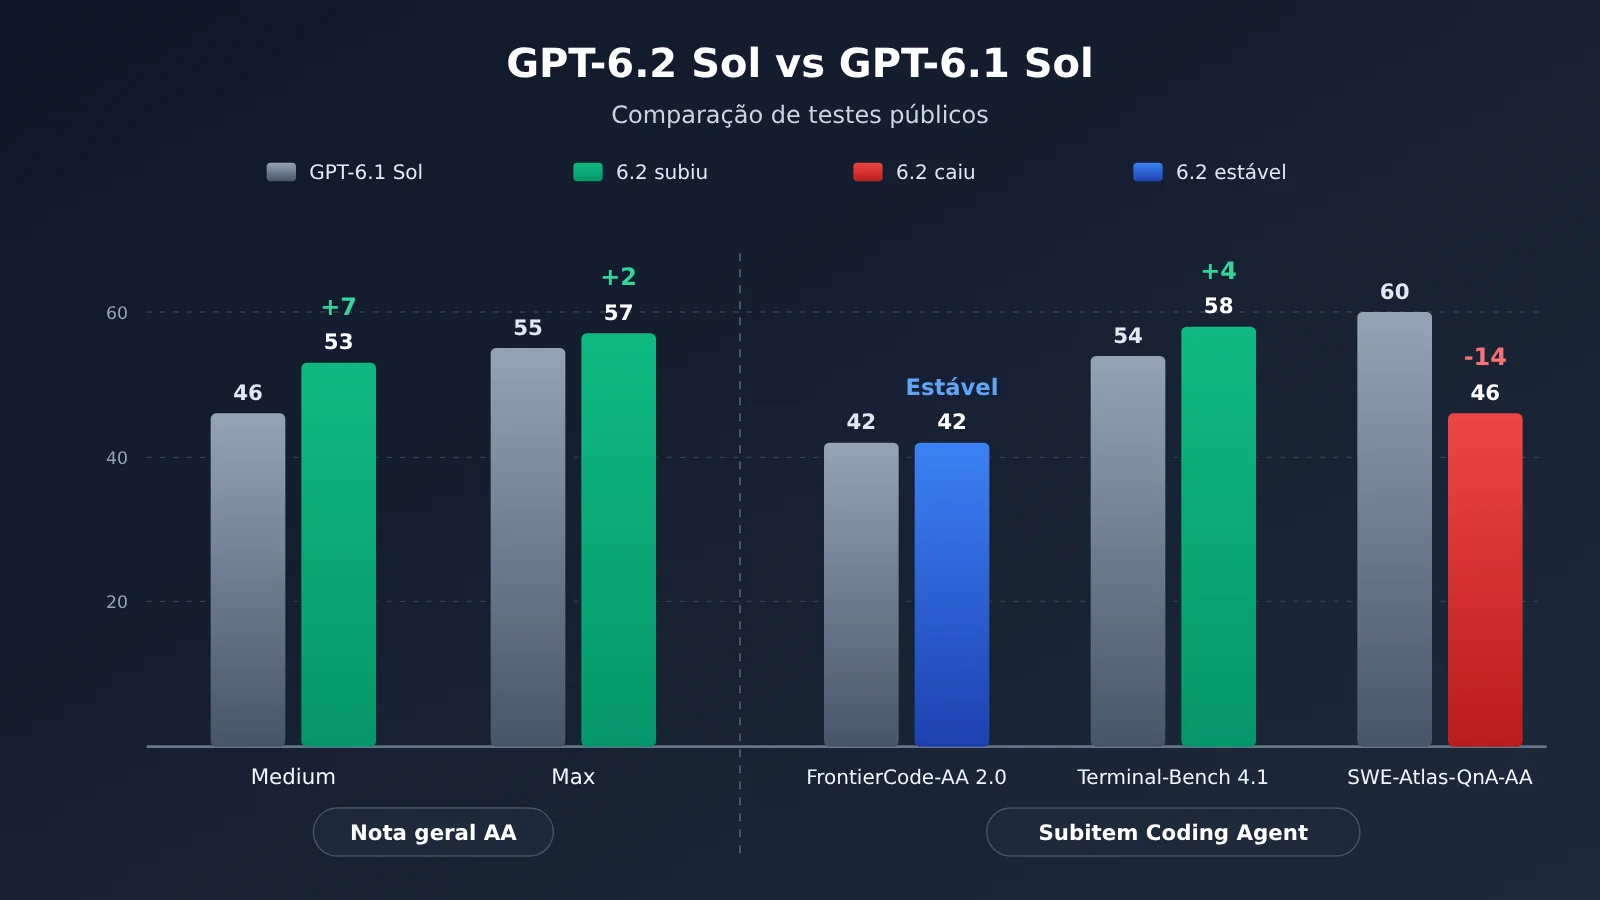
O gráfico acima reúne dados públicos de terceiros, em que verde indica melhora do 6.2 Sol e vermelho indica queda. Esses números vêm de instituições e frameworks de teste diferentes, então só fazem sentido dentro das condições de cada um. Se quiser reproduzir nas suas próprias tarefas, dá para chamar as duas gerações do modelo separadamente, pela mesma via e no mesmo nível, usando APIYI apiyi.com.
2.1 Trabalho de conhecimento e capacidade geral: GPT-6.2 Sol com melhora constante
Autodeclaração oficial: No anúncio de lançamento de 17/11/2026, a OpenAI afirma que o 6.2 Sol está 5,3 pontos percentuais acima do 6.1 Sol na avaliação interna GDPval v2. O GDPval v2 testa trabalho de conhecimento em várias etapas nas áreas de consultoria, finanças, design e outras, e essa conclusão vale apenas para os testes internos divulgados pela OpenAI. O anúncio traz ainda a frase “redução de 22% nos tokens de saída”, mas a comparação é entre GPT-6.2 Astra e GPT-6 Astra, e não se aplica à comparação entre as duas gerações do Sol.
Medição de terceiros: A pontuação composta da Artificial Analysis cobre trabalho de conhecimento, programação, ciência e conhecimento geral. Na passagem do 6.1 Sol para o 6.2 Sol, o nível Medium subiu de 46 para 53, e o Max de 55 para 57. O custo médio por tarefa no nível Max caiu de US$ 1,27 para US$ 1,01, o que dá uma redução de cerca de 20% com base nos valores arredondados divulgados.
As duas fontes apontam na mesma direção: o 6.2 Sol é mais forte em tarefas gerais e sai mais barato por tarefa. Vale destacar que o ganho no nível Medium (+7) é claramente maior do que no Max (+2). Para equipes que no dia a dia usam o nível médio de raciocínio, essa atualização deve ser percebida de forma mais evidente.
2.2 Modificação de código, terminal e perguntas e respostas sobre base de código: GPT-6.2 Sol tem altos e baixos
No Coding Agent Index v2.1 da Artificial Analysis, as duas gerações de modelos usam o framework de teste Codex e o nível de raciocínio Max, com o mesmo critério:
| Métrica (Codex + Max) | GPT-6.1 Sol | GPT-6.2 Sol | Variação |
|---|---|---|---|
| Coding Agent Index — geral | 52 | 49 | -3 |
| FrontierCode-AA 2.0 | 42 | 42 | estável |
| Terminal-Bench 4.1 | 54 | 58 | +4 |
| SWE-Atlas-QnA-AA (perguntas e respostas sobre base de código) | 60 | 46 | -14 |
| Custo médio de API por tarefa | $1.51 | $1.22 | cerca de -19% |
| Tempo médio de execução do agente | 21.9 minutos | 17.5 minutos | -4.4 minutos |
A pontuação geral caiu principalmente porque o subitem de perguntas e respostas sobre base de código perdeu 14 pontos, o que compensou o ganho de 4 pontos no subitem de terminal, enquanto o subitem de modificação de código ficou estável. A métrica de tempo de execução exclui os custos de inicialização do ambiente, revisão e validação, refletindo apenas o tempo de execução do próprio agente. Além disso, o FrontierCode-AA 2.0 aqui é a versão da Artificial Analysis e não deve ser confundido com rankings de mesmo nome de outras instituições.
O comparativo de uma única rodada do DataAnalyticsBench divulgado pela Plotly em 2026-11-17 oferece uma referência para outro tipo de tarefa independente. A pontuação total de 6.1 Sol → 6.2 Sol foi de 43/43 → 40/43, o custo da rodada inteira caiu de $2.61 para $1.22, e o tempo mediano por questão caiu de 17.6 segundos para 10.5 segundos. O número de chamadas de ferramentas caiu de 258 para 158, e o volume de saída caiu de cerca de 70,000 tokens para 45,000 tokens. As três questões que o 6.2 Sol errou se concentraram em problemas de padrões ocultos.
Esses resultados têm duas limitações. Primeiro, o teste usou a estrutura fixa do OpenRouter e da Plotly, e o custo reflete as condições do canal naquele momento. Segundo, cada modelo rodou apenas uma vez; quando a Plotly repetiu testes com outros modelos, observou variações de até três questões. Por isso, os resultados servem mais para ilustrar uma tendência: o 6.2 Sol faz menos ações, é mais rápido e gasta menos, mas pode “parar cedo demais” em problemas difíceis que exigem aprofundamento.
3. Como o comportamento da API do GPT-6.2 Sol afeta os serviços existentes
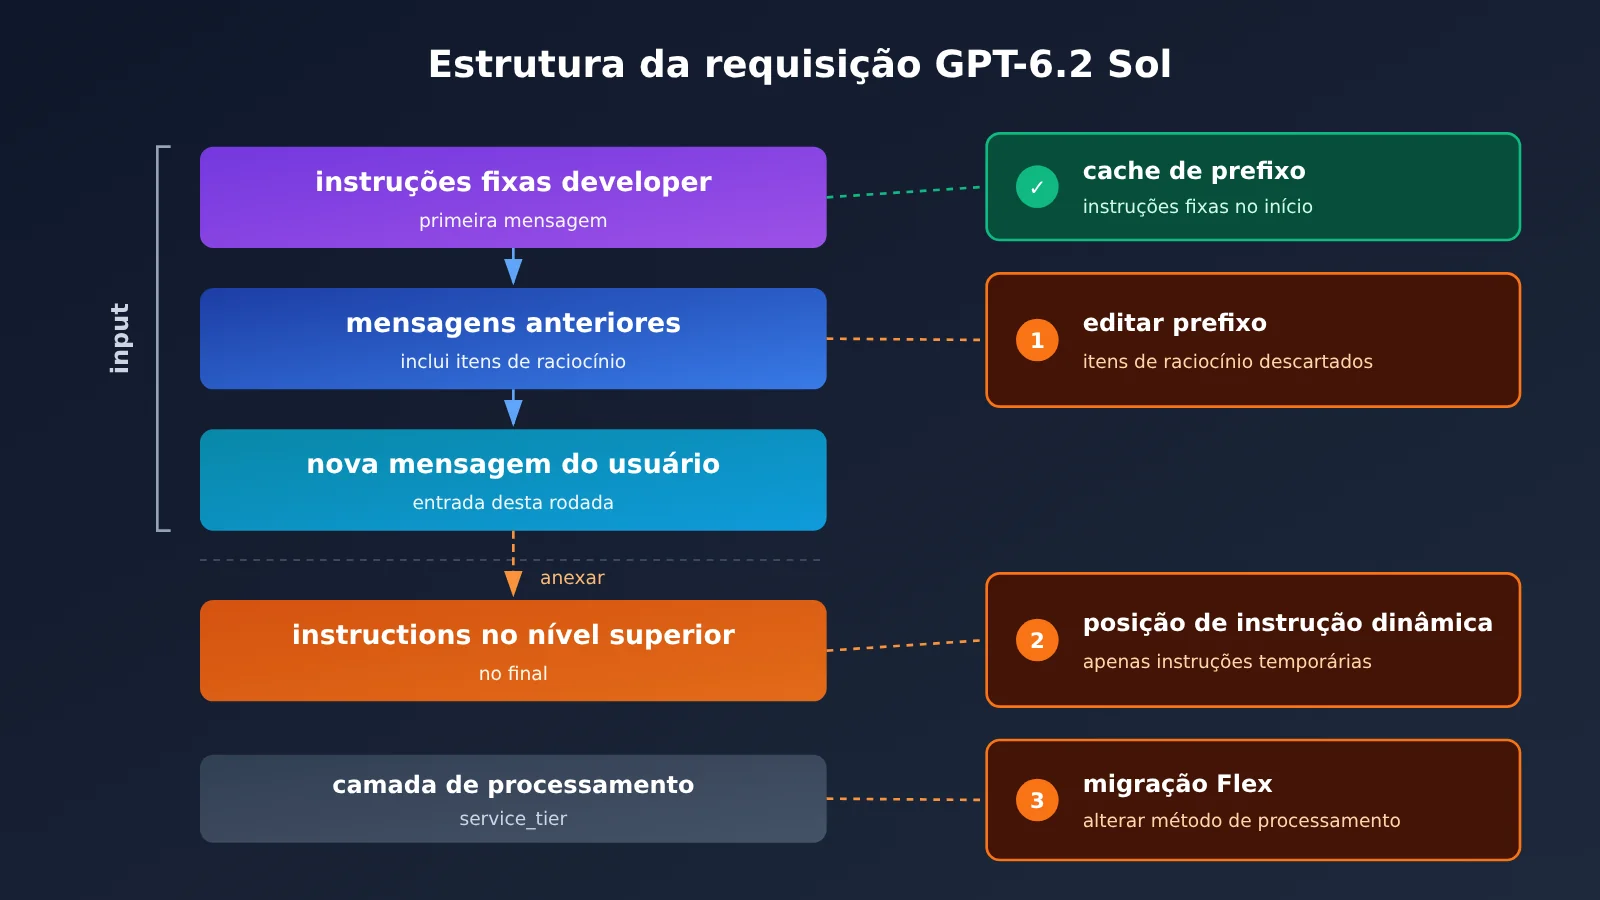
Para aplicações multi-turno que já rodam o 6.1 Sol, os riscos se concentram em três frentes. O diagrama acima mostra a estrutura recomendada de requisição da Responses API do GPT-6.2, que pode ser verificada diretamente pela entrada responses do APIYI apiyi.com seguindo essa estrutura.
- Reescrita do prefixo da sessão: A Responses API do GPT-6.2 descarta os itens de raciocínio anteriores ao editar o prefixo de uma sessão existente, em algumas trocas de modelo e ao alternar o usuário final ou a organização. Se o sistema tiver lógica de “reescrever o histórico e continuar a conversa”, é preciso verificar se a qualidade da continuação e o cache hit são afetados.
- Posição das instruções: As
instructionsde nível superior do GPT-6.2 são anexadas após oinput. Instruções fixas que precisam ser reutilizadas e que se deseja que acertem o cache devem ficar na primeira mensagemdeveloperdoinput; instruções temporárias que mudam a cada vez podem continuar usando asinstructionsde nível superior. - Migração Flex: ver seção 1.3; requisições que antes usavam Flex precisam escolher outra forma de processamento.
Além disso, nenhum dos dois endpoints aceita o nível de raciocínio none. Ao substituir o ID do modelo, também é preciso verificar, conforme o guia de migração oficial, a reescrita de histórico, os parâmetros de amostragem, o nível de raciocínio, a camada de processamento e os dados de cache.
3.1 Exemplo mínimo de chamada do GPT-6.2 Sol
A seguir, uma verificação mínima usando Chat Completions:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada da APIYI
)

resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "用三句话说明什么是会话前缀缓存"}]
)
print(resp.choices[0].message.content)
Ver o código de comparação entre as versões antiga e nova da Responses API (instruções fixas no início + registro de uso)
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Versões nova e antiga usam o mesmo canal, garantindo comparação justa
)

STABLE_RULES = "你是代码库助手。回答必须列出涉及的文件路径、调用方和配置开关。"

def run(model: str, question: str, effort: str = "medium"):
    resp = client.responses.create(
        model=model,
        reasoning={"effort": effort},   # Nenhum dos dois endpoints aceita none
        input=[
            # Instruções fixas vão na primeira mensagem developer do input, o que favorece o cache de prefixo
            {"role": "developer", "content": STABLE_RULES},
            {"role": "user", "content": question},
        ],
        # Instruções temporárias podem ir no instructions de nível superior; elas são anexadas após o input
        instructions="本轮只回答与鉴权模块相关的部分。",
    )
    usage = resp.usage
    details = getattr(usage, "output_tokens_details", None)
    return {
        "model": model,
        "text": resp.output_text,
        "output_tokens": usage.output_tokens,
        "reasoning_tokens": getattr(details, "reasoning_tokens", None),
    }

for m in ["gpt-6.1-sol", "gpt-6.2-sol"]:
    r = run(m, "登录失败后的重试逻辑在哪里实现?受哪些配置影响?")
    print(r["model"], r["output_tokens"], r["reasoning_tokens"])
    print(r["text"][:300], "\n---")
🎯 Recomendação técnica: ao migrar aplicações multi-turno, vale a pena manter um conjunto de requisições reais no formato “prefixo inalterado, apenas acrescentando mensagens” e enviá-las às gerações antiga e nova separadamente, comparando as respostas e o uso de leitura de cache. O APIYI apiyi.com permite chamar as duas gerações de modelos ao mesmo tempo, o que facilita incluir os testes comparativos no CI.
4. Aceitação por tarefa antes da migração para o GPT-6.2 Sol
O plano abaixo é um desenho de teste proposto com base nas evidências públicas apresentadas acima, e não um requisito oficial. O princípio central é manter tudo igual, exceto o modelo: mesmo canal de API, mesmo nível de raciocínio, mesmos materiais de entrada, mesma lista de ferramentas, mesmas configurações de timeout e mesmas regras de pontuação, além de manter o 6.1 Sol como grupo de controle.
| Tipo de tarefa | Prioridade de teste | Principais evidências | Condição de aceitação |
|---|---|---|---|
| Modificação de código | Teste prioritário | FrontierCode-AA 2.0 está empatado, com redução de custo e duração | Taxa de aprovação nos testes não inferior à versão antiga e custo por entrega qualificada menor |
| Operações de terminal / computador | Teste prioritário | Terminal-Bench 4.1 +4 | Taxa de sucesso e tempo de ponta a ponta P50, P95 |
| Análise de rotina | Teste prioritário | Pontuação geral sobe; tempo e custo do Plotly caem | Taxa de aceitação na primeira rodada e número de itens omitidos |
| Perguntas e respostas sobre base de código | Aceitação específica | SWE-Atlas-QnA-AA -14 | Cobertura dos fatos obrigatórios previamente marcados |
| Análise complexa de baixa frequência / casos difíceis | Aceitação específica | Perda de pontos em questões de padrões ocultos do Plotly | Custo por entrega qualificada após revisão |
| Fluxos multi-turno | Aceitação específica | Descarte de itens de raciocínio e mudança na posição das instruções | Consistência dos resultados após replay, preenchimento retroativo do histórico e recuperação de falhas |
Durante a execução, você pode seguir a lista abaixo:
- Perguntas e respostas sobre base de código: para cada questão, anote antecipadamente os chamadores, flags de configuração, condições de ramificação e caminhos de arquivo que precisam ser cobertos; verifique item a item se as evidências estão completas, não apenas se a resposta “parece correta”.
- Registrar métricas: por tipo de tarefa, registre taxa de aceitação na primeira rodada, itens omitidos, número de retrabalhos, tempo de ponta a ponta e uso de modelos e ferramentas; quando houver amostra suficiente, observe P50 e P95 ao mesmo tempo.
- Calcular custos: use “custo total durante a avaliação ÷ número de tarefas aprovadas na aceitação” para estimar o custo por entrega qualificada; os custos de revisão e reexecução também entram no total. O 6.2 Sol é mais barato por chamada, mas se o retrabalho em casos difíceis aumentar, o custo qualificado pode subir.
- Decidir a ampliação de volume: somente os tipos de tarefa que atendem aos três critérios — qualidade, custo por entrega qualificada e latência — devem ter o tráfego ampliado; os que não atingem continuam no 6.1 Sol até a próxima rodada de reteste.
💰 Dica de cálculo de custo: os preços unitários do mesmo canal são iguais, e só assim a comparação faz sentido. Com uma única Key do APIYI apiyi.com, é possível rodar as duas gerações de modelos ao mesmo tempo, com a fatura registrada separadamente por modelo, o que permite calcular diretamente o custo por entrega qualificada.
GPT-6.2 Sol vs GPT-6.1 Sol: como escolher
Se sua carga de trabalho for focada em modificação de código, agentes de terminal e análises de rotina, o 6.2 Sol é a escolha mais rápida e econômica na mesma faixa de preço, e você pode priorizar a migração. Se o Q&A sobre bases de código, problemas difíceis do tipo “padrões ocultos” tiverem uma proporção alta, ou se o negócio depender do Flex, você deve primeiro concluir a aceitação específica da seção 4; antes que as métricas correspondentes sejam atingidas, pode continuar usando o 6.1 Sol para essa parte do tráfego. A variável-chave que determina essa escolha é a composição das tarefas: quanto maior a proporção de casos difíceis, maior a chance de as vantagens do 6.2 Sol em preço unitário e velocidade serem anuladas pelo retrabalho.
Recomenda-se começar usando a cota gratuita de teste para novos usuários no APIYI apiyi.com, selecionar amostras representativas de cada tipo de tarefa e rodar uma rodada de comparação, e então decidir o escopo da migração com base nos resultados.
Referências
- Anúncio de lançamento da OpenAI: Notas de lançamento do GPT-6.2 Astra e Sol e conclusões do GDPval v2
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol
- Link:
- Ficha do modelo e preços da API OpenAI: Especificações, preços e opções de processamento das duas gerações do Sol
- Link:
developers.openai.com/api/docs/models/gpt-6.2-sol - Link:
developers.openai.com/api/docs/pricing
- Link:
- Guia de uso do GPT-6.2: Mudanças de comportamento do Responses e itens de verificação para migração
- Link:
developers.openai.com/api/docs/guides/latest-model
- Link:
- Artificial Analysis: Pontuação geral e dados detalhados do Coding Agent Index
- Link:
artificialanalysis.ai/agents/coding-agents/codex
- Link:
- Plotly DataAnalyticsBench: Comparação de rodada única do 6.2 Sol e explicação dos erros
- Link:
plotly.com/blog/gpt-6-2-sol-plotly-data-analytics-bench
- Link:
Autor: Equipe técnica da APIYI
Comunicação técnica: Sinta-se à vontade para nos contatar na página inicial do APIYI apiyi.com; mais materiais de integração estão disponíveis no centro de documentação docs.apiyi.com