Resumo: Nas tarefas de vídeo orientadas por código do VibeVideoBench, o GPT-6 Astra já está no mesmo nível do Claude Opus 5.5, com qualidade geral ligeiramente superior e custo menor; o Opus 5.5 entrega com mais estabilidade; o próximo modelo de uso geral da OpenAI ainda não foi lançado, e sua capacidade em vídeo precisa ser testada na prática após o lançamento.
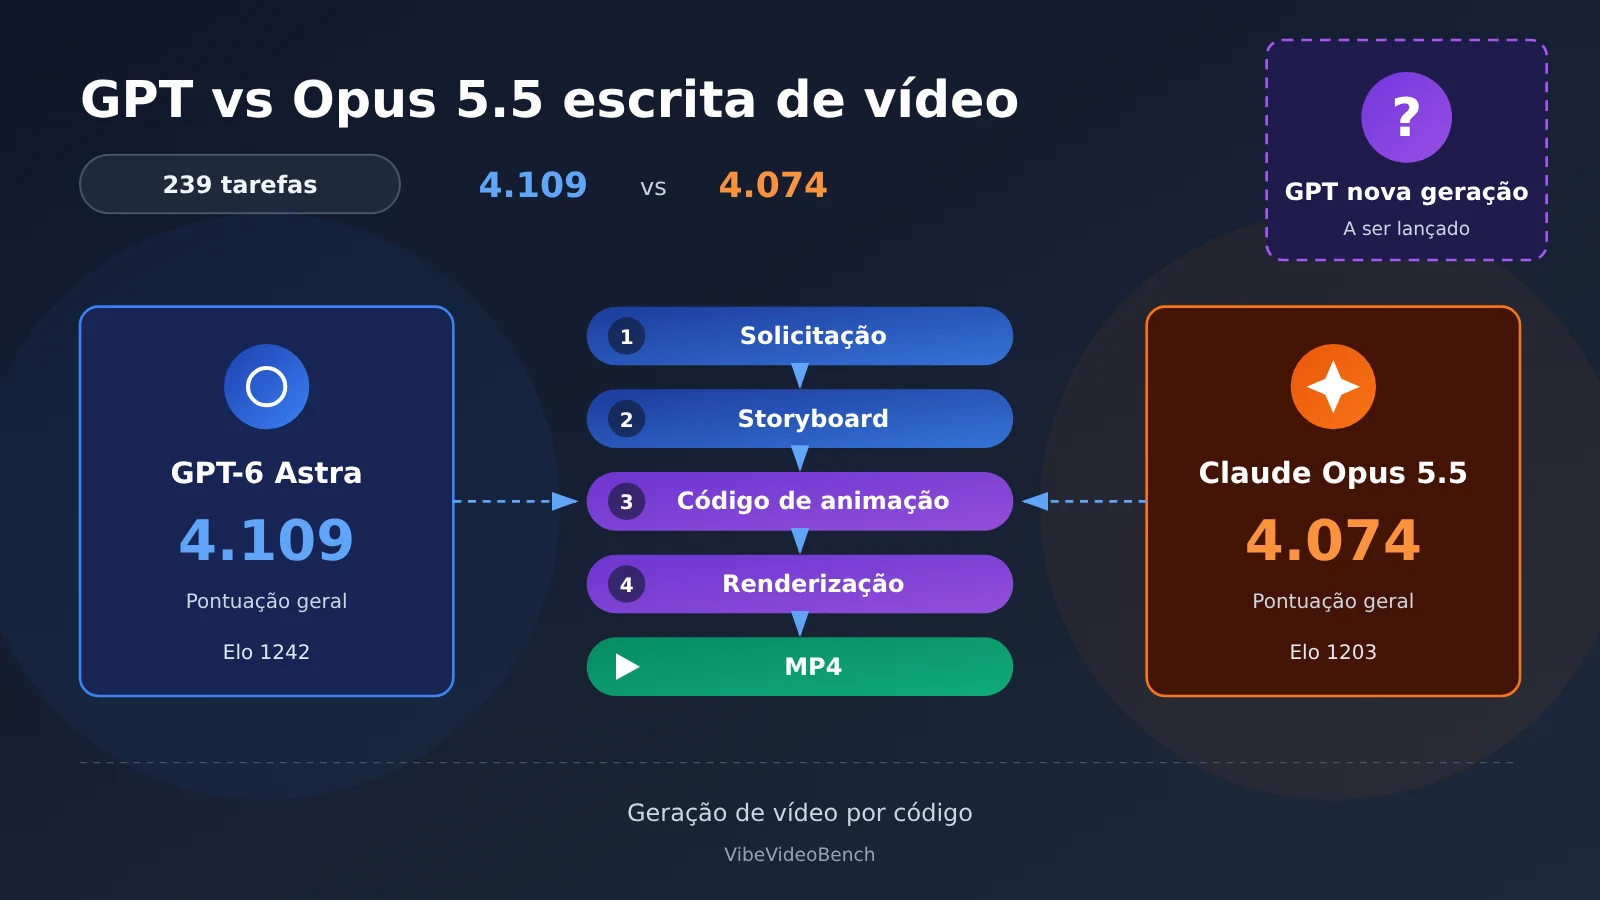
Conclusão antecipada: Em 15 de novembro de 2026, na rota em que um Agent escreve código, chama ferramentas de renderização e entrega um MP4 completo, GPT-6 Astra e Claude Opus 5.5 são os dois sistemas mais próximos no VibeVideoBench. O Astra obteve pontuação de qualidade geral 4,109, e o Opus 5.5, 4,074; no teste cego humano, os Elo foram 1242 e 1203, respectivamente, sem diferença estatística. O Opus 5.5 entregou todas as 239 tarefas, com taxa de sucesso em tarefas estritas de 76,3%, acima dos 74,5% do Astra; o custo médio de API por tarefa do Astra foi de US$ 8,19, cerca de metade do Opus 5.5. A OpenAI já publicou duas evidências de que modelos internos são significativamente mais fortes que o Astra, mas o nome, a data de lançamento e o desempenho específico em vídeo do próximo GPT de uso geral não foram divulgados. Portanto, a resposta à pergunta do título é: o GPT atual já alcançou; se a próxima geração conseguirá abrir vantagem depende de testes reais após o lançamento.
Prévia do conteúdo: A seguir, delimitamos primeiro o escopo da avaliação e depois detalhamos os resultados gerais, os resultados por categoria, as preferências humanas e os dados de custo do VibeVideoBench, explicando de onde vêm as vantagens de cada um; em seguida, organizamos os sinais públicos sobre os modelos internos da OpenAI e o status de lançamento do próximo modelo, analisando o verdadeiro gargalo dos agentes de vídeo; por fim, apresentamos um método de teste comparativo que pode ser reutilizado diretamente após o lançamento de um novo modelo, para ajudar você a decidir se vale a pena substituir a solução atual.
Para saber: termos que você precisa entender antes de ler este artigo
| Termo | Explicação |
|---|---|
| Code-driven Video Generation | Geração de vídeo orientada por código: a IA escreve programas de animação e renderização e, no final, gera um MP4 |
| Native Video Generation | Geração de vídeo nativa: o modelo gera as imagens do vídeo diretamente a partir de texto ou imagens; entre os produtos representativos estão Sora e Veo |
| VibeVideoBench | Benchmark criado especialmente para avaliar agentes de IA que produzem vídeos completos de forma autônoma; publicado em 26 de outubro de 2026 |
| Harness | Ambiente de execução do modelo, que oferece recursos como execução de código, acesso a arquivos e chamada de ferramentas, como Codex CLI e Claude Code |
| L1 / L2 / L3 | As três camadas da avaliação: verificação da entrega do programa, checagem item a item dos requisitos da tarefa e pontuação da qualidade do vídeo por avaliação multimodal |
| Taxa de sucesso rigoroso da tarefa | Proporção de tarefas em que o vídeo é entregue com sucesso e atende a todas as restrições; é mais rigorosa do que a simples “taxa de entrega” |
| Bradley–Terry Elo | Método de pontuação que calcula a preferência relativa dos modelos com base em comparações humanas par a par |
| Multi-agent Orchestration | Orquestração multiagente: fazer vários agentes trabalharem em conjunto, dividindo tarefas, e depois integrar os resultados |
| Render Pipeline | Pipeline de renderização de vídeo: geração de imagens, processamento de áudio, codificação e composição até a saída final |
| Remotion / FFmpeg | O primeiro usa código React para criar animações de vídeo; o segundo cuida da codificação e composição de áudio e vídeo |
| ffprobe | Ferramenta de inspeção que acompanha o FFmpeg, usada para ler informações do vídeo, como resolução, taxa de quadros, duração e faixas de áudio |
| Cache Hit | Taxa de acerto de cache: proporção de contexto repetido lida a partir do cache, o que afeta diretamente o custo de API em tarefas longas |
| BenchCAD 2.0 | Avaliação de engenharia que testa a capacidade da IA de reconstruir peças 3D, projetar montagens mecânicas e reconhecer conexões de PCB |
1 Primeiro, a conclusão: o GPT já entrou na faixa de competição de criação de vídeos do Opus 5.5
1.1 Que tipo de “escrever vídeo” este artigo compara
A criação de vídeos com IA hoje tem duas rotas. A geração de vídeo nativa faz o modelo produzir diretamente quadros contínuos, com boa capacidade para personagens, movimento físico e linguagem de câmera; já a geração de vídeo orientada por código coloca o modelo no papel de diretor e programador: entender o pedido, escrever roteiro e storyboard, criar a animação com Remotion, Three.js, Cairo ou Blender, gerar a narração com TTS e depois montar e revisar o vídeo final com FFmpeg.
Este artigo trata da segunda rota, ou seja, da capacidade de entregar um MP4 completo e um projeto editável por meio de agentes como Codex CLI e Claude Code. Essa rota é adequada para visualização de dados, apresentações de produto, divulgação científica, infográficos dinâmicos e vídeos de branding, e é justamente o campo em que GPT e Claude têm benchmarks independentes comparáveis hoje.
A própria linha de produtos de vídeo nativo da OpenAI mudou: o produto Sora encerrou o serviço em 26 de abril de 2026, e o modelo Sora 2 e a Videos API foram desativados em 24 de setembro, com o aviso oficial de descontinuação indicando que não havia uma API substituta um para um. O GPT-Image-2.6, lançado em 4 de novembro, suporta saída de animação em GIF de 2 a 16 quadros, adequada para memes, ações em loop e pré-visualização de storyboard, o que pertence a um fluxo de trabalho diferente da produção de um MP4 completo. Portanto, a capacidade de “escrever vídeo” da linha GPT, neste momento, se manifesta principalmente na rota orientada por código.
1.2 Respondendo à pergunta do título em uma frase
O GPT-6 Astra está extremamente próximo do Opus 5.5 no VibeVideoBench, com pontuação geral ligeiramente superior e estabilidade de entrega ligeiramente inferior. O modelo da próxima geração da OpenAI apresenta sinais técnicos de que pode continuar melhorando, mas os resultados públicos específicos de vídeo ainda têm o Astra como referência.
2 239 tarefas reais de vídeo: GPT-6 Astra ou Opus 5.5, qual é mais forte?
2.1 Como o VibeVideoBench avalia a capacidade de vídeo do GPT e do Opus 5.5
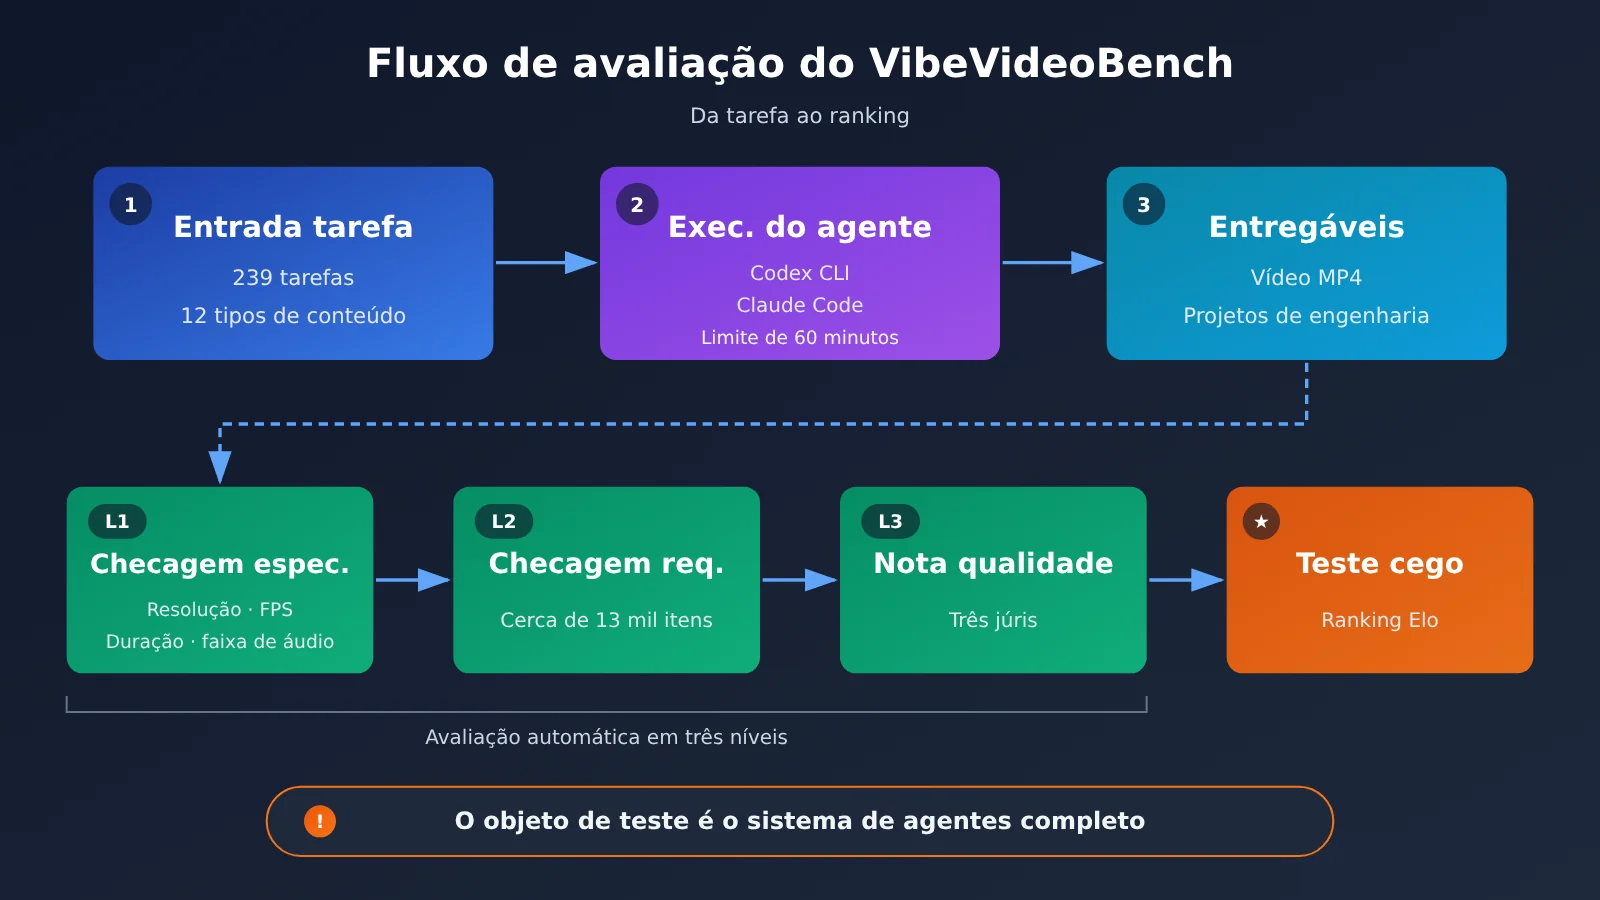
O VibeVideoBench criou 239 tarefas reais de produção de vídeo, cobrindo 12 categorias de conteúdo, e testou 9 sistemas de agente, com um total de 2.151 execuções. Cada tarefa exige que a IA conclua o trabalho de forma autônoma em um sandbox, entregando um MP4 reproduzível, um projeto de engenharia capaz de regerar o vídeo e instruções de produção. Cada tarefa tem limite de 60 minutos; todos os sistemas usam seus ambientes de desenvolvimento nativos e a maior intensidade de raciocínio disponível, sem instruções humanas adicionais durante o processo.
O GPT-6 Astra roda no Codex CLI, e o Claude Opus 5.5 roda no Claude Code. Os demais sistemas avaliados incluem Claude Sonnet 5.5, Gemini 4 Argon, DeepSeek V4.1 Flash, Kimi K3, GLM-5.3 Flash, GPT-5.6 Sol e Gemini 3.8 Flash. A pontuação é dividida em três camadas: a L1 verifica se o MP4 foi entregue e se atende a especificações como resolução, taxa de quadros, duração e faixa de áudio; a L2 valida, uma a uma, cerca de 13 mil exigências da tarefa; a L3 conta com três sistemas de avaliação multimodal que julgam qualidade de imagem, estética, lógica de conteúdo, ritmo de movimento e sincronização de áudio.
2.2 Comparação geral de desempenho entre GPT-6 Astra e Opus 5.5
| Métrica | GPT-6 Astra | Claude Opus 5.5 | Vantagem |
|---|---|---|---|
| Vídeos entregues com sucesso | 238/239 | 239/239 | Opus |
| Taxa de entrega de vídeos | 99,6% | 100% | Opus |
| Taxa de conformidade com as especificações | 93,7% | 99,6% | Opus |
| Taxa de aprovação nos requisitos da tarefa | 97,1% | 97,3% | Opus |
| Qualidade do vídeo | 4,08 | 3,99 | Astra |
| Estética visual | 4,30 | 4,19 | Astra |
| Lógica de conteúdo | 4,20 | 4,18 | Astra |
| Movimento e ritmo | 3,95 | 3,95 | Empate |
| Qualidade e sincronização do áudio | 4,10 | 4,07 | Astra |
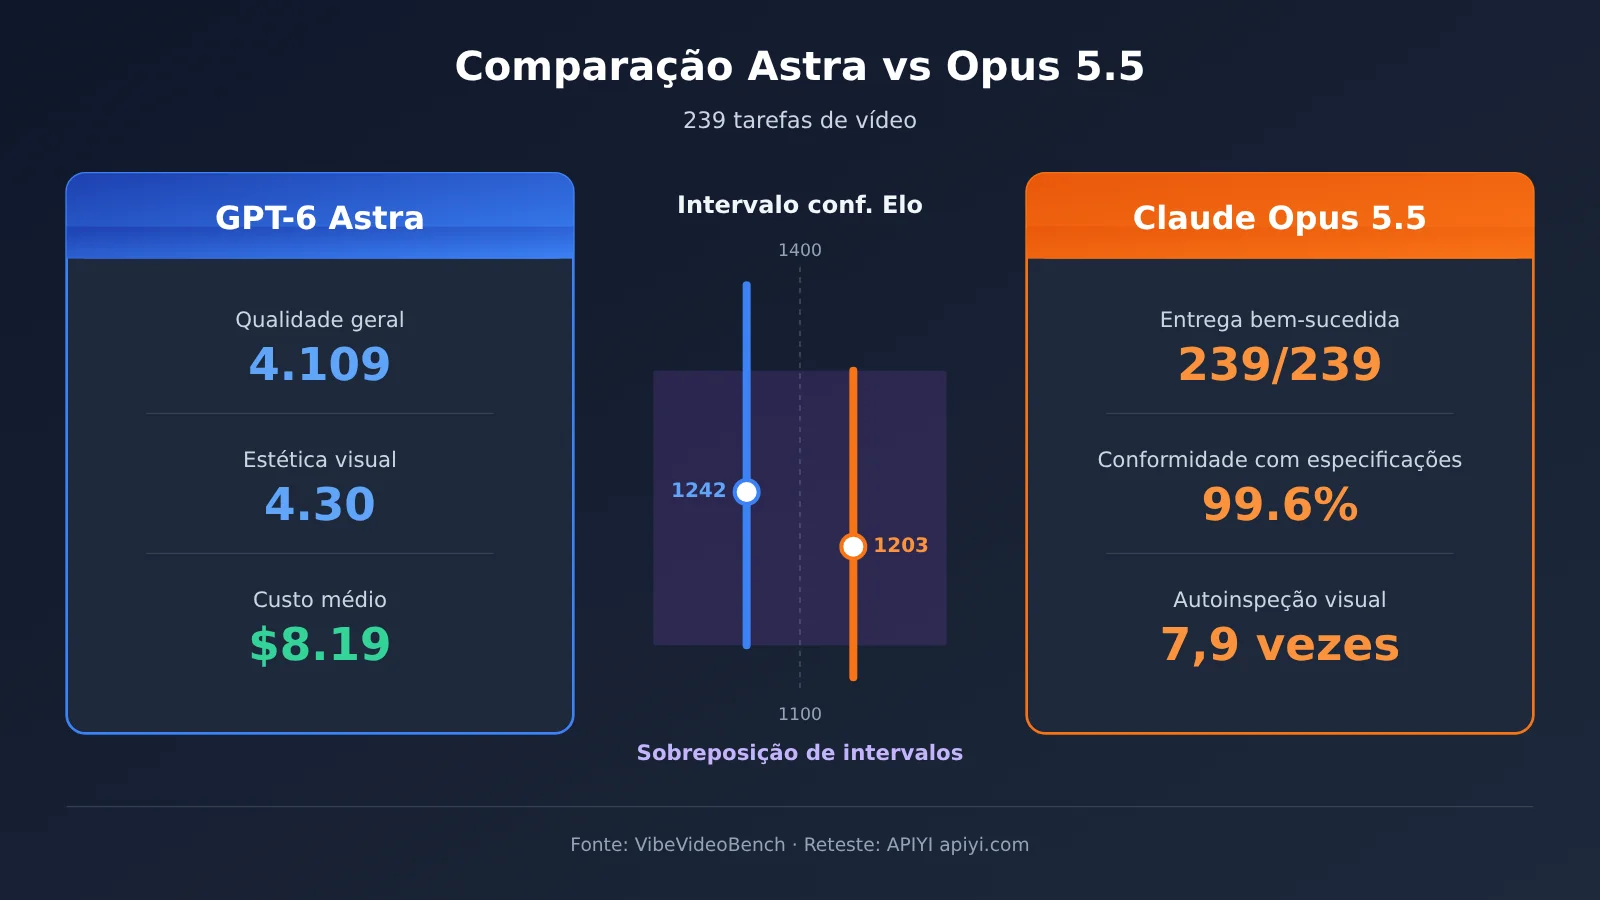
| Pontuação de qualidade geral | 4,109 | 4,074 | Astra |
| Taxa de sucesso em tarefas rigorosas | 74,5% | 76,3% | Opus |
| Elo de preferência humana | 1242 | 1203 | Estatisticamente indistinguível |
Os dados vêm da média dos resultados de três júris de avaliação, com pontuação de 1 a 5. Ambos os sistemas estão à frente dos demais sistemas participantes do teste.
Esta tabela revela uma divisão de trabalho bem clara: o Astra leva leve vantagem em “o vídeo produzido fica bonito ou não”, liderando a qualidade geral por 0,035 ponto e a estética visual por 0,11 ponto; já o Opus 5.5 é mais confiável em “consegue ou não entregar conforme as especificações”, com taxa de conformidade às especificações 5,9 pontos percentuais maior e taxa de sucesso em tarefas rigorosas 1,8 ponto percentual maior. A diferença de 0,035 ponto é muito pequena e, considerando o intervalo de confiança do Elo, os dois estão no mesmo patamar.
2.3 Distribuição de vantagens entre GPT e Opus 5.5 em diferentes tipos de vídeo
| Categoria de vídeo | Astra | Opus 5.5 | Líder |
|---|---|---|---|
| Marca e marketing | 4,18 | 4,18 | Empate |
| Produto e demonstração de funcionalidades | 4,20 | 4,24 | Opus |
| Música e som como elemento condutor | 3,83 | 3,92 | Opus |
| Explicação de artigos científicos | 4,03 | 4,07 | Opus |
| Explicação de conceitos e processos | 4,19 | 4,15 | Astra |
| Histórias de dados e fatos | 4,14 | 4,01 | Astra |
| Arte visual | 3,94 | 3,91 | Astra |
| Jogos e esportes | 4,15 | 4,12 | Astra |
| Eventos e expressão pessoal | 4,03 | 3,93 | Astra |
| Narrativas e comédia visual | 4,00 | 3,88 | Astra |
| Processos de construção e produção | 3,97 | 3,94 | Astra |
| Ensino em sala de aula | 4,47 | 4,45 | Astra |
Os dados vêm do Apêndice E.4 do artigo, com pontuação zero atribuída aos vídeos não entregues.
A Astra lidera em 8 das 12 categorias, com as maiores diferenças em histórias de dados e fatos (0,13) e narrativas e comédia visual (0,12); a Opus 5.5 fica à frente em demonstração de produto, música como elemento condutor e explicação de artigos científicos, sendo a diferença em música de 0,09. Tarefas com música exigem forte alinhamento entre áudio e imagem, e demonstrações de produto exigem precisão de especificações e detalhes, o que está alinhado com a vantagem da Opus na taxa de conformidade com especificações. Na maioria das categorias, a diferença fica dentro de 0,05 ponto: a escolha do modelo já mostra variação conforme o tipo de tarefa, mas diferenças em uma única categoria ainda precisam ser avaliadas junto com testes repetidos.
2.4 Por que o Opus 5.5 ainda é competitivo
O teste cego humano usa o modelo Bradley–Terry para calcular o Elo. O Astra ficou com 1242 (intervalo de confiança de 95%: 1134–1387) e o Opus com 1203 (1111–1327); ambos têm intervalo de confiança de ranking de 1–3, e a probabilidade de comparação indicada no artigo é P=0.69, com a conclusão de que são estatisticamente indistinguíveis. Vale notar que o teste humano avalia apenas vídeos já entregues e não mede a capacidade de entregar no prazo — e entrega é justamente o ponto forte do Opus.
O comportamento de autoverificação explica esse resultado. Em cada execução, o Opus examina em média as imagens renderizadas 7.9 vezes e usa o ffprobe 3.9 vezes; o Astra, 3.4 e 2.1 vezes, respectivamente. O Opus inspeciona a própria saída com mais frequência, encontra problemas e os corrige, o que lhe rendeu 100% de taxa de entrega e 99.6% de conformidade com as especificações. A Anthropic posiciona o Opus 5.5 como um modelo de Agentic Coding para execuções de longa duração. Também há relatos de usuários na comunidade que o usaram por cerca de 30 minutos para concluir um vídeo promocional de um app iOS e produzir automaticamente um vídeo curto de notícias em formato vertical 1080×1920 com legendas SRT; são casos individuais, que servem como evidência indireta da integridade do fluxo de trabalho.
2.5 Custo das tarefas de vídeo: GPT-6 Astra tem preço unitário maior, mas custo por tarefa menor
| Métrica | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|
| Preço padrão de entrada (USD/milhão de tokens) | 10 | 4 |
| Preço padrão de saída (USD/milhão de tokens) | 50 | 20 |
| Custo médio por tarefa | $8,19 | $15,38 |
| Custo mediano por tarefa | $7,88 | $10,19 |
| Custo por tarefa no P90 | $11,88 | $31,22 |
| Tokens de saída em média | 61K | 130,7K |
| Chamadas de API por tarefa | 46 | 51 |
| Cache Hit | 97% | 65% |
O preço unitário padrão do Astra é 2,5 vezes o do Opus 5.5, mas o custo médio por tarefa é cerca de 46,7% menor. Há duas razões: o Astra gera cerca de 53,3% menos tokens de saída; e o Astra alcança 97% de cache hit, enquanto no Opus cerca de 76% do custo por tarefa vem de Cache Write. A diferença de custo no P90 é ainda mais evidente: o Opus oscila muito mais em tarefas complexas. O estudo também aponta que simplesmente aumentar o consumo de tokens não trouxe ganho de qualidade correspondente.
Esses custos são equivalentes calculados com base nos preços públicos de API e não incluem mão de obra nem custos de materiais de vídeos comerciais completos. A Batch API oficial do Opus 5.5 oferece 50% de desconto na entrada e na saída, então a estrutura de custos muda quando se produz em lote offline.
💰 Otimização de custos: o custo por tarefa de um Agente de vídeo é muito influenciado pelo cache hit e pelo comprimento da saída; olhar só o preço unitário leva facilmente a uma avaliação errada. Vale a pena rodar a mesma tarefa com os dois modelos no APIYI apiyi.com e calcular pelo “consumo real por vídeo finalizado”, em vez de comparar pelos preços de tabela.
3 Sinais de melhoria de capacidade da próxima geração do GPT da OpenAI
3.1 Pesquisa sobre Navier–Stokes: modelo interno significativamente mais forte que o GPT-6 Astra
Em 8 de setembro de 2026, a OpenAI publicou os resultados de sua pesquisa sobre Navier–Stokes, um dos Problemas do Milênio. O artigo oficial afirma que o modelo interno usado tinha capacidade significativamente superior à do GPT-6 Astra, foi treinado com aprendizado por reforço em larga escala e, no momento do anúncio, o treinamento ainda continuava.
A escala de execução desse estudo é uma demonstração direta da capacidade multiagente: cerca de 10.000 agentes participaram simultaneamente, a pesquisa levou cerca de 88 horas e produziu 2,7 milhões de mensagens e aproximadamente 130 bilhões de tokens de saída. Os agentes foram divididos em grupos para estudar diferentes versões do problema, os grupos trocaram informações entre si, o Codex integrou os resultados intermediários e o sistema continuou concentrando recursos nas rotas mais promissoras. A validação formal final no Lean levou 17 horas adicionais e usou o GPT-6 Astra.
Para a criação de vídeos, o mais relevante aqui é o agendamento de tarefas de longa duração e a colaboração entre múltiplos agentes, não a capacidade matemática em si. Um vídeo complexo também exige processamento paralelo de roteiro, animação e áudio, seguido de integração, verificação e retrabalho.
3.2 BenchCAD 2.0: capacidade de engenharia sobe de 0,594 para 0,875
Em 3 de novembro de 2026, a OpenAI divulgou em “Accelerating engineering for the physical world” que um modelo interno mais recente obteve média de 0,875 no BenchCAD 2.0, enquanto o GPT-6 Astra, com intensidade de raciocínio máxima, ficou em 0,594 — um ganho relativo de cerca de 47,3%. Os testes incluem reconstrução de peças 3D, design de montagem mecânica e identificação de conexões de PCB.
Essas duas evidências devem ser vistas separadamente. A OpenAI não esclareceu se o modelo testado no BenchCAD é o mesmo do estudo sobre Navier–Stokes, e nem o nome nem a data de lançamento foram divulgados. O BenchCAD é um teste de engenharia divulgado pela própria OpenAI; é um sinal de progresso em compreensão espacial e conhecimento complexo de engenharia, sem relação direta com tarefas de geração de vídeo.
3.3 Quando a próxima geração do GPT será lançada: status público até 15 de novembro
| Data | Progresso público |
|---|---|
| 2 de novembro | Segundo o The National, Altman afirmou no ADIPEC que a pesquisa matemática usou um modelo GPT prestes a ser lançado, com cerca de 10.000 agentes colaborando por aproximadamente quatro dias; a reportagem ressalva que a declaração não foi verificada de forma independente |
| 3 de novembro | A OpenAI divulga os dados do modelo interno no BenchCAD 2.0 |
| 4 de novembro | O The Information, citando pessoas familiarizadas com o assunto, informou que a OpenAI poderia lançar já em 6 de novembro uma nova geração de Astra, Sol e um modelo de segurança cibernética |
| 5 de novembro | O OpenAI API Changelog confirma o lançamento do GPT-6 Cyber, mas não lança a nova geração de Astra ou Sol de uso geral |
| 15 de novembro | No catálogo oficial de modelos, os principais modelos de uso geral continuam sendo GPT-6 Astra, GPT-6.1 Sol, GPT-6.1 Terra e GPT-6 Luna |
Nomes como GPT-6.2 Astra e GPT-6.2 Sol, que circulam na internet, ainda não foram confirmados oficialmente pela OpenAI. Vale o mesmo cuidado: o VibeVideoBench avalia o GPT-6 Astra e o GPT-5.6 Sol; o desempenho do Astra não pode ser aplicado diretamente ao GPT-6.1 Sol ou ao Terra.
4 O que ainda falta para o GPT da próxima geração superar o Opus 5.5 na criação de vídeos
4.1 O verdadeiro gargalo do Agente de Vídeo: gestão de tempo e entrega
Das 2.151 execuções do VibeVideoBench, 224 não entregaram um vídeo reproduzível. Dessas, 169 foram problemas de gestão de tempo: a renderização final começou tarde demais, rodou lenta demais ou simplesmente não começou — cerca de 75% de todas as falhas. O ambiente de teste é um container Docker padronizado com CPU de 8 núcleos, 32 GB de memória e nenhuma GPU; só a renderização já consome um tempo considerável.
Isso mostra que, mesmo depois de a capacidade de raciocínio do modelo melhorar, ainda é preciso acertar o ritmo de execução. Por mais refinada que seja a animação escrita por um modelo, se a renderização só começa no minuto 55, o resultado continua sendo zero. Astra e Opus 5.5 já estão praticamente empatados em qualidade; o espaço para o GPT da próxima geração abrir vantagem está principalmente no lado da entrega.
4.2 Os sete pontos de melhoria do GPT da próxima geração no fluxo de trabalho de vídeo
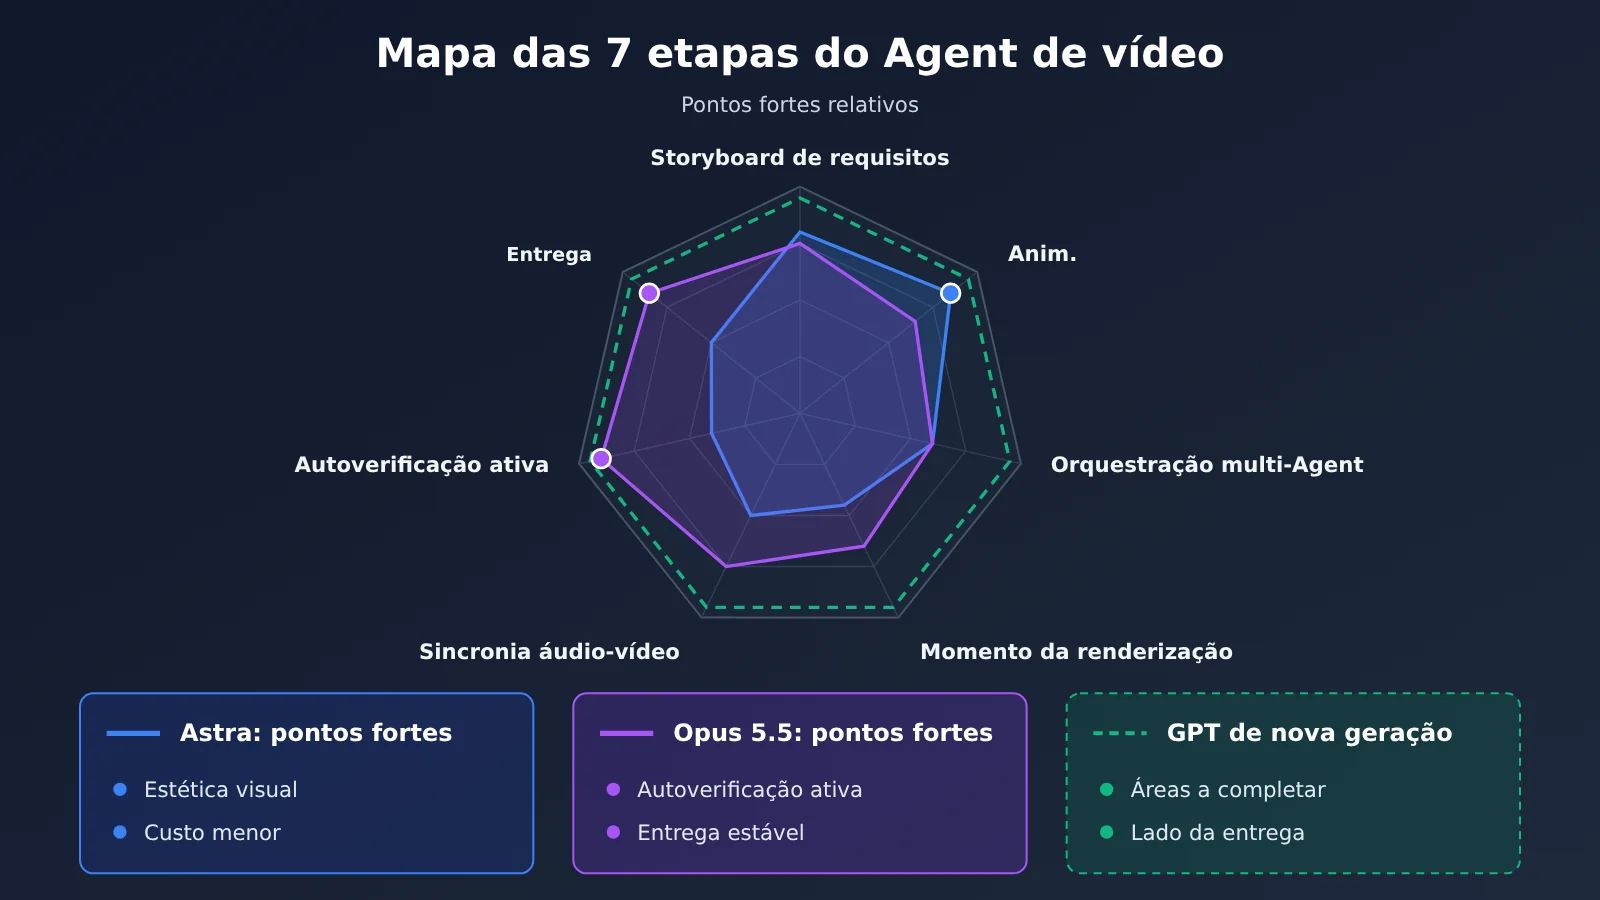
Considerando os pontos fortes e fracos atuais dos dois, um modelo da próxima geração que queira superar claramente o Opus 5.5 precisa avançar ao mesmo tempo nos seguintes elos:
- Compreensão de requisitos e storyboard: captar com precisão tema, público e estilo, decompondo o pedido em ordem de planos e linha do tempo.
- Código de animação complexo: escrever de primeira o código de animação em Remotion, Three.js e Python, reduzindo o retrabalho de renderização.
- Orquestração de múltiplos Agentes: paralelizar roteiro, animação e áudio; a capacidade de orquestração que os modelos internos demonstraram em pesquisa matemática precisa ser transferida para esse tipo de tarefa de engenharia.
- Momento da renderização: reservar tempo suficiente para renderizar, evitando o problema de gestão de tempo que responde por cerca de três quartos do total de falhas.
- Sincronia áudio-imagem: alinhar narração, efeitos sonoros e o ritmo das imagens — essa é justamente a direção em que o Opus lidera nas tarefas orientadas por música.
- Autoverificação ativa: o Opus olha as imagens em média 7,9 vezes, contra 3,4 do Astra; a frequência de autoverificação está diretamente ligada à taxa de conformidade com as especificações.
- Entrega estável: MP4 completo mais projeto editável, com as especificações atendidas de primeira.
5 Depois que a próxima geração do GPT for lançada, como verificar se ela realmente supera o Opus 5.5
5.1 Método de teste comparativo em sete etapas
Os rankings públicos rodam apenas uma vez, com limite de 60 minutos e são compostos majoritariamente por tarefas em inglês (209 dos 239 itens são em inglês); cenários de negócios em chinês precisam ser retestados por conta própria. O método abaixo pode ser reutilizado diretamente no dia do lançamento de um novo modelo:
| Etapa | Como fazer | Métrica observada |
|---|---|---|
| 1 Conjunto fixo de tarefas | Selecionar de 10 a 20 demandas reais de vídeos de negócios, cobrindo roteiro, animação, visualização de dados e apresentação de produto | Cobertura de tarefas |
| 2 Ambiente fixo | Padronizar o conjunto de ferramentas (versões de Remotion/FFmpeg), a configuração da máquina e o limite de tempo; registrar separadamente as diferenças de Harness | Comparabilidade |
| 3 Teste por etapa | Primeiro testar isoladamente via API o storyboard e o código de animação; depois rodar o fluxo completo no ambiente de Agent | Pontuação por etapa |
| 4 Registrar o consumo | Tempo de execução, tokens de entrada e saída e acertos de cache a cada execução | Custo por vídeo |
| 5 Verificar a entrega | Usar ffprobe para conferir resolução, taxa de quadros, duração e faixa de áudio | Taxa de entrega, taxa de conformidade com as especificações |
| 6 Teste cego e repetição | Ocultar o nome dos modelos e fazer comparações par a par; rodar cada tarefa pelo menos 3 vezes | Taxa de preferência, variância |
| 7 Pontuação agregada | Ponderar qualidade, taxa de sucesso, custo de retrabalho e custo por vídeo | Conclusão final de seleção |
A etapa 3 separa a “capacidade do modelo” da “capacidade do ambiente de Agent”. O VibeVideoBench testa um sistema completo de Agent, e o Codex CLI e o Claude Code também têm diferenças entre si; ao usar a mesma interface compatível com OpenAI para invocar diretamente os modelos das duas empresas e gerar storyboard e código de animação, é possível primeiro isolar o efeito do Harness e enxergar com clareza a diferença entre os modelos em si.
5.2 Exemplo de código: comparação por etapa com interface unificada
O exemplo minimalista abaixo chama dois modelos pelo mesmo base_url e gera o storyboard da mesma demanda de vídeo. Consulte a lista de modelos da plataforma para saber os nomes corretos.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada da APIYI: uma única Key para chamar GPT e Claude
)

prompt = "为一款记账 App 设计 30 秒竖屏宣传片:给出 6 个镜头的分镜、旁白和每个镜头的时长。"
for model in ["gpt-6-astra", "claude-opus-5-5"]:
    r = client.chat.completions.create(model=model, messages=[{"role": "user", "content": prompt}])
    print(model, r.usage.total_tokens, "\n", r.choices[0].message.content[:300])
Ver o script completo de teste comparativo multi-turno (com registro de tempo e Tokens)
import time
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Chamada unificada via APIYI, facilitando alternar e comparar
)

MODELS = ["gpt-6-astra", "claude-opus-5-5"]  # Consulte a lista de modelos da plataforma; novos modelos podem ser adicionados diretamente
RUNS = 3  # Número de execuções repetidas por tarefa

TASKS = {
    "storyboard": "为一款记账 App 设计 30 秒竖屏宣传片,输出 6 个镜头的分镜、旁白和时长(JSON)。",
    "remotion": "用 Remotion 写一个 10 秒的柱状图增长动画组件,数据为 [12, 30, 45, 80],带标题与数值标签。",
    "data_story": "把“某城市 2020-2025 年新能源车渗透率从 5% 升至 48%”写成 45 秒数据故事视频的脚本和镜头说明。",
}

SYSTEM = "你是视频导演兼前端动画工程师,输出可直接用于代码驱动视频制作的内容。"


def run_once(model: str, prompt: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        max_tokens=4000,
    )
    return {
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
        "output": resp.choices[0].message.content,
    }


results = []
for task_name, prompt in TASKS.items():
    for model in MODELS:
        for i in range(RUNS):
            try:
                rec = run_once(model, prompt)
            except Exception as e:
                rec = {"error": str(e)}
            rec.update({"task": task_name, "model": model, "run": i + 1})
            results.append(rec)
            print(task_name, model, i + 1, rec.get("seconds"), rec.get("completion_tokens"))

# Salva os resultados; depois de ocultar os nomes dos modelos, envia para avaliação cega pelos revisores
with open("video_bench_results.json", "w", encoding="utf-8") as f:
    json.dump(results, f, ensure_ascii=False, indent=2)
🚀 Comece rápido: a comparação por etapa exige chamar GPT e Claude ao mesmo tempo. Com o apiyi.com da APIYI, você usa uma única chave API e uma interface compatível com OpenAI para alternar entre os modelos das duas empresas. Novos usuários têm cota gratuita de teste e, quando a próxima geração do GPT chegar, basta adicionar o nome do modelo à lista
MODELSpara rodar novamente o mesmo conjunto de tarefas.
5.3 Considerações sobre o teste de fluxo completo
Depois que o teste de etapa passar, execute tarefas de vídeo completas no Codex CLI e no Claude Code, registrando a taxa de entrega e os resultados da verificação com ffprobe. O teste cego manual avalia apenas os vídeos já entregues — a taxa de entrega precisa ser contabilizada separadamente, caso contrário você acaba repetindo o ponto cego do teste manual do VibeVideoBench. Repita cada tarefa pelo menos 3 vezes e calcule média e variância, para não tratar o resultado de uma única execução como desempenho estável.
6 Recomendações de decisão: como escolher entre GPT e Opus 5.5 para cenários de vídeo
6.1 Escolha GPT-6 Astra ou Opus 5.5 conforme o cenário
Com base nas pontuações por categoria e nos dados de entrega do VibeVideoBench, nesta fase dá para distribuir assim:
- Prefira GPT-6 Astra: histórias de dados e fatos, explicações de conceitos e processos, vídeos de narrativa e de jogos; cenários de produção em lote e sensíveis ao custo unitário, com custo médio por tarefa de US$ 8,19 e custo P90 mais controlável.
- Prefira Claude Opus 5.5: demonstrações de produtos e funcionalidades, vídeos guiados por música, leitura de artigos; entregas comerciais com exigências rígidas de especificação e entrega, como resolução fixa, duração fixa e materiais de veiculação que obrigatoriamente devem ter faixa de áudio.
- Marketing de marca: ambos empatam em 4,18 — decida pelo custo e pela cadeia de ferramentas que a equipe já usa.
6.2 Esperar a próxima geração do GPT ou lançar agora
Os dois modelos atuais já conseguem produzir vídeos utilizáveis de forma estável, então o negócio não precisa esperar pela próxima geração de modelos. A abordagem mais prática é usar o método da seção 5 para montar seu próprio conjunto de tarefas e resultados de linha de base, reexecutar no dia do lançamento do novo modelo e deixar os dados decidirem se vale a pena trocar.
💡 Sugestão de escolha: a diferença entre os dois está concentrada na estabilidade de entrega e na estrutura de custos; a escolha final depende do tipo de vídeo e das exigências de entrega. Recomendamos testar cada um via APIYI apiyi.com com o mesmo lote de tarefas reais — a interface unificada facilita a comparação lado a lado e a migração posterior para novos modelos.
7 Conclusão final: o alvo da competição da próxima geração de GPT já não é apenas alcançar o Opus 5.5
7.1 Pontos centrais das capacidades de vídeo do GPT e do Opus 5.5
- Situação atual: GPT-6 Astra e Claude Opus 5.5 estão no mesmo pelotão de elite em tarefas de vídeo orientadas por código no VibeVideoBench, com qualidade geral de 4.109 contra 4.074.
- Vantagens do Astra: estética visual, pontuação na maioria das categorias de conteúdo e custo médio por tarefa cerca de 46.7% menor.
- Vantagens do Opus 5.5: 239/239 entregas concluídas, taxa de conformidade com especificações de 99.6% e autoverificação mais frequente.
- Preferência humana: 1242 contra 1203, com intervalos de confiança sobrepostos, ou seja, estatisticamente indistinguíveis.
- Sinal da próxima geração: o modelo interno alcança 0.875 no BenchCAD 2.0 (Astra 0.594) e demonstrou capacidade de colaboração de agentes em escala de dezenas de milhares; nome, data de lançamento e desempenho em vídeo não foram divulgados.
- O verdadeiro gargalo: cerca de 75% das falhas de entrega têm origem na gestão de tempo, e o foco da competição está migrando da qualidade de geração para execução e entrega.
- Como validar: tarefas fixas, ambiente fixo, múltiplos testes cegos e cálculo pelo custo unitário de vídeo permitem refazer testes em nível de etapa com uma interface unificada na APIYI apiyi.com.
7.2 O ponto final da competição é a eficiência de produção completa
Voltando ao título: o GPT já alcançou o Opus 5.5. O Astra atual leva uma ligeira vantagem em qualidade e custo, enquanto o Opus 5.5 continua liderando em confiabilidade de entrega. O modelo interno da OpenAI mostra capacidade geral mais forte e potencial de execução com múltiplos agentes; a próxima geração de GPT de uso geral tem chance de melhorar ainda mais a produção de vídeo, mas o tamanho exato desse avanço só será respondido por avaliações independentes após o lançamento e pelos seus próprios testes de negócio.
A próxima disputa vai cair sobre a eficiência de produção completa: desde entender a ideia criativa até entregar um vídeo confiável, preciso e editável, quem consegue realizar mais tarefas com menor custo. A recomendação é já montar sua própria linha de base de tarefas de vídeo na APIYI apiyi.com; assim que o novo modelo for lançado, dá para comparar diretamente.
Referências
- Site oficial de avaliação do VibeVideoBench: ranking de agentes de vídeo e pontuações de qualidade
- Link:
vibevideobench.github.io -
Descrição: visão geral do ranking geral e do design da avaliação
-
Artigo do VibeVideoBench: metodologia, resultados por categoria, custo, preferência humana e motivos de falha
- Link:
arxiv.org/abs/2610.35864 -
Descrição: principal fonte dos dados das tabelas deste artigo; os resultados por categoria estão no Apêndice E.4
-
Anúncio de lançamento do Anthropic Claude Opus 5.5: posicionamento do modelo e casos oficiais
- Link:
anthropic.com/claude-opus-5-5 -
Descrição: descrição oficial das mudanças de capacidade e de custo do Opus 5.5
-
OpenAI: On the Navier–Stokes Millennium Prize Problem: modelos internos e pesquisa com multiagentes
- Link:
openai.com/index/navier-stokes-solution -
Descrição: dados como 10.000 agentes simultâneos e 88 horas de pesquisa
-
OpenAI: Accelerating engineering for the physical world: resultado do modelo interno no BenchCAD 2.0
- Link:
openai.com/index/accelerating-engineering-for-the-physical-world -
Descrição: comparação entre o modelo interno com 0.875 e o GPT-6 Astra com 0.594
-
OpenAI API Changelog e catálogo de modelos: verificação do andamento dos lançamentos
- Link:
developers.openai.com/api/docs/changelog,developers.openai.com/api/docs/models -
Descrição: registro do lançamento do GPT-6 Cyber e os modelos principais públicos atuais
-
OpenAI API Deprecations: informações sobre o desligamento do Sora 2 e da Videos API
- Link:
developers.openai.com/api/docs/deprecations - Descrição: situação atual da rota nativa de geração de vídeo
Autor: equipe técnica da APIYI
Contato técnico: fique à vontade para falar com a gente pela home da APIYI, apiyi.com, para trocar experiências sobre testes de agentes de vídeo; mais materiais de integração estão disponíveis no centro de documentação docs.apiyi.com