Nota do autor: este artigo responde a uma pergunta específica — o deepseek-v4-1-flash-economy-261017 é um modelo pior? Conclusão: não. Ele usa os mesmos pesos do deepseek-v4.1-flash, só é mais lento e mais barato.
Depois que o DeepSeek V4.1 Flash foi dividido em duas faixas de preço, qual valor colocar no campo model da requisição virou uma escolha inevitável para quem já usa esse modelo. Este artigo compara deepseek-v4-1-flash-economy-261017 com deepseek-v4.1-flash e traz recomendações claras sob quatro ângulos: preço, endpoint, grupo e velocidade.
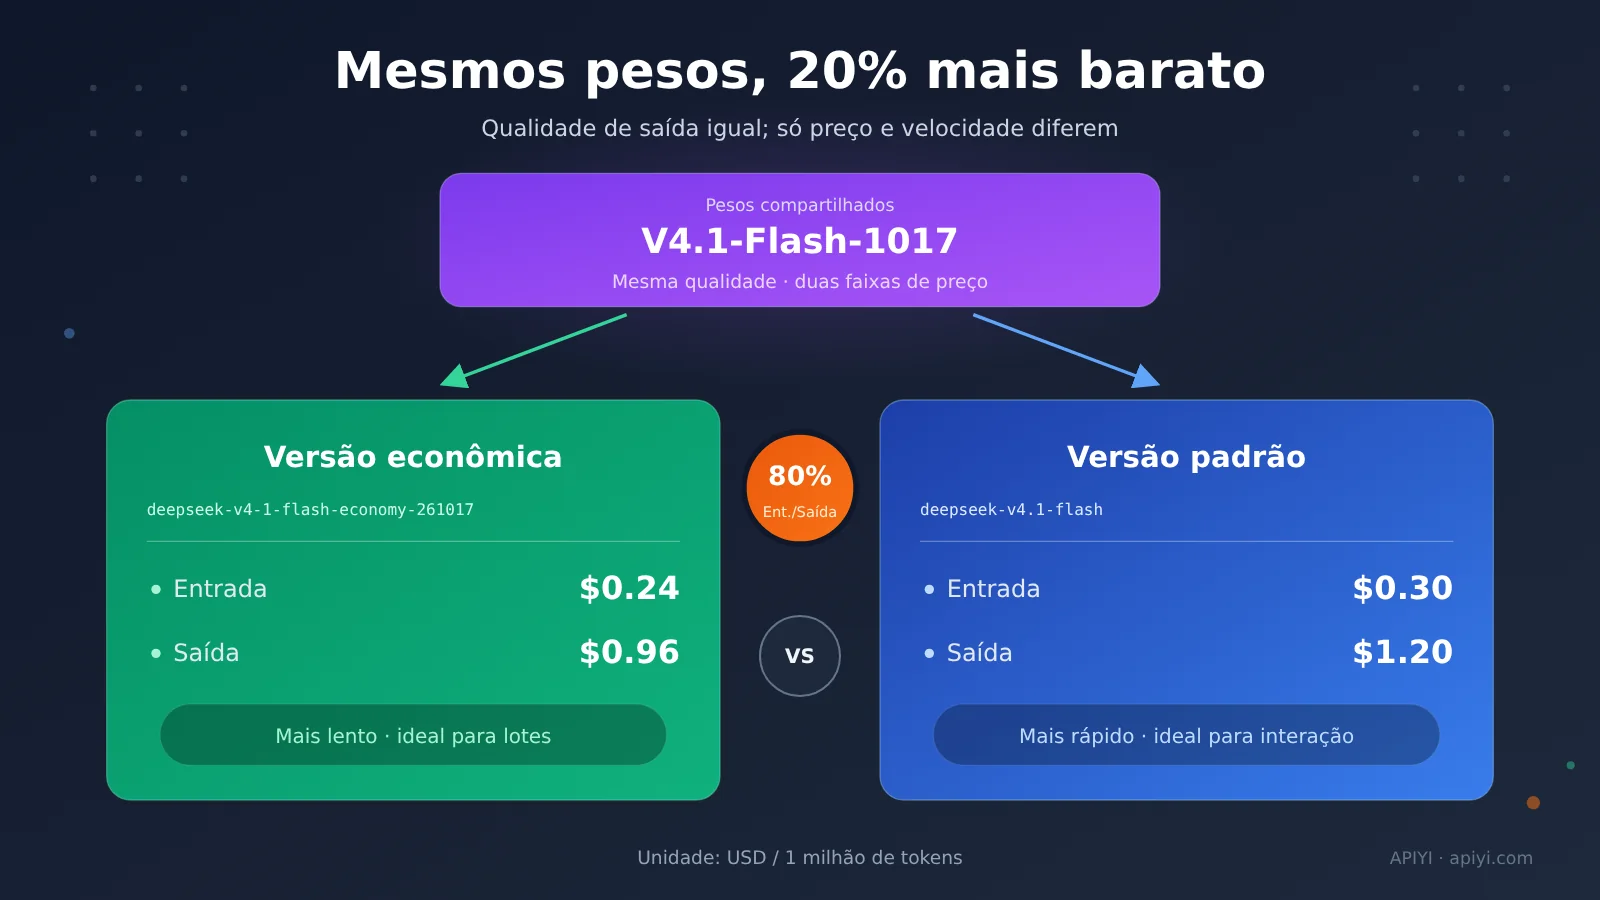
A conclusão vem primeiro: a versão econômica não é um modelo pior. Os dois IDs carregam os mesmos pesos V4.1-Flash-1017, e a documentação oficial indica qualidade de saída idêntica; as diferenças são só duas — geração mais lenta e preço unitário de entrada e saída a 80% da versão padrão (ou seja, 20% mais barato). Não é a avaliação de um modelo novo, nem uma versão capada, mas os mesmos pesos colocados em duas faixas de preço.
Valor central: depois de ler este artigo, você saberá qual ID escolher em cenários como processamento em lote offline, produtos interativos e fluxos de trabalho no formato Anthropic. Os dois modelos já estão disponíveis na APIYI (apiyi.com), e a troca exige apenas mudar uma string.
O que é deepseek-v4-1-flash-economy-261017
A versão econômica entrou no ar em 2026-11-11 12:22 (UTC+8) e, na hora da checagem deste artigo (2026-11-13), tinha acabado de completar dois dias. O posicionamento dela cabe em uma frase: os mesmos pesos do V4.1-Flash-1017, preço por token de entrada e saída mais baixo, geração mais lenta. Não é uma versão destilada nem quantizada — a APIYI, pelo canal oficial da BytePlus, entrega os 552B pesos completos, sem quantização e sem destilação, com cobrança em uma única faixa de preço de pico.
Hoje a versão econômica não tem página própria de detalhes do modelo nem página de explicação, então os parâmetros-chave seguem o documento de lançamento; os preços foram conferidos tanto na lista oficial de modelos quanto na interface de preços do apiyi.com, e os dois batem. Para você não precisar garimpar na documentação, reuni os pontos principais nesta tabela:
| Ponto | Descrição | O que significa para você |
|---|---|---|
| Mesmos pesos | Compartilha o V4.1-Flash-1017 com o deepseek-v4.1-flash |
Qualidade da saída com a mesma especificação oficial, o comando não precisa ser reajustado |
| Entrada e saída com 20% de desconto | Entrada $0.24, saída $0.96 (por 1 milhão de tokens) | O custo de tarefas em lote cai direto em dois décimos |
| Geração mais lenta | A documentação estima cerca de 2 segundos para o primeiro token e cerca de 15 milissegundos por token | Bom para processamento em lote offline, ruim para interação intensa |
| Menos endpoints | Apenas o endpoint Chat, grupos Default e SVIP | Basta usar a interface compatível com OpenAI |
Por que deepseek-v4-1-flash-economy-261017 merece um ID de modelo só para ela
Porque o que se economiza é custo direto, e não é preciso abrir mão de qualidade para isso. O grosso da conta em tarefas de processamento em lote é a taxa de tokens de entrada e saída; com 20% de desconto, o mesmo orçamento rende cerca de um quarto a mais de volume. Como os pesos e a qualidade da saída não mudam, o único preço a pagar é a espera — e a pergunta deixa de ser “vale a pena trocar?” para virar “minha tarefa pode esperar?” É exatamente essa diferença que a próxima seção destrincha.
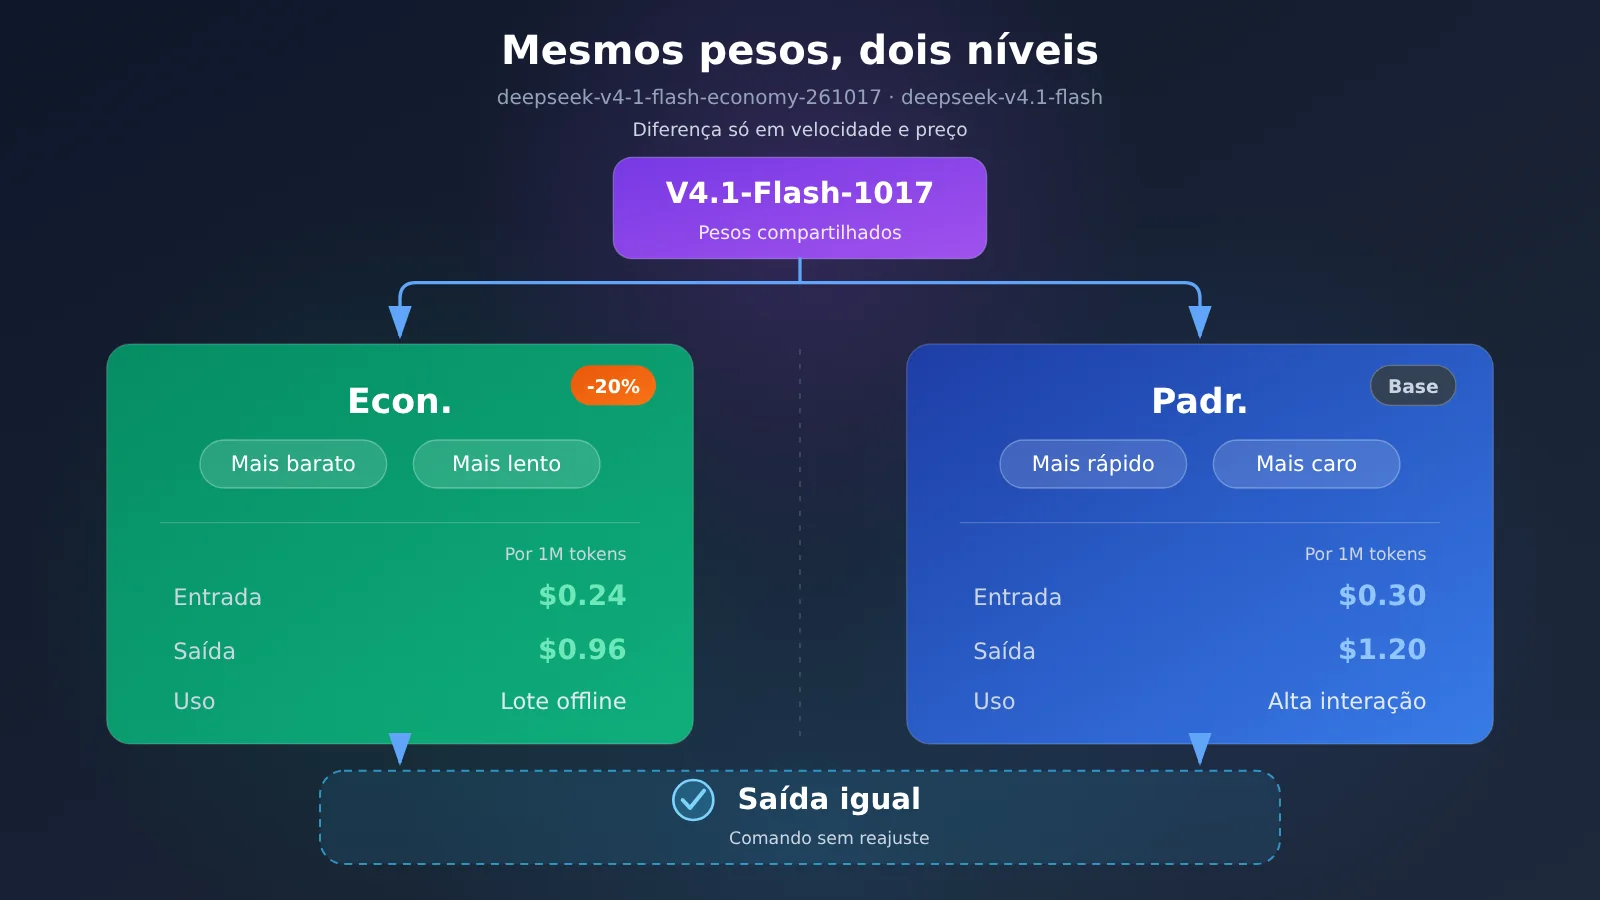
Principais diferenças entre deepseek-v4-1-flash-economy-261017 e deepseek-v4.1-flash
As diferenças entre as duas versões se concentram em três pontos: preço, endpoint e grupo, e velocidade. Pesos e qualidade não entram nesta lista de diferenças — afinal, ambas compartilham o V4.1-Flash-1017.
Diferença de preço: entrada e saída com 20% de desconto; leitura de cache com o mesmo preço
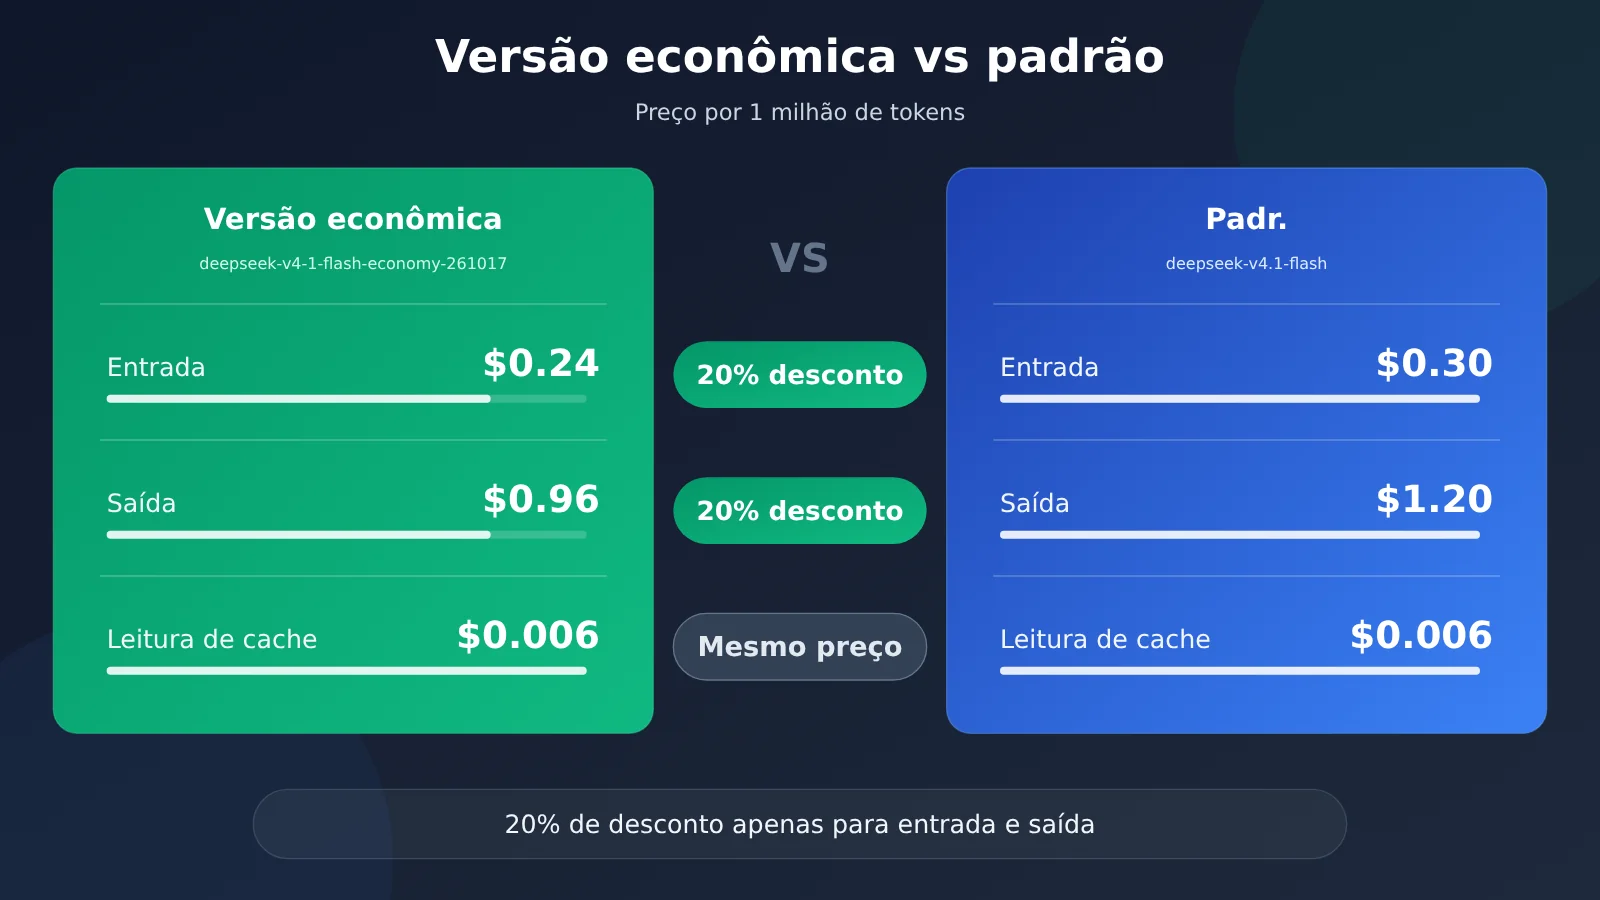
| Item de cobrança (por 1 milhão de tokens) | deepseek-v4-1-flash-economy-261017 | deepseek-v4.1-flash | Desconto |
|---|---|---|---|
| Entrada | $0.24 | $0.30 | 20% de desconto |
| Saída | $0.96 | $1.20 | 20% de desconto |
| Leitura de cache | $0.006 | $0.006 | Mesmo preço |
0.24 dividido por 0.30 dá 0.8, e 0.96 dividido por 1.20 também dá 0.8. Portanto, o desconto de 20% (ou seja, pagar 80% do preço) vale apenas para os dois itens de cobrança — entrada e saída — da versão econômica em relação à padrão; a leitura de cache é $0.006 nas duas versões, sem desconto. Se suas tarefas têm alta taxa de acerto de cache, esse custo não terá diferença entre as duas versões, e a economia geral será diluída; ao fazer uma estimativa de custos, calcule a leitura de cache separadamente.
Há outro ponto que costuma confundir e precisa ficar claro: esse desconto de 20% é uma diferença fixa entre os preços de tabela dos dois modelos, não uma promoção por tempo limitado. Os benefícios da conta APIYI são concedidos como bônus na recarga; o valor bonificado não altera os preços unitários da tabela acima, e a cobrança usa a faixa de preço de pico, sem oscilar por causa de promoções.
💰 Sugestão de custo: Em tarefas de processamento em lote, você pode definir
reasoning_effortcomononepara desativar o raciocínio e, combinando isso com o desconto de 20% na entrada e saída da versão econômica, economizar nos dois pontos. Se quiser fazer as contas antes de começar, é possível comparar os preços unitários dos dois modelos e simular custos em APIYI apiyi.com.
Diferença de endpoints: deepseek-v4-1-flash-economy-261017 só tem Chat
Essa é a única diferença concreta entre as duas versões no quesito “dá para usar ou não”. A versão econômica expõe apenas o endpoint Chat, e os grupos disponíveis são somente Default e SVIP; a versão padrão, além do Chat, também aceita o formato Anthropic, com os grupos ClaudeCode e CodexResponses adicionais.
| Dimensão | deepseek-v4-1-flash-economy-261017 | deepseek-v4.1-flash |
|---|---|---|
| Endpoint | Chat | Chat, formato Anthropic |
| Grupos | Default, SVIP | Default, SVIP, ClaudeCode, CodexResponses |
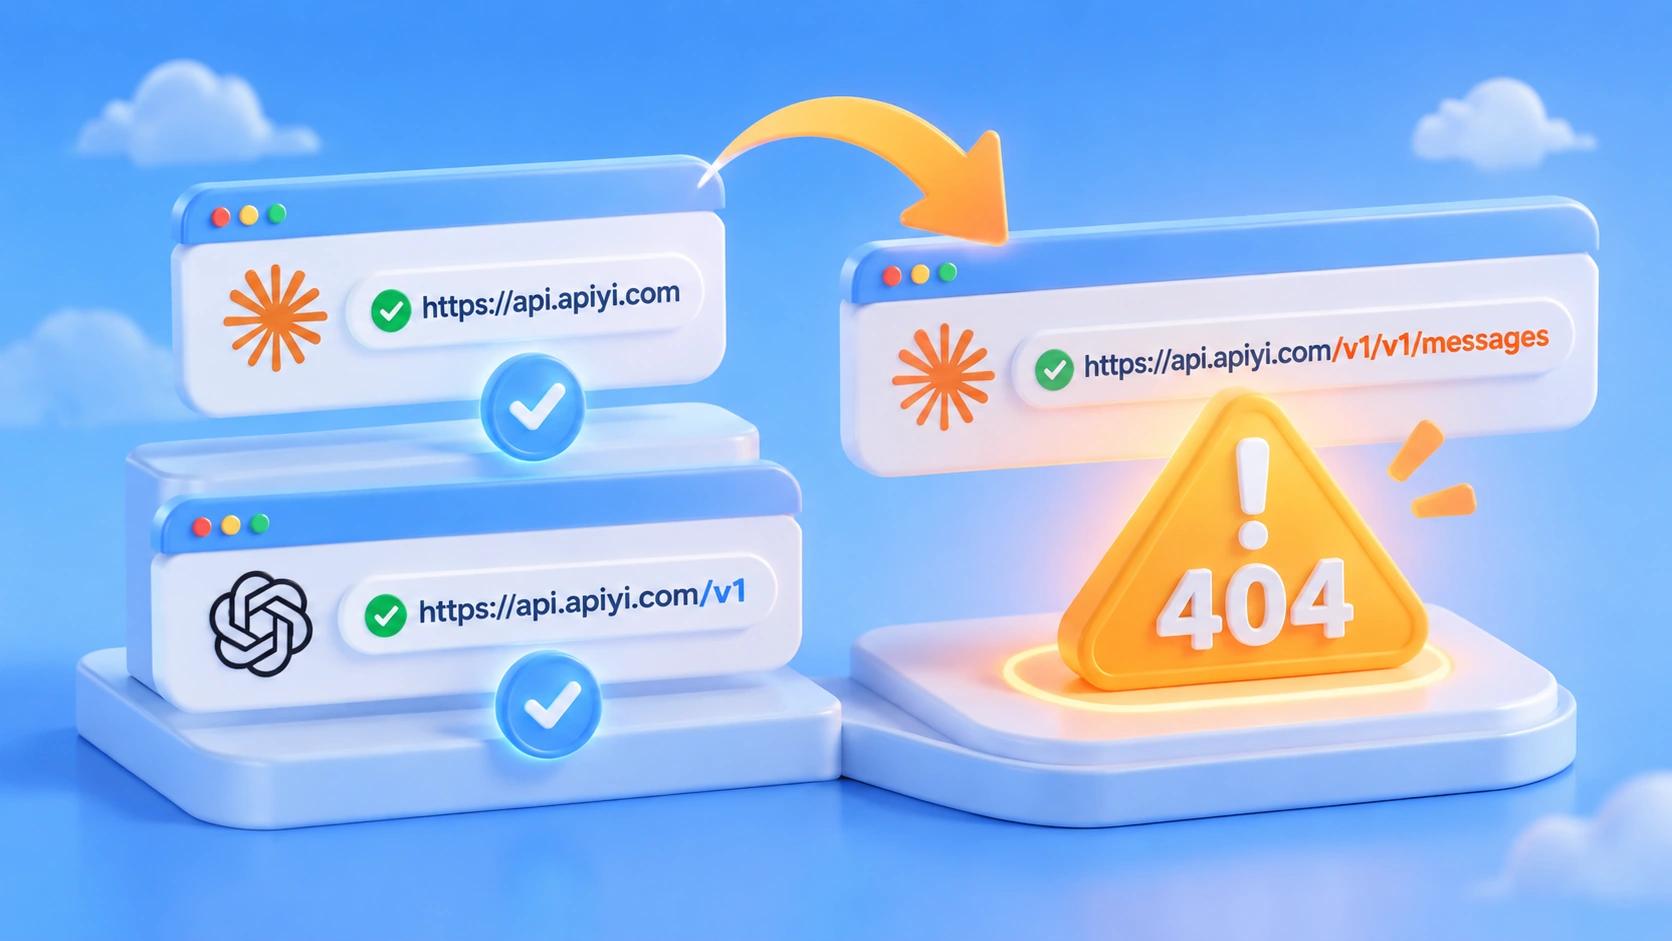
Na prática, no fluxo de trabalho: se o cliente monta requisições no formato de mensagens da Anthropic, ou se a orquestração roda nos grupos ClaudeCode e CodexResponses, só dá para usar deepseek-v4.1-flash; já aplicações comuns que usam a interface compatível com OpenAI podem escolher qualquer uma das duas. Na chamada, o base_url é sempre https://api.apiyi.com/v1; para trocar de versão, basta alterar o campo model.
Diferença de velocidade: deepseek-v4-1-flash-economy-261017 é mais lento, mas só isso
A estimativa de velocidade fornecida na documentação de lançamento é de cerca de 2 segundos para o primeiro token e cerca de 15 milissegundos por token. Vale destacar que essa é a estimativa da documentação, não um ranking de testes reais; a percepção prática varia conforme o comprimento da tarefa e o horário, então, se for usar para planejamento de capacidade, deixe uma margem. Não é preciso se preocupar com qualidade: a documentação oficial indica que as duas versões têm a mesma qualidade de saída, porque carregam o mesmo V4.1-Flash-1017.
Em outras palavras, não trate os dois IDs como dois modelos na hora de avaliar qualidade. Há só uma coisa a avaliar de verdade: se a sua tarefa pode aceitar uma geração mais lenta.
Recomendações de cenário para deepseek-v4-1-flash-economy-261017
A lógica de escolha em uma frase: se a latência não é crítica e você usa o endpoint Chat, vá de versão econômica; caso contrário, use a versão padrão. Vamos por cenário.
Quando escolher deepseek-v4-1-flash-economy-261017
Indicado para cenários em que o preço unitário vem em primeiro lugar e ninguém está esperando o resultado na tela:
- Processamento em lote offline: resumo de logs, rotulagem de documentos, limpeza de corpus, tradução em massa — volume grande, enfileirável, reexecutável
- Tarefas agendadas noturnas: o que se acumulou de dia roda à noite, e 2 segundos até o primeiro token são imperceptíveis
- Etapas intermediárias sensíveis a custo: nós de pipeline como classificação, extração e conversão estruturada, que não exigem interação humana
- Reexecução com prefixo longo: o mesmo lote de contexto chamado repetidamente — a parte que acerta o cache tem o mesmo preço nas duas versões, e a entrada que não acerta sai com 20% de desconto na versão econômica
No processamento em lote há também um pequeno botão que vale a pena lembrar: definir reasoning_effort como none desliga o raciocínio e economiza tokens de saída. É algo independente dos 20% de desconto, mas os dois podem ser combinados.
Quando continuar usando deepseek-v4.1-flash
- Produtos interativos: chat, interfaces do tipo Copilot, em que a latência do primeiro token afeta diretamente a experiência
- Fluxos de trabalho fixos no formato Anthropic: o cliente monta as requisições conforme o protocolo Anthropic, e a versão econômica não atende
- Grupos ClaudeCode e CodexResponses: a orquestração depende desses dois grupos, disponíveis apenas na versão padrão
- Prioridade de throughput online: prefere pagar mais para ter um ritmo de geração mais rápido
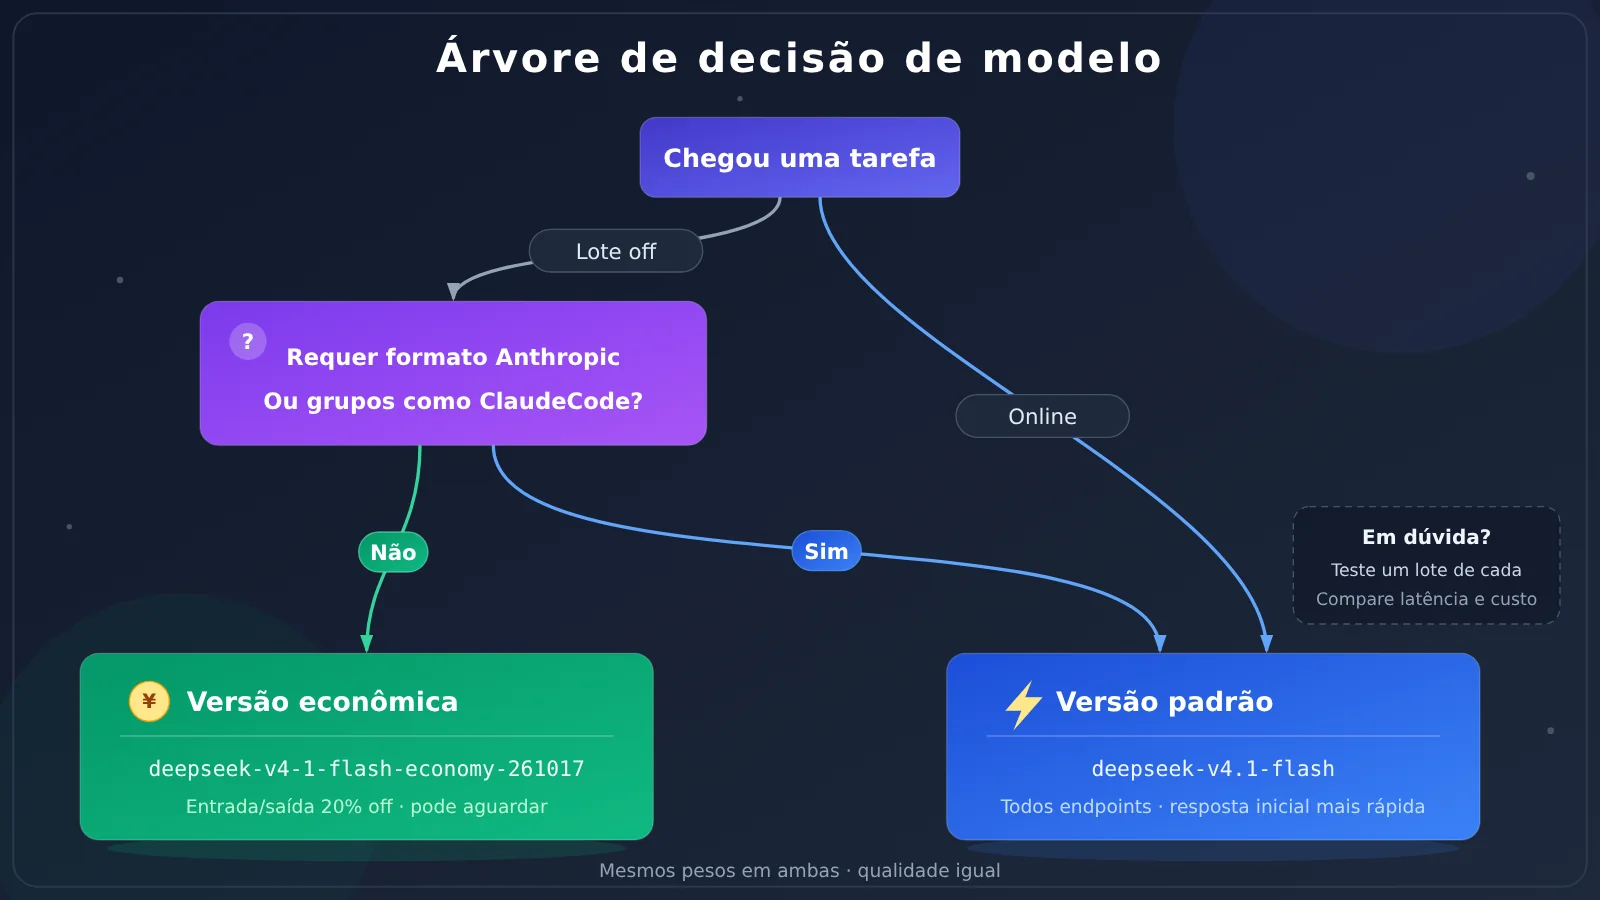
| Seu cenário | Recomendação | Motivo |
|---|---|---|
| Lote offline, tarefas agendadas | deepseek-v4-1-flash-economy-261017 |
20% de desconto na entrada e na saída, latência imperceptível |
| Chat, interface de Copilot | deepseek-v4.1-flash |
Prioridade na velocidade da primeira resposta |
| Formato Anthropic ou grupos ClaudeCode e CodexResponses | deepseek-v4.1-flash |
A versão econômica só tem endpoint Chat |
| Enfileirável e sensível a custo | deepseek-v4-1-flash-economy-261017 |
Mesmos pesos, mesma qualidade |
🎯 Sugestão por cenário: se estiver em dúvida, rode um pequeno lote das mesmas tarefas nas duas faixas, compare latência e fatura e só então decida. O APIYI apiyi.com permite trocar o campo model diretamente com uma única chave API, sem alterar as outras configurações.
deepseek-v4-1-flash-economy-261017: recomendações de decisão e método de alternância
A alternância não tem custo. A estrutura da requisição não muda; o base_url continua sendo https://api.apiyi.com/v1. Basta alterar o campo model de deepseek-v4.1-flash para deepseek-v4-1-flash-economy-261017 e a troca de nível está concluída. A cobrança é diferenciada automaticamente por modelo, não é preciso trocar a chave, e tanto o grupo Default quanto o SVIP podem usar a versão econômica.
| Campo | Versão econômica | Versão padrão |
|---|---|---|
| model | deepseek-v4-1-flash-economy-261017 |
deepseek-v4.1-flash |
| base_url | https://api.apiyi.com/v1 |
https://api.apiyi.com/v1 |
| Endpoint | Chat | Chat, formato Anthropic |
| Preço unitário de entrada e saída | $0.24 / $0.96 | $0.30 / $1.20 |
Um erro fácil de cometer: no ID da versão padrão há um ponto — deepseek-v4.1-flash, não um hífen. Se qualquer um dos dois IDs for digitado errado, o sistema retornará que o modelo não existe. Sugiro guardar esta tabela de referência rápida no memorando de configuração de modelos da equipe, para evitar erros de digitação.
💡 Recomendação de escolha: use a versão econômica para processamento em lote offline e a versão padrão para interação online. Apenas a versão padrão está disponível no formato Anthropic ou nos grupos ClaudeCode e CodexResponses. Para novas tarefas, você pode primeiro testar uma pequena amostra de cada nível no APIYI apiyi.com com a cota gratuita de teste e depois definir.
Perguntas frequentes sobre deepseek-v4-1-flash-economy-261017
Q1: O que é o deepseek-v4-1-flash-economy-261017?
É a faixa econômica do DeepSeek V4.1 Flash, lançada em 2026-11-11 12:22 (UTC+8). Ela carrega os mesmos pesos V4.1-Flash-1017 da versão padrão `deepseek-v4.1-flash`, mas o preço unitário de entrada e saída fica em 80% do valor da versão padrão, com velocidade de geração mais lenta.
Q2: Qual é a diferença entre deepseek-v4-1-flash-economy-261017 e deepseek-v4.1-flash?
São três diferenças: preço (entrada e saída a 80%, leitura de cache com o mesmo preço), velocidade (a versão econômica é mais lenta) e endpoints e grupos (a versão econômica só tem Chat e Default, SVIP; a padrão tem ainda o formato Anthropic e ClaudeCode, CodexResponses). Os pesos e a qualidade de saída são idênticos.
Q3: Quando a versão econômica foi lançada? Já dá para usar?
Foi lançada em 2026-11-11 12:22 (UTC+8) e já está disponível no APIYI apiyi.com, podendo ser usada nos grupos Default e SVIP. Por enquanto ela não tem uma página de detalhes de modelo separada; os parâmetros seguem o documento de lançamento e a lista oficial de modelos.
Q4: Para quais cenários de aplicação o deepseek-v4-1-flash-economy-261017 é mais indicado?
Para tarefas que não são sensíveis à latência e que usam o endpoint Chat: resumo em lote de logs, rotulagem de documentos, limpeza de corpus, tradução em lote, tarefas agendadas noturnas, pipelines de classificação e extração sensíveis a custo. Em lote offline, também dá para definir `reasoning_effort` como `none` e desligar o raciocínio, economizando ainda mais tokens.
Q5: Como chamar o deepseek-v4-1-flash-economy-261017 pela API?
Cadastre-se em APIYI apiyi.com para obter uma chave API, use `https://api.apiyi.com/v1` como `base_url`, preencha o campo `model` com `deepseek-v4-1-flash-economy-261017` e faça uma chamada de Chat pela interface compatível com OpenAI. Novos usuários têm crédito de teste gratuito e podem verificar diretamente a diferença de latência e de faturamento entre as duas faixas.
Q6: Quais são as limitações conhecidas do deepseek-v4-1-flash-economy-261017?
Três pontos para já esperar: geração mais lenta (o documento estima cerca de 2 segundos para o primeiro token e cerca de 15 milissegundos por token); só tem o endpoint Chat, então quem precisa do formato Anthropic deve usar a versão padrão; a leitura de cache não tem desconto e custa $0.006, igual à versão padrão. Ela é “mais lenta, mas mais barata”, não “pior”.
Q7: Os 80% são uma promoção? Vão voltar ao preço normal depois?
Não é promoção. Os 80% se referem à diferença fixa entre os preços de tabela dos dois modelos — entrada $0.24 contra $0.30, saída $0.96 contra $1.20. No APIYI apiyi.com, os descontos da conta vêm na forma de bônus por recarga e não alteram esses dois preços unitários; a cobrança usa a faixa de preço de pico.
deepseek-v4-1-flash-economy-261017 Pontos principais (Key Takeaways)
- Os mesmos pesos: compartilha o V4.1-Flash-1017 com
deepseek-v4.1-flash; a qualidade de saída é oficialmente declarada como equivalente - A fronteira dos 80%: entrada a $0.24 e saída a $0.96 (por milhão de tokens), o que representa 80% do preço da versão padrão; leitura de cache a $0.006 tem o mesmo preço nas duas versões
- Custo em velocidade: a documentação estima cerca de 2 segundos até o primeiro token e cerca de 15 ms por token; é adequada para processamento offline, não para interação
- Diferença de endpoints: a versão econômica tem somente o endpoint Chat (Default e SVIP); a versão padrão também oferece o formato Anthropic e os grupos ClaudeCode e CodexResponses
- Custo de troca: a estrutura da requisição não muda; basta alterar o campo
modelpara alternar entre as duas variantes - Regra prática: quem pode esperar economiza; quem não pode, escolhe a rapidez
Resumo
A relação entre os dois modelos em uma frase: deepseek-v4-1-flash-economy-261017 e deepseek-v4.1-flash são duas variantes dos mesmos pesos V4.1-Flash-1017 — mesma qualidade, velocidades diferentes e preços de entrada e saída com 20% de desconto.
- Custo: tarefas em lote se beneficiam diretamente; entrada e saída com 20% de desconto; leitura de cache com o mesmo preço
- Capacidade: os pesos completos de 552B são fornecidos pelo canal oficial da BytePlus, sem quantização nem destilação
- Limites: a versão econômica tem apenas o endpoint Chat e os grupos Default e SVIP; o formato Anthropic e ClaudeCode/CodexResponses existem apenas na versão padrão
A escolha é simples: se a latência não for um problema, use a versão econômica; para interação online ou para usar o formato Anthropic fixo, use a versão padrão. Recomendo testar as duas variantes com a cota gratuita da APIYI apiyi.com, rodando um pequeno lote em cada uma, e deixar a fatura dar a palavra final.
📚 Referências
- Documentação de lançamento do DeepSeek V4.1 Flash versão econômica
- Link:
docs.apiyi.com/live/2026-11/deepseek-v4-1-flash-economy-launch.md -
Descrição: fonte primária de pesos, preços, endpoints, grupos e estimativas de velocidade
-
Lista de modelos APIYI
- Link:
docs.apiyi.com/models -
Descrição: local para conferir o preço unitário de tabela dos dois modelos
-
Endpoint de preços APIYI
- Link:
api.apiyi.com/api/pricing - Descrição: dados de preço legíveis por máquina, adequados para conciliação automatizada por script
Autor: Equipe técnica da APIYI
Contato técnico: fique à vontade para nos contatar pela página inicial do site da APIYI; mais materiais estão disponíveis no centro de documentação docs.apiyi.com