Résumé : dans les tâches vidéo pilotées par le code de VibeVideoBench, GPT-6 Astra se situe désormais au même niveau que Claude Opus 5.5 : qualité globale légèrement supérieure, coût plus faible ; Opus 5.5 offre une livraison plus stable ; le prochain modèle généraliste d’OpenAI n’est pas encore publié, et ses capacités vidéo devront être mesurées après sa sortie.
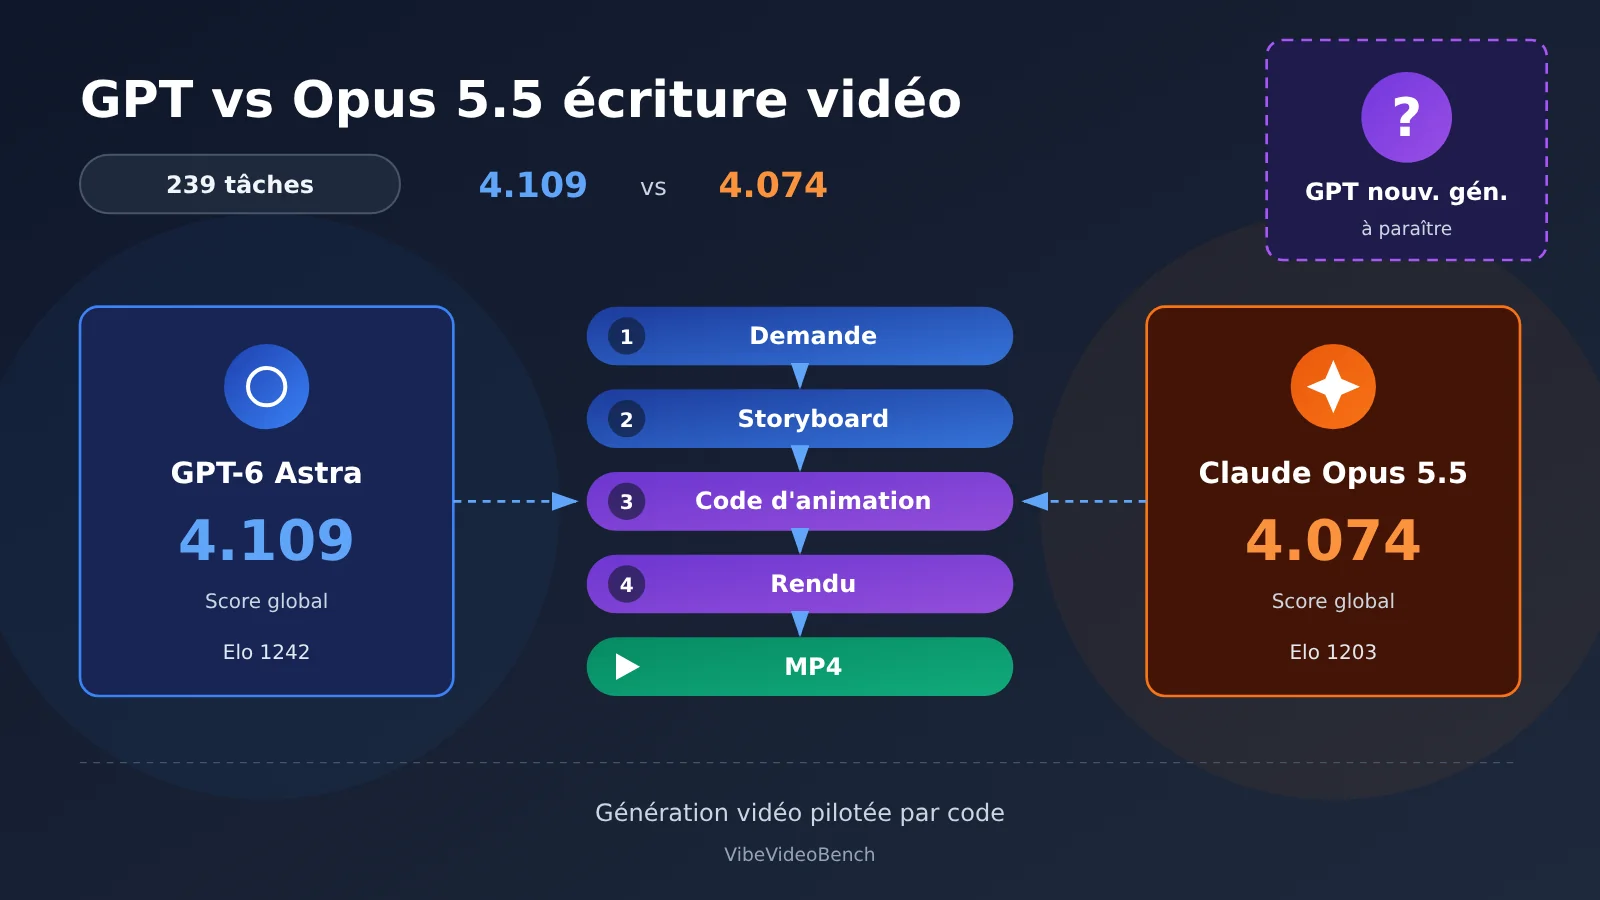
Conclusion d’abord : au 15 novembre 2026, sur la voie « un Agent écrit le code, appelle les outils de rendu et livre un MP4 complet », GPT-6 Astra et Claude Opus 5.5 sont les deux systèmes les plus proches dans VibeVideoBench. Astra obtient un score de qualité global de 4.109, Opus 5.5 de 4.074 ; les Elo du test à l’aveugle mené par des humains sont respectivement de 1242 et 1203, statistiquement indiscables. Opus 5.5 a livré les 239 tâches, avec un taux de réussite strict de 76.3 %, supérieur aux 74.5 % d’Astra ; le coût API moyen par tâche d’Astra est de 8.19 dollars, soit environ la moitié de celui d’Opus 5.5. OpenAI a publié deux éléments de preuve montrant que des modèles internes sont nettement plus forts qu’Astra, mais le nom, la date de sortie et les résultats vidéo spécifiques du prochain GPT généraliste ne sont pas annoncés. La réponse à la question du titre est donc : le GPT actuel a déjà rattrapé son retard ; quant à savoir si la prochaine génération creusera l’écart, cela dépendra des tests réels après sa publication.
Aperçu du contenu : l’article commence par délimiter le périmètre de l’évaluation, puis décortique les résultats globaux de VibeVideoBench, les résultats par catégorie, les préférences humaines et les données de coût, afin d’expliquer d’où viennent les forces respectives des deux systèmes. Il passe ensuite en revue les signaux publics autour des modèles internes d’OpenAI et l’état de publication de la prochaine génération, puis analyse le véritable goulot d’étranglement des Agents vidéo. Enfin, il propose une méthode de test comparative directement réutilisable après la sortie d’un nouveau modèle, pour vous aider à déterminer s’il vaut la peine de remplacer votre solution actuelle.
À savoir : la terminologie à connaître avant de lire cet article
| Terme | Explication |
|---|---|
| Code-driven Video Generation | Génération vidéo pilotée par code : l’IA écrit les programmes d’animation et de rendu, puis produit un fichier MP4 |
| Native Video Generation | Génération vidéo native : le modèle génère directement les images vidéo à partir de texte ou d’images ; produits phares : Sora, Veo |
| VibeVideoBench | Benchmark dédié à l’évaluation de la capacité d’un agent IA à produire seul une vidéo complète, publié le 26 octobre 2026 |
| Harness | Environnement d’exécution du modèle, qui fournit l’exécution de code, l’accès aux fichiers, l’appel d’outils, etc., comme Codex CLI ou Claude Code |
| L1 / L2 / L3 | Les trois niveaux de l’évaluation : contrôle de la livraison du programme, vérification point par point des exigences de la tâche, notation de la qualité vidéo par revue multimodale |
| Taux de réussite strict des tâches | Proportion de tâches livrées avec succès et respectant toutes les contraintes ; c’est plus strict que le simple « taux de livraison » |
| Bradley–Terry Elo | Méthode de notation qui calcule la préférence relative des modèles à partir de comparaisons humaines par paires |
| Multi-agent Orchestration | Orchestration multi-agents : plusieurs agents se répartissent le travail et collaborent, puis les résultats sont intégrés |
| Render Pipeline | Pipeline de rendu vidéo : génération des images, traitement audio, encodage et composition jusqu’à la sortie finale |
| Remotion / FFmpeg | Le premier sert à écrire des animations vidéo en code React, le second gère l’encodage et la composition audio-vidéo |
| ffprobe | Outil d’inspection fourni avec FFmpeg, utilisé pour lire la résolution, la fréquence d’images, la durée, les pistes audio et autres informations d’une vidéo |
| Cache Hit | Taux de succès du cache : proportion de contexte répété lu depuis le cache, ce qui influe directement sur le coût API des tâches longues |
| BenchCAD 2.0 | Benchmark d’ingénierie qui teste la capacité de l’IA à reconstruire des pièces 3D, à concevoir des assemblages mécaniques et à identifier les connexions PCB |
1 Commençons par la conclusion : GPT a déjà rejoint la zone de concurrence d’Opus 5.5 en création vidéo
1.1 Quel type de « écriture de vidéos » cet article compare-t-il ?
La création vidéo par IA suit aujourd’hui deux voies. La génération vidéo native fait produire directement au modèle des images animées en continu ; elle excelle dans les personnages, le mouvement physique et le langage cinématographique. La génération vidéo pilotée par code, elle, confie au modèle le rôle de réalisateur et de programneur : comprendre la demande, écrire le script et le storyboard, coder l’animation avec Remotion, Three.js, Cairo ou Blender, générer la voix off avec TTS, puis assembler et vérifier le film final avec FFmpeg.
C’est de cette deuxième voie que parle cet article : la capacité, via des agents comme Codex CLI ou Claude Code, à livrer un MP4 complet et un projet éditable. Cette voie convient à la visualisation de données, aux présentations de produits, à la vulgarisation scientifique, aux infographies animées et aux films de marque — et c’est justement le domaine où GPT et Claude disposent aujourd’hui de benchmarks indépendants comparables.
La gamme de produits vidéo natifs d’OpenAI a elle-même évolué : le produit Sora a cessé son service le 26 avril 2026, le modèle Sora 2 et l’API Videos ont été arrêtés le 24 septembre, et l’annonce officielle de dépréciation précise qu’il n’existe pas d’API de remplacement un pour un. Publié le 4 novembre, GPT-Image-2.6 prend en charge la sortie d’animations GIF de 2 à 16 images, adaptée aux mèmes, aux mouvements en boucle et aux aperçus de storyboard — un flux de travail distinct de la production d’un MP4 complet. La capacité de la série GPT à « écrire des vidéos » se manifeste donc aujourd’hui principalement dans l’approche pilotée par code.
1.2 La réponse au titre en une phrase
GPT-6 Astra est extrêmement proche d’Opus 5.5 sur VibeVideoBench : score global légèrement supérieur, stabilité de livraison légèrement inférieure. Le modèle de nouvelle génération d’OpenAI présente des signaux techniques d’amélioration continue, mais les résultats publics spécifiques à la vidéo restent basés sur Astra.
2. 239 tâches vidéo réelles : GPT-6 Astra et Opus 5.5, lequel est le plus fort ?
2.1 Comment VibeVideoBench évalue les capacités vidéo de GPT et d’Opus 5.5
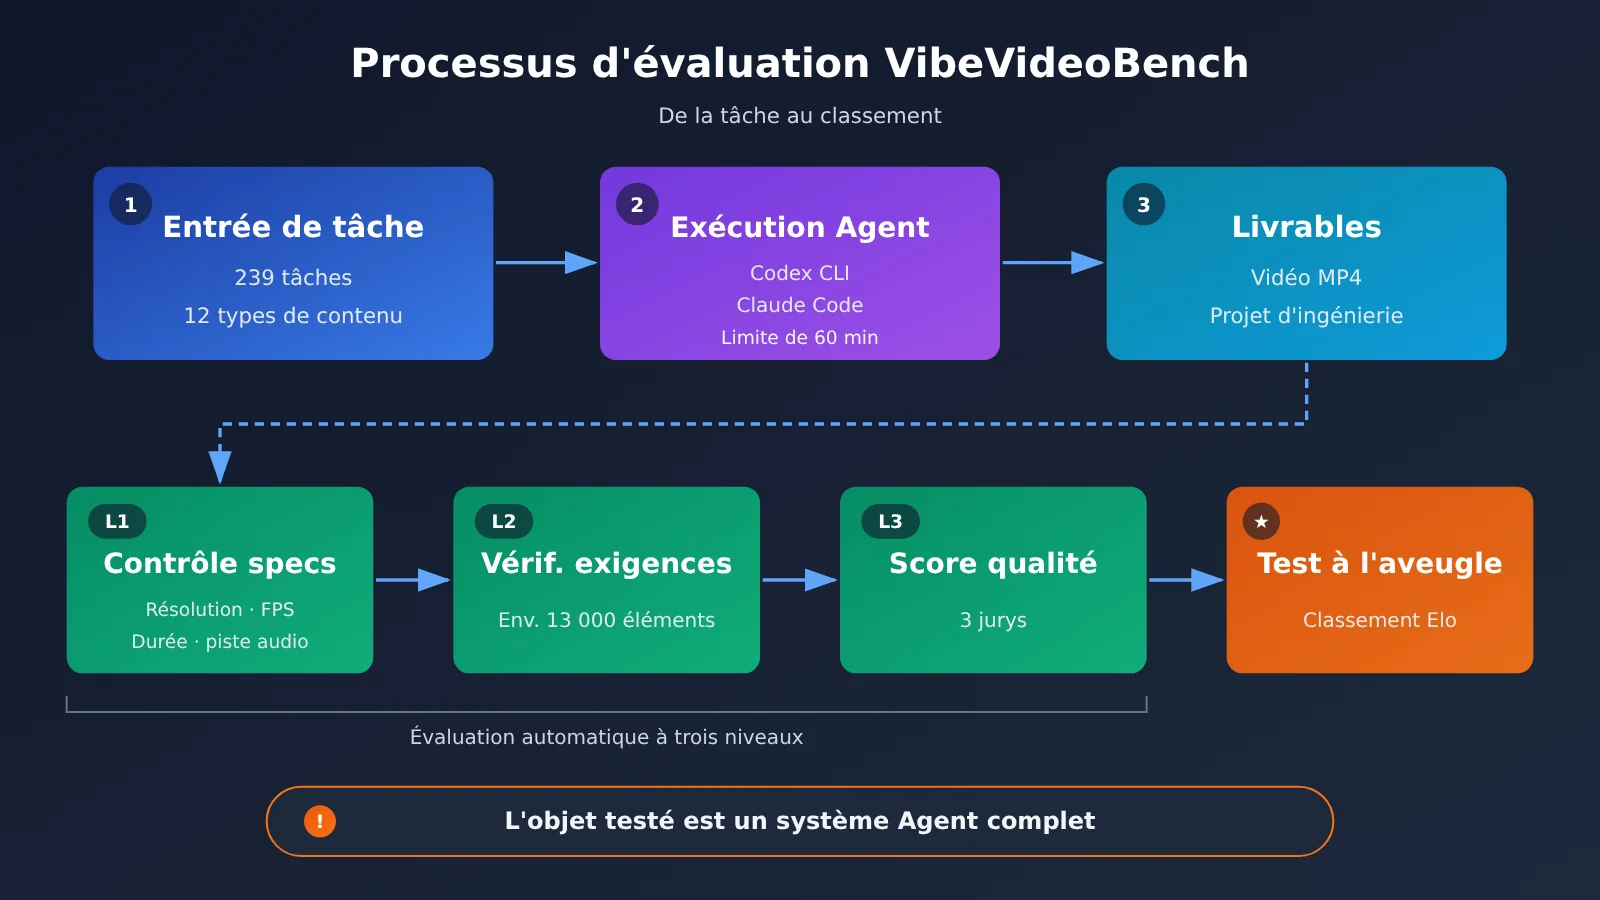
VibeVideoBench a construit 239 tâches réelles de production vidéo, couvrant 12 catégories de contenu, et a testé au total 9 systèmes Agent sur 2 151 exécutions. Chaque tâche demande à l’IA de travailler de manière autonome dans un bac à sable, puis de livrer un MP4 lisible, un projet permettant de régénérer la vidéo ainsi que des notes de production. Chaque tâche est limitée à 60 minutes ; tous les systèmes utilisent leur propre environnement de développement natif et l’intensité de raisonnement maximale disponible, sans ajout d’instructions humaines en cours de route.
GPT-6 Astra tourne dans Codex CLI, Claude Opus 5.5 dans Claude Code. Les autres systèmes testés incluent Claude Sonnet 5.5, Gemini 4 Argon, DeepSeek V4.1 Flash, Kimi K3, GLM-5.3 Flash, GPT-5.6 Sol et Gemini 3.8 Flash. L’évaluation se fait en trois niveaux : L1 vérifie si le MP4 a bien été livré et contrôle ses spécifications (résolution, fréquence d’images, durée, piste audio, etc.) ; L2 valide une à une environ 13 000 exigences de tâche ; L3 confie l’évaluation à trois systèmes d’évaluation multimodaux, qui notent la qualité d’image, l’esthétique, la logique du contenu, le rythme des mouvements et la synchronisation audio.
2.2 Comparaison des résultats globaux entre GPT-6 Astra et Opus 5.5
| Indicateur | GPT-6 Astra | Claude Opus 5.5 | Avantage |
|---|---|---|---|
| Vidéos livrées avec succès | 238/239 | 239/239 | Opus |
| Taux de livraison des vidéos | 99,6 % | 100 % | Opus |
| Taux de conformité aux spécifications | 93,7 % | 99,6 % | Opus |
| Taux de réussite aux exigences des tâches | 97,1 % | 97,3 % | Opus |
| Qualité vidéo | 4,08 | 3,99 | Astra |
| Esthétique visuelle | 4,30 | 4,19 | Astra |
| Logique du contenu | 4,20 | 4,18 | Astra |
| Mouvement et rythme | 3,95 | 3,95 | Égalité |
| Qualité audio et synchronisation | 4,10 | 4,07 | Astra |
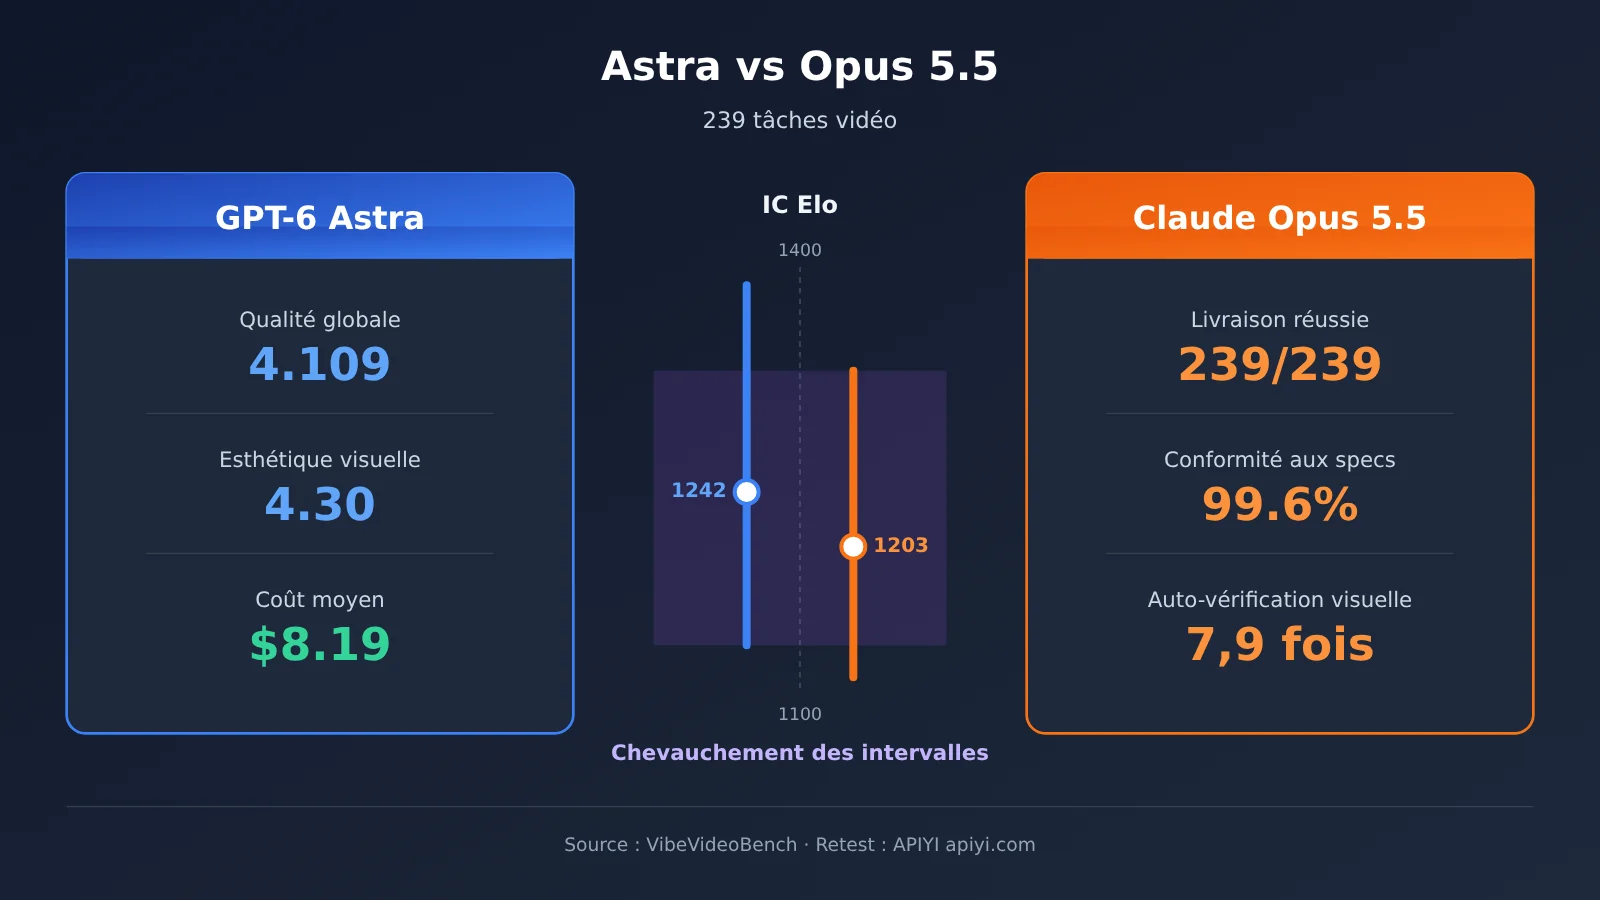
| Score de qualité global | 4,109 | 4,074 | Astra |
| Taux de réussite stricte des tâches | 74,5 % | 76,3 % | Opus |
| Elo de préférence humaine | 1242 | 1203 | Statistiquement indiscernables |
Les données proviennent de la moyenne des résultats de trois jurys, sur une échelle de notation de 1 à 5. Les deux systèmes devancent tous les autres systèmes participants.
Ce tableau révèle une répartition des rôles assez nette : Astra a un léger avantage sur le « à quel point la vidéo produite est agréable à regarder », avec un score de qualité global supérieur de 0,035 point et une esthétique visuelle supérieure de 0,11 point ; Opus 5.5 est plus fiable sur le « peut-il livrer conformément aux spécifications », avec un taux de conformité aux spécifications supérieur de 5,9 points de pourcentage et un taux de réussite stricte des tâches supérieur de 1,8 point de pourcentage. L’écart de 0,035 point est très faible, et si l’on tient compte de l’intervalle de confiance de l’Elo, les deux se situent dans la même catégorie.
2.3 Répartition des avantages de GPT et Opus 5.5 selon les types de vidéos
| Catégorie de vidéo | Astra | Opus 5.5 | En tête |
|---|---|---|---|
| Marque et marketing | 4,18 | 4,18 | Égalité |
| Présentation de produits et fonctionnalités | 4,20 | 4,24 | Opus |
| Musique et son comme moteur | 3,83 | 3,92 | Opus |
| Explication d’articles scientifiques | 4,03 | 4,07 | Opus |
| Explication de concepts et de processus | 4,19 | 4,15 | Astra |
| Récits de données et de faits | 4,14 | 4,01 | Astra |
| Art visuel | 3,94 | 3,91 | Astra |
| Jeux et sport | 4,15 | 4,12 | Astra |
| Événements et expression personnelle | 4,03 | 3,93 | Astra |
| Histoires et comédie visuelle | 4,00 | 3,88 | Astra |
| Construction et processus de fabrication | 3,97 | 3,94 | Astra |
| Enseignement en classe | 4,47 | 4,45 | Astra |
Les données proviennent de l’annexe E.4 de l’article, avec un score de zéro attribué aux vidéos non livrées.
Astra est en tête dans 8 catégories sur 12 ; les écarts les plus importants concernent les récits de données et de faits (0,13) ainsi que les histoires et la comédie visuelle (0,12). Opus 5.5 est en tête pour la présentation de produits, la musique comme moteur et l’explication d’articles scientifiques, avec un écart de 0,09 pour la musique. Les tâches musicales exigent une synchronisation poussée entre son et image, tandis que la présentation de produits demande une grande précision sur les spécifications et les détails : cela va dans le même sens que l’avantage d’Opus sur le taux de conformité aux spécifications. Dans la plupart des catégories, l’écart reste inférieur à 0,05 point ; la sélection du modèle montre déjà des différences selon le type de tâche, mais l’écart sur une catégorie donnée doit encore être interprété à la lumière de tests répétés.
2.4 Pourquoi Opus 5.5 reste compétitif
Les tests à l’aveugle menés par des humains utilisent le modèle Bradley–Terry pour calculer l’Elo. Astra obtient 1242 (intervalle de confiance à 95 % : 1134–1387), Opus 1203 (1111–1327) ; les intervalles de confiance de leurs classements sont tous deux de 1–3, et la probabilité de comparaison donnée dans l’article est P=0.69 : statistiquement, impossible de les départager. À noter que le test humain n’évalue que les vidéos déjà livrées, il ne mesure pas la capacité à livrer dans les délais — or la livraison est justement le point fort d’Opus.
Le comportement d’auto-vérification explique cela. À chaque exécution, Opus consulte en moyenne 7.9 fois les images rendues et utilise ffprobe 3.9 fois ; Astra, respectivement 3.4 et 2.1 fois. Opus inspecte plus souvent sa propre sortie, repère les problèmes et les corrige, ce qui lui vaut un taux de livraison de 100 % et un taux de conformité aux spécifications de 99.6 %. Anthropic positionne Opus 5.5 comme un modèle d’Agentic Coding taillé pour les exécutions longue durée ; dans la communauté, des utilisateurs racontent l’avoir utilisé pour boucler en une trentaine de minutes une vidéo promotionnelle d’application iOS, ou pour produire automatiquement une brève d’actualité verticale en 1080×1920 avec ses sous-titres SRT. Ce sont des cas individuels, à prendre comme preuve indirecte de la complétude du workflow.
2.5 Coût des tâches vidéo : GPT-6 Astra a un prix unitaire plus élevé, mais un coût par tâche plus faible
| Indicateur | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|
| Prix d’entrée standard (USD/million de tokens) | 10 | 4 |
| Prix de sortie standard (USD/million de tokens) | 50 | 20 |
| Coût moyen par tâche | $8.19 | $15.38 |
| Coût médian par tâche | $7.88 | $10.19 |
| Coût par tâche P90 | $11.88 | $31.22 |
| Tokens de sortie moyens | 61K | 130.7K |
| Appels API par tâche | 46 | 51 |
| Taux de cache hit | 97% | 65% |
Le prix standard d’Astra est 2,5 fois celui d’Opus 5.5, mais son coût moyen par tâche est inférieur d’environ 46,7 %. Deux raisons à cela : Astra génère environ 53,3 % de tokens de sortie en moins ; et son taux de cache hit atteint 97 %, alors qu’environ 76 % du coût par tâche d’Opus provient des Cache Write. L’écart de coût P90 est encore plus net : Opus varie davantage sur les tâches complexes. L’étude souligne aussi qu’augmenter simplement la consommation de tokens n’apporte pas l’amélioration de qualité correspondante.
Ces coûts sont des coûts équivalents calculés à partir des tarifs publics de l’API ; ils n’incluent pas les coûts de main-d’œuvre ni de matériaux pour une vidéo commerciale complète. L’API Batch officielle d’Opus 5.5 offre une réduction de 50 % sur l’entrée et la sortie ; pour une production par lots hors ligne, la structure de coûts change.
💰 Optimisation des coûts : Le coût par tâche d’un agent vidéo dépend beaucoup du cache hit et de la longueur de sortie ; se fier au prix unitaire seul peut facilement induire en erreur. Je recommande de lancer la même tâche avec les deux modèles sur APIYI apiyi.com, puis de calculer le coût réel par vidéo finale produite plutôt que de comparer les tarifs affichés.
3 Signaux d’amélioration des capacités de la prochaine génération de GPT d’OpenAI
3.1 Recherche sur Navier–Stokes : le modèle interne est nettement plus puissant que GPT-6 Astra
Le 8 septembre 2026, OpenAI a publié les résultats de ses recherches sur le problème Navier–Stokes, l’un des problèmes du prix du millénaire. L’article officiel précise que le modèle interne utilisé est nettement plus puissant que GPT-6 Astra, qu’il a été entraîné par apprentissage par renforcement à grande échelle et que l’entraînement se poursuivait encore au moment de l’annonce.
L’échelle d’exécution de cette étude est une démonstration directe des capacités multi-agents : environ 10 000 agents y ont participé simultanément, l’étude a duré environ 88 heures et a produit 2,7 millions de messages, soit environ 130 milliards de tokens de sortie. Les agents étaient répartis en groupes pour étudier différentes versions du problème, les groupes échangeaient des informations, Codex consolidait les résultats intermédiaires, et le système concentrait continuellement les ressources sur les pistes les plus prometteuses. La vérification formelle finale dans Lean a demandé 17 heures supplémentaires, avec GPT-6 Astra.
Pour la création vidéo, ce qui est le plus pertinent ici, c’est l’orchestration de tâches sur longue durée et la collaboration multi-agents, plutôt que les capacités mathématiques elles-mêmes. Une vidéo complexe exige elle aussi de traiter en parallèle le script, l’animation et l’audio, puis d’assembler, de vérifier et de retravailler.
3.2 BenchCAD 2.0 : les capacités d’ingénierie passent de 0,594 à 0,875
Le 3 novembre 2026, OpenAI a annoncé dans « Accelerating engineering for the physical world » qu’un modèle interne relativement récent avait obtenu une moyenne de 0,875 à BenchCAD 2.0, contre 0,594 pour GPT-6 Astra au niveau d’effort de raisonnement le plus élevé, soit une amélioration relative d’environ 47,3 %. Les tests portent sur la reconstruction de pièces 3D, la conception d’assemblages mécaniques et la reconnaissance des connexions PCB.
Ces deux éléments doivent être considérés séparément. OpenAI ne précise pas si le modèle testé sur BenchCAD est le même que celui de la recherche Navier–Stokes, et ni son nom ni sa date de publication n’ont été communiqués. BenchCAD est un test d’ingénierie publié par OpenAI elle-même ; il constitue un signal de progrès en compréhension spatiale et en connaissances d’ingénierie complexes, sans lien direct avec les tâches de génération vidéo.
3.3 Quand sortira le prochain GPT : état public au 15 novembre
| Date | Avancées publiques |
|---|---|
| 2 novembre | Selon The National, Altman a déclaré à l’ADIPEC que la recherche mathématique avait utilisé un modèle GPT sur le point d’être publié, avec environ 10 000 agents collaborant pendant environ quatre jours ; l’article précise que cette déclaration n’a pas été vérifiée de manière indépendante |
| 3 novembre | OpenAI publie les données BenchCAD 2.0 du modèle interne |
| 4 novembre | The Information, citant des sources proches du dossier, rapporte qu’OpenAI pourrait lancer dès le 6 novembre une nouvelle génération d’Astra, de Sol et un modèle de cybersécurité |
| 5 novembre | Le journal des modifications de l’API OpenAI confirme la publication de GPT-6 Cyber, mais pas celle d’une nouvelle génération généraliste Astra ou Sol |
| 15 novembre | Les modèles phares généralistes du catalogue officiel restent GPT-6 Astra, GPT-6.1 Sol, GPT-6.1 Terra et GPT-6 Luna |
Les noms comme GPT-6.2 Astra ou GPT-6.2 Sol qui circulent en ligne ne sont pas confirmés officiellement par OpenAI à ce jour. Il faut également noter que VibeVideoBench évalue GPT-6 Astra et GPT-5.6 Sol : les résultats d’Astra ne peuvent pas être transposés directement à GPT-6.1 Sol ou Terra.
4 Que manque-t-il encore à la prochaine génération de GPT pour dépasser Opus 5.5 en création vidéo ?
4.1 Le vrai goulet d’étranglement des agents vidéo : gestion du temps et livraison
Sur les 2 151 exécutions de VibeVideoBench, 224 n’ont pas livré de vidéo jouable. Parmi elles, 169 relèvent de problèmes de gestion du temps : rendu final lancé trop tard, exécution trop lente ou jamais démarrée, soit environ 75 % de l’ensemble des échecs. L’environnement de test est un conteneur Docker uniforme avec un CPU à 8 cœurs, 32 Go de RAM et sans GPU, et le rendu lui-même prend déjà un temps considérable.
Cela montre que, même lorsque les capacités de raisonnement du modèle progressent, il faut encore que cela se traduise dans le rythme d’exécution. Un modèle peut écrire l’animation la plus soignée du monde : s’il ne lance le rendu qu’à la 55e minute, le résultat reste zéro. Astra et Opus 5.5 sont déjà au coude à coude sur la qualité ; c’est surtout du côté de la livraison que la prochaine génération de GPT peut creuser l’écart.
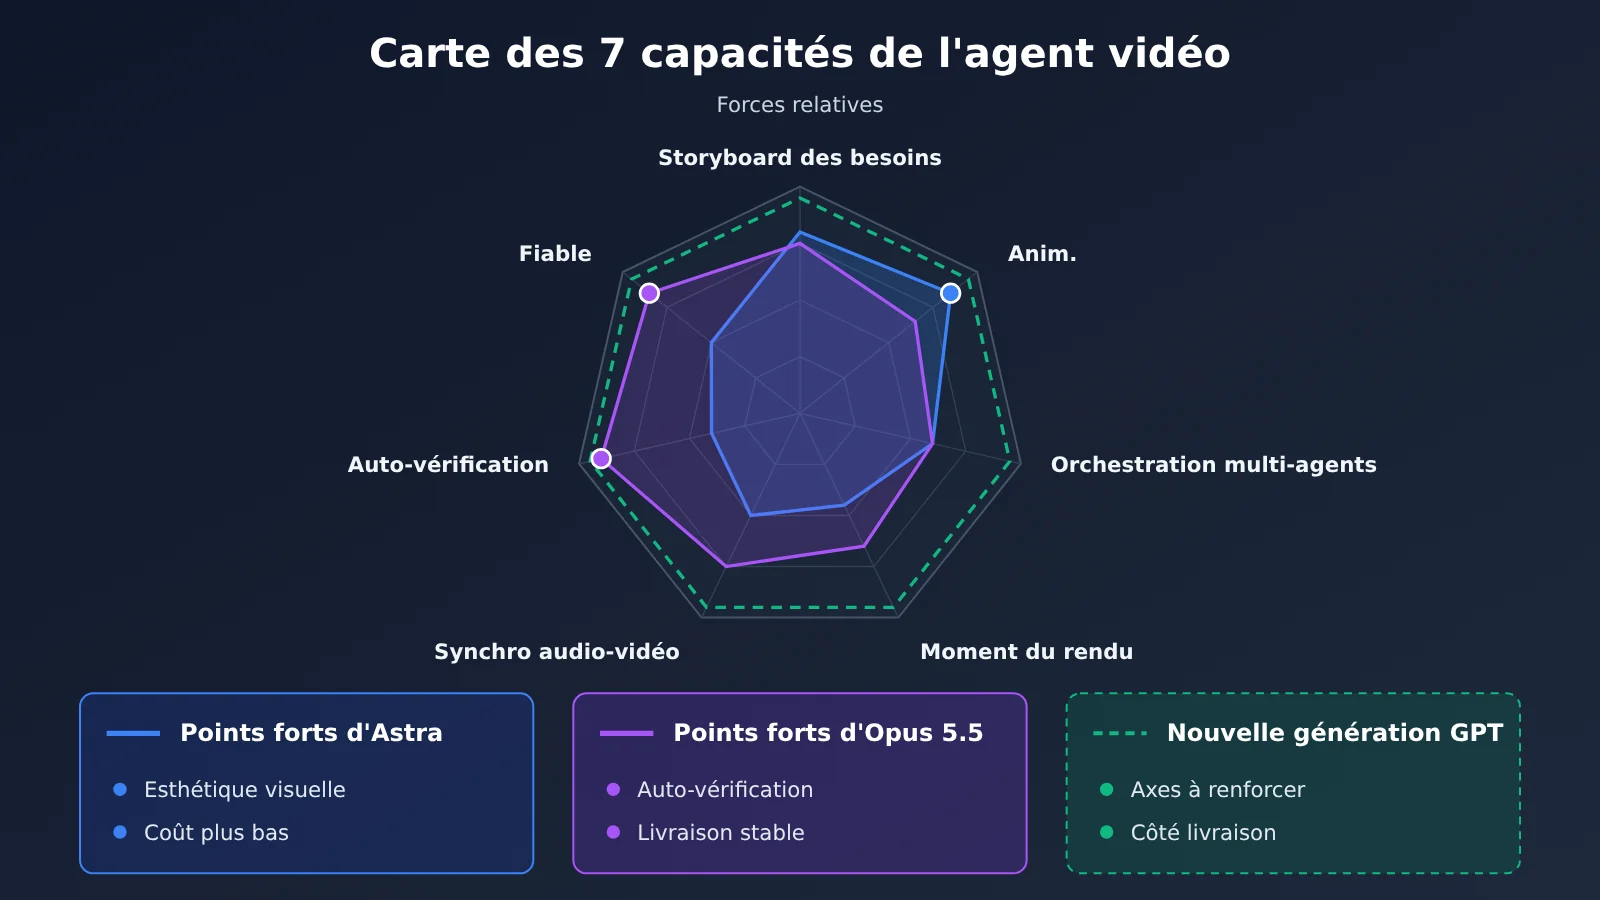
4.2 Les sept points d’amélioration de la prochaine génération de GPT dans la chaîne de production vidéo
Compte tenu des forces et faiblesses actuelles des deux modèles, un modèle de nouvelle génération qui veut dépasser nettement Opus 5.5 doit progresser simultanément sur les points suivants :
- Compréhension du besoin et du storyboard : saisir avec précision le thème, le public et le style, puis décomposer le besoin en ordre de plans et en timeline.
- Code d’animation complexe : écrire du premier coup des animations Remotion, Three.js et Python correctes, pour réduire les rendus à refaire.
- Orchestration multi-agents : paralléliser le script, l’animation et l’audio ; la capacité d’orchestration que les modèles internes démontrent dans la recherche mathématique doit être transposée à ce type de tâche d’ingénierie.
- Moment du rendu : prévoir suffisamment de temps de rendu pour éviter les problèmes de gestion du temps, qui représentent environ les trois quarts des échecs.
- Synchronisation audio-image : aligner la voix off, les effets sonores et le rythme visuel ; c’est le domaine où Opus garde son avance sur les tâches pilotées par la musique.
- Auto-vérification proactive : Opus regarde en moyenne les images 7,9 fois, contre 3,4 fois pour Astra ; la fréquence d’auto-vérification est directement liée au taux de conformité aux spécifications.
- Livraison stable : fournir un MP4 complet accompagné du projet éditable, et respecter les spécifications du premier coup.
5 Comment vérifier que le prochain GPT dépasse vraiment Opus 5.5 après sa sortie
5.1 Méthode de test comparatif en sept étapes
Les classements publics ne s’exécutent qu’une seule fois, avec une limite de 60 minutes et des tâches majoritairement en anglais (209 sur 239 sont en anglais). Les scénarios métier en chinois doivent donc être retestés par vos soins. La méthode suivante peut être réutilisée directement le jour même de la sortie d’un nouveau modèle :
| Étape | Méthode | Indicateur à suivre |
|---|---|---|
| 1 Fixer le jeu de tâches | Sélectionner 10 à 20 besoins vidéo métier réels, couvrant le script, l’animation, la visualisation de données et la présentation de produit | Couverture des tâches |
| 2 Fixer l’environnement | Unifier la chaîne d’outils (versions Remotion/FFmpeg), la configuration machine et la limite de temps ; consigner séparément les différences de Harness | Comparabilité |
| 3 Tester par étape | D’abord tester unitairement le storyboard et le code d’animation via l’API, puis exécuter le processus complet dans l’environnement Agent | Score par étape |
| 4 Consigner la consommation | Durée de chaque exécution, tokens d’entrée/sortie, taux de succès du cache | Coût par vidéo |
| 5 Vérifier la livraison | Utiliser ffprobe pour contrôler la résolution, la fréquence d’images, la durée et la piste audio | Taux de livraison, taux de conformité aux spécifications |
| 6 Tests à l’aveugle et répétition | Masquer le nom du modèle pour des comparaisons par paires, exécuter chaque tâche au moins 3 fois | Taux de victoire par préférence, variance |
| 7 Notation globale | Pondérer la qualité, le taux de réussite, le coût de modification et le coût unitaire par vidéo | Conclusion finale de sélection |
L’étape 3 sépare « la capacité du modèle » de « la capacité de l’environnement Agent ». VibeVideoBench évalue un système Agent complet, et Codex CLI comme Claude Code présentent eux-mêmes des différences ; en appelant directement les deux modèles via la même interface compatible OpenAI pour générer le storyboard et le code d’animation, on peut d’abord isoler l’influence du Harness et mieux cerner l’écart entre les modèles eux-mêmes.
5.2 Exemples de code pour comparer chaque étape avec une interface unifiée
L’exemple minimaliste ci-dessous appelle deux modèles via le même base_url pour générer le storyboard d’une même demande de vidéo. Pour les noms de modèles, référez-vous à la liste des modèles de la plateforme.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI : une seule clé pour appeler GPT et Claude
)

prompt = "为一款记账 App 设计 30 秒竖屏宣传片:给出 6 个镜头的分镜、旁白和每个镜头的时长。"
for model in ["gpt-6-astra", "claude-opus-5-5"]:
    r = client.chat.completions.create(model=model, messages=[{"role": "user", "content": prompt}])
    print(model, r.usage.total_tokens, "\n", r.choices[0].message.content[:300])
Voir le script complet de test comparatif multi-tours (durée et tokens enregistrés)
import time
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Appel unifié via APIYI, pratique pour basculer et comparer
)

MODELS = ["gpt-6-astra", "claude-opus-5-5"]  # Se référer à la liste des modèles de la plateforme ; ajouter directement les nouveaux modèles dès leur sortie
RUNS = 3  # Nombre de répétitions par tâche

TASKS = {
    "storyboard": "为一款记账 App 设计 30 秒竖屏宣传片,输出 6 个镜头的分镜、旁白和时长(JSON)。",
    "remotion": "用 Remotion 写一个 10 秒的柱状图增长动画组件,数据为 [12, 30, 45, 80],带标题与数值标签。",
    "data_story": "把“某城市 2020-2025 年新能源车渗透率从 5% 升至 48%”写成 45 秒数据故事视频的脚本和镜头说明。",
}

SYSTEM = "你是视频导演兼前端动画工程师,输出可直接用于代码驱动视频制作的内容。"


def run_once(model: str, prompt: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        max_tokens=4000,
    )
    return {
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
        "output": resp.choices[0].message.content,
    }


results = []
for task_name, prompt in TASKS.items():
    for model in MODELS:
        for i in range(RUNS):
            try:
                rec = run_once(model, prompt)
            except Exception as e:
                rec = {"error": str(e)}
            rec.update({"task": task_name, "model": model, "run": i + 1})
            results.append(rec)
            print(task_name, model, i + 1, rec.get("seconds"), rec.get("completion_tokens"))

# Enregistrer les résultats, puis les confier aux évaluateurs pour un test à l'aveugle après avoir masqué les noms de modèles
with open("video_bench_results.json", "w", encoding="utf-8") as f:
    json.dump(results, f, ensure_ascii=False, indent=2)
🚀 Démarrage rapide : la comparaison au niveau de chaque étape implique d’appeler GPT et Claude simultanément. Via APIYI apiyi.com, une seule clé API et une interface compatible OpenAI suffisent pour basculer entre les deux modèles. Les nouveaux utilisateurs bénéficient d’un quota de test gratuit ; une fois le prochain GPT disponible, il suffit d’ajouter son nom à la liste
MODELSpour relancer la même série de tâches.
5.3 Points de vigilance pour les tests de bout en bout
Une fois les tests par étape validés, lancez les tâches vidéo complètes dans Codex CLI et Claude Code, et consignez le taux de livraison ainsi que les résultats des vérifications ffprobe. L’évaluation en aveugle humaine ne porte que sur les vidéos effectivement livrées : le taux de livraison doit être mesuré séparément, faute de quoi on retombe dans l’angle mort des tests humains de VibeVideoBench. Répétez chaque tâche au moins 3 fois et calculez moyenne et variance, pour éviter de prendre le résultat d’une seule exécution pour une performance stable.
6 Recommandations : quel modèle choisir pour les scénarios vidéo, GPT ou Opus 5.5 ?
6.1 Choisir GPT-6 Astra ou Opus 5.5 selon le scénario
Sur la base des scores par catégorie et des données de livraison de VibeVideoBench, on peut aujourd’hui répartir les tâches ainsi :
- GPT-6 Astra en priorité : récits de données et de faits, explications de concepts et de processus, vidéos narratives et vidéos de jeu ; production en volume et scénarios sensibles au coût unitaire, avec un coût moyen par tâche de 8,19 dollars et un coût P90 également plus maîtrisé.
- Claude Opus 5.5 en priorité : démonstrations de produits et de fonctionnalités, vidéos pilotées par la musique, décryptage d’articles scientifiques ; livrables commerciaux soumis à des exigences strictes de spécification et de livraison, comme une résolution et une durée fixes, ou des supports de diffusion obligatoirement accompagnés d’une piste audio.
- Marketing de marque : les deux modèles obtiennent le même score de 4,18 ; décidez selon le coût et la chaîne d’outils déjà en place dans l’équipe.
6.2 Attendre la prochaine génération de GPT ou passer en production maintenant
Les deux modèles actuels produisent déjà des vidéos exploitables de façon stable : votre activité n’a pas besoin d’attendre la prochaine génération. La démarche la plus pragmatique consiste à construire votre propre jeu de tâches et vos scores de référence avec la méthode de la section 5, puis à relancer les tests le jour de la sortie d’un nouveau modèle et à décider du basculement sur la base des données.
💡 Conseil de choix : l’écart entre les deux se concentre sur la stabilité de livraison et la structure des coûts ; le choix final dépend de votre type de vidéo et de vos exigences de livraison. Nous vous recommandons de tester les deux séparément sur un même lot de tâches réelles via APIYI apiyi.com : l’interface unifiée facilite la comparaison côte à côte et le passage ultérieur à un nouveau modèle.
7 Conclusion : l’objectif concurrentiel de la prochaine génération de GPT ne se limite plus à rattraper Opus 5.5
7.1 Points essentiels des capacités vidéo de GPT et d’Opus 5.5
- Situation actuelle : GPT-6 Astra et Claude Opus 5.5 se situent tous deux dans le premier peloton sur les tâches vidéo pilotées par code de VibeVideoBench, avec une qualité globale de 4,109 contre 4,074.
- Les atouts d’Astra : l’esthétique visuelle, les scores obtenus dans la plupart des catégories de contenu, et un coût moyen par tâche inférieur d’environ 46,7 %.
- Les atouts d’Opus 5.5 : 239 livraisons sur 239, un taux de conformité aux spécifications de 99,6 %, et des auto-vérifications plus fréquentes.
- Préférence humaine : 1242 contre 1203, avec des intervalles de confiance qui se chevauchent — impossible de les distinguer statistiquement.
- Signal de la prochaine génération : le modèle interne atteint 0,875 sur BenchCAD 2.0 (Astra : 0,594) et a démontré une capacité de collaboration à l’échelle de dizaines de milliers d’agents ; le nom, la date de sortie et les résultats vidéo n’ont pas été publiés.
- Le véritable goulot d’étranglement : environ 75 % des échecs de livraison viennent de la gestion du temps ; le point de convergence de la concurrence glisse de la qualité de génération vers l’exécution et la livraison.
- Comment vérifier : tâches fixes, environnement fixe, tests à l’aveugle sur plusieurs tours, coût calculé par unité de vidéo — on peut refaire des tests au niveau de chaque étape via une interface unifiée sur APIYI apiyi.com.
7.2 Le point d’arrivée de la concurrence, c’est la productivité complète
Revenons au titre : GPT a rattrapé Opus 5.5. La version actuelle d’Astra a un léger avantage en qualité et en coût, tandis qu’Opus 5.5 garde son avance en fiabilité de livraison. Le modèle interne d’OpenAI affiche des capacités générales plus solides et un potentiel d’exécution multi-agents ; la prochaine génération de GPT généraliste a donc la possibilité d’améliorer encore ses capacités de production vidéo — mais l’ampleur exacte, ce sont les évaluations indépendantes après la sortie et vos propres tests métier qui y répondront.
La prochaine bataille se jouera sur la productivité complète : de la compréhension d’une idée créative jusqu’à la production d’une vidéo fiable, précise et modifiable, celui qui accomplira le plus de tâches au coût le plus bas l’emportera. Mon conseil : construisez dès maintenant votre propre base de référence de tâches vidéo sur APIYI apiyi.com, comme ça, dès qu’un nouveau modèle sort, vous pouvez comparer directement.
Références
- Site d’évaluation officiel de VibeVideoBench : classement des agents vidéo et scores de qualité
- Lien :
vibevideobench.github.io -
Description : aperçu du classement global et de la conception de l’évaluation
-
Article VibeVideoBench : méthodologie, scores par catégorie, coûts, préférences humaines et causes d’échec
- Lien :
arxiv.org/abs/2610.35864 -
Description : principale source des données des tableaux de cet article ; les scores par catégorie sont détaillés en annexe E.4
-
Annonce de sortie d’Anthropic Claude Opus 5.5 : positionnement du modèle et exemples officiels
- Lien :
anthropic.com/claude-opus-5-5 -
Description : description officielle des capacités d’Opus 5.5 et de l’évolution de ses coûts
-
OpenAI : On the Navier–Stokes Millennium Prize Problem : modèle interne et recherche multi-agents
- Lien :
openai.com/index/navier-stokes-solution -
Description : données sur les 10 000 agents simultanés, les 88 heures de recherche, etc.
-
OpenAI : Accelerating engineering for the physical world : résultats du modèle interne sur BenchCAD 2.0
- Lien :
openai.com/index/accelerating-engineering-for-the-physical-world -
Description : comparaison entre le modèle interne (0.875) et GPT-6 Astra (0.594)
-
Changelog et catalogue de modèles de l’API OpenAI : vérification de l’avancement des publications
- Liens :
developers.openai.com/api/docs/changelog,developers.openai.com/api/docs/models -
Description : historique de publication de GPT-6 Cyber et modèles phares actuellement publics
-
Dépréciations de l’API OpenAI : informations sur l’arrêt de Sora 2 et de l’API Videos
- Lien :
developers.openai.com/api/docs/deprecations - Description : état actuel de la voie de génération vidéo native
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil d’APIYI apiyi.com pour partager vos expériences de test des agents vidéo ; vous trouverez davantage de ressources d’intégration dans le centre de documentation docs.apiyi.com