Аннотация: В задачах VibeVideoBench по созданию видео на основе кода GPT-6 Astra уже находится на одном уровне с Claude Opus 5.5: общее качество чуть выше, стоимость ниже; Opus 5.5 работает стабильнее; следующее поколение универсальной модели OpenAI ещё не выпущено, и её возможности в работе с видео нужно проверять после релиза.
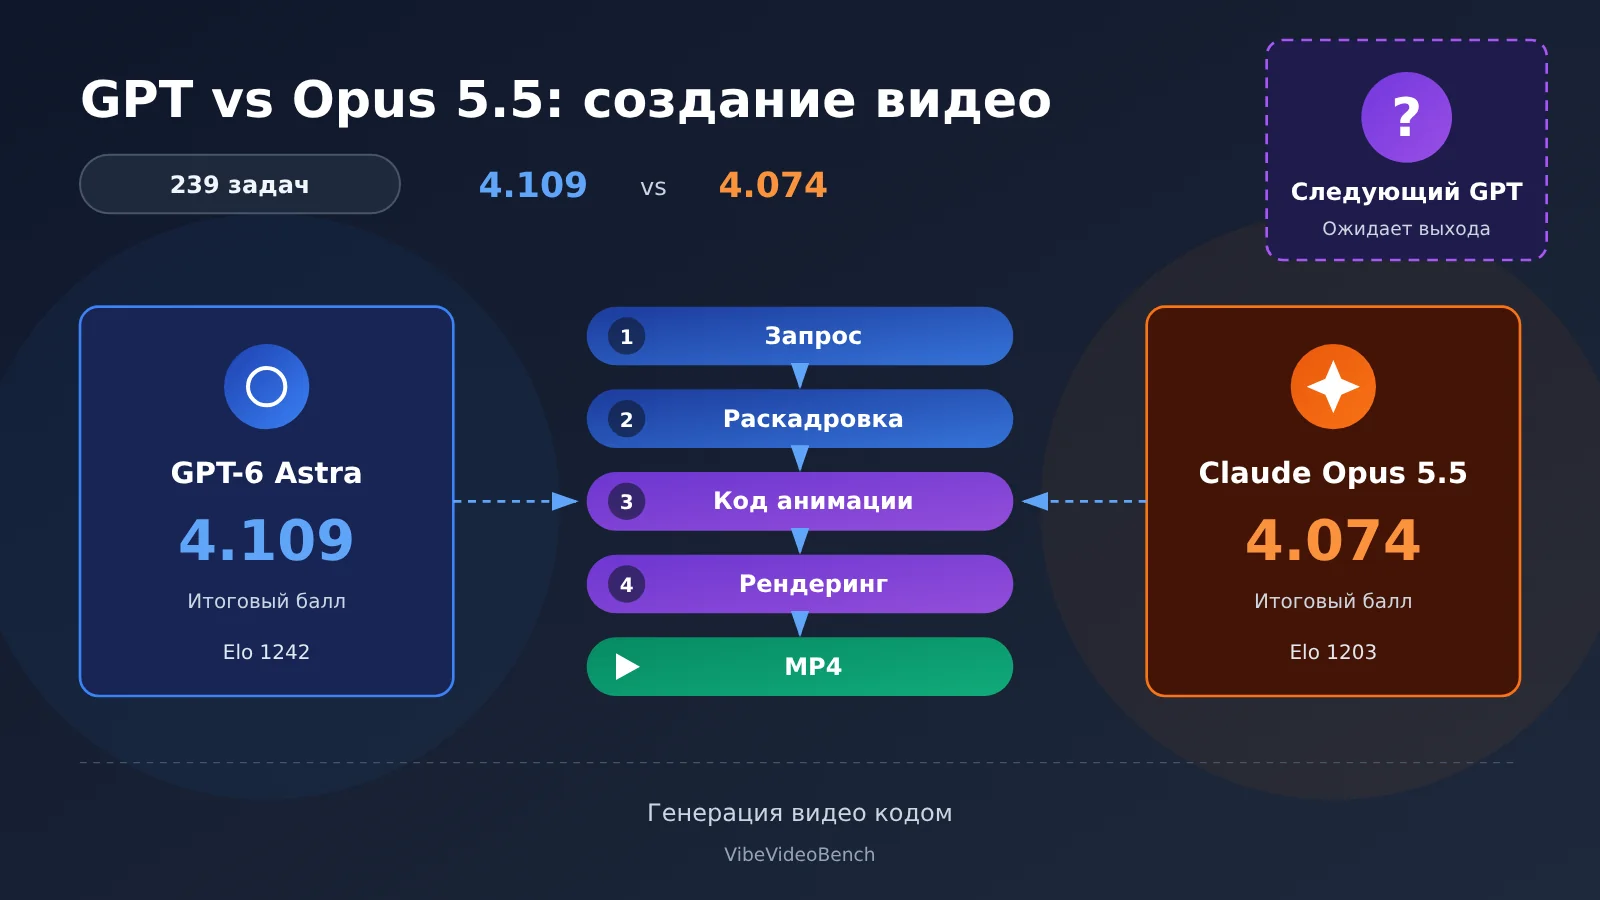
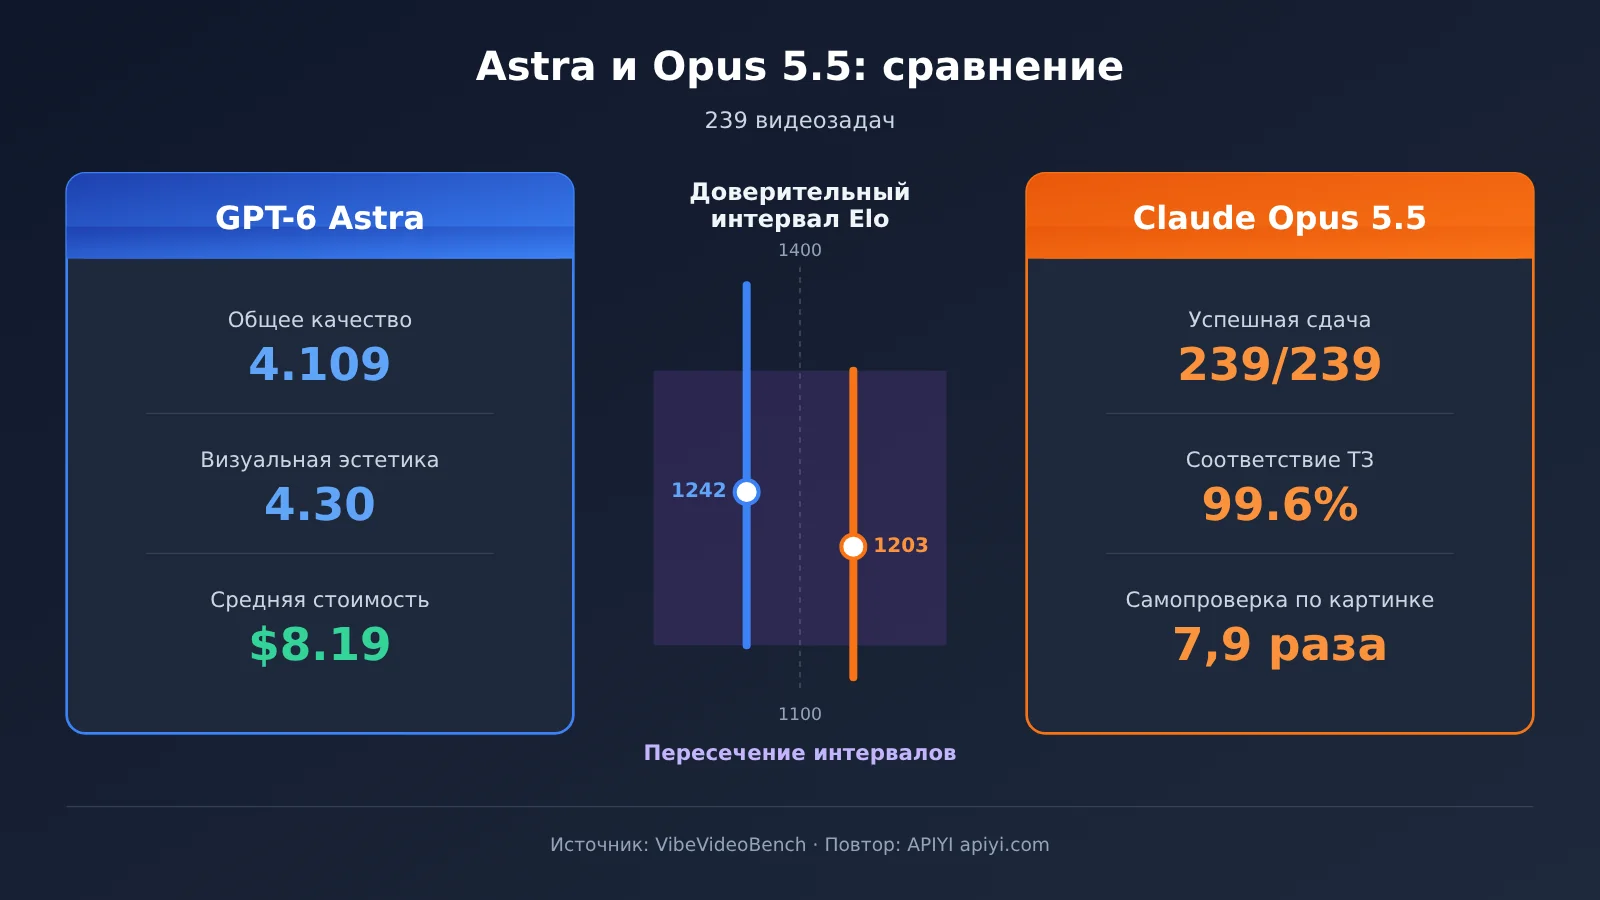
Сначала вывод: По состоянию на 15 ноября 2026 года на направлении «агент пишет код, вызывает инструменты рендеринга, выдаёт готовый MP4» GPT-6 Astra и Claude Opus 5.5 — две самые близкие системы в VibeVideoBench. Общая оценка качества Astra — 4.109, у Opus 5.5 — 4.074; Elo в слепом человеческом тесте — 1242 и 1203 соответственно, статистически различить их невозможно. Opus 5.5 выполнил все 239 задач, строгий успех по задачам — 76.3%, выше, чем у Astra — 74.5%; средняя стоимость API на задачу у Astra — 8.19 доллара, примерно вдвое меньше, чем у Opus 5.5. OpenAI уже публично показала доказательства того, что две внутренние модели заметно сильнее Astra, но название следующего универсального GPT, сроки выпуска и результаты в специализированных видео-тестах не объявлены. Поэтому ответ на вопрос из заголовка такой: текущий GPT уже догнал, а сможет ли следующее поколение вырваться вперёд — зависит от реальных тестов после релиза.
Что будет дальше: Ниже сначала определяются рамки оценки, затем разбираются общие результаты VibeVideoBench, результаты по категориям, предпочтения людей и данные по стоимости — откуда берутся преимущества каждого. Затем рассматриваются публичные сигналы о внутренних моделях OpenAI и статус выпуска следующего поколения, анализируется реальное узкое место видео-агентов. В конце — методика сравнительного тестирования, которую можно сразу использовать после выхода новой модели, чтобы понять, стоит ли менять текущее решение.
К сведению: термины, которые нужно знать перед чтением
| Термин | Объяснение |
|---|---|
| Code-driven Video Generation | Генерация видео на основе кода: AI пишет программы анимации и рендеринга, на выходе получается MP4 |
| Native Video Generation | Нативная генерация видео: модель напрямую создаёт видео по тексту или изображению; типичные продукты — Sora, Veo |
| VibeVideoBench | Бенчмарк, специально проверяющий способность AI-агента самостоятельно сделать полноценное видео; опубликован 26 октября 2026 года |
| Harness | Среда выполнения модели, дающая доступ к исполнению кода, файлам и вызову инструментов; например, Codex CLI, Claude Code |
| L1 / L2 / L3 | Три уровня оценки: проверка сдачи программы, построчная проверка требований задачи и мультимодальная оценка качества видео |
| Строгий показатель успешных задач | Доля задач, в которых видео успешно сдано и выполнены все ограничения; это строже, чем просто «доля сдачи» |
| Bradley–Terry Elo | Метод оценки, вычисляющий относительное предпочтение моделей по результатам попарных человеческих сравнений |
| Multi-agent Orchestration | Мультиагентная оркестрация: несколько агентов распределяют работу и затем объединяют результаты |
| Render Pipeline | Конвейер рендеринга видео: генерация изображения, обработка аудио, кодирование и сборка в финальный вывод |
| Remotion / FFmpeg | Первый позволяет писать видеоанимацию на React-коде, второй отвечает за кодирование и сборку аудио и видео |
| ffprobe | Утилита проверки из комплекта FFmpeg: читает разрешение, частоту кадров, длительность, звуковые дорожки и другую информацию о видео |
| Cache Hit | Доля попаданий в кэш: пропорция повторного контекста, читаемого из кэша; напрямую влияет на стоимость API для длинных задач |
| BenchCAD 2.0 | Инженерный бенчмарк для проверки способностей AI к трёхмерной реконструкции деталей, проектированию механических сборок и распознаванию соединений PCB |
1 Сначала вывод: GPT уже вышел на конкурентный уровень Opus 5.5 в создании видео
1.1 Какой именно «написание видео» сравнивается в этой статье
В AI-создании видео сейчас есть два направления. Нативная генерация видео — когда модель напрямую выдаёт непрерывные кадры, хорошо справляясь с персонажами, физическим движением и языком камеры. Генерация видео через код — когда модель выступает в роли режиссёра и программиста одновременно: понимает задачу, пишет скрипты и раскадровку, создаёт анимацию с помощью Remotion, Three.js, Cairo или Blender, генерирует озвучку через TTS, а затем собирает и проверяет готовый ролик в FFmpeg.
В этой статье речь идёт именно о втором направлении — о способности агентов вроде Codex CLI и Claude Code выдавать полноценный MP4 и редактируемый проект. Этот путь подходит для визуализации данных, презентаций продуктов, научно-популярного контента, динамических инфографик и брендовых промороликов — и именно здесь у GPT и Claude сейчас есть независимые бенчмарки для сравнения.
Собственная линейка нативных видео-продуктов OpenAI уже изменилась: продукт Sora прекратил работу 26 апреля 2026 года, модель Sora 2 и Videos API были отключены 24 сентября, а в официальном объявлении об устаревании указано, что API-замены один к одному нет. Выпущенная 4 ноября GPT-Image-2.6 поддерживает вывод GIF-анимации на 2–16 кадров — это подходит для стикеров, циклических движений и предпросмотра раскадровок, но относится к другому рабочему процессу, нежели создание полноценного MP4. Поэтому способность серии GPT «писать видео» сегодня проявляется в основном на маршруте, управляемом кодом.
1.2 Ответ на вопрос из заголовка в одном предложении
GPT-6 Astra в VibeVideoBench очень близок к Opus 5.5: итоговая оценка чуть выше, а стабильность сдачи результата чуть ниже. У следующего поколения моделей OpenAI есть технические сигналы для дальнейшего роста, но публичные результаты по специализированным видео-задачам пока опираются на Astra.
2 239 реальных видеозадач: кто сильнее — GPT-6 Astra или Opus 5.5?
2.1 Как VibeVideoBench проверяет видеоспособности GPT и Opus 5.5
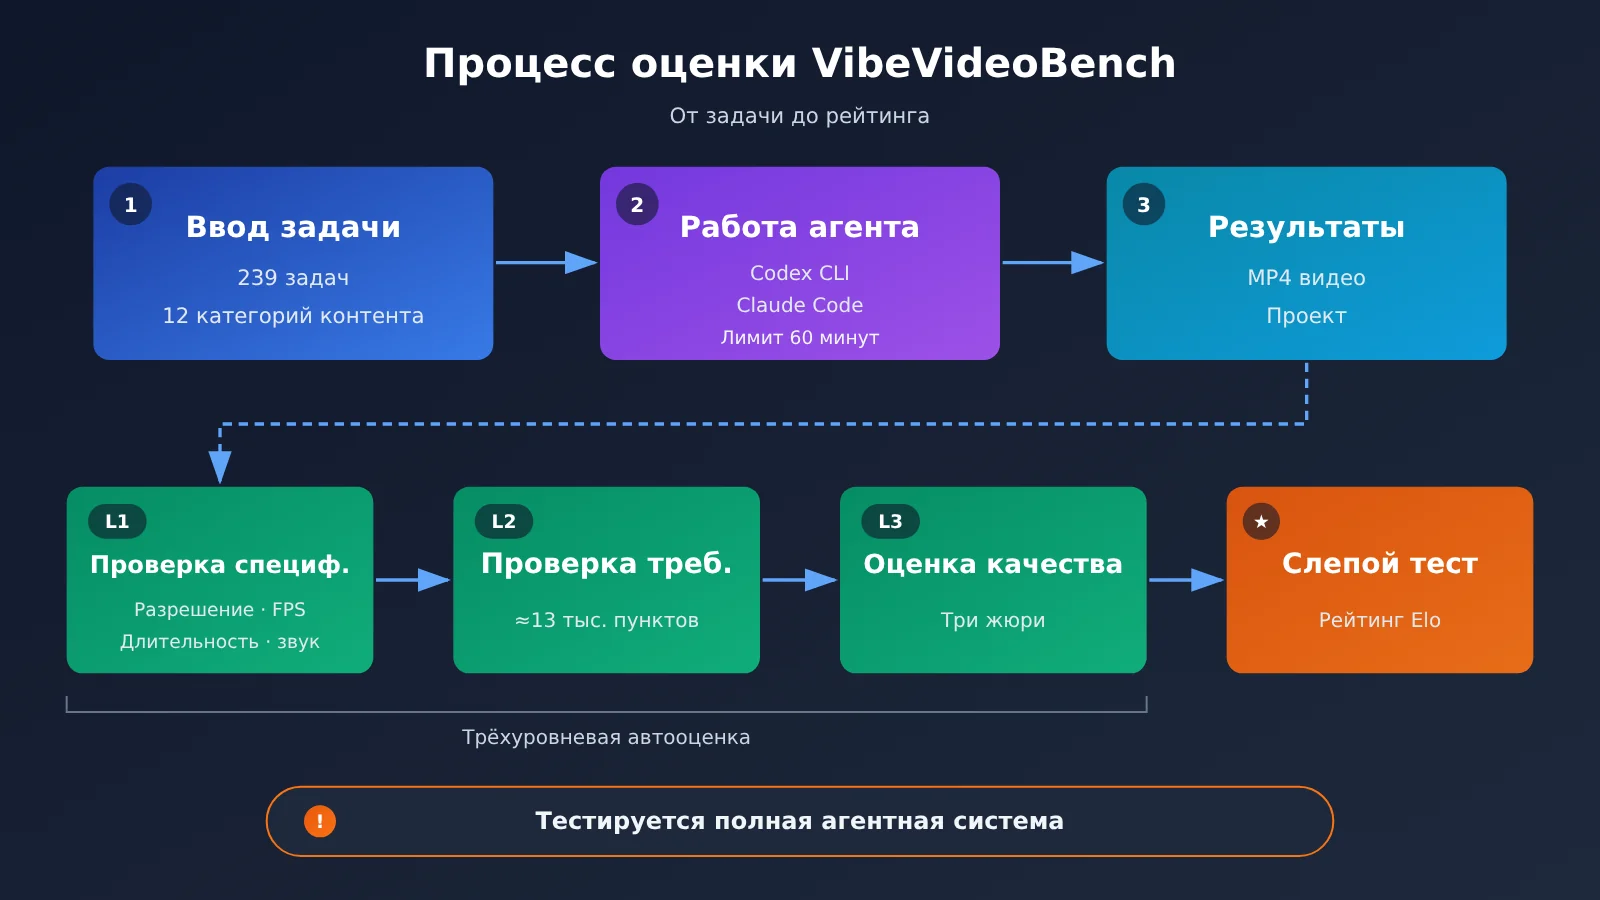
VibeVideoBench собрал 239 реальных задач по видеопроизводству, охватывающих 12 категорий контента, и протестировал 9 агентных систем в общей сложности за 2 151 запуск. Каждая задача требует, чтобы ИИ самостоятельно выполнил её в песочнице, сдав воспроизводимый MP4-файл, инженерный проект, позволяющий перегенерировать видео, и инструкцию по производству. На каждую задачу отводится 60 минут, все системы используют собственную нативную среду разработки и максимально доступную интенсивность рассуждений, а по ходу выполнения дополнительные инструкции от человека не добавляются.
GPT-6 Astra работает в Codex CLI, Claude Opus 5.5 — в Claude Code. Среди остальных участников — Claude Sonnet 5.5, Gemini 4 Argon, DeepSeek V4.1 Flash, Kimi K3, GLM-5.3 Flash, GPT-5.6 Sol и Gemini 3.8 Flash. Оценка идёт на трёх уровнях: L1 проверяет, сдан ли MP4, а также его спецификации — разрешение, частоту кадров, длительность, звуковую дорожку; L2 построчно проверяет около 13 тысяч требований задачи; L3 — три мультимодальные системы-судьи оценивают качество изображения, эстетику, логику контента, ритм движения и синхронизацию звука.
2.2 Общее сравнение результатов GPT-6 Astra и Opus 5.5
| Показатель | GPT-6 Astra | Claude Opus 5.5 | Лидер |
|---|---|---|---|
| Успешно доставлено видео | 238/239 | 239/239 | Opus |
| Доля доставленных видео | 99.6% | 100% | Opus |
| Соответствие спецификации | 93.7% | 99.6% | Opus |
| Прохождение требований задания | 97.1% | 97.3% | Opus |
| Качество видео | 4.08 | 3.99 | Astra |
| Визуальная эстетика | 4.30 | 4.19 | Astra |
| Логика содержания | 4.20 | 4.18 | Astra |
| Движение и ритм | 3.95 | 3.95 | Ничья |
| Качество аудио и синхронизация | 4.10 | 4.07 | Astra |
| Итоговая оценка качества | 4.109 | 4.074 | Astra |
| Доля успешных строгих задач | 74.5% | 76.3% | Opus |
| Человеческое предпочтение Elo | 1242 | 1203 | Статистически неразличимы |
Данные получены усреднением результатов трёх судейских панелей, шкала оценки — от 1 до 5. Обе системы опережают остальные участвовавшие системы.
Эта таблица показывает чёткое разделение ролей: Astra немного сильнее в том, «насколько хорошо выглядит созданное видео» — по итоговой оценке качества она опережает на 0.035 балла, по визуальной эстетике — на 0.11 балла; Opus 5.5 надёжнее в том, «удастся ли сдать результат в соответствии со спецификацией» — доля соответствия спецификации выше на 5.9 процентного пункта, а доля успешных строгих задач — на 1.8 процентного пункта. Разрыв в 0.035 балла очень мал, и с учётом доверительного интервала Elo оба находятся на одном уровне.
2.3 Распределение преимуществ GPT и Opus 5.5 по разным типам видео
| Категория видео | Astra | Opus 5.5 | Лидер |
|---|---|---|---|
| Бренды и маркетинг | 4.18 | 4.18 | ничья |
| Демонстрация продуктов и функций | 4.20 | 4.24 | Opus |
| Музыка и звуковое сопровождение | 3.83 | 3.92 | Opus |
| Разбор научных статей | 4.03 | 4.07 | Opus |
| Объяснение концепций и процессов | 4.19 | 4.15 | Astra |
| Истории о данных и фактах | 4.14 | 4.01 | Astra |
| Визуальное искусство | 3.94 | 3.91 | Astra |
| Игры и спорт | 4.15 | 4.12 | Astra |
| События и самовыражение | 4.03 | 3.93 | Astra |
| Истории и визуальная комедия | 4.00 | 3.88 | Astra |
| Строительство и производственные процессы | 3.97 | 3.94 | Astra |
| Обучение в классе | 4.47 | 4.45 | Astra |
Данные взяты из Appendix E.4 статьи; непоставленные видео учитывались как нулевые баллы.
Astra лидирует в 8 из 12 категорий. Наибольший разрыв — в категориях «Истории о данных и фактах» (0.13) и «Истории и визуальная комедия» (0.12). Opus 5.5 опережает в демонстрации продуктов, музыке и звуковом сопровождении, а также в разборе научных статей; в категории «Музыка и звуковое сопровождение» разрыв составляет 0.09. Музыкальные задачи предъявляют высокие требования к синхронизации звука и изображения, а демонстрация продуктов — к specifications и деталям; это согласуется с направлением преимущества Opus по соблюдению спецификаций. В большинстве категорий разрыв не превышает 0.05 балла. Выбор модели уже зависит от типа задачи, но для отдельных категорий разницу стоит подтверждать повторными тестами.
2.4 Почему Opus 5.5 всё ещё конкурентоспособен
В человеческом слепом тесте Elo считали по модели Bradley–Terry. У Astra — 1242 (95% доверительный интервал 1134–1387), у Opus — 1203 (1111–1327). Доверительные интервалы по рангу у обеих моделей — 1–3, вероятность сравнения, приведённая в статье, P=0.69, и вывод такой: статистически различить их нельзя. Здесь важна оговорка: люди оценивают только уже доставленные видео и не могут измерить способность сдать работу в срок — а как раз доставка и есть сильная сторона Opus.
Картину объясняет самопроверка. Opus за один прогон в среднем просматривает отрендеренные изображения 7.9 раза и обращается к ffprobe 3.9 раза; у Astra — 3.4 и 2.1 соответственно. Opus чаще проверяет собственный вывод, находит проблемы и исправляет их — и получает за это 100% доставку и 99.6% соответствия спецификации. Anthropic позиционирует Opus 5.5 как модель для агентного программирования (Agentic Coding) с длительными прогонами. В сообществе тоже есть пользователи, которые рассказывают, как примерно за 30 минут сделали рекламный ролик для iOS-приложения, автоматически собрали вертикальный новостной ролик 1080×1920 с SRT-субтитрами. Это частные случаи, но их можно рассматривать как косвенное подтверждение того, что рабочий процесс у модели выстроен целиком.
2.5 Стоимость видеозадач: у GPT-6 Astra выше цена за единицу, но задача выходит дешевле
| Показатель | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|
| Стандартная цена ввода (долл./1 млн токенов) | 10 | 4 |
| Стандартная цена вывода (долл./1 млн токенов) | 50 | 20 |
| Средняя стоимость задачи | $8.19 | $15.38 |
| Медианная стоимость задачи | $7.88 | $10.19 |
| Стоимость задачи P90 | $11.88 | $31.22 |
| Средний объём вывода, токенов | 61K | 130.7K |
| Вызовов API на задачу | 46 | 51 |
| Cache Hit | 97% | 65% |
Стандартная цена Astra в 2.5 раза выше, чем у Opus 5.5, но средняя стоимость задачи ниже примерно на 46.7%. Причин две: Astra выводит примерно на 53.3% меньше токенов, а доля попаданий в кэш у неё достигает 97%, тогда как у Opus около 76% стоимости задачи приходится на Cache Write. На P90 разрыв ещё заметнее — у Opus затраты на сложных задачах колеблются сильнее. В статье также отмечается, что простое увеличение расхода токенов не даёт соответствующего прироста качества.
Эти затраты — эквивалентные, пересчитанные по публичным ценам API, без учёта расходов на персонал и материалы для полноценного коммерческого видео. Официальный Batch API Opus 5.5 даёт скидку 50% на ввод и вывод, так что при офлайн-пакетном производстве структура затрат изменится.
💰 Оптимизация затрат: на стоимость одной задачи видео-Agent сильно влияют попадание в кэш и длина вывода — если смотреть только на цену за единицу, легко ошибиться. Советую на APIYI apiyi.com прогнать одну и ту же задачу на обеих моделях и считать по «фактическому расходу на каждый готовый ролик», а не сравнивать по прайс-листу.
3 Сигналы роста возможностей GPT следующего поколения от OpenAI
3.1 Исследование Navier–Stokes: внутренняя модель заметно сильнее GPT-6 Astra
8 сентября 2026 года OpenAI опубликовала результаты работы над задачей тысячелетия, посвящённой уравнениям Навье — Стокса. В официальной публикации указано, что использованная внутренняя модель существенно превосходит GPT-6 Astra, обучена с помощью масштабного обучения с подкреплением, а на момент публикации обучение всё ещё продолжалось.
Масштаб этого исследования — прямое доказательство возможностей мультиагентных систем: одновременно участвовали около 10 000 агентов, работа заняла около 88 часов, было создано 2,7 млн сообщений и около 130 млрд выходных токенов. Агенты были разбиты на группы, каждая исследовала свою версию задачи, группы обменивались информацией, Codex объединял промежуточные результаты, а система постоянно перенаправляла ресурсы на более перспективные направления. Финальная формальная верификация в Lean заняла ещё 17 часов и выполнялась с использованием GPT-6 Astra.
Для видеосоздания здесь важнее не сама математическая способность, а планирование долгих задач и взаимодействие нескольких агентов. Сложный видеоролик тоже требует параллельной работы над сценарием, анимацией и звуком с последующей сборкой, проверкой и доработкой.
3.2 BenchCAD 2.0: инженерные способности выросли с 0,594 до 0,875
3 ноября 2026 года OpenAI в материале «Accelerating engineering for the physical world» сообщила: одна из более новых внутренних моделей показала средний результат 0,875 в BenchCAD 2.0, у GPT-6 Astra при максимальной интенсивности рассуждений — 0,594, относительный прирост около 47,3%. Тесты включали реконструкцию трёхмерных деталей, проектирование механических сборок и распознавание соединений на печатных платах.
Эти два свидетельства стоит рассматривать отдельно. OpenAI не уточнила, использовалась ли одна и та же модель для BenchCAD и исследования Navier–Stokes; названия и даты выпуска также не раскрыты. BenchCAD — это инженерный тест, опубликованный самой OpenAI; он сигнализирует о прогрессе в пространственном понимании и сложных инженерных знаниях, но напрямую с задачами генерации видео не связан.
3.3 Когда выйдет следующее поколение GPT: публичный статус по состоянию на 15 ноября
| Дата | Что стало известно публично |
|---|---|
| 2 ноября | По сообщению The National, Альтман на ADIPEC заявил, что в математическом исследовании использовалась ещё не выпущенная модель GPT, а около 10 000 агентов работали вместе примерно четыре дня; издание отметило, что это утверждение не прошло независимую проверку |
| 3 ноября | OpenAI опубликовала данные внутренней модели в BenchCAD 2.0 |
| 4 ноября | The Information со ссылкой на источники сообщила, что OpenAI может уже 6 ноября выпустить новые Astra, Sol и модель для кибербезопасности |
| 5 ноября | В OpenAI API Changelog подтверждён выпуск GPT-6 Cyber; новые универсальные Astra и Sol выпущены не были |
| 15 ноября | В официальном каталоге моделей универсальными флагманами по-прежнему остаются GPT-6 Astra, GPT-6.1 Sol, GPT-6.1 Terra и GPT-6 Luna |
Названия вроде GPT-6.2 Astra и GPT-6.2 Sol, распространяемые в сети, пока не получили официального подтверждения OpenAI. Также стоит учитывать, что VibeVideoBench оценивает GPT-6 Astra и GPT-5.6 Sol, поэтому результаты Astra нельзя напрямую переносить на GPT-6.1 Sol или Terra.
4 Что ещё нужно следующему поколению GPT, чтобы обогнать Opus 5.5 в создании видео
4.1 Настоящее узкое место видеоагентов: управление временем и доставка результата
Из всех 2 151 запуска VibeVideoBench в 224 случаях не удалось получить воспроизводимый видеофайл. 169 из них — это проблемы управления временем: финальный рендеринг стартовал слишком поздно, работал слишком медленно или вообще не запускался. Это примерно 75% всех провалов. Тестовая среда — единый Docker-контейнер с 8-ядерным CPU, 32 ГБ памяти и без GPU, так что сам рендеринг забирает ощутимую часть времени.
Отсюда вывод: после роста способности модели к рассуждению всё упирается в ритм выполнения. Как бы изящно модель ни написала анимацию, если рендеринг запускается на 55-й минуте, результат всё равно нулевой. Astra и Opus 5.5 по качеству уже практически неразличимы, а основное пространство для отрыва у следующего поколения GPT — именно на стороне доставки результата.
4.2 Семь точек роста следующего поколения GPT в видеорабочем процессе
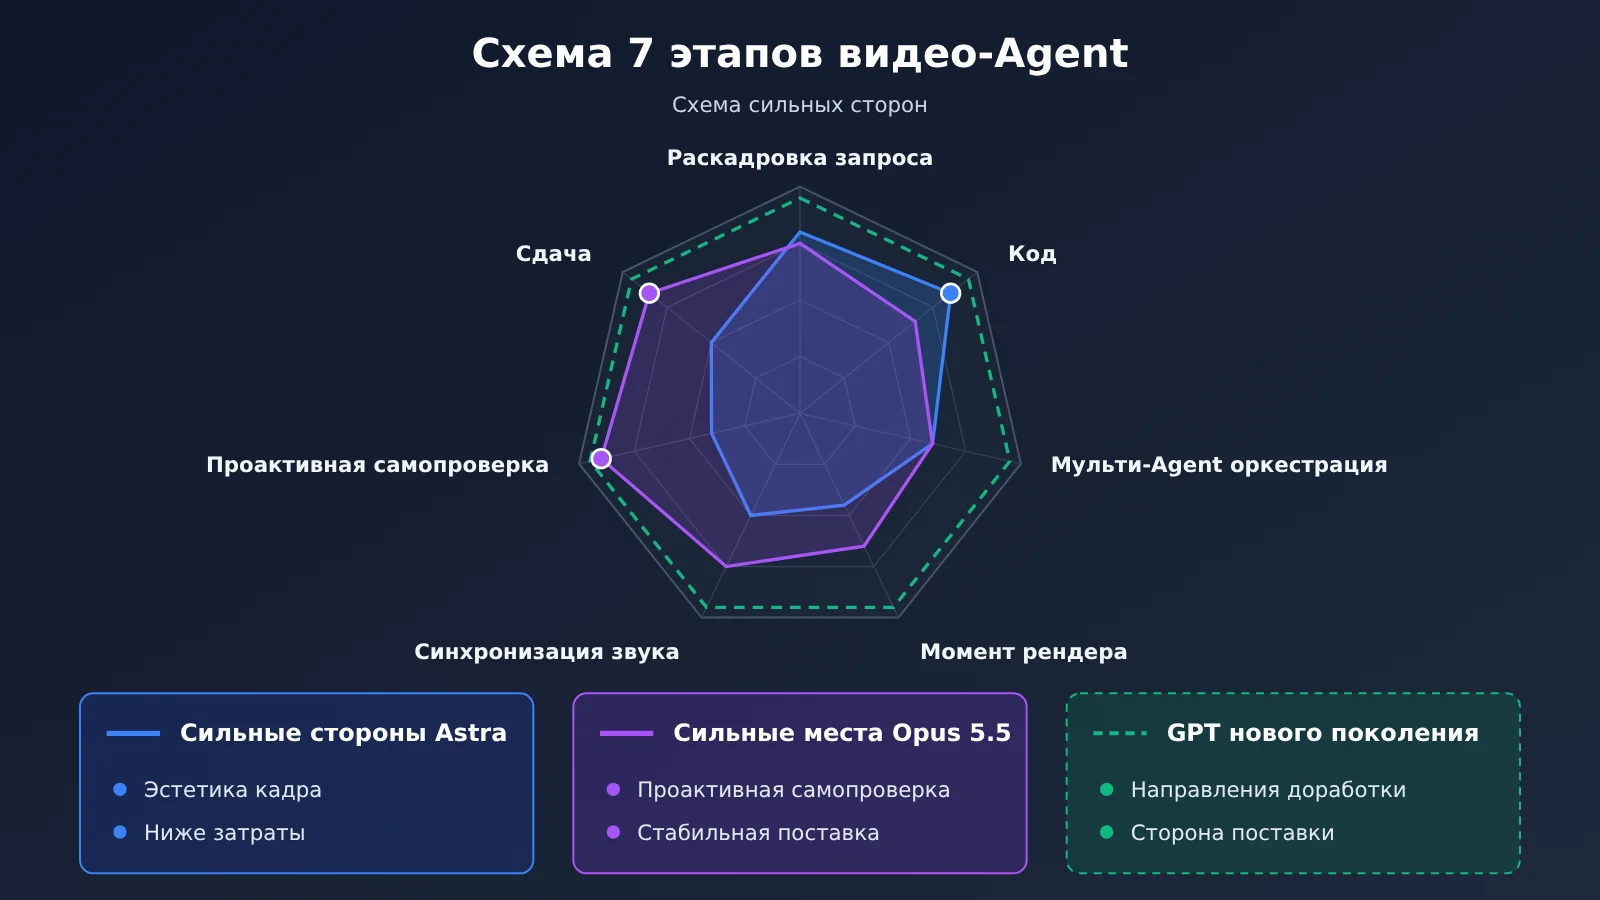
Если сопоставить текущие сильные и слабые стороны обоих, то новому поколению модели, чтобы заметно превзойти Opus 5.5, нужно одновременно подтянуть следующие звенья:
- Понимание требований и раскадровки: точно схватывать тему, аудиторию и стиль, разбивать задачу на последовательность кадров и таймлайн.
- Код сложной анимации: Remotion, Three.js и Python-анимации — писать правильно с первого раза, чтобы меньше переделывать рендеры.
- Оркестрация нескольких агентов: распараллеливать сценарий, анимацию и звук; способность к координации, которую внутренняя модель показала в математических исследованиях, нужно перенести на такие инженерные задачи.
- Момент рендеринга: резервировать достаточно времени на рендеринг и не допускать проблем управления временем, которые дают примерно три четверти всех провалов.
- Синхронизация звука и картинки: выравнивать закадровый голос, звуковые эффекты и ритм изображения — именно в этом направлении Opus лидирует в задачах с музыкальной основой.
- Активная самопроверка: Opus в среднем просматривает изображения 7,9 раза, Astra — 3,4 раза. Частота самопроверки напрямую связана с долей соответствия спецификации.
- Стабильная доставка: готовый MP4 плюс редактируемый проект, и чтобы спецификация соблюдалась с первого раза.
5. Как после релиза GPT нового поколения проверить, что он действительно превосходит Opus 5.5
5.1 Как сравнивать: методика из семи шагов
Публичные лидерборды прогоняются один раз, имеют лимит в 60 минут и в основном состоят из англоязычных задач (209 из 239 задач — на английском). Поэтому бизнес-сценарии на китайском приходится перепроверять самостоятельно. Методику ниже можно использовать сразу в день релиза новой модели:
| Шаг | Что делать | На что смотреть |
|---|---|---|
| 1. Фиксируем набор задач | Выберите 10–20 реальных бизнес-запросов на видео, покрывающих сценарии, анимацию, визуализацию данных и демонстрацию продукта | Покрытие задач |
| 2. Фиксируем среду | Единый инструментарий (версии Remotion/FFmpeg), одинаковые конфигурации машин и лимиты времени; различия Harness записывайте отдельно | Сопоставимость |
| 3. Тестируем по этапам | Сначала отдельно проверьте через API раскадровку и код анимации, затем прогоните весь процесс в агентной среде | Оценка по этапам |
| 4. Учитываем затраты | Время каждого запуска, входные и выходные токены, попадания в кэш | Стоимость одного видео |
| 5. Проверяем результат | С помощью ffprobe сверьте разрешение, частоту кадров, длительность и звуковую дорожку | Доля сданных результатов, соответствие спецификациям |
| 6. Слепое тестирование и повторы | Скрывайте названия моделей и сравнивайте попарно; каждый запуск повторяйте минимум 3 раза | Доля побед по предпочтению, дисперсия |
| 7. Итоговая оценка | Взвешенно оцените качество, успешность, стоимость доработок и стоимость одного видео | Итоговый вывод по выбору модели |
Шаг 3 разделяет «возможности модели» и «возможности агентной среды». VibeVideoBench оценивает агентную систему целиком, а Codex CLI и Claude Code сами по себе тоже различаются. Если напрямую вызывать обе модели через один и тот же OpenAI-совместимый интерфейс для генерации раскадровки и кода анимации, можно сначала отделить влияние Harness и яснее увидеть разницу между самими моделями.
5.2 Пример кода для сравнения на уровне этапов через единый интерфейс
В приведённом ниже минимальном примере через один и тот же base_url вызываются две модели и генерируется раскадровка для одного и того же видео-брифа. Названия моделей следует сверять со списком моделей на платформе.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс APIYI: один ключ для вызова GPT и Claude
)

prompt = "为一款记账 App 设计 30 秒竖屏宣传片:给出 6 个镜头的分镜、旁白和每个镜头的时长。"
for model in ["gpt-6-astra", "claude-opus-5-5"]:
    r = client.chat.completions.create(model=model, messages=[{"role": "user", "content": prompt}])
    print(model, r.usage.total_tokens, "\n", r.choices[0].message.content[:300])
Посмотреть полный скрипт многократного сравнительного тестирования (с фиксацией времени и токенов)
import time
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый вызов через APIYI — удобно переключаться и сравнивать
)

MODELS = ["gpt-6-astra", "claude-opus-5-5"]  # Сверяйтесь со списком моделей на платформе; новые модели можно просто добавлять после релиза
RUNS = 3  # Количество повторных запусков для каждой задачи

TASKS = {
    "storyboard": "为一款记账 App 设计 30 秒竖屏宣传片,输出 6 个镜头的分镜、旁白和时长(JSON)。",
    "remotion": "用 Remotion 写一个 10 秒的柱状图增长动画组件,数据为 [12, 30, 45, 80],带标题与数值标签。",
    "data_story": "把“某城市 2020-2025 年新能源车渗透率从 5% 升至 48%”写成 45 秒数据故事视频的脚本和镜头说明。",
}

SYSTEM = "你是视频导演兼前端动画工程师,输出可直接用于代码驱动视频制作的内容。"


def run_once(model: str, prompt: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        max_tokens=4000,
    )
    return {
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
        "output": resp.choices[0].message.content,
    }


results = []
for task_name, prompt in TASKS.items():
    for model in MODELS:
        for i in range(RUNS):
            try:
                rec = run_once(model, prompt)
            except Exception as e:
                rec = {"error": str(e)}
            rec.update({"task": task_name, "model": model, "run": i + 1})
            results.append(rec)
            print(task_name, model, i + 1, rec.get("seconds"), rec.get("completion_tokens"))

# Сохраняем результаты; после скрытия названий моделей передаём их на слепую оценку рецензентам
with open("video_bench_results.json", "w", encoding="utf-8") as f:
    json.dump(results, f, ensure_ascii=False, indent=2)
🚀 Быстрый старт: для сравнения на уровне этапов нужно одновременно вызывать GPT и Claude. Через APIYI apiyi.com можно переключаться между моделями обоих провайдеров с помощью одного API-ключа и OpenAI-совместимого интерфейса. Новым пользователям доступен бесплатный тестовый лимит; после запуска следующего поколения GPT достаточно добавить название модели в список
MODELS, чтобы повторно прогнать тот же набор задач.
5.3 Что учитывать при сквозном тестировании
Когда тесты отдельных этапов пройдены, запускайте полные видеозадачи в Codex CLI и Claude Code и фиксируйте долю успешных доставок и результаты проверки через ffprobe. Слепое тестирование людьми оценивает только уже доставленные видео, а долю доставок нужно считать отдельно — иначе мы повторим ту самую слепую зону ручного тестирования VibeVideoBench. Каждую задачу стоит повторить минимум 3 раза и брать среднее и дисперсию, чтобы не принимать результат одного прогона за стабильную производительность.
6 Рекомендации по выбору: GPT или Opus 5.5 для видеосценариев
6.1 Выбор GPT-6 Astra или Opus 5.5 в зависимости от сценария
Опираясь на результаты по категориям и данные о доставке из VibeVideoBench, на текущий момент распределение может быть таким:
- Приоритет — GPT-6 Astra: данные и фактологические истории, объяснение концепций и процессов, сюжетные и игровые видео; массовое производство и сценарии, чувствительные к удельной стоимости — средняя стоимость задачи 8,19 доллара, а P90-стоимость тоже более управляемая.
- Приоритет — Claude Opus 5.5: демонстрация продуктов и функций, видео под музыку, разбор научных статей; коммерческие поставки с жёсткими требованиями к спецификациям и доставке — фиксированное разрешение, длительность, обязательная звуковая дорожка в рекламных материалах.
- Брендовый маркетинг: у обеих моделей одинаковый балл 4,18, так что решайте по стоимости и по инструментарию, который уже есть у команды.
6.2 Ждать следующее поколение GPT или запускаться уже сейчас
Обе текущие модели уже стабильно выдают пригодные к использованию видео, так что бизнесу незачем ждать следующего поколения. Гораздо практичнее — собрать собственный набор задач и базовые показатели по методике из раздела 5, а в день выхода новой модели прогнать тесты заново и решить на основе данных, стоит ли переключаться.
💡 Совет по выбору: разница между моделями сосредоточена в стабильности доставки и структуре затрат, а окончательный выбор зависит от типа ваших видео и требований к доставке. Рекомендую через APIYI apiyi.com проверить обе модели на одной и той же партии реальных задач — единый интерфейс упрощает сравнение бок о бок и последующий переход на новую модель.
7. Итоговый вывод: цель конкуренции для GPT следующего поколения — уже не просто догнать Opus 5.5
7.1 Ключевые моменты по видео-возможностям GPT и Opus 5.5
- Текущее положение: GPT-6 Astra и Claude Opus 5.5 в задачах VibeVideoBench по генерации видео на основе кода входят в одну группу лидеров; итоговое качество — 4.109 против 4.074.
- Преимущества Astra: визуальная эстетика, более высокие оценки в большинстве категорий контента и средняя стоимость задачи ниже примерно на 46.7%.
- Преимущества Opus 5.5: 239/239 успешно сданных результатов, 99.6% соответствия спецификации и более частые самопроверки.
- Человеческие предпочтения: 1242 против 1203, доверительные интервалы пересекаются — статистически различить нельзя.
- Сигнал следующего поколения: внутренняя модель достигла 0.875 на BenchCAD 2.0 (у Astra — 0.594) и продемонстрировала способность к взаимодействию агентов в масштабе десяти тысяч; название, дата выпуска и результаты по видео не раскрыты.
- Настоящее узкое место: около 75% срывов сдачи результата связаны с управлением временем; фокус конкуренции смещается с качества генерации на исполнение и сдачу результата.
- Как проверять: фиксированные задачи, фиксированная среда, несколько раундов слепых тестов, расчёт стоимости на единицу видео — всё это можно повторно тестировать на уровне отдельных этапов через единый интерфейс на APIYI apiyi.com.
7.2 Конечная точка конкуренции — эффективность полного производственного цикла
Вернёмся к заголовку: GPT уже догнал Opus 5.5. Нынешняя Astra немного выигрывает по качеству и затратам, а Opus 5.5 сохраняет лидерство по надёжности сдачи результата. Внутренняя модель OpenAI показала более сильные универсальные возможности и потенциал выполнения задач силами многих агентов. У GPT следующего поколения есть шанс ещё повысить возможности видеопроизводства, а насколько именно — покажут независимая оценка после релиза и ваши собственные бизнес-тесты.
Дальше конкуренция будет идти вокруг эффективности полного производственного цикла: от понимания идеи до выпуска надёжного, точного и редактируемого видео — кто сумеет выполнить больше задач с меньшими затратами. Советую уже сейчас выстроить на APIYI apiyi.com собственную базовую линию для видеозадач: когда новая модель выйдет, можно будет сравнить сразу.
Справочные материалы
- Официальный сайт оценки VibeVideoBench: рейтинг видеоагентов и оценки качества
- Ссылка:
vibevideobench.github.io -
Описание: общий рейтинг и обзор методики оценки
-
Статья VibeVideoBench: методология, результаты по категориям, стоимость, предпочтения людей и причины неудач
- Ссылка:
arxiv.org/abs/2610.35864 -
Описание: основной источник табличных данных в этой статье, результаты по категориям см. в Appendix E.4
-
Анонс выпуска Anthropic Claude Opus 5.5: позиционирование модели и официальные кейсы
- Ссылка:
anthropic.com/claude-opus-5-5 -
Описание: официальное описание возможностей и изменения стоимости Opus 5.5
-
OpenAI: On the Navier–Stokes Millennium Prize Problem: внутренние модели и мультиагентные исследования
- Ссылка:
openai.com/index/navier-stokes-solution -
Описание: данные о 10 000 параллельных агентов, 88 часах исследований и т. д.
-
OpenAI: Accelerating engineering for the physical world: результаты внутренней модели на BenchCAD 2.0
- Ссылка:
openai.com/index/accelerating-engineering-for-the-physical-world -
Описание: сравнение внутренней модели 0.875 и GPT-6 Astra 0.594
-
OpenAI API Changelog и каталог моделей: проверка статуса выпусков
- Ссылки:
developers.openai.com/api/docs/changelog,developers.openai.com/api/docs/models -
Описание: запись о выпуске GPT-6 Cyber и текущие публичные флагманские модели
-
OpenAI API Deprecations: информация о прекращении поддержки Sora 2 и Videos API
- Ссылка:
developers.openai.com/api/docs/deprecations - Описание: текущее состояние направления нативной генерации видео
Автор: техническая команда APIYI
Обмен опытом: будем рады пообщаться на тему тестирования видеоагентов — свяжитесь с нами на главной странице APIYI apiyi.com, а дополнительные материалы по интеграции доступны в центре документации docs.apiyi.com