Resumo: A criação de vídeo com IA já se dividiu em duas rotas técnicas: geração nativa de vídeo e renderização de código via Agent. A primeira se destaca em cenas realistas e movimento natural; a segunda brilha em animação precisa, expressão de dados e produção de engenharia modificável. Entender a diferença entre as duas é o que permite montar um fluxo de produção de vídeo eficiente.
Conclusão antecipada: A geração nativa de vídeo e a renderização de código via Agent servem para tarefas diferentes. Personagens, sensação de filmagem real, movimento natural e linguagem de câmera ficam com modelos nativos de vídeo como Seedance, Kling e Veo; gráficos de dados, fórmulas, tutoriais de software, parâmetros de preço e conteúdo em lote baseado em templates ficam com a cadeia de renderização de código formada por Remotion, Manim e FFmpeg. Combinando os dois, você obtém ao mesmo tempo imagem natural e controle preciso — essa é a solução de produção mais prática hoje.
Prévia do conteúdo: O texto a seguir começa explicando a diferença fundamental nos mecanismos de saída das duas rotas, e depois detalha separadamente as capacidades e os custos dos modelos nativos de vídeo (Seedance 2.5, Kling 4.0, Veo 3.1) e do conjunto de ferramentas de renderização de código (Remotion, Manim, FFmpeg, Claude Motion, Codex). Em seguida, usa os dados de avaliação independente do VibeVideoBench para mostrar o nível real dos Agents na produção de vídeo. No final, apresenta um fluxo de produção híbrido tendo como exemplo um vídeo de divulgação de produto, mostrando qual trecho do trabalho cada modelo e ferramenta assume.
Para saber mais: glossário de termos das rotas tecnológicas de vídeo com IA
| Termo | Explicação |
|---|---|
| Text-to-Video | Gerar vídeo diretamente a partir de um comando de texto |
| Image-to-Video | Gerar um vídeo animado a partir de uma imagem de referência |
| Multimodal Reference | Orientar a geração usando, ao mesmo tempo, vários tipos de material, como imagem, vídeo e áudio |
| Keyframe | Quadro-chave, usado para definir o estado da imagem em um determinado momento |
| Timestamp-level Editing | Modificar com precisão um trecho específico do conteúdo, de acordo com o ponto no tempo do vídeo |
| Agent | Sistema de IA capaz de planejar tarefas por conta própria, chamar ferramentas, verificar resultados e fazer correções |
| Remotion | Ferramenta para produzir animações em vídeo com componentes React e código |
| Manim | Engine para produzir animações matemáticas e científicas com Python |
| FFmpeg | Ferramenta de linha de comando responsável por codificação de vídeo, síntese de áudio, edição e conversão de formato |
| ffprobe | Ferramenta de inspeção que vem junto com o FFmpeg, capaz de ler resolução, taxa de quadros, duração e faixas de áudio |
| TTS | Text-to-Speech (texto para fala), usado para gerar narração automaticamente |
| Deterministic Rendering | Renderização determinística: o mesmo código e os mesmos parâmetros produzem a mesma imagem em todas as execuções |
| Claude Motion | Recurso da Anthropic que empacota animações orientadas por código em um produto; atualmente em Beta |
| Cache Hit | Taxa de acerto de cache: contextos repetidos são lidos diretamente do cache, o que reduz bastante o custo de Tokens |
1 As duas rotas técnicas do vídeo com IA: mecanismos de saída completamente diferentes
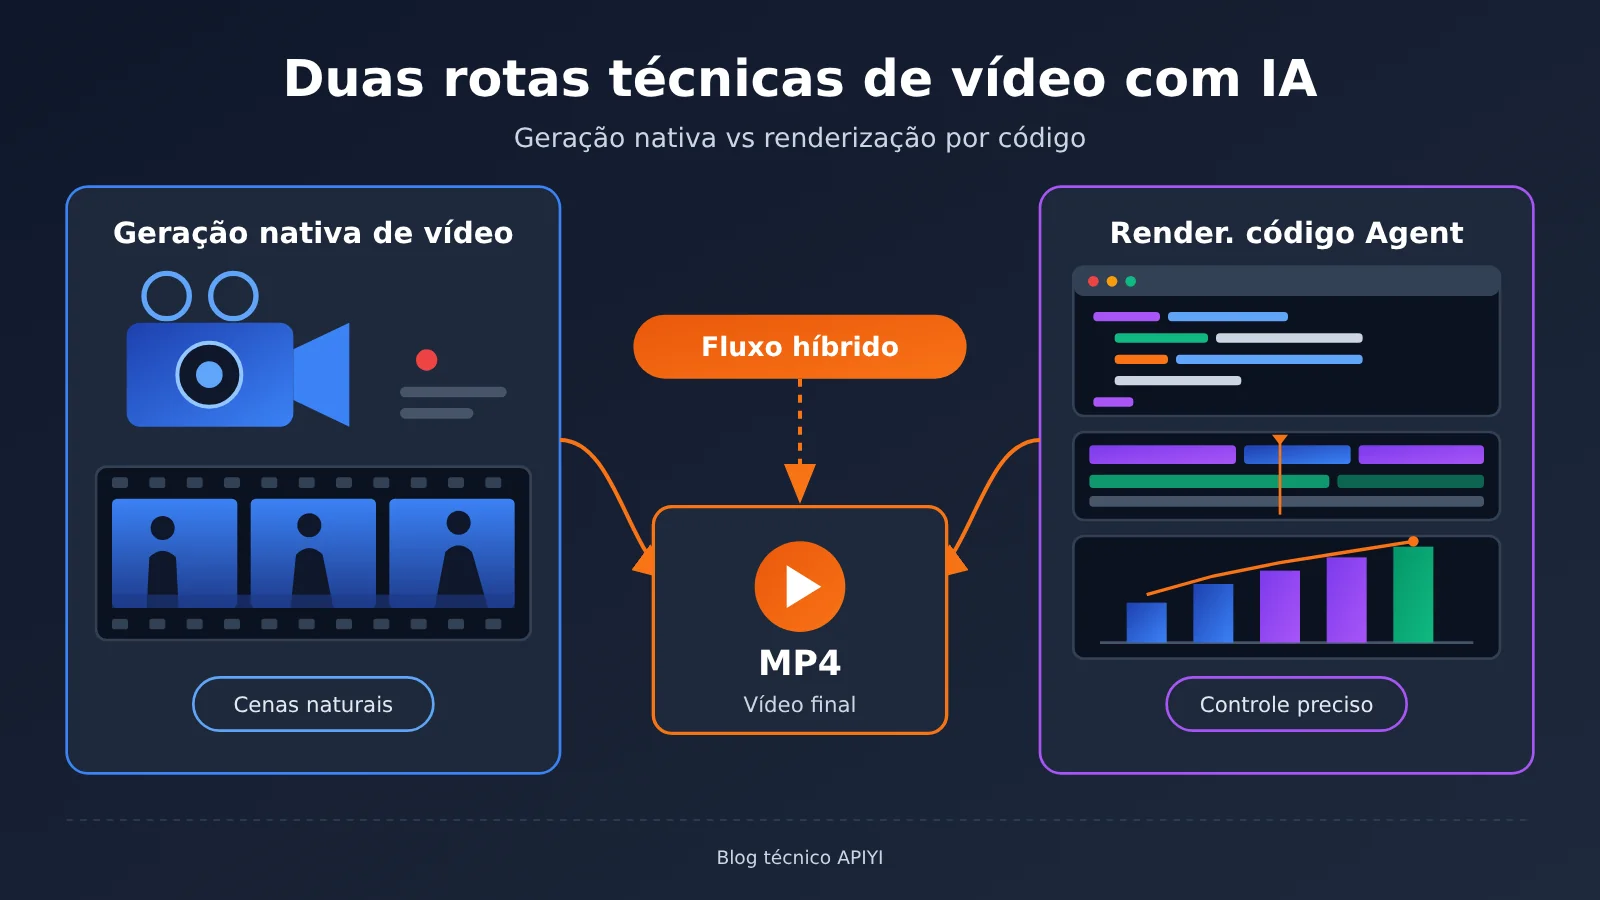
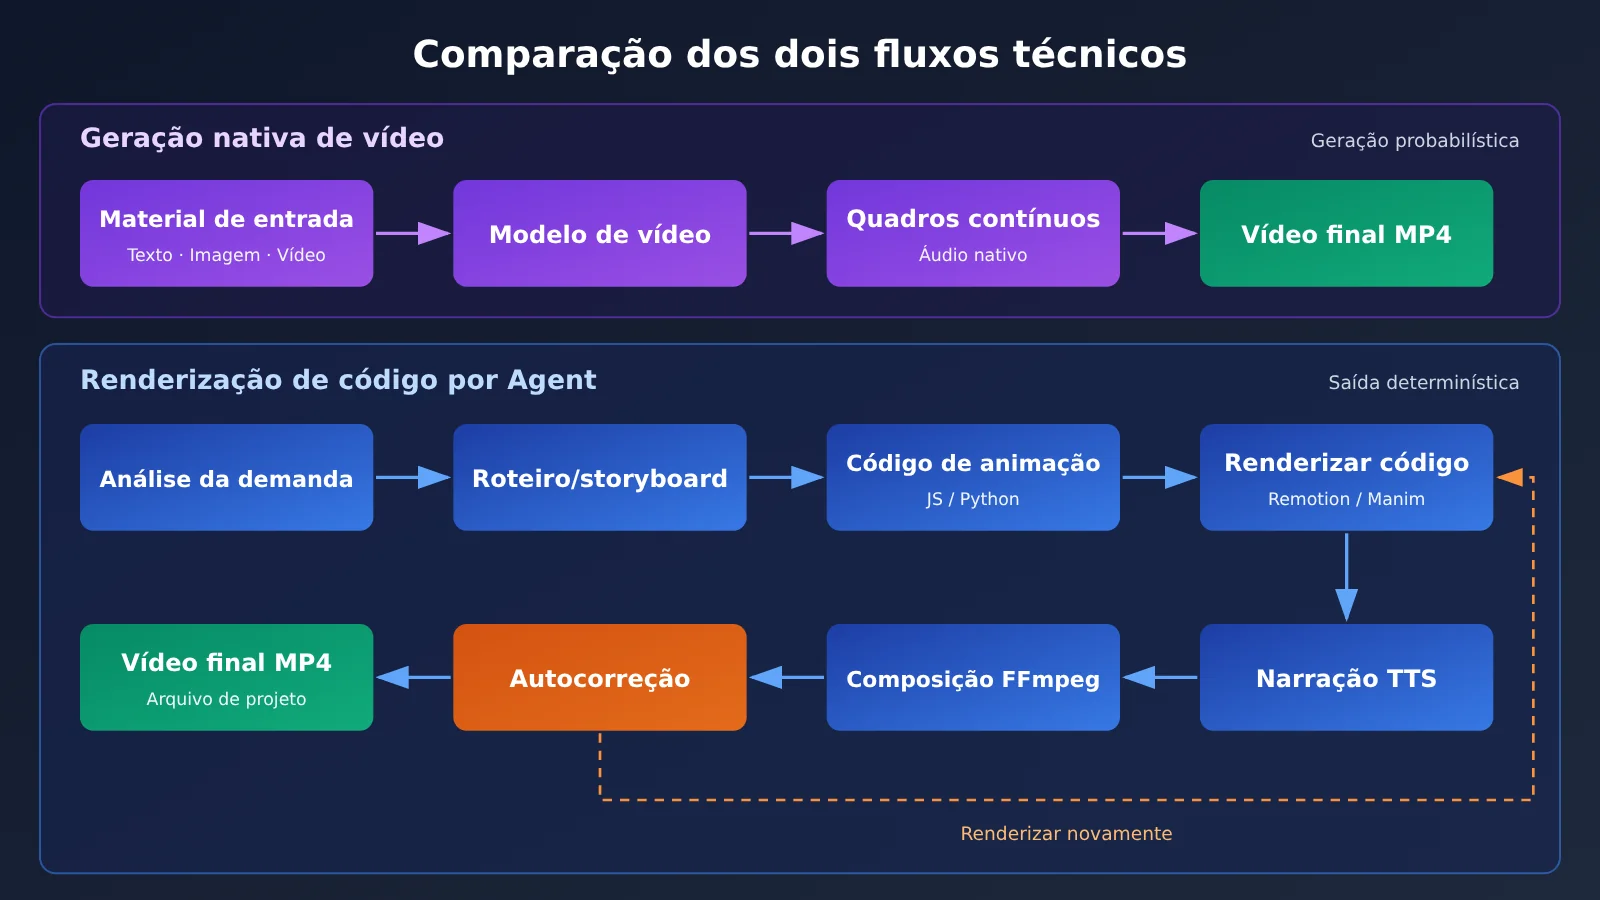
As duas rotas são capazes de entregar um MP4, mas a forma como produzem os quadros é totalmente diferente. Na geração de vídeo nativa, o modelo “desenha” diretamente cada quadro; na renderização por código de agente, o modelo escreve um programa de produção de vídeo e o motor de renderização gera as imagens seguindo esse programa. Essa diferença determina todas as distinções entre as duas abordagens em precisão de controle, capacidade de modificação e custo.
1.1 Geração de vídeo nativa: o modelo cria imagens contínuas diretamente
A geração de vídeo nativa tem como base Text-to-Video e Image-to-Video. O usuário fornece uma descrição em texto ou uma imagem de referência, e o modelo gera diretamente quadros de vídeo contínuos: personagens, objetos, ambiente, movimentos contínuos e movimento físico são todos gerados de uma só vez pelo modelo. Movimentos de câmera (zoom, dolly), mudanças de enquadramento e trocas de cena também podem ser escritos no comando.
A nova geração de modelos já consegue gerar áudio nativo em sincronia e permite controlar a aparência dos personagens, o cenário e o estilo visual com várias imagens de referência e vídeos de referência. A vantagem está na naturalidade das imagens e no forte senso de realismo; o preço é que cada quadro vem de uma geração probabilística — o mesmo comando gera resultados diferentes em duas execuções, e alterações precisas ao nível do pixel dependem de nova geração ou de funções de edição específicas.
1.2 Renderização por código de agente: a IA escreve seu próprio programa de produção de vídeo
A renderização por código de agente faz com que o Modelo de Linguagem Grande atue ao mesmo tempo como diretor e programador. Um fluxo completo geralmente inclui:
- Entender a demanda e definir tema, público e estilo visual;
- Escrever o roteiro, a narração, o storyboard e a linha do tempo;
- Escrever o código de animação em JavaScript ou Python (Remotion, Manim, Three.js, Cairo, Blender etc.);
- Chamar o TTS para gerar a narração e produzir música e efeitos sonoros;
- Chamar o FFmpeg para compor áudio e imagem;
- Verificar imagem, áudio e sincronização temporal, corrigir os problemas encontrados e renderizar novamente;
- Exportar o MP4 finalizado e os arquivos de projeto reutilizáveis.
A saída dessa rota é determinística: se o código e os parâmetros não mudam, o resultado da renderização também não muda. Para alterar um número, uma linha de legenda ou um esquema de cores, basta mexer no código e renderizar de novo, mantendo o restante dos quadros intacto. Ela se destaca em visualização de dados, apresentações de produto, divulgação de conhecimento e infográficos animados; já para gerar pessoas reais e imagens de filmagem real, é preciso depender de material pronto ou de ativos 3D.
2 Rota de geração nativa de vídeo: para quais tarefas é adequada
Os modelos nativos de vídeo de 2026 já elevaram a duração de geração única para 30 segundos, e o foco da competição migrou para referências multimodais, controle de quadros-chave e edição contínua após a geração. A tabela abaixo resume as capacidades públicas de três modelos representativos.
| Capacidade | Seedance 2.5 | Kling 4.0 | Veo 3.1 |
|---|---|---|---|
| Data de lançamento/disponibilização | Lançado em 2026-07-31 | API totalmente aberta em 2026-10-28 | Presente na documentação da Gemini API |
| Duração por geração única | Até 30 segundos | Até 30 segundos | Suporta extensão de vídeo |
| Material de referência | 30 imagens, 10 vídeos, 10 áudios | 10 imagens, 5 vídeos, até 15 itens combinados | Geração guiada por imagem |
| Método de controle principal | Extensão em múltiplas rodadas, edição por carimbo de tempo, edição de chroma key e ângulo de câmera | Até 10 quadros-chave, referência de voz | Controle de quadro final, extensão de vídeo |
| Áudio | Suporta referência de áudio | Suporta referência de voz | Geração nativa de áudio |
| Forma de cobrança | Por resolução e duração (incluindo consumo de Token) | Por Unit/segundo | Por especificação de geração |
2.1 Seedance 2.5: geração contínua de 30 segundos e referência multimodal
O Seedance 2.5 foi lançado pela equipe Seed da ByteDance em 31 de julho de 2026, com geração de até 30 segundos por vez, podendo incluir várias tomadas contínuas em uma única geração. Sua capacidade de referência é a mais ampla entre os parâmetros públicos atuais: até 30 imagens de referência, 10 vídeos de referência e 10 áudios de referência, permitindo entregar ao modelo, de uma só vez, o design do personagem, fotos de cenário, referências de movimento e trilha sonora para organizar cenas complexas.
No nível de edição, o Seedance 2.5 permite estender um vídeo existente em várias rodadas mantendo ao máximo a consistência de personagens, cenários e som, permite alterar ações e enredo dos personagens em pontos de tempo especificados, e também oferece edição em tela verde, edição de ângulo de câmera e consistência entre múltiplos personagens. Ele ainda pode usar referências de Clay Render (renderização em argila) para controlar a estrutura espacial, o posicionamento dos personagens e o movimento de câmera. Os exemplos oficiais cobrem performances de personagens da ópera de Pequim, apresentações de palco, interação entre múltiplos personagens e transições de cenas contínuas — justamente o tipo de conteúdo com vários personagens, planos longos e narrativa contínua que a renderização por código tem mais dificuldade de realizar.
2.2 Kling 4.0: keyframes e controle por referência de vídeo
O Kling 4.0 abriu totalmente a API em 28 de outubro de 2026, com geração de até 30 segundos por vez, suporte a 720p e 1080p, e proporções de imagem incluindo 21:9 e proporção adaptativa. Seu diferencial são até 10 keyframes: o criador pode travar vários estados de imagem na linha do tempo e deixar o modelo preencher o movimento entre os keyframes, tornando a trajetória da câmera e a pose dos personagens mais controláveis.
Quanto aos materiais de referência, o Kling 4.0 aceita até 10 imagens de referência e 5 vídeos de referência, com no máximo 15 itens em uma única entrada mista, além de oferecer referência multimodal Omni e referência de voz. Ele integra texto para vídeo, imagem para vídeo, materiais de referência e edição de vídeo em um só lugar, sendo adequado para projetos que exigem imagem de personagem estável, caminho de câmera definido ou uma segunda edição sobre um vídeo já existente.
2.3 Veo 3.1: áudio nativo e extensão de vídeo
O Google oferece dois tipos de produto de geração de vídeo na Gemini API. O Veo 3.1 prioriza geração de áudio nativo, extensão de vídeo, controle do último quadro e geração guiada por imagem, sendo adequado para produzir de uma só vez um clipe com “imagem sonora”; o Gemini Omni Flash prioriza entrada multimodal, consistência de personagem, compreensão de vídeo e edição conversacional em múltiplas rodadas. Os dois representam duas direções no campo do vídeo nativo: gerar clipes de alta qualidade e, após a geração, continuar editando, modificando e estendendo o conteúdo.
Do lado da OpenAI, o produto Sora foi descontinuado em 26 de abril de 2026, e o modelo Sora 2 e a Videos API foram encerrados em 24 de setembro de 2026, com o anúncio oficial de depreciação indicando que não há API substituta um-para-um. O Images 2.6, lançado pela OpenAI em 4 de novembro de 2026, suporta saída de animação GIF de 2 a 16 quadros, adequado para emoticons dinâmicos, loops de movimento de personagem e pré-visualização de storyboard, o que pertence a um fluxo de trabalho diferente da produção completa de vídeo MP4.
2.4 Vantagens e custos da geração nativa de vídeo
As principais vantagens da geração nativa de vídeo se concentram em quatro aspectos: movimentos naturais de personagens, movimento físico verossímil, movimento de câmera cinematográfico e expressão criativa aberta. Essas capacidades, quando implementadas por código, exigem muitos ativos de animação e ajustes manuais; com um modelo de vídeo, podem ser geradas de uma só vez.
Em termos de custo, o vídeo nativo é cobrado pela especificação de saída e pela duração. Tomando como exemplo o preço oficial do Seedance 2.5 atualizado pela BytePlus ModelArk em 13 de novembro de 2026:
| Especificação de saída | Preço de referência para vídeo de 5 segundos | Estimativa por segundo |
|---|---|---|
| 480p | $0.514 | $0.103 |
| 720p | $1.156 | $0.231 |
| 1080p | $2.843 | $0.569 |
De 720p para 1080p, o custo por segundo aumenta cerca de 2,5 vezes. A tabela acima é uma estimativa para especificações típicas oficiais; a duração, a resolução, a taxa de quadros do vídeo de entrada e o consumo real de Token afetam a fatura final. Já o Kling 4.0 cobra por Unit da plataforma: 720p custa 1 Unit/segundo, 1080p custa 1.5 Units/segundo, e o Kling 4.0 Flash em 720p custa 0.6 Units/segundo; quando há vídeo de entrada, o custo também é afetado pela duração da entrada. Unit é a unidade de cobrança da plataforma e precisa ser convertida em valor real conforme as regras da plataforma.
Vale observar que esses preços correspondem ao custo de “uma geração”. O vídeo nativo tem aleatoriedade, e na produção real muitas vezes é preciso gerar várias vezes e depois escolher; o custo final por take utilizável costuma ser maior que o preço de uma única geração.
3 A rota de renderização por código do Agent: transformando a IA em engenheira de produção de vídeo
O núcleo da rota de renderização por código é um conjunto de ferramentas maduras, sejam de código aberto ou comerciais, e o Modelo de Linguagem Grande fica responsável por traduzir a necessidade em código que essas ferramentas conseguem executar, além de cuidar da orquestração, verificação e correção.
3.1 Remotion: animação em React e produção automatizada de vídeo
O Remotion descreve a cena com componentes React, controlando posição, tamanho, transparência e movimento dos elementos pelo número do frame. Desenvolvedores podem usar React, HTML, CSS e JavaScript diretamente para criar animações, combinando numa mesma cena textos, gráficos, imagens, vídeos e áudio, com controle preciso de cada frame. Ele suporta renderização em lote via CLI, renderização no servidor e renderização em nuvem no Lambda, e também permite gerar, em lote, vídeos com conteúdos diferentes passando parâmetros distintos.
O fluxo oficial de renderização é bem enxuto:
# Instalar o Remotion
npm install remotion @remotion/cli

# Renderizar a composição de vídeo especificada (Composition) e gerar um MP4
npx remotion render HelloWorld out.mp4
No quesito licenciamento, o Remotion é gratuito para pessoas físicas e pequenas empresas com até 3 pessoas, podendo ser usado comercialmente desde que os termos sejam cumpridos; o plano Automators cobra $0.01 por renderização, com consumo mínimo mensal de $100; o plano Creators é $25 por assento/mês; o plano Enterprise começa em $500/mês (atualizado em 14 de novembro de 2026). A taxa de licença de renderização do Remotion e o custo de Tokens consumidos pelo modelo de IA ao escrever código são duas despesas independentes e precisam ser calculadas separadamente.
3.2 Manim: animações matemáticas e científicas de precisão
O Manim é um motor de animação em Python, feito sob medida para demonstrar fórmulas matemáticas, transformações de formas geométricas, processos de movimento em física, o funcionamento de algoritmos e a explicação de experimentos científicos. Fórmulas, eixos coordenados, estruturas geométricas e as relações de movimento entre objetos são todos definidos por código, então a posição de cada símbolo e de cada curva é precisa e controlável. Modelos de vídeo nativos costumam gerar fórmulas com erros de caractere ou de estrutura — e é justamente aí que o Manim brilha.
O exemplo oficial de início rápido gera um MP4 com um único comando:
manim -pql main.py CreateCircle
3.3 FFmpeg: transformando todo tipo de material no vídeo final
O FFmpeg é a “linha de montagem final” de toda a cadeia de renderização por código. Ele cuida da codificação e transcodificação de vídeo, da junção de áudio, da concatenação de múltiplos trechos, da gravação de legendas, do corte e redimensionamento, da conversão de taxa de quadros e da conversão de formato. O ffprobe, que vem junto, lê a resolução, a taxa de quadros, a duração e as informações das faixas de áudio do vídeo pronto — e o Agent usa isso para a validação automática: se a especificação não estiver dentro do esperado, volta à etapa anterior para corrigir.
# Concatena os trechos (o list.txt lista os arquivos de cada trecho, uma linha por arquivo)
ffmpeg -f concat -safe 0 -i list.txt -c copy merged.mp4

# Junta a narração e grava as legendas
ffmpeg -i merged.mp4 -i voice.mp3 -vf subtitles=subs.srt \
  -map 0:v -map 1:a -c:v libx264 -c:a aac final.mp4

# Verifica as especificações da saída
ffprobe -v error -show_entries stream=codec_type,width,height,r_frame_rate \
  -show_entries format=duration final.mp4
3.4 Claude Motion: animações em código viram uma funcionalidade comum de produto
A Anthropic lançou o Claude Motion Beta em 8 de outubro de 2026, entregando animações movidas a código diretamente para usuários corporativos. O usuário descreve em linguagem natural o que precisa animar, e o Claude organiza texto, gráficos, formas e imagens em uma animação em código, salvando tudo nos Artifacts; a partir daí é possível continuar ajustando por meio de conversa, entrar no editor para fazer ajustes manuais e, por fim, exportar em MP4.
Os usos típicos incluem: transformar o relatório financeiro trimestral em uma animação explicativa de 30 segundos, montar o plano de preços como um gráfico comparativo dinâmico, converter os passos de operação do produto em uma animação de tutorial e transformar materiais de reunião em vídeos de divulgação interna. Sobre as condições de uso: o Beta está aberto para usuários Team e Enterprise, sendo habilitado por padrão no Team, enquanto no Enterprise precisa ser ativado pelo administrador da organização, com o consumo contabilizado na cota do plano. O Claude Motion não chama modelos nativos de geração de vídeo, então não consegue produzir pessoas reais nem tomadas contínuas em estilo de filmagem real.
O valor de produto do Claude Motion está justamente na barreira de entrada: pessoas de operações, finanças e marketing dentro das empresas não precisam montar um projeto Remotion para obter diretamente a precisão e a facilidade de edição das animações em código.
3.5 GPT + Codex: Agente chamando ferramentas para concluir a produção de vídeos
Outra forma é deixar um modelo generalista chamar ferramentas de forma autônoma em um ambiente de desenvolvimento de Agente. O VibeVideoBench, lançado em 26 de outubro de 2026, avalia especificamente essa capacidade: são 239 tarefas reais de produção de vídeo, cobrindo 12 categorias de conteúdo como narrativas de dados, cursos educacionais, leitura de artigos, marketing de marca e demonstração de funcionalidades de produto. Cada tarefa exige que a IA entregue de forma autônoma, dentro de um sandbox e em 60 minutos, um MP4 reproduzível, um projeto de engenharia capaz de regerar o vídeo, além do cronograma e das notas de produção. 9 sistemas de agentes somaram 2.151 execuções, todas rodando em seus respectivos ambientes nativos de desenvolvimento e na maior intensidade de raciocínio disponível, sem permissão para inserir instruções humanas no meio do caminho.
A comparação entre os dois sistemas mais bem colocados é a seguinte (média de três júris, notas de 1 a 5):
| Métrica | GPT-6 Astra (Codex CLI) | Claude Opus 5.5 (Claude Code) |
|---|---|---|
| Entrega de vídeo bem-sucedida | 238/239 (99.6%) | 239/239 (100%) |
| Taxa de conformidade com especificações | 93.7% | 99.6% |
| Taxa de aprovação nos requisitos da tarefa | 97.1% | 97.3% |
| Nota de qualidade geral | 4.109 | 4.074 |
| Taxa de sucesso em tarefas estritas | 74.5% | 76.3% |
| Elo de preferência humana | 1242 | 1203 |
| Custo médio por tarefa | $8.19 | $15.38 |
| Custo mediano / P90 por tarefa | $7.88 / $11.88 | $10.19 / $31.22 |
| Média de tokens de saída | 61K | 130.7K |
| Cache Hit | 97% | 65% |
Nesse conjunto de testes, o GPT-6 Astra ficou um pouco à frente em qualidade geral e preferência humana, com custo médio por tarefa cerca de 46.7% menor; já o Claude Opus 5.5 entregou todas as 239 tarefas, com taxas de conformidade com especificações e de sucesso em tarefas estritas mais altas. A principal fonte da diferença de custo é a eficiência no uso de tokens: o Astra produz cerca de 53.3% menos tokens de saída e tem taxa de acerto de cache de 97%, enquanto no Opus cerca de 76% do custo por tarefa vem de Cache Write. Apesar de o preço unitário padrão de entrada e saída do Astra ser 2.5 vezes o do Opus, o gasto real para concluir uma única tarefa acaba sendo menor.
Para interpretar esses dados é preciso levar em conta os critérios do benchmark: o objeto avaliado é um sistema de agente completo, formado por “modelo + ambiente de execução”, e o Codex CLI e o Claude Code usados por GPT e Claude já são diferentes entre si; cada tarefa é executada apenas uma vez, com limite de 60 minutos; a correlação de ranking entre os três júris é de 0.933–0.950, e a correlação com o ranking Elo humano é de 0.98, mas a concordância entre a preferência humana por um vídeo individual e o resultado do júri é de 73.3%. Ou seja, essas notas servem para avaliar o nível aproximado de um sistema, não para generalizar a todas as tarefas de vídeo, e também não substituem a avaliação de modelos nativos de texto para vídeo (Text-to-Video).
O VibeVideoBench também revela o principal gargalo dos Agentes que fazem vídeo: das 2.151 execuções, 224 não entregaram um vídeo reproduzível, e 169 dessas foram problemas de gestão de tempo — incluindo renderização final iniciada tarde demais, execução lenta demais ou simplesmente nunca iniciada —, o que representa cerca de 75% dos casos de falha. A dificuldade dos Agentes de vídeo já deixou de ser “saber ou não escrever código de animação” e passou a ser o agendamento da renderização e a gestão da entrega.
Em comparação com o Claude Motion, ambientes de Agente como Codex e Claude Code são voltados para desenvolvedores: dá para combinar livremente Remotion, Manim, FFmpeg, TTS e gravação de tela, gerando arquivos completos de projeto, o que os torna adequados para integração em linhas de produção automatizadas. Já o Claude Motion é voltado para usuários finais corporativos, tem interação mais simples e seus limites de capacidade se concentram em animações de texto, gráficos e formas.
4 Como escolher entre geração nativa de vídeo e renderização de código por Agent
4.1 Tarefas adequadas para geração nativa de vídeo
- Estilo de filmagem real de pessoas: pessoas reais em cena, com expressões e movimentos corporais;
- Cenários de uso do produto: cenas do produto sendo utilizado em um ambiente real;
- Movimento natural e linguagem de câmera: zoom in e out, panorâmica, plano de acompanhamento, mudança de enquadramento;
- Anúncios com estética cinematográfica: filmes de marca que priorizam iluminação, atmosfera e textura;
- Atuação de personagens e enredo contínuo: interação entre vários personagens, narrativa em plano-sequência;
- Ambientes naturais complexos: cenas difíceis de modelar, como clima, fluxo de água e ruas da cidade.
4.2 Tarefas adequadas para produção orientada por código
- Gráficos de dados precisos: números, coordenadas e proporções devem ser exatos;
- Tutoriais de operação de software: gravação de tela da interface com anotações, destaques e descrição dos passos;
- Explicações matemáticas e científicas: dedução de fórmulas, transformações geométricas, demonstração de algoritmos;
- Infográficos dinâmicos: apresentação passo a passo de informações estruturadas;
- Comparação de parâmetros de produtos e explicação de preços: cada valor pode ser conferido e modificado;
- Conteúdo em lote a partir de templates: substituir dados em um mesmo template para gerar centenas de vídeos em lote.
A tabela abaixo resume o grau de adequação das duas rotas nas tarefas mais comuns:
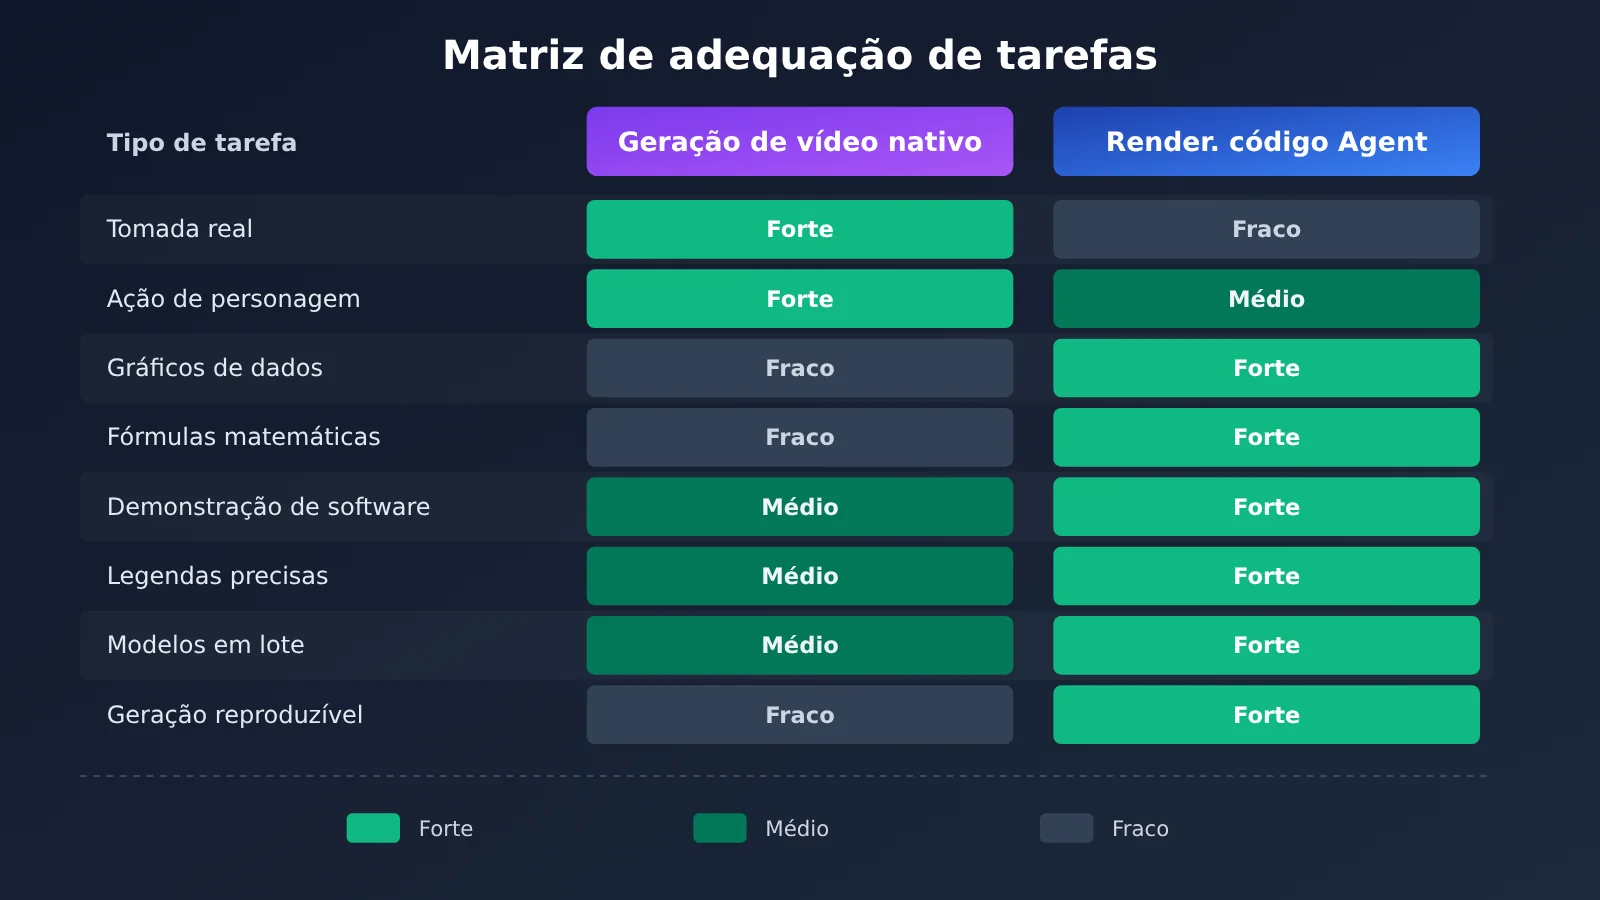
| Tarefa | Geração nativa de vídeo | Renderização por código do Agent |
|---|---|---|
| Tomadas de imagem real com estética cinematográfica | Forte | Requer material existente ou ativos 3D |
| Ações naturais de personagens | Forte | Depende de ativos de animação |
| Movimentos complexos de câmera | Forte | Pode ser programado com precisão |
| Exibição precisa de dados | Difícil de garantir | Forte |
| Animação de fórmulas matemáticas | Propensa a erros | Forte |
| Demonstração de interface de software | Requer referência e pós-processamento | Forte |
| Legendas precisas | Requer revisão na pós-produção | Forte |
| Demonstração dinâmica de produtos | Forte | Forte |
| Produção em lote com template unificado | Requer múltiplas gerações e triagem | Forte |
| Modificação precisa de um único detalhe | Depende de nova geração ou edição | Forte |
| Geração repetível da mesma animação | Afetada pela aleatoriedade | Forte |
O estudo do VibeVideoBench também aponta que a renderização por código é especialmente adequada para tarefas como fórmulas precisas, gráficos de dados, cenas de jogos com regras consistentes e narração sincronizada.
💡 Sugestão de escolha: o critério pode ser resumido em uma frase — se a imagem precisa “parecer real”, use o modelo de geração nativa de vídeo; se a informação precisa ser “exata e sem erros”, use renderização por código. O roteiro, o storyboard e o código de animação da cadeia de renderização por código dependem todos de Modelos de Linguagem Grande de uso geral. Recomendamos primeiro testar o desempenho de GPT, Claude e Gemini nas suas tarefas de roteiro e código usando a mesma chave API por meio do APIYI apiyi.com, e só então decidir qual será o modelo principal.
4.3 Estrutura de custos das duas abordagens
A composição de custos das duas abordagens é bem diferente, e comparar diretamente o preço unitário tem significado limitado:
- Geração de vídeo nativa: a cobrança é feita principalmente por resolução de saída e duração, somando-se o consumo extra trazido pela entrada de vídeo de referência; a geração e a seleção repetidas causadas pela aleatoriedade são um custo oculto.
- Renderização de código por Agent: inclui os custos de Token do modelo generalista (entrada, saída, leitura e escrita de cache), poder computacional para execução e renderização de código, licenças de ferramentas (como a licença comercial do Remotion) e custos de TTS e de materiais de música e efeitos sonoros.
Na comparação, deve-se tomar como base o “custo total do vídeo final entregável”: se uma tomada de vídeo nativa precisa ser gerada cinco vezes para se escolher um resultado utilizável, seu custo real é cinco vezes o valor cotado; uma tarefa de Agent, se tiver taxa de acerto de cache baixa e re-renderizações repetidas, também verá os custos de Token subirem rapidamente. Os dados do VibeVideoBench mostram que um modelo com preço unitário mais alto pode alcançar um custo de tarefa menor devido a menos Tokens de saída e maior taxa de acerto de cache; na seleção de modelo, é preciso olhar o gasto real por tarefa medido.
💰 Otimização de custos: na cadeia de renderização de código, os custos de modelo têm participação elevada e são majoritariamente de contexto longo e múltiplas rodadas de invocação. Invocando múltiplos modelos mainstream por consumo via APIYI apiyi.com, é possível usar o mesmo conjunto de código para comparar o gasto real de diferentes modelos na conclusão da mesma tarefa de vídeo, e então alocar modelos conforme o tipo de tarefa.
5 A solução mais eficaz: combinar as duas rotas de tecnologia de vídeo com IA
5.1 Fluxo de produção híbrido
Combinar as duas rotas — deixando os modelos nativos de vídeo responsáveis pelas imagens naturais e a renderização por código responsável pela expressão precisa — é hoje a abordagem mais viável na prática:
- Criação e storyboard: GPT ou Claude cuida da ideia, do roteiro e do storyboard, e marca para cada plano qual será o método de produção;
- Planos naturais: Seedance, Kling ou Veo geram tomadas de pessoas, cenários e uso de produtos;
- Imagens precisas: Remotion cuida de gráficos de dados, legendas, elementos de marca e animações de parâmetros do produto;
- Narração: o TTS gera a narração a partir do roteiro;
- Composição: o FFmpeg junta os planos, mescla as faixas de áudio e grava as legendas no vídeo;
- Validação e correção: o agente de IA usa o ffprobe para verificar as especificações, além de checar a sincronia entre áudio e imagem e as legendas; ao encontrar problemas, volta à etapa correspondente para corrigir.
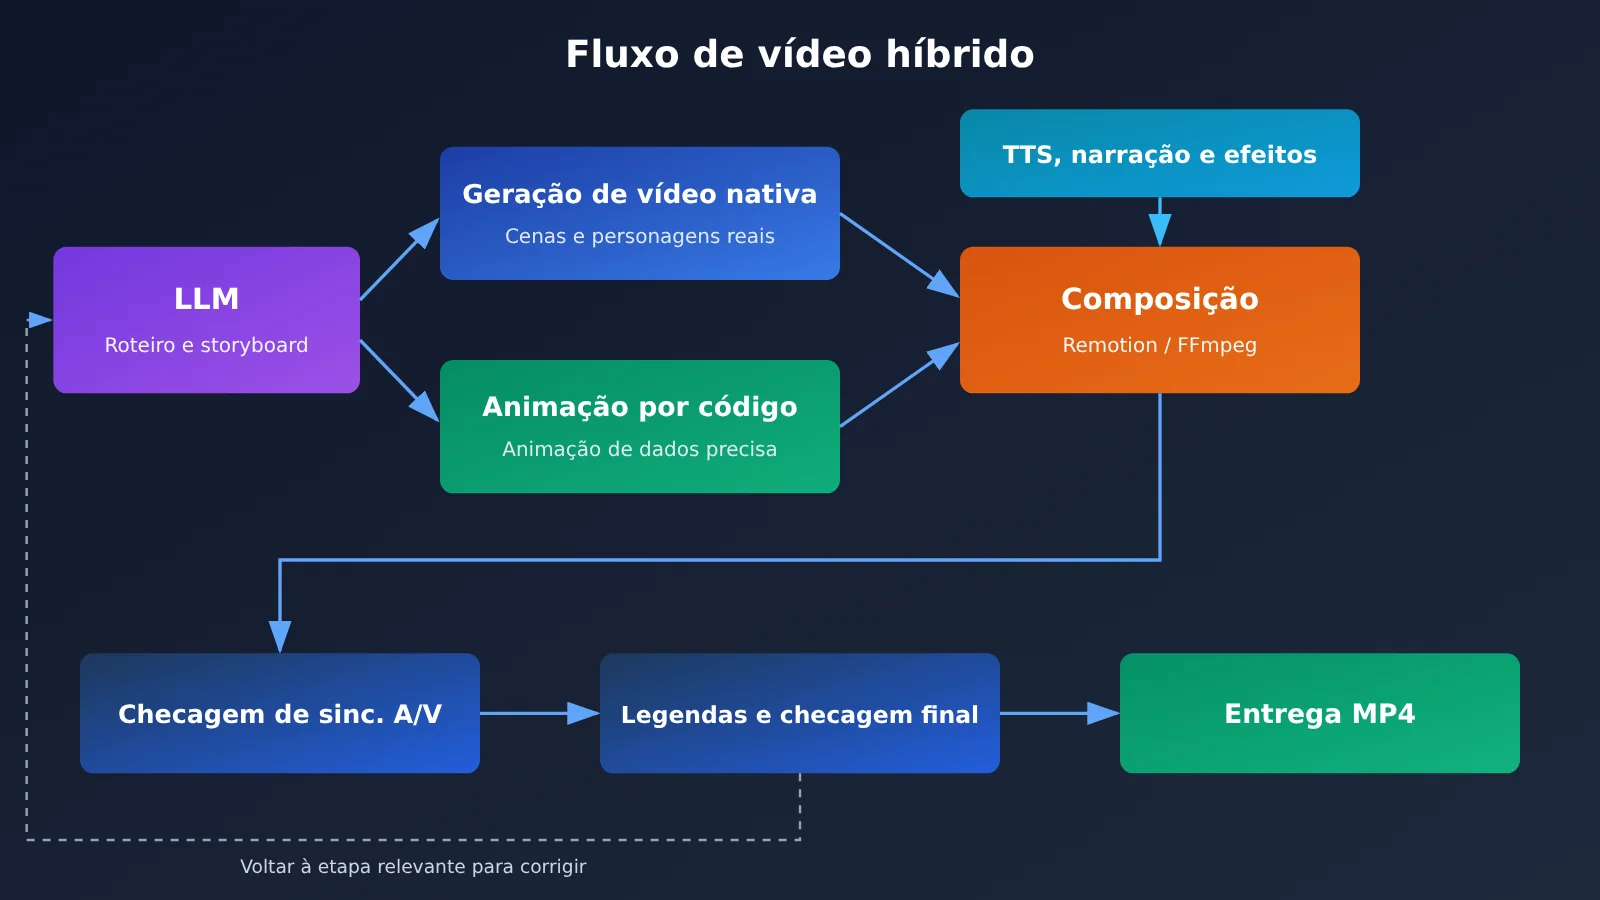
Na figura acima, as duas etapas — roteiro/storyboard e verificação do vídeo final — são ambas realizadas pelo Modelo de Linguagem Grande de uso geral, e essa parte das chamadas pode ser unificada via APIYI apiyi.com, alternando entre GPT, Claude e Gemini por meio de uma única interface compatível com OpenAI.
5.2 Exemplo prático: a divisão de trabalho em um vídeo promocional de produto
Tomemos como exemplo um vídeo promocional de um aplicativo móvel. As partes podem ser divididas assim:
- Cenas de abertura e ambientação (usuários usando o produto no deslocamento e no escritório): entregue ao Seedance 2.5 ou ao Kling 4.0. Use fotos do produto e imagens de definição de personagem como referência para garantir que a aparência das pessoas e do produto permaneça consistente; o Kling 4.0 permite travar a composição da abertura e do encerramento com keyframes. Segundo a estimativa oficial do Seedance 2.5, 720p custa cerca de US$ 0,231 por segundo; ao planejar o orçamento, reserve margem para várias gerações.
- Segmento de demonstração de funcionalidades: grave a interface real do aplicativo e, em seguida, use o Remotion para sobrepor caixas de destaque, numeração de etapas e anotações dinâmicas. O conteúdo da interface vem de uma gravação real de tela, então não aparecem botões “inventados” pelo modelo.
- Segmento de recursos e preços: use componentes do Remotion para renderizar tabelas comparativas de funcionalidades e cartões de preço. Quando os preços mudarem, basta alterar o arquivo de dados e renderizar novamente; as demais cenas permanecem inalteradas.
- Narração e legendas: o Modelo de Linguagem Grande escreve o roteiro de narração, o TTS gera o áudio e, ao mesmo tempo, exporta o arquivo de legendas SRT.
- Montagem final e validação: o FFmpeg junta todos os clipes e sintetiza a faixa de áudio; o Agent usa o ffprobe para conferir duração, resolução e faixa de áudio, e depois verifica trecho por trecho se as legendas estão sincronizadas com a narração.
O resultado dessa divisão é: as cenas realistas ficam garantidas pelo modelo de vídeo, e todas as informações verificáveis ficam garantidas pelo código. Nas revisões futuras, basta renderizar novamente os trechos correspondentes.
5.3 Gerar um storyboard com marcação de roteamento usando a API
O primeiro passo do fluxo híbrido é fazer o Modelo de Linguagem Grande gerar um storyboard estruturado e indicar, para cada plano, qual caminho seguir. O exemplo abaixo usa a interface compatível com OpenAI para realizar essa etapa:
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI
)

MODEL = "your-model-name"  # Substitua pelo nome real do modelo na lista de modelos da plataforma

prompt = """为一款记账 App 写 30 秒宣传片分镜,输出 JSON 数组。
每个镜头包含 id、duration、description、route 字段。
route 只能是 native(真实人物与场景,交给视频模型)
或 code(数据、参数、字幕、界面标注,交给 Remotion 渲染)。"""

resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": prompt}],
)
print(resp.choices[0].message.content)
Ver implementação completa: roteamento do storyboard + geração de parâmetros de renderização do Remotion
import json
import subprocess
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

PLANNER_MODEL = "your-planner-model"  # Modelo responsável pela criatividade e pelo storyboard
CODER_MODEL = "your-coder-model"      # Modelo responsável por gerar parâmetros de renderização/código


def plan_storyboard(brief: str) -> list[dict]:
    """Faz o modelo gerar um storyboard em JSON com anotações de route."""
    resp = client.chat.completions.create(
        model=PLANNER_MODEL,
        messages=[
            {"role": "system", "content": "你是视频导演,只输出合法 JSON 数组。"},
            {"role": "user", "content": brief},
        ],
    )
    return json.loads(resp.choices[0].message.content)


def build_remotion_props(shot: dict) -> dict:
    """Gera os parâmetros do componente Remotion para um plano da rota code."""
    resp = client.chat.completions.create(
        model=CODER_MODEL,
        messages=[
            {"role": "system", "content": "把镜头描述转换为 Remotion 组件 props,只输出 JSON 对象。"},
            {"role": "user", "content": json.dumps(shot, ensure_ascii=False)},
        ],
    )
    return json.loads(resp.choices[0].message.content)


def render_code_shot(shot_id: str, props: dict) -> str:
    """Chama a CLI do Remotion para renderizar um único plano."""
    out = f"out/{shot_id}.mp4"
    subprocess.run(
        ["npx", "remotion", "render", "InfoCard", out,
         f"--props={json.dumps(props, ensure_ascii=False)}"],
        check=True,
    )
    return out


if __name__ == "__main__":
    shots = plan_storyboard("为一款记账 App 写 30 秒宣传片分镜,"
                            "字段:id、duration、description、route(native/code)。")
    for shot in shots:
        if shot["route"] == "code":
            path = render_code_shot(shot["id"], build_remotion_props(shot))
            print("已渲染:", path)
        else:
            # Planos native vão para o modelo de geração de vídeo; aqui registramos o prompt para geração posterior
            print("待原生生成:", shot["id"], shot["description"])
🚀 Início rápido: as etapas de geração do storyboard e dos parâmetros acima precisam apenas de um Modelo de Linguagem Grande de uso geral. Recomendamos registrar-se em APIYI apiyi.com e usar a cota de teste gratuita para novos usuários: primeiro execute dois ou três modelos com a mesma solicitação de vídeo promocional, compare a qualidade do storyboard e o consumo de Tokens, e depois fixe no fluxo de produção.
6 Conclusão: a competição em vídeo com IA está centrada no fluxo completo de produção
A relação entre as duas rotas tecnológicas e as tarefas já está bem clara: a geração nativa de vídeo é responsável por imagens realistas, atuação de personagens e linguagem cinematográfica — Seedance 2.5, Kling 4.0 e Veo 3.1 têm ênfases distintas em geração contínua de 30 segundos, referência multimodal, keyframes e edição contínua. A renderização via código por Agent cuida de informações precisas, renderização repetível e produção em lote — Remotion, Manim e FFmpeg formam a base de ferramentas, o Claude Motion a transforma em produto para usuários corporativos, e Codex e Claude Code permitem que desenvolvedores montem pipelines de automação completos.
Os resultados do VibeVideoBench mostram que os sistemas Agent de ponta já entregam vídeos completos de forma estável, e as principais causas de falha se concentram no agendamento de renderização e na gestão de tempo; o custo por tarefa depende da eficiência de Tokens e da taxa de acerto de cache, e não do preço unitário do modelo. Isso significa que a competição na produção de vídeo está migrando da qualidade de imagem de um único modelo para a capacidade de organizar todo o fluxo de trabalho de “geração, edição, renderização e entrega”.
Recapitulando os pontos principais:
- Diferença entre as rotas: na geração nativa, o modelo produz a imagem diretamente; na renderização por código, o modelo escreve o programa e depois renderiza;
- Onde a geração nativa se aplica: pessoas, sensação de filmagem real, movimento natural, anúncios com pegada cinematográfica e narrativas contínuas;
- Onde a renderização por código se aplica: gráficos de dados, fórmulas, tutoriais de software, parâmetros e preços, e conteúdo em lote baseado em templates;
- Critério de comparação de custos: considerar o custo total do vídeo final entregável, incluindo tentativas, Tokens, renderização e licenças;
- Melhor prática: fluxo de trabalho híbrido — o modelo de vídeo cuida das imagens naturais e o código cuida da expressão precisa;
- Invocação de múltiplos modelos: roteiro, storyboard, código de animação e verificação do vídeo final se adequam a modelos diferentes, e uma interface unificada reduz o custo de troca.
Na produção real, um vídeo costuma exigir a invocação de vários Modelos de Linguagem Grande para cuidar separadamente de criação, codificação e verificação. A recomendação é usar o APIYI apiyi.com para invocar GPT, Claude, Gemini e outros modelos de forma unificada com uma única chave API, distribuindo os modelos conforme a tarefa e pagando pelo volume usado, para concentrar os esforços no próprio fluxo de trabalho.
Referências
- Avaliação oficial do VibeVideoBench: avaliação de agentes para geração de vídeo orientada por código
- Link:
vibevideobench.github.io -
Descrição: ranking com 239 tarefas, pontuações de qualidade, análise de custos e causas de falha
-
Anúncio oficial do Seedance 2.5: geração em 30 segundos e referências multimodais
- Link:
seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5 -
Descrição: limite de materiais de referência, capacidade de extensão e edição por timestamps
-
BytePlus ModelArk Pricing: preços da API do Seedance 2.5
- Link:
docs.byteplus.com/en/docs/modelark/model-pricing -
Descrição: preços de referência para geração de vídeo em diferentes resoluções
-
Documentação da API do Kling: anúncio da atualização do Kling 4.0 e cobrança
- Link:
kling.ai/document-api/apiReference/updateNotice -
Descrição: keyframes, referência a múltiplos materiais e regras de cobrança por Unit
-
Documentação de geração de vídeo da API Gemini: Veo 3.1 e Gemini Omni Flash
- Link:
ai.google.dev/gemini-api/docs/video -
Descrição: áudio nativo, extensão de vídeo e edição em múltiplas rodadas
-
Documentação e preços de licença do Remotion
- Link:
remotion.dev/docs/render,remotion.dev/docs/license/pricing -
Descrição: comandos de renderização e opções de licença comercial
-
Documentação do Manim Community
- Link:
docs.manim.community/en/stable -
Descrição: uso do motor de animação para matemática e ciências
-
Documentação oficial do FFmpeg
- Link:
ffmpeg.org/documentation.html -
Descrição: codificação, composição, legendas e verificação com ffprobe
-
Guia de uso do Claude Motion
- Link:
support.claude.com/en/articles/17454997-get-started-with-claude-motion -
Descrição: fluxo do recurso Beta e condições de liberação
-
OpenAI API Deprecations
- Link:
developers.openai.com/api/docs/deprecations - Descrição: informações sobre o desligamento do Sora 2 e da Videos API
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: Fique à vontade para falar com a gente pela página inicial do site oficial da APIYI; há mais materiais de integração no centro de documentação docs.apiyi.com