作者注:解读 OpenAI 12 小时 Prompt Cache 对 GPT-6 API 成本的影响,用回本公式和 5 个判断标准说明哪些场景开缓存能省钱、哪些场景收益有限。
OpenAI 为 Prompt Cache 新增 12 小时缓存保留能力,这对调用 GPT-6 API 的团队来说是一个值得重新核算成本的信号。以前缓存通常只在几分钟的空闲时间内有效,很多低频请求根本吃不到折扣;现在缓存窗口拉长,一大批”隔几个小时才回来”的请求也有机会命中。
这不是”开了缓存就自动省一半”的营销话术。缓存是否省钱,取决于前缀是否稳定、请求间隔多长、单次前缀有多大,以及缓存写入是否有额外成本。本文用一个简单的回本公式,帮你判断自己的业务到底该不该开 12 小时缓存。
核心价值:5 分钟看懂 12 小时 Prompt Cache 的机制变化,学会用 5 个标准判断 GPT-6 API 缓存什么时候真正省钱。
OpenAI 12 小时 Prompt Cache 核心信息速览
先用一张表把这次更新的关键信息梳理清楚。由于官方价格和参数会持续调整,表中涉及计费比例的部分都以 OpenAI 官方文档和价格页为准。
| 信息项 | 详情 |
|---|---|
| 更新内容 | Prompt Cache 新增 12 小时缓存保留选项 |
| 发布方 | OpenAI |
| 涉及模型 | GPT-6 API 等支持 Prompt Caching 的模型(以官方模型列表为准) |
| 计费逻辑 | 命中缓存的输入 token 按低于常规输入的单价计费,具体折扣以官方价格页为准 |
| 核心变化 | 缓存从”分钟级空闲失效”延长到最长 12 小时保留 |
| 影响范围 | 长系统提示词、Agent 工具定义、RAG 固定知识、多轮对话等场景 |
Prompt Cache 是怎么工作的
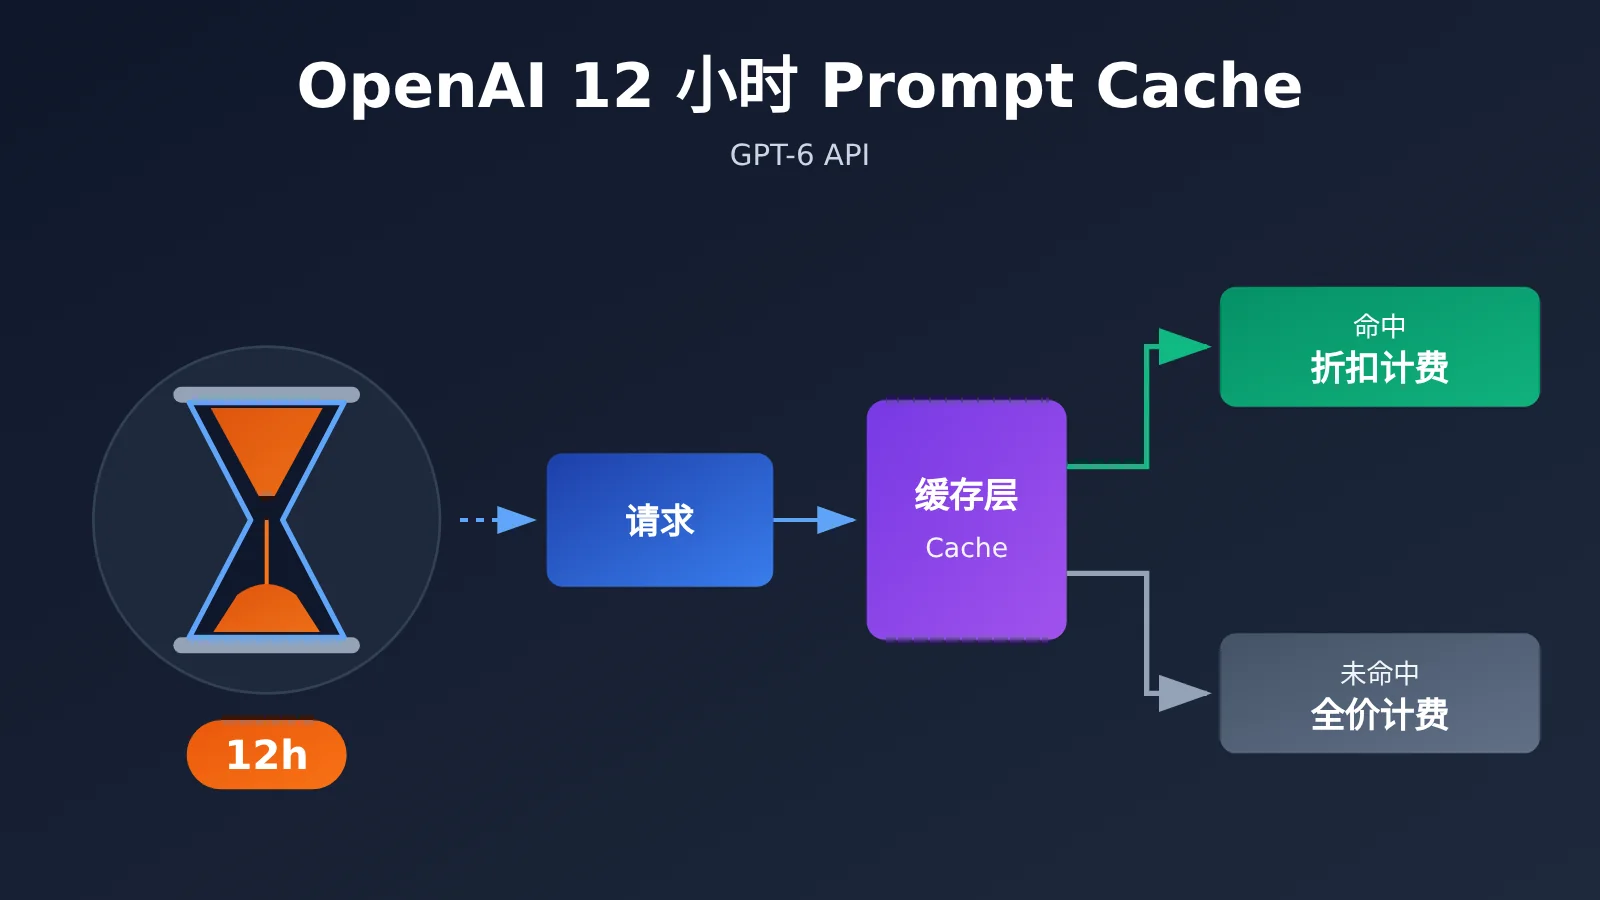
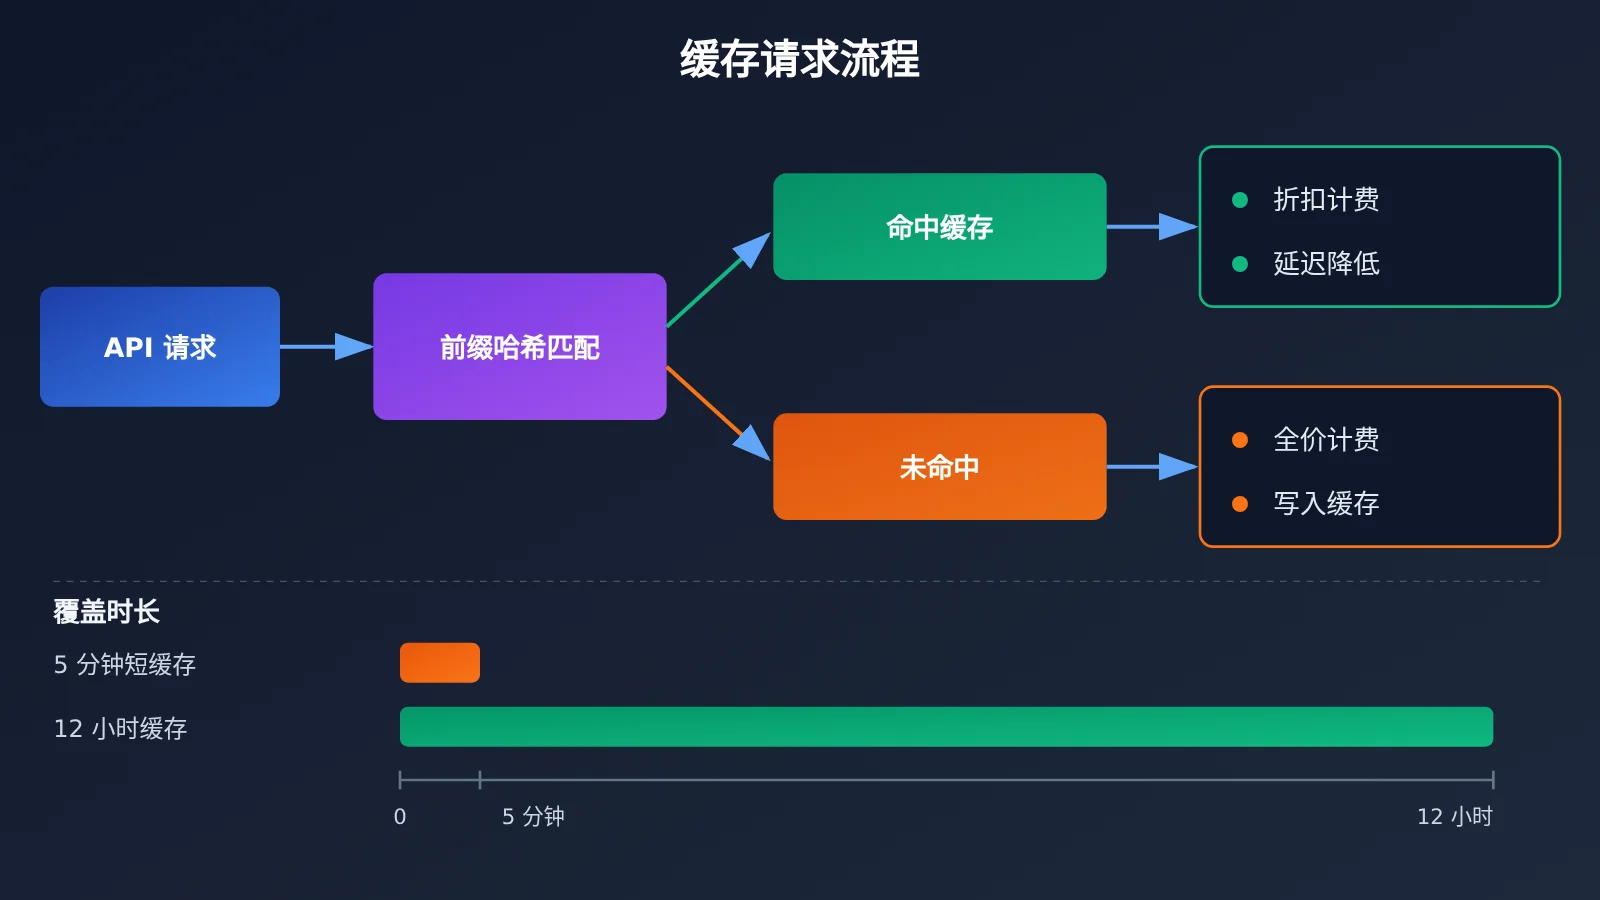
OpenAI 的 Prompt Caching 是基于”前缀匹配”的机制。当请求的开头部分(系统提示词、工具定义、固定文档等)与近期某次请求完全一致,并且长度达到官方规定的最小阈值时,这部分 token 就会被识别为缓存命中,按折扣价计费,同时首 token 延迟也会明显降低。
需要特别注意的是,缓存只认”从第一个 token 开始连续一致”的部分。只要前缀中间插入了一个时间戳或用户 ID,后面的内容就全部无法命中。因此 Prompt 结构设计比”开不开缓存”更重要:静态内容放前面,动态内容放最后。
12 小时缓存与短缓存的区别
过去的短缓存在空闲几分钟后就会被清除,只有高频、连续的请求才能稳定命中。12 小时保留则把”命中窗口”从分钟级扩展到半天级,这直接改变了低频场景的成本结构。
| 对比维度 | 默认短缓存 | 12 小时缓存 |
|---|---|---|
| 保留时长 | 分钟级空闲后失效 | 最长约 12 小时 |
| 适合的请求频率 | 高频、连续请求 | 中低频、间歇性请求 |
| 典型受益场景 | 实时客服、批量连续调用 | 用户隔数小时回到会话、日内定时任务 |
| 命中率稳定性 | 受流量波动影响大 | 对流量低谷更友好 |
| 额外成本 | 通常无写入附加费 | 是否有附加费以官方说明为准 |
GPT-6 API 缓存什么时候真正省钱:回本公式
很多文章只说”缓存能省钱”,却不讲省多少、什么条件下省。下面用一个通用公式把问题量化,你只需要代入自己的业务参数即可。
Prompt Cache 回本公式推导
设定以下变量:
L:可缓存前缀的 token 数P:常规输入单价d:缓存命中单价相对常规单价的比例(0 < d < 1)w:首次写入缓存的附加成本比例(无附加费时 w = 0)N:在缓存有效期内,同一前缀被调用的次数
不使用缓存时,前缀总成本是 N × L × P。使用缓存时,第一次按写入成本计费,后续按命中价计费,总成本是 L × P × (1 + w) + (N − 1) × L × P × d。
两者相减可以得到一个很简洁的回本条件:N > 1 + w / (1 − d)。这个公式说明了两件事:如果写入没有附加费(w = 0),只要同一前缀在有效期内被复用一次就开始省钱;如果写入有附加费,复用次数需要超过一个阈值才能回本,而折扣越大(d 越小),回本越快。
不同场景的回本测算
下面用”假设参数”做一个示意测算,仅用于说明公式的用法,不代表 OpenAI 实际价格。我们假设缓存命中价为常规价的一定比例,分别观察有无写入附加费时的回本次数。
| 场景假设 | 写入附加费 w | 命中折扣 d | 回本所需调用次数 N | 结论 |
|---|---|---|---|---|
| 无写入附加费 | 0 | 任意 | N > 1 | 复用 1 次即省钱 |
| 小额写入附加费 | 较低 | 折扣较大 | 约 2 次 | 绝大多数场景都划算 |
| 较高写入附加费 | 较高 | 折扣较小 | 3 次以上 | 只有高复用场景划算 |
从测算可以看出,12 小时缓存的真正价值不在于”折扣本身”,而在于让 N 变大。原本几小时才来一次的请求,在短缓存下 N 基本等于 1,根本谈不上省钱;拉长到 12 小时后,同一前缀在一天内被复用多次,省钱效果才会真正体现。
🚀 快速开始:想在真实流量上验证回本公式,推荐通过 API易 apiyi.com 用同一个 API Key 对比不同模型的缓存命中情况,平台采用 OpenAI 兼容接口,新用户可领取免费测试额度。
如何在 GPT-6 API 中验证 Prompt Cache 命中
判断缓存是否省钱,最可靠的方式是读取响应里的 usage 字段。OpenAI 兼容接口会在 usage.prompt_tokens_details.cached_tokens 中返回本次命中缓存的 token 数,你可以据此计算真实命中率。
极简示例
下面的代码连续发送两次相同前缀的请求,观察第二次的 cached_tokens 是否大于 0:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 统一接口,OpenAI 兼容
)

SYSTEM_PROMPT = "你是资深技术顾问……(此处放置超过最小缓存阈值的固定长提示词)"

for i in range(2):
    resp = client.chat.completions.create(
        model="gpt-6",  # 以平台模型列表中的实际名称为准
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": f"第 {i+1} 次提问:如何优化接口成本?"}
        ]
    )
    cached = resp.usage.prompt_tokens_details.cached_tokens
    print(f"第 {i+1} 次请求,命中缓存 token 数:{cached}")
查看完整实现代码(含命中率统计与缓存路由键)
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class CacheStats:
    total_prompt: int = 0
    total_cached: int = 0
    records: list = field(default_factory=list)

    def add(self, prompt_tokens: int, cached_tokens: int):
        self.total_prompt += prompt_tokens
        self.total_cached += cached_tokens
        self.records.append((prompt_tokens, cached_tokens))

    @property
    def hit_rate(self) -> float:
        if self.total_prompt == 0:
            return 0.0
        return self.total_cached / self.total_prompt


def build_messages(static_prefix: str, user_input: str) -> list:
    """静态内容放最前面,动态内容放最后,保证前缀稳定"""
    return [
        {"role": "system", "content": static_prefix},
        {"role": "user", "content": user_input},
    ]


def ask(static_prefix: str, user_input: str, cache_key: str, stats: CacheStats,
        model: str = "gpt-6") -> str:
    resp = client.chat.completions.create(
        model=model,
        messages=build_messages(static_prefix, user_input),
        # prompt_cache_key 帮助相同前缀的请求路由到同一缓存
        # 如需启用 12 小时保留,请按 OpenAI 官方文档添加对应参数
        extra_body={"prompt_cache_key": cache_key},
    )
    usage = resp.usage
    cached = getattr(usage.prompt_tokens_details, "cached_tokens", 0) or 0
    stats.add(usage.prompt_tokens, cached)
    return resp.choices[0].message.content


if __name__ == "__main__":
    stats = CacheStats()
    prefix = open("system_prompt.txt", encoding="utf-8").read()
    questions = ["如何设计缓存友好的 Prompt?", "工具定义应该放在哪里?", "如何统计命中率?"]

    for q in questions:
        ask(prefix, q, cache_key="kb-v1", stats=stats)

    print(f"整体缓存命中率:{stats.hit_rate:.1%}")
    for idx, (p, c) in enumerate(stats.records, 1):
        print(f"请求 {idx}: prompt={p}, cached={c}")
建议:先在小流量上跑一天,统计整体命中率和请求间隔分布,再决定是否在生产环境全面启用 12 小时缓存。通过 API易 apiyi.com 获取测试额度即可完成这类验证,无需单独开通多个官方账号。
12 小时 Prompt Cache 的 5 个省钱判断标准
把回本公式落到实际业务中,可以归纳为下面 5 个判断标准。满足的条件越多,开启 12 小时缓存的收益越明显。
- 前缀足够长:可缓存的固定部分要达到官方最小阈值,且越长折扣总额越大。几百 token 的短提示词即使命中,省下的钱也很有限。
- 前缀足够稳定:系统提示词、工具定义、Schema 顺序在一天内保持不变。频繁改版提示词会让缓存反复失效。
- 请求间隔落在 12 小时内:如果同一前缀每隔几十分钟到几小时被调用一次,这正是 12 小时缓存相比短缓存的最大增量收益区。
- 复用次数超过回本阈值:用
N > 1 + w / (1 − d)核算,确认日内复用次数稳定高于阈值。 - 输入成本占比高:如果你的账单主要来自输出 token,缓存只优化输入侧,整体降幅会被稀释。
不同业务场景的 12 小时缓存适配度
| 业务场景 | 请求间隔特征 | 短缓存效果 | 12 小时缓存增量价值 |
|---|---|---|---|
| 实时客服机器人 | 高频连续 | 已较好 | 一般,主要补齐流量低谷 |
| 企业知识库 RAG | 中频,固定文档前缀 | 波动较大 | 明显,日内多次复用固定知识 |
| 编程 Agent 会话 | 用户间歇性回到会话 | 常常失效 | 很高,长上下文跨小时复用 |
| 日内定时批处理 | 每隔数小时一批 | 基本无效 | 很高,同一模板一天多批 |
| 一次性长文档分析 | 只调用一次 | 无效 | 几乎没有,N = 1 无法回本 |
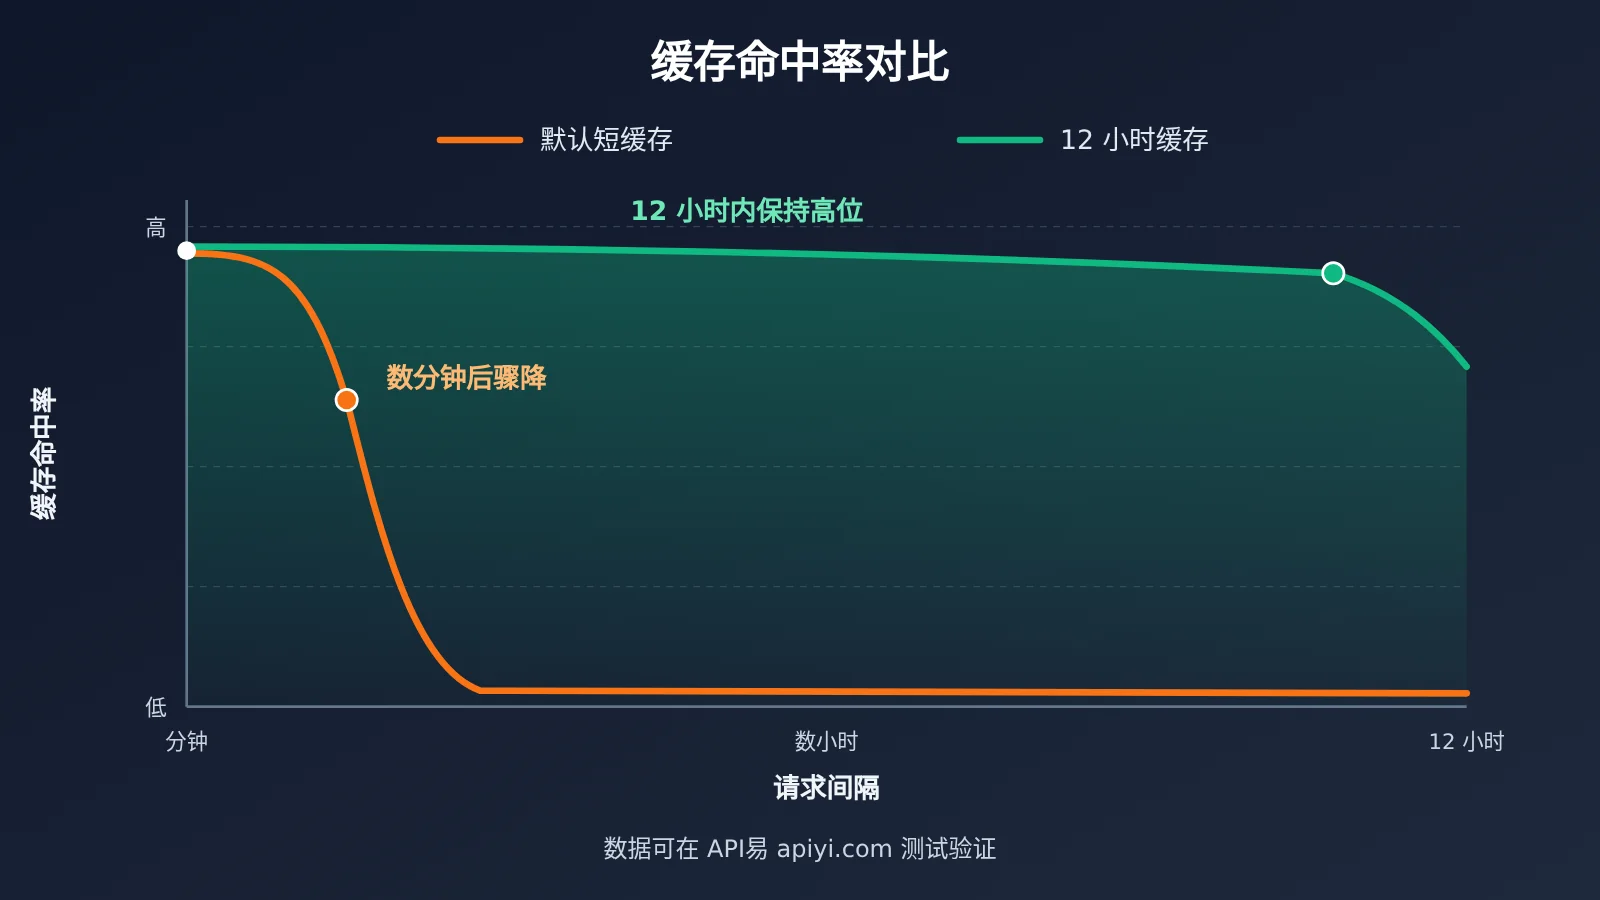
对比说明:上图展示的是不同请求间隔下两种缓存策略命中率的趋势差异,实际命中率取决于你的前缀稳定性和流量分布,建议用自己的真实请求日志做对比。
OpenAI 12 小时 Prompt Cache 影响分析
对开发者的影响
- Prompt 工程要升级为”缓存工程”:需要把系统提示词、工具定义、固定知识整理成稳定的前缀块,并对版本做显式管理,避免小改动导致全量失效。
- 成本评估从”单价”转向”有效单价”:同样的 GPT-6 API,命中率高的团队和命中率低的团队,实际每千次请求成本可能差距明显,监控 cached_tokens 应成为常规指标。
- 长上下文 Agent 更可行:编程助手、研究型 Agent 的上下文往往很长,过去用户离开一会儿再回来就要全价重算,现在跨小时复用让长会话的经济性显著改善。
- 延迟同步改善:命中缓存的请求首 token 延迟更低,对交互体验敏感的产品是额外收益。
对行业的影响
- 缓存成为模型定价的竞争维度:主流厂商都在提供各自的提示词缓存方案,保留时长、折扣力度、是否收写入费,正在成为开发者选型时的重要参考。
- 聚合平台的多模型对比价值上升:不同厂商的缓存规则差异较大,统一接口下横向对比实际账单,比只看官方标价更有参考意义。
- RAG 架构可能被重新评估:当长文档前缀可以低成本复用半天,部分中小规模知识库场景可能从”检索切片”转向”整段放入上下文 + 缓存”。
多模型缓存方案选型参考
| 模型方向 | 缓存特点(以各家官方文档为准) | 适用场景 | 可用平台 |
|---|---|---|---|
| GPT-6 API | 自动前缀缓存,新增 12 小时保留选项 | 长系统提示词、Agent 会话 | API易 apiyi.com、OpenAI 官方 |
| Claude 系列 | 需显式标记缓存断点,支持不同保留时长 | 精细控制缓存位置的场景 | API易、Anthropic 官方 |
| Gemini 系列 | 支持隐式与显式上下文缓存 | 超长文档、多模态上下文 | API易、Google 官方 |
💡 选择建议:不同模型的缓存规则差异较大,建议用同一份业务 Prompt 在多个模型上实测命中率与账单,再结合效果做决策。
常见问题 FAQ
Q1:什么是 OpenAI 12 小时 Prompt Cache?
它是 OpenAI Prompt Caching 机制的延长保留选项。相同前缀的请求在最长约 12 小时内都有机会命中缓存,命中部分的输入 token 按折扣价计费,并能降低首 token 延迟。
Q2:12 小时缓存和默认短缓存有什么区别?
默认短缓存在空闲几分钟后就会失效,只适合高频连续请求;12 小时缓存则覆盖了中低频、间歇性的请求。对实时客服这类高频场景,两者差别不大;对 Agent 会话、定时批处理这类间隔数小时的场景,12 小时缓存的增量收益明显。
Q3:开启 12 小时缓存一定能省钱吗?
不一定。如果写入缓存没有附加费,同一前缀在有效期内被复用一次就开始省钱;如果有附加费,需要复用次数超过 `1 + w / (1 − d)` 才能回本。一次性调用、前缀频繁变化、前缀很短的场景,收益都非常有限。
Q4:如何提高 GPT-6 API 的缓存命中率?
核心原则是”静态在前、动态在后”:
– 系统提示词、工具定义、固定文档放在消息最前面,并保持顺序不变
– 时间戳、用户 ID、检索结果等动态内容放在最后
– 对同一类请求使用固定的缓存路由键,提升路由到同一缓存的概率
– 提示词改版集中发布,避免日内频繁小改
Q5:如何通过 API 快速测试 12 小时缓存效果?
推荐使用支持多模型的 API 聚合平台进行测试:
1. 访问 API易 apiyi.com 注册账号
2. 获取 API Key 和免费测试额度
3. 使用本文代码示例(base_url 替换为 `https://api.apiyi.com/v1`),读取 `cached_tokens` 统计命中率
API易 采用 OpenAI 兼容接口,一个 Key 即可对比 GPT、Claude、Gemini 的缓存表现。
Q6:Prompt Cache 有哪些已知限制?
缓存只对达到最小长度阈值的连续前缀生效,且只优化输入侧成本,输出 token 不打折。缓存属于”尽力而为”机制,高并发或流量路由变化时可能出现未命中,不宜把命中率当作 100% 保证。12 小时保留的具体计费方式和支持模型,请以 OpenAI 官方文档为准。
12 小时 Prompt Cache 核心要点 Key Takeaways
- 机制本质:基于前缀完全匹配,命中部分输入 token 按折扣价计费
- 核心变化:保留时长从分钟级延长到约 12 小时,覆盖低频请求
- 回本公式:复用次数 N > 1 + w / (1 − d) 才开始省钱
- 最大受益场景:Agent 长会话、知识库 RAG、日内定时批处理
- 收益有限场景:一次性调用、短前缀、频繁改版的提示词
- 落地关键:静态内容前置,用 cached_tokens 持续监控命中率
- 验证方式:通过 API易 apiyi.com 用真实流量小规模测试后再全量启用
总结
OpenAI 12 小时 Prompt Cache 对 GPT-6 API 成本的核心影响:
- 省钱的关键是复用次数:12 小时窗口让中低频请求也能多次复用同一前缀,把 N 从 1 拉高才是真正的增量价值。
- 写入成本决定回本门槛:没有写入附加费时几乎稳赚,有附加费时要用回本公式核算。
- Prompt 结构比开关更重要:静态前置、版本管理、命中率监控,才能把缓存折扣真正兑现到账单上。
建议先从长系统提示词和 Agent 会话这类高收益场景入手,跑一天真实流量看命中率,再决定全面推广的范围。推荐通过 API易 apiyi.com 快速完成多模型缓存效果对比,平台提供免费测试额度和统一的 OpenAI 兼容接口。
📚 参考资料
- OpenAI Prompt Caching 官方指南:缓存机制、最小阈值与 usage 字段说明
- 链接:
platform.openai.com/docs/guides/prompt-caching -
说明: 了解缓存命中规则和最新保留时长参数的权威来源
-
OpenAI API 价格页:各模型常规输入、缓存输入与输出单价
- 链接:
openai.com/api/pricing -
说明: 代入回本公式时,以此页面的实时价格为准
-
OpenAI API Reference:Chat Completions 与 Responses 接口参数说明
- 链接:
platform.openai.com/docs/api-reference - 说明: 查询 prompt_cache_key 等缓存相关参数的具体用法
作者: APIYI 技术团队
技术交流: 欢迎在 API易 网站首页联系我们,获取更多模型接入与成本优化方案