Gemini 4 Argon 有了新进展:继 9 月 30 日官宣、先向 Fairwind 计划网络防御方开放之后,Gemini 4 Argon 已经可以在 Vertex AI 中拉取到模型,Google Cloud 侧的放量正式开始。对大多数开发者来说,接下来最现实的问题就是:Gemini 4 Argon 的价格到底怎么算,接入后每个月要花多少钱?
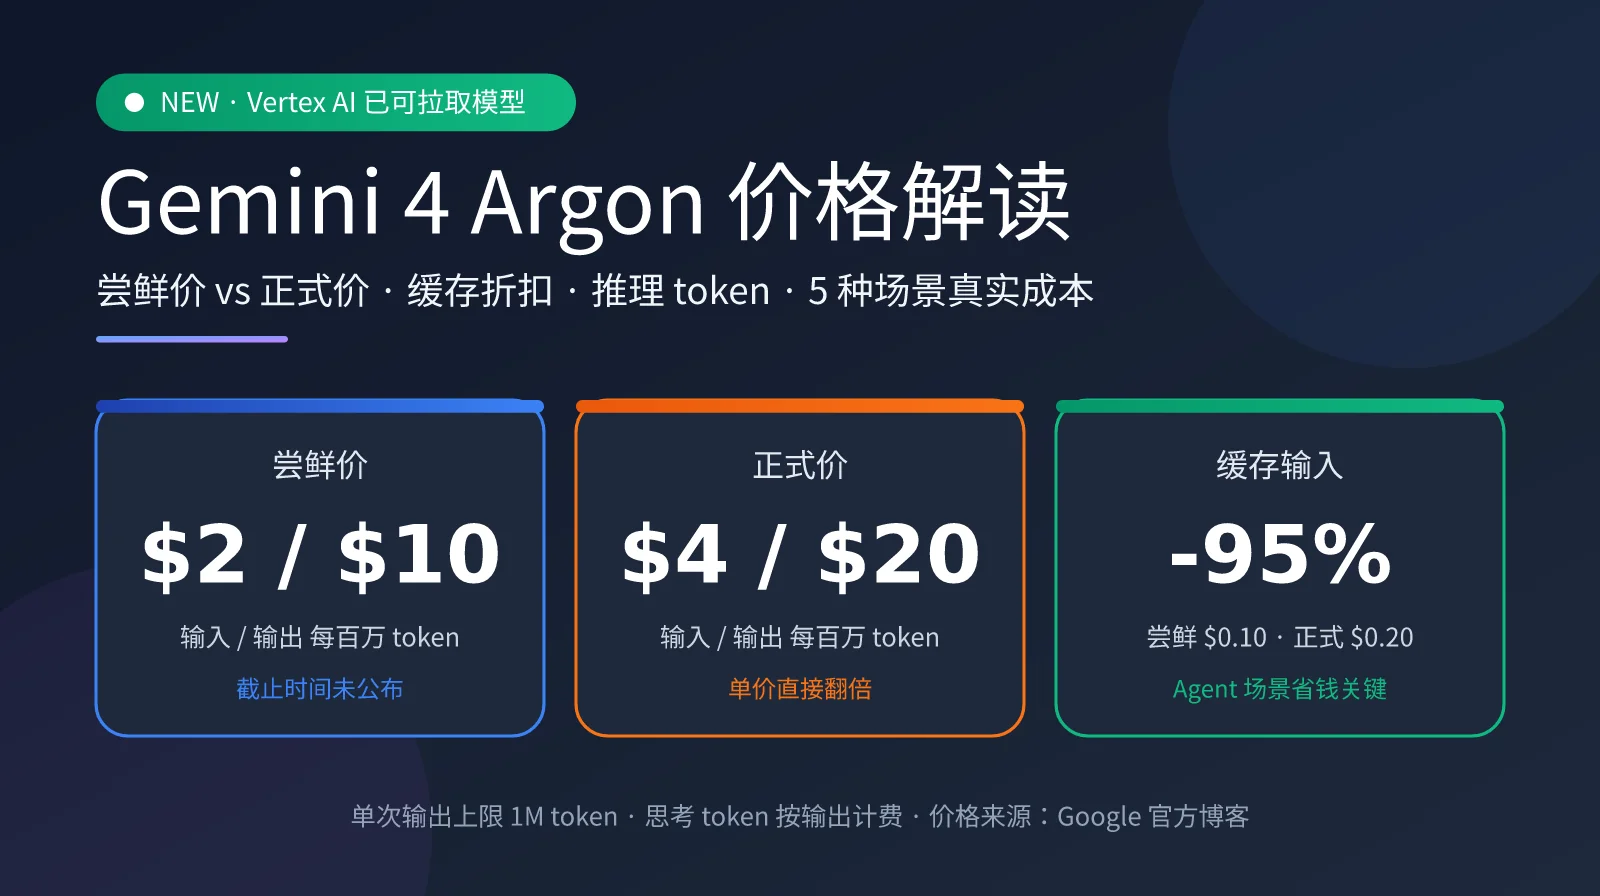
表面上看,Argon 的定价很简单:尝鲜价输入 $2、输出 $10 每百万 token,正式价翻倍到 $4/$20,缓存输入打 95% 折。但这张价目表背后还藏着几个变量:推理 token 怎么计费、1M 输出上限会不会让单次请求成本失控、Argon 的 token 消耗量比竞品高出多少。本文结合 Google 官方博文与多家英文媒体、第三方评测机构的公开数据,逐项拆解 Gemini 4 Argon 价格,并给出 5 种典型场景的成本测算。
核心价值:读完本文,你能算清 Gemini 4 Argon 在自己业务中的真实单任务成本,知道尝鲜期结束后账单会怎么变,以及如何用缓存和输出上限把成本压下来。
Gemini 4 Argon 价格一览
先把 Google 官方公布的价格信息整理成一张表。需要特别注意的是,Google 只公布了尝鲜价和正式价两档,没有说明尝鲜期持续多久,也没有公布批量(Batch)、Flex、长上下文分档和缓存存储费等细项。
| 计费项 | 尝鲜价(每百万 token) | 正式价(每百万 token) | 说明 |
|---|---|---|---|
| 输入 | $2.00 | $4.00 | 尝鲜期时长未公布 |
| 输出 | $10.00 | $20.00 | 推理 token 计费方式官方未单独说明 |
| 缓存输入 | $0.10 | $0.20 | 输入价打 95% 折,正式价档位按同一折扣推算 |
| 单次输出上限 | 1M token | 1M token | 此前 Gemini 模型为 64K |
| Batch / Flex | 未公布 | 未公布 | 现有 Gemini 型号通常有批量折扣 |
| 长上下文分档 | 未公布 | 未公布 | 输入上下文窗口官方亦未公布 |
Gemini 4 Argon 价格的三个关键细节
第一个细节是推理 token。Google 没有单独说明 Argon 的思考 token 怎么计费,但当前 Gemini 系列的惯例是思考 token 按输出价格计费。做预算时最稳妥的做法是假设 Argon 沿用这一规则,也就是所有思考过程都按 $10(尝鲜)或 $20(正式)每百万 token 计入账单。
第二个细节是缓存折扣。95% 的缓存折扣意味着尝鲜期缓存输入只要 $0.10 每百万 token。对于 Agent 类工作流,每一轮对话都要重复发送系统提示词、工具定义和代码库上下文,缓存命中率往往能做到 70% 以上,这个折扣对总账单的影响可能比 $2 的标价还大。
第三个细节是尝鲜期的不确定性。尝鲜期结束后所有单价直接翻倍,而 Google 没有给出截止时间。这意味着你基于尝鲜价做的 ROI 测算,最好同时准备一份正式价版本,避免某天账单突然翻倍。
🎯 预算建议:Gemini 4 Argon 的价格变量较多,建议先用小流量跑出真实的 token 消耗分布,再决定是否大规模切换。通过 API易 apiyi.com 平台可以在统一接口下同时调用 Gemini、GPT、Claude 等多个系列模型,方便用同一批任务对比真实成本。
Gemini 4 Argon Vertex AI 上线最新动态
Argon 的开放节奏一直是开发者最关心的问题。按照 Google 博文的规划,Argon 先面向 Fairwind 计划的可信网络防御方和 Google 内部,然后是付费 API 客户和 Google AI Ultra 订阅用户,最后才是更广泛的开发者、企业和消费者。下表梳理了从官宣到 Vertex AI 可拉取的时间线。
| 时间 | 事件 | 信息来源 |
|---|---|---|
| 9 月 3 日 | Fairwind 计划启动,首发模型为 Gemini 3.8 Flash Cyber | Google 官方博客 |
| 9 月 30 日 | Gemini 4 Argon 官宣,向 Fairwind 成员推送 | Google 官方博客 |
| 9 月 30 日 | DataCamp 检查:Vertex AI、Gemini CLI 等均未上架 | DataCamp |
| 10 月 7-8 日 | 社区在 Vertex AI 发现 gemini-4-argon-cyber-permissive 条目 |
社区与科技媒体 |
| 10 月中旬 | Vertex AI 中已可拉取 Gemini 4 Argon 模型 | 最新动态 |
社区最早发现的 gemini-4-argon-cyber-permissive 这个 ID 很有意思。“cyber-permissive”暗示这是面向网络防御方、放宽网络安全护栏的版本,这和 Google 博文中“对可信防御方不加网络安全护栏”的描述一致。面向普通付费客户的版本大概率会使用不同的 ID,并保留完整的安全防护。因此在接入时,请以你自己的 Google Cloud 控制台 Model Garden 中实际显示的模型 ID 为准,不要直接照搬网上流传的名称。
Gemini 4 Argon 在 Vertex AI 的价格与平台变化
有社区消息称,Vertex AI 中展示的 Argon 全球价格为输入 $4、输出 $20 每百万 token,也就是 Google 博文中的正式价档位。这一点值得重视:如果企业通过 Vertex AI 接入时直接按正式价计费,那么基于 $2/$10 尝鲜价做的测算都需要乘以 2。尝鲜价究竟适用于哪些渠道,Google 目前没有明确说明,接入前请以控制台账单页的实际单价为准。
另一个容易被忽视的变化是平台本身。Google 在 2026 年 4 月的 Cloud Next 大会上把 Vertex AI 的服务整合进了 Gemini Enterprise Agent Platform,旧版 Vertex AI 文档已经标注不再更新。现有端点继续可用,但 Argon 这类新模型的文档和新功能会优先出现在 Agent Platform 一侧。此外,Gemini 2.5 Pro、2.5 Flash 和 2.5 Flash-Lite 将于 10 月 16 日退役,还在使用这些型号的团队正好可以借这次机会统一完成迁移。
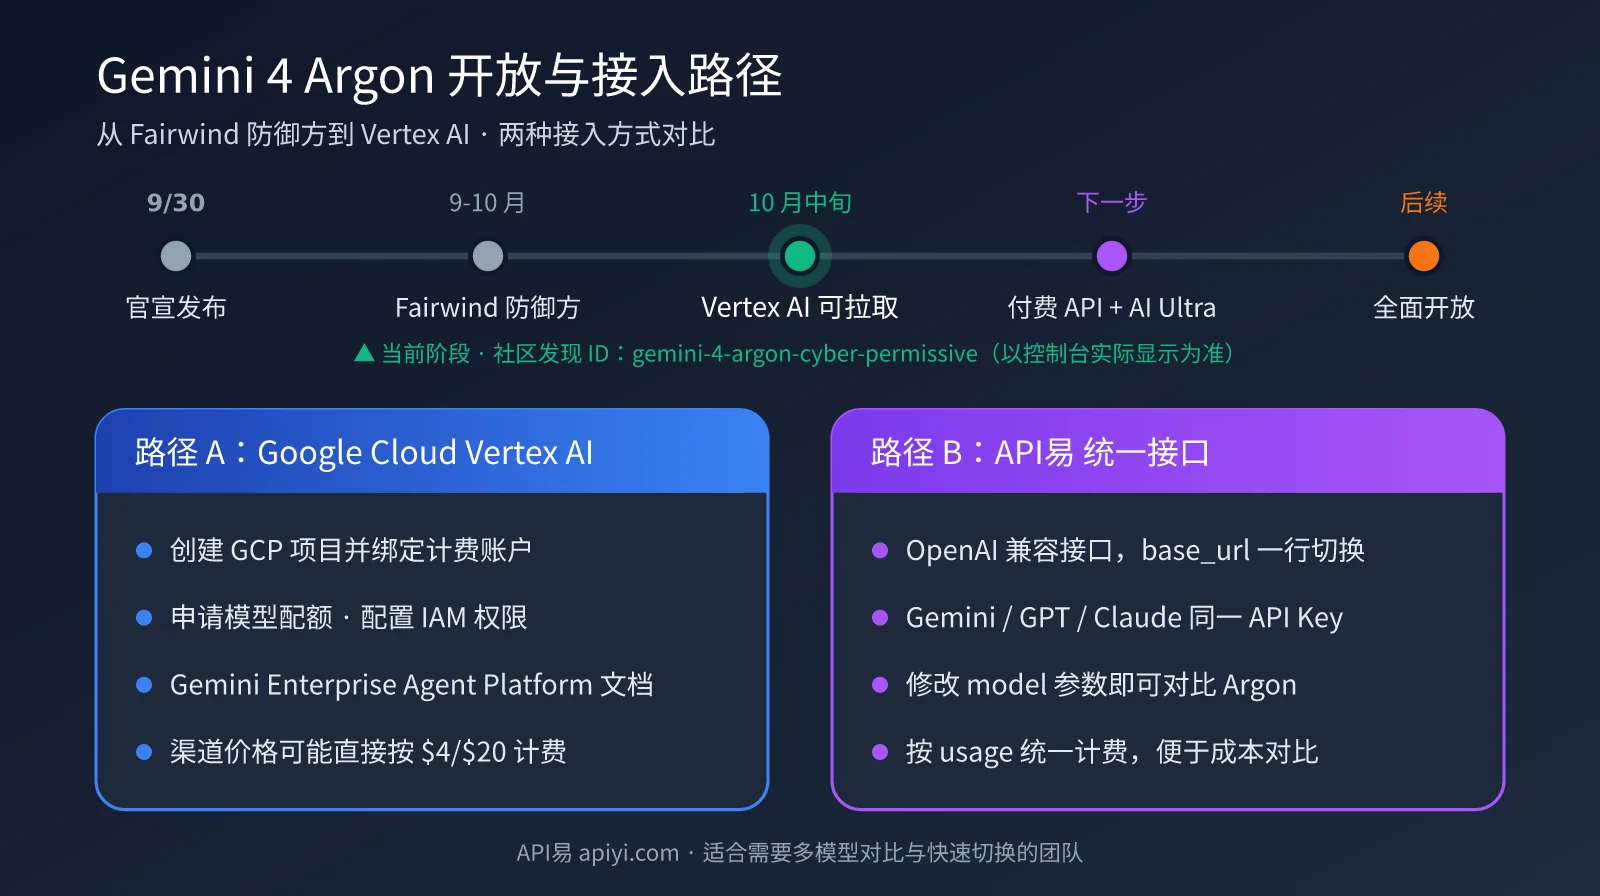
🚀 接入建议:直接走 Vertex AI 需要 GCP 项目、计费账户、配额申请和 IAM 配置,对中小团队门槛不低。我们建议通过 API易 apiyi.com 平台的 OpenAI 兼容接口统一接入 Gemini 系列模型,只需修改 model 参数就能在 Argon 和其他模型之间切换。
Gemini 4 Argon 价格对比:同门与竞品
只看单价很难判断 Argon 贵不贵,需要放到同门的 Gemini 3.8 Flash 和竞品旗舰模型中一起比较。下表为各模型的标价,其中竞品价格来自第三方整理,以各厂商官方页面为准。
| 模型 | 输入 / 百万 token | 输出 / 百万 token | 单次输出上限 | 定位 |
|---|---|---|---|---|
| Gemini 3.8 Flash | $0.75 | $3.75 | — | 日常主力,高性价比 |
| Gemini 4 Argon(尝鲜) | $2.00 | $10.00 | 1M | 长链路推理旗舰 |
| Gemini 4 Argon(正式) | $4.00 | $20.00 | 1M | 长链路推理旗舰 |
| Claude Opus 5.5 | $4.00 | $20.00 | 128K | 竞品旗舰 |
| GPT-6 Astra | $10.00 | $50.00 | 128K | 竞品旗舰 |
从单价看,Argon 尝鲜价约为 Gemini 3.8 Flash 的 2.7 倍,正式价与 Claude Opus 5.5 持平,只有 GPT-6 Astra 的 40%。但单价只是一半,另一半是完成同样任务要消耗多少 token,这正是 Argon 定价最需要警惕的地方。
Gemini 4 Argon 单任务成本:token 消耗才是关键
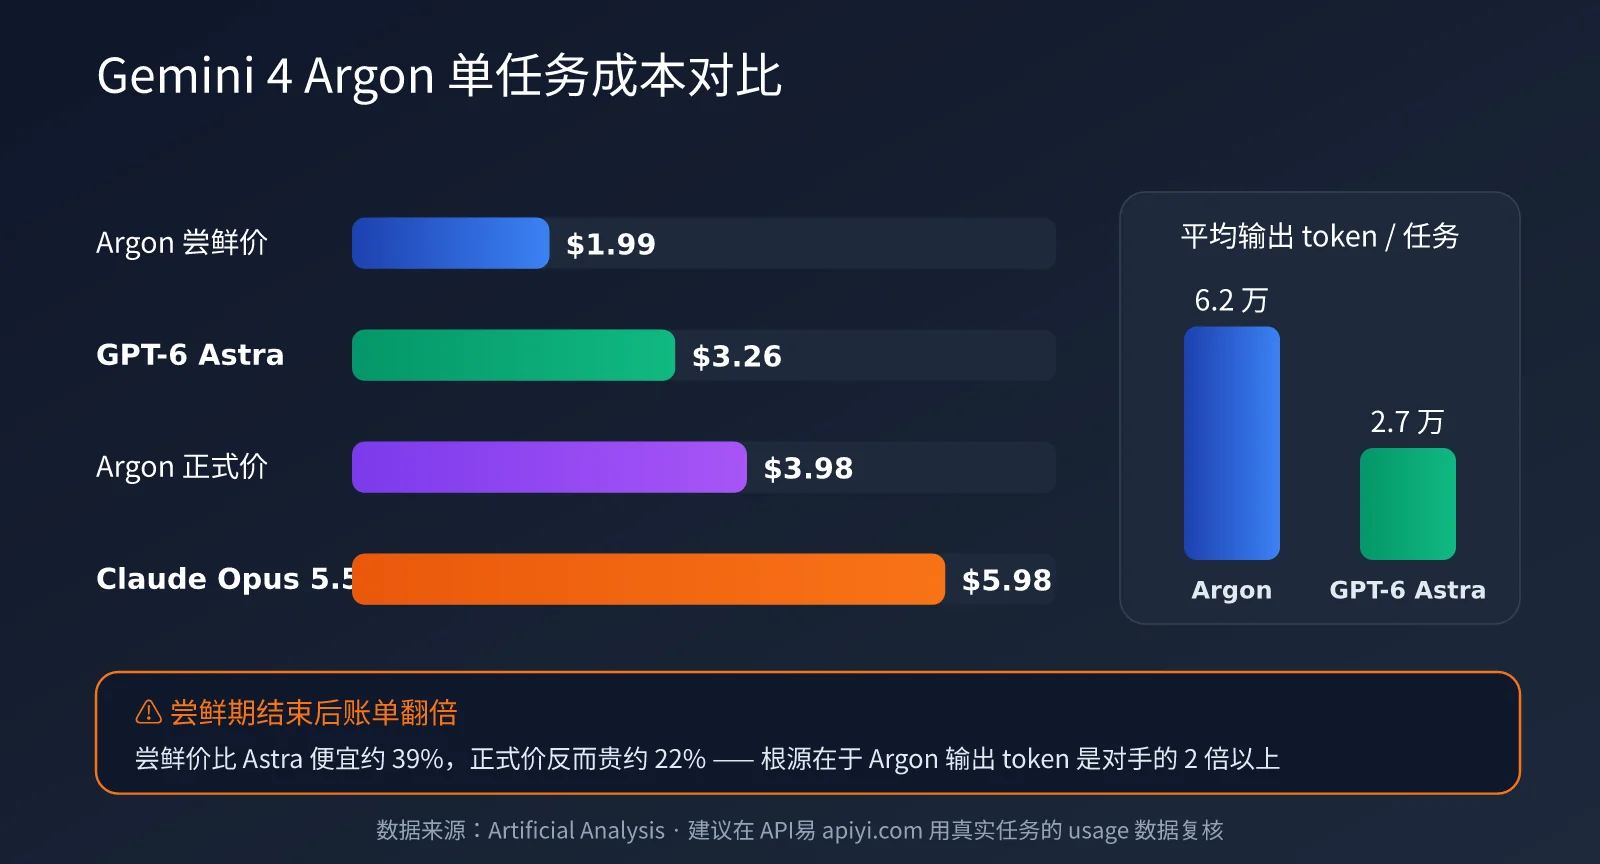
第三方评测机构给出的单任务成本,比单价更能说明问题。Artificial Analysis 的数据显示,Argon 在智能指数测试中平均每个任务生成约 6.2 万个输出 token,而得分相同的 GPT-6 Astra 只用了约 2.7 万个,Argon 的“话量”是对手的两倍多。
| 评测口径 | Gemini 4 Argon | 对比模型 | 结论 |
|---|---|---|---|
| AA 单任务成本(尝鲜价) | $1.99 | GPT-6 Astra $3.26 | 尝鲜期比 Astra 便宜约 39% |
| AA 单任务成本(正式价) | $3.98 | GPT-6 Astra $3.26 | 正式价反而比 Astra 贵约 22% |
| AA 单任务成本 | $1.99 | Claude Opus 5.5 $5.98 | 约为 Opus 5.5 的三分之一 |
| Vals 单次测试成本 | $15.68 | Opus 5.5 $32.14 / Sonnet 5.5 $21.34 | 该工作负载下成本最低 |
| 平均输出 token / 任务 | 约 6.2 万 | GPT-6 Astra 约 2.7 万 | Argon 推理过程明显更长 |
这张表揭示了 Gemini 4 Argon 价格最关键的一点:尝鲜期 Argon 的性价比很高,但尝鲜期结束后,在部分工作负载上它可能比单价更高的 GPT-6 Astra 还贵。原因就在于输出 token 消耗量。不过 Vals 的测试又显示 Argon 在另一类工作负载上成本最低,说明结论高度依赖具体任务,必须用自己的数据来测算。
💡 选型提示:单价低不等于账单低。建议在 API易 apiyi.com 平台用同一批真实任务分别调用 Argon 和其他旗舰模型,记录每次请求的 usage 字段,用实际 token 消耗而不是标价来决定路由策略。
Gemini 4 Argon 真实成本测算:5 种典型场景
下面用 Google 公布的单价,按尝鲜价和正式价分别测算 5 种典型场景的单次请求成本。思考 token 统一计入输出。
| 场景 | 输入 token | 输出 token | 尝鲜价成本 | 正式价成本 |
|---|---|---|---|---|
| 日常问答 | 2 万 | 5000 | $0.09 | $0.18 |
| 长文档分析 | 20 万 | 5 万 | $0.90 | $1.80 |
| Agent 编程(80% 缓存命中) | 60 万 | 6.2 万 | $0.91 | $1.82 |
| 大型代码迁移 | 30 万 | 40 万 | $4.60 | $9.20 |
| 满额 1M 输出 | 忽略不计 | 100 万 | $10.00 | $20.00 |
以 Agent 编程场景为例:60 万输入中 48 万命中缓存,按 $0.10 计费仅 $0.048;其余 12 万按 $2 计费为 $0.24;6.2 万输出按 $10 计费为 $0.62,合计约 $0.91。可以看到,在缓存充分的情况下,输出 token 占了总成本的近七成,控制输出长度比压低输入更重要。
大型代码迁移和满额 1M 输出这两个场景最需要警惕。1M 输出上限是 Argon 的核心卖点,但一次满额输出在正式价下就是 $20。如果客户端超时设置不合理导致请求失败后自动重试,成本会直接翻倍。对于每天要跑上百次长任务的团队,这类隐性成本很容易让月度账单失控。
Gemini 4 Argon 隐性成本清单
结合以上测算,接入 Argon 时需要重点防范以下几类隐性成本:
- 推理 token 膨胀:Argon 平均输出 token 是 GPT-6 Astra 的两倍以上,按输出价计费的思考过程会显著推高单任务成本。
- 超长输出与重试:1M 输出上限下,客户端、负载均衡的超时设置不当会导致长请求失败重试,成本成倍增加。
- 缓存未命中:提示词结构不合理会让缓存命中率很低,白白损失 95% 的折扣。
- 尝鲜期结束:所有单价翻倍,且没有明确截止日期。
- 渠道价格差异:Vertex AI 展示价格可能直接是正式价,与尝鲜价测算存在 2 倍差距。
Gemini 4 Argon 省钱接入实践
针对上面的隐性成本,最有效的三个手段是:给每个请求设置明确的输出上限、把稳定内容放在提示词前部以提高缓存命中率、按任务难度做模型路由。下面的示例采用 OpenAI 兼容接口,模型 ID 通过环境变量配置。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

# 模型 ID 以平台或 Vertex AI 控制台实际显示为准
ARGON = os.getenv("ARGON_MODEL", "gemini-4-argon")

resp = client.chat.completions.create(
    model=ARGON,
    max_tokens=16000,  # 显式设置输出上限,避免默认放开到 1M
    messages=[{"role": "user", "content": "分析这段代码的并发安全问题"}],
)
u = resp.usage
print(f"输入 {u.prompt_tokens} / 输出 {u.completion_tokens} token")
查看完整代码:按难度路由 + 成本记录
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

# 模型与单价全部配置化,尝鲜期结束后只需改环境变量
ROUTES = {
    "easy": {
        "model": os.getenv("FLASH_MODEL", "gemini-3.8-flash"),
        "price_in": 0.75, "price_out": 3.75, "max_tokens": 8000,
    },
    "hard": {
        "model": os.getenv("ARGON_MODEL", "gemini-4-argon"),
        "price_in": float(os.getenv("ARGON_PRICE_IN", "2")),
        "price_out": float(os.getenv("ARGON_PRICE_OUT", "10")),
        "max_tokens": 64000,
    },
}

# 稳定前缀放在最前面,提升缓存命中率
SYSTEM_PREFIX = open("system_prompt.md", encoding="utf-8").read()


def classify(task: str) -> str:
    """简单示例:长任务、迁移、审计类任务走 Argon,其余走 Flash"""
    keywords = ("迁移", "重构", "审计", "漏洞", "多文件")
    return "hard" if len(task) > 4000 or any(k in task for k in keywords) else "easy"


def run(task: str) -> str:
    route = ROUTES[classify(task)]
    resp = client.chat.completions.create(
        model=route["model"],
        max_tokens=route["max_tokens"],
        messages=[
            {"role": "system", "content": SYSTEM_PREFIX},
            {"role": "user", "content": task},
        ],
        timeout=600,  # 长输出任务放宽超时,避免失败重试导致成本翻倍
    )
    u = resp.usage
    cost = (u.prompt_tokens * route["price_in"]
            + u.completion_tokens * route["price_out"]) / 1_000_000
    print(f"[{route['model']}] in={u.prompt_tokens} out={u.completion_tokens} "
          f"估算成本 ${cost:.4f}(未计缓存折扣)")
    return resp.choices[0].message.content


if __name__ == "__main__":
    print(run("把 legacy/ 目录下的 C 模块迁移为 Rust,并保持接口一致"))
这段代码体现了三个省钱原则。一是 max_tokens 显式设置,不要依赖模型默认的超大输出上限;二是 系统提示词作为稳定前缀放在最前面,让多轮请求尽量命中缓存;三是 按难度路由,把简单任务留给单价只有 Argon 约三分之一的 Gemini 3.8 Flash,只把长链路、高难度任务交给 Argon。
建议:可以先在 API易 apiyi.com 获取测试额度,用上面的路由脚本跑一周真实流量,再根据 usage 日志调整路由阈值和输出上限。
常见问题
Q1:Gemini 4 Argon 现在的价格是 $2/$10 还是 $4/$20?
Google 官方公布的尝鲜价是 $2/$10,正式价是 $4/$20,但没有说明尝鲜期持续多久,也没有说明不同渠道是否统一执行尝鲜价。有社区消息称 Vertex AI 展示的是 $4/$20 正式价。建议以你实际接入渠道的账单单价为准,并同时按两档价格做预算。
Q2:Vertex AI 上的 gemini-4-argon-cyber-permissive 能直接用吗?
这个 ID 从名称看是面向网络防御方、放宽网络安全护栏的版本,对应 Fairwind 计划的访问权限,普通项目通常没有调用权限。普通付费客户应以自己控制台 Model Garden 中显示的模型 ID 为准。如果不想处理 GCP 项目、配额和权限配置,也可以通过 API易 apiyi.com 等聚合平台统一调用 Gemini 系列模型。
Q3:Argon 的思考 token 要额外收费吗?
Google 尚未单独说明,但现有 Gemini 模型的思考 token 按输出价计费,建议按同一规则预算。由于 Argon 平均输出 token 偏多,思考 token 往往是成本的主要来源,可以通过限制 max_tokens 和调整推理强度来控制。
Q4:什么场景值得为 Gemini 4 Argon 付费?
大规模代码迁移、长文档专业分析、法律金融类 Agent 和安全审计等长链路任务,最能体现 Argon 的能力优势,值得付费。日常问答、简单代码补全和高并发轻量任务,用 Gemini 3.8 Flash 等低价模型通常更划算。最稳妥的做法是在 API易 apiyi.com 平台上用真实任务做 A/B 对比,再决定路由比例。
总结
Gemini 4 Argon 的价格可以概括为“标价友好、变量很多”。尝鲜价 $2/$10 在旗舰模型中很有竞争力,95% 的缓存折扣对 Agent 场景尤其友好;但推理 token 消耗偏高、尝鲜期结束后单价翻倍、Vertex AI 渠道可能直接执行正式价,这三点都会让真实账单与标价预期出现明显偏差。
随着 Gemini 4 Argon 已经可以在 Vertex AI 中拉取,接下来的关键不是抢先全量切换,而是先用真实流量测出 token 消耗分布,再通过输出上限、缓存前缀和难度路由把成本控制住。建议把 Argon 定位为“难题专用”的旗舰模型,与 Flash 级模型搭配使用。
我们建议通过 API易 apiyi.com 平台统一接入 Gemini 系列模型,在同一接口下完成 Argon 与其他模型的成本和效果对比,用数据而不是标价来决定模型策略。
参考资料:
- Google 官方博客 Gemini 4 Argon 发布文章: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Google Fairwind Program 介绍页: deepmind.google/fairwind-program
- DataCamp Gemini 4 Argon 基准与定价整理: datacamp.com/blog/gemini-4-argon
- Artificial Analysis 模型成本与智能指数: artificialanalysis.ai
- Vals AI 模型评测与成本数据: vals.ai
作者:APIYI Team | 持续追踪大模型价格与接入动态,更多 AI 模型接入资讯请访问 API易 apiyi.com