Catatan penulis: Mengurai dampak Prompt Cache 12 jam dari OpenAI terhadap biaya GPT-6 API, menggunakan rumus titik impas dan 5 kriteria penilaian untuk menjelaskan skenario mana yang hemat biaya saat cache diaktifkan dan mana yang manfaatnya terbatas.
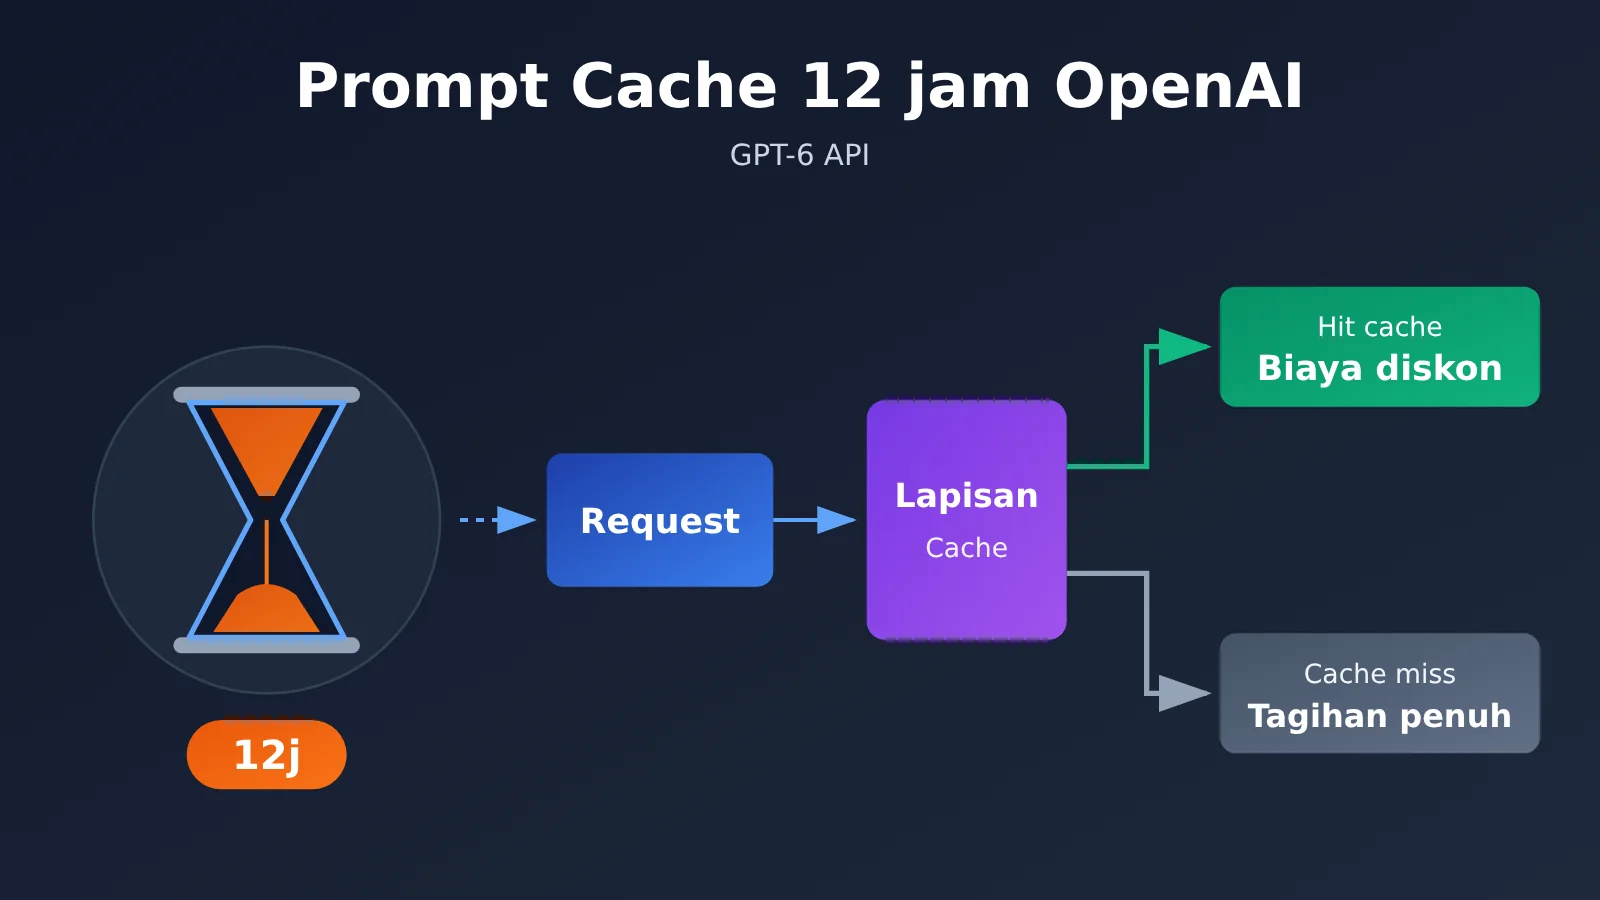
OpenAI menambahkan kemampuan retensi cache 12 jam pada Prompt Cache, dan bagi tim yang memanggil GPT-6 API ini adalah sinyal untuk menghitung ulang biaya. Sebelumnya cache biasanya hanya efektif dalam waktu idle beberapa menit, sehingga banyak permintaan berfrekuensi rendah sama sekali tidak mendapat diskon; sekarang jendela cache lebih panjang, dan banyak permintaan yang “baru kembali beberapa jam kemudian” juga berpeluang mengalami hit.
Ini bukan bahasa pemasaran “aktifkan cache otomatis hemat setengah”. Apakah cache menghemat biaya bergantung pada apakah prefix stabil, seberapa panjang interval antarpermintaan, seberapa besar prefix per permintaan, dan apakah penulisan cache memiliki biaya tambahan. Artikel ini menggunakan rumus titik impas sederhana untuk membantu Anda menilai apakah bisnis Anda sebaiknya mengaktifkan cache 12 jam.
Nilai inti: Pahami perubahan mekanisme Prompt Cache 12 jam dalam 5 menit, dan pelajari cara menggunakan 5 kriteria untuk menilai kapan cache GPT-6 API benar-benar menghemat biaya.
Ringkasan Cepat Informasi Inti Prompt Cache 12 Jam dari OpenAI
Mari kita rapikan dulu informasi kunci dari pembaruan kali ini lewat satu tabel. Karena harga dan parameter resmi bisa terus berubah, bagian yang menyangkut rasio penagihan dalam tabel ini mengacu pada dokumentasi dan halaman harga resmi OpenAI.
| Item informasi | Detail |
|---|---|
| Isi pembaruan | Prompt Cache menambahkan opsi retensi cache 12 jam |
| Pihak yang merilis | OpenAI |
| Model terkait | GPT-6 API dan model lain yang mendukung Prompt Caching (mengacu pada daftar model resmi) |
| Logika penagihan | Token input yang kena cache ditagih dengan harga satuan lebih rendah dari input biasa; diskon spesifik mengacu pada halaman harga resmi |
| Perubahan inti | Cache diperpanjang dari “kedaluwarsa saat idle dalam hitungan menit” menjadi retensi hingga 12 jam |
| Cakupan dampak | Prompt sistem yang panjang, definisi tool Agent, pengetahuan tetap RAG, percakapan multi-giliran, dan skenario serupa |
Cara Kerja Prompt Cache
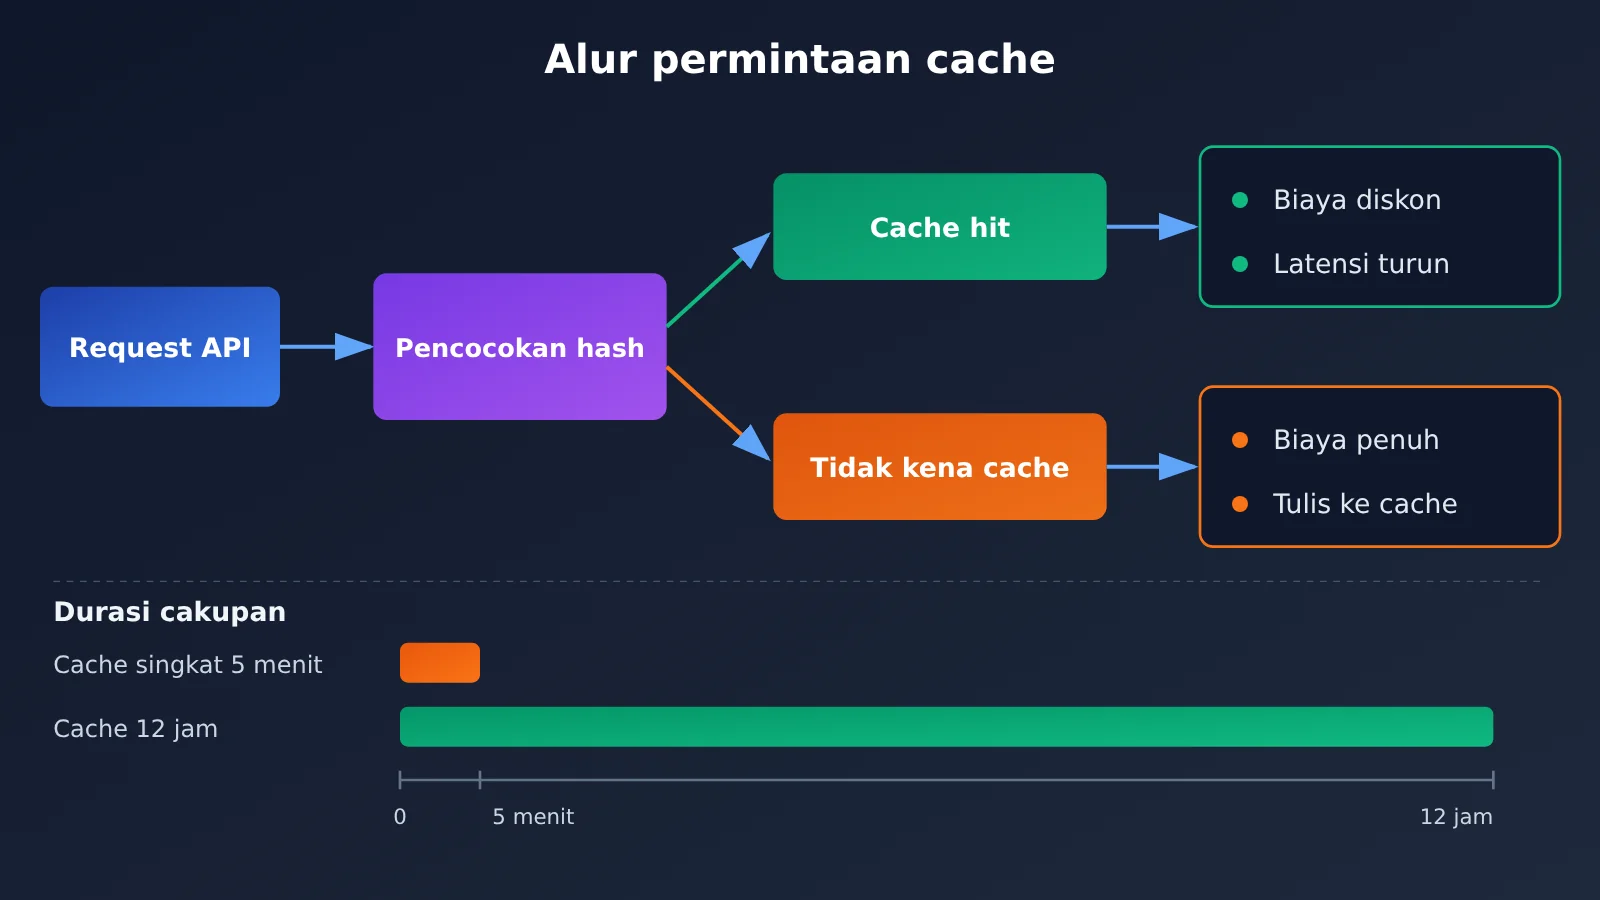
Prompt Caching dari OpenAI bekerja berdasarkan mekanisme “pencocokan prefiks”. Ketika bagian awal permintaan (prompt sistem, definisi tool, dokumen tetap, dan sejenisnya) persis sama dengan salah satu permintaan sebelumnya, dan panjangnya mencapai ambang minimum yang ditetapkan resmi, token bagian itu akan dikenali sebagai cache hit. Token tersebut ditagih dengan harga diskon, dan latensi token pertama juga turun cukup signifikan.
Yang perlu diperhatikan khusus: cache hanya mengenali bagian yang “konsisten secara berurutan mulai dari token pertama”. Begitu ada satu timestamp atau user ID yang disisipkan di tengah prefiks, seluruh isi setelahnya tidak akan bisa kena cache. Karena itu, desain struktur prompt lebih penting daripada sekadar “mengaktifkan cache atau tidak”: konten statis diletakkan di depan, konten dinamis di belakang.
Perbedaan Cache 12 Jam dengan Cache Pendek
Cache pendek di masa lalu akan terhapus setelah idle beberapa menit, sehingga hanya permintaan berfrekuensi tinggi dan beruntun yang bisa stabil kena cache. Retensi 12 jam memperluas “jendela cache hit” dari hitungan menit menjadi setengah hari, dan ini langsung mengubah struktur biaya pada skenario frekuensi rendah.
| Dimensi perbandingan | Cache pendek default | Cache 12 jam |
|---|---|---|
| Durasi retensi | Kedaluwarsa setelah idle dalam hitungan menit | Maksimal sekitar 12 jam |
| Frekuensi permintaan yang cocok | Permintaan frekuensi tinggi dan beruntun | Permintaan frekuensi menengah-rendah dan intermiten |
| Skenario yang biasanya mendapat manfaat | Layanan pelanggan real-time, pemanggilan beruntun secara batch | Pengguna yang kembali ke sesi setelah beberapa jam, tugas terjadwal dalam satu hari |
| Stabilitas hit rate | Sangat terpengaruh fluktuasi trafik | Lebih bersahabat pada periode trafik rendah |
| Biaya tambahan | Biasanya tidak ada biaya tambahan penulisan | Ada atau tidaknya biaya tambahan mengacu pada penjelasan resmi |
Kapan Cache API GPT-6 Benar-Benar Menghemat Biaya: Rumus Titik Impas
Banyak artikel hanya mengatakan “cache bisa menghemat biaya”, tetapi tidak menjelaskan berapa besar penghematannya dan dalam kondisi apa penghematan itu terjadi. Berikut ini kita kuantifikasi masalahnya dengan rumus umum; Anda hanya perlu memasukkan parameter bisnis Anda sendiri.
Penurunan Rumus Titik Impas Cache Prompt
Tetapkan variabel berikut:
L: jumlah token prefix yang dapat di-cacheP: harga satuan input regulerd: rasio harga satuan cache hit terhadap harga reguler (0 < d < 1)w: rasio biaya tambahan untuk penulisan pertama ke cache (saat tidak ada biaya tambahan, w = 0)N: jumlah pemanggilan prefix yang sama selama masa berlaku cache
Tanpa menggunakan cache, total biaya prefix adalah N × L × P. Dengan menggunakan cache, pemanggilan pertama ditagih berdasarkan biaya penulisan, sedangkan pemanggilan berikutnya ditagih berdasarkan harga cache hit, sehingga total biayanya adalah L × P × (1 + w) + (N − 1) × L × P × d.
Dengan mengurangkan keduanya, kita mendapatkan syarat titik impas yang sangat ringkas: N > 1 + w / (1 − d). Rumus ini menunjukkan dua hal: jika penulisan tidak memiliki biaya tambahan (w = 0), maka selama prefix yang sama digunakan ulang satu kali dalam masa berlaku cache, penghematan sudah mulai terjadi; jika penulisan memiliki biaya tambahan, jumlah penggunaan ulang harus melewati ambang tertentu agar mencapai titik impas, dan semakin besar diskonnya (semakin kecil d), semakin cepat titik impas tercapai.
Perhitungan Titik Impas untuk Berbagai Skenario
Berikut adalah perhitungan ilustratif dengan “parameter asumsi”, yang hanya digunakan untuk menjelaskan cara menggunakan rumus dan tidak mewakili harga aktual OpenAI. Kita mengasumsikan harga cache hit adalah proporsi tertentu dari harga reguler, lalu mengamati jumlah pemanggilan yang dibutuhkan untuk mencapai titik impas dengan dan tanpa biaya tambahan penulisan.
| Asumsi skenario | Biaya tambahan penulisan w | Diskon cache hit d | Jumlah pemanggilan yang dibutuhkan untuk titik impas N | Kesimpulan |
|---|---|---|---|---|
| Tanpa biaya tambahan penulisan | 0 | Berapa pun | N > 1 | Hemat biaya setelah 1 kali penggunaan ulang |
| Biaya tambahan penulisan kecil | Relatif rendah | Diskon besar | Sekitar 2 kali | Menguntungkan di hampir semua skenario |
| Biaya tambahan penulisan lebih tinggi | Relatif tinggi | Diskon kecil | Lebih dari 3 kali | Hanya menguntungkan untuk skenario dengan penggunaan ulang tinggi |
Dari perhitungan tersebut terlihat bahwa nilai sebenarnya dari cache 12 jam bukan terletak pada “diskonnya sendiri”, melainkan pada kemampuannya membuat N menjadi lebih besar. Permintaan yang semula hanya datang beberapa jam sekali, dengan cache pendek nilai N umumnya mendekati 1 sehingga sama sekali tidak bisa disebut hemat; setelah diperpanjang menjadi 12 jam, prefix yang sama digunakan ulang beberapa kali dalam sehari, barulah efek penghematan benar-benar terasa.
🚀 Mulai cepat: Ingin memverifikasi rumus titik impas pada trafik nyata? Disarankan menggunakan APIYI apiyi.com dengan kunci API yang sama untuk membandingkan cache hit pada berbagai model. Platform ini menggunakan antarmuka yang kompatibel dengan OpenAI, dan pengguna baru bisa mendapatkan kuota uji coba gratis.
Cara memverifikasi hit Prompt Cache di GPT-6 API
Cara paling andal untuk menilai apakah cache benar-benar menghemat biaya adalah membaca field usage pada respons. Antarmuka yang kompatibel dengan OpenAI akan mengembalikan jumlah token yang hit cache pada permintaan tersebut di usage.prompt_tokens_details.cached_tokens; dari situ Anda bisa menghitung hit rate sebenarnya.
Contoh minimal
Kode berikut mengirim dua permintaan berturut-turut dengan prefix yang sama; perhatikan apakah cached_tokens pada permintaan kedua lebih besar dari 0:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI antarmuka terpadu, kompatibel OpenAI
)

SYSTEM_PROMPT = "Anda adalah konsultan teknis senior... (di sini letakkan petunjuk panjang tetap yang melewati ambang minimum cache)"

for i in range(2):
    resp = client.chat.completions.create(
        model="gpt-6",  # Sesuaikan dengan nama aktual di daftar model platform
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": f"Pertanyaan ke-{i+1}: bagaimana mengoptimalkan biaya API?"}
        ]
    )
    cached = resp.usage.prompt_tokens_details.cached_tokens
    print(f"Permintaan ke-{i+1}, jumlah token cache yang hit: {cached}")
Lihat kode implementasi lengkap (termasuk statistik hit rate dan cache routing key)
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class CacheStats:
    total_prompt: int = 0
    total_cached: int = 0
    records: list = field(default_factory=list)

    def add(self, prompt_tokens: int, cached_tokens: int):
        self.total_prompt += prompt_tokens
        self.total_cached += cached_tokens
        self.records.append((prompt_tokens, cached_tokens))

    @property
    def hit_rate(self) -> float:
        if self.total_prompt == 0:
            return 0.0
        return self.total_cached / self.total_prompt


def build_messages(static_prefix: str, user_input: str) -> list:
    """Konten statis di paling depan, konten dinamis di paling belakang, agar prefix tetap stabil"""
    return [
        {"role": "system", "content": static_prefix},
        {"role": "user", "content": user_input},
    ]


def ask(static_prefix: str, user_input: str, cache_key: str, stats: CacheStats,
        model: str = "gpt-6") -> str:
    resp = client.chat.completions.create(
        model=model,
        messages=build_messages(static_prefix, user_input),
        # prompt_cache_key membantu permintaan dengan prefix sama dirutekan ke cache yang sama
        # Jika ingin mengaktifkan retensi 12 jam, tambahkan parameter terkait sesuai dokumentasi resmi OpenAI
        extra_body={"prompt_cache_key": cache_key},
    )
    usage = resp.usage
    cached = getattr(usage.prompt_tokens_details, "cached_tokens", 0) or 0
    stats.add(usage.prompt_tokens, cached)
    return resp.choices[0].message.content


if __name__ == "__main__":
    stats = CacheStats()
    prefix = open("system_prompt.txt", encoding="utf-8").read()
    questions = ["Bagaimana merancang prompt yang ramah cache?", "Di mana definisi tool sebaiknya diletakkan?", "Bagaimana menghitung hit rate?"]

    for q in questions:
        ask(prefix, q, cache_key="kb-v1", stats=stats)

    print(f"Hit rate cache keseluruhan: {stats.hit_rate:.1%}")
    for idx, (p, c) in enumerate(stats.records, 1):
        print(f"Permintaan {idx}: prompt={p}, cached={c}")
Saran: Coba dulu dengan trafik rendah selama satu hari, catat hit rate keseluruhan dan distribusi jarak antarpermintaan, baru tentukan apakah akan mengaktifkan cache 12 jam secara penuh di lingkungan produksi. Dapatkan kuota pengujian melalui APIYI apiyi.com untuk melakukan verifikasi semacam ini, tanpa perlu membuka beberapa akun resmi secara terpisah.
5 Kriteria Hemat Biaya untuk Prompt Cache 12 Jam
Jika rumus titik impas diterapkan ke bisnis nyata, dapat dirangkum menjadi 5 kriteria berikut. Semakin banyak kriteria yang terpenuhi, semakin jelas manfaat mengaktifkan cache 12 jam.
- Prefiks cukup panjang: Bagian tetap yang dapat di-cache harus mencapai ambang minimum resmi, dan semakin panjang prefiksnya, semakin besar total diskonnya. Petunjuk singkat berisi ratusan token, meskipun mengenai cache, penghematan biayanya tetap terbatas.
- Prefiks cukup stabil: System prompt, definisi tool, dan urutan schema tetap sama sepanjang hari. Perubahan prompt yang terlalu sering membuat cache berulang kali tidak berlaku.
- Interval permintaan masih dalam 12 jam: Jika prefiks yang sama dipanggil setiap beberapa puluh menit hingga beberapa jam, di sinilah nilai tambah terbesar cache 12 jam dibandingkan cache pendek.
- Frekuensi penggunaan ulang melebihi ambang titik impas: Hitung dengan
N > 1 + w / (1 − d)dan pastikan frekuensi penggunaan ulang dalam sehari secara konsisten berada di atas ambang. - Porsi biaya input tinggi: Jika tagihan Anda sebagian besar berasal dari token output, cache hanya mengoptimalkan sisi input, sehingga penurunan keseluruhan akan terencerkan.
Kesesuaian cache 12 jam untuk berbagai skenario bisnis
| Skenario bisnis | Ciri interval permintaan | Efek cache pendek | Nilai tambah cache 12 jam |
|---|---|---|---|
| Chatbot layanan pelanggan real-time | Frekuensi tinggi dan berkelanjutan | Sudah cukup baik | Biasa saja, terutama untuk menutup periode traffic rendah |
| RAG basis pengetahuan perusahaan | Frekuensi sedang, prefiks dokumen tetap | Fluktuasi cukup besar | Jelas, pengetahuan tetap digunakan ulang beberapa kali dalam sehari |
| Sesi Agent coding | Pengguna kembali ke sesi secara berkala | Sering tidak berlaku | Sangat tinggi, konteks panjang digunakan ulang lintas jam |
| Pemrosesan batch terjadwal harian | Satu batch setiap beberapa jam | Praktis tidak efektif | Sangat tinggi, templat yang sama dipakai untuk beberapa batch per hari |
| Analisis dokumen panjang sekali pakai | Hanya dipanggil sekali | Tidak efektif | Hampir tidak ada, N = 1 tidak mencapai titik impas |
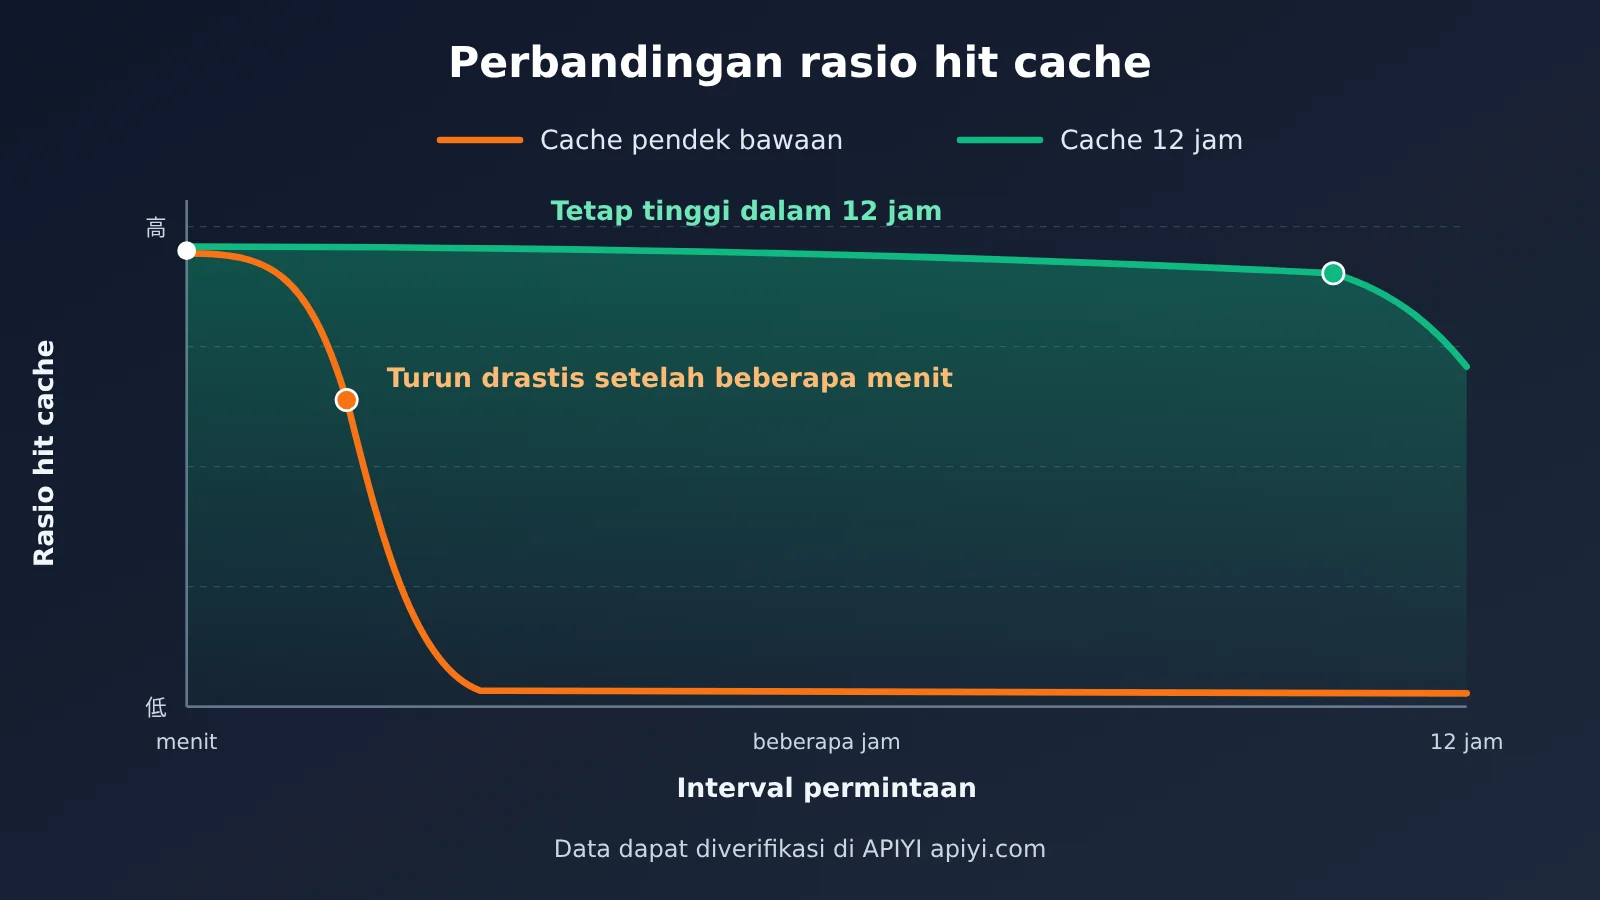
Penjelasan perbandingan: Grafik di atas menunjukkan perbedaan tren tingkat cache hit dari dua strategi cache pada interval permintaan yang berbeda. Tingkat cache hit aktual bergantung pada stabilitas prefiks dan distribusi traffic Anda; sebaiknya bandingkan dengan log permintaan nyata Anda sendiri.
Analisis Dampak Prompt Cache 12 Jam OpenAI
Dampak bagi Developer
- Rekayasa prompt perlu naik level menjadi “rekayasa cache”: petunjuk sistem, definisi tool, dan pengetahuan tetap perlu disusun menjadi blok prefiks yang stabil, dengan manajemen versi eksplisit agar perubahan kecil tidak membuat seluruh cache invalid.
- Evaluasi biaya bergeser dari “harga satuan” ke “harga satuan efektif”: dengan GPT-6 API yang sama, tim dengan hit rate tinggi dan rendah bisa punya biaya aktual per seribu permintaan yang jauh berbeda. Pemantauan
cached_tokenssebaiknya jadi metrik rutin. - Agent dengan konteks panjang makin layak: konteks asisten pemrograman dan Agent riset sering sangat panjang. Dulu, saat pengguna pergi sebentar lalu kembali, konteks harus dihitung ulang dengan harga penuh. Sekarang, pemakaian ulang lintas jam membuat sesi panjang jauh lebih ekonomis.
- Latensi ikut membaik: permintaan yang kena cache punya latensi token pertama lebih rendah. Ini nilai tambah bagi produk yang sensitif terhadap pengalaman interaksi.
Dampak bagi Industri
- Cache menjadi dimensi persaingan dalam penetapan harga model: vendor utama menawarkan solusi cache petunjuk masing-masing. Durasi penyimpanan, besaran diskon, dan ada tidaknya biaya penulisan kini menjadi pertimbangan penting saat developer memilih.
- Nilai perbandingan multi-model di platform agregator meningkat: aturan cache tiap vendor cukup berbeda. Membandingkan tagihan aktual secara berdampingan lewat antarmuka terpadu lebih bermakna daripada hanya melihat harga resmi.
- Arsitektur RAG mungkin dievaluasi ulang: ketika prefiks dokumen panjang bisa dipakai ulang dengan biaya rendah selama setengah hari, sebagian skenario basis pengetahuan skala kecil-menengah mungkin beralih dari “potongan retrieval” ke “masukkan seluruh bagian ke konteks + cache”.
Referensi Pemilihan Solusi Cache Multi-Model
| Jenis model | Karakteristik cache (mengacu dokumentasi resmi masing-masing) | Skenario penggunaan | Platform yang tersedia |
|---|---|---|---|
| GPT-6 API | Cache prefiks otomatis, kini ada opsi penyimpanan 12 jam | Petunjuk sistem panjang, sesi Agent | APIYI apiyi.com, OpenAI resmi |
| Seri Claude | Perlu menandai breakpoint cache secara eksplisit, mendukung durasi penyimpanan berbeda | Skenario yang butuh kontrol presisi atas lokasi cache | APIYI, Anthropic resmi |
| Seri Gemini | Mendukung cache konteks implisit dan eksplisit | Dokumen sangat panjang, konteks multimodal | APIYI, Google resmi |
💡 Saran pemilihan: Aturan cache antar model cukup berbeda. Sebaiknya uji hit rate dan tagihan secara nyata menggunakan prompt bisnis yang sama di beberapa model, lalu ambil keputusan dengan mempertimbangkan kualitas hasilnya.
FAQ Umum
Q1: Apa itu OpenAI Prompt Cache 12 jam?
Ini adalah opsi penyimpanan yang diperpanjang dari mekanisme Prompt Caching OpenAI. Permintaan dengan prefix yang sama masih memiliki peluang untuk mengenai cache hingga sekitar 12 jam. Token input pada bagian yang mengenai cache ditagih dengan harga diskon, dan latensi token pertama juga bisa berkurang.
Q2: Apa perbedaan antara cache 12 jam dan cache pendek bawaan?
Cache pendek bawaan akan kedaluwarsa setelah beberapa menit menganggur, jadi hanya cocok untuk permintaan beruntun dengan frekuensi tinggi. Sementara cache 12 jam mencakup permintaan dengan frekuensi rendah hingga menengah yang bersifat intermiten. Untuk skenario frekuensi tinggi seperti layanan pelanggan real-time, perbedaannya tidak terlalu besar. Namun untuk skenario dengan jeda beberapa jam seperti sesi Agent atau pemrosesan batch terjadwal, manfaat tambahan dari cache 12 jam terasa jelas.
Q3: Apakah mengaktifkan cache 12 jam pasti menghemat biaya?
Belum tentu. Jika penulisan cache tidak dikenakan biaya tambahan, penghematan mulai terjadi begitu prefix yang sama digunakan ulang satu kali dalam masa berlaku. Jika ada biaya tambahan, Anda perlu menggunakan ulang lebih dari `1 + w / (1 − d)` kali agar modalnya kembali. Untuk pemanggilan sekali pakai, prefix yang sering berubah, atau prefix yang sangat pendek, manfaatnya sangat terbatas.
Q4: Bagaimana cara meningkatkan tingkat cache hit pada GPT-6 API?
Prinsip intinya adalah “yang statis di depan, yang dinamis di belakang”:
– Letakkan system prompt, definisi tool, dan dokumen tetap di bagian paling awal pesan, serta jaga urutannya tidak berubah
– Letakkan konten dinamis seperti timestamp, user ID, dan hasil retrieval di bagian akhir
– Gunakan cache routing key yang tetap untuk jenis permintaan yang sama, agar peluang dirutekan ke cache yang sama meningkat
– Rilis perubahan prompt secara terpusat, hindari perubahan kecil yang sering dalam satu hari
Q5: Bagaimana cara cepat menguji efek cache 12 jam melalui API?
Sebaiknya gunakan platform agregasi API yang mendukung banyak model untuk pengujian:
1. Kunjungi APIYI apiyi.com untuk mendaftar akun
2. Dapatkan API Key dan kuota uji gratis
3. Gunakan contoh kode di artikel ini (ganti base_url menjadi `https://api.apiyi.com/v1`), lalu baca `cached_tokens` untuk menghitung tingkat cache hit
APIYI menggunakan antarmuka yang kompatibel dengan OpenAI, jadi satu Key saja sudah cukup untuk membandingkan performa cache GPT, Claude, dan Gemini.
Q6: Apa saja keterbatasan Prompt Cache yang diketahui?
Cache hanya berlaku untuk prefix berurutan yang mencapai ambang panjang minimum, dan hanya mengoptimalkan biaya sisi input; token output tidak mendapat diskon. Cache bersifat “best effort”, sehingga pada konkurensi tinggi atau saat rute trafik berubah bisa terjadi cache miss. Jangan menganggap tingkat cache hit sebagai jaminan 100%. Untuk detail cara penagihan dan model yang didukung pada retensi 12 jam, silakan merujuk ke dokumentasi resmi OpenAI.
Poin-Poin Utama Prompt Cache 12 Jam
- Inti mekanisme: Berbasis pencocokan awalan yang persis; token input yang cocok ditagih dengan harga diskon
- Perubahan inti: Masa simpan diperpanjang dari hitungan menit menjadi sekitar 12 jam, mencakup permintaan frekuensi rendah
- Rumus balik modal: Baru mulai menghemat ketika jumlah pemakaian ulang N > 1 + w / (1 − d)
- Skenario paling diuntungkan: Sesi panjang Agent, RAG basis pengetahuan, pemrosesan batch terjadwal dalam hari
- Skenario dengan manfaat terbatas: Pemanggilan sekali pakai, awalan pendek, petunjuk yang sering berganti versi
- Kunci implementasi: Konten statis diletakkan di depan, pantau rasio hit secara berkelanjutan dengan cached_tokens
- Cara verifikasi: Uji skala kecil dengan lalu lintas nyata melalui APIYI apiyi.com, baru kemudian aktifkan sepenuhnya
Kesimpulan
Dampak utama Prompt Cache 12 jam OpenAI terhadap biaya API GPT-6:
- Kunci penghematan adalah jumlah pemakaian ulang: Jendela 12 jam memungkinkan permintaan frekuensi rendah-menengah memakai ulang awalan yang sama berkali-kali; menaikkan N dari 1 adalah nilai tambah yang sesungguhnya.
- Biaya penulisan menentukan ambang balik modal: Tanpa biaya tambahan penulisan hampir pasti untung; jika ada biaya tambahan, hitung dengan rumus balik modal.
- Struktur prompt lebih penting daripada tombol on/off: Konten statis di depan, manajemen versi, dan pemantauan rasio hit-lah yang benar-benar mewujudkan diskon cache di tagihan.
Disarankan mulai dari skenario berpotensi untung besar seperti system prompt panjang dan sesi Agent, jalankan lalu lintas nyata selama sehari untuk melihat rasio hit, lalu tentukan cakupan penerapan menyeluruh. Direkomendasikan menyelesaikan perbandingan efek cache multi-model dengan cepat melalui APIYI apiyi.com; platform menyediakan kuota pengujian gratis dan antarmuka kompatibel OpenAI yang terpadu.
📚 Referensi
- Panduan Resmi OpenAI Prompt Caching: mekanisme caching, ambang minimum, dan penjelasan field usage
- Tautan:
platform.openai.com/docs/guides/prompt-caching -
Keterangan: sumber otoritatif untuk memahami aturan cache hit dan parameter durasi retensi terbaru
-
Halaman Harga OpenAI API: harga satuan input reguler, input cache, dan output untuk setiap model
- Tautan:
openai.com/api/pricing -
Keterangan: saat dimasukkan ke rumus ROI, gunakan harga real-time di halaman ini sebagai acuan
-
OpenAI API Reference: penjelasan parameter antarmuka Chat Completions dan Responses
- Tautan:
platform.openai.com/docs/api-reference - Keterangan: untuk mencari penggunaan spesifik parameter terkait cache seperti prompt_cache_key
Penulis: Tim Teknis APIYI
Diskusi teknis: Jangan ragu menghubungi kami di halaman utama situs APIYI untuk mendapatkan lebih banyak solusi integrasi model dan optimalisasi biaya