作者注:解讀 OpenAI 12 小時 Prompt Cache 對 GPT-6 API 成本的影響,用回本公式和 5 個判斷標準說明哪些場景開緩存能省錢、哪些場景收益有限。
OpenAI 爲 Prompt Cache 新增 12 小時緩存保留能力,這對調用 GPT-6 API 的團隊來說是一個值得重新覈算成本的信號。以前緩存通常只在幾分鐘的空閒時間內有效,很多低頻請求根本喫不到折扣;現在緩存窗口拉長,一大批”隔幾個小時纔回來”的請求也有機會命中。
這不是”開了緩存就自動省一半”的營銷話術。緩存是否省錢,取決於前綴是否穩定、請求間隔多長、單次前綴有多大,以及緩存寫入是否有額外成本。本文用一個簡單的回本公式,幫你判斷自己的業務到底該不該開 12 小時緩存。
核心價值:5 分鐘看懂 12 小時 Prompt Cache 的機制變化,學會用 5 個標準判斷 GPT-6 API 緩存什麼時候真正省錢。
OpenAI 12 小時 Prompt Cache 核心信息速覽
先用一張表把這次更新的關鍵信息梳理清楚。由於官方價格和參數會持續調整,表中涉及計費比例的部分都以 OpenAI 官方文檔和價格頁爲準。
| 信息項 | 詳情 |
|---|---|
| 更新內容 | Prompt Cache 新增 12 小時緩存保留選項 |
| 發佈方 | OpenAI |
| 涉及模型 | GPT-6 API 等支持 Prompt Caching 的模型(以官方模型列表爲準) |
| 計費邏輯 | 命中緩存的輸入 token 按低於常規輸入的單價計費,具體折扣以官方價格頁爲準 |
| 核心變化 | 緩存從”分鐘級空閒失效”延長到最長 12 小時保留 |
| 影響範圍 | 長系統提示詞、Agent 工具定義、RAG 固定知識、多輪對話等場景 |
Prompt Cache 是怎麼工作的
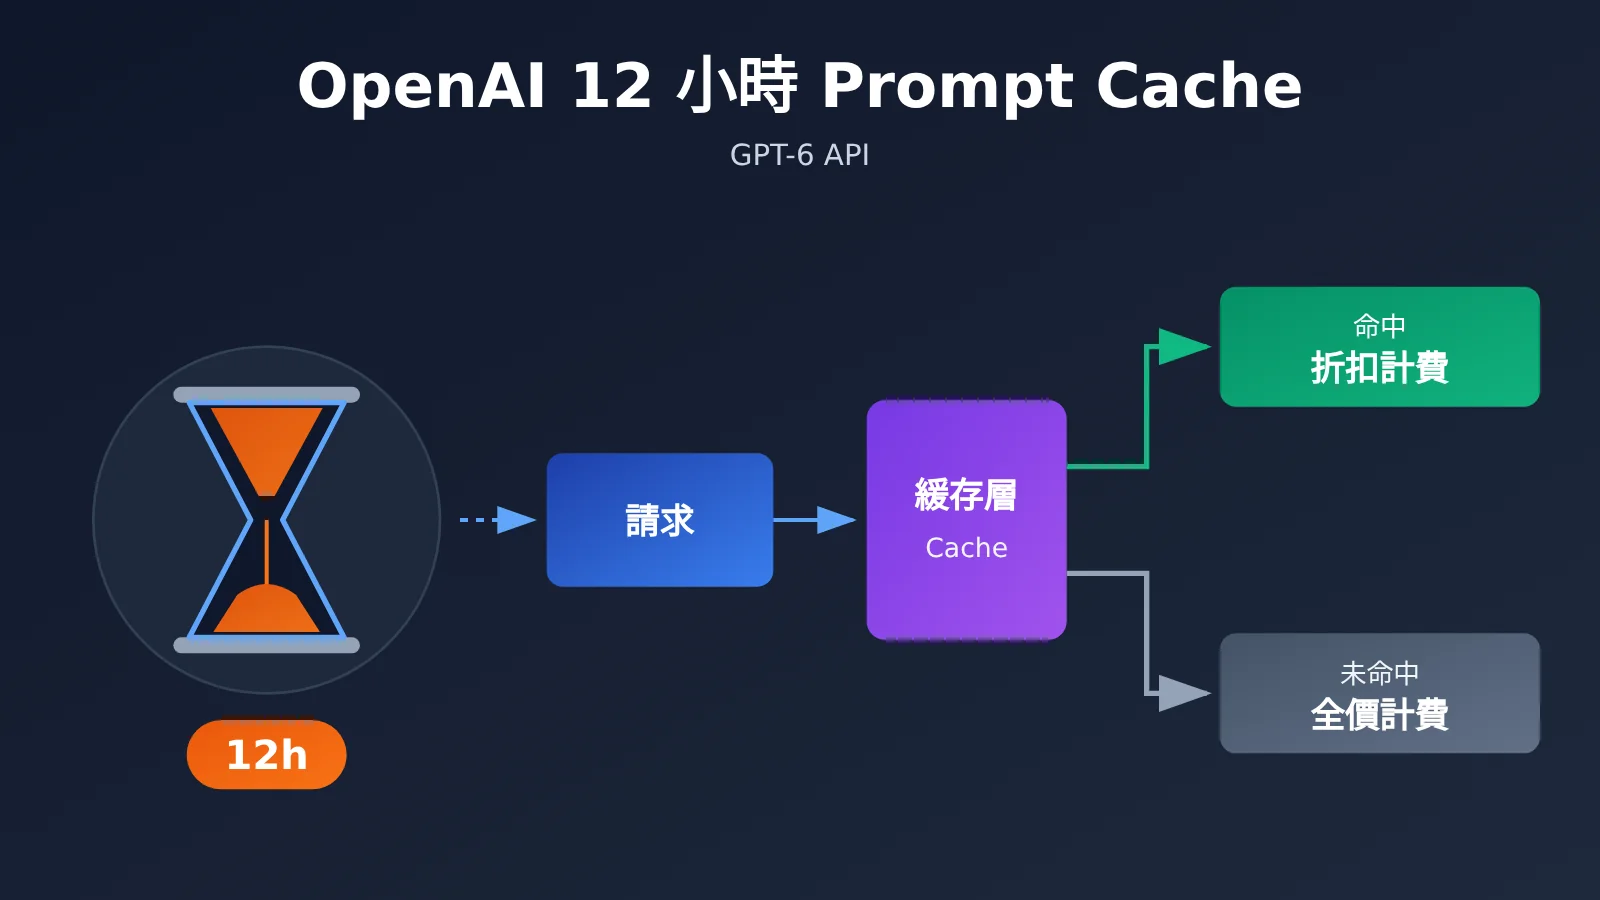
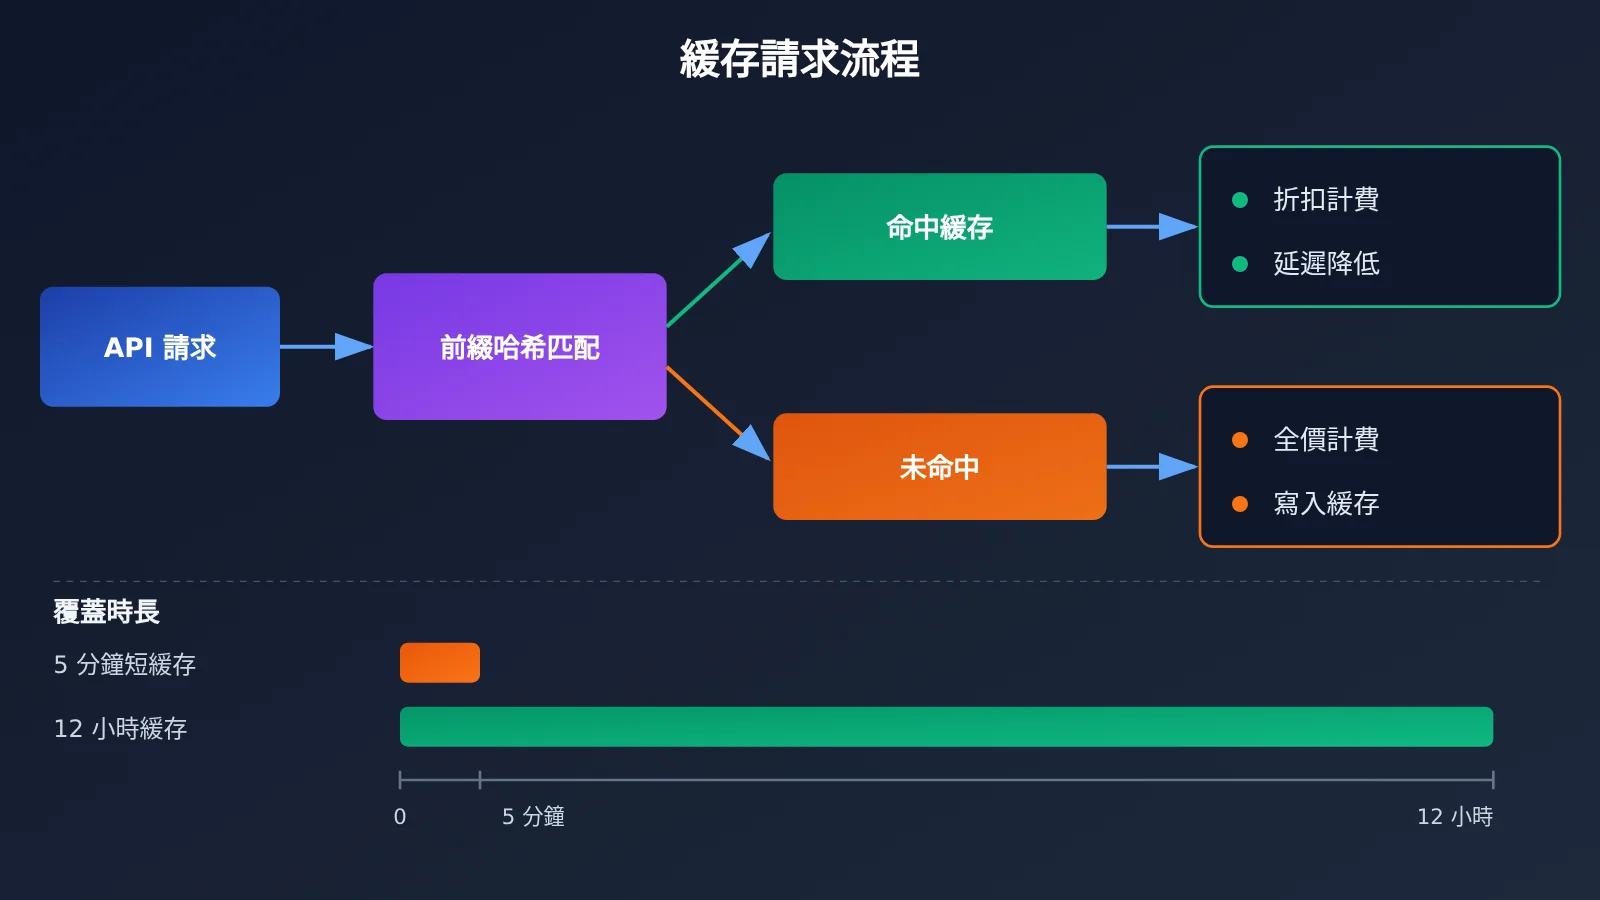
OpenAI 的 Prompt Caching 是基於”前綴匹配”的機制。當請求的開頭部分(系統提示詞、工具定義、固定文檔等)與近期某次請求完全一致,並且長度達到官方規定的最小閾值時,這部分 token 就會被識別爲緩存命中,按折扣價計費,同時首 token 延遲也會明顯降低。
需要特別注意的是,緩存只認”從第一個 token 開始連續一致”的部分。只要前綴中間插入了一個時間戳或用戶 ID,後面的內容就全部無法命中。因此 Prompt 結構設計比”開不開緩存”更重要:靜態內容放前面,動態內容放最後。
12 小時緩存與短緩存的區別
過去的短緩存在空閒幾分鐘後就會被清除,只有高頻、連續的請求才能穩定命中。12 小時保留則把”命中窗口”從分鐘級擴展到半天級,這直接改變了低頻場景的成本結構。
| 對比維度 | 默認短緩存 | 12 小時緩存 |
|---|---|---|
| 保留時長 | 分鐘級空閒後失效 | 最長約 12 小時 |
| 適合的請求頻率 | 高頻、連續請求 | 中低頻、間歇性請求 |
| 典型受益場景 | 實時客服、批量連續調用 | 用戶隔數小時回到會話、日內定時任務 |
| 命中率穩定性 | 受流量波動影響大 | 對流量低谷更友好 |
| 額外成本 | 通常無寫入附加費 | 是否有附加費以官方說明爲準 |
GPT-6 API 緩存什麼時候真正省錢:回本公式
很多文章只說”緩存能省錢”,卻不講省多少、什麼條件下省。下面用一個通用公式把問題量化,你只需要代入自己的業務參數即可。
Prompt Cache 回本公式推導
設定以下變量:
L:可緩存前綴的 token 數P:常規輸入單價d:緩存命中單價相對常規單價的比例(0 < d < 1)w:首次寫入緩存的附加成本比例(無附加費時 w = 0)N:在緩存有效期內,同一前綴被調用的次數
不使用緩存時,前綴總成本是 N × L × P。使用緩存時,第一次按寫入成本計費,後續按命中價計費,總成本是 L × P × (1 + w) + (N − 1) × L × P × d。
兩者相減可以得到一個很簡潔的回本條件:N > 1 + w / (1 − d)。這個公式說明了兩件事:如果寫入沒有附加費(w = 0),只要同一前綴在有效期內被複用一次就開始省錢;如果寫入有附加費,複用次數需要超過一個閾值才能回本,而折扣越大(d 越小),回本越快。
不同場景的回本測算
下面用”假設參數”做一個示意測算,僅用於說明公式的用法,不代表 OpenAI 實際價格。我們假設緩存命中價爲常規價的一定比例,分別觀察有無寫入附加費時的回本次數。
| 場景假設 | 寫入附加費 w | 命中折扣 d | 回本所需調用次數 N | 結論 |
|---|---|---|---|---|
| 無寫入附加費 | 0 | 任意 | N > 1 | 複用 1 次即省錢 |
| 小額寫入附加費 | 較低 | 折扣較大 | 約 2 次 | 絕大多數場景都划算 |
| 較高寫入附加費 | 較高 | 折扣較小 | 3 次以上 | 只有高複用場景划算 |
從測算可以看出,12 小時緩存的真正價值不在於”折扣本身”,而在於讓 N 變大。原本幾小時纔來一次的請求,在短緩存下 N 基本等於 1,根本談不上省錢;拉長到 12 小時後,同一前綴在一天內被複用多次,省錢效果纔會真正體現。
🚀 快速開始:想在真實流量上驗證回本公式,推薦通過 API易 apiyi.com 用同一個 API Key 對比不同模型的緩存命中情況,平臺採用 OpenAI 兼容接口,新用戶可領取免費測試額度。
如何在 GPT-6 API 中驗證 Prompt Cache 命中
判斷緩存是否省錢,最可靠的方式是讀取響應裏的 usage 字段。OpenAI 兼容接口會在 usage.prompt_tokens_details.cached_tokens 中返回本次命中緩存的 token 數,你可以據此計算真實命中率。
極簡示例
下面的代碼連續發送兩次相同前綴的請求,觀察第二次的 cached_tokens 是否大於 0:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 統一接口,OpenAI 兼容
)

SYSTEM_PROMPT = "你是資深技術顧問……(此處放置超過最小緩存閾值的固定長提示詞)"

for i in range(2):
    resp = client.chat.completions.create(
        model="gpt-6",  # 以平臺模型列表中的實際名稱爲準
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": f"第 {i+1} 次提問:如何優化接口成本?"}
        ]
    )
    cached = resp.usage.prompt_tokens_details.cached_tokens
    print(f"第 {i+1} 次請求,命中緩存 token 數:{cached}")
查看完整實現代碼(含命中率統計與緩存路由鍵)
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class CacheStats:
    total_prompt: int = 0
    total_cached: int = 0
    records: list = field(default_factory=list)

    def add(self, prompt_tokens: int, cached_tokens: int):
        self.total_prompt += prompt_tokens
        self.total_cached += cached_tokens
        self.records.append((prompt_tokens, cached_tokens))

    @property
    def hit_rate(self) -> float:
        if self.total_prompt == 0:
            return 0.0
        return self.total_cached / self.total_prompt


def build_messages(static_prefix: str, user_input: str) -> list:
    """靜態內容放最前面,動態內容放最後,保證前綴穩定"""
    return [
        {"role": "system", "content": static_prefix},
        {"role": "user", "content": user_input},
    ]


def ask(static_prefix: str, user_input: str, cache_key: str, stats: CacheStats,
        model: str = "gpt-6") -> str:
    resp = client.chat.completions.create(
        model=model,
        messages=build_messages(static_prefix, user_input),
        # prompt_cache_key 幫助相同前綴的請求路由到同一緩存
        # 如需啓用 12 小時保留,請按 OpenAI 官方文檔添加對應參數
        extra_body={"prompt_cache_key": cache_key},
    )
    usage = resp.usage
    cached = getattr(usage.prompt_tokens_details, "cached_tokens", 0) or 0
    stats.add(usage.prompt_tokens, cached)
    return resp.choices[0].message.content


if __name__ == "__main__":
    stats = CacheStats()
    prefix = open("system_prompt.txt", encoding="utf-8").read()
    questions = ["如何設計緩存友好的 Prompt?", "工具定義應該放在哪裏?", "如何統計命中率?"]

    for q in questions:
        ask(prefix, q, cache_key="kb-v1", stats=stats)

    print(f"整體緩存命中率:{stats.hit_rate:.1%}")
    for idx, (p, c) in enumerate(stats.records, 1):
        print(f"請求 {idx}: prompt={p}, cached={c}")
建議:先在小流量上跑一天,統計整體命中率和請求間隔分佈,再決定是否在生產環境全面啓用 12 小時緩存。通過 API易 apiyi.com 獲取測試額度即可完成這類驗證,無需單獨開通多個官方賬號。
12 小時 Prompt Cache 的 5 個省錢判斷標準
把回本公式落到實際業務中,可以歸納爲下面 5 個判斷標準。滿足的條件越多,開啓 12 小時緩存的收益越明顯。
- 前綴足夠長:可緩存的固定部分要達到官方最小閾值,且越長折扣總額越大。幾百 token 的短提示詞即使命中,省下的錢也很有限。
- 前綴足夠穩定:系統提示詞、工具定義、Schema 順序在一天內保持不變。頻繁改版提示詞會讓緩存反覆失效。
- 請求間隔落在 12 小時內:如果同一前綴每隔幾十分鐘到幾小時被調用一次,這正是 12 小時緩存相比短緩存的最大增量收益區。
- 複用次數超過回本閾值:用
N > 1 + w / (1 − d)覈算,確認日內複用次數穩定高於閾值。 - 輸入成本佔比高:如果你的賬單主要來自輸出 token,緩存只優化輸入側,整體降幅會被稀釋。
不同業務場景的 12 小時緩存適配度
| 業務場景 | 請求間隔特徵 | 短緩存效果 | 12 小時緩存增量價值 |
|---|---|---|---|
| 實時客服機器人 | 高頻連續 | 已較好 | 一般,主要補齊流量低谷 |
| 企業知識庫 RAG | 中頻,固定文檔前綴 | 波動較大 | 明顯,日內多次複用固定知識 |
| 編程 Agent 會話 | 用戶間歇性回到會話 | 常常失效 | 很高,長上下文跨小時複用 |
| 日內定時批處理 | 每隔數小時一批 | 基本無效 | 很高,同一模板一天多批 |
| 一次性長文檔分析 | 只調用一次 | 無效 | 幾乎沒有,N = 1 無法回本 |
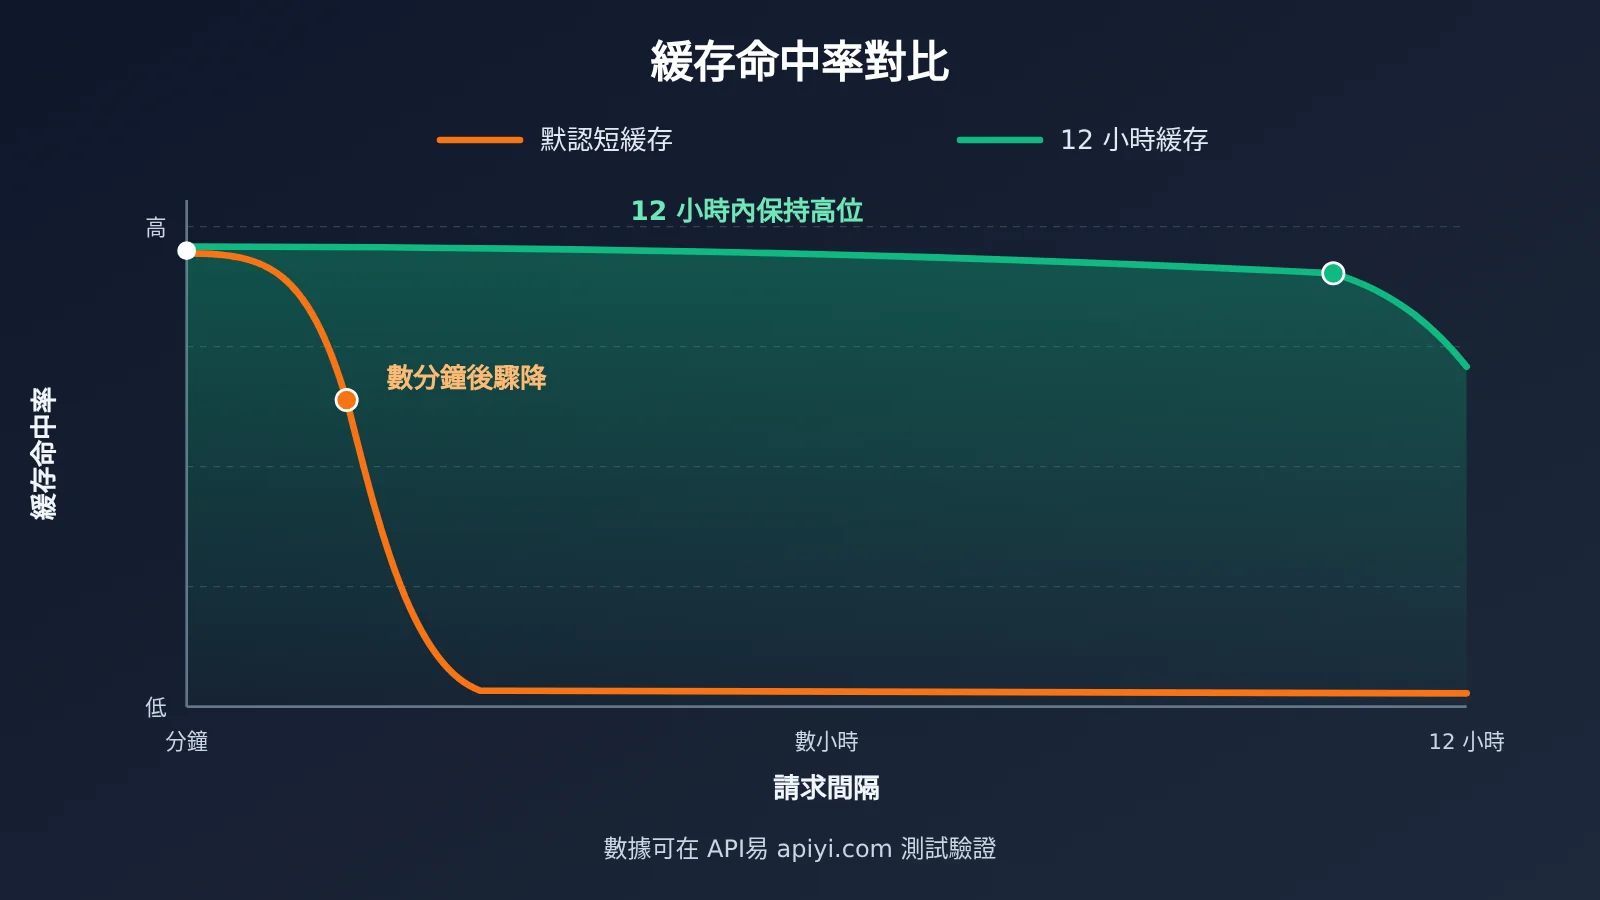
對比說明:上圖展示的是不同請求間隔下兩種緩存策略命中率的趨勢差異,實際命中率取決於你的前綴穩定性和流量分佈,建議用自己的真實請求日誌做對比。
OpenAI 12 小時 Prompt Cache 影響分析
對開發者的影響
- Prompt 工程要升級爲”緩存工程”:需要把系統提示詞、工具定義、固定知識整理成穩定的前綴塊,並對版本做顯式管理,避免小改動導致全量失效。
- 成本評估從”單價”轉向”有效單價”:同樣的 GPT-6 API,命中率高的團隊和命中率低的團隊,實際每千次請求成本可能差距明顯,監控 cached_tokens 應成爲常規指標。
- 長上下文 Agent 更可行:編程助手、研究型 Agent 的上下文往往很長,過去用戶離開一會兒再回來就要全價重算,現在跨小時複用讓長會話的經濟性顯著改善。
- 延遲同步改善:命中緩存的請求首 token 延遲更低,對交互體驗敏感的產品是額外收益。
對行業的影響
- 緩存成爲模型定價的競爭維度:主流廠商都在提供各自的提示詞緩存方案,保留時長、折扣力度、是否收寫入費,正在成爲開發者選型時的重要參考。
- 聚合平臺的多模型對比價值上升:不同廠商的緩存規則差異較大,統一接口下橫向對比實際賬單,比只看官方標價更有參考意義。
- RAG 架構可能被重新評估:當長文檔前綴可以低成本複用半天,部分中小規模知識庫場景可能從”檢索切片”轉向”整段放入上下文 + 緩存”。
多模型緩存方案選型參考
| 模型方向 | 緩存特點(以各家官方文檔爲準) | 適用場景 | 可用平臺 |
|---|---|---|---|
| GPT-6 API | 自動前綴緩存,新增 12 小時保留選項 | 長系統提示詞、Agent 會話 | API易 apiyi.com、OpenAI 官方 |
| Claude 系列 | 需顯式標記緩存斷點,支持不同保留時長 | 精細控制緩存位置的場景 | API易、Anthropic 官方 |
| Gemini 系列 | 支持隱式與顯式上下文緩存 | 超長文檔、多模態上下文 | API易、Google 官方 |
💡 選擇建議:不同模型的緩存規則差異較大,建議用同一份業務 Prompt 在多個模型上實測命中率與賬單,再結合效果做決策。
常見問題 FAQ
Q1:什麼是 OpenAI 12 小時 Prompt Cache?
它是 OpenAI Prompt Caching 機制的延長保留選項。相同前綴的請求在最長約 12 小時內都有機會命中緩存,命中部分的輸入 token 按折扣價計費,並能降低首 token 延遲。
Q2:12 小時緩存和默認短緩存有什麼區別?
默認短緩存在空閒幾分鐘後就會失效,只適合高頻連續請求;12 小時緩存則覆蓋了中低頻、間歇性的請求。對實時客服這類高頻場景,兩者差別不大;對 Agent 會話、定時批處理這類間隔數小時的場景,12 小時緩存的增量收益明顯。
Q3:開啓 12 小時緩存一定能省錢嗎?
不一定。如果寫入緩存沒有附加費,同一前綴在有效期內被複用一次就開始省錢;如果有附加費,需要複用次數超過 `1 + w / (1 − d)` 才能回本。一次性調用、前綴頻繁變化、前綴很短的場景,收益都非常有限。
Q4:如何提高 GPT-6 API 的緩存命中率?
核心原則是”靜態在前、動態在後”:
– 系統提示詞、工具定義、固定文檔放在消息最前面,並保持順序不變
– 時間戳、用戶 ID、檢索結果等動態內容放在最後
– 對同一類請求使用固定的緩存路由鍵,提升路由到同一緩存的概率
– 提示詞改版集中發佈,避免日內頻繁小改
Q5:如何通過 API 快速測試 12 小時緩存效果?
推薦使用支持多模型的 API 聚合平臺進行測試:
1. 訪問 API易 apiyi.com 註冊賬號
2. 獲取 API Key 和免費測試額度
3. 使用本文代碼示例(base_url 替換爲 `https://api.apiyi.com/v1`),讀取 `cached_tokens` 統計命中率
API易 採用 OpenAI 兼容接口,一個 Key 即可對比 GPT、Claude、Gemini 的緩存表現。
Q6:Prompt Cache 有哪些已知限制?
緩存只對達到最小長度閾值的連續前綴生效,且只優化輸入側成本,輸出 token 不打折。緩存屬於”盡力而爲”機制,高併發或流量路由變化時可能出現未命中,不宜把命中率當作 100% 保證。12 小時保留的具體計費方式和支持模型,請以 OpenAI 官方文檔爲準。
12 小時 Prompt Cache 核心要點 Key Takeaways
- 機制本質:基於前綴完全匹配,命中部分輸入 token 按折扣價計費
- 核心變化:保留時長從分鐘級延長到約 12 小時,覆蓋低頻請求
- 回本公式:複用次數 N > 1 + w / (1 − d) 纔開始省錢
- 最大受益場景:Agent 長會話、知識庫 RAG、日內定時批處理
- 收益有限場景:一次性調用、短前綴、頻繁改版的提示詞
- 落地關鍵:靜態內容前置,用 cached_tokens 持續監控命中率
- 驗證方式:通過 API易 apiyi.com 用真實流量小規模測試後再全量啓用
總結
OpenAI 12 小時 Prompt Cache 對 GPT-6 API 成本的核心影響:
- 省錢的關鍵是複用次數:12 小時窗口讓中低頻請求也能多次複用同一前綴,把 N 從 1 拉高才是真正的增量價值。
- 寫入成本決定回本門檻:沒有寫入附加費時幾乎穩賺,有附加費時要用回本公式覈算。
- Prompt 結構比開關更重要:靜態前置、版本管理、命中率監控,才能把緩存摺扣真正兌現到賬單上。
建議先從長系統提示詞和 Agent 會話這類高收益場景入手,跑一天真實流量看命中率,再決定全面推廣的範圍。推薦通過 API易 apiyi.com 快速完成多模型緩存效果對比,平臺提供免費測試額度和統一的 OpenAI 兼容接口。
📚 參考資料
- OpenAI Prompt Caching 官方指南:緩存機制、最小閾值與 usage 字段說明
- 鏈接:
platform.openai.com/docs/guides/prompt-caching -
說明: 瞭解緩存命中規則和最新保留時長參數的權威來源
-
OpenAI API 價格頁:各模型常規輸入、緩存輸入與輸出單價
- 鏈接:
openai.com/api/pricing -
說明: 代入回本公式時,以此頁面的實時價格爲準
-
OpenAI API Reference:Chat Completions 與 Responses 接口參數說明
- 鏈接:
platform.openai.com/docs/api-reference - 說明: 查詢 prompt_cache_key 等緩存相關參數的具體用法
作者: APIYI 技術團隊
技術交流: 歡迎在 API易 網站首頁聯繫我們,獲取更多模型接入與成本優化方案