Nota del autor: un análisis del impacto del Prompt Cache de 12 horas de OpenAI en el costo de la API de GPT-6, con una fórmula de retorno de la inversión y 5 criterios para identificar en qué escenarios activar el caché ahorra dinero y en cuáles el beneficio es limitado.
OpenAI añadió a Prompt Cache la capacidad de retener el caché durante 12 horas, y para los equipos que invocan la API de GPT-6 es una señal clara de que toca recalcular costos. Antes el caché solía vivir apenas unos minutos de inactividad, así que muchas solicitudes de baja frecuencia ni siquiera llegaban al descuento; ahora, con una ventana mucho más amplia, un montón de peticiones que «vuelven cada varias horas» también tienen oportunidad de acertar en caché.
Esto no es el discurso de marketing de «activa el caché y ahorras la mitad automáticamente». Que el caché ahorre dinero depende de si el prefijo es estable, de cuánto tiempo pasa entre solicitudes, de qué tan grande es el prefijo en cada llamada y de si la escritura del caché tiene un costo adicional. En este artículo usamos una fórmula sencilla de retorno de la inversión para ayudarte a decidir si tu negocio realmente debería activar el caché de 12 horas.
Valor clave: en 5 minutos entiendes qué cambia en el mecanismo del Prompt Cache de 12 horas y aprendes a usar 5 criterios para saber cuándo el caché de la API de GPT-6 realmente te ahorra dinero.
Resumen rápido de los puntos clave del Prompt Cache de 12 horas de OpenAI
Empecemos con una tabla para dejar claros los puntos clave de esta actualización. Como los precios y parámetros oficiales se ajustan de forma continua, cualquier proporción de facturación que aparezca en la tabla se rige por la documentación oficial y la página de precios de OpenAI.
| Elemento | Detalle |
|---|---|
| Contenido de la actualización | Prompt Cache añade una opción de retención de caché de 12 horas |
| Quién lo publica | OpenAI |
| Modelos afectados | Modelos compatibles con Prompt Caching, como la API de GPT-6 (según la lista oficial de modelos) |
| Lógica de facturación | Los tokens de entrada que aciertan en la caché se facturan a un precio unitario inferior al de la entrada normal; el descuento exacto se rige por la página de precios oficial |
| Cambio principal | La caché pasa de «caducar tras minutos de inactividad» a conservarse hasta 12 horas |
| Alcance del impacto | Escenarios como indicaciones de sistema largas, definiciones de herramientas de agentes, conocimiento fijo de RAG y conversaciones de múltiples turnos |
Cómo funciona el Prompt Cache
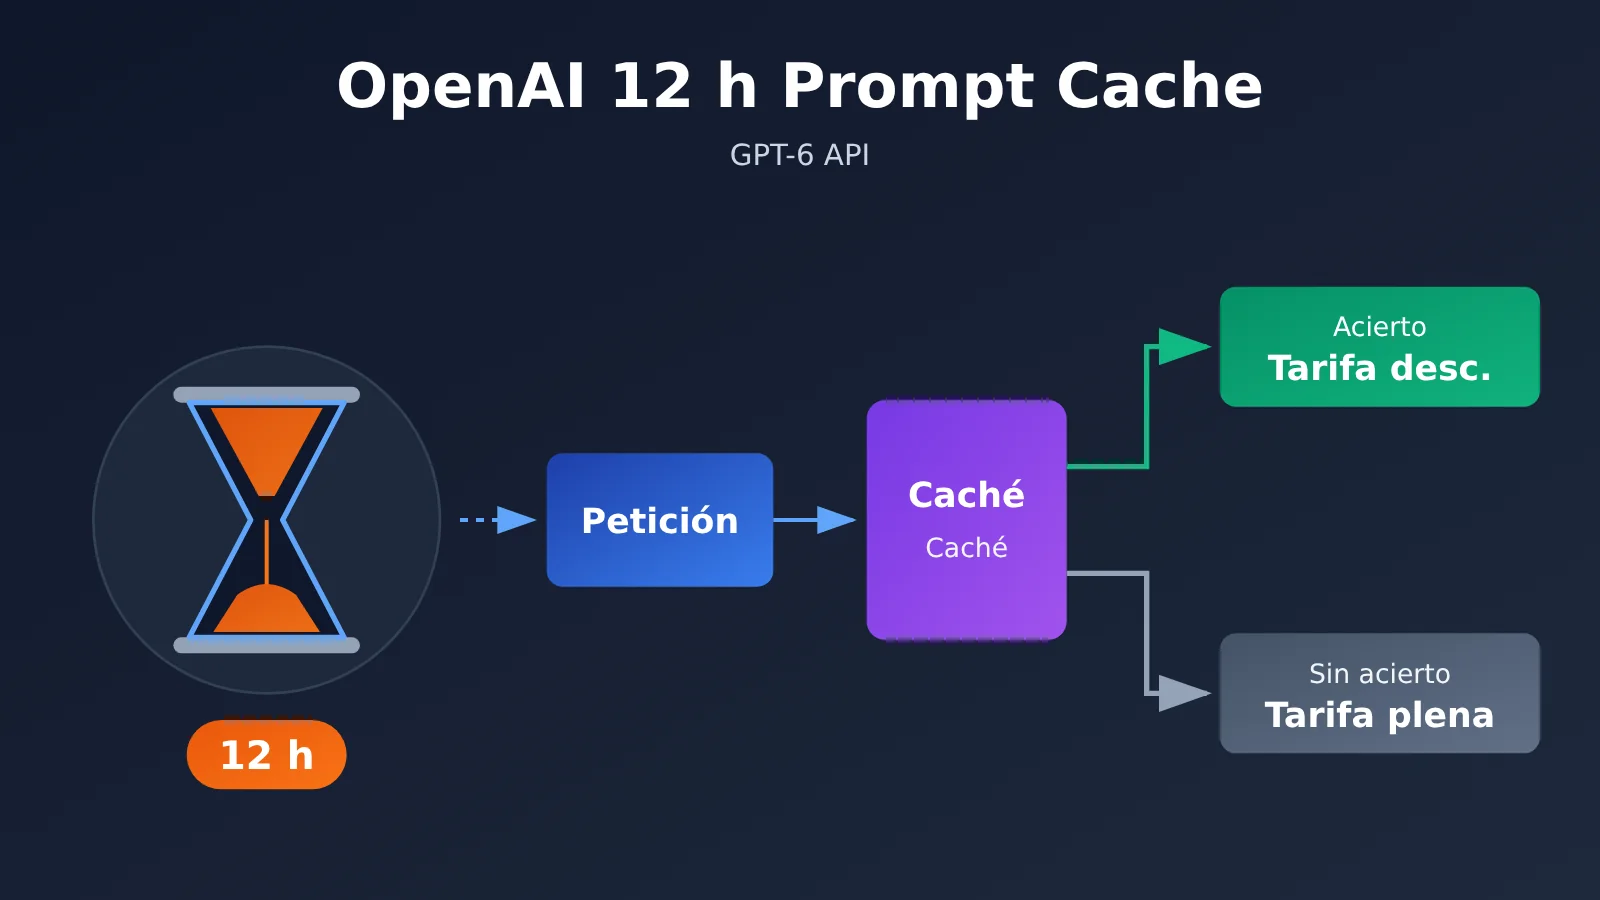
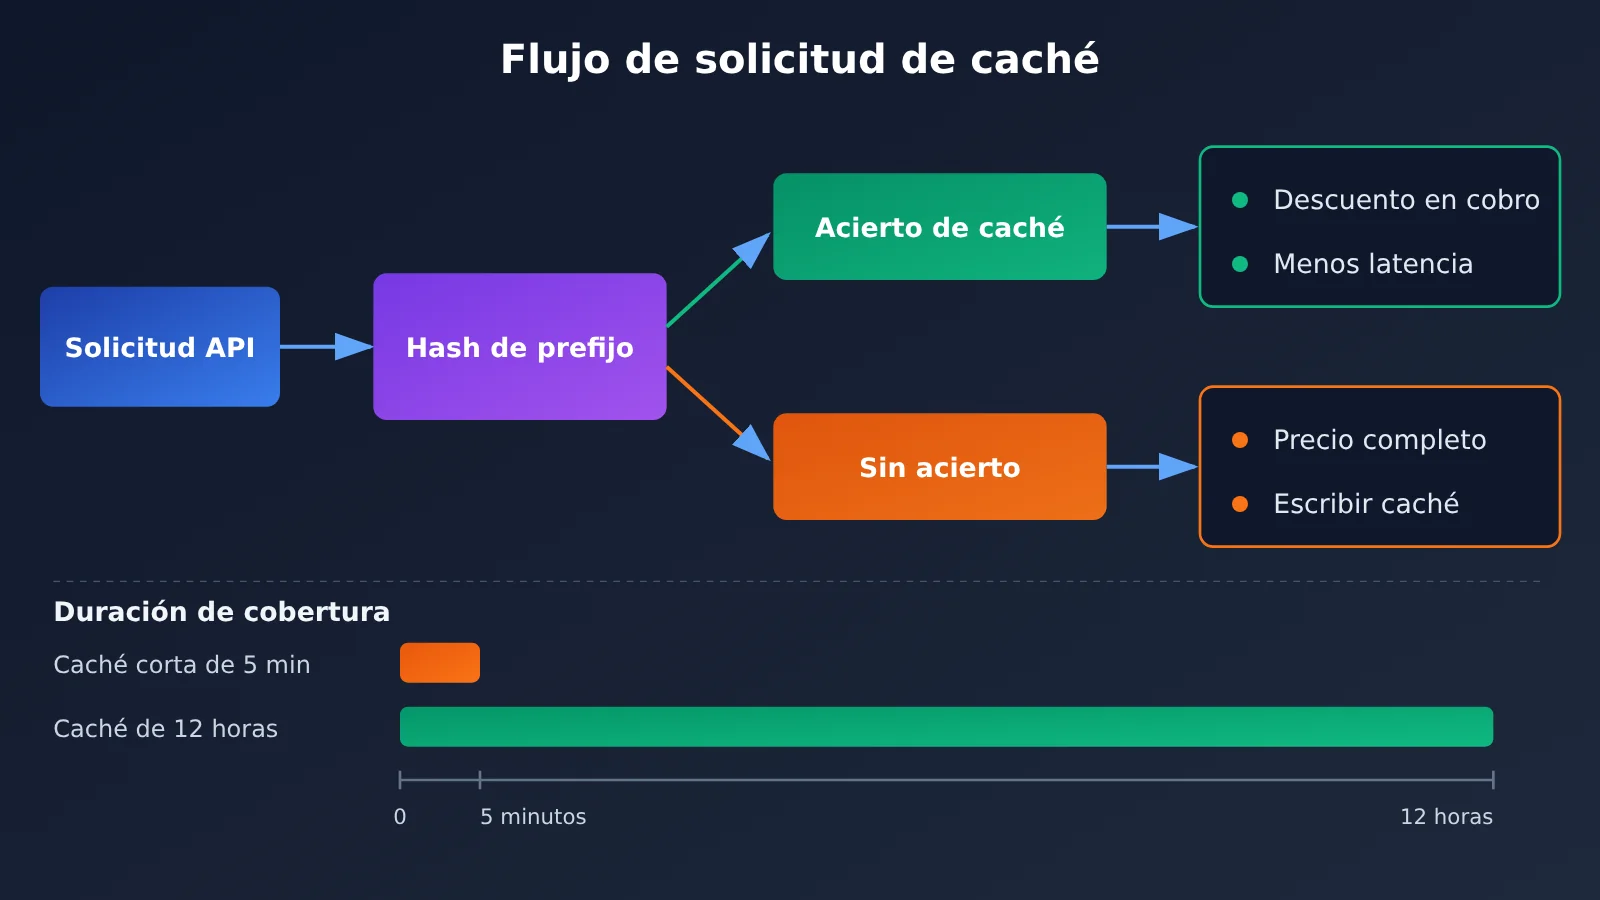
El Prompt Caching de OpenAI se basa en un mecanismo de «coincidencia de prefijo». Cuando la parte inicial de una solicitud (indicaciones de sistema, definiciones de herramientas, documentos fijos, etc.) coincide exactamente con alguna solicitud reciente y además alcanza la longitud mínima establecida oficialmente, esos tokens se reconocen como un acierto de caché, se facturan a precio con descuento y, al mismo tiempo, la latencia del primer token se reduce de forma notable.
Hay que tener muy en cuenta que la caché solo reconoce la parte que es «coincidente de forma continua desde el primer token». Basta con insertar una marca de tiempo o un ID de usuario en medio del prefijo para que todo lo que venga después deje de acertar. Por eso, diseñar bien la estructura del Prompt importa más que «activar o no la caché»: el contenido estático va delante y el dinámico al final.
Diferencias entre la caché de 12 horas y la caché corta
La caché corta de antes se borraba tras unos minutos de inactividad, así que solo las solicitudes de alta frecuencia y continuas lograban acertar de forma estable. La retención de 12 horas amplía la «ventana de acierto» de minutos a medio día, lo que cambia directamente la estructura de costos en escenarios de baja frecuencia.
| Dimensión | Caché corta predeterminada | Caché de 12 horas |
|---|---|---|
| Duración de retención | Caduca tras minutos de inactividad | Hasta unas 12 horas |
| Frecuencia de solicitudes adecuada | Solicitudes de alta frecuencia y continuas | Solicitudes de frecuencia media-baja e intermitentes |
| Escenarios típicos beneficiados | Atención al cliente en tiempo real, llamadas por lotes continuas | Usuario que vuelve a la conversación horas después, tareas programadas del día |
| Estabilidad de la tasa de aciertos | Muy afectada por las fluctuaciones de tráfico | Más favorable ante los valles de tráfico |
| Costo adicional | Normalmente sin cargo adicional por escritura | Si hay o no cargo adicional, según la explicación oficial |
¿Cuándo ahorra realmente dinero la caché de la API de GPT-6? La fórmula del punto de equilibrio
Muchos artículos solo dicen «la caché ahorra dinero», pero no explican cuánto ni en qué condiciones. Aquí vamos a cuantificar el problema con una fórmula genérica: solo tienes que sustituir tus propios parámetros de negocio.
Deducción de la fórmula de punto de equilibrio de Prompt Cache
Definimos las siguientes variables:
L: número de tokens del prefijo que se puede cachearP: precio unitario de entrada normald: proporción del precio de acierto de caché respecto al precio normal (0 < d < 1)w: proporción del coste adicional de la primera escritura en caché (w = 0 cuando no hay recargo)N: número de veces que se invoca el mismo prefijo dentro del periodo de validez de la caché
Sin caché, el coste total del prefijo es N × L × P. Con caché, la primera vez se factura al coste de escritura y las siguientes al precio de acierto, así que el coste total es L × P × (1 + w) + (N − 1) × L × P × d.
Restando ambas expresiones se obtiene una condición de equilibrio muy simple: N > 1 + w / (1 − d). La fórmula dice dos cosas: si la escritura no tiene recargo (w = 0), basta con reutilizar el mismo prefijo una vez dentro del periodo de validez para empezar a ahorrar; si la escritura tiene recargo, el número de reutilizaciones debe superar un umbral para recuperar la inversión, y cuanto mayor sea el descuento (menor d), más rápido se amortiza.
Cálculo del punto de equilibrio en distintos escenarios
A continuación hacemos un cálculo ilustrativo con «parámetros hipotéticos», solo para mostrar cómo se usa la fórmula; no representa los precios reales de OpenAI. Suponemos que el precio de acierto de caché es una determinada proporción del precio normal y observamos el número de invocaciones necesarias para amortizar, con y sin recargo de escritura.
| Escenario hipotético | Recargo de escritura w | Descuento por acierto d | Invocaciones necesarias para amortizar N | Conclusión |
|---|---|---|---|---|
| Sin recargo de escritura | 0 | Cualquiera | N > 1 | Reutilizar 1 vez ya ahorra |
| Recargo de escritura bajo | Bajo | Descuento grande | Unas 2 veces | Rentable en la gran mayoría de escenarios |
| Recargo de escritura alto | Alto | Descuento pequeño | 3 veces o más | Solo rentable con alta reutilización |
Del cálculo se desprende que el verdadero valor de una caché de 12 horas no está en «el descuento en sí», sino en hacer que N sea más grande. Con una caché corta, una petición que llega cada varias horas tiene un N prácticamente igual a 1 y no hay ahorro del que hablar; al ampliar a 12 horas, el mismo prefijo se reutiliza varias veces en un día y el ahorro se hace realidad.
🚀 Inicio rápido: si quieres validar la fórmula del punto de equilibrio con tráfico real, te recomendamos usar la misma clave API a través de APIYI apiyi.com para comparar el acierto de caché entre distintos modelos. La plataforma utiliza una interfaz compatible con OpenAI y los nuevos usuarios pueden obtener cuota de prueba gratuita.
Cómo verificar los aciertos de Prompt Cache en la API de GPT-6
Para saber si la caché te está ahorrando dinero, la forma más fiable es leer el campo usage de la respuesta. La API compatible con OpenAI devuelve en usage.prompt_tokens_details.cached_tokens la cantidad de tokens que acertaron en caché en esa llamada; con ese dato puedes calcular la tasa de acierto real.
Ejemplo mínimo
El código siguiente envía dos peticiones consecutivas con el mismo prefijo y revisa si en la segunda cached_tokens es mayor que 0:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI, compatible con OpenAI
)

SYSTEM_PROMPT = "Eres un consultor técnico sénior… (aquí va una indicación larga y fija que supere el umbral mínimo de caché)"

for i in range(2):
    resp = client.chat.completions.create(
        model="gpt-6",  # Usa el nombre real que aparezca en la lista de modelos de la plataforma
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": f"Pregunta {i+1}: ¿cómo optimizar el costo de la API?"}
        ]
    )
    cached = resp.usage.prompt_tokens_details.cached_tokens
    print(f"Petición {i+1}, tokens que acertaron en caché: {cached}")
Ver el código completo (con estadísticas de acierto y clave de enrutamiento de caché)
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class CacheStats:
    total_prompt: int = 0
    total_cached: int = 0
    records: list = field(default_factory=list)

    def add(self, prompt_tokens: int, cached_tokens: int):
        self.total_prompt += prompt_tokens
        self.total_cached += cached_tokens
        self.records.append((prompt_tokens, cached_tokens))

    @property
    def hit_rate(self) -> float:
        if self.total_prompt == 0:
            return 0.0
        return self.total_cached / self.total_prompt


def build_messages(static_prefix: str, user_input: str) -> list:
    """El contenido estático va primero y el dinámico al final, para mantener estable el prefijo"""
    return [
        {"role": "system", "content": static_prefix},
        {"role": "user", "content": user_input},
    ]


def ask(static_prefix: str, user_input: str, cache_key: str, stats: CacheStats,
        model: str = "gpt-6") -> str:
    resp = client.chat.completions.create(
        model=model,
        messages=build_messages(static_prefix, user_input),
        # prompt_cache_key ayuda a que las peticiones con el mismo prefijo se enruten a la misma caché
        # Si quieres activar la retención de 12 horas, añade el parámetro correspondiente según la documentación oficial de OpenAI
        extra_body={"prompt_cache_key": cache_key},
    )
    usage = resp.usage
    cached = getattr(usage.prompt_tokens_details, "cached_tokens", 0) or 0
    stats.add(usage.prompt_tokens, cached)
    return resp.choices[0].message.content


if __name__ == "__main__":
    stats = CacheStats()
    prefix = open("system_prompt.txt", encoding="utf-8").read()
    questions = ["¿Cómo diseñar una indicación amigable para la caché?", "¿Dónde deben ir las definiciones de herramientas?", "¿Cómo calcular la tasa de acierto?"]

    for q in questions:
        ask(prefix, q, cache_key="kb-v1", stats=stats)

    print(f"Tasa de acierto global de caché: {stats.hit_rate:.1%}")
    for idx, (p, c) in enumerate(stats.records, 1):
        print(f"Petición {idx}: prompt={p}, cached={c}")
Recomendación: prueba primero un día con poco tráfico, revisa la tasa de acierto global y la distribución de intervalos entre peticiones, y luego decide si activas la caché de 12 horas en producción. Puedes obtener crédito de prueba en APIYI apiyi.com para hacer este tipo de validación sin abrir varias cuentas oficiales por separado.
5 criterios para saber si el Prompt Cache de 12 horas te ahorra dinero
Al llevar la fórmula de punto de equilibrio a un negocio real, se pueden resumir en los siguientes 5 criterios. Cuantos más se cumplan, más evidente será el beneficio de activar la caché de 12 horas.
- Prefijo suficientemente largo: la parte fija que se puede cachear debe alcanzar el umbral mínimo oficial, y cuanto más larga sea, mayor será el descuento total. Una indicación corta de unos cientos de tokens, incluso si acierta en la caché, ahorra muy poco.
- Prefijo suficientemente estable: la indicación del sistema, las definiciones de herramientas y el orden del esquema deben mantenerse sin cambios durante un día. Modificar la indicación con frecuencia hace que la caché se invalide una y otra vez.
- El intervalo entre solicitudes se mantiene dentro de las 12 horas: si el mismo prefijo se invoca cada pocas decenas de minutos o cada pocas horas, esta es precisamente la zona donde la caché de 12 horas aporta su mayor beneficio incremental frente a la caché corta.
- Número de reutilizaciones por encima del umbral de rentabilidad: calcula con
N > 1 + w / (1 − d)y confirma que el número de reutilizaciones diarias se mantiene de forma estable por encima del umbral. - El costo de entrada tiene un peso alto: si tu factura proviene principalmente de los tokens de salida, la caché solo optimiza el lado de la entrada y la reducción total se diluye.
Grado de adecuación de la caché de 12 horas según el escenario de negocio
| Escenario de negocio | Características del intervalo entre solicitudes | Efecto de la caché corta | Valor incremental de la caché de 12 horas |
|---|---|---|---|
| Bot de atención al cliente en tiempo real | Alta frecuencia y continuo | Ya es bueno | Normal; sobre todo cubre los valles de tráfico |
| RAG sobre base de conocimiento empresarial | Frecuencia media, prefijo de documentos fijo | Varía bastante | Evidente; reutiliza varias veces al día conocimiento fijo |
| Sesión de agente de programación | El usuario vuelve a la sesión de forma intermitente | Suele invalidarse | Muy alto; reutiliza contexto largo durante horas |
| Procesamiento por lotes programado durante el día | Un lote cada pocas horas | Básicamente ineficaz | Muy alto; varias tandas al día con la misma plantilla |
| Análisis de un documento largo de una sola vez | Solo se invoca una vez | Ineficaz | Casi nulo; con N = 1 no se recupera la inversión |
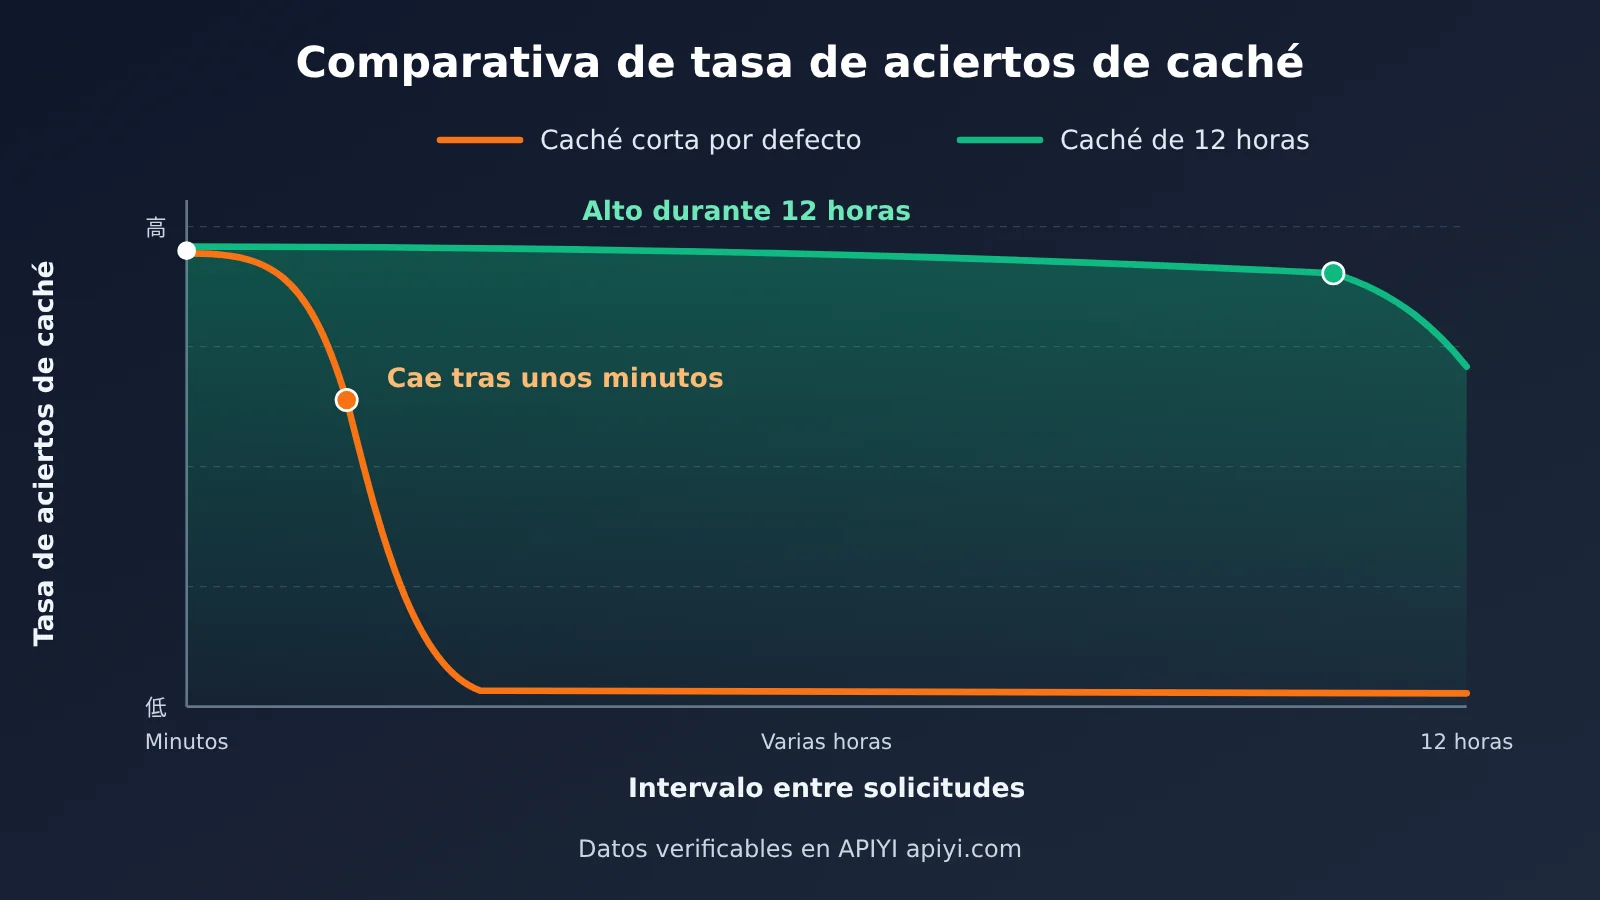
Aclaración sobre la comparación: la figura anterior muestra la diferencia de tendencia en la tasa de aciertos entre las dos estrategias de caché según el intervalo entre solicitudes. La tasa de aciertos real depende de la estabilidad de tu prefijo y de la distribución del tráfico; se recomienda comparar con tus propios registros reales de solicitudes.
Análisis del impacto del Prompt Cache de 12 horas de OpenAI
Impacto para los desarrolladores
- La ingeniería de indicaciones tiene que evolucionar hacia una «ingeniería de caché»: conviene organizar las indicaciones de sistema, las definiciones de herramientas y el conocimiento fijo en bloques de prefijo estables, y gestionar sus versiones de forma explícita para que un pequeño cambio no invalide todo el contenido.
- La evaluación de costos pasa de la «tarifa unitaria» a la «tarifa unitaria efectiva»: con la misma API de GPT-6, un equipo con alta tasa de aciertos de caché y otro con tasa baja pueden tener costos reales por cada mil solicitudes notablemente distintos; monitorear
cached_tokensdebería convertirse en una métrica habitual. - Los Agent de contexto largo son más viables: los asistentes de programación y los Agent de investigación suelen manejar contextos muy extensos; antes, si el usuario se ausentaba un rato y volvía, había que recalcular todo a precio completo. Ahora, la reutilización entre horas mejora mucho la economía de las sesiones largas.
- La latencia también mejora: las solicitudes que aciertan en la caché tienen un primer token con menor latencia, lo que supone un beneficio extra para productos sensibles a la experiencia interactiva.
Impacto para el sector
- La caché se convierte en una dimensión competitiva del precio de los modelos: los principales proveedores ofrecen sus propias soluciones de caché de indicaciones, y el tiempo de retención, el nivel de descuento o si se cobra por escritura se están volviendo referencias importantes a la hora de elegir.
- Crece el valor de las comparativas multimodelo en plataformas agregadoras: como las reglas de caché varían bastante entre proveedores, comparar facturas reales de forma transversal bajo una interfaz unificada resulta más útil que mirar solo el precio oficial de lista.
- La arquitectura RAG podría replantearse: cuando un prefijo de documento largo puede reutilizarse a bajo costo durante medio día, algunos escenarios de bases de conocimiento de tamaño pequeño o medio podrían pasar de «recuperar fragmentos» a «meter el bloque completo en el contexto + caché».
Referencia para elegir entre distintas soluciones de caché multimodelo
| Tipo de modelo | Características de caché (según la documentación oficial de cada proveedor) | Casos de uso | Plataformas disponibles |
|---|---|---|---|
| API de GPT-6 | Caché de prefijo automática, con nueva opción de retención de 12 horas | Indicaciones de sistema largas, sesiones de Agent | APIYI apiyi.com, OpenAI oficial |
| Serie Claude | Requiere marcar explícitamente los puntos de corte de caché; admite distintas duraciones de retención | Escenarios con control fino de la posición de la caché | APIYI, Anthropic oficial |
| Serie Gemini | Admite caché de contexto implícita y explícita | Documentos muy largos, contexto multimodal | APIYI, Google oficial |
💡 Consejo para elegir: las reglas de caché varían bastante entre modelos, así que conviene probar la misma indicación de negocio en varios modelos, medir la tasa de aciertos y la factura real, y luego decidir en función de los resultados.
Preguntas frecuentes (FAQ)
Q1: ¿Qué es el Prompt Cache de 12 horas de OpenAI?
Es una opción de retención extendida del mecanismo Prompt Caching de OpenAI. Las solicitudes con el mismo prefijo pueden acertar en la caché durante un máximo de unas 12 horas. Los tokens de entrada que aciertan se facturan a precio con descuento y además se reduce la latencia del primer token.
Q2: ¿Cuál es la diferencia entre la caché de 12 horas y la caché corta predeterminada?
La caché corta predeterminada deja de ser válida tras unos minutos de inactividad, así que solo sirve para solicitudes continuas de alta frecuencia. La caché de 12 horas, en cambio, cubre solicitudes intermitentes de frecuencia media o baja. En escenarios de alta frecuencia como la atención al cliente en tiempo real, la diferencia entre ambas no es significativa; en escenarios con intervalos de varias horas, como sesiones de Agent o procesamiento por lotes programado, la ganancia adicional de la caché de 12 horas sí es clara.
Q3: ¿Activar la caché de 12 horas siempre ahorra dinero?
No necesariamente. Si escribir en la caché no tiene coste adicional, basta con reutilizar el mismo prefijo una vez dentro del periodo de validez para empezar a ahorrar. Si tiene un coste adicional, el número de reutilizaciones debe superar `1 + w / (1 − d)` para amortizarla. En llamadas puntuales, prefijos que cambian con frecuencia o prefijos muy cortos, la ganancia es muy limitada.
Q4: ¿Cómo aumentar la tasa de aciertos de caché de la API de GPT-6?
La regla clave es «lo estático primero, lo dinámico después»:
– Las indicaciones del sistema, las definiciones de herramientas y los documentos fijos van al principio del mensaje, y su orden no debe cambiar.
– La marca de tiempo, el ID de usuario, los resultados de recuperación y demás contenido dinámico van al final.
– Usa una clave de enrutamiento de caché fija para el mismo tipo de solicitud, para aumentar la probabilidad de que se enrute a la misma caché.
– Publica los cambios de indicaciones de forma concentrada y evita hacer pequeños cambios frecuentes durante el día.
Q5: ¿Cómo probar rápidamente el efecto de la caché de 12 horas a través de la API?
Se recomienda usar una plataforma de agregación de API que admita varios modelos:
1. Visita APIYI apiyi.com y crea una cuenta.
2. Obtén una clave API y crédito de prueba gratuito.
3. Usa el ejemplo de código de este artículo (cambia `base_url` por `https://api.apiyi.com/v1`) y lee `cached_tokens` para calcular la tasa de aciertos.
APIYI utiliza una interfaz compatible con OpenAI, así que con una sola clave puedes comparar el rendimiento de caché de GPT, Claude y Gemini.
Q6: ¿Qué limitaciones conocidas tiene Prompt Cache?
La caché solo se aplica a prefijos continuos que alcancen el umbral mínimo de longitud, y solo optimiza el coste del lado de entrada; los tokens de salida no tienen descuento. La caché es un mecanismo de «mejor esfuerzo»: con alta concurrencia o cambios en el enrutamiento del tráfico puede haber fallos de acierto, así que no conviene tratar la tasa de aciertos como una garantía del 100 %. Para conocer la facturación concreta de la retención de 12 horas y los modelos compatibles, consulta la documentación oficial de OpenAI.
Puntos clave del Prompt Cache de 12 horas
- Cómo funciona: se basa en una coincidencia exacta de prefijos; los tokens de entrada que coinciden se facturan a precio con descuento.
- Cambio clave: el tiempo de retención pasa de minutos a aproximadamente 12 horas, lo que cubre solicitudes de baja frecuencia.
- Fórmula de rentabilidad: solo empiezas a ahorrar cuando el número de reutilizaciones N > 1 + w / (1 − d).
- Escenarios con mayor beneficio: sesiones largas de Agent, RAG sobre bases de conocimiento y procesamiento por lotes programado durante el día.
- Escenarios con beneficio limitado: llamadas únicas, prefijos cortos e indicaciones que cambian con frecuencia.
- Clave para llevarlo a producción: colocar el contenido estático al principio y monitorear de forma continua la tasa de aciertos con
cached_tokens. - Validación: hacer una prueba a pequeña escala con tráfico real a través de APIYI apiyi.com y, después, activarlo por completo.
Resumen
El impacto clave del Prompt Cache de 12 horas de OpenAI en el costo de la API de GPT-6:
- Ahorrar depende de cuántas veces reutilices: la ventana de 12 horas permite que solicitudes de frecuencia media y baja reutilicen el mismo prefijo varias veces. Subir N por encima de 1 es el verdadero valor incremental.
- El costo de escritura marca el umbral de rentabilidad: si no hay cargo adicional por escritura, casi siempre sales ganando; si lo hay, tienes que calcularlo con la fórmula de punto de equilibrio.
- La estructura de la indicación importa más que el interruptor: contenido estático al inicio, gestión de versiones y monitoreo de la tasa de aciertos son lo que de verdad convierte el descuento de la caché en una factura más baja.
Se recomienda empezar por escenarios de alto beneficio, como indicaciones de sistema largas y sesiones de Agent. Ejecuta un día con tráfico real para ver la tasa de aciertos y luego decide hasta dónde generalizar. Para comparar rápidamente el efecto de la caché entre varios modelos, se recomienda usar APIYI apiyi.com: la plataforma ofrece crédito de prueba gratuito y una interfaz unificada compatible con OpenAI.
📚 Referencias
- Guía oficial de OpenAI Prompt Caching: mecanismo de caché, umbral mínimo y descripción del campo usage
- Enlace:
platform.openai.com/docs/guides/prompt-caching -
Descripción: la fuente autoritativa para entender las reglas de acierto de la caché y el parámetro más reciente de duración de retención
-
Página de precios de OpenAI API: precio unitario de entrada normal, entrada en caché y salida para cada modelo
- Enlace:
openai.com/api/pricing -
Descripción: al aplicar la fórmula de retorno de la inversión, toma como referencia los precios en tiempo real de esta página
-
OpenAI API Reference: descripción de los parámetros de las interfaces Chat Completions y Responses
- Enlace:
platform.openai.com/docs/api-reference - Descripción: aquí puedes consultar el uso concreto de parámetros relacionados con la caché, como prompt_cache_key
Autor: Equipo técnico de APIYI
Contacto técnico: puedes contactarnos desde la página de inicio del sitio web de APIYI para obtener más soluciones de integración de modelos y optimización de costes