작성자 주석: OpenCode에서 아무도 주장하지 않은 무료 익명 모델 Iceman을 예로 들어, 공식 성명·카탈로그 파라미터·미확인 단서라는 세 층위의 정보를 분해합니다. 연동 전 확인해야 할 5가지 체크리스트를 제시하고, 여러 id를 병합해 사용량 순위표를 읽는 방법도 설명합니다.
무료이고, 요청 횟수 제한도 없고, 컨텍스트 윈도우도 아주 큰데, 누가 만든 건지는 아무도 모릅니다. 이런 무료 익명 모델은 최근 코딩 도구에서 흔히 보이는 존재라서, 많은 개발자의 첫 반응은 “일단 프로젝트에 붙여보자”예요. 이 글은 OpenCode의 Iceman을 사례로 삼아, 하나의 구체적인 질문에 답합니다. 출처가 불분명한 무료 모델에 코드나 업무 데이터를 보내기 전에, 무엇을 확인해야 할까요?
이 글은 “쓰지 마세요”라고 설득하는 글이 아닙니다. 무료 익명 모델은 프로토타입 검증과 공개 코드 실험에 충분히 활용할 수 있어요. 중요한 건 어떤 정보를 사용 근거로 삼을 수 있고, 어떤 정보가 소문일 뿐인지, 그리고 학습·보존 조항이 내 데이터에 실제로 어떤 영향을 주는지 구분하는 것입니다.
핵심 가치: 이 글을 읽고 나면 데이터 학습, 제로 데이터 보존, 무료 기간, 출처 귀속이라는 네 가지 차원을 아우르는, 재사용 가능한 익명 모델 체크리스트를 얻게 됩니다. 또한 “id 교체로 생긴 가짜 성장” 같은 순위표 오독을 식별하는 법도 배우게 돼요.
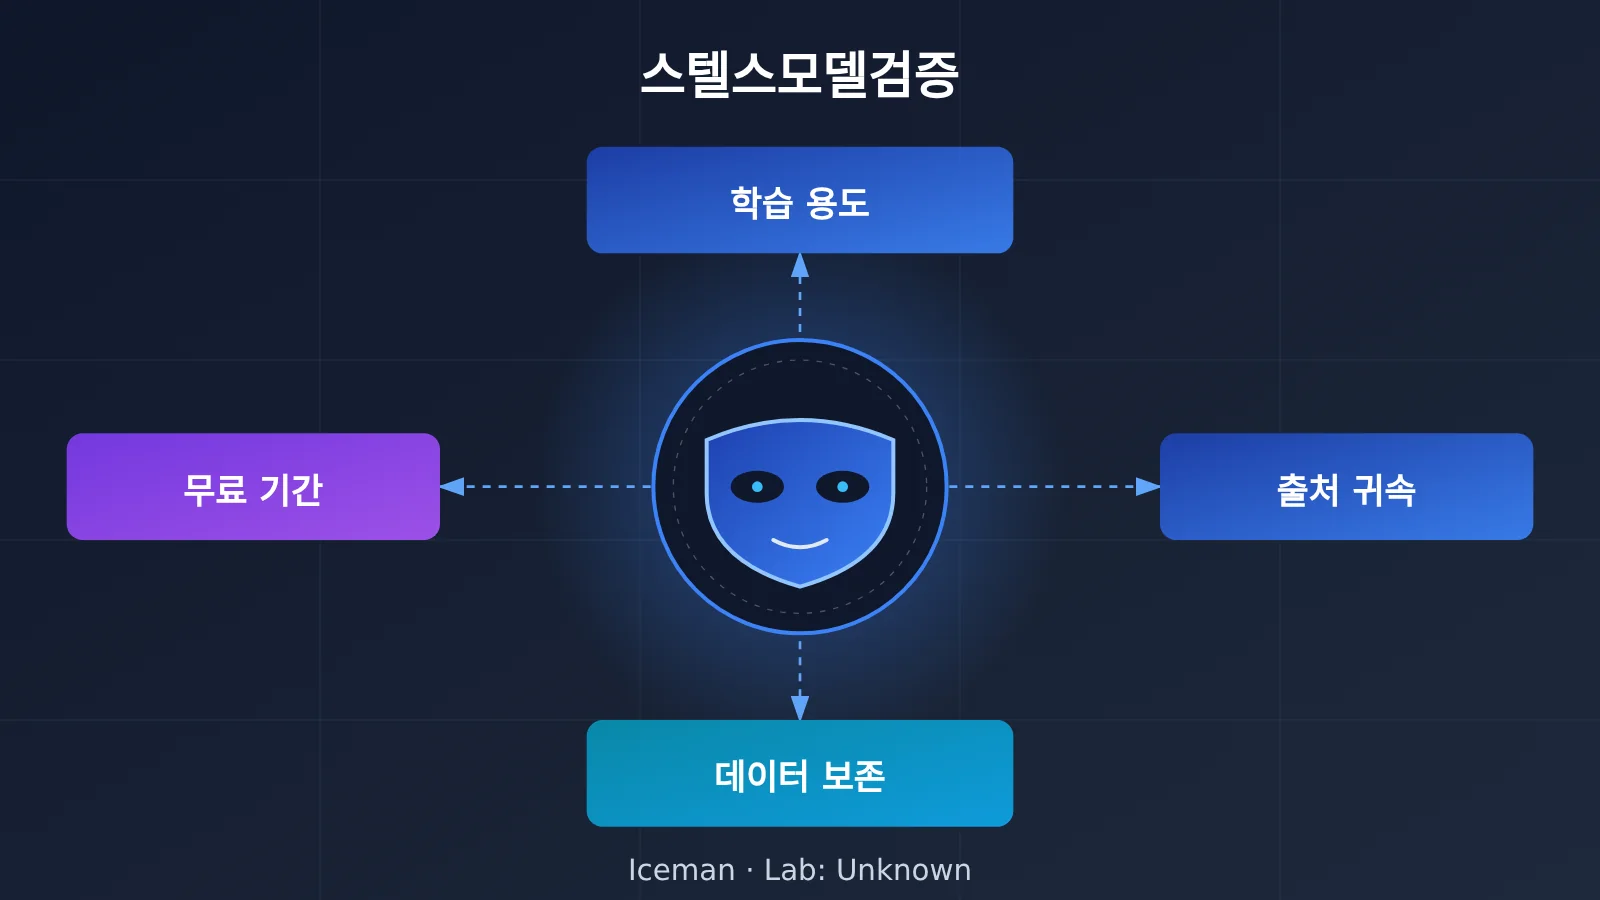
무료 스텔스 모델 Iceman 핵심 포인트
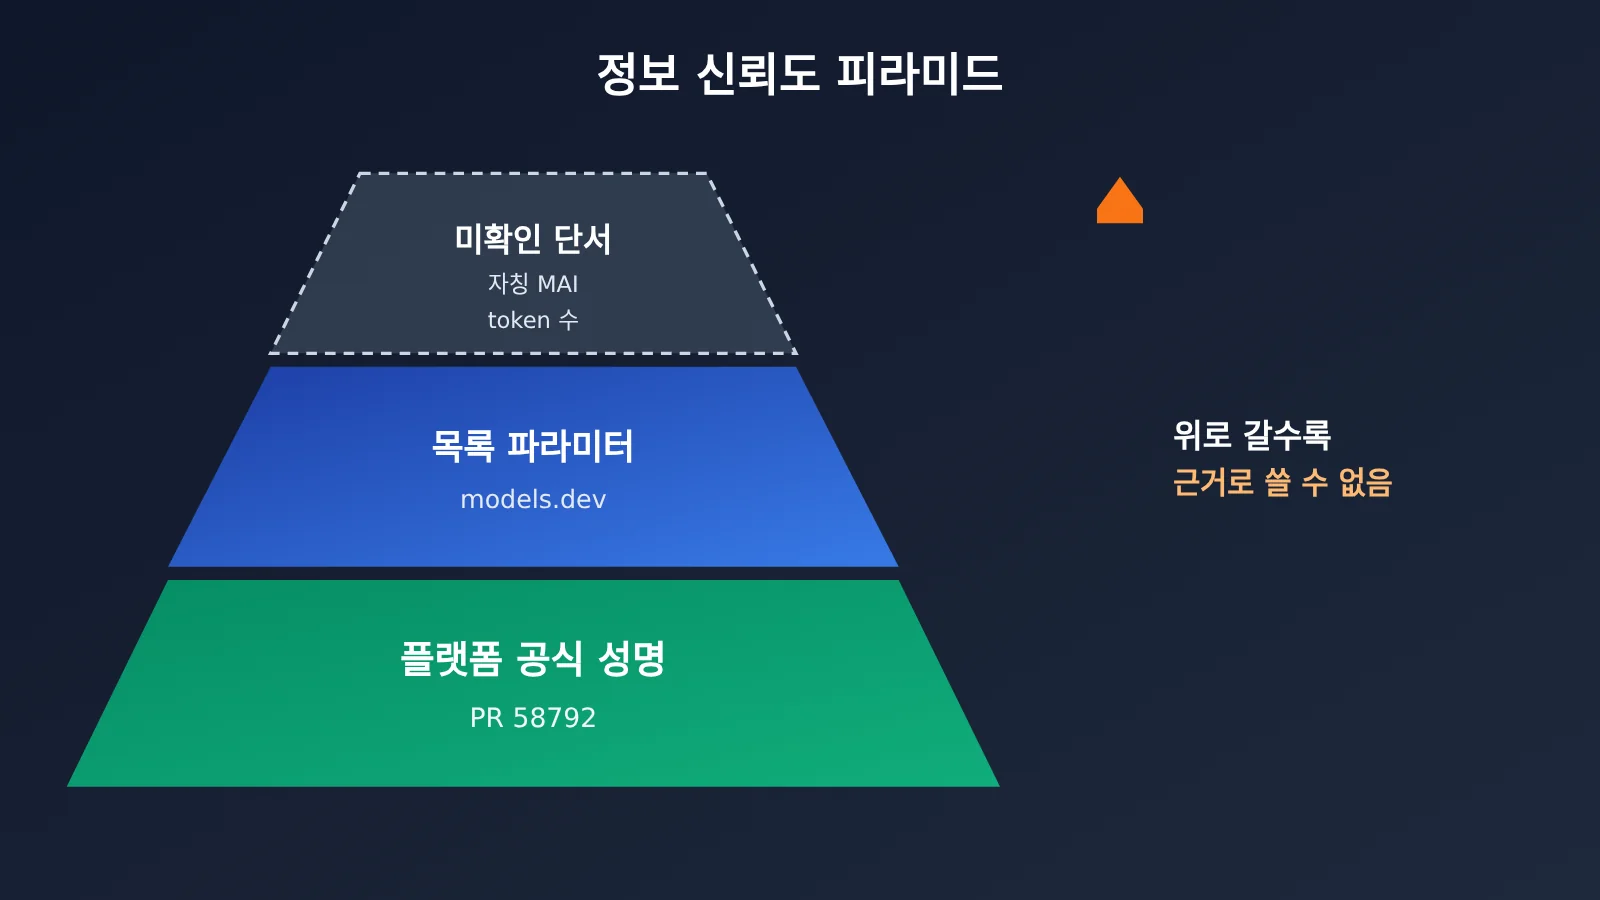
2026-11-04 18:31 UTC 기준, Iceman은 아직 어떤 AI 연구소도 공식적으로 소유권을 주장하지 않았습니다. OpenCode 사용량 데이터에 따르면 Iceman은 10월 23일부터 두 개의 id에서 누적 약 3.37조 토큰을 처리했습니다. 아래 표는 Iceman에 관한 정보를 신뢰도에 따라 세 계층으로 나눈 것이며, 뒤에 나오는 모든 판단의 기준이 됩니다.
| 정보 계층 | 구체 내용 | 사용 근거로 삼을 수 있는지 |
|---|---|---|
| 플랫폼 공식 발표 | OpenCode가 병합한 PR 58792: 기간 한정 무료, 요청 제한 없음, 프롬프트가 학습에 사용됨, 제로 데이터 보존이 아님 | ✅ 가능, 약관 차원에서 확인되는 사실 |
| 카탈로그 파라미터 | models.dev 카탈로그: 262,144 컨텍스트, 최대 131,072 출력 토큰, 추론 및 도구 호출 지원, 텍스트 입력·텍스트 출력 | ✅ 가능, 기술 선택에 활용 |
| 미확인 단서 | 서드파티 추적에 따르면 스스로 Microsoft MAI라고 주장하며, 토큰 집계가 MAI Thinking 1과 일치 | ❌ 불가, 소문으로만 취급 |
스텔스 모델 Iceman의 공식 약관 자세히 보기
OpenCode는 10월 24일 Iceman을 월 10달러짜리 Go 요금제에 추가했습니다. 저장소의 pull request 58792에 해당하며, 20:24 UTC에 병합됐어요. 모델 이름은 Iceman Contributor Free이고, 약관에는 “기간 한정 무료, 요청 제한 없음”이라고 명시돼 있습니다. 같은 변경 사항에는 두 가지가 함께 적혀 있습니다. 이 모델로 보낸 프롬프트는 학습에 사용되며, 데이터 보존 정책은 제로 데이터 보존이 아닙니다.
개발자가 가장 주목해야 할 부분은 바로 이 두 가지예요. 컨텍스트 윈도우나 출력 길이보다, 어떤 데이터를 보낼 수 있는지를 더 직접적으로 결정하기 때문이죠. 또한 이 PR은 해당 id를 OpenCode의 스텔스 모델 목록에 추가했기 때문에, 사용량 페이지의 연구소 항목에는 Unknown으로 표시됩니다. 다시 말해 플랫폼 스스로 출처가 알려지지 않았다고 분명히 밝히고 있는 셈이에요.
스텔스 모델 이름에서 Contributor가 실제로 뜻하는 것
많은 분이 iceman-contributor에 들어 있는 Contributor를 특정 연구소나 기여자의 이름으로 이해합니다. 하지만 실제로는 OpenCode의 일종의 교환 방식, 즉 학습 데이터를 제공하는 대신 무료 접근을 얻는 모델을 뜻해요. Meta의 Muse Spark 1.3과 1.2에도 Contributor 버전이 있습니다. 이는 플랫폼 차원의 공통 라벨일 뿐, 모델 출처를 알려 주는 단서가 아니라는 뜻이죠.
따라서 Contributor라는 문구를 보면 “이 채널의 데이터는 학습에 들어간다”고 해석해야지, “특정 연구소가 기여한 버전이다”라고 해석하면 안 됩니다. 이 내용은 뒤에 나오는 확인 목록에서 첫 번째 점검 항목으로 다룰게요.
무료 익명 모델의 학습 약관이 코드와 프라이버시 데이터에 미치는 영향
“프롬프트가 학습에 사용된다”는 말은 추상적으로 들리지만, 프로젝트에 적용하는 순간 아주 구체적인 문제가 됩니다. 내가 보낸 모든 컨텍스트가 다른 사람 모델의 학습 샘플이 될 수 있다는 뜻이니까요. 프로그래밍 도구에서는 컨텍스트가 입력한 질문 한 줄로 끝나지 않아요. 자동으로 함께 첨부되는 파일 내용, 오류 로그, 설정 파일, 심지어 환경 변수까지 포함되는 경우가 많습니다.
0이 아닌 데이터 보존은 요청 내용이 서버에 일정 기간 남는다는 뜻입니다. 얼마나 오래, 어디에, 누가 처리하는지는 모델 출처를 알 수 없는 상황에서는 확인할 방법이 없어요. 기업 프로젝트라면 이런 점이 계약서의 비밀 유지 조항이나 데이터 규정 준수 요구사항과 곧바로 부딪히기 쉽습니다. 아래 표는 데이터 유형별 실제 위험을 정리한 것입니다.
| 데이터 유형 | 일반적인 출처 | 학습 + 0이 아닌 보존 시 위험 | 권장 사항 |
|---|---|---|---|
| 오픈소스 또는 공개 코드 | 공개 저장소, 예제 프로젝트 | 낮음, 이미 공개된 내용 | 사용 가능 |
| 회사 사유 비즈니스 코드 | 내부 저장소, 핵심 알고리즘 | 높음, 구현 세부 사항과 아키텍처 유출 가능 | 전송 비권장 |
| 키와 설정 | .env, 설정 파일, CI 스크립트 |
매우 높음, 자격 증명이 남아 학습될 수 있음 | 반드시 제외 |
| 사용자 개인정보 데이터 | 로그, 데이터베이스 샘플, 티켓 | 매우 높음, 개인정보 규정 준수 이슈 | 전송 금지 |
| 합성 또는 비식별화 데이터 | 테스트 픽스처, Mock 데이터 | 낮음~중간, 비식별화 품질에 따라 다름 | 비식별화 후 사용 가능 |
여기서 프로그래밍 도구 특유의 “암묵적 컨텍스트” 문제를 특히 짚고 넘어가야 합니다. 많은 에이전트가 작업 공간 파일을 자동으로 읽어요. 함수 하나를 어떻게 작성하는지 물었다고 생각했는데, 실제로는 디렉터리 구조 전체와 인접 파일까지 요청에 함께 담겨 전송될 수 있습니다. 학습용 채널을 사용한다면, 공개 데이터나 합성 데이터만 담긴 별도 작업 공간에서 작업하는 것이 가장 안전한 방법입니다.
무료 스텔스 모델, 어떻게 확인할까: 연동 전 5가지 체크리스트
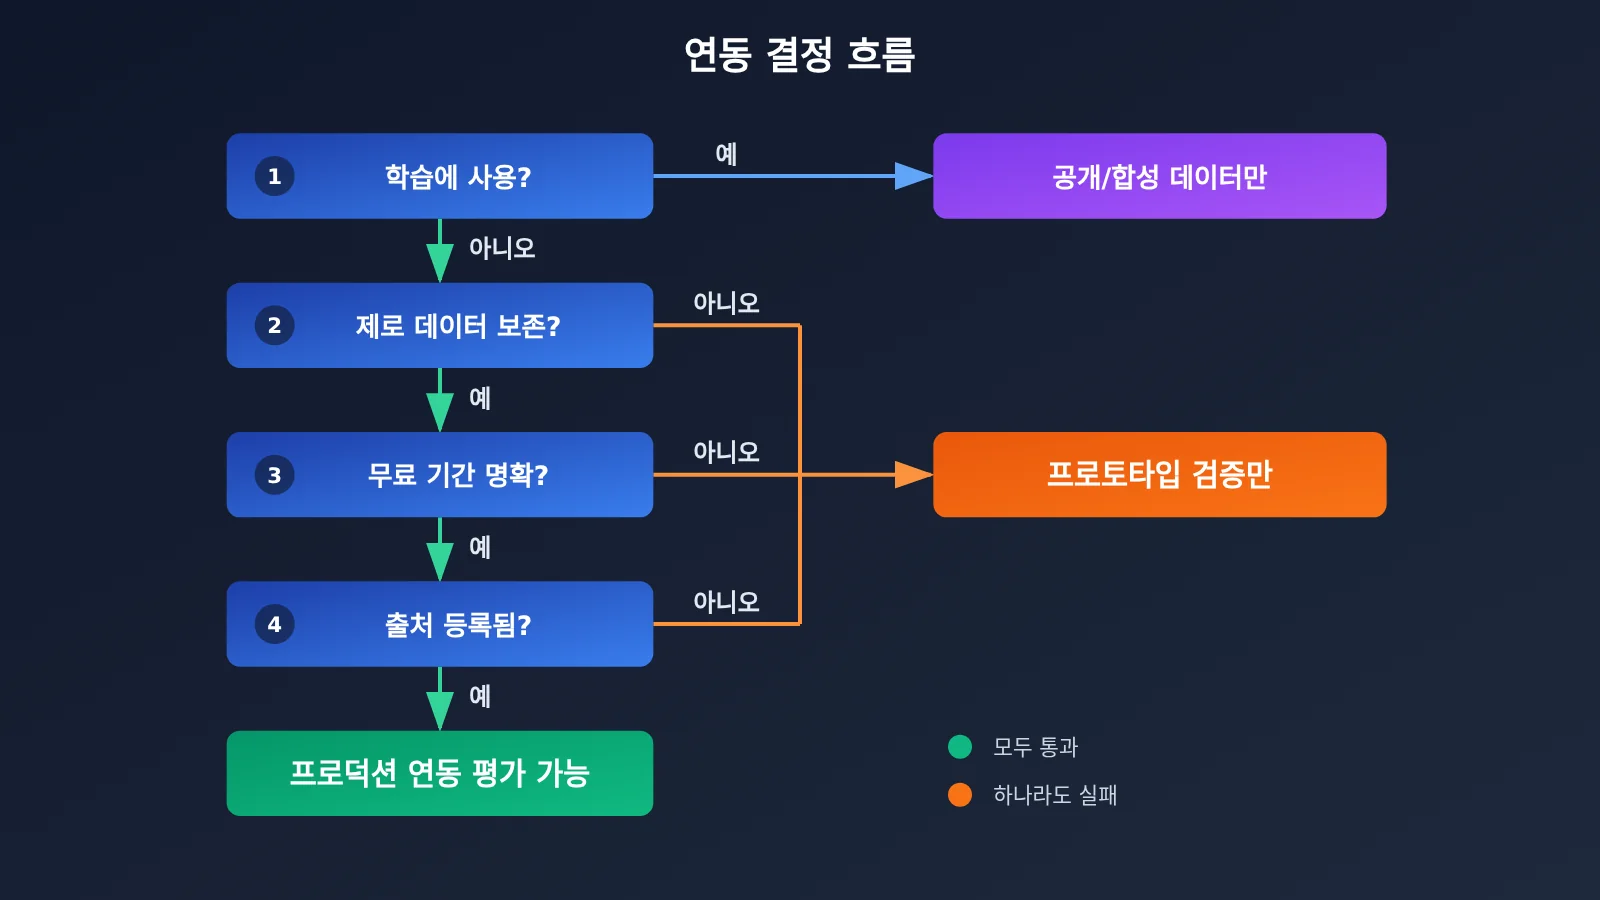
아래 체크리스트는 Iceman 한 모델만을 위한 것이 아니라, 무료로 공개됐지만 출처가 아직 밝혀지지 않은 모든 모델에 적용할 수 있어요. 앞의 네 항목은 약관과 출처 귀속에서, 다섯 번째 항목은 데이터 해석에서 나온 것이니 팀 내부에서 고정된 검토 절차로 만들어 두는 걸 권해요.
| 번호 | 확인 항목 | 확인 위치 | Iceman 현재 상태 |
|---|---|---|---|
| 1 | 프롬프트가 학습에 사용되는지 | 플랫폼 약관, 모델 구성 변경 기록 | 예, 학습에 사용됨 |
| 2 | 제로 데이터 보존 여부 | 플랫폼 약관, 개인정보 안내 | 아니요, 제로 데이터 보존 아님 |
| 3 | 무료 기간은 얼마나 되는지 | 플랫폼 공지, 요금제 설명 | “기간 한정”만 표기, 기간 미상 |
| 4 | 출처 귀속이 확인되었는지 | 연구소 공식 성명 | 미확인, 연구소 표시가 Unknown |
| 5 | 사용량 데이터가 id별로 분리되는지 | 사용량 순위표의 관련 id 전부 | 예, iceman과 iceman-contributor로 분리됨 |
스텔스 모델의 출처 귀속: 단서가 확인은 아닌 이유
Iceman의 출처와 관련해 스텔스 모델 추적 사이트 stealthmodels.com은 X 계정 @aitrackerbot이 Iceman이 스스로를 Microsoft의 MAI라고 소개했고, 프롬프트 토큰 집계 방식이 MAI Thinking 1과 완전히 일치한다는 점을 발견했다고 보도했어요. 하지만 이 사이트가 직접 테스트한 결과, Iceman은 MAI Thinking 1과 일치했고 OpenAI의 GPT-6 시리즈와도 똑같이 일치했어요. 즉 토큰 집계만으로는 이 모델들을 구분할 수 없다는 뜻이에요.
모델이 “자신이 누구라고 말하는지” 역시 믿을 수 없어요. 모델은 학습 데이터에 담긴 신원 정보를 그대로 반복할 수 있고, 시스템 프롬프트에 의해 의도적으로 설정될 수도 있거든요. 현재까지 Microsoft는 아무런 성명도 내지 않았어요. 그래서 이 정보는 “하나의 단서”로 자리매김해야 하며, 기술 선택 문서에 사실처럼 적어서는 안 돼요.
스텔스 모델 정체 공개, 과거 선례는?
OpenCode의 과거 스텔스 모델 사례를 보면, 정체 공개는 보통 출시 시점이나 몇 주 안에 이뤄졌어요. ox-alpha는 Z.ai가 GLM-5.3 Flash라고 밝혔고, cat-jam은 Reflection AI가 Beam이라고 밝혔으며, Space Bunny는 처음 등장한 지 26일 후에 MiniMax가 M3.1 Flash라고 밝혔어요. 11월 4일 기준으로 Iceman은 출시된 지 11일이 지났지만 여전히 정체를 밝힌 곳이 없어요.
선례의 가치는 예측이 아니라 기대치를 제공하는 데 있어요. 정체 공개까지 몇 주가 걸릴 수 있고, 그동안 모델 규모와 출처, 무료 기간은 모두 미지수라는 점을 알려주죠. 여러분의 계획은 이런 미지수에 기대면 안 돼요.
무료 스텔스 모델 빠르게 시작하기: 여러 id를 합쳐 사용량 순위 읽기
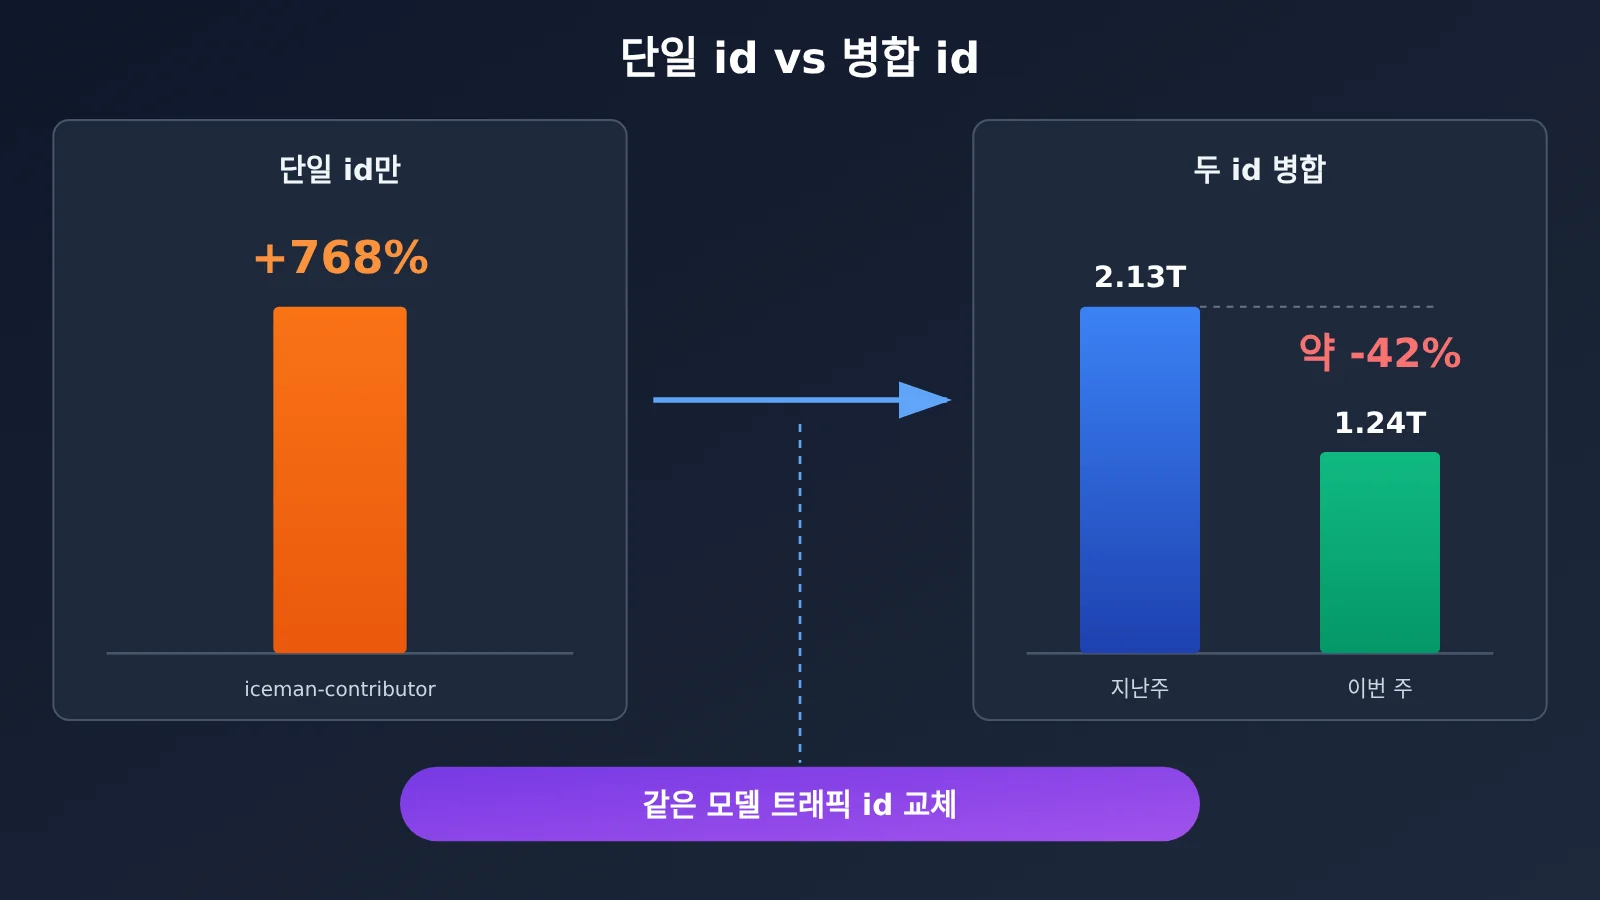
Iceman이 OpenCode 주간 순위에서 보인 성과는 전형적인 순위 오독 사례예요. 단일 id만 보면 ‘폭발적 성장’이라는 결론이 나오지만, 두 id를 합쳐서 보면 결론이 정반대가 돼요.
| id | 주간 순위 | 이번 주 tokens | 전주 대비 변화 |
|---|---|---|---|
| iceman-contributor | #12 | 670B | +768% |
| iceman | #16 | 567B | -72% |
| 합계 | — | 약 1.24T | 약 -42%(지난주 약 2.13T) |
+768%는 성장이 아니라, 같은 모델의 트래픽이 한 id에서 다른 id로 옮겨간 것뿐이에요. 두 id를 합치면 지난 7일 동안 약 1.24조 tokens를 실행했는데, 이는 전주 약 2.13조보다 약 42% 줄어든 수치예요. 일일 사용량은 10월 28일에 약 6,530억 tokens로 정점을 찍었고, 10월 29일부터 11월 3일까지는 매일 1,620억에서 2,510억 사이를 오갔어요.
최소 예제: id 병합으로 실제 전주 대비 증감률 계산하기
아래 Python 코드는 병합 로직을 보여줘요. 데이터는 앞서 언급한 공개 수치를 사용했어요. 지난주 각 id의 값은 이번 주 값과 증감률에서 역산한 것이므로 근사치예요.
# 동일 모델의 여러 id, 이번 주 tokens(단위: 10억)와 전주 대비 증감률
ids = {
    "iceman-contributor": {"this_week": 670, "change": 7.68},   # +768%
    "iceman":             {"this_week": 567, "change": -0.72},  # -72%
}

this_total = sum(v["this_week"] for v in ids.values())
# 증감률로 지난주 값 역산: last = this / (1 + change)
last_total = sum(v["this_week"] / (1 + v["change"]) for v in ids.values())

print(f"本周合计:{this_total}B")
print(f"上周合计(反推):{last_total:.0f}B")
print(f"合并后环比:{(this_total / last_total - 1):.1%}")
실행해 보면 이번 주 약 1,237B, 지난주 약 2,100B 규모, 합산 증감률 약 -41%에서 -42%가 나오는데, 보도에서 제시한 합계 데이터와 거의 들어맞아요. 역산에는 반올림 오차가 있으니, 실제 분석에서는 각 id의 원본 주간 데이터를 직접 읽어야 해요.
전체 구현 보기: 연동 전 모델 정책 게이트
아래 코드는 점검 체크리스트를 간단한 “정책 게이트”로 구현한 것이에요. 어떤 특정 플랫폼의 API도 호출하지 않고, 여러분이 직접 확인한 뒤 입력한 메타데이터만을 근거로 특정 데이터를 특정 모델로 보낼 수 있는지 판단해요. 이 게이트는 여러분의 요청 라우팅 계층 앞에 두면 돼요.
from dataclasses import dataclass
from typing import Optional

@dataclass
class ModelPolicy:
    model_id: str
    used_for_training: bool          # 검증 항목 1
    zero_data_retention: bool        # 검증 항목 2
    free_until: Optional[str]        # 검증 항목 3, None이면 기한 미확인
    lab_confirmed: bool              # 검증 항목 4
    related_ids: tuple = ()          # 검증 항목 5, 통계 병합에 사용

# 데이터 민감도 등급: 0 공개, 1 비식별화/합성, 2 사설 코드, 3 키 또는 개인정보
SENSITIVITY = {"public": 0, "synthetic": 1, "private_code": 2, "secret_or_pii": 3}

def max_allowed_level(p: ModelPolicy) -> int:
    """모델 약관에 따라 전송을 허용하는 최대 민감도 등급을 반환"""
    if p.used_for_training or not p.zero_data_retention:
        return 1          # 학습 사용 또는 비영(非零) 보존: 공개·합성 데이터만 허용
    if not p.lab_confirmed:
        return 1          # 출처 미확인: 마찬가지로 저민감 데이터만 허용
    return 2              # 약관과 소속이 모두 확인된 뒤에야 사설 코드를 고려

def can_send(p: ModelPolicy, data_kind: str) -> bool:
    level = SENSITIVITY[data_kind]
    if level >= 3:
        return False      # 키와 개인정보는 절대 외부 무료 채널로 보내지 않음
    return level <= max_allowed_level(p)

def production_ready(p: ModelPolicy) -> list:
    """프로덕션 연동을 막는 문제 목록을 반환, 빈 리스트면 평가 단계 진입 가능"""
    issues = []
    if p.used_for_training:
        issues.append("提示词用于训练")
    if not p.zero_data_retention:
        issues.append("비영 데이터 보존")
    if p.free_until is None:
        issues.append("무료 기한 미확인, 갑작스러운 과금 또는 서비스 종료 위험 존재")
    if not p.lab_confirmed:
        issues.append("출처 미확인, 모델 규모와 장기 가용성을 평가할 수 없음")
    return issues

iceman = ModelPolicy(
    model_id="iceman-contributor",
    used_for_training=True,
    zero_data_retention=False,
    free_until=None,
    lab_confirmed=False,
    related_ids=("iceman", "iceman-contributor"),
)

for kind in SENSITIVITY:
    print(f"{kind:15s} -> {'允许' if can_send(iceman, kind) else '拒绝'}")

print("生产接入阻碍:", production_ready(iceman))
실천 제안: 위의 메타데이터를 팀이 공유하는 설정으로 관리하고, 플랫폼 약관이나 모델 소유권 주장 상태가 바뀔 때마다 한 번씩 업데이트하세요. 이렇게 해두면 새로 합류한 동료가 어떤 무료 모델을 붙이든 감으로 판단하지 않고 같은 기준을 그대로 재사용할 수 있어요.
자주 묻는 질문 FAQ
Q1: 무료 스텔스 모델이란 무엇인가요?
스텔스 모델(stealth model)은 플랫폼에 코드명으로 먼저 올라오고, 연구소의 정체는 아직 공개되지 않은 모델을 말해요. 플랫폼의 사용량 페이지에서는 보통 출처를 Unknown으로 표시하죠. Iceman은 OpenCode 스텔스 모델 목록의 일원으로, 2026-11-04 기준 아직 소유권을 주장한 곳이 없어요.
Q2: Iceman과 iceman-contributor는 무엇이 다른가요?
공개된 데이터를 보면, 이 둘은 OpenCode 사용량 순위표가 같은 모델을 추적할 때 쓰는 두 개의 id예요. 주간 순위표에서는 하나가 급등하고 하나가 급락하는 모습으로 나타나는데, 실제로는 트래픽이 두 id 사이를 옮겨 다니는 것뿐이에요. Contributor라는 단어는 “학습 데이터로 무료 접근을 맞바꾸는” 플랫폼 교환 모델을 뜻하며, 특정 연구소의 이름이 아니에요.
Q3: Iceman의 무료 기간은 얼마나 이어지나요?
현재로서는 공개된 답이 없어요. OpenCode의 변경 공지는 “기간 한정 무료, 요청 수 제한 없음”이라고만 적혀 있고 마감일은 제시하지 않았어요. 모델 규모, 개발 주체, 무료 기간 모두 아직 알 수 없는 정보라서, 프로덕션 계획에서 이 모델의 무료 상태에 의존하는 건 권하지 않아요.
Q4: 무료 스텔스 모델은 어떤 상황에 가장 잘 맞나요?
약관이 “학습에 사용, 0이 아닌 보존”이라고 명확히 밝히고 있다는 전제하에, 비교적 적합한 상황은 이렇습니다:
– **오픈소스 프로젝트 실험**: 애초에 공개된 코드를 다루는 경우예요. 예를 들어 오픈소스 라이브러리에 예제나 테스트를 작성하는 일이죠.
– **역량 파악용 평가**: 합성 문제로 추론과 도구 호출 성능을 시험해보고, 긴 컨텍스트에서 어떻게 동작하는지 알아보는 용도예요.
– **개인 학습용 프로토타입**: 실제 데이터가 들어가지 않는 데모를 만들어 상호작용 흐름이 실현 가능한지 검증하는 경우죠.
Q5: 팀 안에서 이 스텔스 모델 점검 체크리스트를 어떻게 정착시키면 좋을까요?
세 단계를 권해요. 먼저 5가지 점검 항목을 모델 도입 문서에 적어 넣고, 그다음 위에서 말한 정책 게이트처럼 라우팅 계층에서 데이터 민감도 등급에 따라 차단하고, 마지막으로 코딩 도구에는 별도의 워크스페이스를 설정해 Agent가 사적인 파일을 자동으로 끌고 가지 않도록 하는 거예요. 약관이 바뀌면 메타데이터만 같이 업데이트하면 됩니다.
Q6: 모델이 스스로 특정 회사의 제품이라고 말하면 믿어도 되나요?
그대로 믿을 수는 없어요. 모델의 자기소개는 학습 코퍼스나 시스템 프롬프트에서 나온 것일 수 있고, 토큰 계산 방식 역시 여러 모델에서 완전히 똑같이 나타날 수 있거든요. Iceman의 경우에도 제3자 테스트에서 토큰 계산이 MAI Thinking 1과 GPT-6 시리즈와 똑같이 맞아떨어져서, 그것만으로는 구분할 수 없었어요. 귀속은 오직 연구소의 공식 소유권 주장만을 기준으로 삼아야 해요.
Q7: 스텔스 모델의 소유권이 밝혀지면, 그전에 보낸 데이터는 어떻게 되나요?
소유권 주장은 출처 귀속 정보만 바꿀 뿐, 데이터를 보낼 당시 적용되던 약관을 바꾸지는 않아요. 그때 약관이 학습에 사용하고 0이 아닌 보존을 명시했다면, 그 데이터의 처리 방식은 이미 정해진 셈이죠. 그래서 점검은 소유권이 밝혀진 뒤에 보충하는 게 아니라, 데이터를 보내기 전에 끝내야 한다는 거예요.
무료 스텔스 모델 핵심 포인트 Key Takeaways
- 약관을 먼저 보고 파라미터는 그다음: 학습 용도와 데이터 보존 정책이 무엇을 보낼 수 있는지를 결정하고, 컨텍스트 길이는 얼마나 많이 보낼 수 있는지만 결정해요.
- Contributor는 교환 모델: 학습 데이터를 제공하는 대신 무료 접근을 얻는 방식일 뿐, 모델의 출처를 뜻하지 않아요.
- 단서는 확인이 아니에요: 모델이 스스로 밝히는 정체성과 토큰 카운트만으로는 소속을 증명할 수 없어요.
- 무료 기간은 미지의 값으로 처리: “기간 한정”에 종료일이 없으니 계획에서 의존하지 마세요.
- 리더보드는 id를 합쳐서 봐야 해요: Iceman의 +768%는 id를 합치면 실제로 약 -42%예요.
- 민감한 데이터는 무조건 격리: API 키, 개인정보, 사내 핵심 코드는 학습형 채널로 보내지 마세요.
정리
무료 스텔스 모델을 프로젝트에 붙일 수 있느냐는 어떤 데이터를 보낼지에 달려 있어요. 무료인지 아닌지가 기준이 아니에요. Iceman을 예로 들면, 근거로 삼을 수 있는 건 플랫폼 약관과 카탈로그 파라미터예요. 학습에 사용됨, 0이 아닌 데이터 보존, 기간 한정 무료, 262,144 컨텍스트, 추론과 도구 호출 지원이 그렇죠. 반대로 근거로 삼을 수 없는 건 개발사에 관한 온갖 단서들이에요. 공식적으로 인정하기 전까지는 모두 소문일 뿐이에요.
재사용할 수 있는 방법론은 세 가지로 정리할 수 있어요.
- 정보를 층위로 나눠 보기: 플랫폼 공지, 카탈로그 파라미터, 미확인 단서를 분리하고 앞의 두 층만으로 의사결정하세요.
- 데이터 등급에 따라 사용: 학습형 채널에서는 공개 데이터나 합성 데이터만 다루고, 사내 코드와 개인정보는 따로 처리하세요.
- 합산 기준으로 리더보드 읽기: 같은 모델의 여러 id는 반드시 합산한 뒤 성장률을 계산해서, id 교체로 생긴 가짜 성장에 속지 마세요.
나중에 Iceman을 누가 공식적으로 인정하든, 이 검증 방법은 다음에 등장할 스텔스 모델에도 오래도록 그대로 쓸 수 있어요.
📚 참고 자료
- ArtificialWatch – Iceman 사용량 및 귀속 분석: 이 글의 핵심 사실 출처
- 링크:
artificialwatch.com/wire/iceman-opencode-stealth-model-3-trillion-tokens-unclaimed -
설명: Iceman의 이중 id 사용량, 약관 변경, 귀속 단서를 정리했으며 2026-11-04에 게시됨
-
OpenCode Data 사용량 페이지: iceman과 iceman-contributor의 사용량 데이터
- 링크:
opencode.ai/data -
설명: 각 id의 주간 순위와 토큰 사용량을 직접 확인 가능
-
models.dev 모델 카탈로그: Iceman의 기술 사양
- 링크:
models.dev -
설명: 컨텍스트 윈도우, 최대 출력, 추론 및 도구 호출 등 카탈로그 정보 제공
-
stealthmodels.com 스텔스 모델 추적: 귀속 단서 보도 출처
- 링크:
stealthmodels.com - 설명: Iceman이 스스로 주장하는 신원과 토큰 카운트에 대한 테스트를 기록한 것으로, 단서 참고용임
저자: APIYI 기술 팀
설명: 이 글의 사실은 2026-11-04 기준이며, Iceman의 클레임 상태와 무료 기간은 언제든 변할 수 있으니 플랫폼의 최신 약관을 기준으로 하세요.