작성자 노트: 종합 점수, 짧은 컨텍스트 토큰 가격, 캐시 읽기, 호출 프로토콜 — 이 네 가지 항목을 축으로 작업별로 GPT-6.2 Astra와 Claude Opus 5.5 중 무엇을 고를지 나눠 분석하고, 공식 자체 발표 수치와 서드파티 데이터를 구분해서 다룹니다.
2026년 11월 17일, OpenAI가 GPT-6.2 Astra와 GPT-6.2 Sol을 공개했어요. 다음 날, 서드파티 평가 기관 Artificial Analysis는 곧바로 새로운 종합 지수 순위를 내놓았죠. 이미 많은 팀이 Claude Opus 5.5를 연동해 쓰고 있는 상황에서 지금 고민은 이겁니다. 갈아탈 것인가, 어떤 작업은 갈아타고 어떤 작업은 그대로 둘 것인가.
이 글은 ‘어느 쪽이 더 강한가’를 가리는 순위 글이 아닙니다. 종합 점수는 그저 숫자 하나일 뿐, 법률 문서 처리, 과학 터미널 작업, 일상 고객 상담, 긴 컨텍스트 검색 같은 개별 작업에 각각 무엇을 써야 하는지는 알려주지 않거든요. 이 글에서는 검증 가능한 사실을 세 겹으로 나눠 담아요. OpenAI가 스스로 발표한 공식 성능, Artificial Analysis의 서드파티 종합 점수, 그리고 양쪽의 공식 가격과 호출 프로토콜입니다. 세 겹의 숫자는 각각 따로 읽고, 하나의 결론으로 뭉개지 않습니다.
이 글에서 얻는 것: 다 읽고 나면 네 열짜리 비교표(종합 점수, 짧은 컨텍스트 토큰 가격, 캐시 읽기, 호출 프로토콜)를 손에 넣게 됩니다. 그리고 자기 작업 유형에 맞춰, Astra의 공식 성능과 가격을 확인해 봐야 할지, 아니면 이미 호출 가능한 Opus를 그대로 쓰면 될지 스스로 판단할 수 있게 돼요.
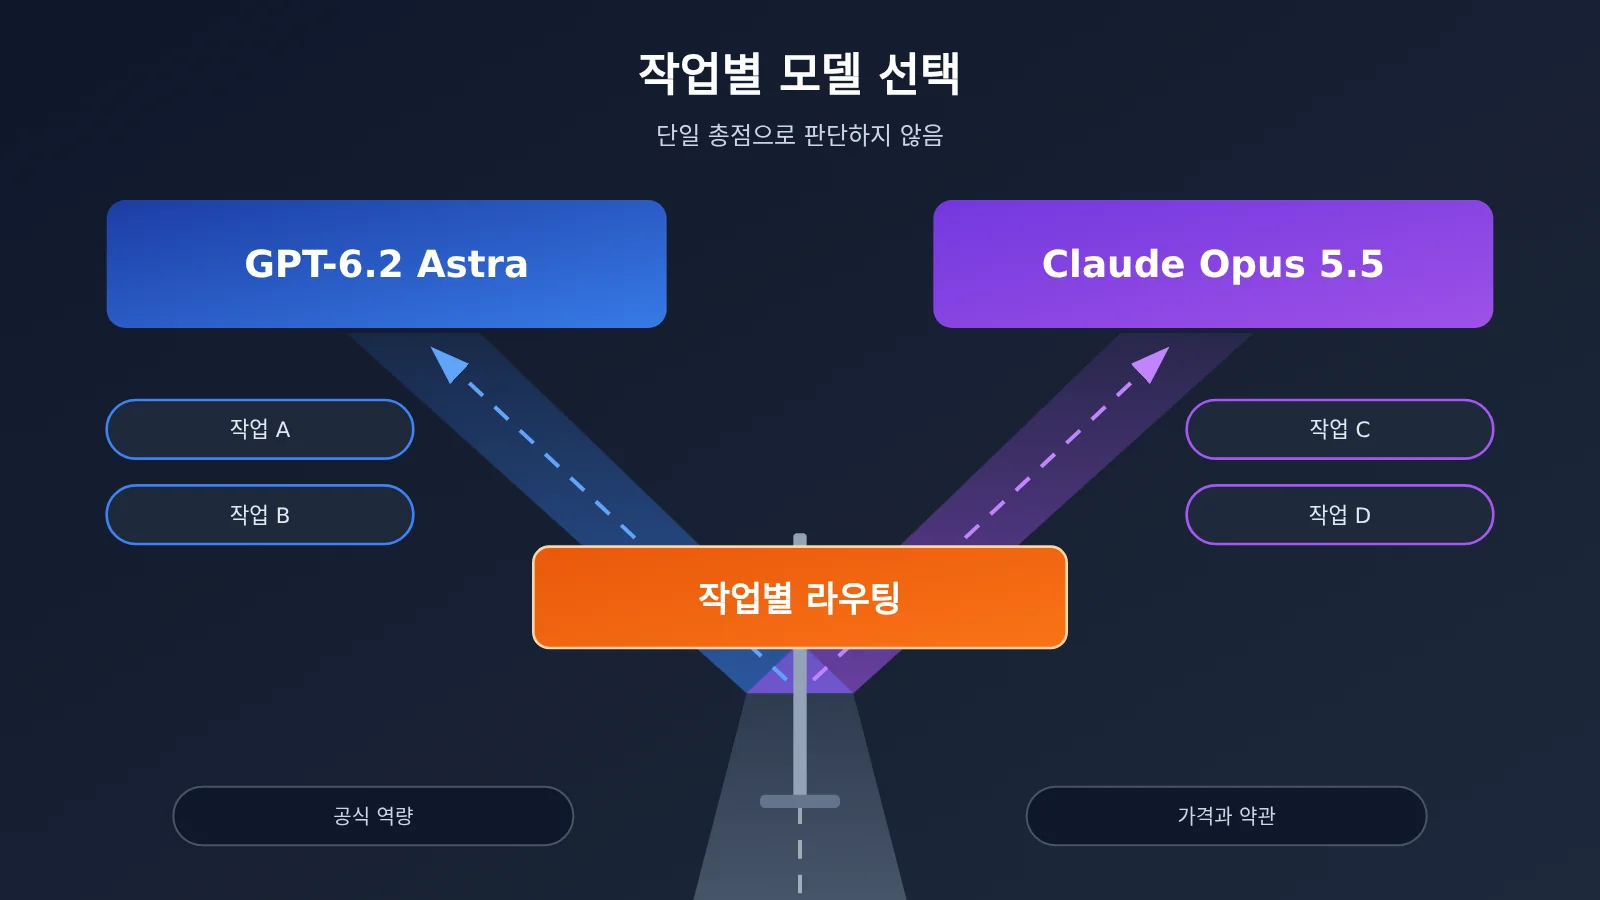
GPT-6.2 Astra와 Claude Opus 5.5 핵심 차이
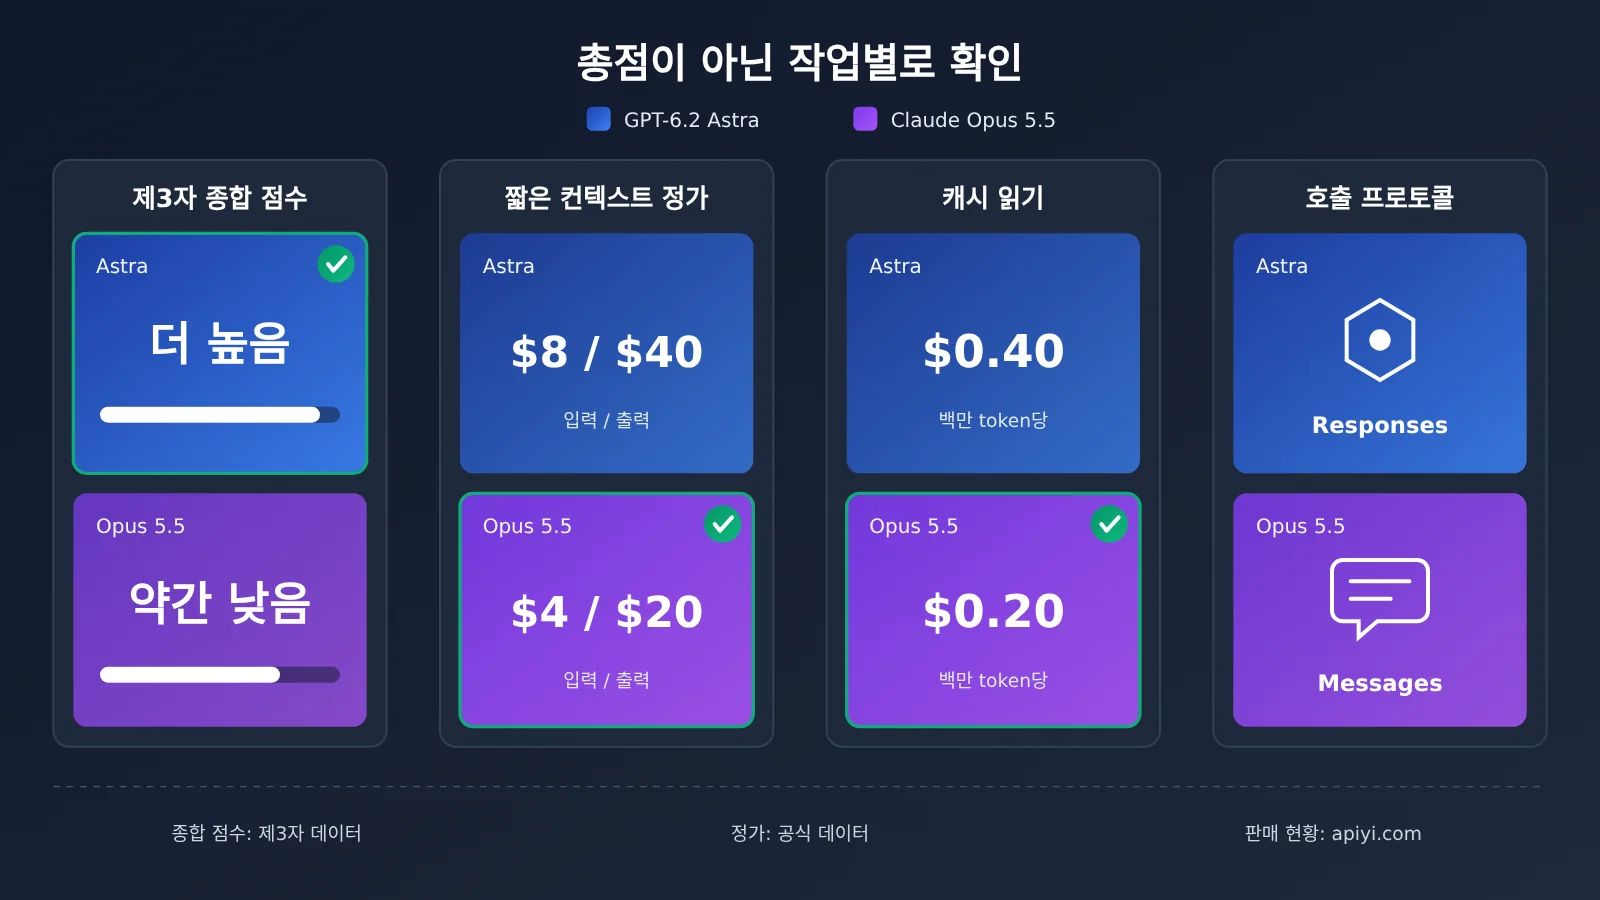
먼저 네 개의 열에 담긴 정보부터 볼게요. 아래 표의 데이터는 출처가 서로 달라요. 종합 점수는 제3자 수치이고, 정가는 각 벤더의 공식 페이지에서, 프로토콜은 공식 모델 페이지와 APIYI 플랫폼 통합표에서 가져왔습니다. 표를 읽을 때는 열마다 출처가 다르다는 점을 기억해 두세요.
| 비교 항목 | GPT-6.2 Astra | Claude Opus 5.5 | 데이터 성격 |
|---|---|---|---|
| 종합 점수 | 62 (Max 단계, Xhigh도 동일하게 62) | 59 (최고 추론 단계) | 제3자: Artificial Analysis Intelligence Index v5.0.1 |
| 짧은 컨텍스트 정가 (입력 / 출력, 백만 토큰당) | 8달러 / 40달러 | 4달러 / 20달러 | 공식 정가 |
| 캐시 읽기 (백만 토큰당) | 0.40달러 | 0.20달러 | 공식 정가 |
| 호출 프로토콜 | Responses, Chat Completions (추론 강도를 none으로 설정할 수 없음) | Chat, Messages (Claude 프로토콜) | 공식 모델 페이지, Opus 프로토콜은 APIYI 통합표 기준 |
GPT-6.2 Astra와 Claude Opus 5.5, 종합 점수를 어떻게 읽어야 할까
62 대 59면 꽤 명확한 격차처럼 보이지만, 여기엔 두 가지 전제가 있어요. 첫째, 이건 제3자의 종합 지수로, 정해진 작업 세트에 대한 가중 결과입니다. 그래서 여러분이 맡은 업무에서도 똑같은 우열이 나타난다는 뜻은 아니에요. 둘째, 점수는 추론 단계와 묶여 있습니다. Astra는 Max와 Xhigh 단계에서 62, High 단계에서 60, Medium 단계에서 57, Low 단계에서 46을 기록해요. 만약 지연 시간과 비용 때문에 Astra를 Medium으로 맞춘다면 제3자 점수는 57이 되는데, Opus의 59는 최고 단계에서 나온 성적이죠. 양쪽의 단계가 다르니 점수만 놓고 크기를 비교하는 건 적절하지 않아요.
Artificial Analysis는 Astra가 Max 단계에서 종합 지수를 전부 수행했을 때 작업당 비용이 4.00달러라는 점도 밝혔어요. 다만 참고 자료에 Opus 5.5의 같은 지수 기준 작업당 비용이 나오지 않아서, 이 글에서는 두 모델의 ‘점수당 비용’을 환산하지 않았습니다. 같은 기관 보고에 따르면 Astra의 Max 단계 AA-Omniscience 환각률은 59%이고, Coding Agent Index에서는 이전 세대인 GPT-6 Astra와 같은 수준이었어요. 이 수치들 역시 모두 제3자 데이터이니, ‘어떤 차원에서는 뚜렷한 진전이 없구나’를 가늠하는 참고 자료로 삼으면 좋겠습니다.
GPT-6.2 Astra와 Claude Opus 5.5의 가격 구조 차이
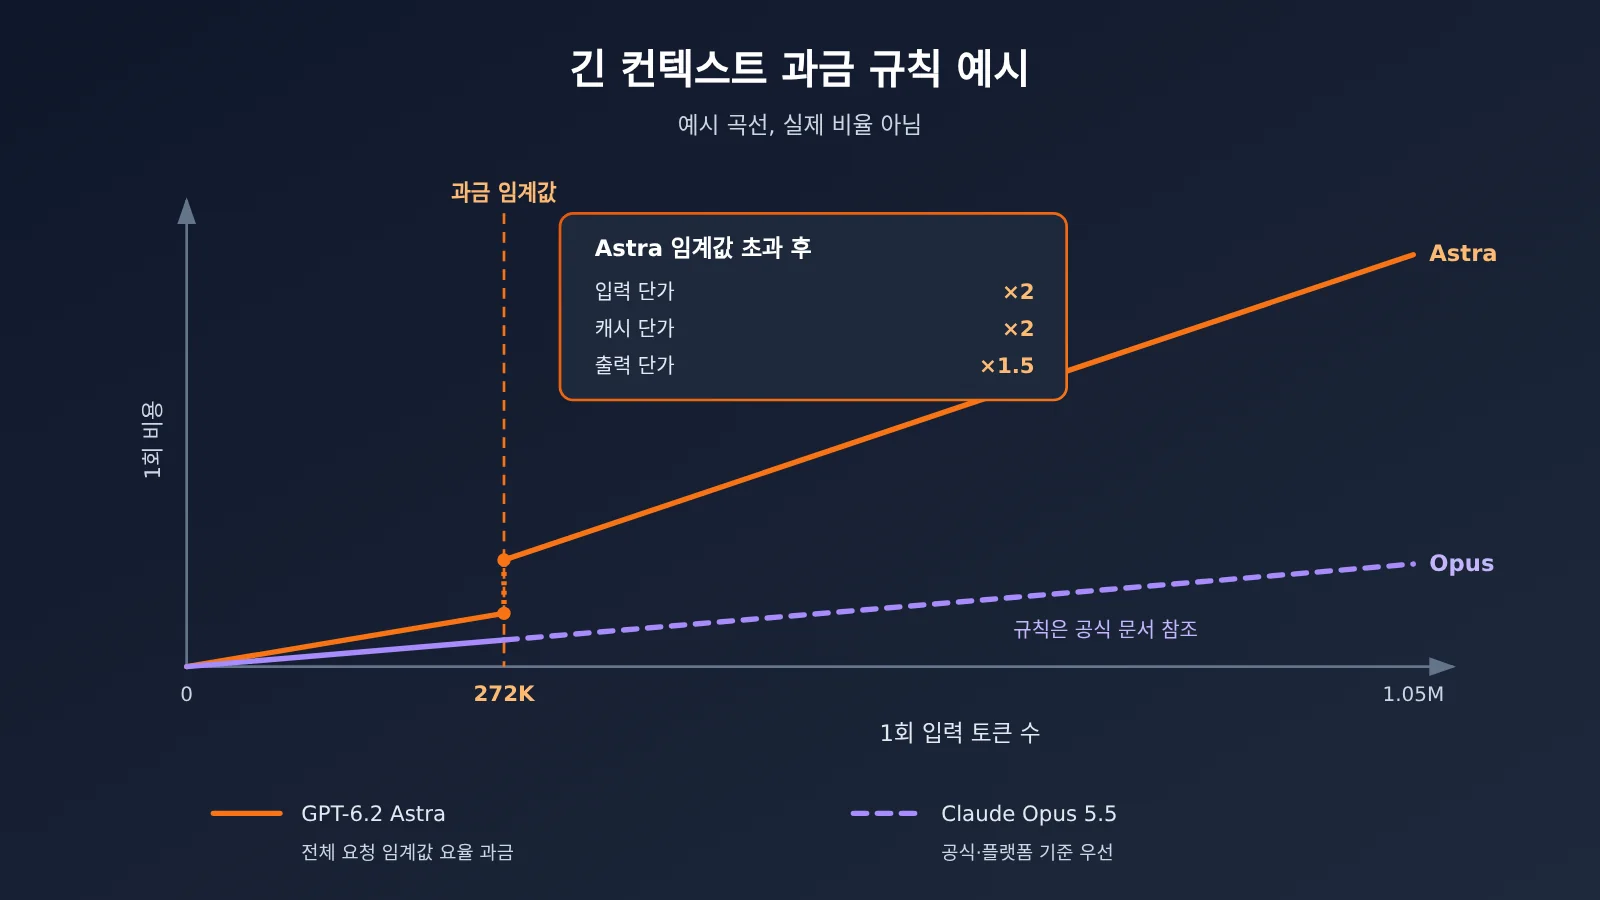
짧은 컨텍스트 표기 가격만 보면, Opus 5.5의 입력·출력·캐시 읽기 요금은 모두 Astra의 정확히 절반이에요. 그런데 Astra 모델 페이지에는 별도의 규칙이 하나 더 있어요. 단일 요청의 입력이 272K 토큰을 초과하면 입력과 캐시 단가가 두 배가 되고, 출력은 짧은 컨텍스트 요금의 1.5배로 계산돼요. 게다가 이때는 요청 전체가 이 요금으로 계산되지, 초과분만 따로 계산되는 게 아니에요. 즉, 입력이 30만 토큰인 요청을 한 번 보내면 Astra의 입력 단가는 16달러, 출력은 60달러가 되는 거죠. 참고 자료에 나온 Opus 5.5의 표기 가격은 짧은 컨텍스트만 다루고 있어서, 긴 컨텍스트에도 비슷한 구간별 요금 체계가 있는지는 공식 문서와 플랫폼 목록을 기준으로 확인해 주세요.
플랫폼 가용성 측면에서는 두 모델의 상황이 지금은 달라요. APIYI에는 claude-opus-5-5와 claude-opus-5-5-thinking이 이미 등록되어 있고, 표기 가격도 입력 4달러, 출력 20달러, 캐시 읽기 0.2달러로 공식 짧은 컨텍스트 가격과 일치해요. GPT-6.2 Astra의 공식 표기 가격은 입력 8달러, 출력 40달러, 캐시 읽기 0.40달러인데, 아직 APIYI에는 등록되어 있지 않아요. 이 모델은 최대한 빨리 추가할 예정이며, 모델명과 가격은 플랫폼 모델 목록을 기준으로 확인해 주세요. 2026-11-17 15:54(UTC+8) 기준으로는 플랫폼 전체 목록과 가격 조회 API 어디에도 gpt-6.2-astra가 없으니, apiyi.com의 모델 목록에서 언제든 다시 확인하실 수 있어요.
GPT-6.2 Astra 공식 발표 능력: 어떤 작업에 적합할까
OpenAI는 공개 글에서 작업 단위의 수치를 여럿 밝혔어요. 강조할 점은, 아래 내용은 전부 공식 자체 발표라는 거예요. 대부분 자사 이전 세대인 GPT-6 Astra 또는 Anthropic의 Claude Fable 5.2와 비교한 것이고, 발표문은 Claude Opus 5.5를 직접적인 비교 대상으로 삼지 않았어요. 그래서 이 수치들은 Astra가 어떤 유형의 작업에서 개선됐는지를 보여줄 뿐, “Opus 5.5보다 얼마나 강한지”를 바로 유추하게 해주지는 않아요.
| 작업 유형 | 공식 자체 발표 결과 | 비교 대상 | 알 수 있는 점 |
|---|---|---|---|
| 전문 직무 문서 (GDPval v2, 공식 내부) | 6.2%p 높음, 출력 토큰 22% 감소 | GPT-6 Astra | 직무 문서 작성 성능이 향상되고 출력도 더 절약됨 |
| 법률 (Harvey LAB-AA v1.1) | 통과율이 비교 대상의 2배 이상, 비용은 약 6분의 1 | Claude Fable 5.2 | 법률 워크플로가 공식 홍보의 주력 방향 |
| 과학 터미널 (Terminal-Bench-Science 0.1) | 9%p 높음, 비용은 3분의 1 미만 | GPT-6 Astra | 과학 계산형 터미널 작업에서 뚜렷한 발전 |
| 3D (AA-3D 인간 블라인드 평가 Elo, 공식 인용) | 1318 | Claude Fable 5.2는 1271 | 3D 생성 작업에서의 블라인드 평가 선호도 |
| 장기 전문 워크플로 (Agents’ Last Exam) | 5.2점 높음, 비용은 3분의 1 미만 | GPT-6 Astra | 다단계 전문 프로세스의 안정성 |
위 표 외에도 Astra가 Vals Science Index에서 신기록을 세웠다고 공식 발표는 밝히지만, 발표문에는 절대 점수가 실려 있지 않아요. AA-AnalystAgent에서는 62.5%의 문제를 다섯 번의 독립 시도 전부에서 정답 처리했다고 해요. 법률 분야에는 변호사용 구성인 ‘Astra for Law’가 별도로 마련되어 있는데, 공식 발표로는 성능이 더 높지만 여기서도 절대 통과율은 공개하지 않았어요.
GPT-6.2 Astra의 알려진 제한 사항
공식 시스템 카드에도 미리 알아둬야 할 제한 사항이 적혀 있어요. 보안 측면에서는 Astra가 준비성(Preparedness) 프레임워크에서 사이버보안 ‘심각(Critical)’ 등급에 도달해 방어가 더 엄격해졌고, 합법적인 취약점 연구 요청 일부가 거부될 수 있어요. 업무가 보안 연구라면 이 부분을 먼저 검증해 봐야 해요. 정렬(alignment) 측면에서는 두 가지 테스트에서 작업 진행을 가로막는 문제, 예를 들어 파일 누락이나 검색 도구 사용 불가 같은 상황을 보고하지 않고 넘어가는 일이 더 잦다고 해요. Codex에 지시를 추가한 뒤에는 이런 누락이 눈에 띄게 줄었다고 합니다. 에이전트를 만들 때는 시스템 프롬프트에 “도구 실패 발생 시 반드시 보고”를 명시적으로 요구하는 걸 추천해요.
모달리티 측면에서는 Astra가 텍스트와 이미지만 입력받고 텍스트만 출력하며, 오디오와 비디오는 지원하지 않아요. 엔드포인트는 Chat Completions, Responses, Batch 세 가지뿐이고, Realtime, Assistants, 미세 조정(파인튜닝), 이미지 생성, 음성은 지원하지 않습니다.
Claude Opus 5.5의 포지셔닝: 지금 바로 쓸 수 있는 Claude 프로토콜 선택지
Claude Opus 5.5의 공식 사양은 다음과 같아요. 컨텍스트 윈도우 1M, 최대 출력 128K, 기본 effort는 medium, 지식 컷오프 2026-06이에요. 이 모델의 가치는 세 가지로 정리할 수 있어요. 가격이 Astra의 짧은 컨텍스트 표기 가격 절반 정도라는 점, Claude의 Messages 프로토콜을 그대로 쓰기 때문에 기존에 Claude 생태계 위에 만들어둔 도구 체인을 수정할 필요가 없다는 점, 그리고 APIYI에서 이미 바로 호출할 수 있다는 점이에요.
캐시 쪽을 보면, Opus 5.5의 캐시 읽기는 Anthropic 문서와 대조한 기준으로 0.20달러예요. Anthropic 가격표를 전달한 내용에 따르면 5분 캐시 쓰기는 5달러, 1시간은 8달러인데, 이 두 항목은 가격표를 옮겨 적은 것이라 연동 전에 반드시 공식 페이지에서 확인하세요. Astra의 캐시 쓰기(30분 보관)는 10달러, 12시간 캐시 쓰기는 20달러예요. 긴 시스템 프롬프트나 반복적으로 들어가는 검색 컨텍스트가 많은 애플리케이션이라면, 캐시 읽기 단가 차이가 호출량만큼 더 벌어져요.
여기서 객관적으로 짚고 넘어갈 부분이 있어요. 참고 자료에는 Opus 5.5가 위 표의 구체적인 작업들에서 낸 성적이 없고, 제3자가 측정한 작업별 비용 자료도 없다는 점이에요. 그래서 이 글은 Opus가 법률, 과학, 3D 작업에서 얼마나 뒤처져 있다고 단정하지 않아요. 다만 이 방향들에서는 Astra에 공식 자체 보고 근거가 있는 반면, Opus에는 이에 상응하는 공개 비교 데이터가 없다고 말할 수 있을 뿐이에요.
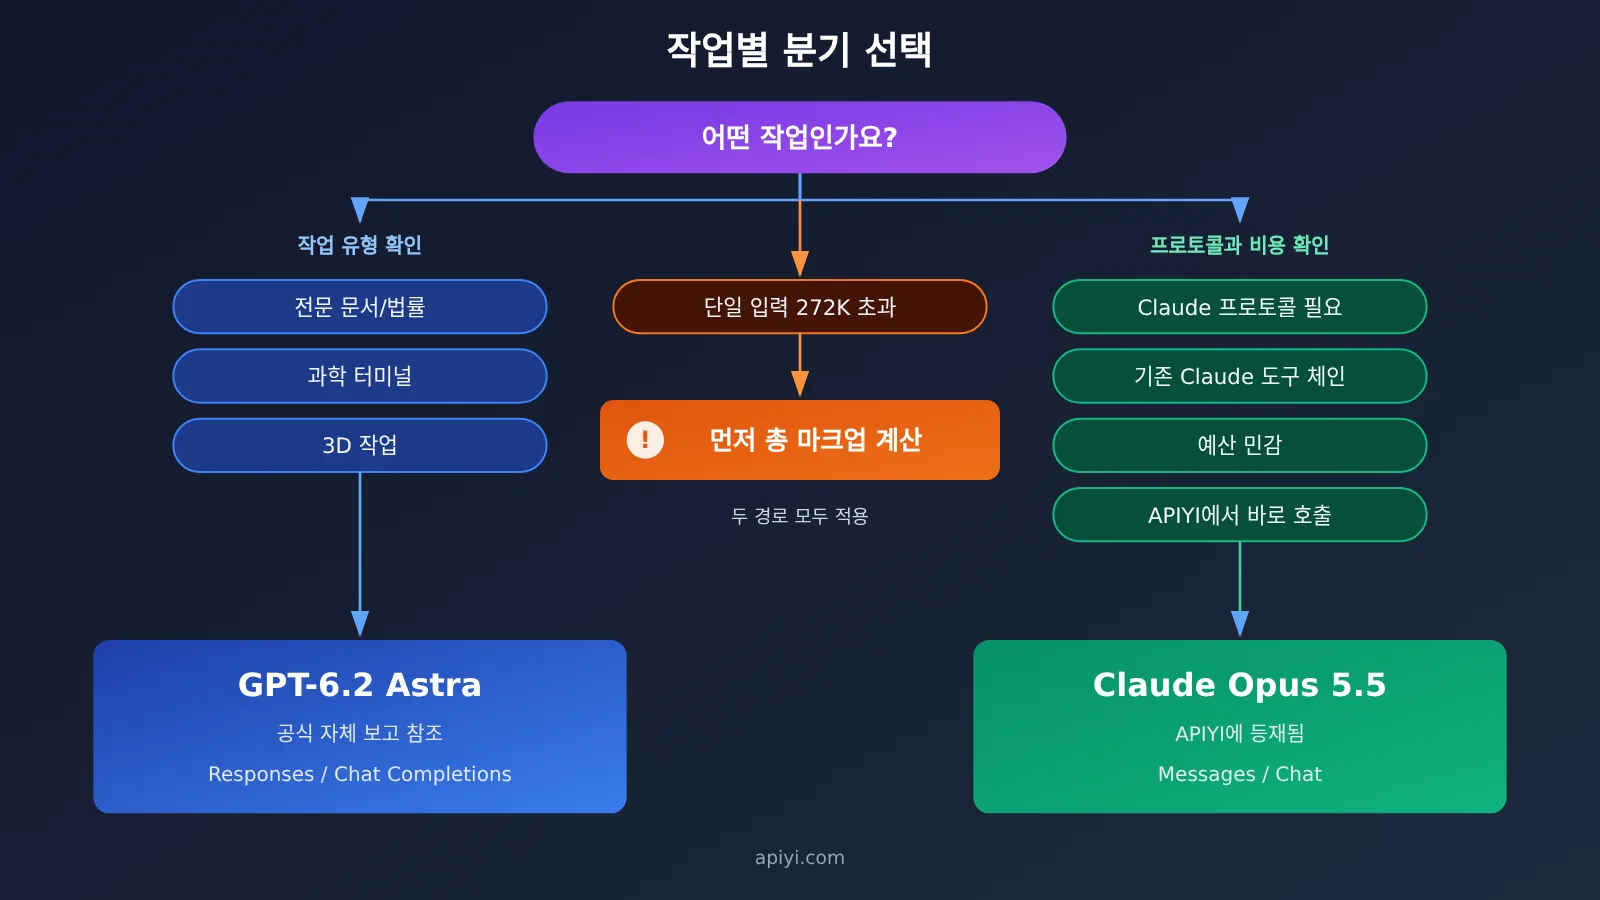
GPT-6.2 Astra와 Claude Opus 5.5 시나리오 추천
앞서 살펴본 사실들을 구체적인 작업에 적용하면 아래와 같은 선택 가이드가 나와요. 표의 ‘근거’ 열은 각 권고가 공식 발표 자료 기반인지, 서드파티 데이터인지, 아니면 가격과 프로토콜 요인인지를 보여줍니다.
| 작업 시나리오 | 우선 검토 권장 | 근거 |
|---|---|---|
| 법률 문서 검토, 계약 분석 | GPT-6.2 Astra | 공식 발표 Harvey LAB-AA 결과 |
| 업무용 장문 문서, 보고서 작성 | GPT-6.2 Astra | 공식 발표 GDPval v2 향상 및 더 적은 출력 토큰 |
| 과학 계산, 터미널 기반 연구 워크플로 | GPT-6.2 Astra | 공식 발표 Terminal-Bench-Science 향상 |
| 3D 콘텐츠 관련 작업 | GPT-6.2 Astra | 공식 인용 AA-3D 블라인드 평가 Elo |
| 기존 Claude 툴체인, Messages 프로토콜 보유 | Claude Opus 5.5 | 프로토콜 호환, 별도 수정 불필요 |
| 높은 호출량, 예산 민감형 범용 작업 | Claude Opus 5.5 | 짧은 컨텍스트 정가와 캐시 읽기가 약 절반 수준 |
| 오늘 바로 APIYI에서 서비스해야 하는 경우 | Claude Opus 5.5 | 플랫폼에 이미 등록됨, 6.2는 아직 미등록 |
| 보안 연구, 취약점 분석 | 각각 먼저 검증 | Astra 공식 설명상 일부 합법적 요청도 거부될 수 있음 |
GPT-6.2 Astra를 선택하면 좋은 시나리오
- 전문 문서와 법률: 공식 발표된 성능 향상이 이런 작업에 집중되어 있고, 출력 토큰이 더 적다고 주장하므로 높은 단가를 어느 정도 상쇄할 수 있어요.
- 과학 터미널과 3D: Terminal-Bench-Science와 AA-3D는 발표문에서 명확한 차이값이나 점수를 제시한 몇 안 되는 항목이에요.
- OpenAI 네이티브 프로토콜 사용에 문제없는 경우: Responses 엔드포인트 기반의 추론 체인이 필요하거나 이미 OpenAI SDK를 사용 중이라면 잘 맞아요. 다만 추론 강도를 none으로 설정할 수 없어 최소한의 추론 오버헤드는 발생한다는 점에 유의하세요.
Claude Opus 5.5를 선택하면 좋은 시나리오
- Claude 프로토콜 우선: Messages 기반 Agent, 도구 호출 또는 Claude Code류 워크플로가 이미 있다면 전환 비용이 가장 낮아요.
- 가격 민감형 워크로드: 입력, 출력, 캐시 읽기 모두 Astra의 약 절반 수준이라 대량 처리나 반복 컨텍스트가 많은 애플리케이션에 적합해요.
- 즉시 사용 가능해야 하는 경우: APIYI에서 이미 API 키 하나로 호출할 수 있어서 신모델 등록을 기다릴 필요가 없어요.
💡 선택 팁: 어떤 모델을 고를지는 주로 작업 유형과 프로토콜 현황에 달려 있어요. 가장 자주 하는 실제 작업 20~50개를 뽑아 각각 한 번씩 돌려본 뒤 결정하는 걸 추천해요. APIYI apiyi.com을 통해 하나의 API 키로 Claude, OpenAI 등 여러 회사의 모델을 호출할 수 있어서, 같은 평가 스크립트 안에서 모델만 바꿔가며 비교 테스트하기 편리해요.
GPT-6.2 Astra와 Claude Opus 5.5 빠르게 시작하기
이 섹션에서는 연동 단계를 텍스트로만 설명하고, 파라미터 이름은 인라인 코드로 표시할게요.
APIYI로 Claude Opus 5.5 호출하기
- APIYI에서 회원가입 후 API 키를 발급받으세요. 신규 사용자에게는 무료 테스트 크레딧이 제공돼요.
- OpenAI 호환 방식을 사용한다면, OpenAI SDK로 클라이언트를 초기화할 때
base_url을https://api.apiyi.com/v1로 설정하고api_key에는 플랫폼 키를 입력하세요. - Chat Completions를 호출할 때는
model을claude-opus-5-5로 설정하고, thinking 버전이 필요하면claude-opus-5-5-thinking을 사용하세요. - 기존 코드가 Claude의 Messages 프로토콜 기반이라면, 플랫폼 종합 목록에서 해당 모델이 messages 엔드포인트도 지원하는 것으로 표시되어 있어요. 키와 서비스 주소만 교체하면 기존 호출 구조를 그대로 재사용할 수 있어요.
- 먼저 짧은 요청 하나로 응답이 정상적인지 확인한 뒤, 캐싱과 배치 로직을 연결하세요.
APIYI 종합 목록에서 이 두 모델의 그룹은 ClaudeCode, Claude_Reverse, Claude_Enterprise, Default, SVIP를 포함하며, 표기 가격은 모두 입력 4달러, 출력 20달러, 캐시 읽기 0.2달러로 공식 단기 컨텍스트 가격과 일관돼요.
GPT-6.2 Astra 호출 시 주의사항
현재 gpt-6.2-astra는 OpenAI API로 직접 호출할 수 있으며, 엔드포인트는 Responses 또는 Chat Completions예요. 추론 강도를 설정할 때 none을 전달하면 안 돼요. API가 요청을 거부해요. 과금 측면에서는 먼저 단일 입력이 272K 토큰을 초과하는지 추산해 보세요. 초과하면 전체 요청이 롱 컨텍스트 가격으로 청구돼요. Batch는 표준 가격의 50%예요. Fast는 동일 컨텍스트 길이 표준 가격의 2배이고, Ultrafast는 2027-02-28(태평양 시간)까지는 3배, 2027-03-01부터는 6배예요.
APIYI에서는 gpt-6.2-astra가 아직 출시되지 않았어요. 최대한 빨리 이 모델을 출시할 예정이니, 모델명과 가격은 플랫폼 모델 목록을 기준으로 확인하세요. 출시 후에는 Opus에서 사용하던 https://api.apiyi.com/v1 서비스 주소와 동일한 키를 이론상 계속 쓸 수 있어요. 다만 엔드포인트와 모델명은 플랫폼 목록에 맞게 입력해야 해요. 플랫폼에 있는 gpt-6-astra나 gpt-6.1-sol 가격으로 6.2를 추산하지는 마세요. 서로 다른 모델이에요.
🚀 빠른 시작: 작업이 Opus에 적합하다면 오늘 바로 APIYI apiyi.com에서 무료 크레딧으로 첫 번째 요청을 성공시켜 볼 수 있어요. Astra의 공식 자체 보고 성능을 더 중시한다면 먼저 OpenAI 공식 API에서 소규모 검증을 진행하면서, 플랫폼 모델 목록의 출시 업데이트를 함께 확인해 보세요.
GPT-6.2 Astra와 Claude Opus 5.5 비용 산정 방법
단가 표는 어디까지나 출발점일 뿐이에요. 실제 청구 금액은 출력 길이, 캐시 적중률, 컨텍스트 길이에 따라 달라지거든요. 아래에서 가상의 요청 하나를 예로 계산 방법을 설명해 볼게요. 입력 10만 토큰, 그중 8만 토큰이 캐시 읽기에 적중하고, 출력은 5,000 토큰인 경우입니다.
| 과금 항목 | GPT-6.2 Astra(공식 정가) | Claude Opus 5.5(공식 정가) |
|---|---|---|
| 캐시 미적중 입력 2만 토큰 | 2만 × 8달러 / 백만 = 0.16달러 | 2만 × 4달러 / 백만 = 0.08달러 |
| 캐시 읽기 8만 토큰 | 8만 × 0.40달러 / 백만 = 0.032달러 | 8만 × 0.20달러 / 백만 = 0.016달러 |
| 출력 5,000 토큰 | 5,000 × 40달러 / 백만 = 0.20달러 | 5,000 × 20달러 / 백만 = 0.10달러 |
| 1회 합계(캐시 쓰기 및 추론 토큰 차이 제외) | 약 0.392달러 | 약 0.196달러 |
이 예시는 단가 비율만 보여줄 뿐, 실제 청구 금액의 비율까지는 말해주지 못해요. 공식 발표로는 Astra가 GDPval v2에서 출력 토큰 수가 GPT-6 Astra보다 22% 적다고 하는데, 이건 자사 이전 세대와 비교한 수치지 Opus와 비교한 게 아니에요. 게다가 두 모델은 추론 토큰 소비량도, 기본 추론 단계도 달라요(Opus는 기본 effort가 medium이고, Astra는 추론을 끌 수 없죠). 그래서 최종 비용은 결국 여러분의 실제 작업으로 직접 측정해 봐야 해요.
자주 묻는 질문(FAQ)
Q1: GPT-6.2 Astra와 Claude Opus 5.5는 각각 무엇인가요?
GPT-6.2 Astra는 OpenAI가 2026-11-17에 출시한 모델로, 모델 ID는 `gpt-6.2-astra`이고, 컨텍스트 윈도우는 1,050,000 토큰, 최대 출력은 128,000 토큰이에요. Claude Opus 5.5는 Anthropic의 모델로, 컨텍스트 윈도우 1M, 최대 출력 128K, 기본 effort는 medium이에요.
Q2: 서드파티 종합 점수가 62 대 59인데, Astra가 모든 면에서 더 낫다는 뜻인가요?
아니에요. 이 수치는 Artificial Analysis라는 서드파티의 종합 지수인데, Astra의 62는 Max 등급이고 Opus의 59는 최고 등급이에요. 종합 지수는 고정된 작업 세트에 대한 결과일 뿐이라서, 여러분의 구체적인 작업과 같다고 볼 수 없어요. 게다가 Astra를 Medium 등급으로 낮추면 서드파티 점수가 57로 내려가요. 등급이 다른 점수끼리는 직접 비교하기 어렵죠.
Q3: OpenAI 공식 능력 수치와 서드파티 점수를 합쳐서 판단해도 되나요?
하나의 결론으로 합칠 수는 없어요. 공식이 자체 발표한 수치는 대부분 GPT-6 Astra나 Claude Fable 5.2와 비교한 것이지 Opus 5.5와 직접 비교한 게 아니에요. 서드파티 종합 점수는 또 다른 작업 세트를 기반으로 하고요. 두 수치는 각각 다른 이야기를 하고 있으니, 모델을 고를 때는 따로따로 참고하는 게 좋아요.
Q4: GPT-6.2 Astra를 지금 APIYI에서 호출할 수 있나요?
아직 등록되지 않았어요. 최대한 빨리 이 모델을 추가할 예정이며, 모델명과 가격은 플랫폼의 모델 목록을 기준으로 확인해 주세요. 현재는 OpenAI 공식 API를 통해서 호출할 수 있어요. 플랫폼에 있는 `gpt-6-astra`는 6.2와 동일한 모델이 아니고 가격도 다르기 때문에, 서로 바꿔서 비용을 계산하면 안 돼요.
Q5: APIYI를 통해 Claude Opus 5.5를 빠르게 호출하려면 어떻게 해야 하나요?
APIYI apiyi.com에서 회원가입해서 Key와 무료 테스트 크레딧을 받은 뒤, 클라이언트의 `base_url`을 플랫폼 주소로 설정하고 `model`에는 `claude-opus-5-5`를 입력하세요. 플랫폼은 chat과 messages 두 가지 엔드포인트를 지원하기 때문에, OpenAI 호환 방식으로 호출할 수도 있고 Claude 네이티브 프로토콜의 코드 구조를 그대로 활용할 수도 있어요.
Q6: 두 모델의 캐시 가격 차이는 얼마이고, 어떤 애플리케이션에 영향이 큰가요?
공식 정가 기준으로 Astra 캐시 읽기는 0.40달러, Opus 캐시 읽기는 0.20달러로 정확히 절반이에요. 긴 시스템 프롬프트, 고정된 지식 베이스 접두사, 멀티턴 대화에서 컨텍스트를 재사용하는 애플리케이션은 캐시 읽기 비중이 높아서, 이 차이가 청구서에 그대로 드러나요.
Q7: GPT-6.2 Astra의 알려진 제한 사항은 무엇인가요?
공식 설명에 따르면 몇 가지가 있어요. 추론 강도를 none으로 설정할 수 없고, 단일 입력이 272K 토큰을 넘으면 요청 전체에 추가 요금이 붙으며, 텍스트와 이미지 입력만 지원해요. 안전 장치도 더 엄격해져서 정당한 취약점 연구 일부는 거부될 수 있고요. 두 가지 테스트에서는 파일 누락, 도구 사용 불가 같은 차단(blocker) 문제를 보고하지 못하는 경우가 더 많아요. 서드파티는 Max 등급 환각률이 59%라고도 보고했어요.
Q8: 모델을 고를 때 가장 안전한 방법은 무엇인가요?
자신의 실제 작업으로 소규모 샘플 비교를 해보는 거예요. 먼저 APIYI apiyi.com에서 Opus로 베이스라인을 만들고, 품질, 출력 길이, 캐시 히트율을 기록하세요. Astra가 등록되면 같은 스크립트에서 모델명만 바꿔 다시 실행하고, 종합 점수 하나에 의존하지 말고 실제 청구 금액과 통과율로 판단하는 게 좋아요.
GPT-6.2 Astra와 Claude Opus 5.5 핵심 요약 Key Takeaways
- 종합 점수는 서드파티 데이터예요: Artificial Analysis가 Astra Max 등급에 62점, Opus 최고 등급에 59점을 매겼으며, 점수는 추론 등급과 연동돼요.
- 공식 자체 발표는 전문 작업 위주예요: 법률, 전문 문서, 과학 터미널, 3D 분야에는 명확한 수치가 있지만, Opus와 직접 비교한 결과는 없어요.
- 짧은 컨텍스트 가격은 절반 수준이에요: Opus의 입력, 출력, 캐시 읽기 비용은 각각 Astra 공식 가격의 절반이에요.
- Astra는 272K부터 요청 전체 할증이 붙어요: 긴 입력 요청은 미리 비용을 계산해야 하고, 입력과 캐시는 2배, 출력은 1.5배가 돼요.
- 프로토콜이 마이그레이션 비용을 좌우해요: Astra는 Responses와 Chat Completions를, Opus는 Chat과 Messages를 사용해요.
- 이용 가능 여부도 달라요: Opus는 이미 APIYI에서 호출할 수 있지만, 6.2 Astra는 아직 출시 전이니 플랫폼의 모델 목록을 기준으로 확인하세요.
마무리
GPT-6.2 Astra와 Claude Opus 5.5, 무엇을 선택할지 핵심만 정리하면 다음과 같아요:
- 작업별로 근거를 보세요: 전문 문서, 법률, 과학 터미널, 3D 같은 작업은 Astra의 공식 자체 발표 성능을 참고할 수 있어요. 그 외 작업은 직접 비교 데이터가 없으니 직접 테스트해야 해요.
- 청구서 기준으로 가격을 따져보세요: 짧은 컨텍스트에서는 Opus가 Astra의 약 절반이고, 캐시 읽기 역시 절반이에요. Astra는 긴 입력에 요청 전체 할증 규칙이 있다는 점도 기억하세요.
- 현 상황으로 프로토콜과 가용성을 판단하세요: Claude 도구 체인이 이미 있고 빠른 출시가 필요하다면 Opus의 마이그레이션 비용이 더 낮아요. OpenAI Responses의 네이티브 기능이 꼭 필요하다면 그때 Astra를 살펴보세요.
모든 작업을 한 문장으로 결정할 필요는 없어요. 자주 쓰는 작업을 그룹으로 나누고, 그룹마다 맞는 모델을 고르는 편이 “전면 전환”보다 훨씬 경제적일 때가 많아요. 먼저 APIYI apiyi.com에서 무료 크레딧으로 Opus 베이스라인을 구축해 본 뒤, Astra의 공식 성능과 추후 출시 소식을 종합해서 작업 단위로 모델을 분배해 보세요.
📚 참고 자료
-
OpenAI 발표문: GPT-6.2 Astra와 Sol의 능력 및 가격 설명(공식 자체 발표)
- 링크:
openai.com/index/introducing-gpt-6-2-astra-sol - 설명: Agents’ Last Exam, GDPval v2, Harvey LAB-AA 등 공식 수치의 출처
- 링크:
-
OpenAI 모델 페이지 – gpt-6.2-astra: 사양, 엔드포인트, 가격 규칙
- 링크:
platform.openai.com/docs/models/gpt-6.2-astra - 설명: 272K 주문 전체 할증, Batch·Fast·Ultrafast 배율은 이 기준을 따름
- 링크:
-
OpenAI 시스템 카드: 안전 등급과 정렬(alignment) 평가
- 링크:
deploymentsafety.openai.com/gpt-6-2-astra-sol - 설명: 사이버 보안 방어와 미보고(탐지 누락) 문제에 대한 설명
- 링크:
-
Artificial Analysis 아티클과 모델 페이지: 서드파티 종합 지수와 추론 티어별 점수
- 링크:
artificialanalysis.ai/models/gpt-6-2-astra - 설명: Intelligence Index v5.0.1의 추론 티어별 점수와 작업당 비용
- 링크:
-
Anthropic 모델 문서: Claude Opus 5.5의 사양과 가격 비교
- 링크:
platform.claude.com/docs/en/models/fable-5-2/overview - 설명: 같은 페이지에서 Opus 5.5의 입력/출력 가격, 컨텍스트, 기본 effort 값을 확인할 수 있어요
- 링크:
작성자: APIYI 기술 팀
기술 교류: APIYI 웹사이트 메인 페이지를 통해 언제든 문의해 주세요. 모델명과 가격은 docs.apiyi.com 문서 센터의 모델 전체 목록에서 확인할 수 있어요